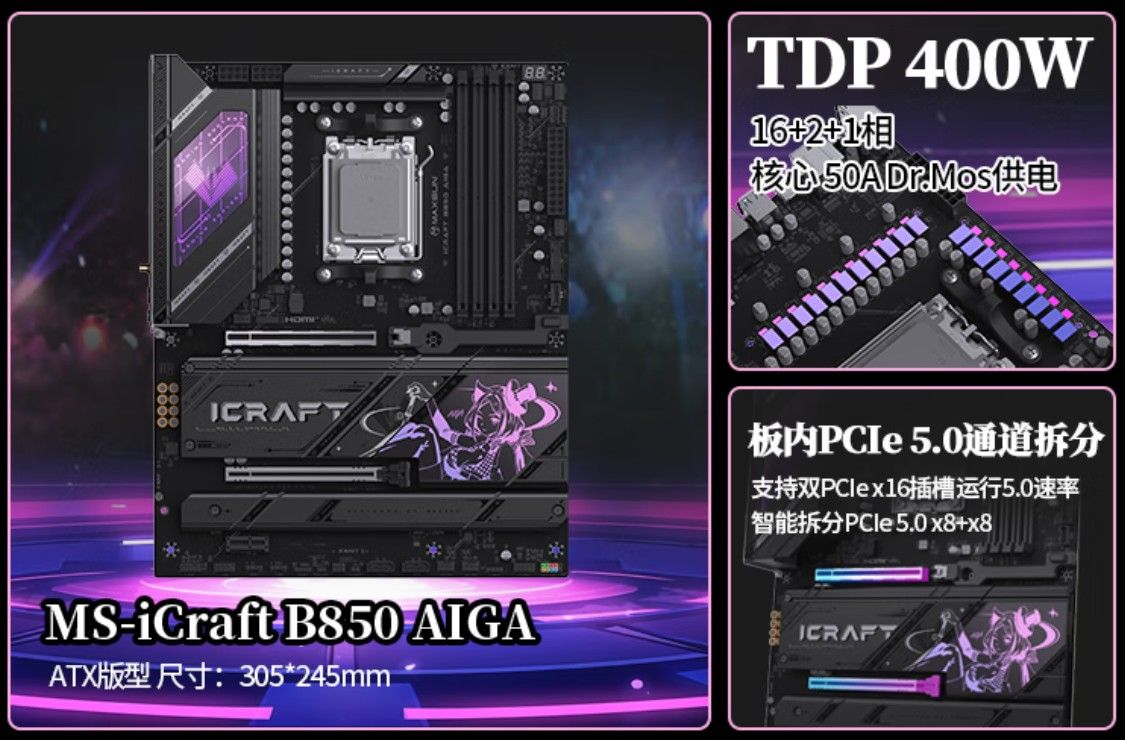
x99-tf 的规格最高支持到DDR4 2400吧?不知道是否跟这个有关
-
X99-TF不兼容32GB U-DIMM DDR4 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结请看一楼:三、装机经验与教训 1. 板+U和内存的匹配
-
7900 XTX单卡:prefill 2086→3205,decode 64.7→96.3 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结买了一个利民4口风扇集线器,十几块钱,插在cpufan_1上,把cpu风扇和机箱顶部的两个风扇接上去,让系统根据cpu和gpu的温度来调速,之前那两个顶部风扇之前都是100%转速疯狂运转的,这下子安静多了!
之前脑子短路了,只想着在主板上找第二个可调速的接口,却忘了风扇可以并联。现在三个风扇的总电流不到1A,主板供电应该没问题。
非常感谢指点!
-
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)去他家官网找说明书,进bios是按del
-
7900 XTX单卡:prefill 2086→3205,decode 64.7→96.3以下全部来自实测日志(非估算),中位数取自每臂 2–3 次重复:
指标 0.1.45 原版 0.1.45 + RDNA3 env 0.1.45 + RDNA3 + 全套调优 升级至0.1.54 升级至0.1.55 4K prefill tok/s 1179 1997 2094 2041 2017 16K prefill tok/s 1766 2761 2805 2697 2710 32K prefill tok/s 1779 3029 3194 3074 3108 chat decode 中位 tok/s 78.2 79.2 80.5 77.1 82.7 agent decode tok/s 88.2 92.0 87.6 95.0 97.1 agent cache hit % — — 68.65 69.25 69.42 供参考。
-
7900 XTX单卡:prefill 2086→3205,decode 64.7→96.3 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结多谢分享,先去看一下!
-
攒机成果:x99-TF + 7900XTX 平台握个手!这个鼠标的蓝牙密钥只能存一组,单机win+ubuntu双系统时,如果是蓝牙连接就比较麻烦,要么需要手动切换蓝牙通道,不想手动就得把两个系统的蓝牙密钥弄成一样的,比较折腾,现在插个接收器改用2.4G无线连接了。
-
攒机成果:x99-TF + 7900XTX 平台 -
攒机成果:x99-TF + 7900XTX 平台分享近期组装的x99平台,总体来说,性价比超高,比较满意。配置如下:
序号 品名 品牌型号与规格 1 板U套装 华南金牌X99-TF + E5 2686V4 + 6铜管散热 2 内存 三星 DDR3 RECC 1600 32G x 4 拆机条 3 显卡 蓝宝石 RX 7900XTX 白金版 4 亮机卡 小影霸 R7 240 4GD3 5 SSD HP EX900plus Gen 3 1T 6 电源 长城 F10 1000W 白金牌 7 机箱 先马 黑洞PRO 8 显卡支架 联拓 铝合金 两段 磁吸 9 机箱风扇 利民 TL-C14C x 2 10 扩展卡 萌图 PCIe 转USB3.2 Gen2x2 20Gbps 11 蓝牙适配器 绿联 CM749 天线版
-
散件到货
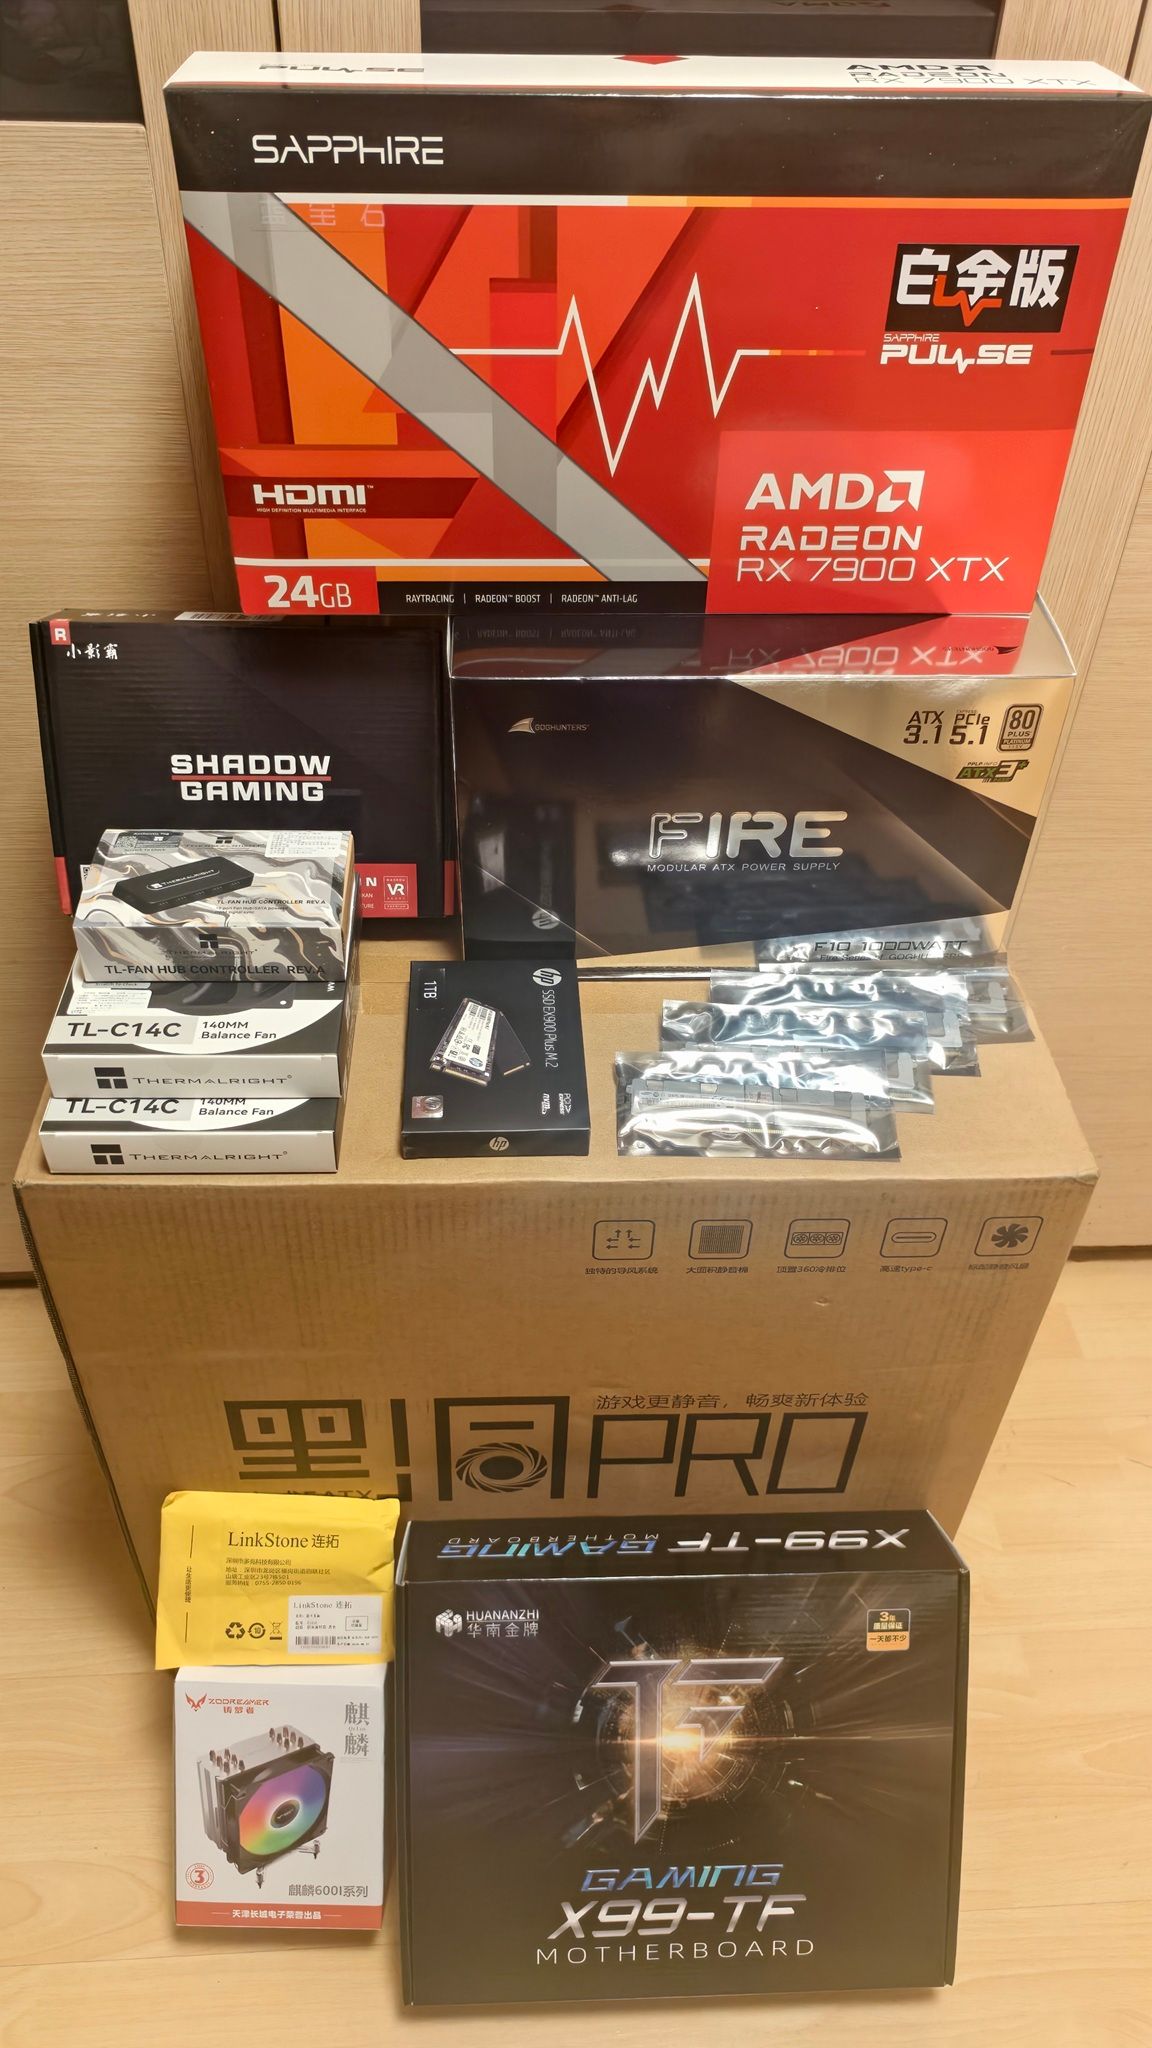
-
拆包
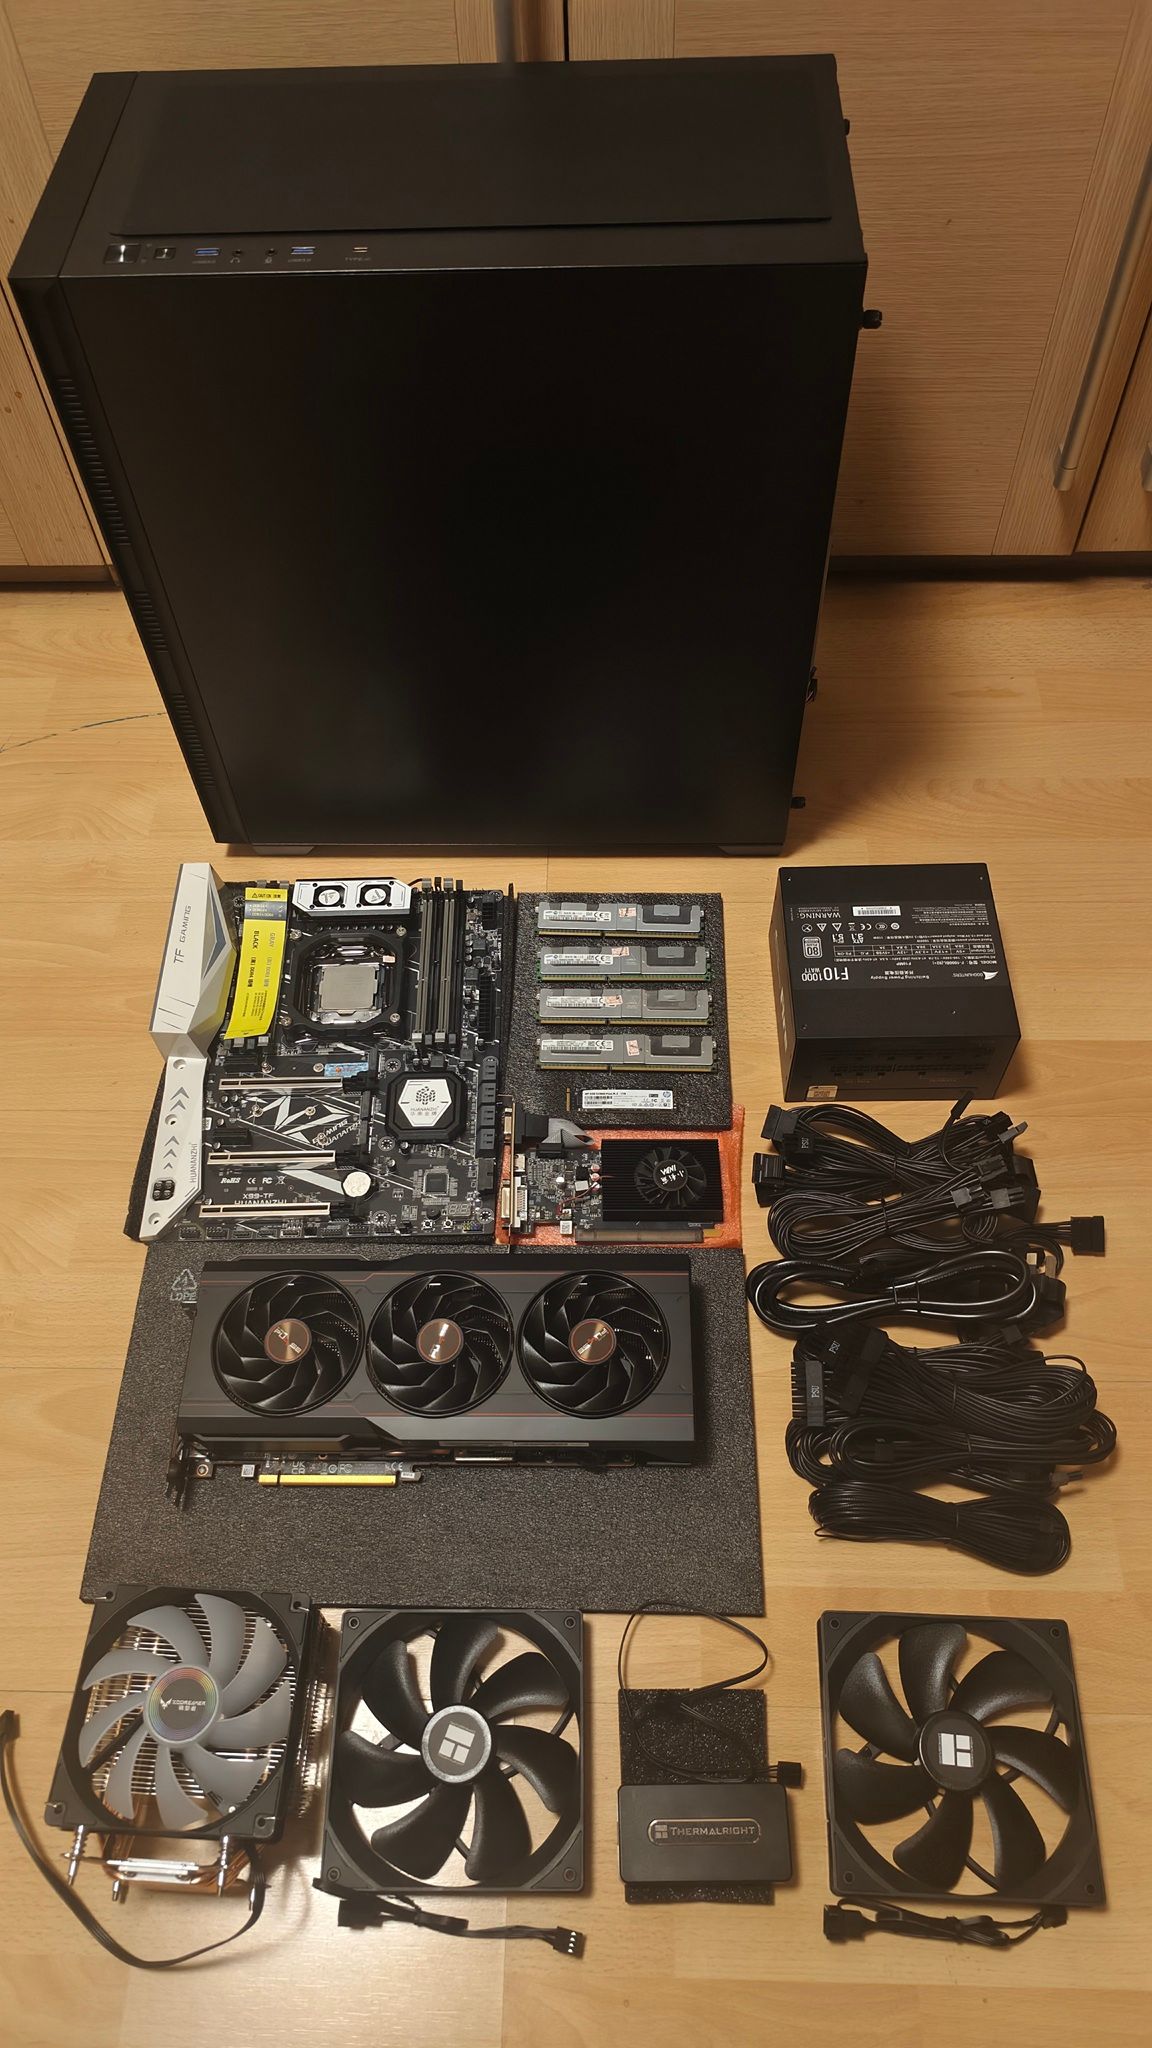
-
组装
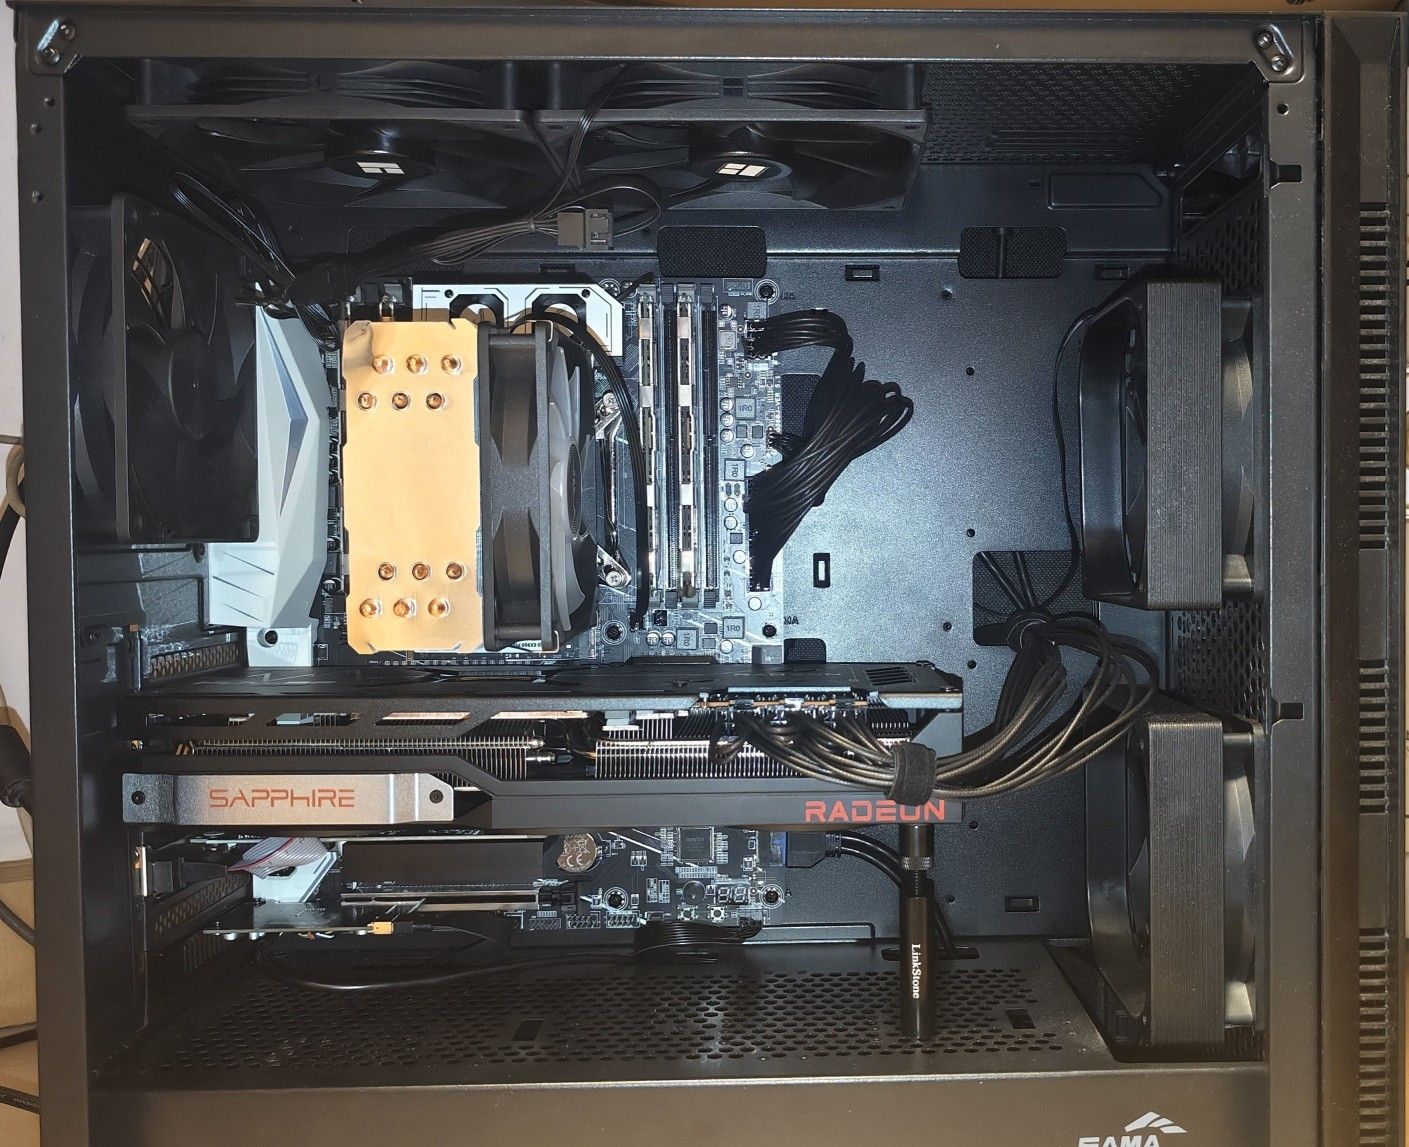
-
开机
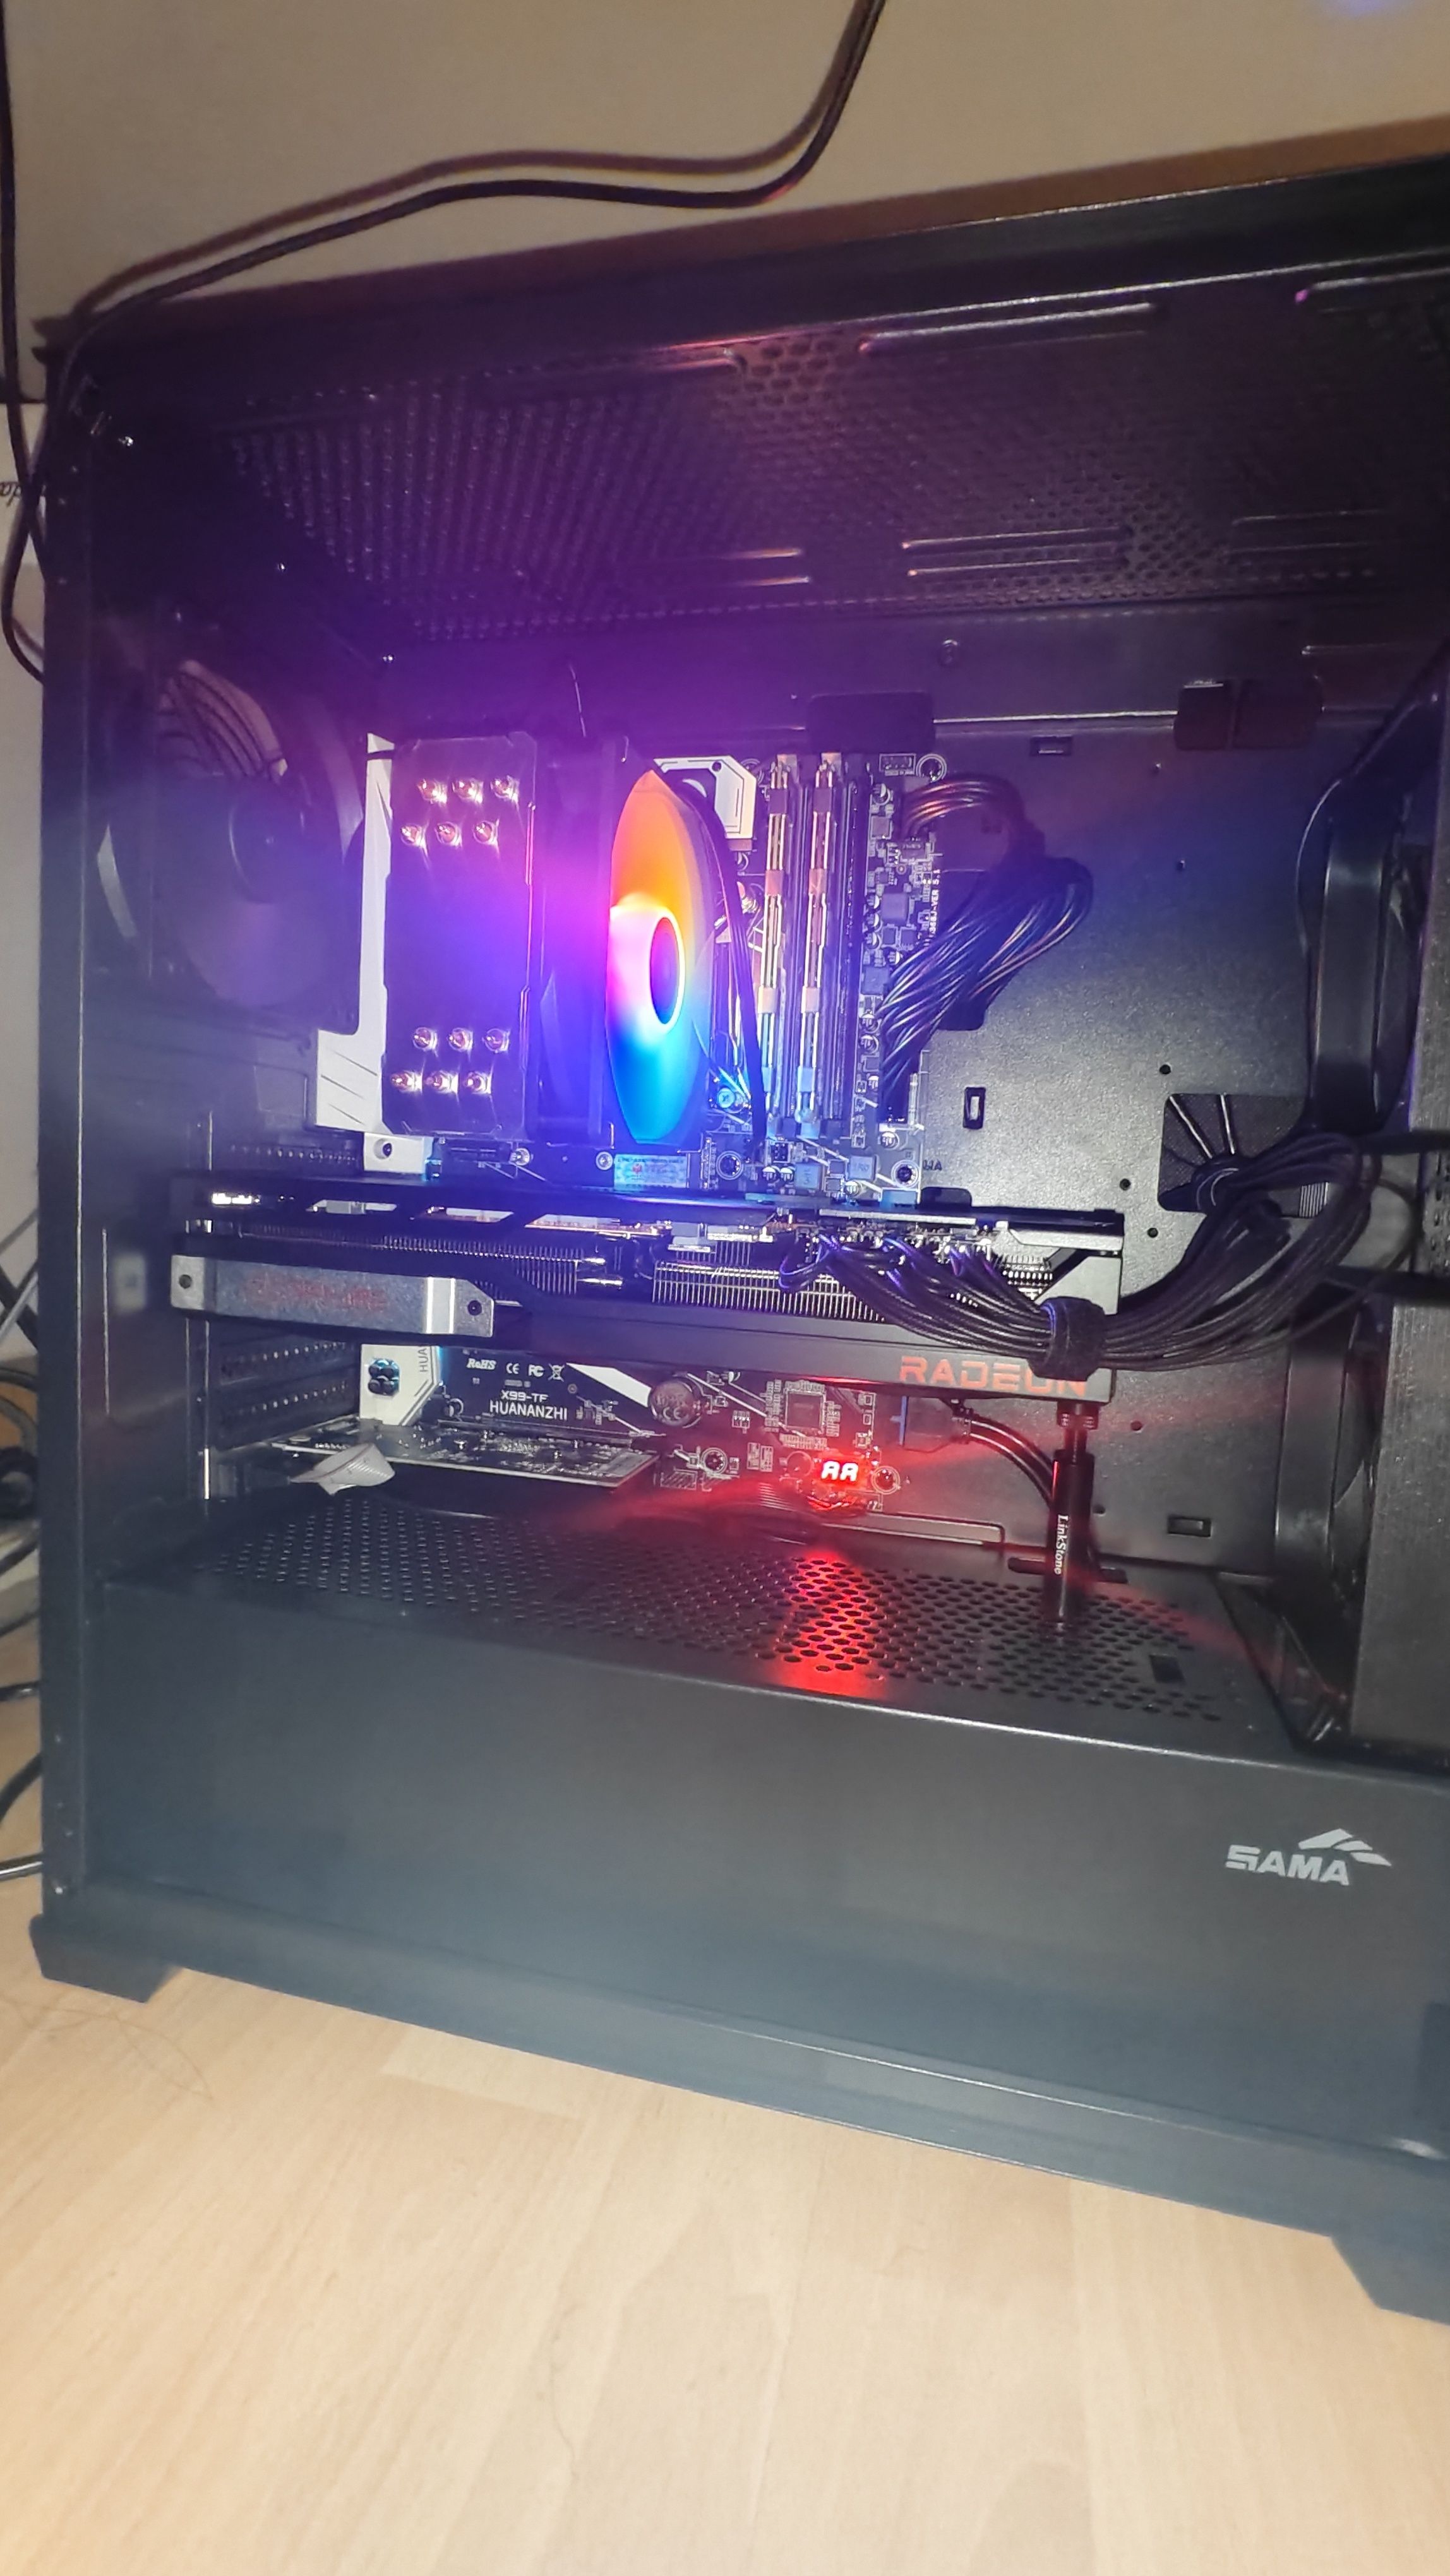
-
散热
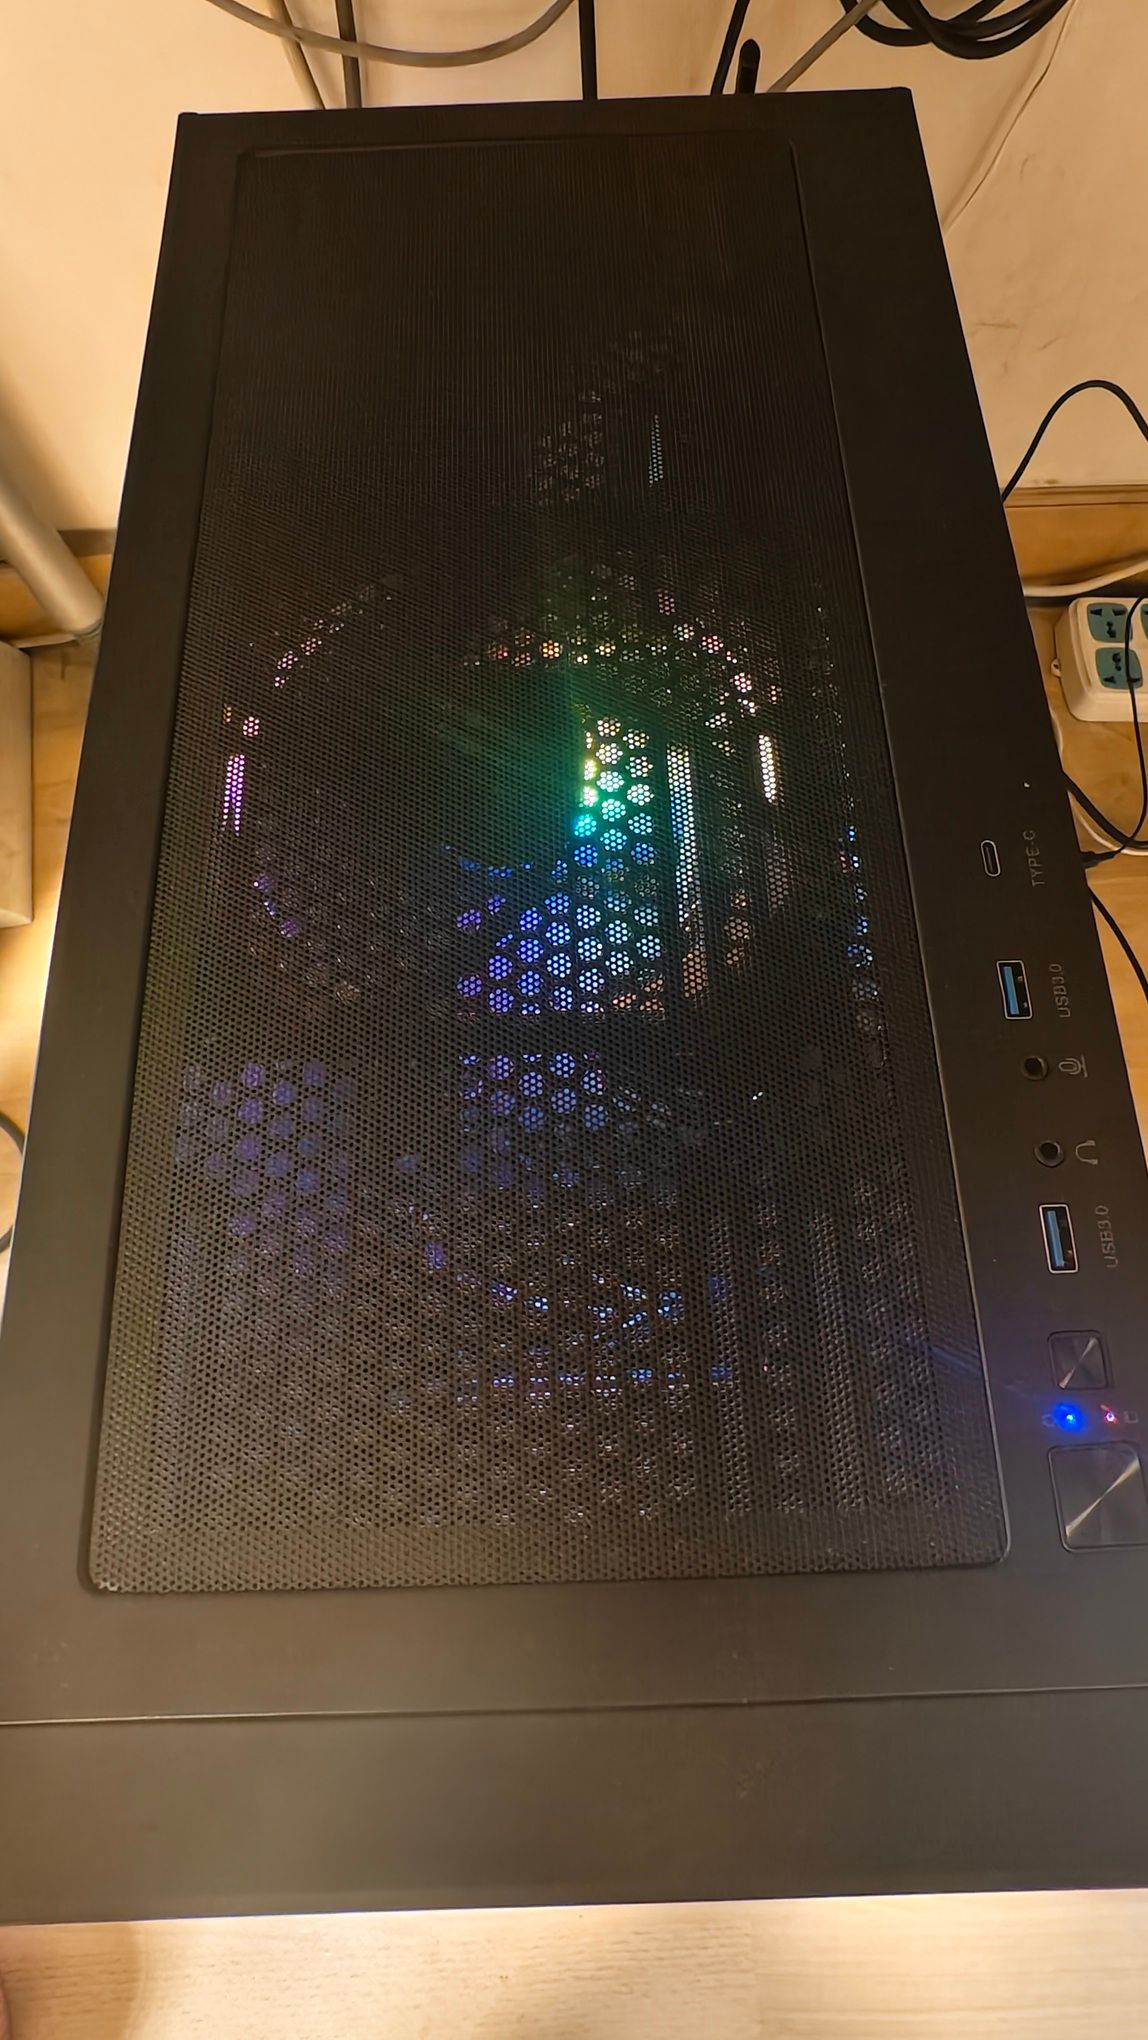
-
桌面
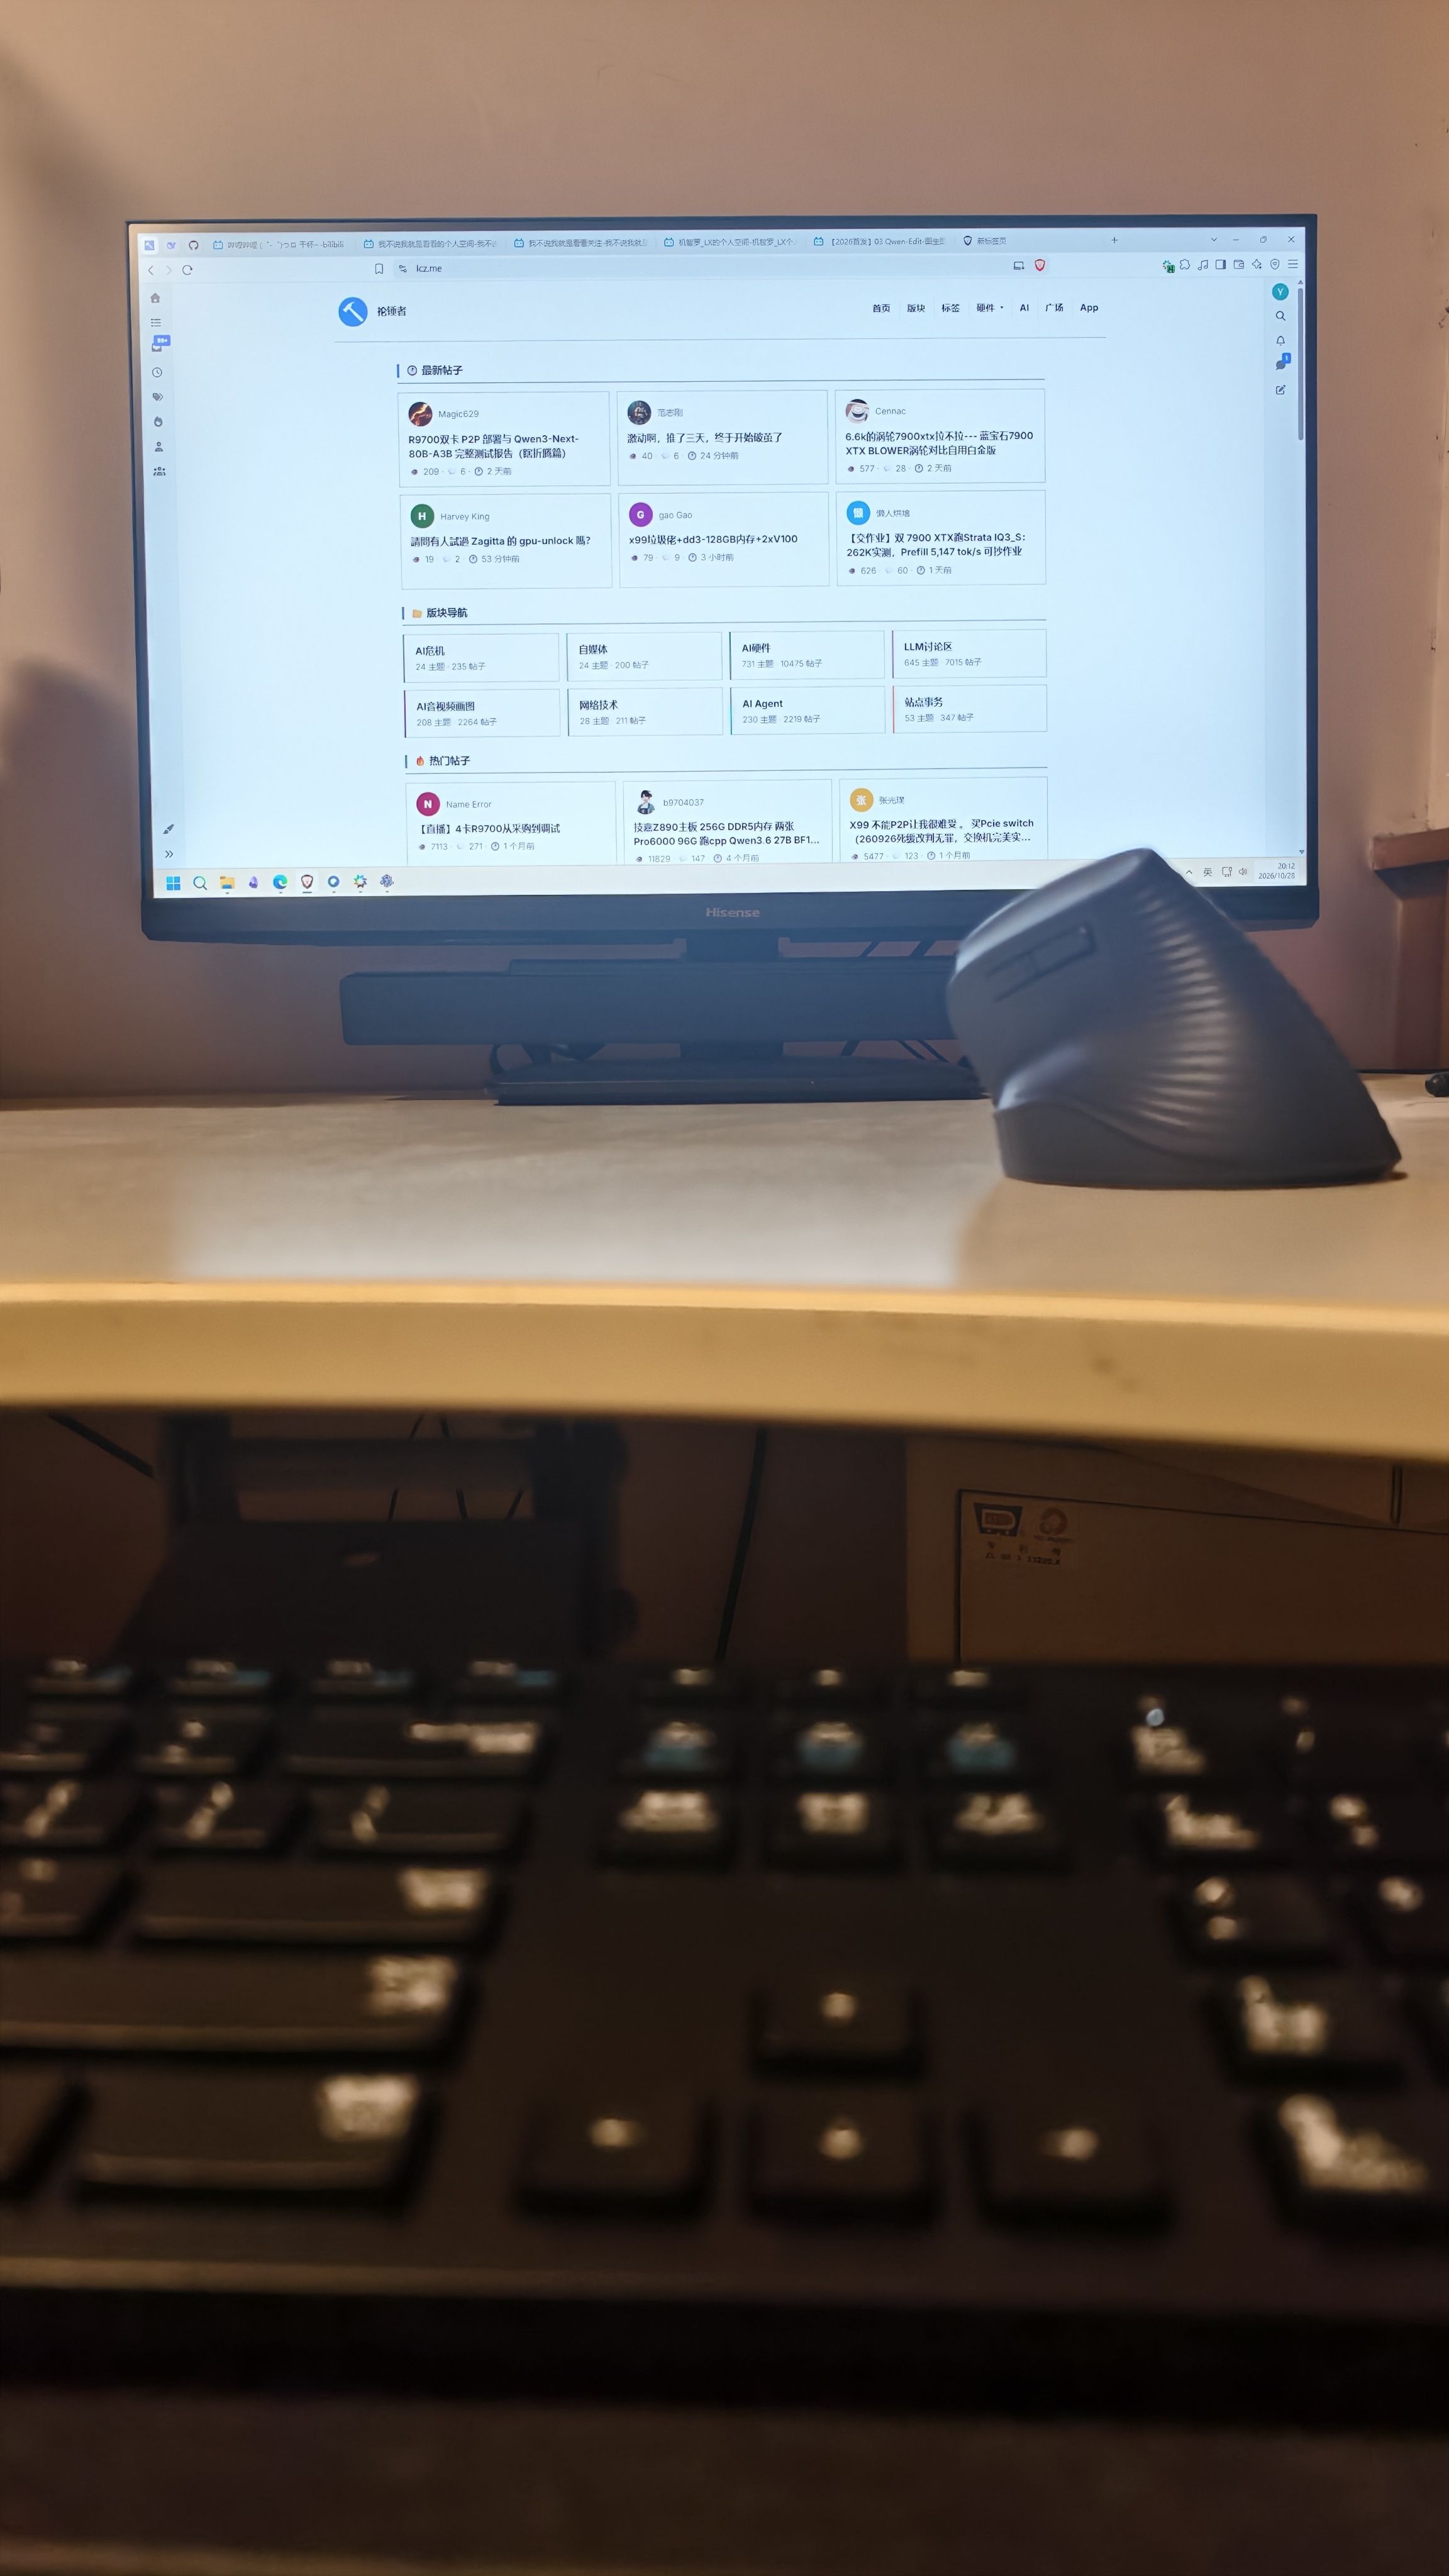
-
-
新手交作业:X99+DDR3+7900XTX 攒机和调试小结感谢老特和小特的鼓励!稍后去装备秀发个贴。
再分享一下从昨晚到现在的一点儿收获,让Hermes去分析了大家热烈讨论的 https://github.com/nicejunjie/Strata-rdna3, 并对本地 Strata+IQ3_S 的配置进行了优化和测试,结果非常满意:
指标 10-27 基线 10-29(--long) Δ chat decode(中位) 80.60 80.50 持平 chat 首 token 0.32 s 0.31 s 持平 4K prefill 1222.10 2094.00 +71% 4K 首 token 3.31 s 1.95 s −41% 16K prefill 1770.60 2804.80 +58% 16K 首 token 9.11 s 5.77 s −37% 32K prefill 1834.00 3193.60 +74% 32K 首 token 17.53 s 10.09 s −42% agent 缓存命中 68.70% 68.65% 持平 agent re-read/session 4 (4–74) 74 (2–74) 持平 agent 回合首 token 3.26 s 2.54 s −22% agent decode 89.10 87.60 −2%(噪声内) 注:以上结果是在显卡功率上限333w、电压 - 50mv的约束下测得。
基于 strata-rdna3 优化的具体做法
nicejunjie/Strata-rdna3是上游 Strata 的 gfx1100(同款 7900 XTX)调优分叉。只取它的 env 配方,不合并代码树(落后上游、合并=完整重编+PCM 补丁重打)。流程五步:- 找配方:fork 的
docs/RDNA3_SETTINGS.md给出按 pack 的 env 开关集;同时确认本地arch_default_env("gfx1100")是空的——即这些调优路径在原版上默认全 OFF,是"免费的钱"。 - 重叠审计:对每个开关先
grep本地src/+strings -a engine/strata | grep -i <switch>,确认 0.1.45 已编译进对应内核。26 个开关本地存在 → env-only 即可生效;GR_RDNA*、RDNA_MMVQ_WAVE、RDNA_Q6K等 fork-only 内核不存在 → 记为日后 port 目标(decode 侧收益在那里)。 - env-only ABBA 验证:命令行一字不动,只往配置
env注入 26 个开关,官方 bench--runs 2 --long跑 ABBA——32K +70.4%,组内方差 ≤0.4%,是真效应不是漂移。 - 组归因:拆 wmma(+24%)/pf(+9%)/dec(+5.5%)/cpu(+5%) 单独臂——单加和只有 +43% 但全量 +74%,超可加(WMMA prompt attention 要靠 pf 预填路径喂),所以不能只挑单个开关上。
- 守则:他们的命令行不能抄(
--ple-io direct、--pcie-frac 0是 RAM 紧张机器的选择,本机ram+0.20是定案);数值不再逐位可复现(PF_F16=2、SELECT_WMMA),greedy sha256 回归测试要放宽;他们 CPU 是 9950X3D2,绝对值不可比,本机实测 3028。
两次采纳修改的参数对比
两次都是纯 env 修改,args 命令行完全未动:
修改 时间/验证 env 变化 args 变化 效果 ①STRATA_ROUTE_RESIDENT 10-27,ABBA×2 逐项验 /proc/environ 新增 1 个键:STRATA_ROUTE_RESIDENT=1 无 decode +17.5%,槽位/显存/草稿接受率不变,greedy 输出逐位一致 ②RDNA3 gfx1100 env set 10-28,ABBA(bench --runs 2 --long) 新增 26 个键(见下表) 无 4K/16K/32K prefill +70/+56/+70%,decode/TTFT/命中率不变;代价:greedy 不再逐位复现 env 键的前后对照(修改前生产 env 只有 3 个键):
类别 键(=值) 状态 原有基线 STRATA_HIPBLASLT_TUNING=<table-local-100401.txt>、STRATA_HIPBLASLT_VERBOSE=1、STRATA_ARENA_THP=1 10-27 前已有 修改① 新增 STRATA_ROUTE_RESIDENT=1 10-27 采纳 修改② WMMA 组 STRATA_HIP_WMMA=1、STRATA_SELECT_WMMA=1 10-28 采纳(+24%) 修改② 预填路径组 STRATA_PF_F16=2、PF_GEMM=1、PF_FUSED=1、PF_PAD=1、PF_HCDOWN=1、PREFILL_RING=192、PREFILL_AUTO_MAX=32768、STAGER_RING=64、KV_HOST_DMA=1 10-28 采纳(+9%) 修改② decode/融合组 GPU_MAX_HW_QUEUES=6、GDN_CHUNKED/CONVL2/HEAD/NOY/PP=1、HC_UPMIX=1、HEAD_MIX_MULTI=1、PA_FAST=1、QFUSE=1、FUSE_CONVAB=1、VERIFY_QDEDUP=1、SH_STREAM=0 10-28 采纳(+5.5%) 修改② CPU 分担组 STRATA_PREFILL_CPU_SHARE=auto、PREFILL_CPU_SHARE_MAX=6144 10-28 采纳(+5%) 当前生产 env 共 30 键(3 原有 + 1 + 26),已核对
strata-iq3s-0145.json;10-29 bench 的 prefill +60~74% 正是修改②的持续效果。 - 找配方:fork 的
-
新手交作业:X99+DDR3+7900XTX 攒机和调试小结 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结@Tong-Guan
兄弟客气了,共同学习 -
新手交作业:X99+DDR3+7900XTX 攒机和调试小结没敢尝试,感觉硬件还是差了些,即便勉强跑的话,速度也不行, 目前还是用 Qwen3.8 Flash-Next 更现实一些
-
新手交作业:X99+DDR3+7900XTX 攒机和调试小结一、前言
一直想弄个本地的LLM服务器。其实没啥生产的需求,就是个人玩耍,让AI做点儿管理小程序、翻译和处理一些不便上网的文件。
10月之前想的是一套R9700+9700X+64G DDR5的平台跑Qwen3.8-27B,但看着显卡和内存的价格一路飙升,奔着3万去了,感觉非常不值得。
恰逢9月底Strata横空出世,便转换思路,决定先攒一套X99+DDR3+7900XTX的系统,以万把块钱的投入把Strata+Qwen3.8-Flash-Next跑起来,顺便尝试一下机智罗的ComfyUI整合包,作为新手单人练手也够用了。未来真要升级的话,无论是配双显卡,还是整体淘汰,到时候看需求再定,但估计很大概率是当前的配置一直用到淘汰为止了。
二、硬件配置
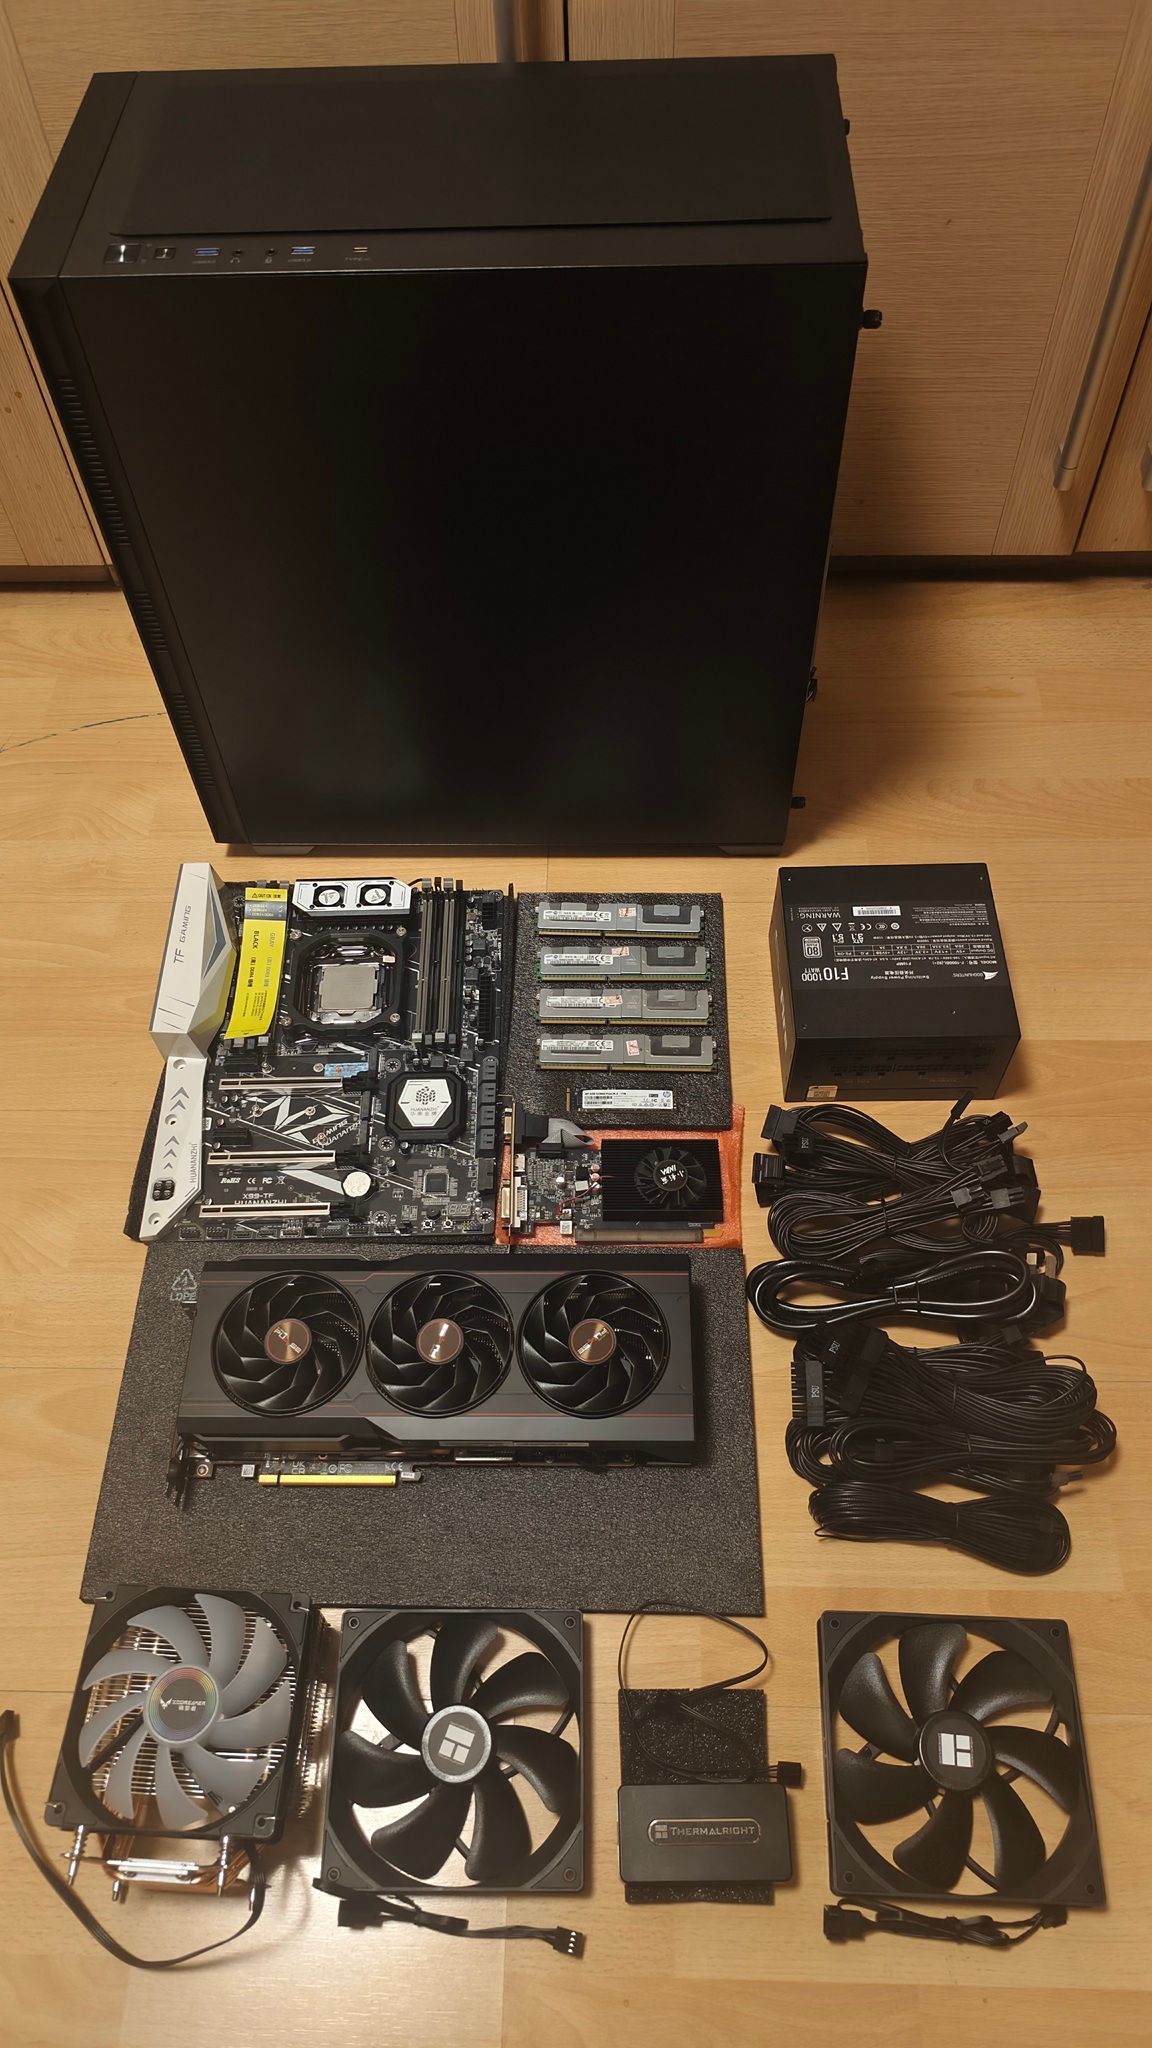
不想等双十一了,陆陆续续在10月12日前,从京东下单购买一堆散件,优惠后价格如下:
序号 品名 品牌型号与规格 价格 1 板U套装 华南金牌X99-TF + E5 2686V4 + 6铜管散热 841.55 2 内存 三星 DDR3 RECC 1600 32G x 4 拆机条 1194 3 显卡 蓝宝石 RX 7900XTX 白金版 8043.88 4 亮机卡 小影霸 R7 240 4GD3 233.06 5 SSD HP EX900plus Gen 3 1T 832.55 6 电源 长城 F10 1000W 白金牌 607.05 7 机箱 先马 黑洞PRO 222.72 8 显卡支架 联拓 铝合金 两段 磁吸 8.90 9 机箱风扇 利民 TL-C14C x 2 44 10 扩展卡 萌图 PCIe 转USB3.2 Gen2x2 20Gbps 145 11 蓝牙适配器 绿联 CM749 天线版 69.43 合计 12242.14 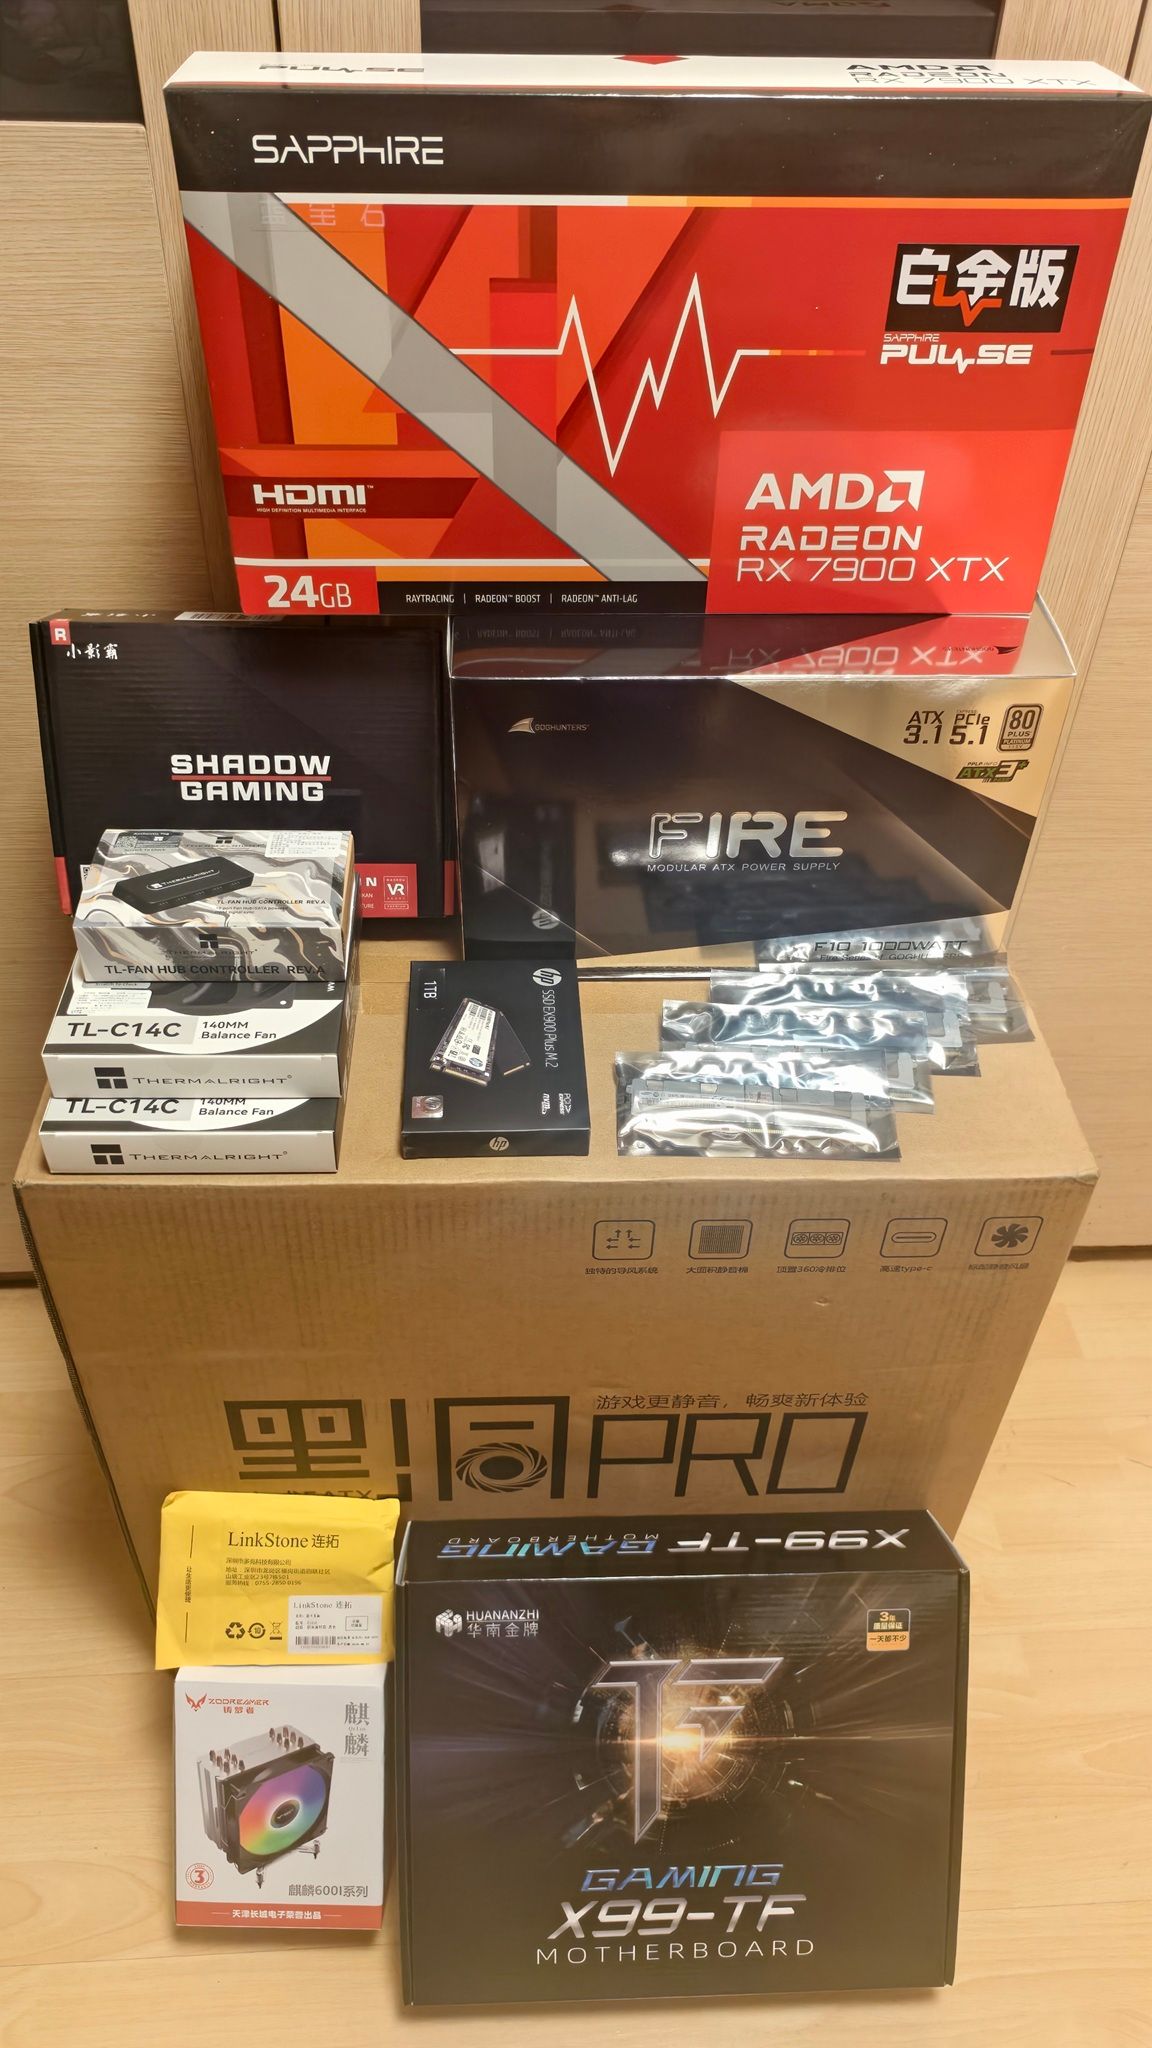
三、装机经验与教训
1. 板+U和内存的匹配
板+U选的是华南金牌的X99-TF+E5 2686V4。主板的官方资料宣称既支持DDR3,又支持DDR4,但不能混插,且每种规格最大128G。买之前让千问和deepseek分别评估了一下配置,都预警说2686V4只支持DDR4,不支持DDR3,建议换成2666V3。但店家客服回复说搭配DDR3 128G没问题,为避免分别购买板U出现问题不好处理,仍下了单,但做好万一不行就换CPU的心理准备。
到货组装后,一次点亮,板、U和内存均能正常工作,至少在这块主板上,2686V4支持128G DDR3没问题。可见,AI 的说法只能供参考,但并不一定完全正确。
但内存遇到点儿意外。店家是京东的一个销量较大的拍拍二手店,价格相对较低,但不是最低。开始是想买三星 DDR3 1866 的条子,但该店只剩2条了,且短期内不会补货。只好下单4根1600的条子,再三要求说一定要同品牌同颗粒的,店家也答应了,但到货测试时发现,3根是1600的,一根是1866的,但都能在1600下工作,也就不折腾了。BIOS中把内存频率设为1600,理论上4通道的带宽51.2G,在ubuntu下实测约42G。
这个板子也能支持DDR4,最大容量也是128g。按当前实际测试Strata+Qwen3.8-Flash-Next_IQ3_S的数据来看,DDR3 128G 表现不错,实测数据并未比DDR4 差很多,主要是价格便宜太多了。
2. 显卡的选择
9月份看 R9700 的时候,价格是10999-11999,但9月底突然涨价到 13999-14999,现在更是报出17999的价格,实在离谱,这个价格已经比两张7900xtx都贵了。
24G显存想跑27B的模型,确实有点儿小,不适合长上下文。但是,如果用Strata 跑 Flash-Next的长上下文,则没啥问题,对速度也没太大的影响,完全可以接受。
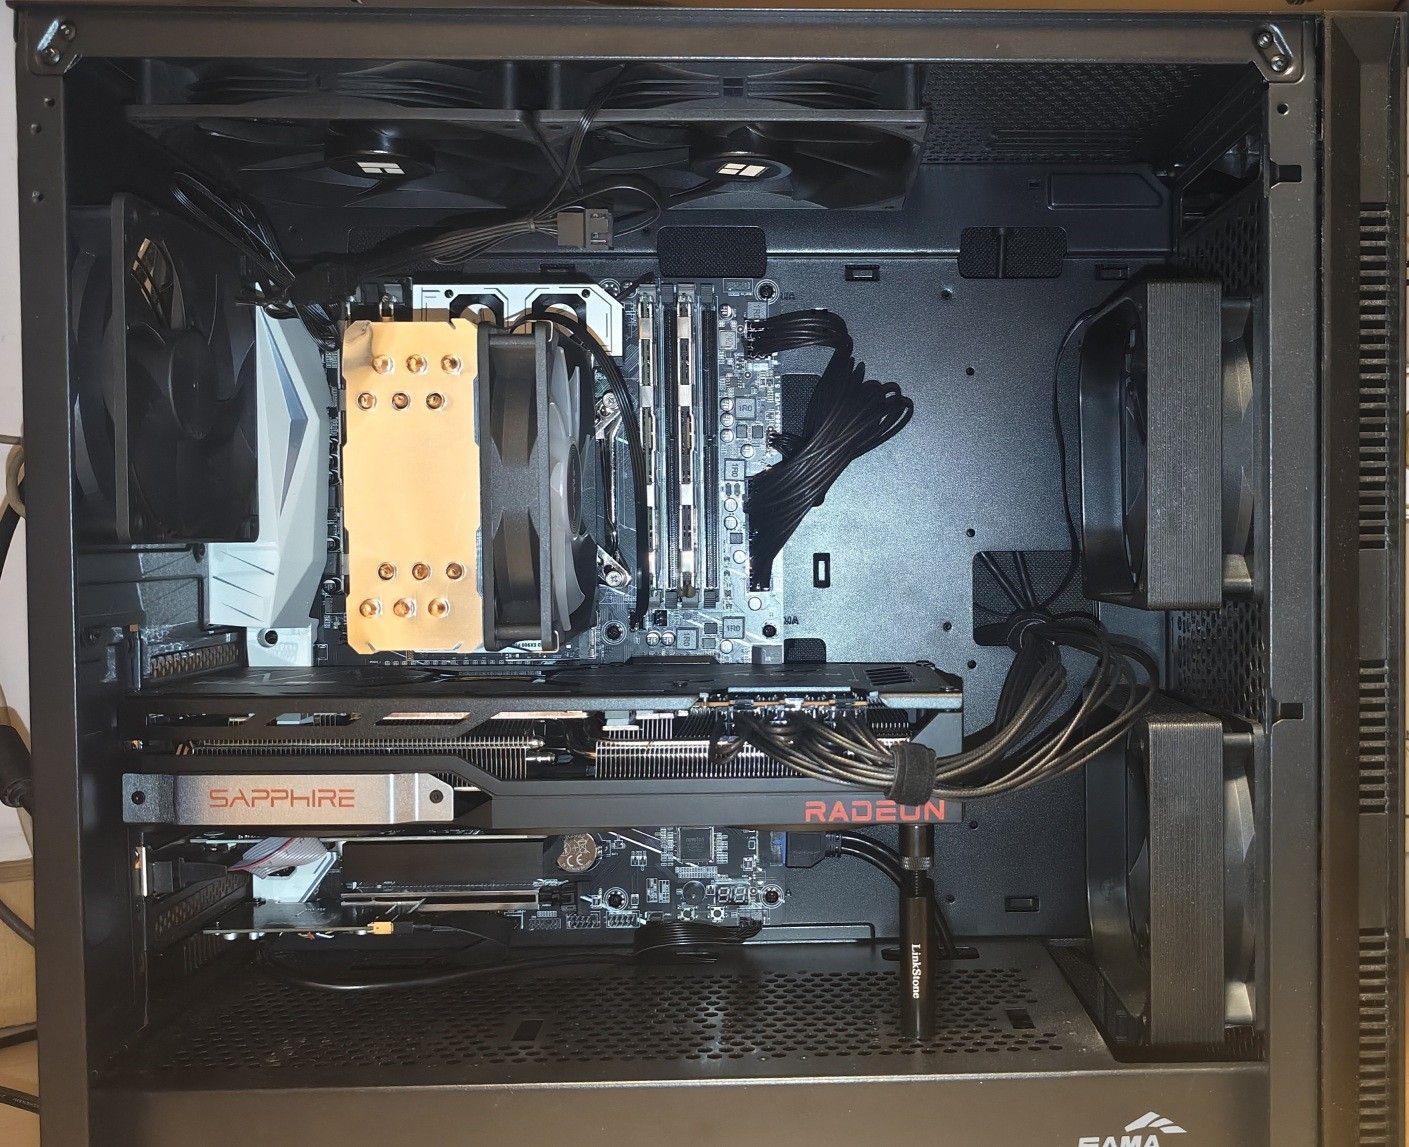
此外,参考坛友的经验和建议,配了一张亮机卡。个人认为还是很有必要的,可以让7900xtx的显存多放点儿专家。在现有主板(bios 版本5.11)上,该卡未遇到其他坛友提及的黑屏等事宜,可以正常点亮。而且三个插槽都试过,都能亮屏。当然这块亮机卡也有自己的问题:一是增加了系统复杂性,一些软件需要设置正确的显卡;二是这个卡的驱动太老了,AMD已不再更新,edge和brave等浏览器都要关闭GPU加速,否则容易出现向下翻页时GPU调用崩溃而闪屏。
顺便说一句:华南官网上有该主板6.0版本的BIOS,但它提供的刷机软件不能在win11 x64环境下运行,懒得再弄win pe之类的启动盘了,再加上目前没碰到什么问题,就不升级了。
目前三个PCIe 3.0的插槽分配是:
- 槽1(x16,靠近CPU的):7900xtx;
- 槽2(x16,中间的):R7 240;
- 槽3(x4,最下边的):PCIe 转 USB 3.2 Gen2 Tpye-E 转接卡,接机箱前面板的Type-C插口。
3. SSD的容量
该主板接口规格比较老,两个 M.2 NVME 接口一个是PCIe 3.0的(靠近CPU的),一个是2.0的(显卡下面的),这个说明书没明确说哪个是3.0的,装错了一次,挺坑的。
在这套配置中,没必要选太新型号的SSD,瓶颈是主板。如果想windows+ubuntu双系统,还要玩ComfyUI,1T的容量确实有点小,2T的价格又有点儿偏高。可能需要在2.0的口上插个500G-1T的作为仓库盘,或者配合NAS或其他移动SSD之类的来用存储暂时不用的文件。这也是配了一个USB 3.2 Gen2x2 20Gbps的转接卡的由头。
4. 机箱的教训
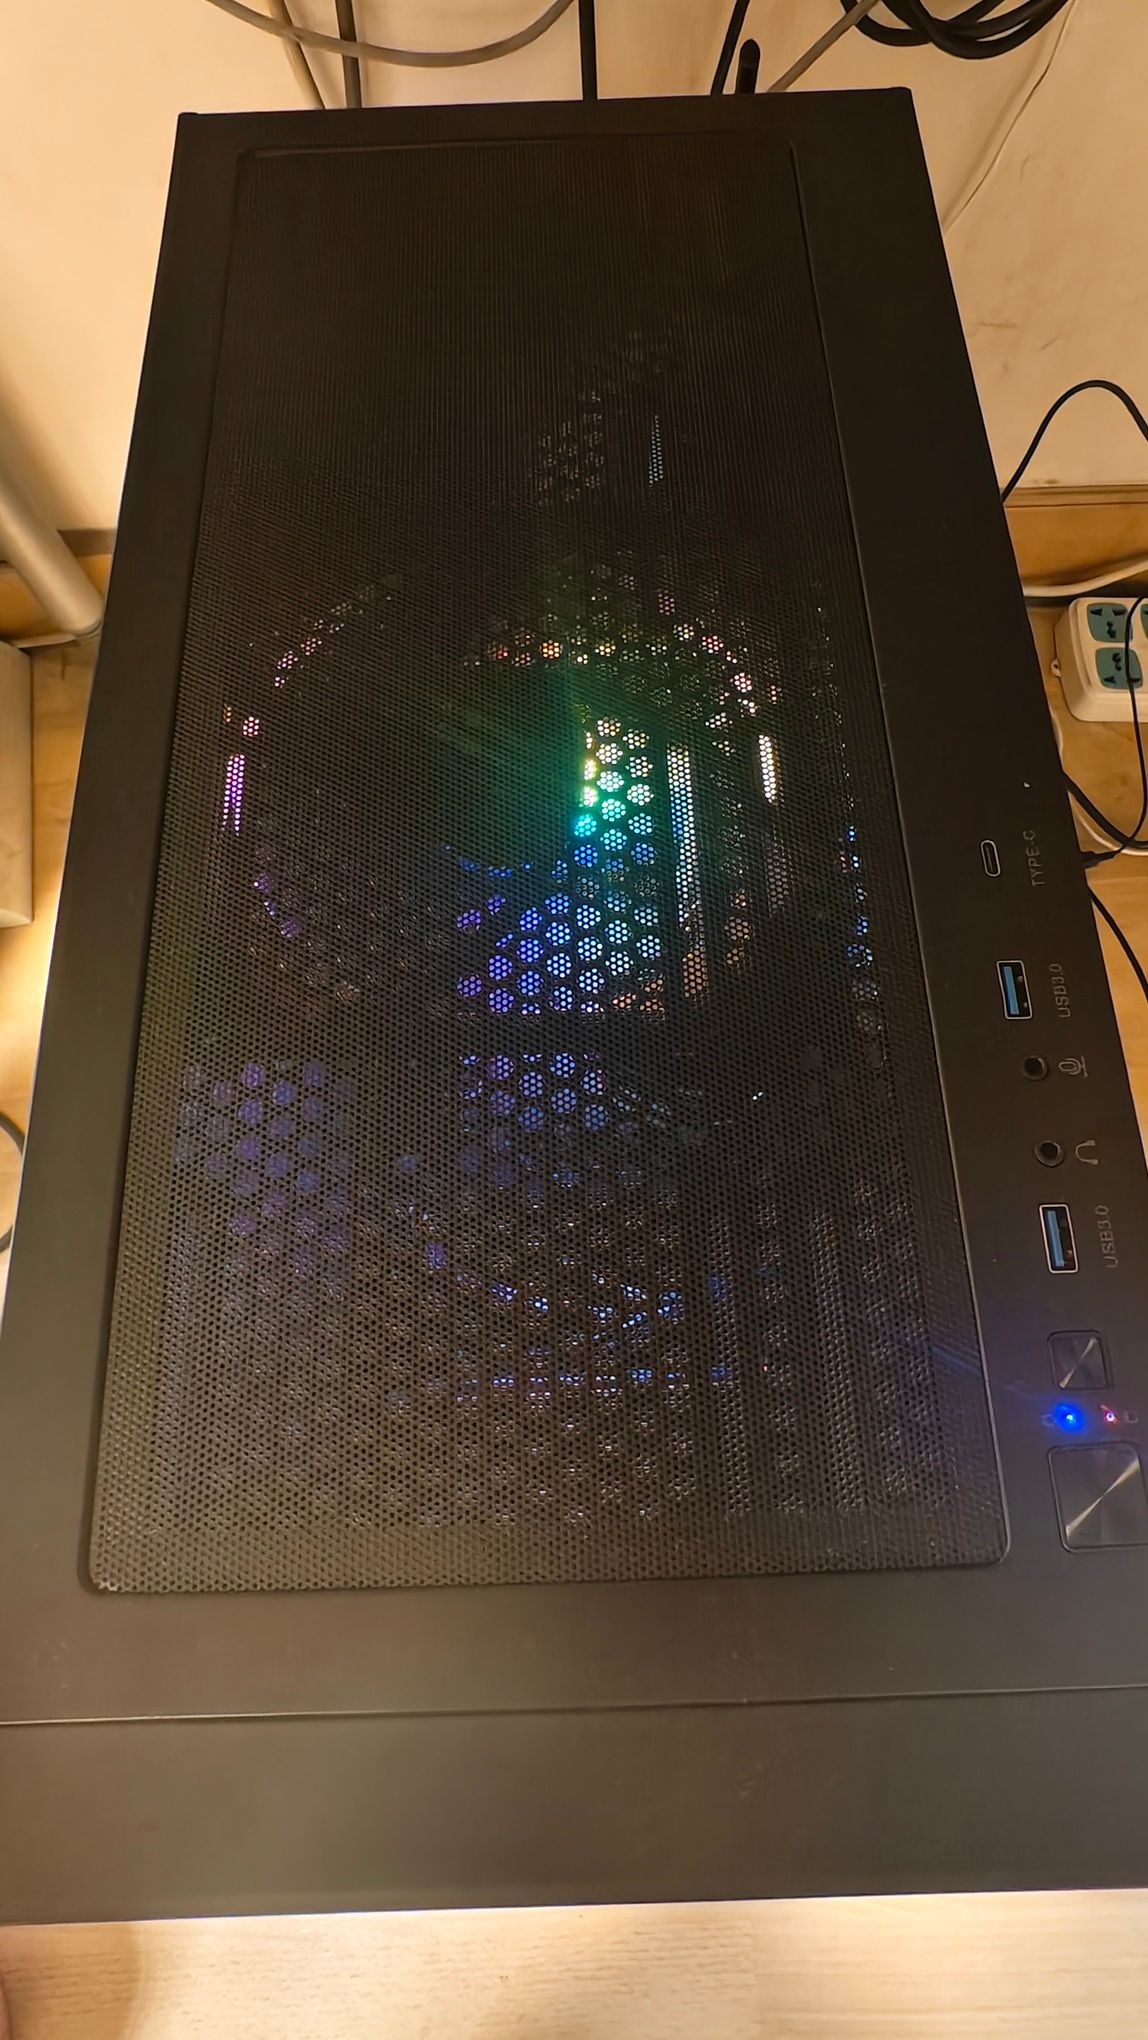
之前听说显卡满负荷时噪声较大,于是选了一个带静音棉的机箱。现在看这个选择很有问题:显卡高负荷运行时,风扇噪声并不算大,但温度很高。静音机箱确实真静音,但机箱上盖板很热,散热很差。幸好这个机箱的上盖板是磁吸的,还提供了一个透气网。现在把机箱的上盖板收起来了,只用透气网,再加上两个风扇,散热没问题了,但静音就不存在了 。早知如此,还不如买个更便宜的全透气的机箱呢,算是小白的教训吧。
5. 机箱风扇
这个机箱自带前后3个14cm的风扇,顶部可装2个14cm或3个12cm的风扇。于是买了两个利民的14cm的风扇,都是4pin的插线。
但是,主板设计有问题:SYSFan的插座都是3针的,不支持DC调速。CPUFan的插座倒是有两个,而且都是4pin的,但厂家技术人员回复说,只有CPUFan 1是支持调速的。这个有点儿坑。期间买过利民的10口风扇集线器,发现用不上,退货了。反而板上有好多A-RGB的灯效接口,但对我没用。
6. 显卡支架
这个机箱在PCIe插槽的螺钉处设计了一个压板,与7900XTX自带的支架冲突,于是买了一个可调高度的磁吸支架。这个与显卡安装位置有关,如果7900XTX插在中间的槽上,几乎贴在电源区的隔板上,不但盖住了主板的PCIe 3.0 x 4的槽,而且也没有安装支架的空间了。
四、运行Strata的情况
1. 模型的选择
目前选定的是Qwen3.8-Flash-Next-IQ3_S,也曾测试过UD Q4_K_XL,让DeepSeek Harness出了八道测试AI能力的题,结果是没什么差别,但Q4_K_XL消耗的资源更多,速度也慢。
2. Windows 11下的表现
在Windows 11专业版中,由于驱动的关系,Strata能跑起来,但显存的利用不如Ubuntu,只能加载8000左右的专家,无论prefill 还是 decode ,都比Ubuntu下慢很多。印象里长上下文的prefill最高800-1000 t/s,decode 大约 60-70 t/s。此外,Strata的监控界面大量的参数取不到,看着很不爽。于是卸载,彻底转向Ubuntu。
3. Ubuntu 24.04.5 LTS 下的表现
对Ubuntu不熟,安装完系统后,基本都是让 Hermes 帮忙进行Strata的安装和配置,以及测速和调优。最初的版本是0.1.44,后升级至0.1.45并保持至今,每次Strata发布新版后,都让Hermes 去分析一下是否值得升级,但每次返回的结论都是没必要,因为新的改动基本都与7900XTX关系不大。
在128K上下文、显卡保留500M余量、功率帽分别限定为303W(默认)/ 272W(下限) / 288W(折中)的情况下,用Strata自带的bench测试情况如下:
指标 272W 288W 303W chat decode 63.5 61.5 61.1 agent decode 84.6 82.2 83.0 4K prefill (TTFT) 1181 (3.43s) 1187 (3.41s) 1185 (3.42s) 16K prefill (TTFT) 1674 (9.63s) 1706 (9.45s) 1728 (9.34s) 32K prefill (TTFT) 1683 (19.10s) 1732 (18.56s) 1755 (18.31s) agent 缓存命中 68.7% 68.6% 68.8% 对此Hermes的判读:
- prefill 16K/32K 呈单调上升,4K 已在噪声内,数字很稳(三次重复测量的波动 <1%):272 → 288 → 303 分别是 32K 1683 / 1732 / 1755,即 288W 拿到 303W 增益的约 2/3。
- decode 在 288/303 都差不多(61 上下),272 略高但在已知的 ±10 tok/s 前缀缓存噪声内。
- 综合看 288W 是合理折中:保住长上下文 TTFT 大部分收益(32K 比 272 快 2.9%),decode 不亏,温度更低。
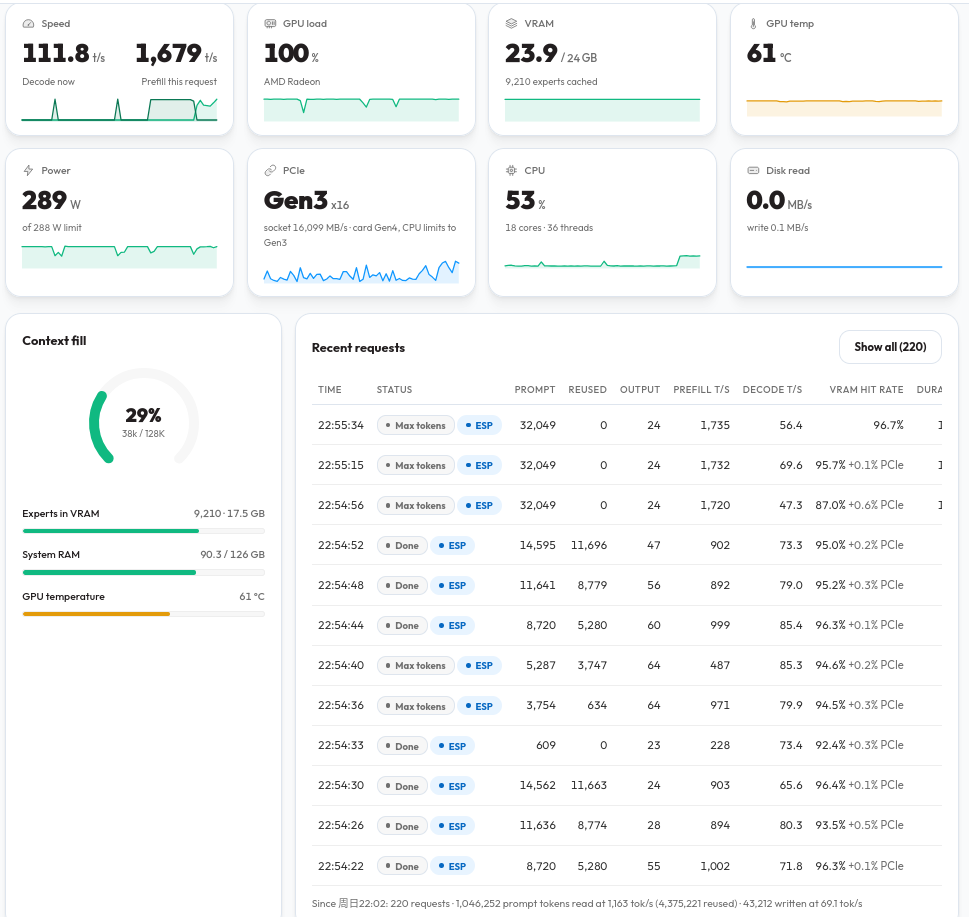
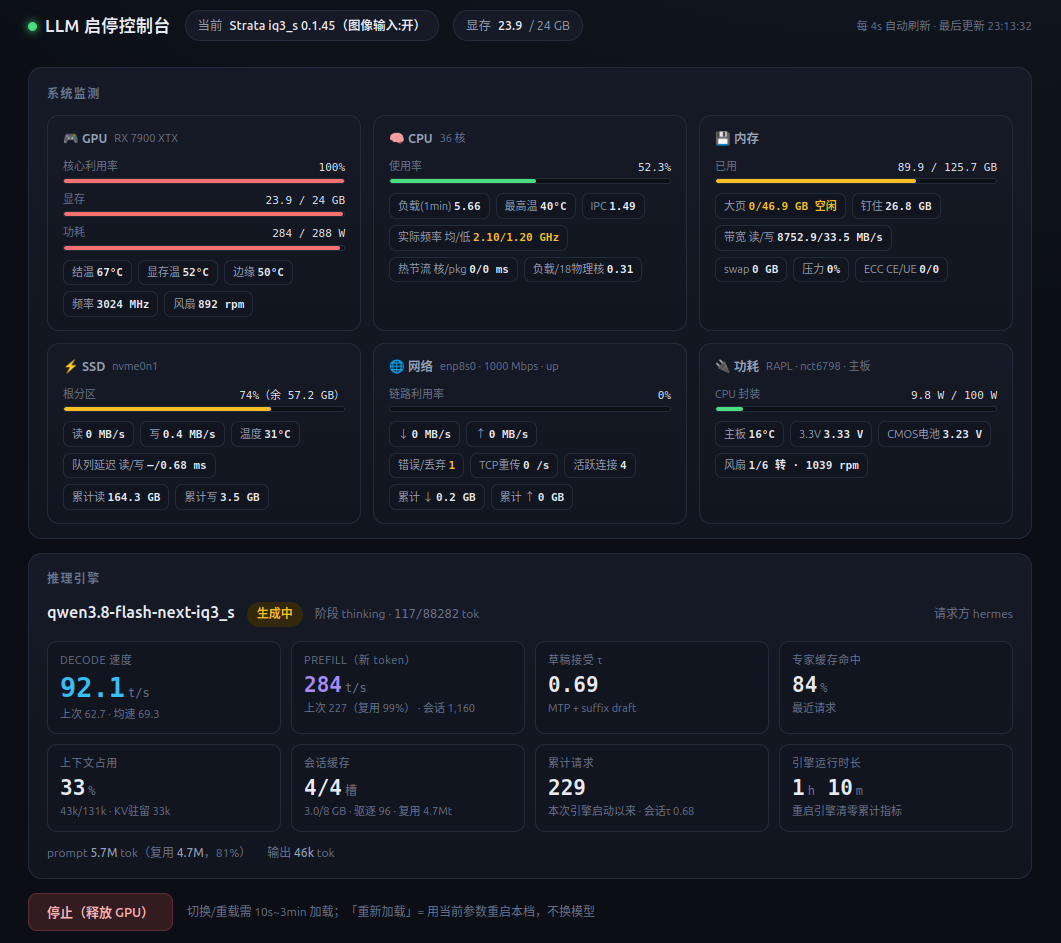
原版的Strata Monitor界面是读不到X99-TF主板的PCIe 的状态的,让 Hermes 接入本地的 Strata+IQ3_S 模型修了一下,同时另做了一个系统监测和模型加载参数调节的页面,与Strata Monitor界面互为补充。
五、运行机智罗ComfyUI整合包的情况
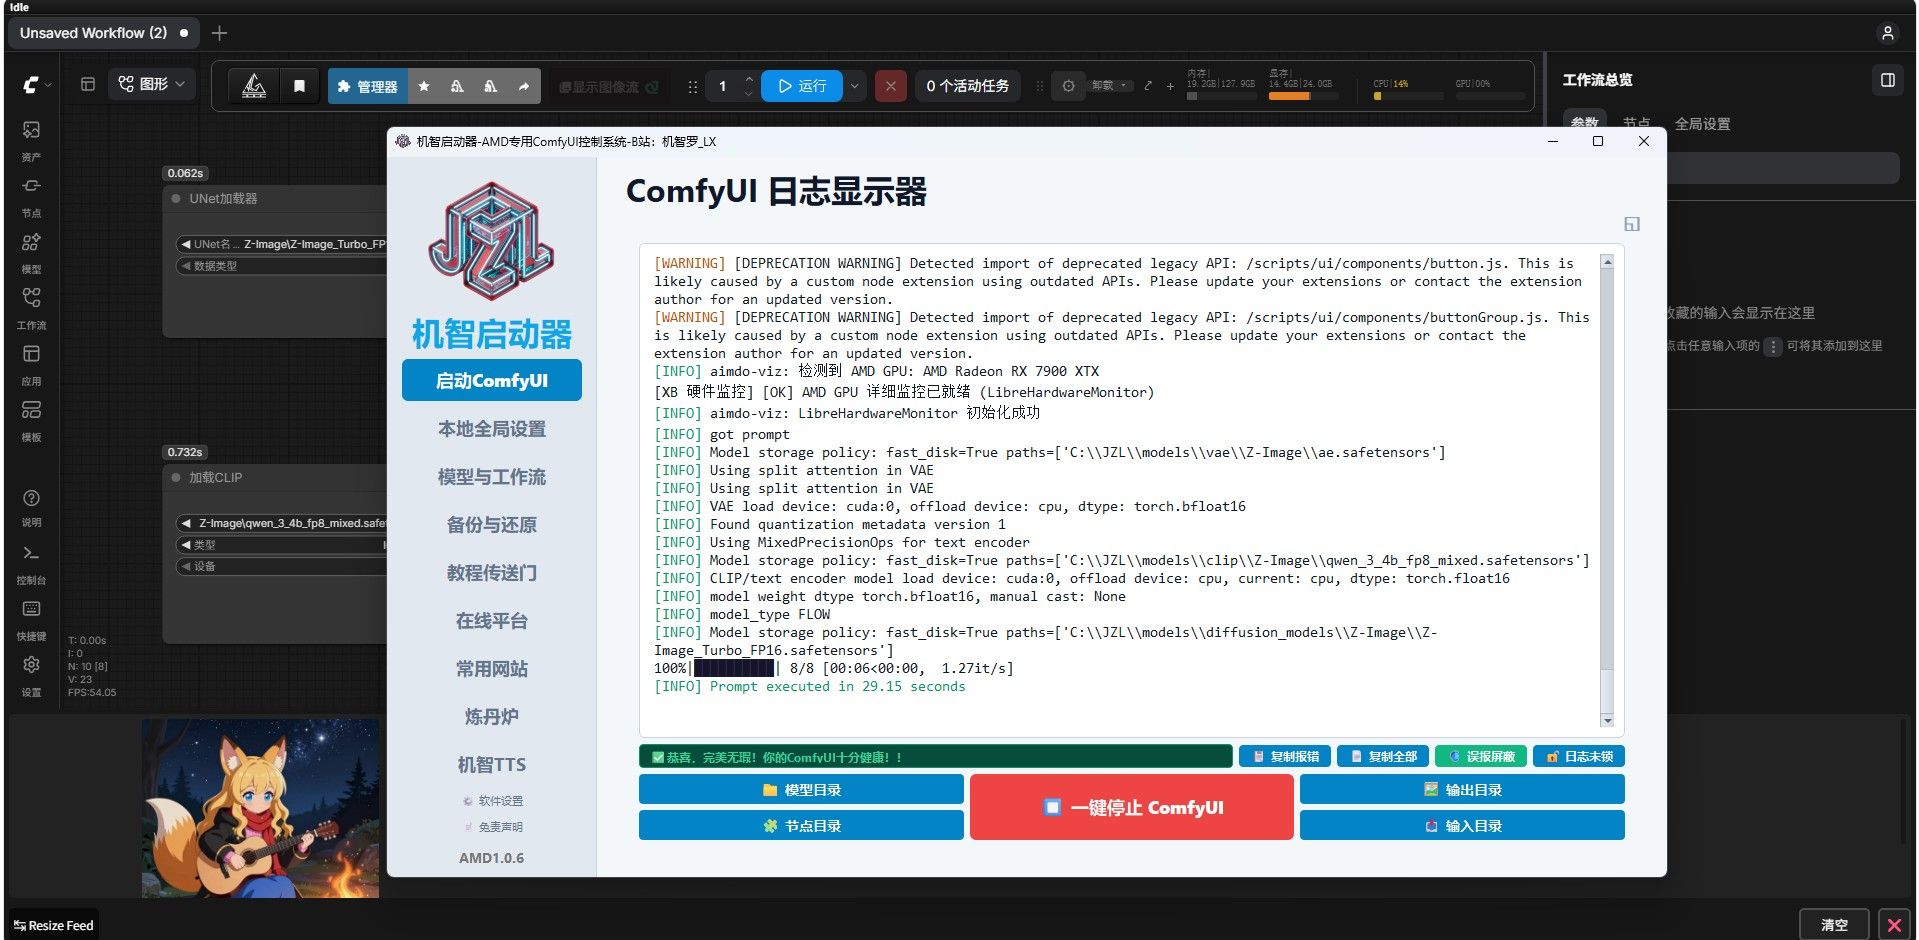
下载了机智罗整合的ComfyUI整合包 V7,这个就是纯小白新试水了,安装和运行倒是简单,如有报警或错误,就把启动日志丢给AI,它会帮你分析脚本中的bug并修正。
目前整合包的各工作流能跑了,但接下来需要补课的东西太多了,也算活到老学到了吧。
六、结语
一分钱一分货,自己的心态要摆正。既然选了洋垃圾,就别期望太高,能跑能用就挺好,目前没啥不满意的。
-
DDR3 1866HZ RECC拆机条32G单条不到300,搭配X99洋垃圾4通道主板完全能带得动高端显卡,硬件大涨价行情下的性价比之选,双11冲一波!哈哈,一周多前也从京东上攒了一套华南金牌x99 tf + e5 2686v4 + 三星 ddr3 recc 1600 32G x 4 + 7900xtx的机子,总计12000元。
本来想买1866的,但那个卖家只有2条了,于是换成1600的了,这几天一直在调试strata + qwen3.8-flash-next-iq3_s, 90k上下文下,prefill最高冲到1600多 t/s, decode平均70多 t/s。
目前看,四通道ubuntu 24.04.5下实测41~42G带宽,足够用。而且这块主板很有意思,ddr3和ddr4的内存槽各4个,但不能混插。现在用的是ddr3, 如果哪天ddr4成白菜价了,换一下条子和插槽就行。
-
老旧的 4060 8G 显卡的笔记本用 LM Studio 跑 MoE 模型的加载参数测试手头有一台2024年1月的华硕天选5 pro笔记本,硬件的主要配置如下:
- CPU:intel i9-13980HX
- 显卡:4060 8G
- 内存:32G DDR5
本着废物利用的原则,也想折腾一下,处理一些不方便上网或受限制的简单任务。经过认真拜读和学习本坛各位大神的帖子后,调试了几天,现在基本上能凑合着用了,总结分享如下:
1. 运行环境
- windows 11 专业版
- LM Studio 0.4.25
- runtime:CUDA llama.cpp (Windows) 2.44.0 和 2.66.0
平时主用windows,不想装双系统,试过wsl+ubuntu+llama.cpp,但性能损耗比较大,prefill和decode的表现不如直接用LM Studio。
此外,LM Studio查询和下载模型非常方便,如果不是追求极致性能的话,LM Studio也挺好的。
2. 模型选择
8G显存就不要想Qwen 3.8-27B之类的了,基本上吐字比打字机还慢。
只能考虑MoE类型的,比如Qwen3.6-35B-A3B系列、Gemma4-26B-A4B系列和Ornith-1.5-35B-A3B系列等。
至于4B、9B、12B的小模型,只能陪你聊天,如果想用于智能体调用,只能说看你想做什么了。
目前感觉Ornith-1.5-35B-A3B系列的综合表现比较符合我的要求,所以重点基于该系列模型进行了测试。其中:
- 原版:ornith-ai/Ornith-1.5-35B-A3B-GGUF · Hugging Face
- huihui版(mradermacher 量化) :mradermacher/Huihui-Ornith-1.5-35B-A3B-abliterated-GGUF · Hugging Face
- SC117版:SC117/Ornith-1.5-35B-A3B-Heretic-MTP-APEX-GGUF · Hugging Face
总体来讲,上述各模型的prefill和decode的速度表现相差不大,主要看自己的用途和喜好。
3. 参数配置
贫穷的硬件条件有限,无法将全部内容都加载到显存中,因此,哪些放显存、哪些放内存?是追求速度还是要安静稳定?要不要处理图像?难以兼顾的情况下,这就是个人的选择了。
(1)在LM Studio加载模型时应优先要满足的参数
-
Context Length (对应llama.cpp的 --ctx-size / -c)
如果想满足智能体调用,上下文长度至少32K,而64K相对稳妥些。实测结果32K时decode可以达到40 t/s 上下,64K时可达36 t/s 左右。
16K不是绝对不行,但经常会超限。而超过64K,对显存的需求和推理速度的影响比较大,需要取舍的内容就更多了。
极端一点儿,不加载mmproj、把所有的MoE都放在内存、把上下文开到256K,也一样能跑,无非是prefill和decode慢一些。
-
GPU Offload (对应llama.cpp的 --n-gpu-layers / -ngl)
一定要拉满,全部放入GPU。
-
Evaluation Batch Size 和 Physical Batch Size(对应llama.cpp的 --batch-size / -b 和 --ubatch-size / -ub)
这两个参数对prefill的影响非常大,太大或太小,都影响处理效率。经过对各种组合的实测,在 eval=16384 / phys=4096 时,prefill 速度可维持在900 - 1100 t/s 左右。
但是,这两个数值越大,消耗的显存越多。建议 phys 不要低于2048,eval ≥ phys,最好 eval 是 phys 的 2 - 4 倍。具体表现以在自己的机器上实测数据为准。
个人认为优先满足prefill的速度更重要,值得多分配一些显存。但太高也没必要,一是性价比不值得;二是本身显存就小,需要斤斤计较。
-
Offload KV Cache to GPU Memory (对应llama.cpp的 --no-kv-offload / -nkvo)
这个一定要开,对decode的速度影响很大。放在显存中比放在内存中差不多要快一倍。
需要注意的是:LM Studio中的设置和llama.cpp的参数所代表的含义恰好是相反的!在LM Studio的参数一定设置为开,意味着在llmam.cpp的参数一定不要加。
-
FlashAttention (对应llama.cpp的 --flash-attn / -fa)
一定要开,否则下面的 K/V cache 量化类型没法设置。
-
K Cache Quantization Type 和 V Cache Quantization Type (对应llama.cpp的 --cache-type-k / -ctk 和 --cache-type-v / -ctv)
都设置成 Q8_0 ,没毛病。由Q8_0改Q4_0,省下的显存不一定能多装一层MoE,但反而带来精度等问题,不太划算。
(2)在LM Studio加载模型时可以进行个性化选择的参数
-
Number of layers for which to force MoE weights onto CPU (对应llama.cpp的 --n-cpu-moe)
这个参数对于decode的速度有影响。原则应该是尽量让更多的MoE层留在显存,但通常最多也就保留10层左右,更多的还是要放在内存中。
对于Ornith系列 Q4_K_M 的模型,通常每个MoE层约占显存400~500M,每多保留一层在显存,可能会对decode速度提升1-2%。
尽管这个参数对decode的速度很重要,但也没必要太在意,毕竟硬件条件有限,只有大幅度改变该数值时,才会有明显感受,否则可能都比不过噪声或抖动。
-
mmproj的加载 (对应llama.cpp的 --mmproj )
对于mmproj文件,LM Studio默认是自动加载的,只要模型的文件夹里有与模型文件主名相同的mmproj文件。通常如果一个模型支持vision,则在LM Studio中下载时,相应的mmproj文件会自动随gguf文件下载到本地同一个文件夹中。
如果需要让智能体识别图像,当然要加载 mmproj 文件。但mmproj文件也算要占显存的,比如Ornith-1.5-35B-A3B系列模型BF16格式的mmproj文件大约880M左右,如果只是处理纯文本,不加载它则有可能在显存里多放两层MoE层,有利于提升decode的速度。
如何才能不让LM Studio自动加载呢?之前很多网传做法是移除mmproj文件或改名,这样比较麻烦。也有说法是在model.yaml增加设置 metadataOverrides: vision: false 来禁止加载mmproj,但实测无效。
在新版的LM Studio中,在模型加载页面的下面增加了 Ilama.cpp Arquments Override 的开关,只要开启这个选项,然后取消 --mmproj 的勾选即可。以后如果需要vision功能,再关闭这个开关或勾选 --mmproj即可,操作简便。
-
MTP (对应llama.cpp的 --spec-type draft-mtp)
这个不好一概而论。开启MTP是要占大量显存的,而且每次推断都要调用MoE进行计算,这都是要消耗系统资源的。而关闭MTP的话,则有可能争取多留MoE层在显存。两者经常是根据实际情况一起调整,以确保剩余的显存不被撑爆。
根据本机的实测结果,开启MTP并设Max draft tokens=1是值得的,尤其长上下文。但Max draft tokens设为2以上时,draft 越长,验证步要读的专家量越大,投机收益被吃掉,不一定划算。
具体哪种情况好,可自行测试。
-
CPU Thread Pool Size (对应llama.cpp的 --threads / -t)
要看具体的硬件情况。本机是8个大核+16个小核,通常设 8 即可。有一种说法是大小核混用时会被小核拖慢整体速度。试过一次 t=12,decode速度大概慢了5 - 8%。但未作更多测试。
-
Max Concurrent Predictions (对应llama.cpp的 --parallel)
单机个人使用的话,设为1,省显存,省一点是一点。
4. 小结
(1)运行结果
-
ctx=65536 prefill 汇总
模型:huihui-ornith-1.5-35b-a3b-abliterated(Q4_K_M),ngl=999999、KV q8_0 在 GPU、batch 16384/4096、th=8、增强电源模式。每格为单轮实测值(t/s)。
表 A:64K prefill 吞吐(t/s),按 MTP 档与 ncmoe 排列
序号 MTP ncmoe GPU 专家层 @3276 @13107 @26214 1 关 33 7 1026.7 1082.2 1101.3 2 关 35 5 1084.7 1066.5 1042.7 3 1 36 4 944.1 985.8 1022.8 4 1 38 2 867.4 931.8 943.6 5 1 39 1 881.2 931.4 929.9 注:"GPU 专家层"按运行时
--n-cpu-moe N反算,可用层数 40(blk.40 为 MTP 草稿层,MTP 关闭时不加载); MTP 开启时草稿层是否计入该口径需另行说明 ,否则同一 ncmoe 会差 1 层。读数:prefill 随 GPU 专家层数增加而 整体 变好,但只有最大档 @26214 严格单调;最小档 @3276 噪声较大(ncmoe 35 的 1084.7 反而高于 ncmoe 33 的 1026.7),不要按单点排序解读。5 行里 MTP=1 组的 prefill 整体偏低,原因是它们把更多专家层留在了 CPU,而非 MTP 本身拖慢 prefill。
-
ctx=65536 decode 汇总
同一批 5 轮的 decode 结果。“@26214 上下文” 指先把 26150 个 token 灌入 KV 后再解码,是跨参数组最稳的锚点档。
表 B:64K decode 吞吐(t/s)与 MTP 接受率
序号 MTP ncmoe GPU 专家层 @128 @512 @1024 @26214 上下文 接受率 1 关 33 7 36.3 37.4 38.2 31.9 — 2 关 35 5 36.6 36.0 36.6 31.6 — 3 1 36 4 38.9 38.1 36.7 36.4 0.65–0.83 4 1 38 2 42.3 39.7 38.5 36.1 0.72–0.88 5 1 39 1 39.4 38.8 37.1 32.9 0.65–0.79 读数:MTP=1 的长上下文 decode(36.1–36.4)明显高于 MTP 关闭(31.6–31.9);MTP=1 组内部短档差异(38.9 / 42.3 / 39.4)落在 ±10% 噪声内,不要按 ncmoe 排序解读。
-
MTP 效应:最接近的单变量配对
64K 档案里唯一“只差 1 层专家落位”的 MTP 配对是 ncmoe=35(MTP 关) 与 ncmoe=36(MTP=1)。两轮相隔约 2.4 小时,机器处于相近热态。
表 C:ncmoe 35 → 36(MTP 关 → MTP=1)的逐档变化
指标档位(上下文) MTP 关(ncmoe 35) MTP=1(ncmoe 36) Δ prefill@3276 1084.7 944.1 ↓ −13.0% prefill@13107 1066.5 985.8 ↓ −7.6% prefill@26214 1042.7 1022.8 ↓ −1.9% decode@128 36.6 38.9 ↑ +6.2% decode@512 36.0 38.1 ↑ +5.8% decode@1024 36.6 36.7 ↑ +0.4% decode@26214 31.6 36.4 ↑ +15.2% 读数:ncmoe 从 35 加到 36 意味着少放 1 层专家到 GPU,单这一项就会让 decode 略微变慢。因此 MTP=1 的真实收益不低于表 C 中的 Δ。反之,prefill 的下降与 ncmoe 单调关系一致,主要不是 MTP 造成的。(注意:prefill@3276 的 −13.0% 远大于 prefill@26214 的 −1.9%,单层专家落位解释不了这个幅度,最小档的批处理效率与噪声占主导,该行不宜当作"ncmoe 影响 prefill"的量化依据。)
(2) 需注意的事项
-
噪声、散热和稳定性
当前系统下,CPU和内存是瓶颈,因为有大量的内容在内存中,需要CPU疯狂运算,温度直冲95度高烧不退。而GPU温度和显存的使用率则很低,明显是在等CPU侧的结果。
由此的问题就是,如果采用增强模式,确实速度快一些,但噪声和散热都是问题,担心CPU扛不住。
因此,当前采取是限制CPU和GPU温度和功率的手动模式,损失了约15-20%的性能,宁可慢一些,能长时间运行就好。
-
显存的剩余空间
原则上显存至少要剩余500-600M空间,否则很容易爆掉。而且,最好是用nvidia-smi来查看,windows的性能管理器中显示的GPU数值不一定准,很多时候偏小。
-
电源模式的影响
不插原配的交流电源而改用 USB Type-C 供电时,哪怕电源 140W 也无法激活增强模式,某一次的实测数据表明 decode 约低 22.5%。
但此时系统负荷也没那么大,CPU温度也相对低些,未尝不是好事。
-
Limit Model Offload to Dedicated GPU Memory
新版LM Studio的设置->Hardware中,有个选项“Limit Model Offload to Dedicated GPU Memory”。如果显存不够,希望按自己的心意调整MoE在显存和内存的分配时,该选项建议要关闭,否则它可能会强行更改你在加载界面上设置的参数,以确保显存的安全。这个很隐蔽,如果你不注意看加载时的log文字,不注意计算内存和显存的变化,很可能被蒙过去。
(注:本人仅仅是个瞎折腾的业余爱好者,上面的一些观点、说法都不一定对,仅供参考。希望抛砖引玉,能让垃圾显卡发挥更大的作用。)
-
3W 预算玩qwen3.8-27b + 生图生视频,双R9700有没有搞头?踩坑实录