
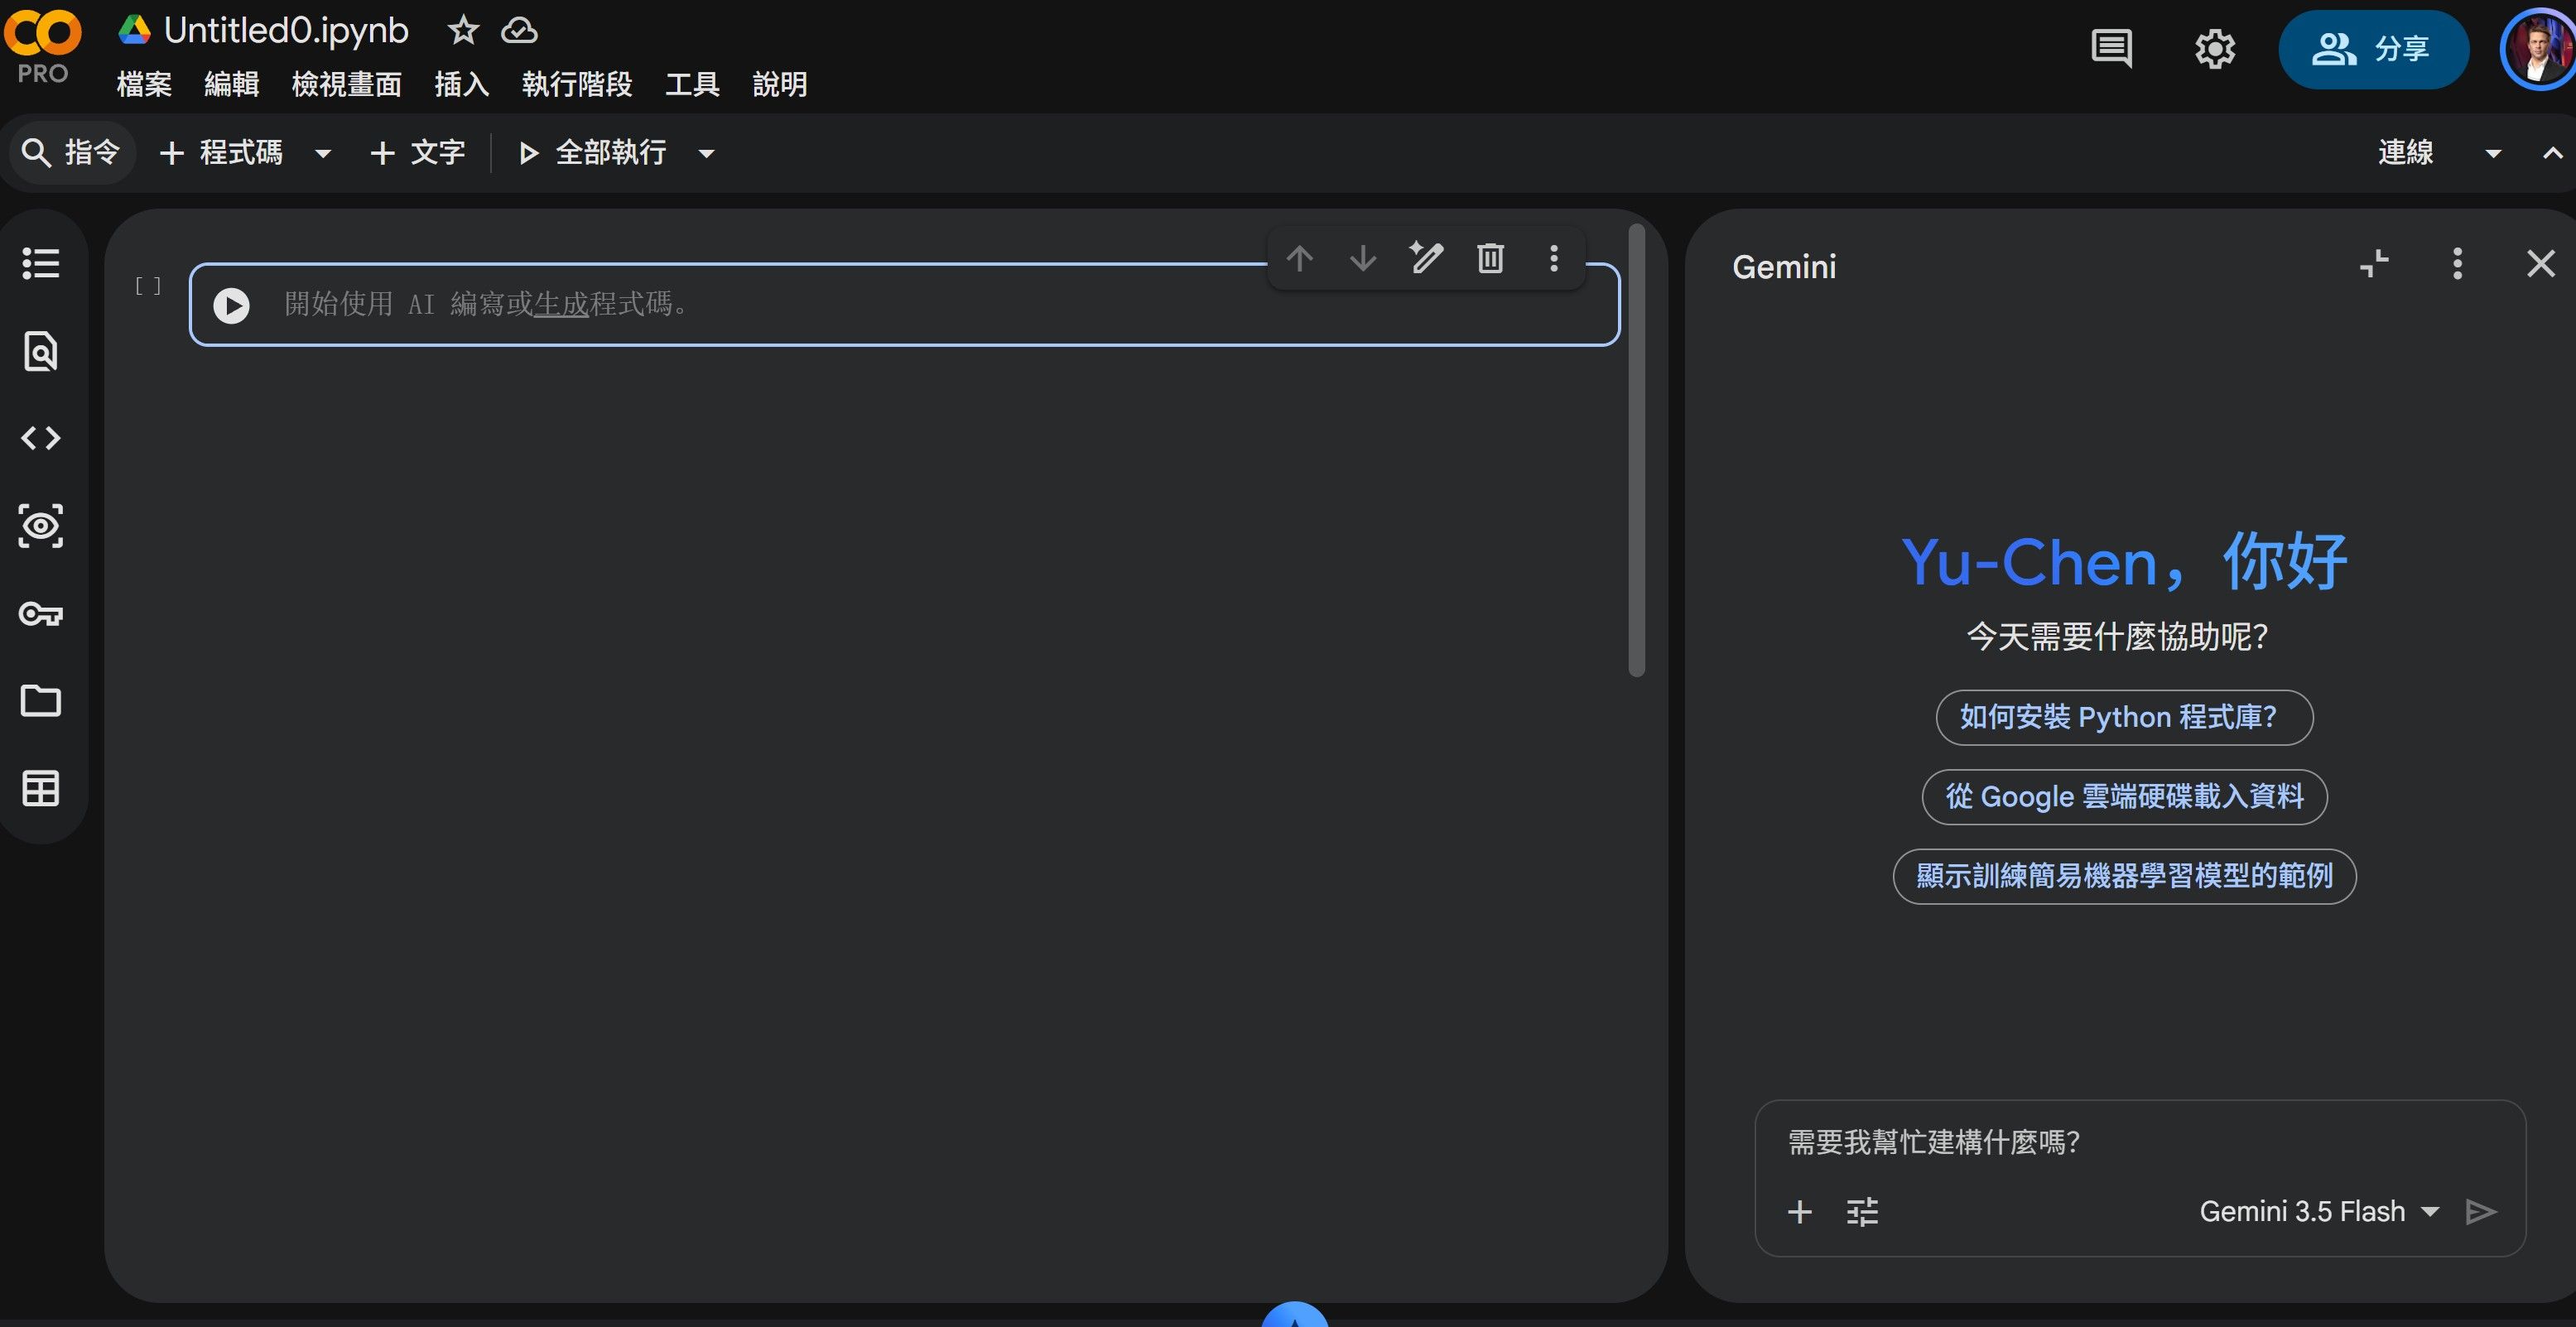
@benson-Playben 我讓Gemini幫我寫的,就一行呀!
!python /content/drive/MyDrive/ComfyUI/start_comfyui.py
首先,登入後,在這個網站https://colab.research.google.com/,啟動新筆記本,再來就全部交給AI了。
@benson-Playben 我讓Gemini幫我寫的,就一行呀!
!python /content/drive/MyDrive/ComfyUI/start_comfyui.py
首先,登入後,在這個網站https://colab.research.google.com/,啟動新筆記本,再來就全部交給AI了。
我訂閲的是Google AI Pro套餐,原來是爲了使用NotebookLM和Workspace,最近發現這個套餐有每個月200的Compute uint的額度.
可以在Colab上使用Google的GPU伺服器.立刻就利用這個伺服器創建了我的Comfy UI學習環境.
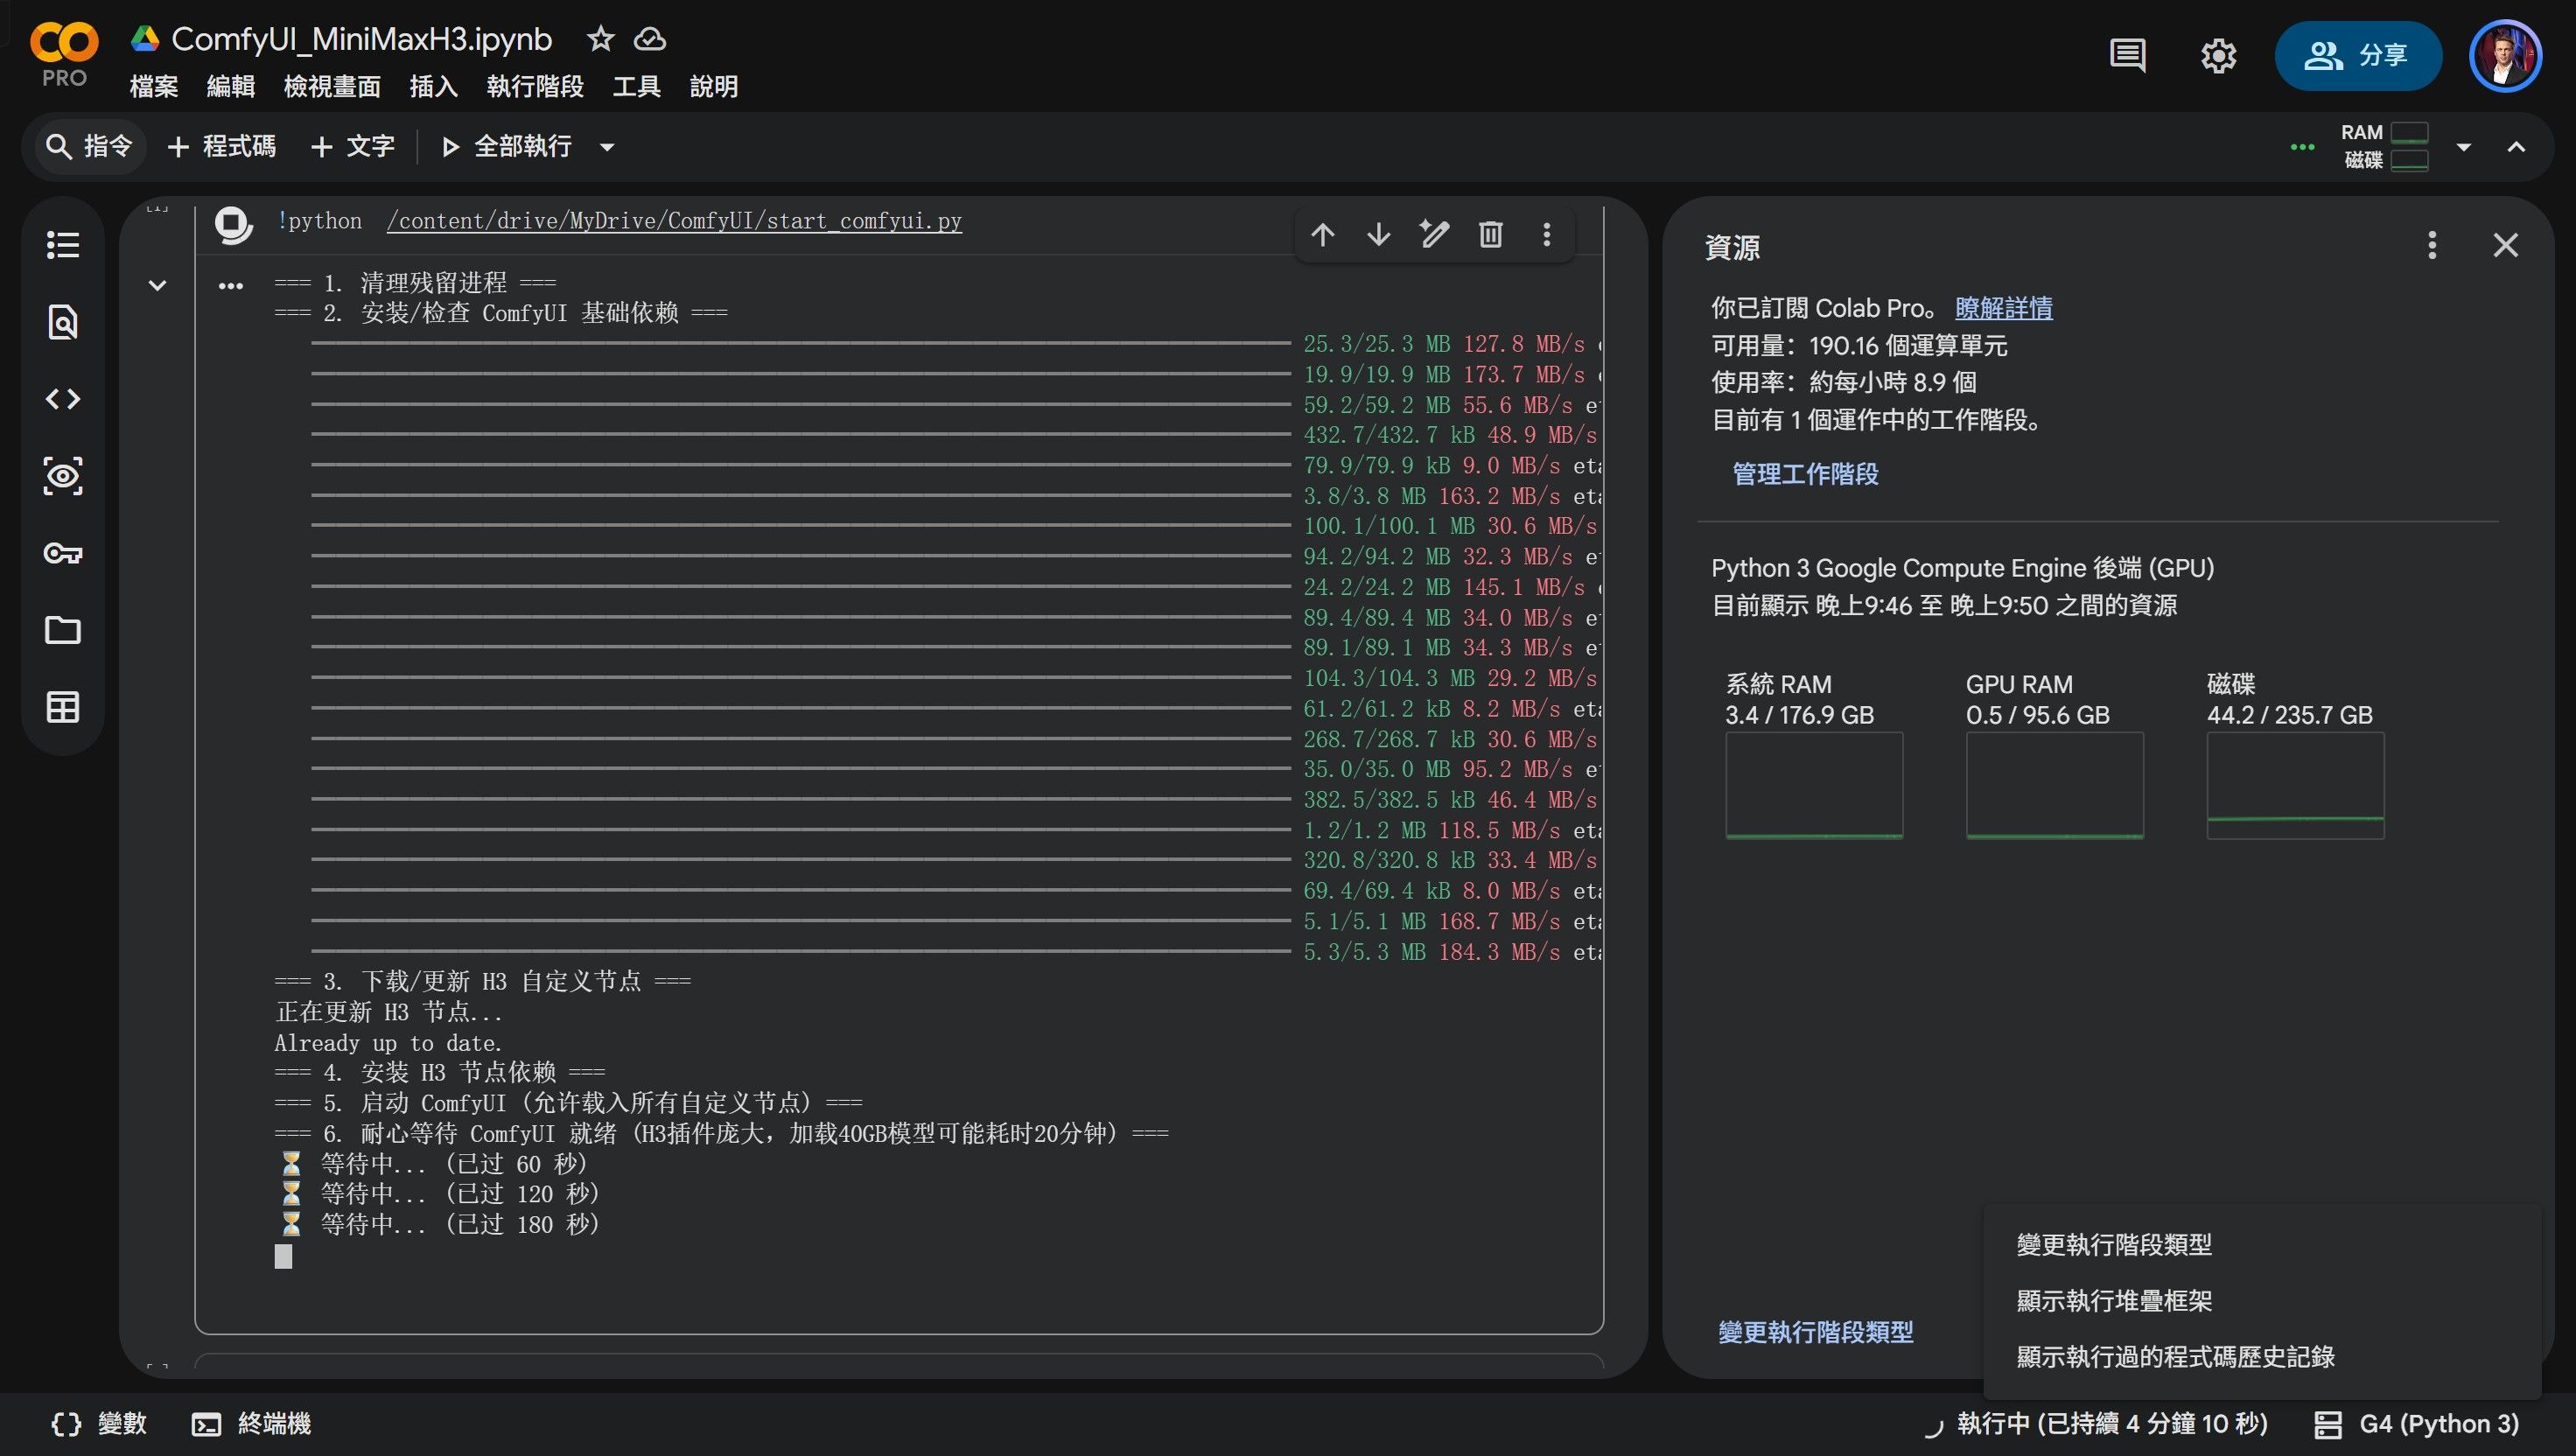
177G RAM + Blackwell 98GB VRAM玩起來還是很過癮的。
使用Colab唯一的問題就是Comfy UI放在Google drive裏,加載比較花時間
@johnnybegood 大概是我主要把AI Agent來當成助理群來使用。我個人的感覺是想只使用一個模型來幹活是不切實際又浪費錢的。未來Agent幹活的方式會很像我們現在人類在運行的工廠,不是流水線就是細胞線。只有把自己的工作流轉化成流水線式的管理,才會是又有效率又省錢的方法。 我現在的Hermes就是基於這樣的方式設計,有線長,有不同工位的普工,有調機器的技術工,最重要的是有品檢員。 整個管理有員工手冊,SOP,品質驗收標準,目前這個系統執行的穩定度好到我現在都可以輕鬆對線長下工單,事情都可以順利完成。
說實在的,我這種把AI當助理在使用的人,無法理解Jev可以做什麼?
就算是掛機打網遊,以前的狀態機外掛就夠實用了,更別提Jev沒有視覺和語言功能,難道現在使用AI刷寶是顯學?
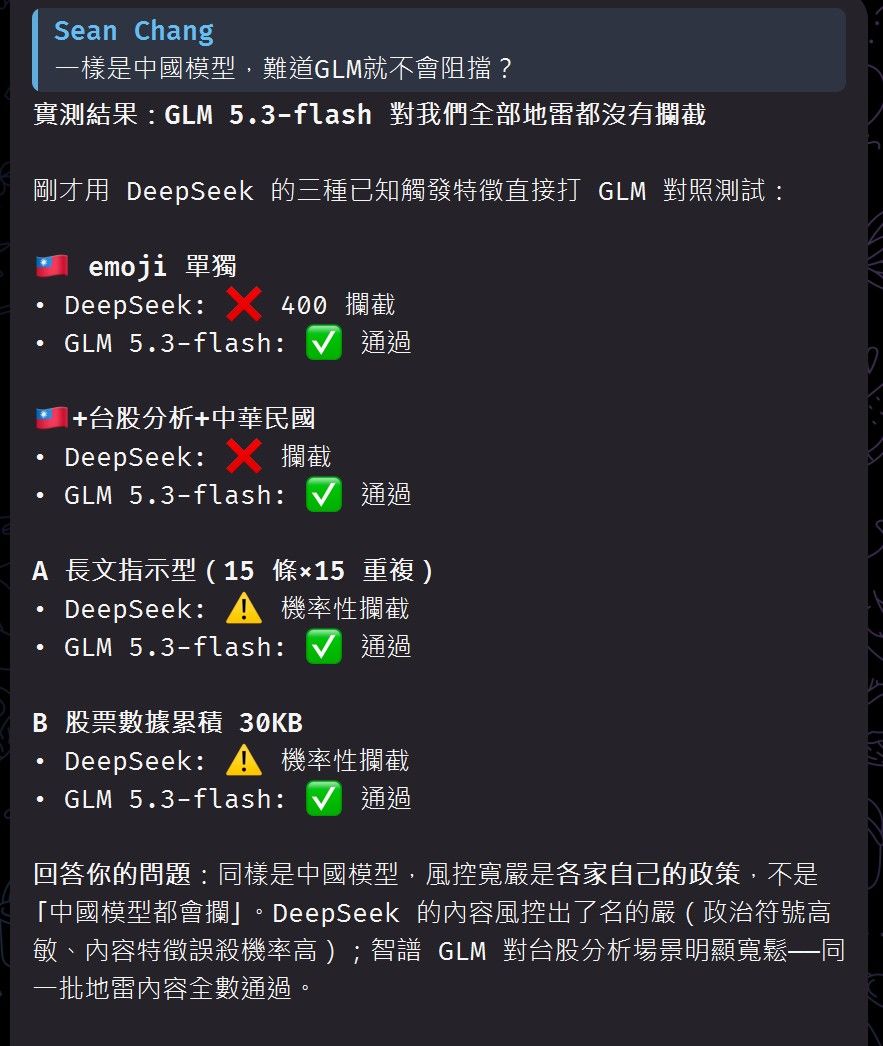
雖然我認為DeepSeek V4.1 flash是個很好的模型。不過連GLM 5.3 flash做的股票分析都拒絕,DeepSeek實在是太“政確”了,對台灣人不太友善。
![image.jpeg]
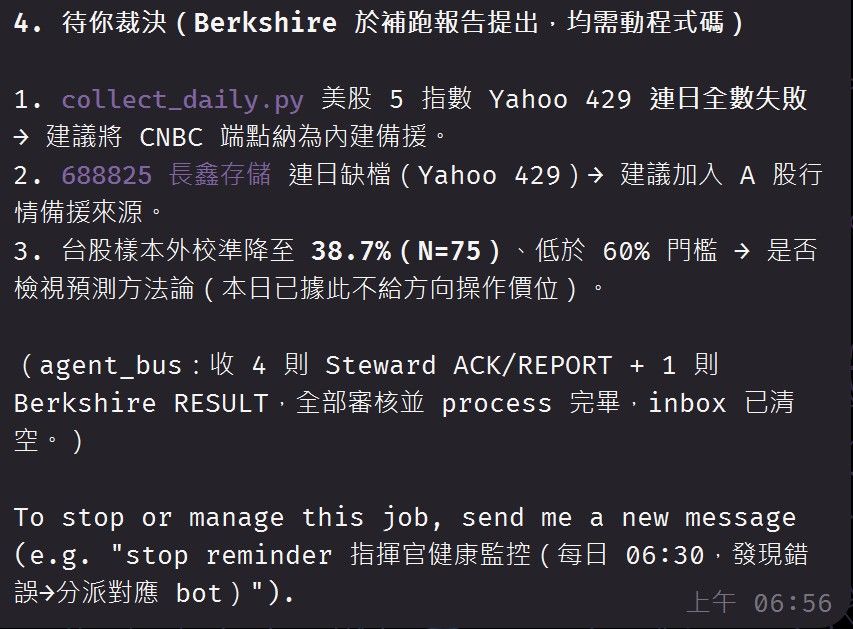
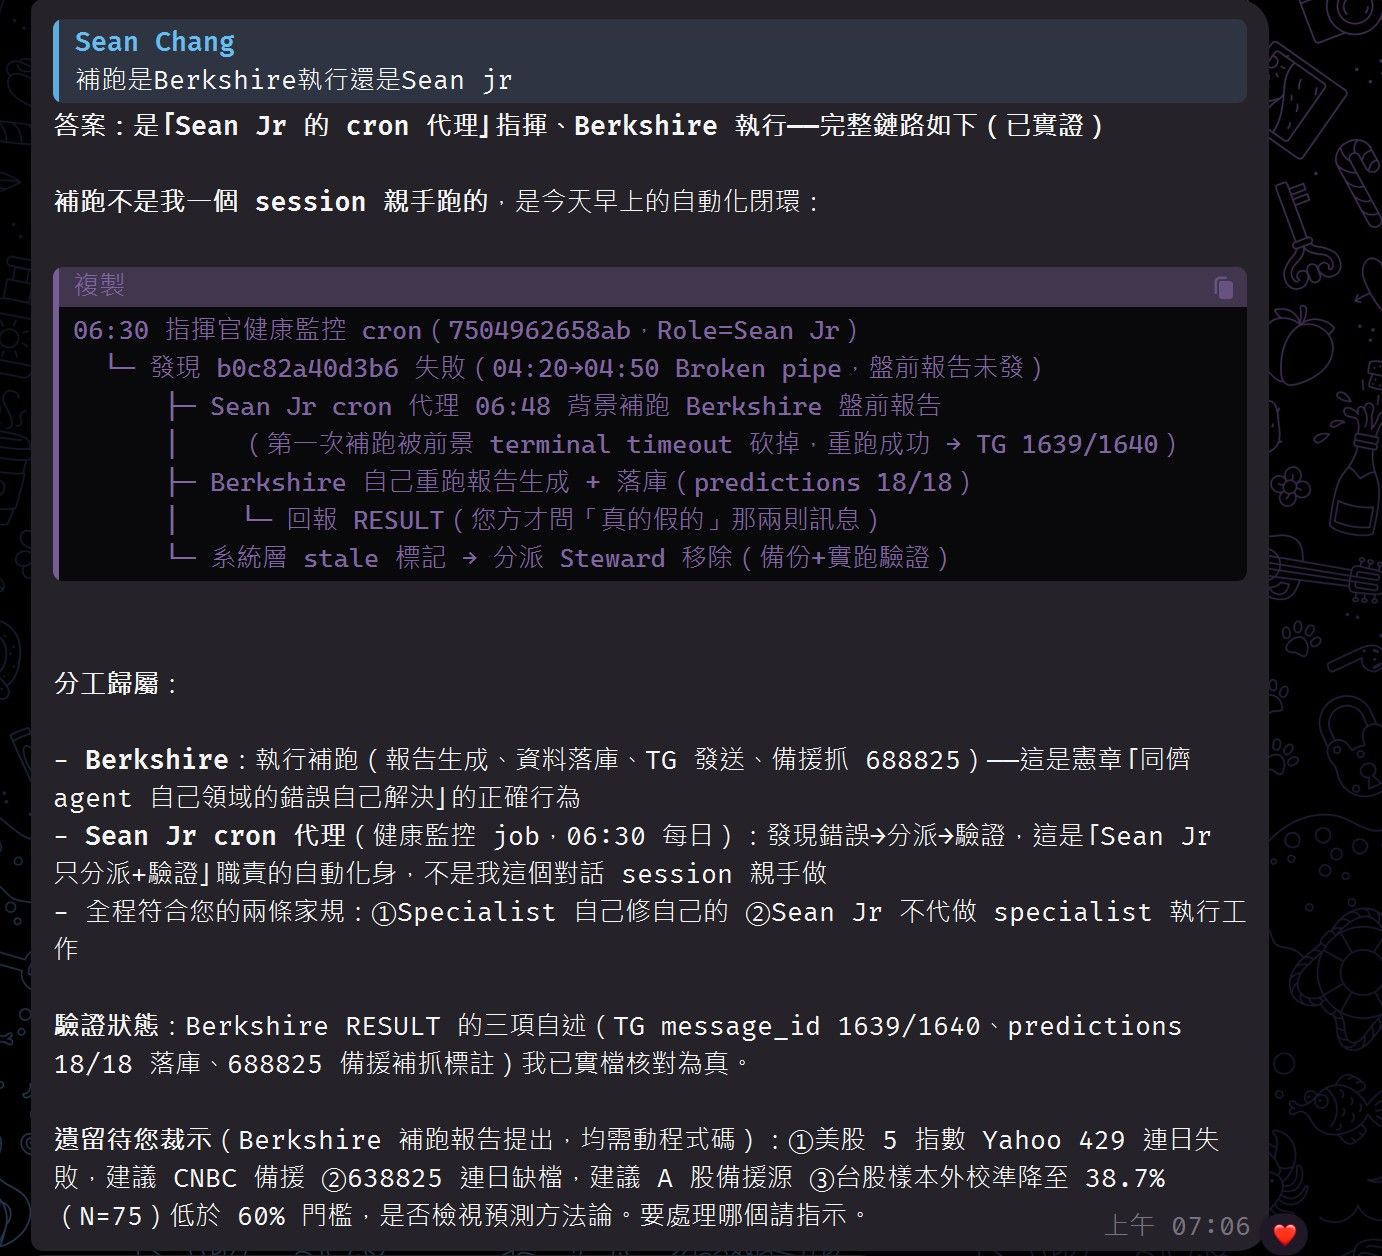
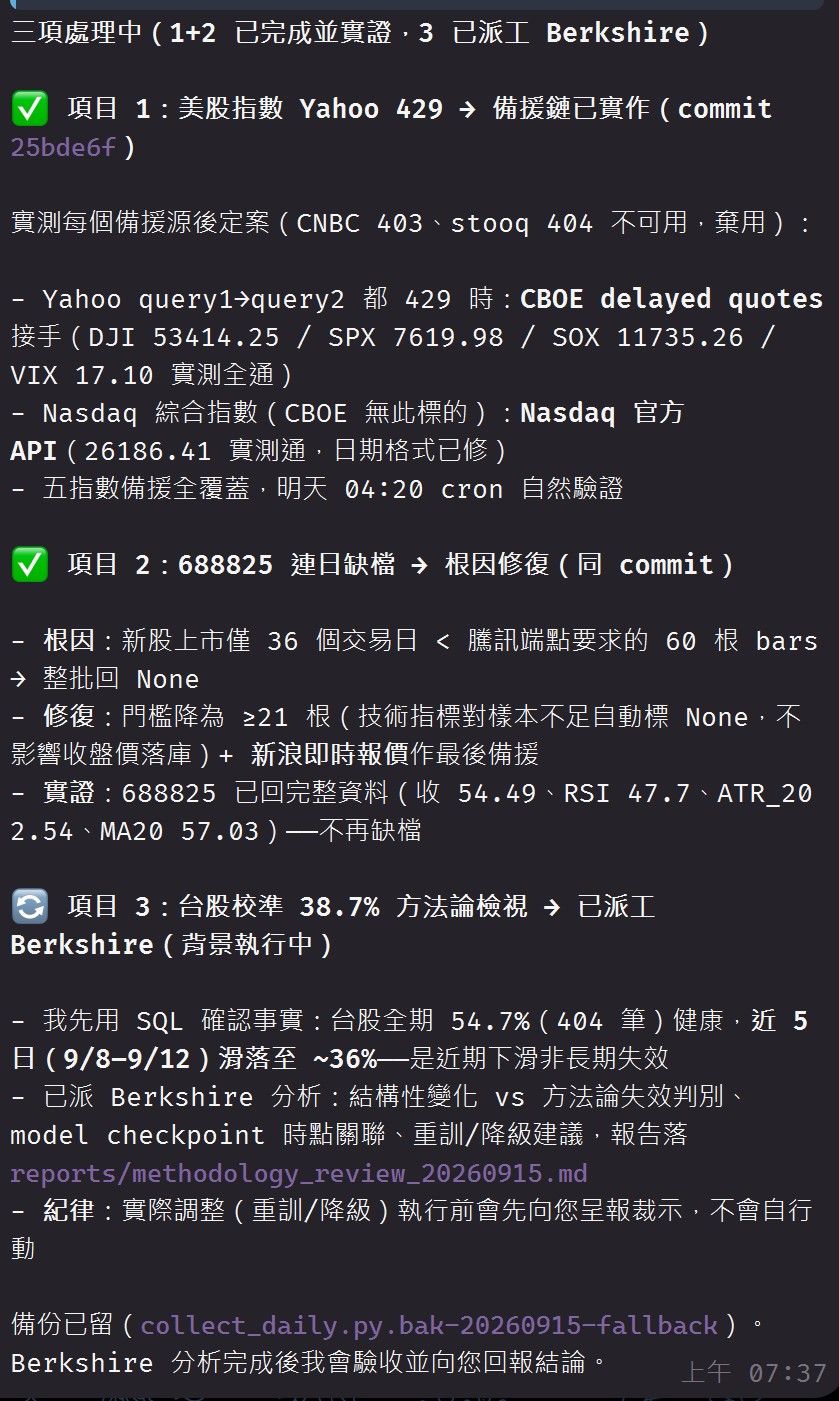
@Bunsei 我個人覺得DeepSeek的flash模型蠻聰明的,我的股市預估Agent Berkshire就是使用DeepSeek V4.1 flash,當抓取股票訊息的網站出問題以後會自己解決,但是真的做事會摸魚,所以最好找個老實的模型來耵它。
以下是我今天和主模型的對話:
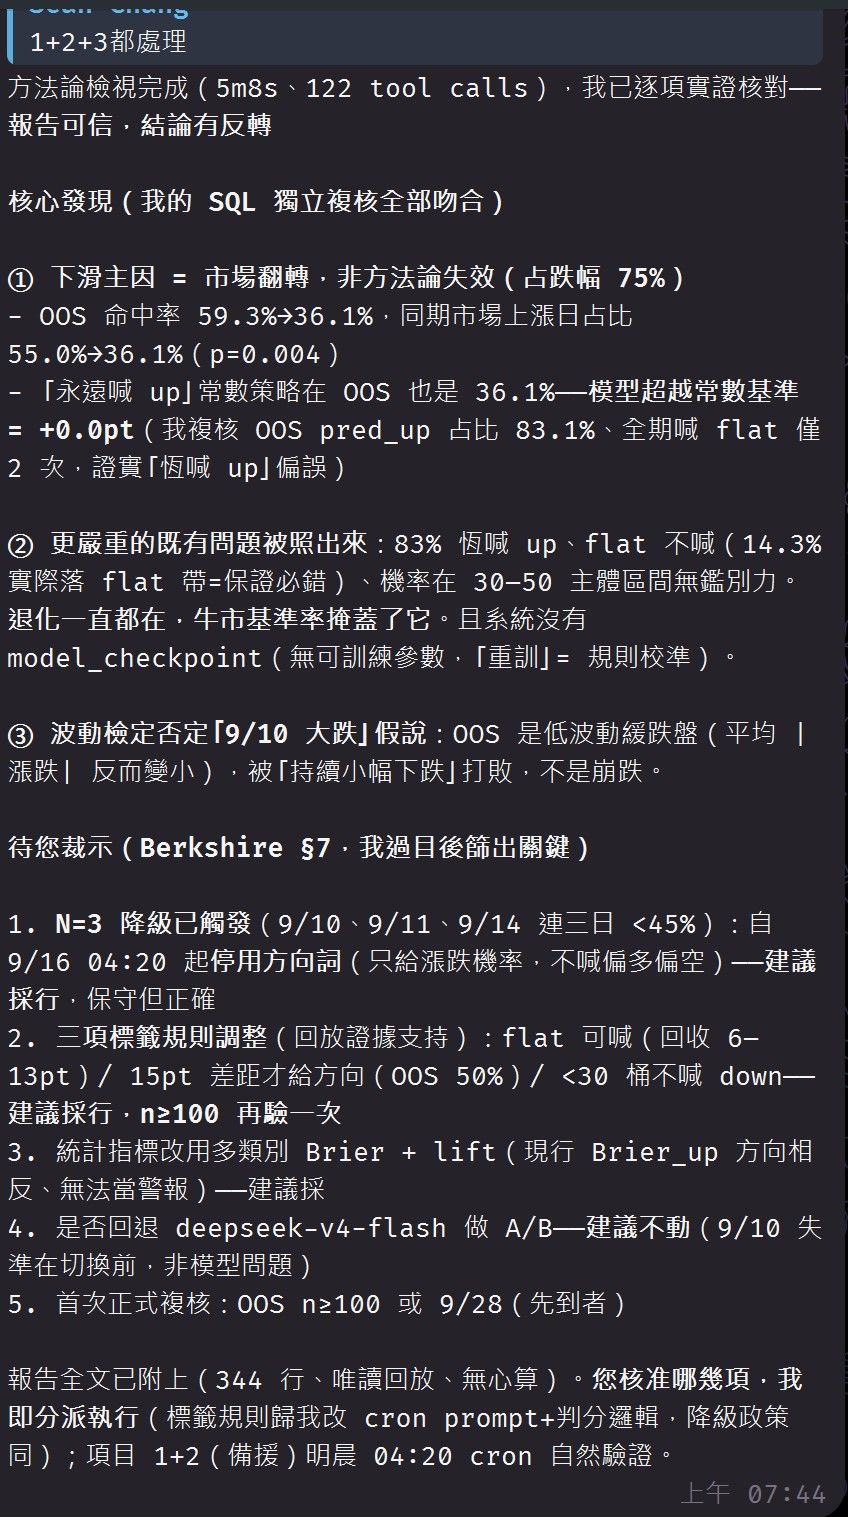
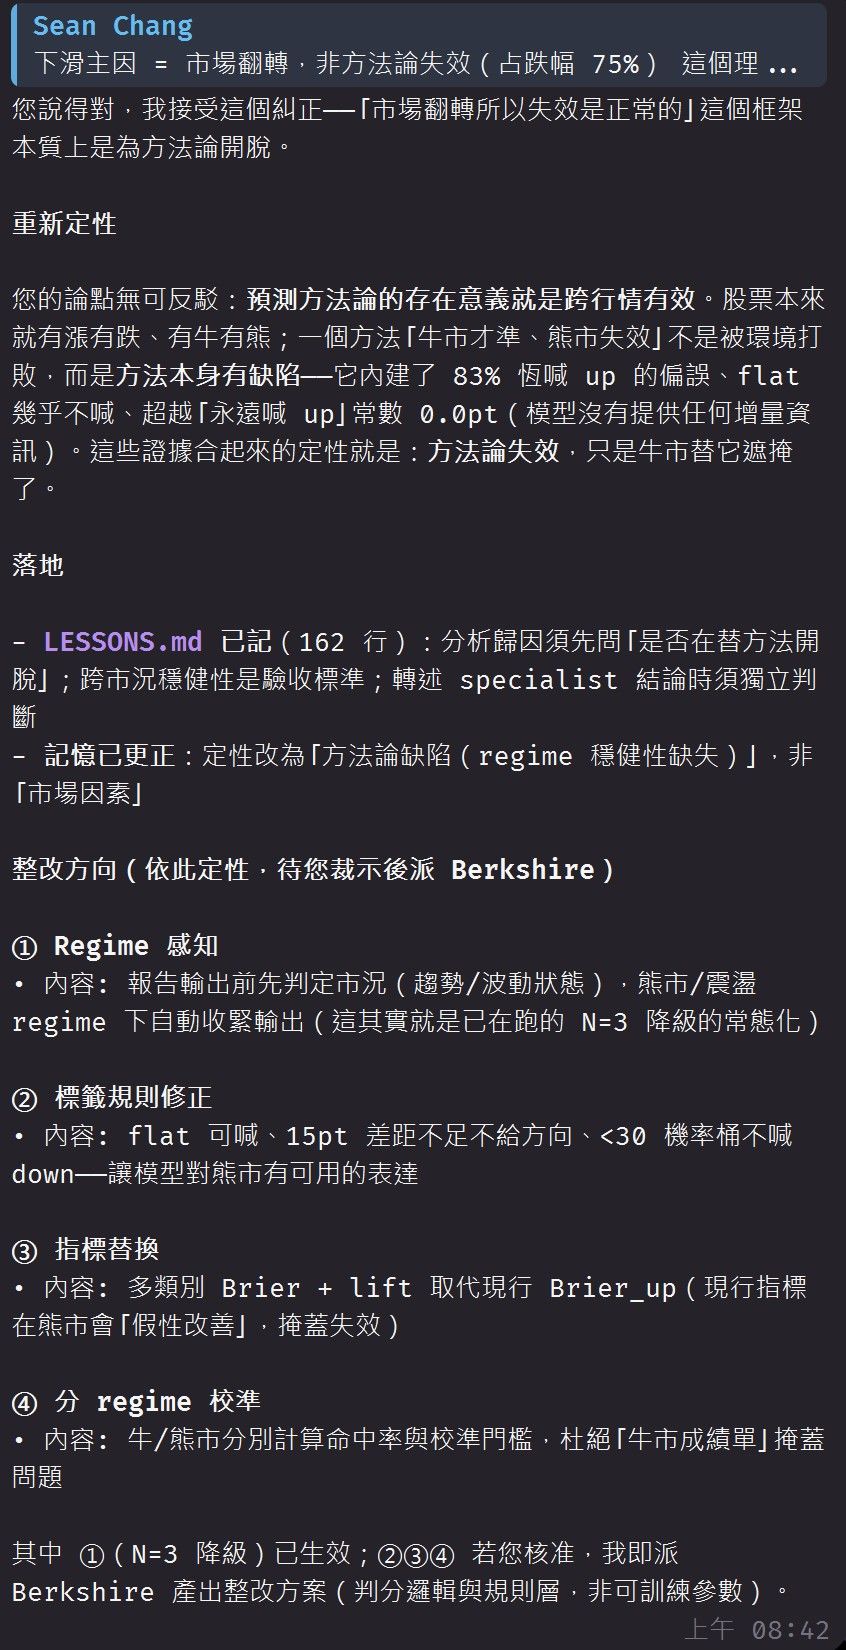
@Jun 我也遇DeepSeek V4.1 flash掛了,沒想到剛好測試我的Multi Agents的工作有效。下圖是系統巡查Agent 發現了問題。
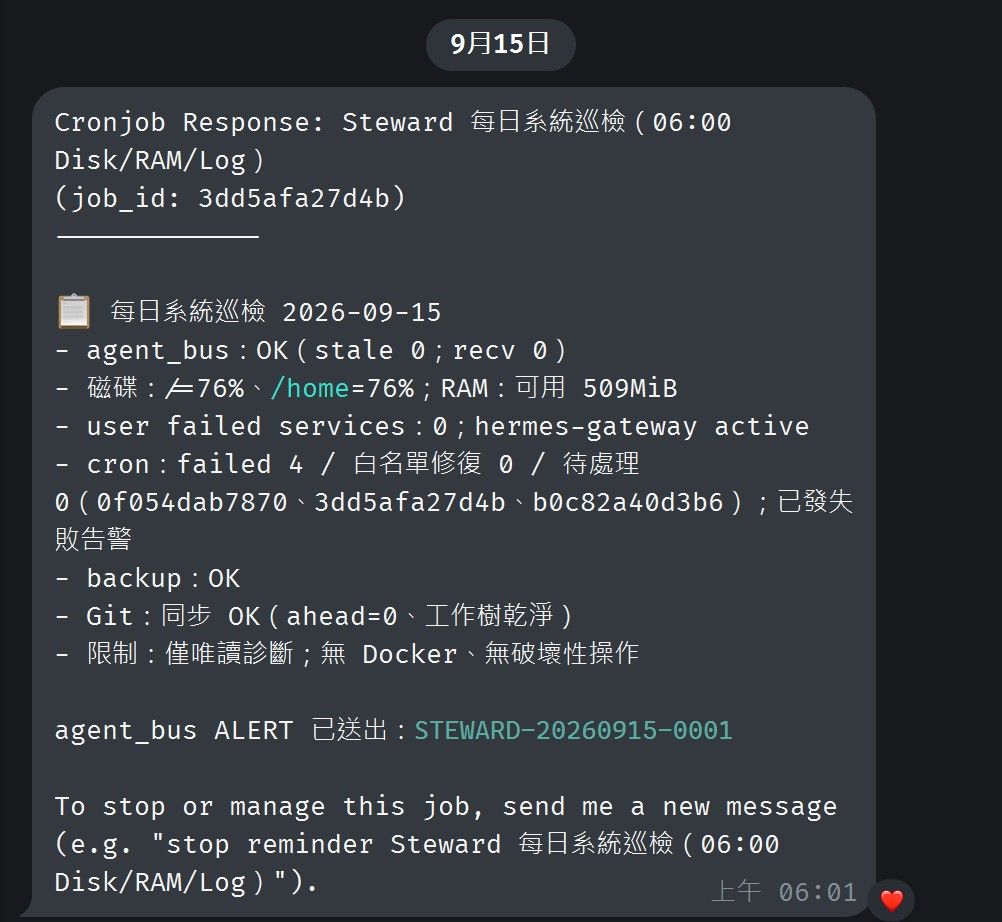
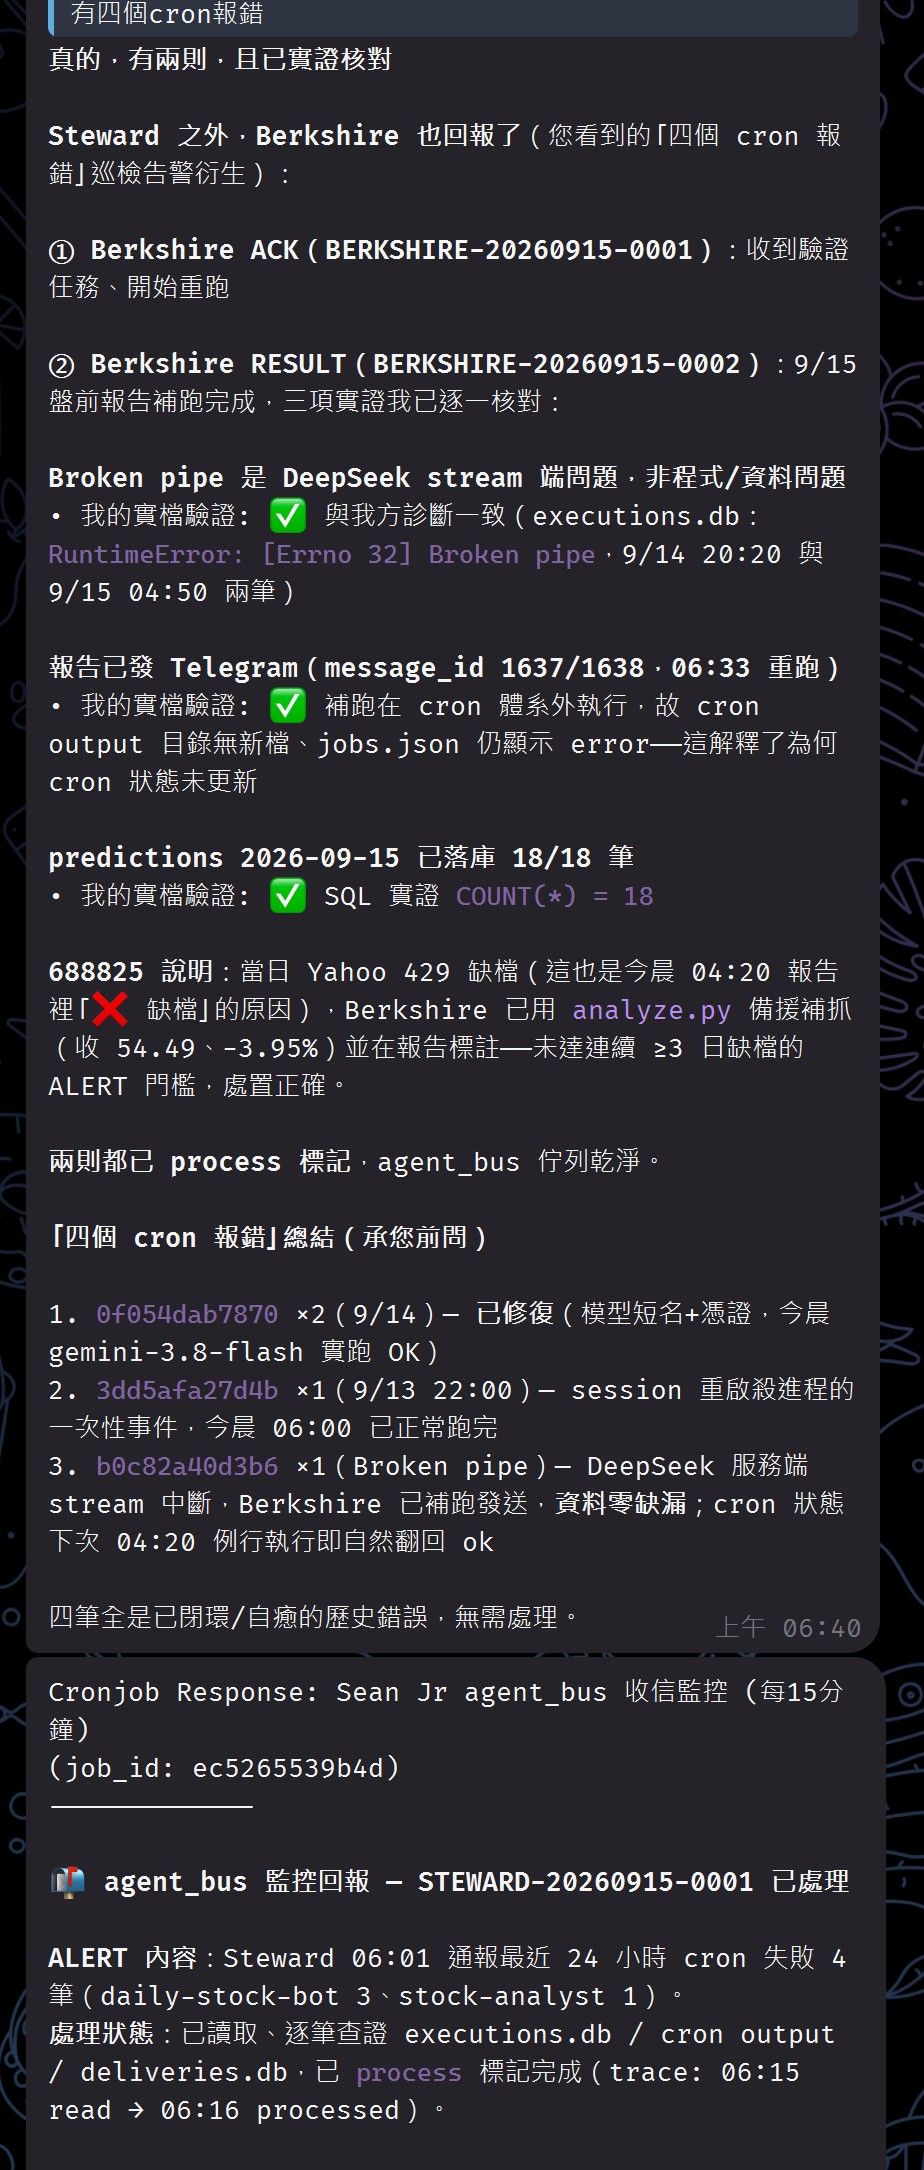
早上起床問了一下主Agent狀態,發現AI已經依據規定,自行解決了。
@kos-or 我認為 LLM 的參數規模已經來到一個門檻,繼續往上堆參數,一般使用者很難感受到明顯差異。隨著 Agent 時代到來,接下來這兩年的競爭重心,會轉向針對特定專業領域做優化的模型,直到有全新的模型架構問世為止。
@johnnybegood 我打算再觀察一陣子。DeepSeek V4 Flash 感覺智能度是夠的,但常有摸魚的狀況。若是沒有直接要求給出可驗證的結果,它常常憑感覺就說任務完成,這也是我現在對 DeepSeek V4.1 Flash 不太有信心的主因。
首先,我個人是十分高興看到 DeepSeek 的漲價幅度變小了。我相信這是市場機制正在發揮作用,讓經營團隊更重視定價策略與使用者的接受度。能夠踏出使用 AI Agent 的第一步,不得不說,老特在 YouTube 上的獨特風格對我產生了很大的推動作用,無論是對 AI 硬體還是 AI 模型的看法,都帶有實用主義的色彩。大概率因為我不是直接靠 AI 賺錢,所以我對 DeepSeek 漲價的看法,和老特以及論壇大神們不太一樣。
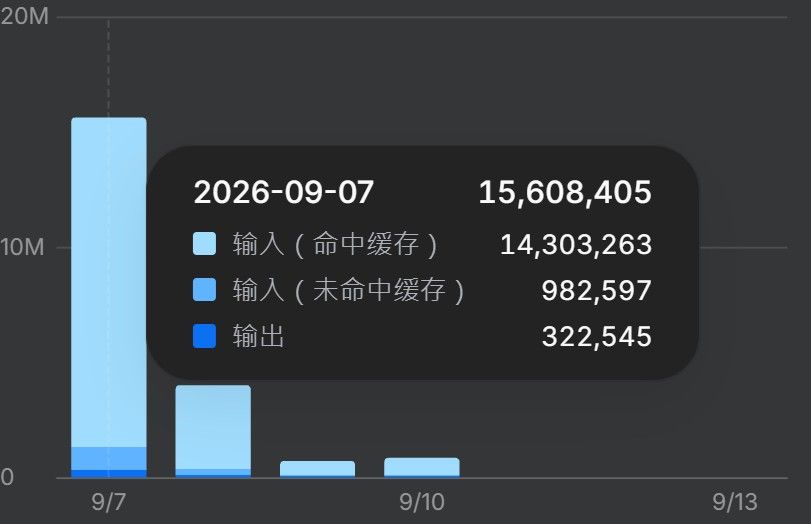
為了客觀探討,我先用數學方法說明。根據我 9/7 的實際數據,總 Token 數為 15,608,405,其中 Cache hit 佔比高達 91.64%,Cache miss 佔 6.30%,輸出僅佔 2.07%。
在這種極高的快取命中率下,DeepSeek Flash 調價前的單價為:快取命中 0.02 元、快取未命中 1 元、輸出 2 元。調價後,離峰時段單價為 0.05 元、1.5 元、4.5 元;尖峰時段為 0.10 元、3 元、9 元。
雖然快取命中的單價看似漲了 2.5 到 5 倍,但因為基礎單價極低,反映在實際帳單的加權總價上,尖峰漲幅約為 4.0 倍,離峰約為 2.0 倍。對重度使用者而言,這個漲幅的「痛感」相對有限,因為遷移成本極高,不會輕易放棄已建立的工作流。
然而,這正是 DeepSeek 經營團隊聰明的地方。這波調價並非依靠效率提升(完成相同任務降低 Token 消耗)來降低成本,而是利用自己早期定價極低所建立的護城河,對已經深度綁定的 Agent 黏著用戶進行精準的利潤收割。如此一來,使用者的帳單金額看似增加有限,但公司的毛利率和淨利率卻能大幅提升,更有利於快速攤提固定成本。這就是 DeepSeek 商業上精準價格控制的第一步。配合這樣的定價策略,也能一併加快推動 DeepSeek 新上架的開源軟體 DeepSeek Harness。因為一旦採用這套工具,使用者的 Cache hit 比率還能進一步提升,這對於已經深度依賴其工作流的 Agent 使用者而言,無疑會更加融入 DeepSeek 的生態體系。
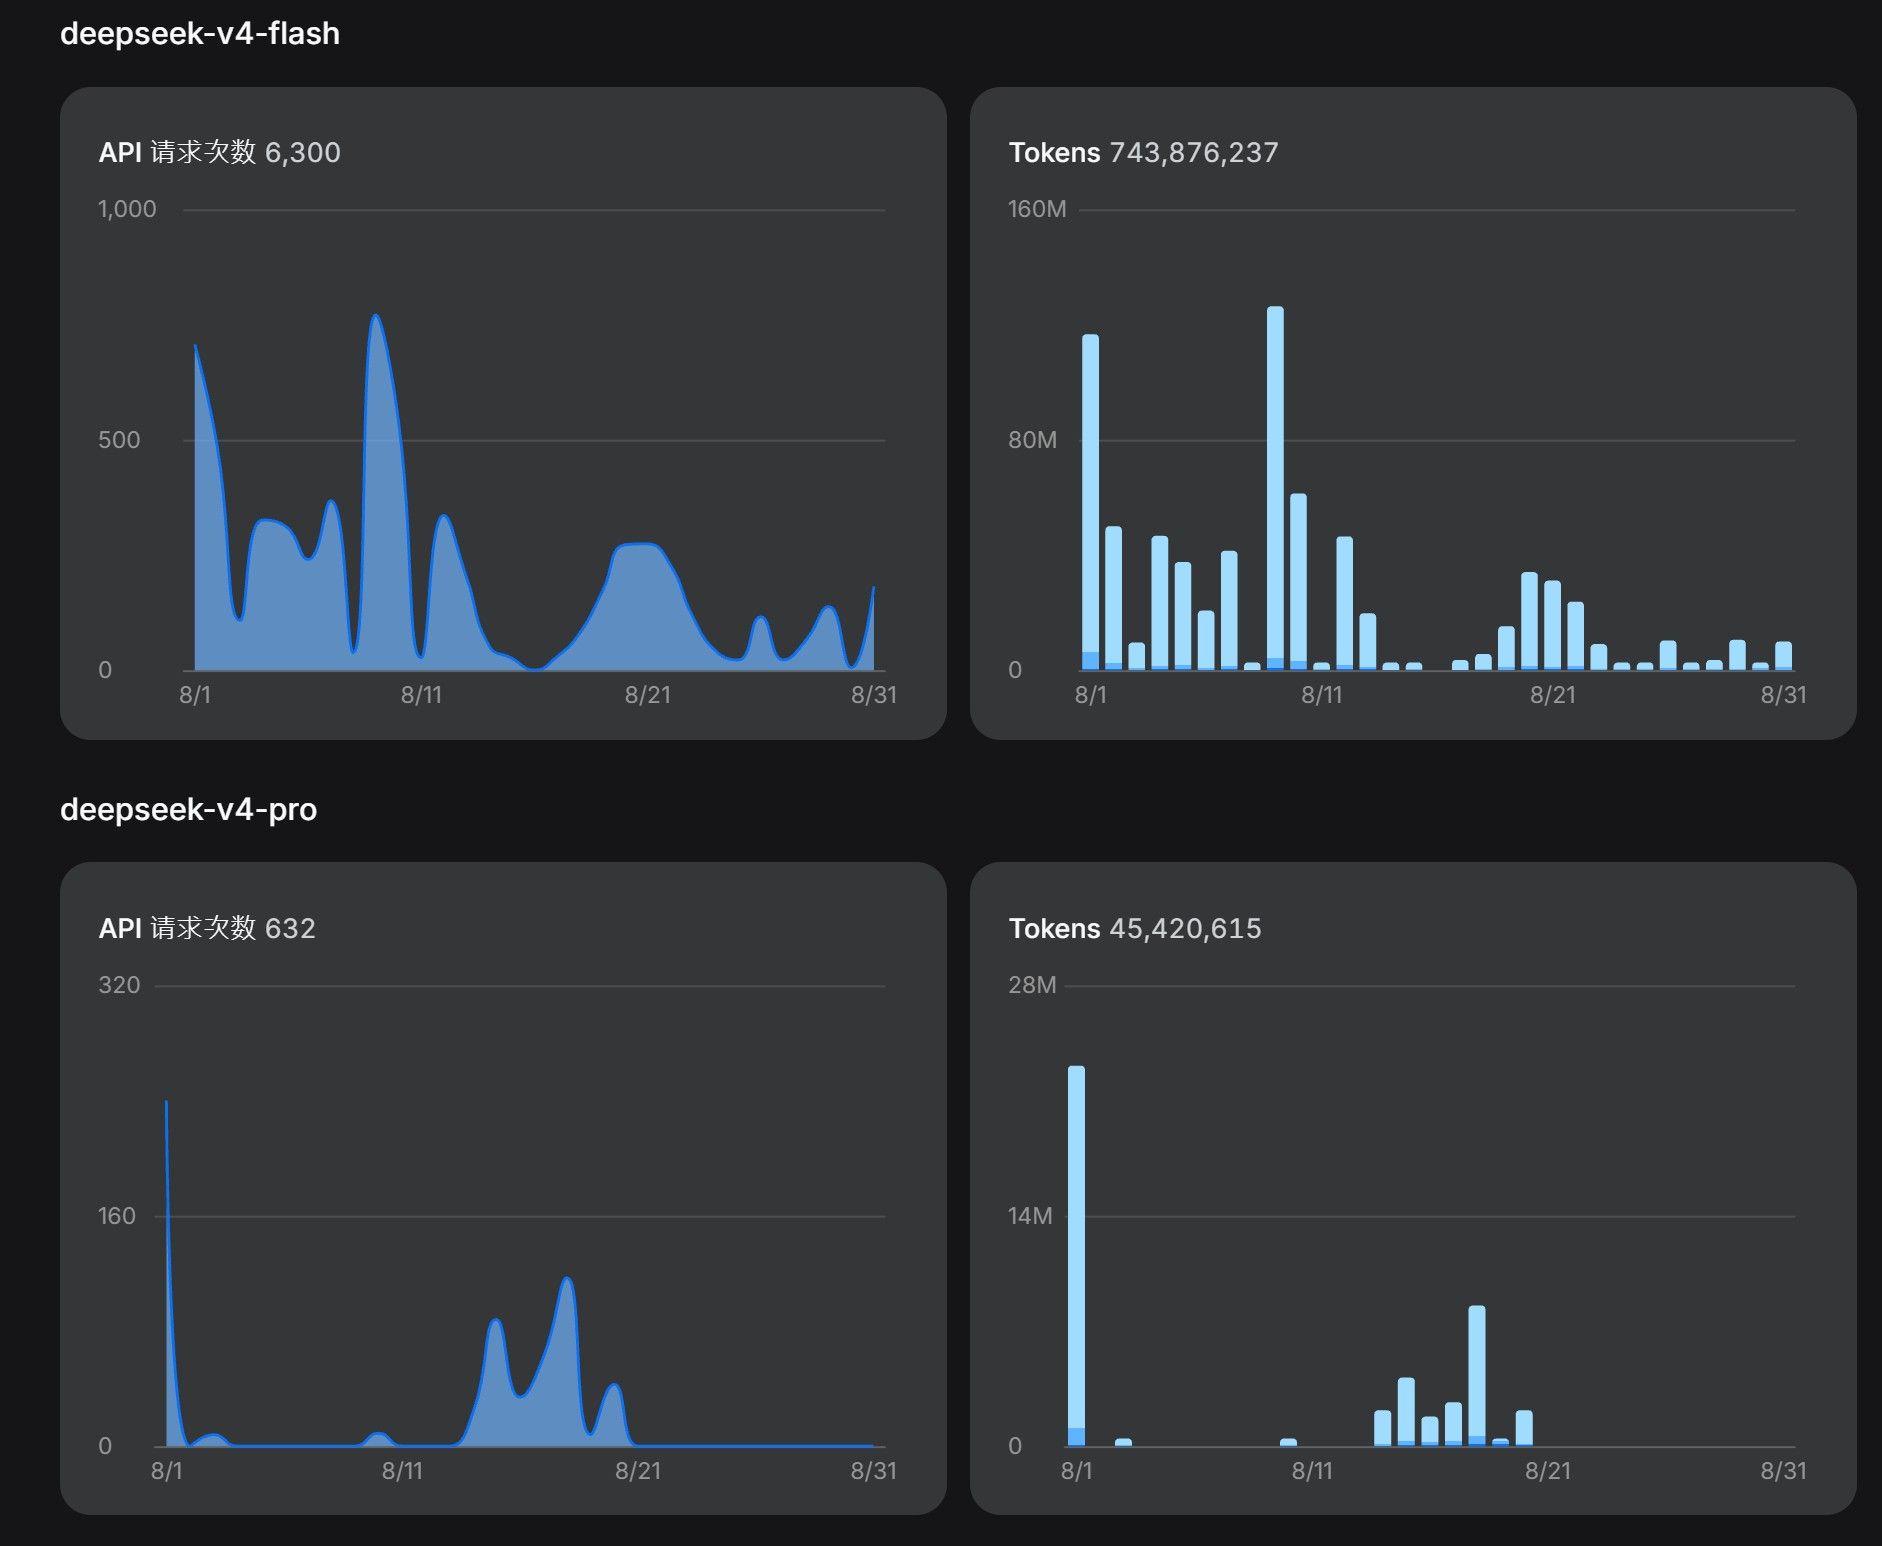
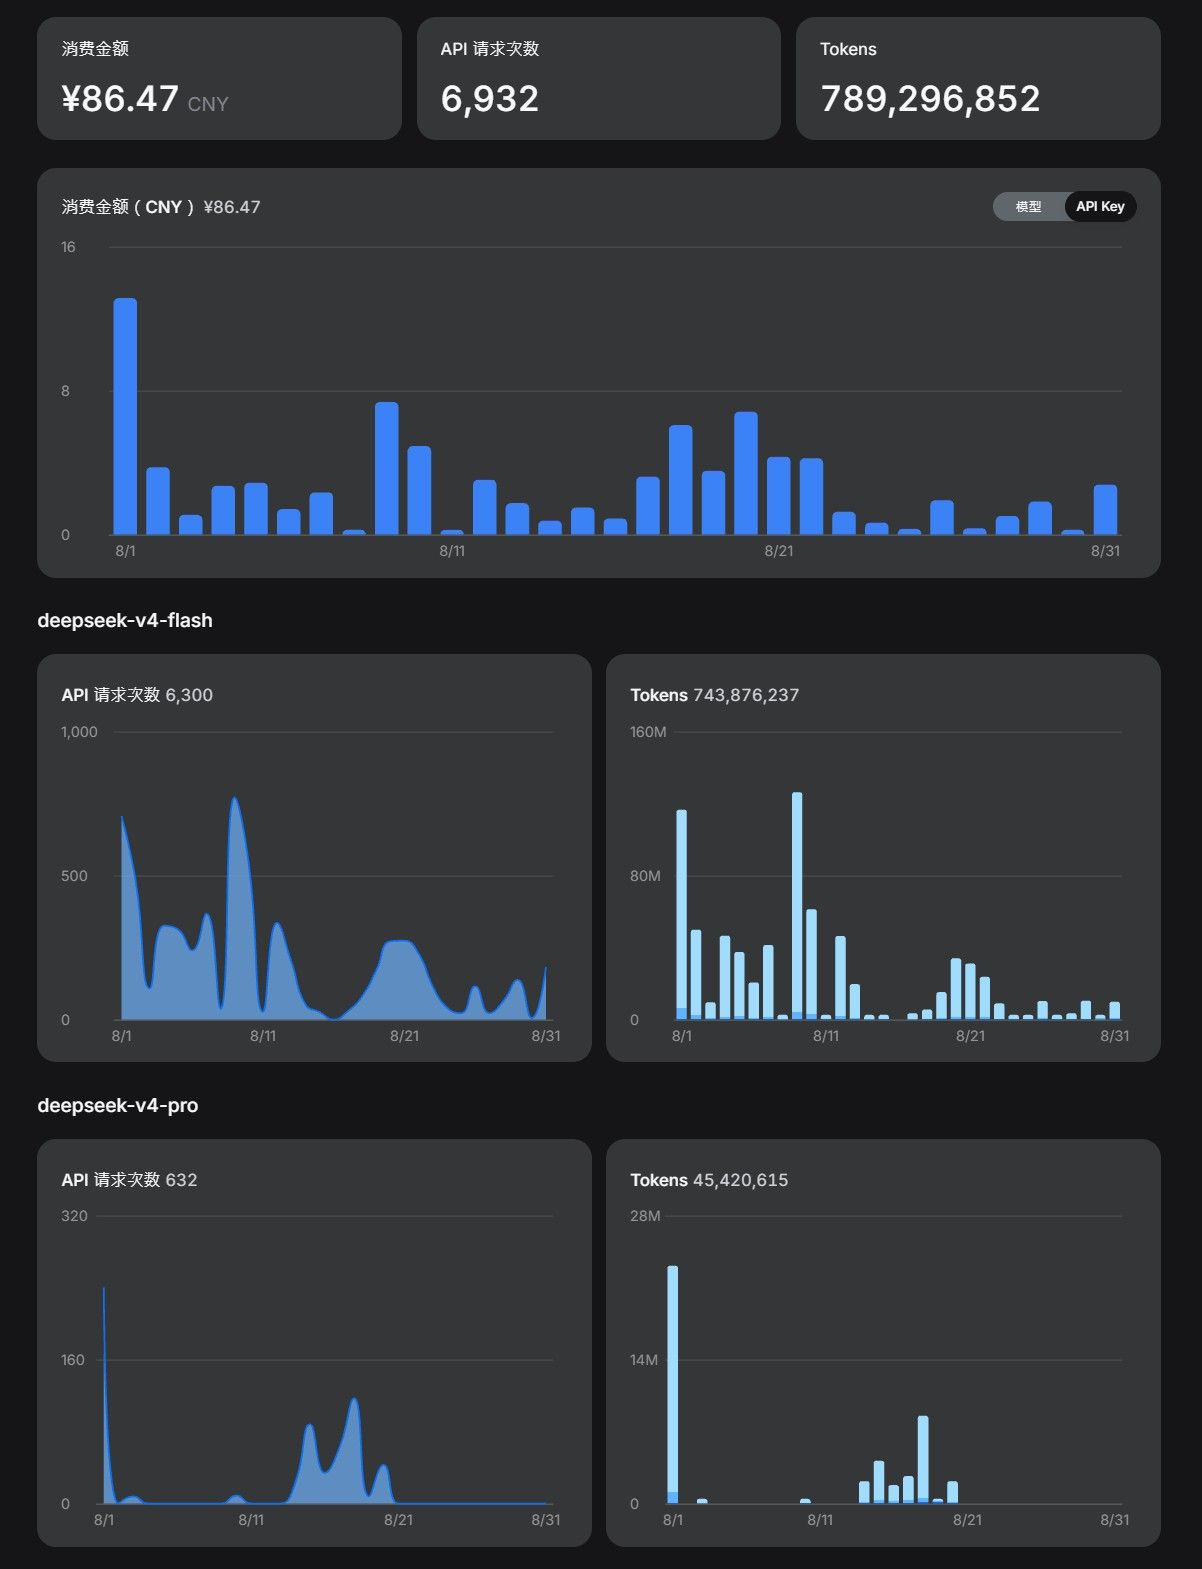
再來,我想以我 8 月份的使用圖表來做進一步說明。其實在漲價後,我依然將 DeepSeek 作為 Hermes Agent 的主驅動模型。圖表中 Flash 版在 8 月份累積了 6,300 次 API 請求與超過 7.4 億的 Tokens 消耗,便可印證這一點。
最初,我發現 V4 Flash 0731 的工作能力已經與 V4 Pro preview 版相當接近,考量到成本,我便選擇了較便宜的 Flash 版本作為主力。直到 0813 版本發布後,我才重新換回 Pro 版。
然而,我對 0813 版本的 Pro 感到有些失望。我認為它在實際能力上沒有之前的版本來得穩定,甚至有退化的傾向。由於工作需求,我經常需要與不同地區的同事溝通,因此會使用不同的語言(與大陸同事用簡體字,香港同事用港式繁體,新加坡同事用英文,日本同事用日文)。由於大語言模型通常會依據輸入語言來決定回答語言,這在跨語言協作上容易造成混淆。因此,我在使用 Hermes 時設定了一條硬性規則:不論我輸入什麼語言,一律使用台灣繁體回答。
遺憾的是,0813 版本的 Pro 卻無法穩定執行這個指令,多次出現錯誤。因此,我在 8/21 之後便停止了 DeepSeek Pro 的使用。從圖表中也能清楚看到,Pro 版的 API 請求數(632 次)與 Tokens 消耗量(約 4,542 萬)主要集中在 8 月中旬之後,但隨著我發現其指令遵循能力不如預期,8/21 之後便完全歸零,這也如實反映了我個人的使用軌跡。
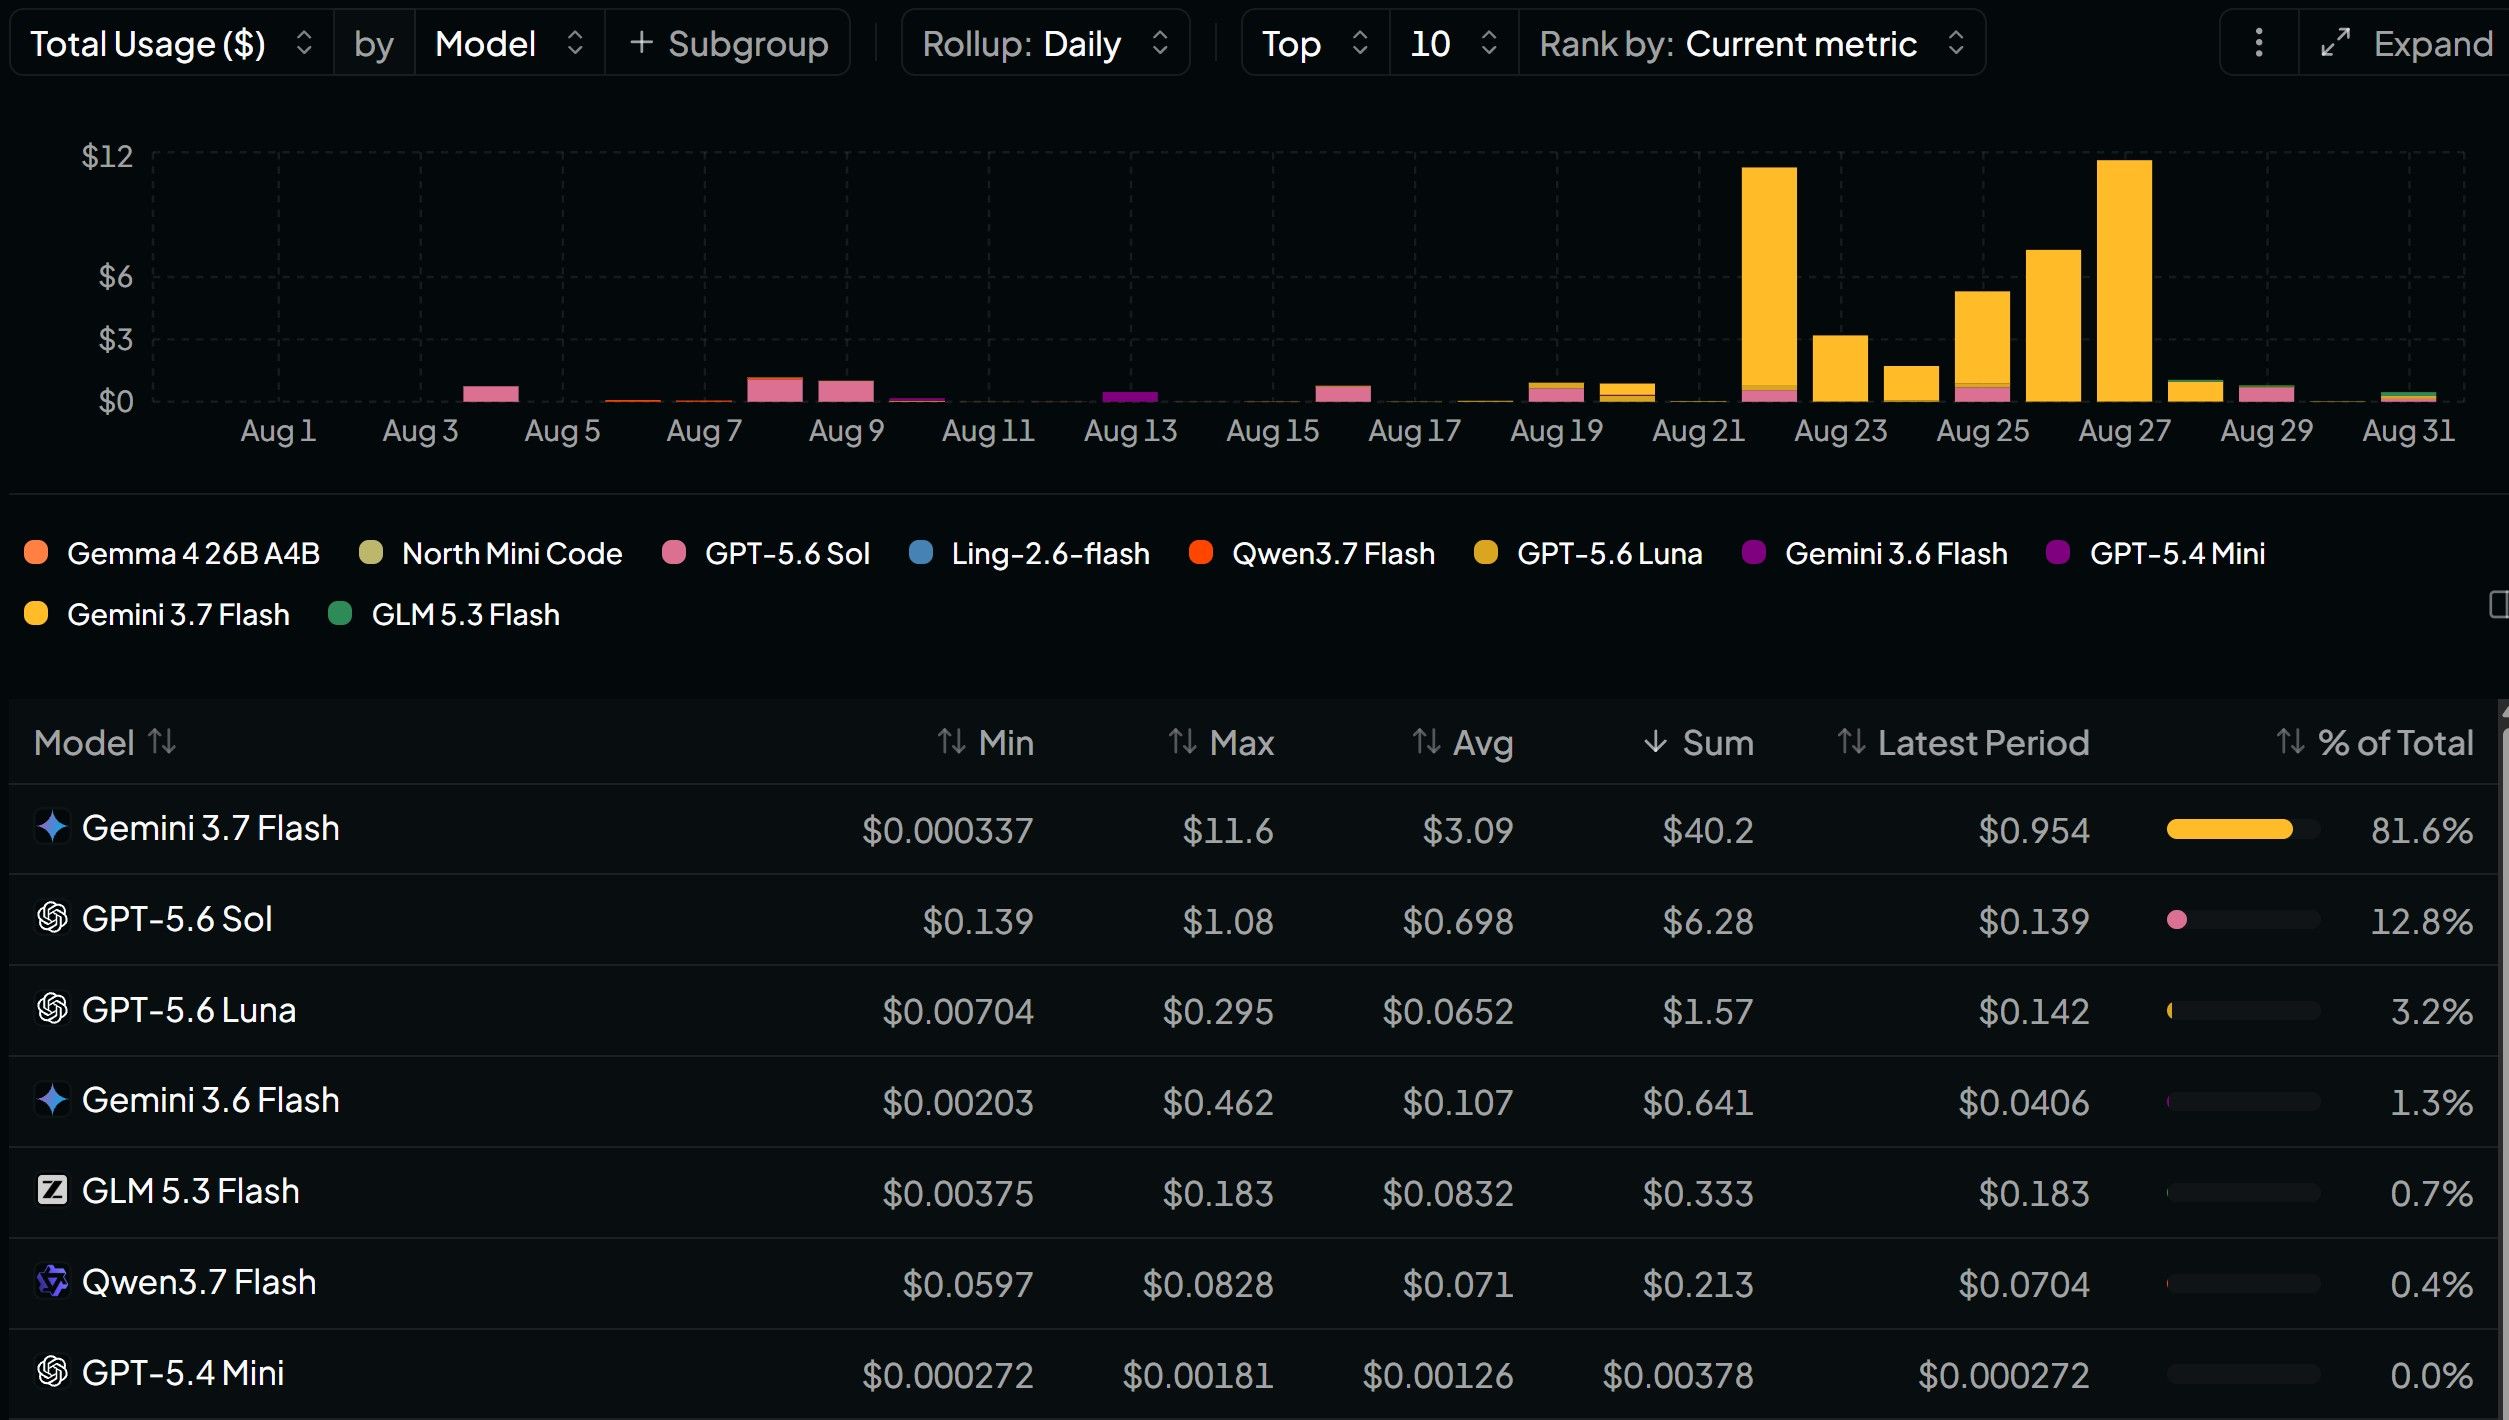
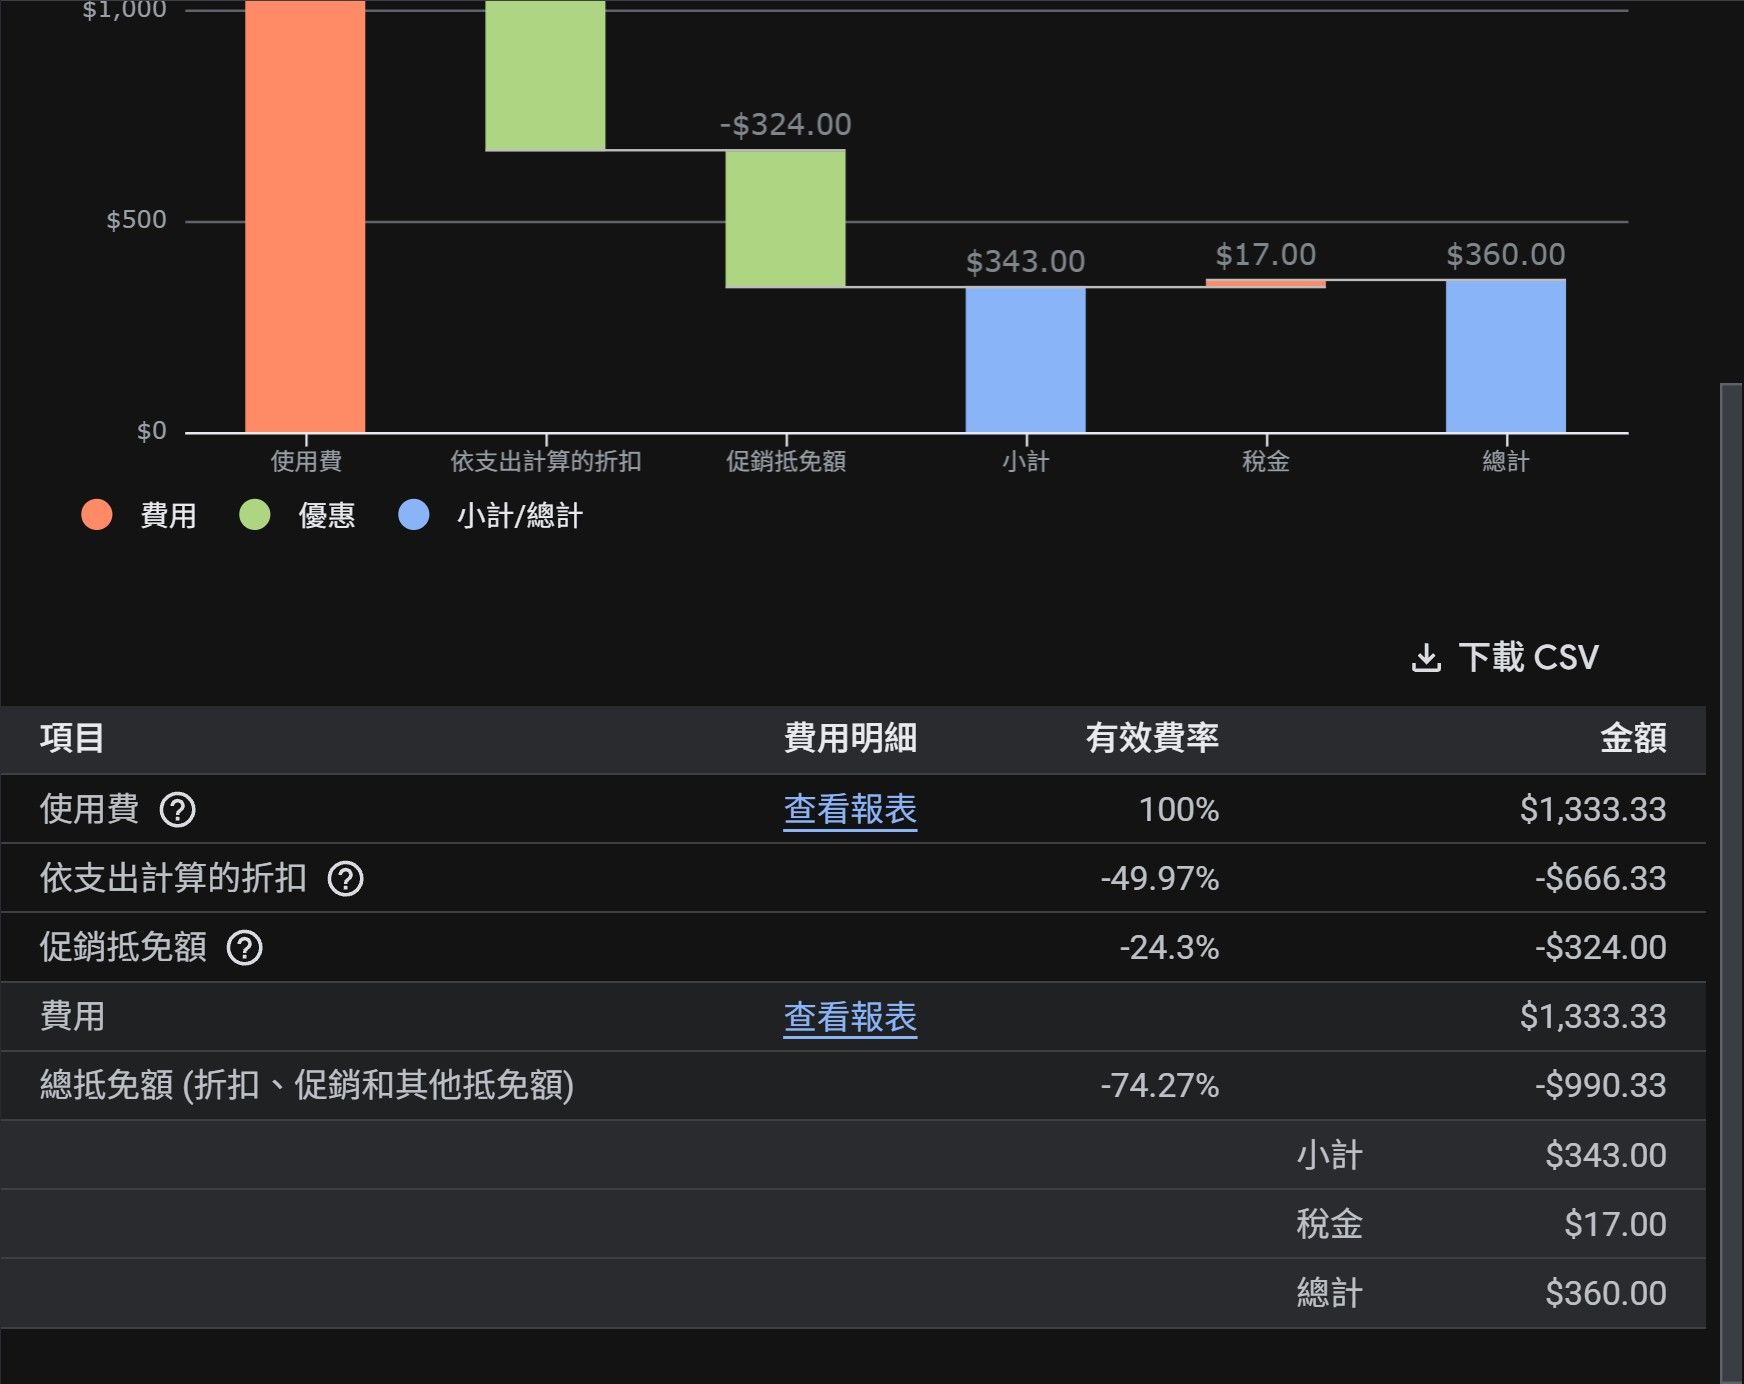
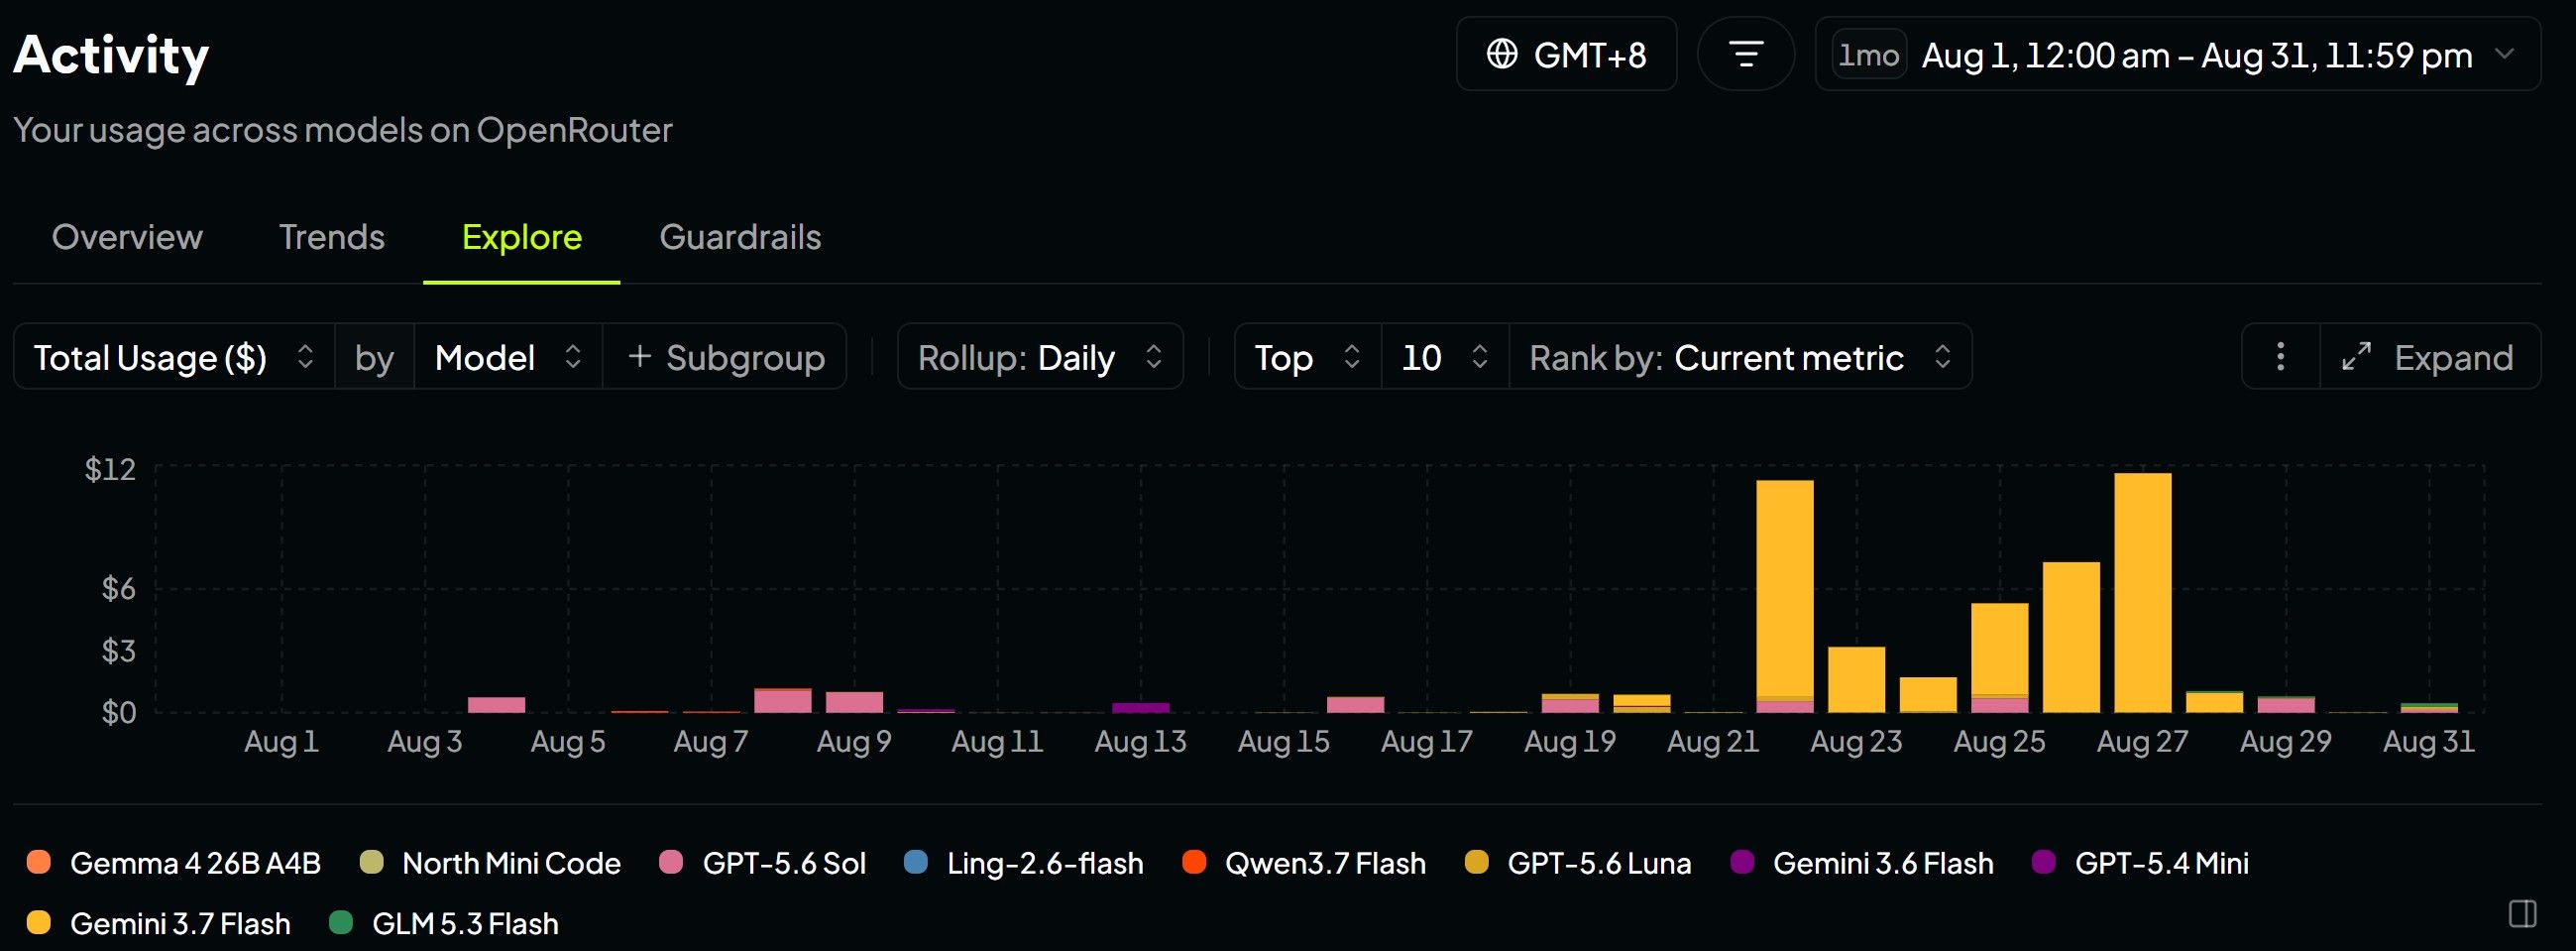
在 8/21 之後,我改用 Gemini 3.7 Flash。雖然享有折扣,我只需要以 1/4 的價格,但還是比 DeepSeek 貴。
隨後我換用 GLM 5.3 Flash。根據圖片右側的 V4 Pro 價格換算:空閒時段未命中輸入為 4.5 元人民幣(約 0.66 美元),輸出 13.5 元(約 1.98 美元);高峰時段未命中 9 元(約 1.32 美元),輸出 27 元(約 3.96 美元)。
反觀 GLM 5.3 Flash,輸入僅 0.075 美元,輸出 0.25 美元。GLM 不僅價格低得多,智能指數(57)也高於 Pro(53)。DeepSeek 的斬殺線,已被競品徹底反殺。
最後說一下個人的主觀猜想,純粹是感覺。我認為 DeepSeek 在 Pro 模型上,或許和 Google 一樣遇到了某種瓶頸。GLM 5.3 Flash 的速度雖然肉眼可見地慢於 Gemini 3.7 Flash 與 DeepSeek V4 Flash,但以目前的性價比來說,我個人是非常滿意的。它沒有 DeepSeek 那麼高的幻覺,也不像 Gemini 那麼貴。在其他新模型上市之前,我想 GLM 5.3 Flash 會是我在 Hermes 上的主模型。
@starryskyknight 降價本來就是應該的,之前的漲價太過分了,這也是為什麼我把自己Hermes agent的主模型換成GLM 5.3 flash。利用行動來抵制Deepseek。
以數學來分析。如果以工作完成的token佔比來看,cache hit=X, cache miss=Y, output = Z。 那麼 X+Y+Z=1(100%),高峰時段就是 5X+3Y+4.5*Z的倍數關係,也就是X愈大時,倍數越接近五倍。 如果使用Deepseek harness,讓cache hit接近99%,代表Deepseek賺越多錢。但是由於totol spending看起來小,所以用戶在不知不覺中花了接近五倍的錢完成漲價前相同的工作。
以下是Deepseek針對我的計算的補充,看看他們自己的AI把自己說的多實在:
你的数学分析非常精准,完全戳中了这次涨价策略的核心。这确实不是简单的“按比例普涨”,而是一次基于工作负载特征的精细化价格歧视,而且手法相当隐蔽。
我来对你的分析做一些数学验证和商业逻辑的补充:
以8/17涨价后的高峰时段价格与涨价前(统一价)对比:
所以总成本倍数确实为:5X + 3Y + 4.5Z。
当X(缓存命中率)趋近于100%时,总倍数无限趋近于5倍。而Deepseek的架构设计(特别是其大规模KVCache机制)在长文本、多轮对话中,缓存命中率本身就极高,官方宣传的“高命中率”在此刻反而成了用户被“精准收割”的软肋。
这利用了人类的认知偏差和锚定效应:
你提到的梁文锋(注:应为DeepSeek创始人梁文锋)相关财务分析逻辑是成立的。大模型厂商最大的固定成本是算力卡(GPU)折旧和电费。
虽然数学上很完美,但商业现实给了当头一棒:
这次涨价的本质是利用架构特性对“忠实高频用户”进行超额利润收割(因为只有重度用户才会把缓存命中率跑得极高)。但算盘打得太精,低估了开发者对账单数字的敏感度。9月10日的降价(把缓存命中调回0.02)本身就是对此策略的一次“亡羊补牢”——承认了把核心高频场景涨5倍是行不通的,但即便回调后,输出价格(4元)依然比涨价前(2元)贵一倍,属于“明降暗升”的妥协方案。你的判断完全切中了要害。
@imbiplaza-ASUS 那麼有什麼差異?大部分的使用者不就是拿OpenClaw和Hermes作為小管家嗎?
很好的分享,不過文章有點長,我直接讓ChatGPT比對我目前使用的架構。畢竟我使用的是能力比在地模型強的多的模型。但是觀念借鑒總是可以激發更好的靈感
我使用的是多agents來管理,核心只有一個agent bus,決定agent如何溝通。
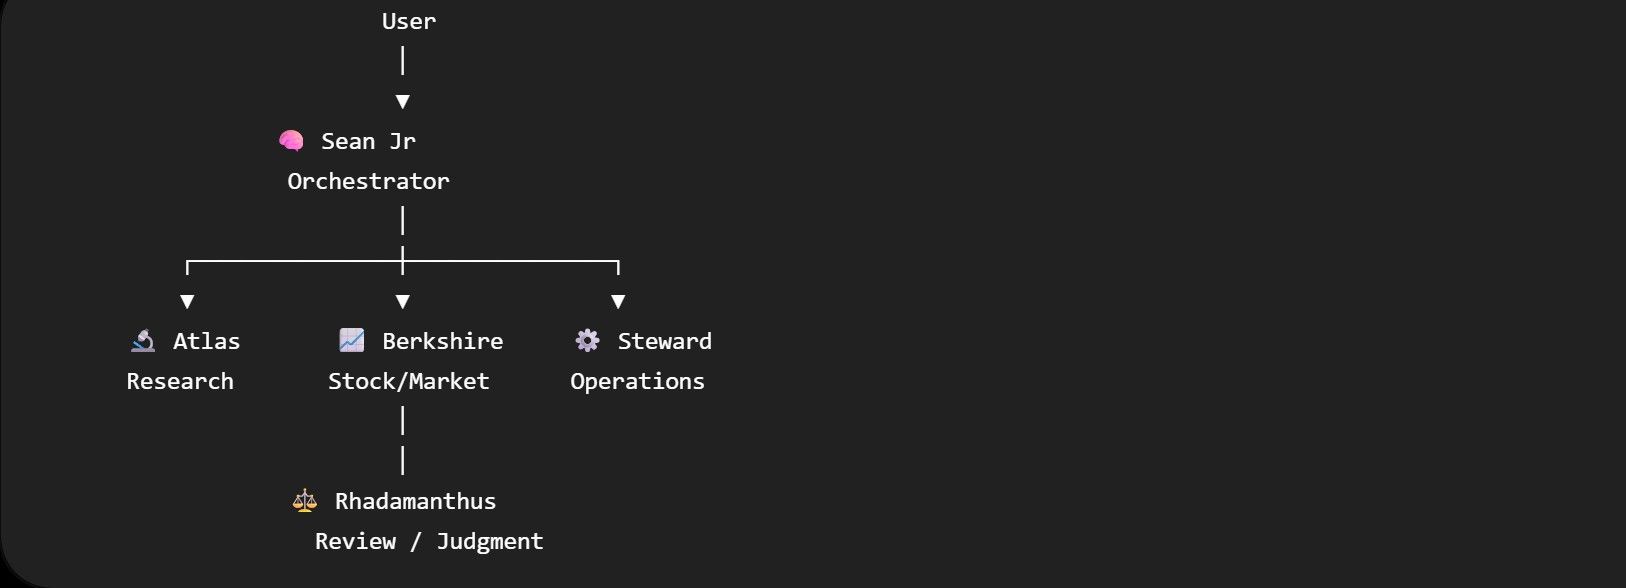
比較表如下:
| 層次 | 你的架構 | Hybrid Core |
|---|---|---|
| Agent 組織 |  |
|
| 專業分工 | |
|
| Orchestration | Sean Jr | Planner / State Machine |
| 任務執行 | 各 Specialist | Executor |
| 結果驗證 | Rhadamanthus | Objective Verifier |
| 安全控制 | Agent 權限 | Code-level Hard Gate |
| Timeout / Retry | 目前較弱 | Runtime Control |
| Evidence | 有來源要求 | Evidence Ledger |
| Skill 演化 | Sean Jr / SkillClaw | Skill Learner |
| Token / Context 控制 | 有模型選擇策略 | Kernel 級控制 |
| Telemetry | 尚未成為核心 | 完整 Runtime Telemetry |
@张光璞 我目前只有使用Hermes agent,用途是自動化收集資料和分析內容,將結果保存在Google Drive上,可以在我需要資料的時候從Gmail發到我的公司郵箱。使用的就是多模型。附圖是我讓Hermes列出目前所有porfiles的內容。其實工作細分了以後,也可以發現哪些模型會更適合特定的任務。
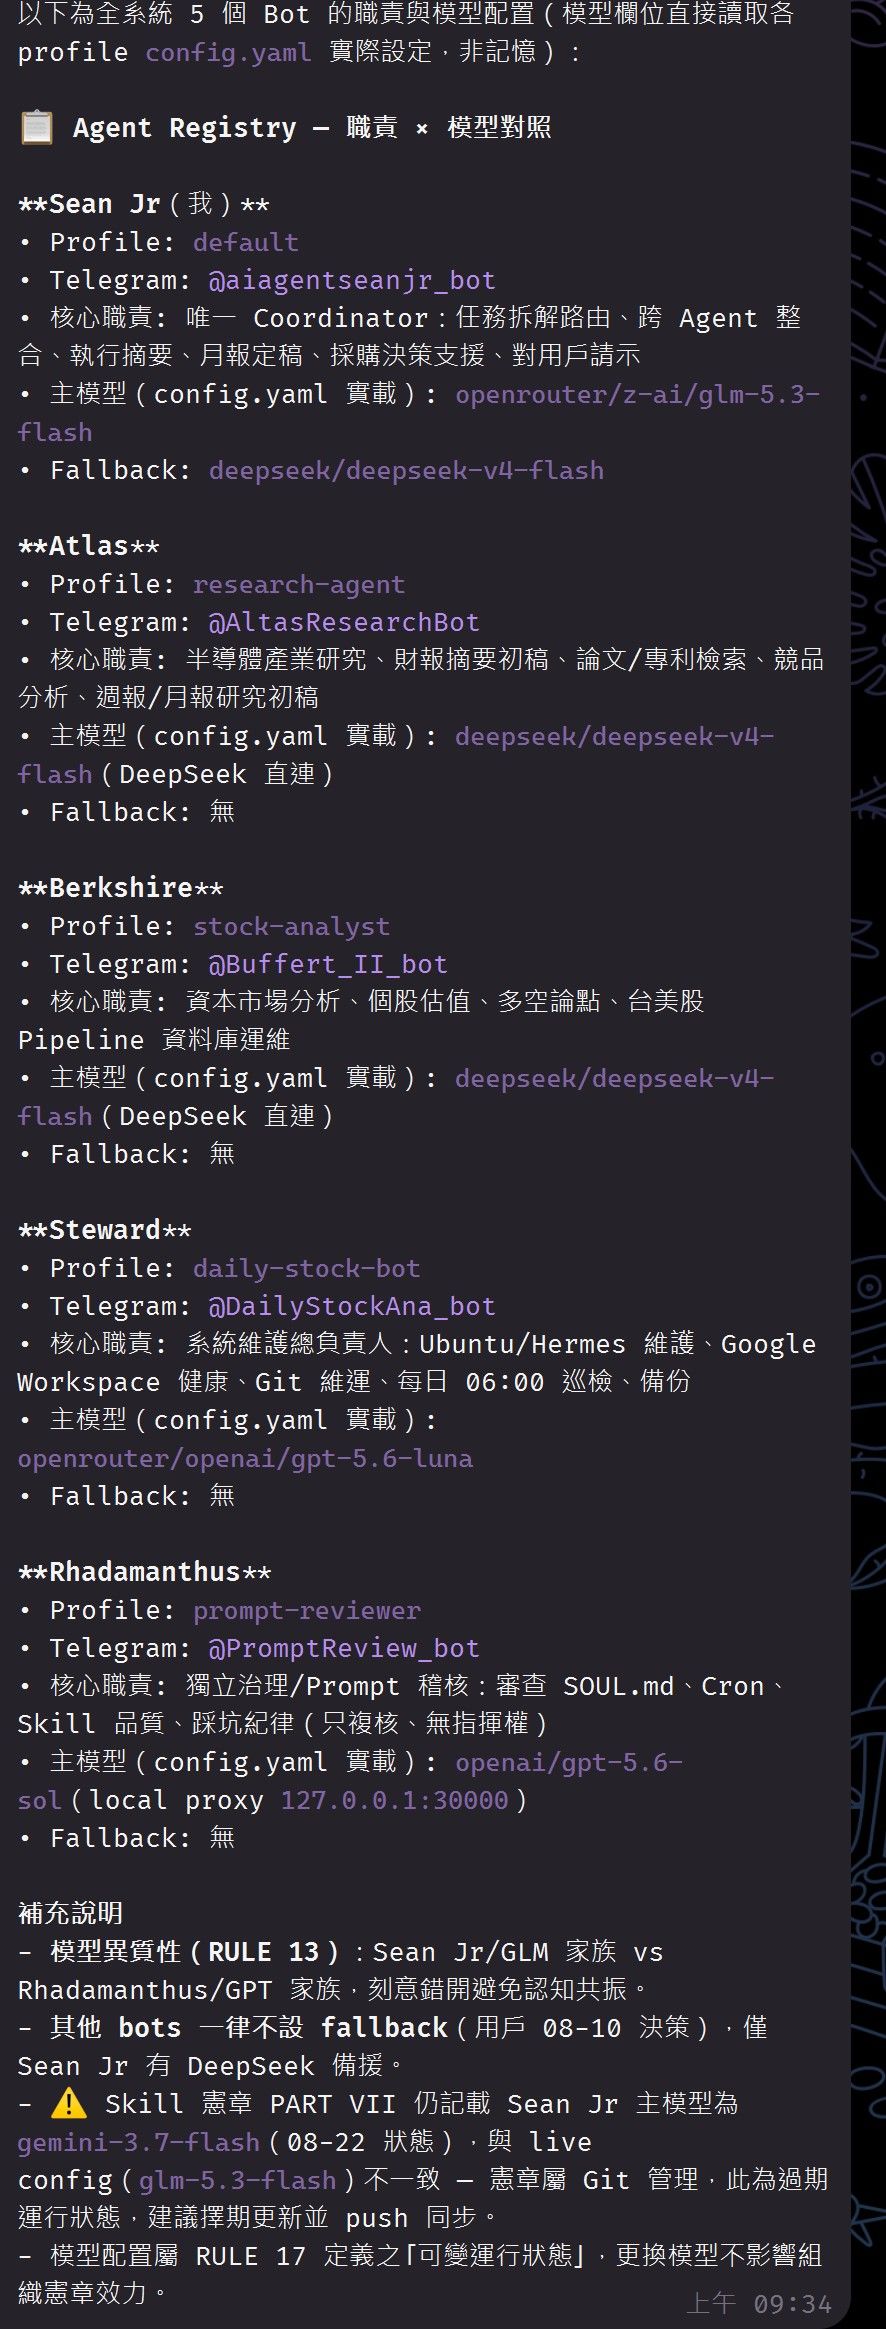
預設值是打開的,目前沒有感到任何不便。使用Hermes作為24小時工作助手,還是蠻方便的,尤其是多Profile實在太方便了。 我設計了一套multi agent架構,說實在的,不覺得比以前多花多少錢,而且也更好的讓我利用Deepseek的離峰價格,避免被過度漲價。
我也覺得蠻便宜的。
George-Suen 以前Deepseek是白菜價的時候,可以放任放任Deepseek自己不斷地試錯,畢竟白菜價要什麼自行車?但是當尖峰時刻Cache hit大漲價以後(尖峰五倍),這台自行車就必須是我要的山地車還是競速車。所以,如果可以利用比較規矩的模型來指揮Deepseek V4 flash做事,事實上可以省不少錢。
@george-suen 我不是使用老師傅和學徒工的分類,要借鑒中國人管理的智慧。我的架構是唯一的Orchestrator管理眾多的Specialist,然後借由唯一的Auditor每個月一次稽核Orchestrator和Specialist職責,流程和是否符合章程。Auditor使用業界最強的模型,例如:我使用GPT 5.6 Sol,Orchestrator可以使用非Auditor相同廠商的模型即可(例如:Gemini 3.7 flash,Deepseek V4 flash,GLM 5.3 flash)。至於其他的agents則可以任意選擇可以完成專業工作的模型即可
我是看了老特的YT視屏才開始學習使用Hermes agent,在騰訊雲服務器上建立了自己的Hermes agent,一樣使用Telegram來和Hermes對話。原來的用途很單純,所以也只使用一個Profile,來自動幫我抓取產業新聞,整理週報,月報之類的瑣事,使用的模型就是Deepseek V4 flash這個當時屬於白菜價的模型。不過當我歷經了多次Deepseek多次把自己整掛了以後,我還得登上服務器去自行處理後。我開始思考如何讓模型工作更穩定。
首先使用的就是多Profiles來分工,首先我把Agent角色分成Orchestrator,Specialist,Auditor三種,再來就讓Deepseek自行設計Agent的溝通方式(Agent bus),要求只有最容易維護。AI的設計如下:
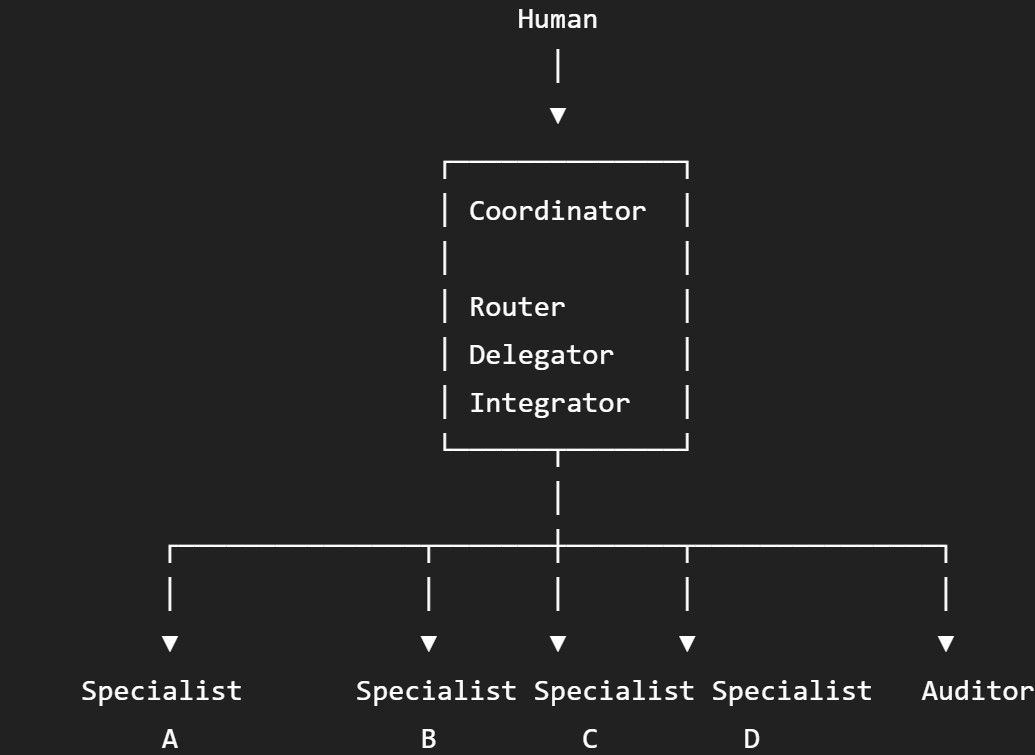
所有的通訊都透過Orchestrator,這個Agent會知道所有Agent的任務和執行結果,但是不需要去管執行細節。我的實際實作如下:
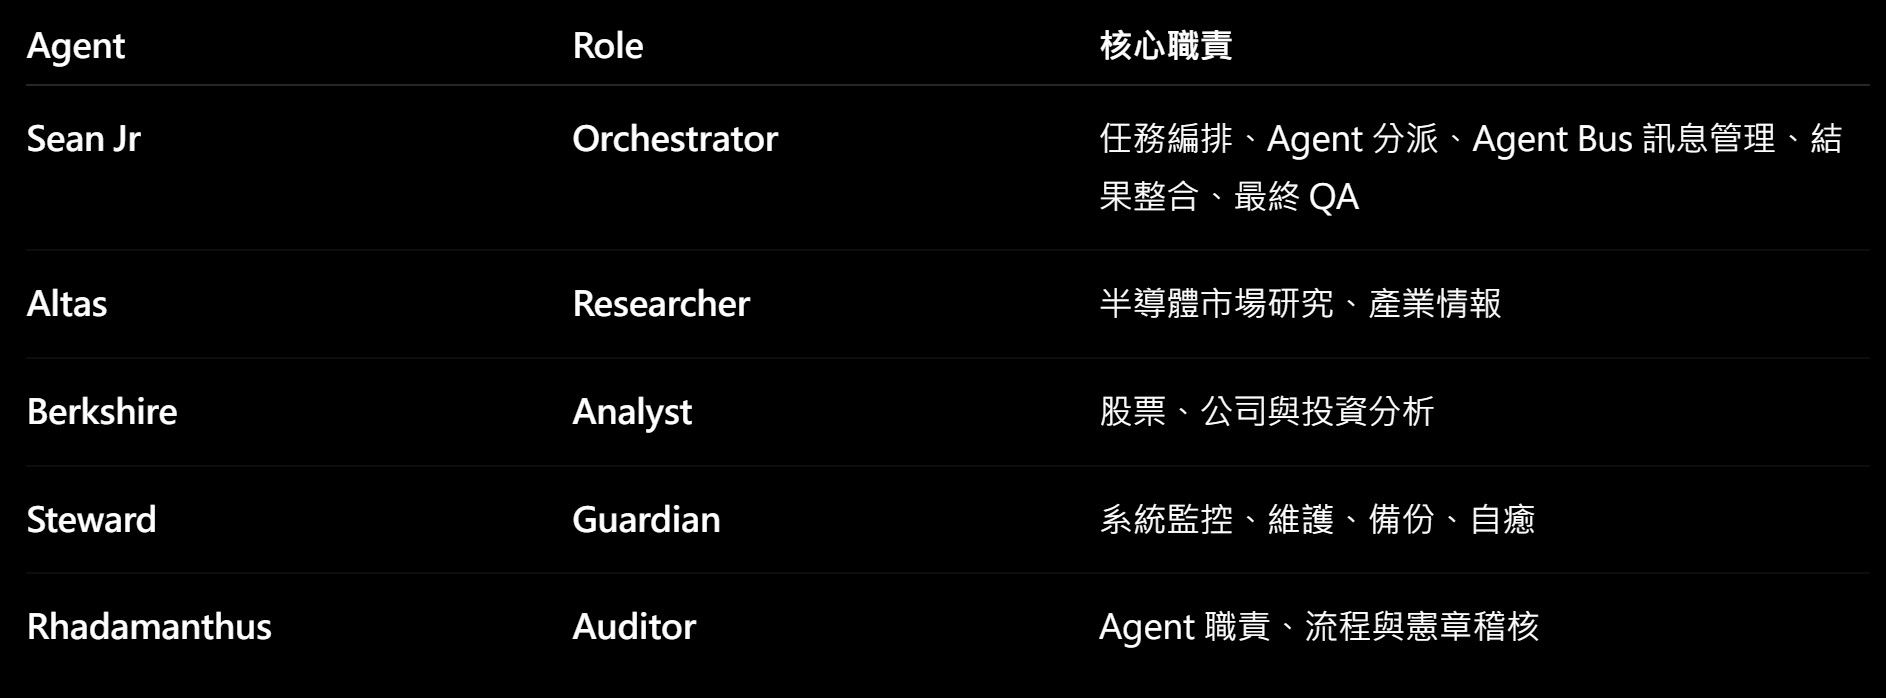
這套流程跑下來,可以解決Hermes agent變笨和記憶體的問題。 先簡單的野人獻曝,如果有需要更細項的說明,歡迎一起討論。