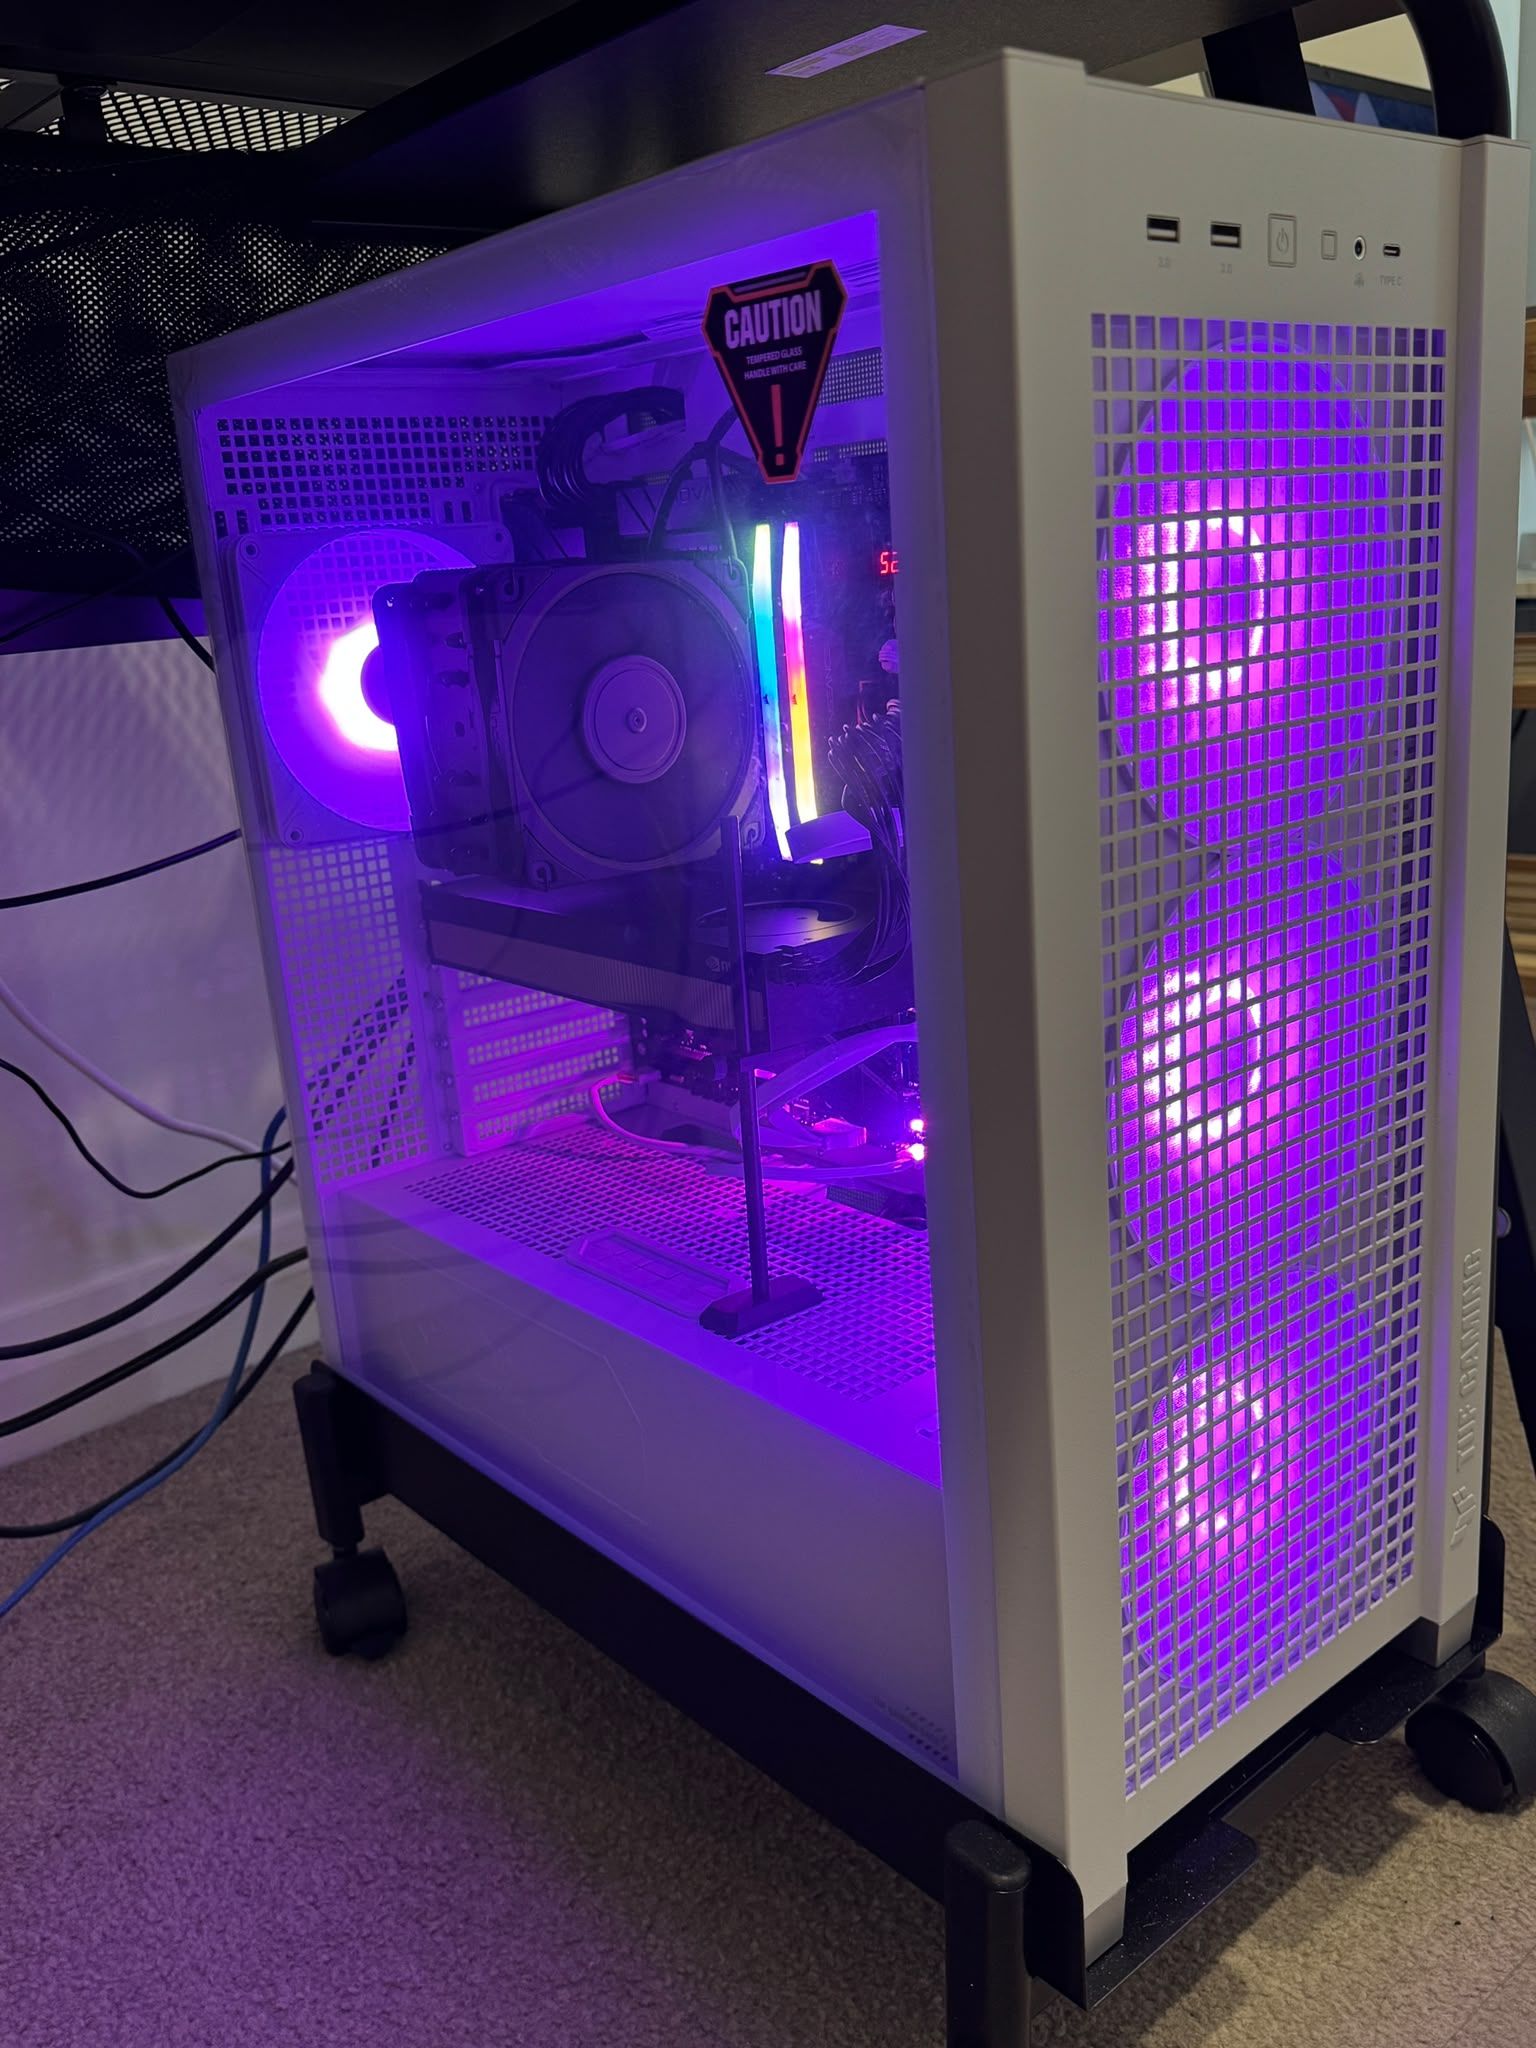
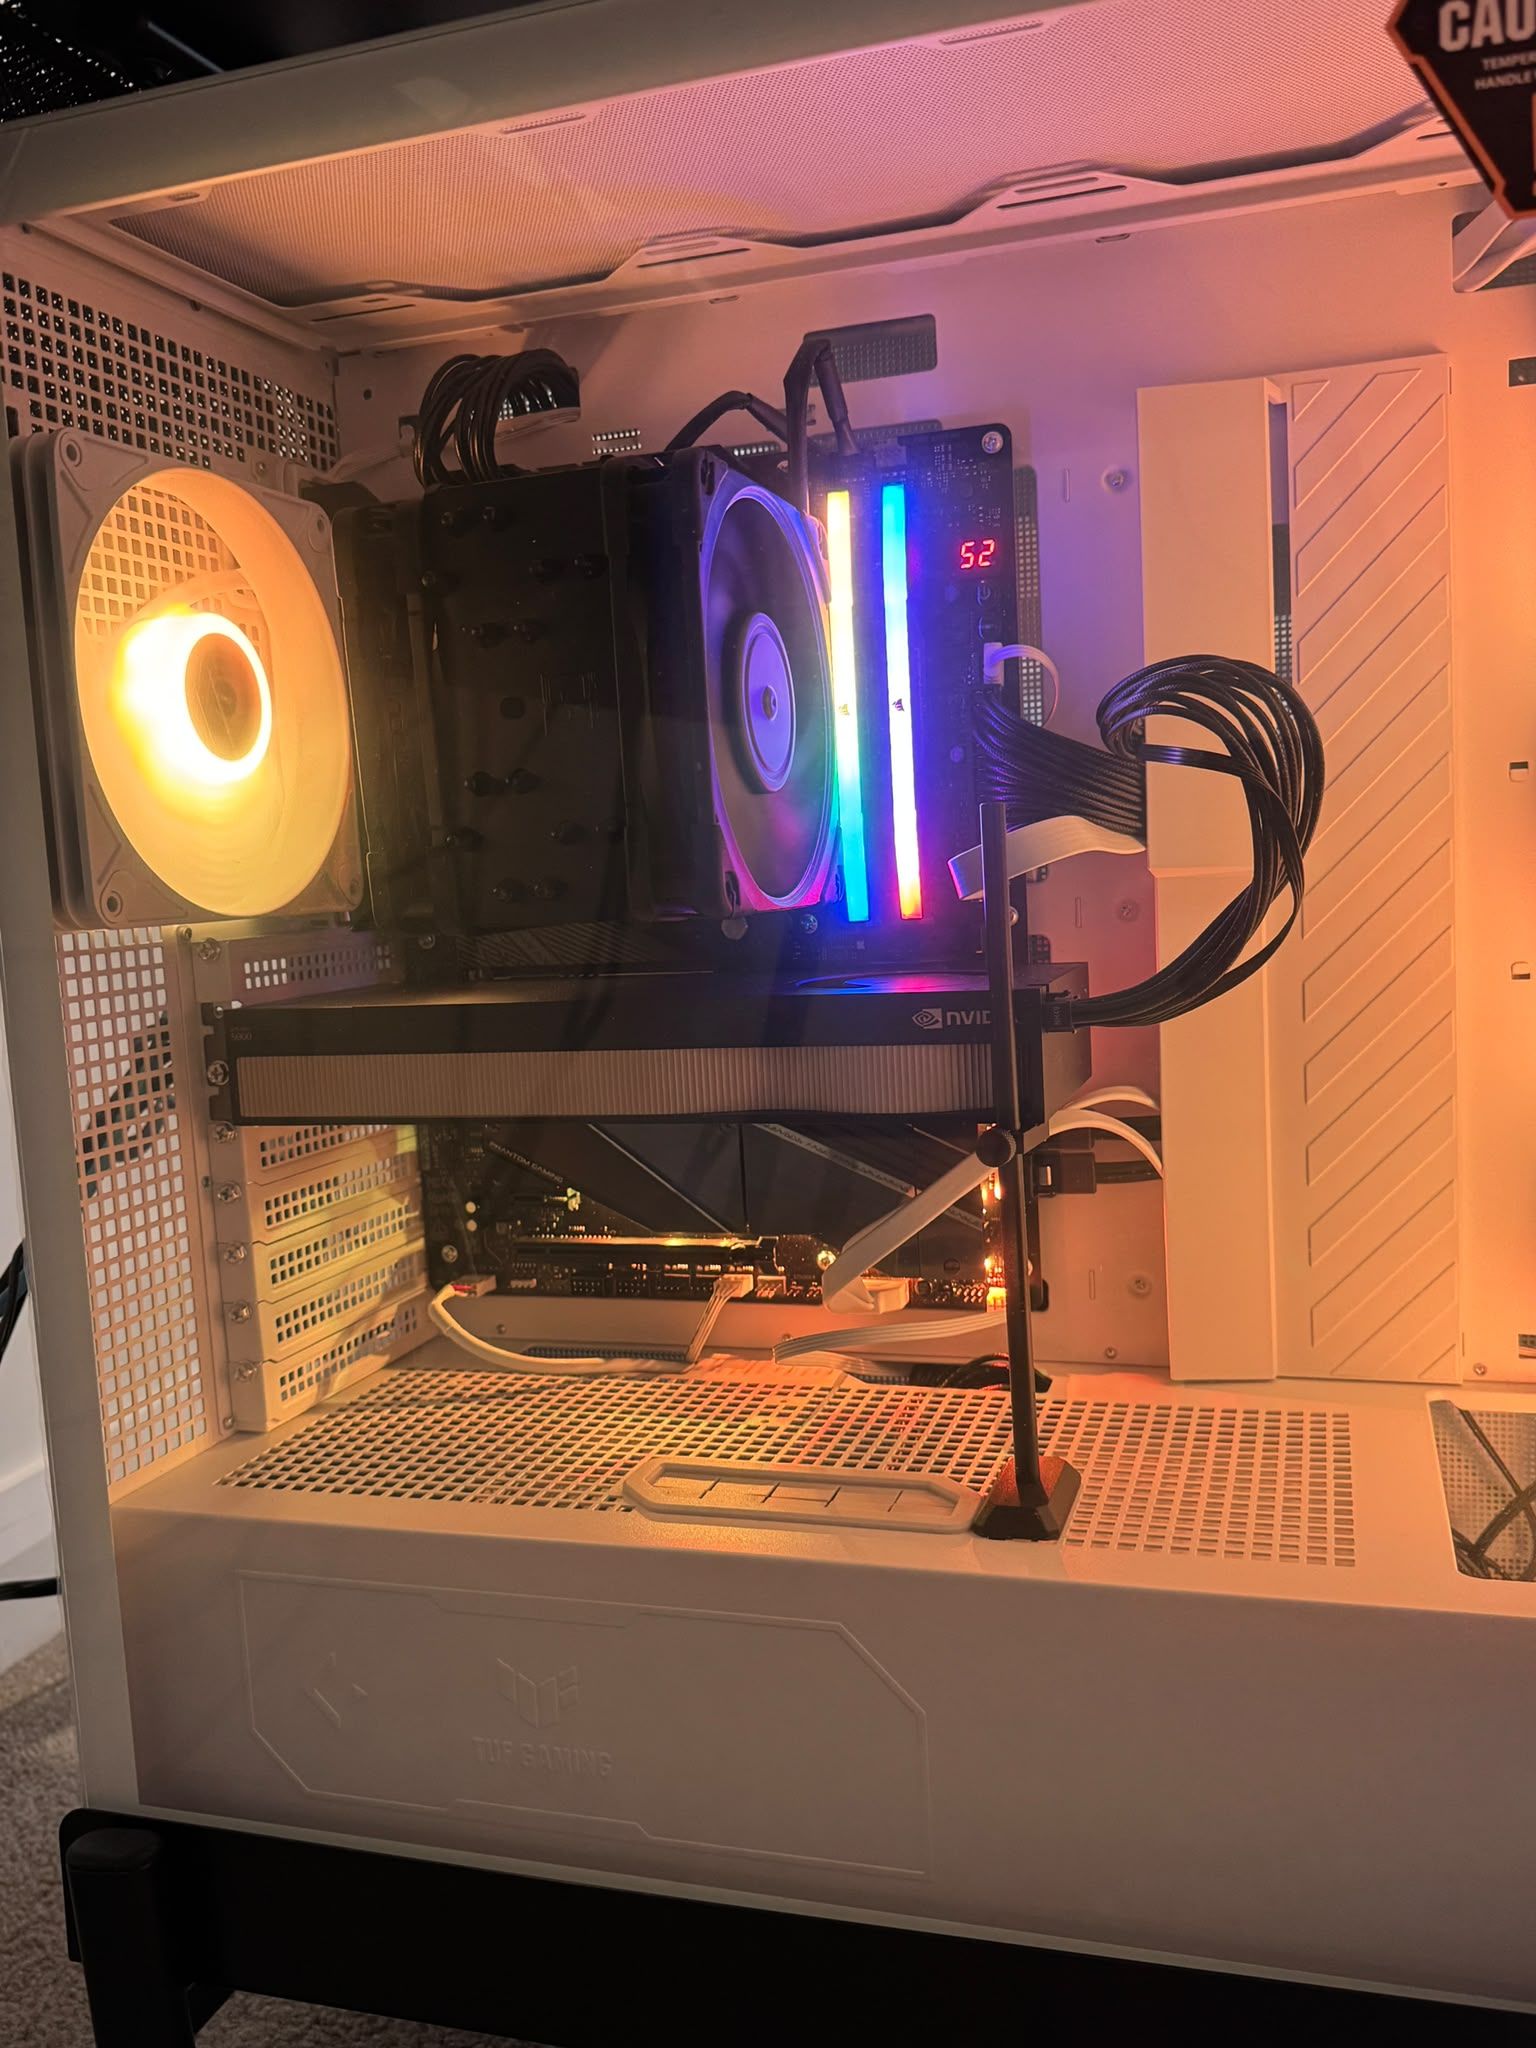
大家好,之前一直做CD-rom。這是我第一篇的文章。
我今天測試了strata,以下是測試報告。
一、測試環境
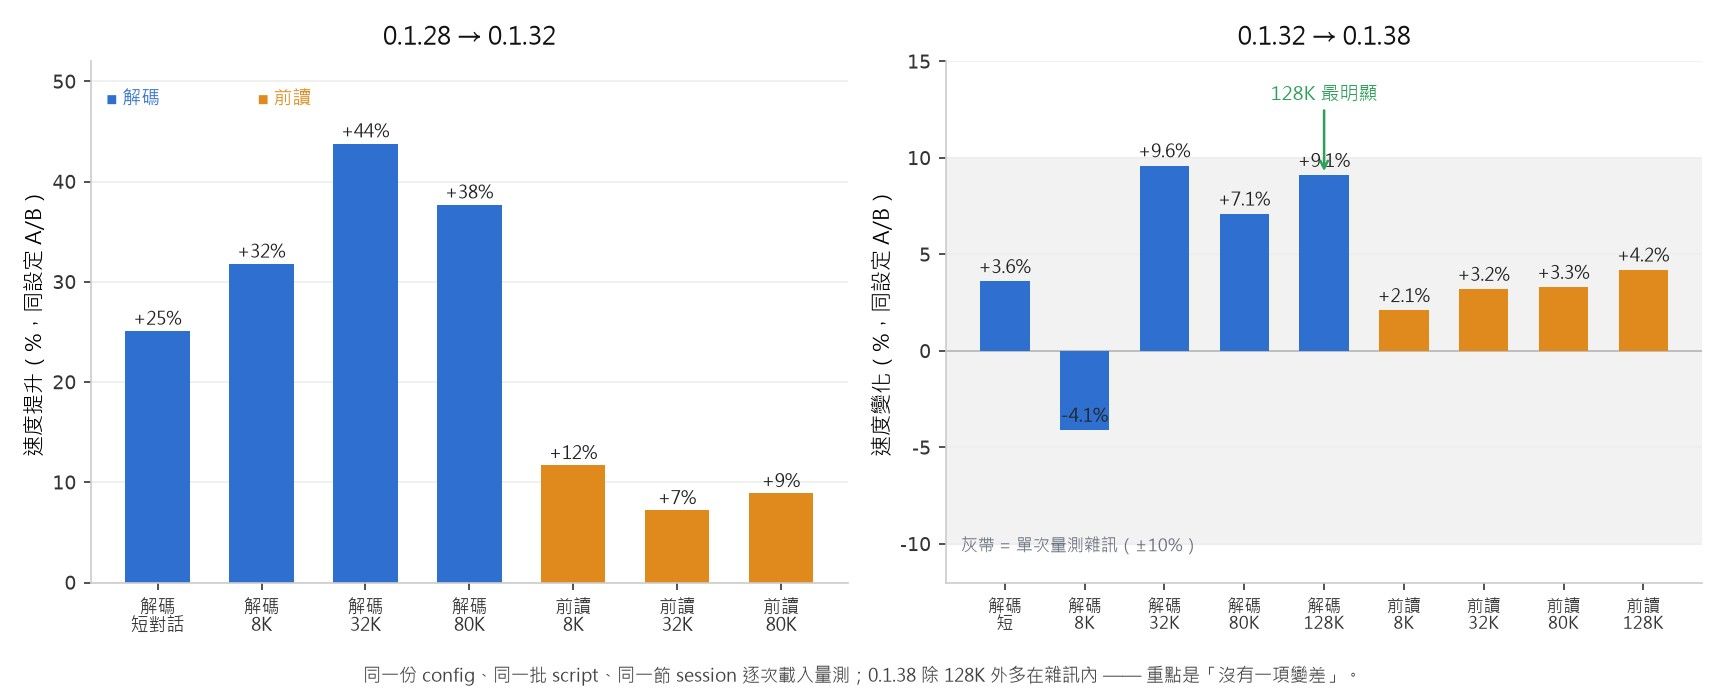
| 項目 | 規格 |
|---|---|
| GPU | NVIDIA RTX PRO 5000 72GB Blackwell(compute capability 12.0 / sm_120) |
| CPU | AMD Ryzen 9 9950X3D(16C/32T,AVX-512) |
| RAM | 96 GB(實測可用 93.6 GB)DDR5 |
| 儲存 | NVMe SSD(模型) |
| 驅動 | 616.92(CUDA UMD 13.4) |
| OS | Windows 11 |
二、安裝(完全不需要編譯)
用的是 sergqwer/strata-nvfp4 的 release bundle —— 422 MB,已內嵌 CUDA 13.3 runtime + cuBLAS,不用裝 CUDA Toolkit:
# 1. 下載 bundle(release zip 已含 strata.exe)
curl -sL -o bundle.zip https://github.com/sergqwer/strata-nvfp4/releases/download/v0.1.28-nvfp4.4/strata-nvfp4-v0.1.28-nvfp4.4-windows-x64.zip
python -c "import zipfile; zipfile.ZipFile('bundle.zip').extractall('.')"
cd strata-nvfp4

# 2. 一鍵準備模型(7 步,可斷點續跑)
cmd.exe /c prepare-model.cmd

# 3. 起 server
cmd.exe /c start-server.cmd
prepare-model.cmd 會建立自己的 venv、下載 126 GB checkpoint、然後跑完 7 個轉換步驟:
| 產出檔案 | 大小 |
|---|---|
checkpoint\(來源,可刪) |
126 GB |
ple-fp8.gguf(n-gram 表,FP8) |
48 GB |
orca-nvfp4.gguf(NVFP4 權重) |
69 GB |
pack\experts.bin(expert arena) |
64 GB |
token-embd-bf16.gguf |
1.2 GB |
mmproj-f32.gguf(vision tower) |
1.7 GB |
mtp\rt\experts.bin(draft head) |
675 MB |
126 GB 下載實測 43 分鐘(我這邊沒裝 hf_xet,fallback 到普通 HTTP)。完成後 models\ 約 317 GB,其中 checkpoint 那 126 GB 可以刪掉。
Large pages(建議開)
powershell -ExecutionPolicy Bypass -File tools\enable-large-pages.ps1   # 需要 admin
# 之後一定要登出再登入,或重新開機
小提醒:我第一次跑
secedit回傳 exit 1 失敗,再跑一次就 exit 0 成功。看到 exit 1 就再執行一次。
效果:冷載入從 26.6s(4KB 分頁)降到 18.8s(2MB 大頁)。
三、實測數據
3.1 Decode / Prefill
| Decode 場景 | 結果 |
|---|---|
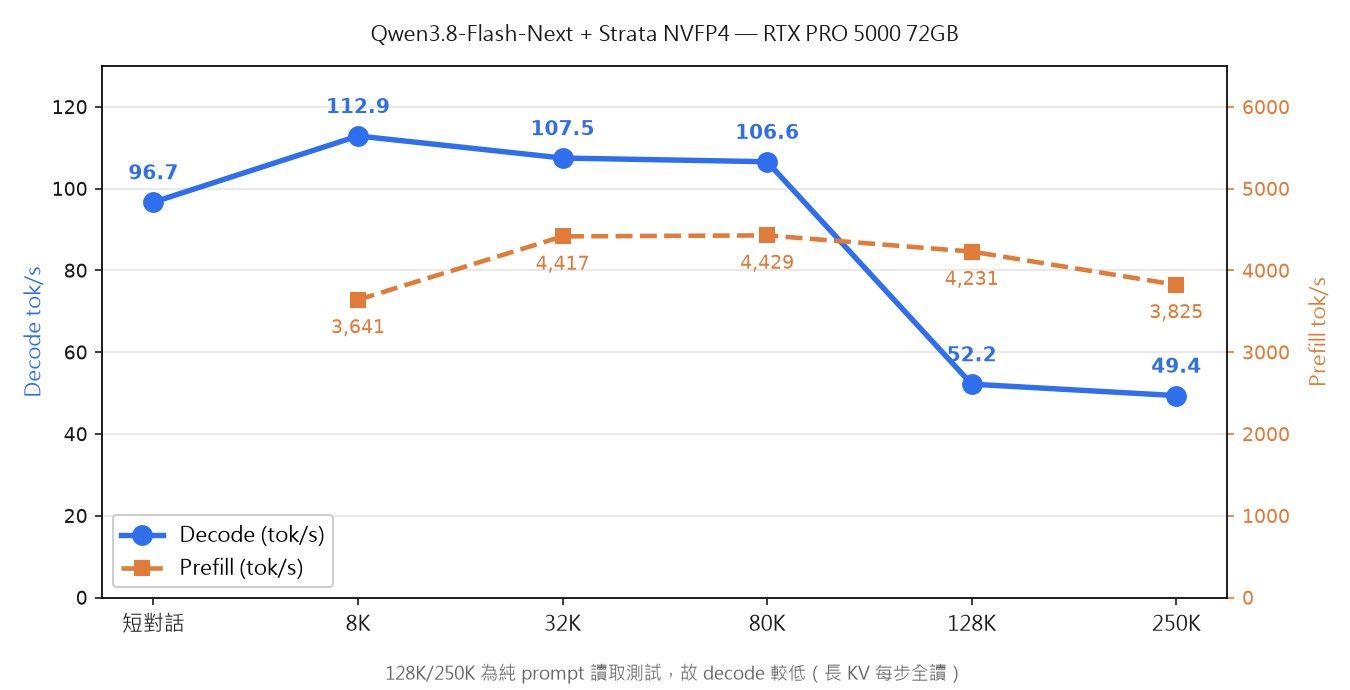
| 短對話(冷) | 96.7 tok/s |
| 穩定輸出 1000 tokens | 91.2 tok/s(10.96 ms/token) |
| ~8K context | 112.9 tok/s |
| ~32K context | 107.5 tok/s |
| ~80K context | 106.6 tok/s |
| Prefill | 結果 |
| --- | ---: |
| ~8K | 3,531 – 4,087 tok/s |
| ~32K | 4,417 – 5,069 tok/s |
| ~80K | 4,429 – 5,074 tok/s |
(官方在 RTX 5090 32GB + 128GB RAM 上測到約 115 tok/s,我這邊數字相當)
3.2 資源佔用
| 數值 | |
|---|---|
| VRAM | 69.0 / 73.4 GB |
| Expert cache | 21,278 slots / 54.79 GiB |
| Expert cache 命中率 | 98.3 – 99.9%(每個 request) |
| RAM | 84.6 / 93.6 GB(63.28 GiB arena pinned) |
| Commit | 155 / 189.6 GB |
| 冷載入 | 18.8 秒(大頁) |
對照:RTX 5090 32GB 只有 7,352 slots,這張卡有 21,278 slots(2.9×)。不過實際 decode 速度差不多——5090 的記憶體頻寬(GDDR7)抵銷了 cache 較小的劣勢。
3.3 長 context
| prompt | Prefill | 首 token | Decode |
|---|---|---|---|
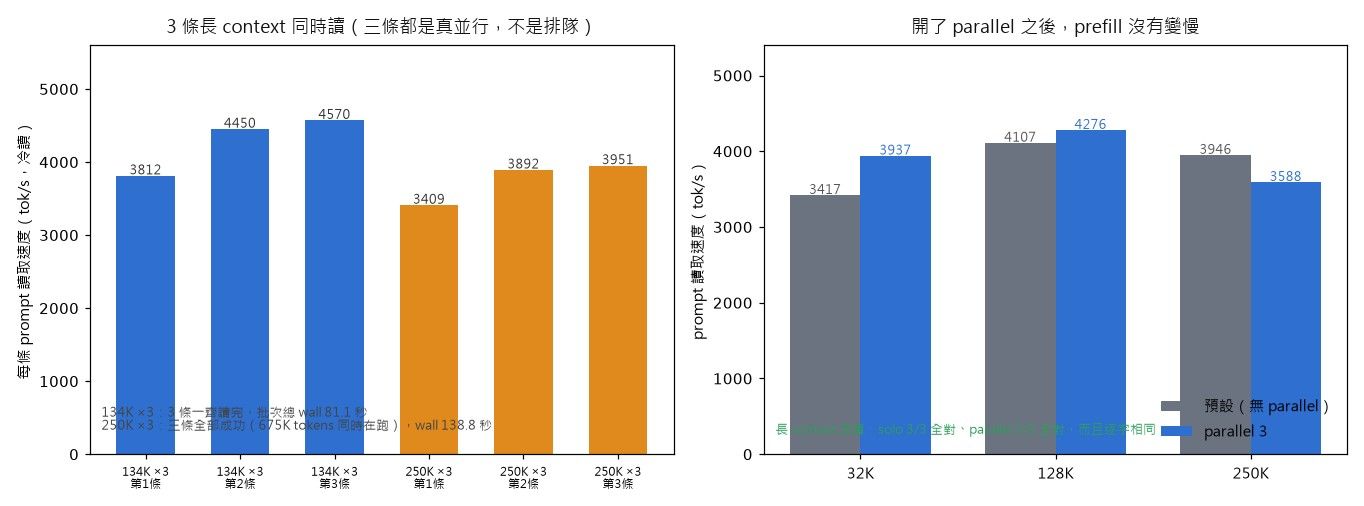
| 28,905 tok(~32K) | 4,685 tok/s | 6.2s | 66.4 tok/s |
| 121,479 tok(~128K) | 4,231 tok/s | 28.7s | 52.2 tok/s |
| 235,870 tok(~250K) | 3,825 tok/s | 36.6s | 49.4 tok/s |
上限 --max-context 262144。decode 會隨 context 變長而下降(66 → 52),因為每步都要讀完整 KV。
3.4  ️ 並行 —— 這是單流引擎
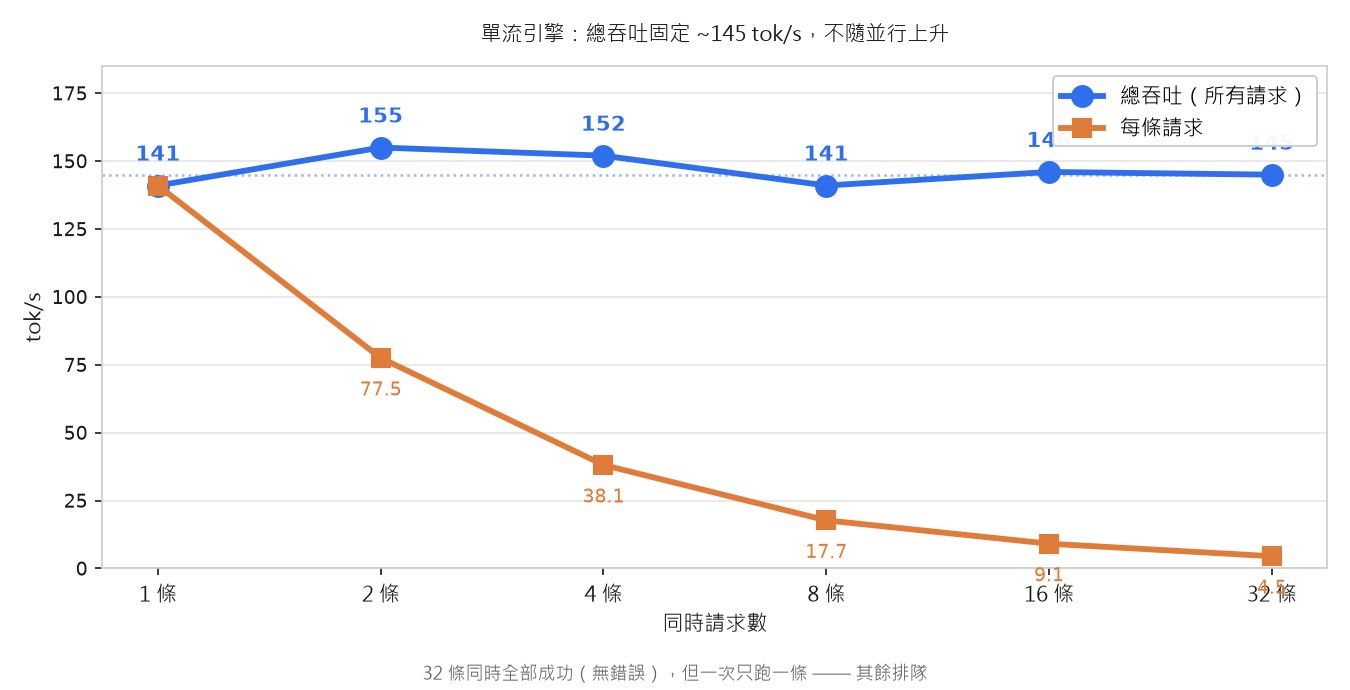
這點很多人在意,我實測了完整的 1→32 並行:
| 同時 N 條 | 總吞吐 | 每條實際 | 成功 |
|---|---|---|---|
| 1 | 141 tok/s | 141 | 1/1 |
| 2 | 155 | 77.5 | 2/2 |
| 4 | 152 | 38.1 | 4/4 |
| 8 | 141 | 17.7 | 8/8 |
| 16 | 146 | 9.1 | 16/16 |
| 32 | 145 | 4.5 | 32/32 |
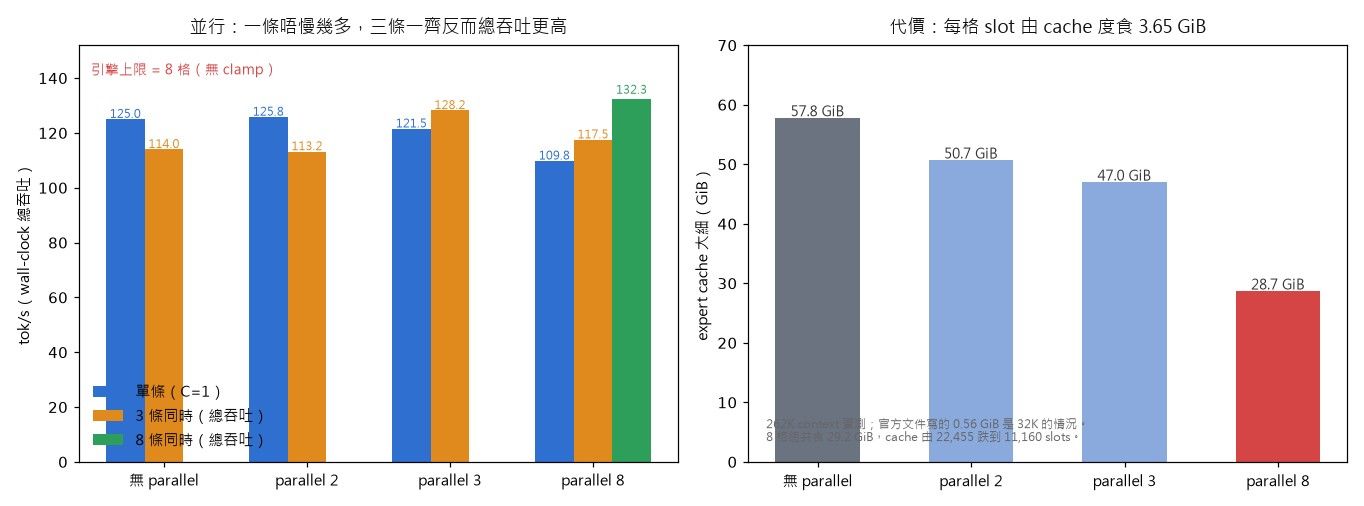
總吞吐一直維持在 ~145 tok/s,完全不隨並行數上升。 收多少 client 都可以(32/32 零錯誤),但一次只跑一條。
證明是排隊而不是 batching:同時丟 3 個 128K prompt,完成時間是 29.6s / 58.2s / 86.8s——一個接一個。如果是 batched 會差不多時間一起完成。
我自己一開始量錯過:把每個 request 自報的
decode_tok_s相加,得到「4 條 365 tok/s」的錯誤數字。正確做法是 wall-clock:總 output tokens ÷ 總 wall time。
3.5 Prefix cache —— 同一個 session 極快,兩個 session 互相沖掉
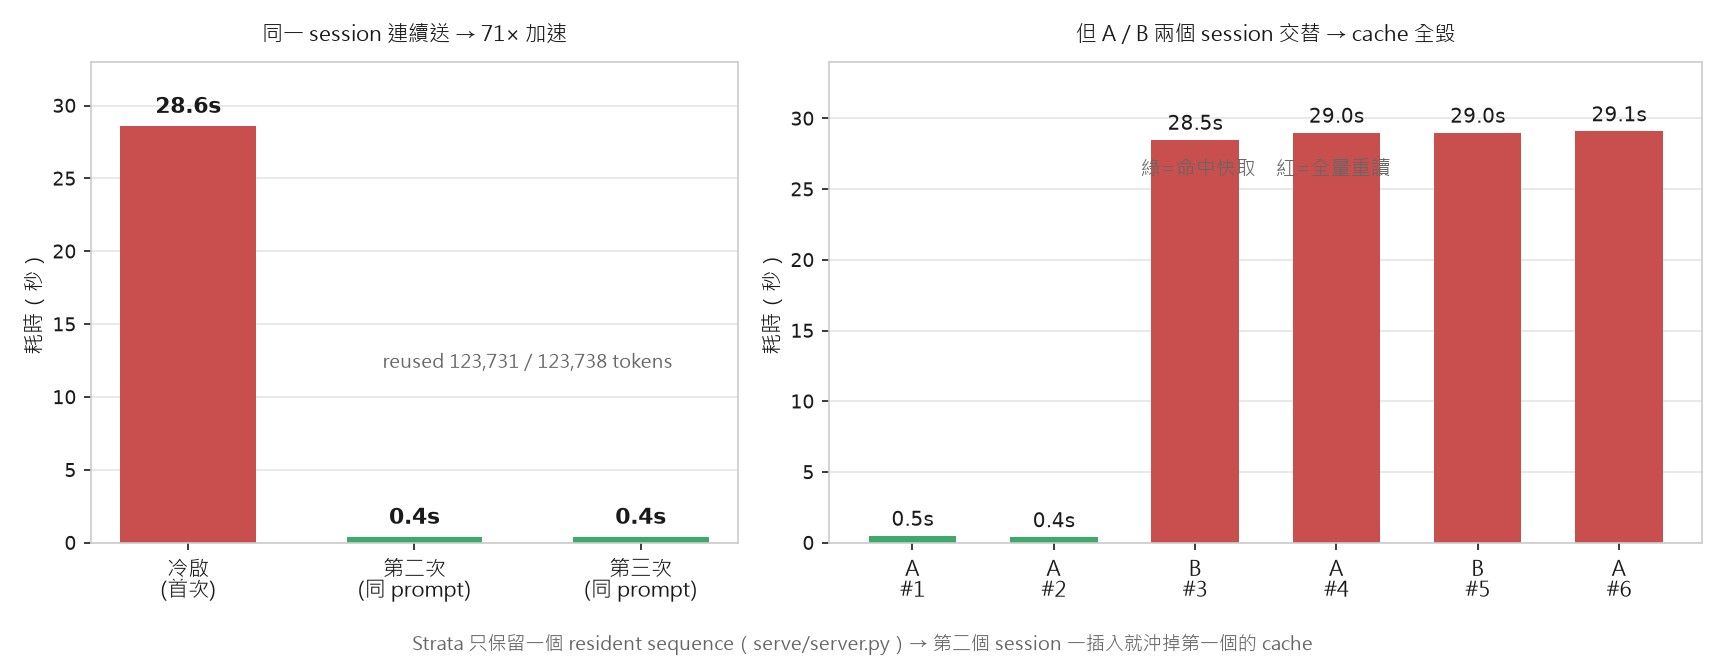
這是我覺得最值得分享的發現。
同一個 prompt 連送三次:
| 次數 | 耗時 | reused | read |
|---|---|---|---|
| 1(冷) | 28.6s | 0 | 123,738 |
| 2 | 0.4s | 123,731 | 7 |
| 3 | 0.4s | 123,731 | 7 |
→ 28.6s → 0.4s(71×)。Prefix cache 是有效的,而且很強。
但是——A / B 兩個不同 session 交替時:
| 步驟 | agent | 耗時 | reused |
|---|---|---|---|
| 1 | A | 0.5s | 123,731 |
| 2 | A | 0.4s | 123,731 |
| 3 | B | 28.5s | 0 |
| 4 | A | 29.0s | 0 |
| 5 | B | 29.0s | 0 |
| 6 | A | 29.1s | 0 |
原因寫在 serve/server.py 開頭:
"One sequence at a time behind a FIFO (plan: one resident sequence)"
只 cache 一個 resident sequence,所以 B 一插入就沖掉 A 的 cache。
→ 實務結論:跑兩個長 context 的 coding agent 時,兩邊每一輪都要重讀全部 context(~29s)。 不是「慢一半」,是兩邊都變慢 70 倍。
| context | 每輪 prefill(兩個 agent 交替) |
|---|---|
| 130K | ~29s |
| 60K | ~14s |
| 30K | ~7s |
3.6 Vision(讀圖)
| 圖片 | image tokens | 耗時 | 讀對? |
|---|---|---|---|
| 256×256 | 66 | 1.1s |  |
| 1024×768 | 770 | 5.8s | |
| 1920×1080 | 1,010 | 8.1s | |
| 3840×2400 | 1,002 | 8.1s | |
image token 上限約 1,024/張 → 4K 圖和 1080p 一樣貴。
時間瓶頸是 CPU 圖像編碼,不是 LLM。 證據:64 張 frame 共 14,234 tokens,引擎實際只花 3.6 秒讀完,但總耗時 86.1 秒——其中約 82 秒是 CPU 編碼。編碼吞吐約 130–175 image-tokens/s。
準確度測試(我自己畫的圖表,含標題、四個數值、一組 REF code):6/6 全對。
# serve/server.py 第 496 行 — vision embedding cache
if len(self.cache) > 64:
    old = next(iter(self.cache))
    self.cache.pop(old)[0].unlink(missing_ok=True)   # 刪掉 .sve 檔

# 但第 771/789 行是「先全部 encode,之後才讀檔」
encoded = [self.vision.encode(src) for src in images]
for path, _ in encoded:
    f.write(path.read_bytes())      # FileNotFoundError:已被驅逐
超過 64 張時,最前面那批
.sve會在後續 encode 時被驅逐刪掉。Server 不會掛,下一個 request 正常。context 本身不是瓶頸(262,144 ÷ 770 ≈ 340 張)。
3.7 STRATA_PREFILL_NVFP4 調校:w4a8 vs w4a4
| context | w4a8(預設) |
w4a4 |
提升 |
|---|---|---|---|
| ~8K | 3,641 | 4,087 | +12.2% |
| ~32K | 4,417 | 5,069 | +14.8% |
| ~80K | 4,429 | 5,074 | +14.6% |
但代價(官方 docs/NVFP4.md,first-token KL vs fp16):
| mode | KL mean | top-1 一致率 |
|---|---|---|
| w4a8 | 0.0018 | 8/8 |
| w4a4 | 0.0080(差 4.5×) | 7/8 |
只快 prefill,decode 完全一樣。 檢索能力我也實測過(needle-in-haystack 6/6、5 針一次問齊 5/5,兩個模式都過)。
→ 建議保留預設 w4a8。
3.8 長 context 品質驗證
很多人問「接近 260K 會不會變笨/失憶」,我實測了:
| 測試 | 2K | 32K | 128K | 200K | 250K |
|---|---|---|---|---|---|
| 單針檢索(深度 10/50/90%) | — | 3/3 | 3/3 | 3/3 | 3/3 |
| 5 針一次問齊 | — | — | — | — | 5/5 |
| 多跳推理(兩個事實隔 90% 距離要組合) | |
|
|
|
|
多跳推理是關鍵測試(retrieval 測不出「變笨」):兩個事實分別插在 5% 和 95% 的位置,答案是 VELMORA-7719,從 2K 到 250K 完全一致。
不會變笨。 原因:262,144 是原生訓練窗口(不是 YaRN 外推),而且模型有 QSA sparse attention + indexer budget。
順帶一提:Strata 曾經有一個真正的長 context bug——RoPE 用 fast-math 角度,在 262K 時差約 0.02 rad。已修(改用 float64 angle table)。
3.9 ️ 但有一個硬牆:~245.7K
prompt + max_tokens ≤ 262,136 (max_context 262144 − CTX_SLACK 8)
| prompt | 最多可出 | 若 client 要 16384 |
|---|---|---|
| 230K | 32,136 | |
| 245K | 17,136 | ← 轉折點 ≈ 245,752 |
| 250K | 12,136 |  HTTP 400 |
| 260K | 2,136 | |
超過的錯誤訊息:"prompt (N tokens) + max tokens (M) exceeds the context (262144); requests are never truncated"
過去的話不是「慢慢變笨」,是 session 直接壞死(每個 call 都 400)。
四、模型大小 / 量化
Flash-Next 跟一般 dense 模型不一樣——不能只挑一個 Q4/Q8 檔:
176B = 125B backbone + 51B n-gram 表 + 4B MTP,而那個表的大小不隨量化縮小(GGUF 版固定 26.85 GiB IQ4_NL/Strata 版 48 GB FP8)。
| 級別 | 磁碟總計 | 其中 n-gram 表 | GPU 必需 |
|---|---|---|---|
| BF16(原始) | 329.7 GiB | — | 裝不下 |
| FP8 | 172.8 GiB | 47.7 | 裝不下 72GB 卡 |
| Q8_0(GGUF) | 174.65 GiB | ~26.9 | ~148 |
| UD-Q4_K_XL | 103.68 | 26.85 | 76.82 |
| UD-IQ4_XS | 87.24 | 26.85 | 60.38 |
| UD-IQ3_XXS | 76.32 | 26.85 | 49.47 |
| UD-IQ1_S(最小) | 67.55 | 26.85 | 40.70 |
範圍 67.55 → 329.7 GiB(4.9×);對比 27B 的 15.66 → 27.05 GB(1.7×)。差距窄是因為那張 26.85 GiB 的表佔最小版本的 40%。
我目前跑的 NVFP4 ≈ 4.5-bit,工作集約 184 GB(表 48 GB + 權重 69 GB + arena 64 GB),但 VRAM 常駐只需 69 GB——因為 experts 放 RAM、表串流自 SSD。
量化對輸出的影響
官方(unsloth)對 Qwen3.8 做的 NVFP4 vs BF16 實測:
| 領域 | KLD mean | top-1 一致率 |
|---|---|---|
| 中文 | 0.0163 | 93.55% |
| 程式碼 | 0.0260 | 96.68% |
| 閒聊 | 0.0582 | 92.15% |
→ NVFP4 保留約 92–97% 的 BF16 品質(寫程式最抗跌)。
而 1-bit 家族(KLD 0.56–1.11)比 NVFP4 差 10–20 倍,top-1 掉到 66–79%。過 4-bit 之後就開始急墮。
另外這個 checkpoint 的 model card 寫明:NVFP4 只量化 routed experts,attention、Gated-DeltaNet、router、shared experts、hyper-connections、PLE、embeddings、LM head、MTP 全部保留高精度。這是「保護好所有關鍵模組、只壓縮大宗 FFN」的配方——尤其 router 不量化對 MoE 至關重要。
五、實測踩過的坑
- thinking 預設開啟——Qwen3.8 會先輸出
reasoning_content,可能吃光max_tokens讓content變 null。要關就送chat_template_kwargs: {enable_thinking: false} enable-large-pages.ps1第一次可能 exit 1 → 再跑一次fit_max_tokens是 server 層設定——一開全機所有 client 都受影響。我沒有開,因為:① 我的 harness 會在 0.8 × contextWindow ≈ 209.7K 自動 compact,距離 245.7K 硬牆有約 36K 餘裕;② clamp 會把「寫檔案/JSON/tool call」的答案剪短,產生半截檔案——比一個明確的 400 更危險
六、結論
| 數值 | |
|---|---|
| Decode | 91–113 tok/s(短→8K context) |
| Prefill | 4.4–5.1K tok/s |
| VRAM 常駐 | 69 GB(單卡 72GB 可跑) |
| Expert cache | 21,278 slots,98–99.9% 命中 |
| 冷載入 | 18.8 秒 |
| 250K context | 可用,品質零退化 |
| 並行 | ️ 單流,總吞吐固定 ~145 tok/s |
| Prefix cache | ️ 同 session 71× 加速,兩個 session 互相沖掉 |
適合:
- 單一重型 session(長 context、要品質、要離線)
- 需要 250K context 又不想上雲
不適合:
- 多個 agent 並行(會互相沖掉 prefix cache,每輪 ~29s)
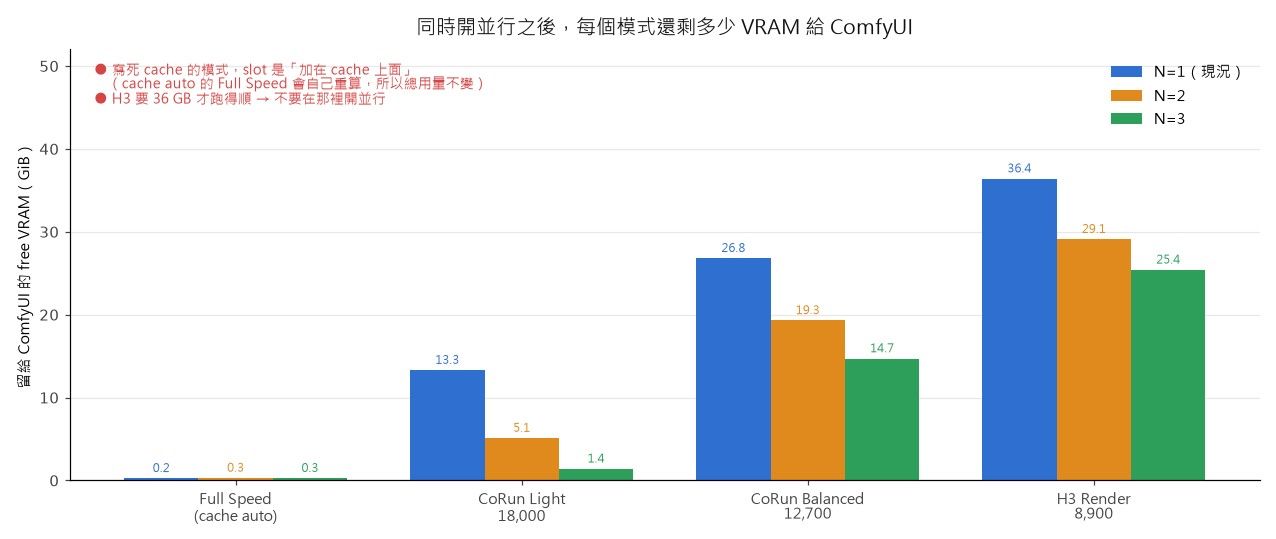
- 需要同時跑其他 GPU 工作
在 72GB 單卡上,這是我目前找到最好的 Flash-Next 方案。官方在 5090 32GB 測到約 115 tok/s,這張卡因為 VRAM 大了一倍多,expert cache 多 2.9 倍(21,278 slots),但受限於單流架構,實際吞吐相當。
結論:這是目前少數能在 72GB 單卡上跑,同時又保有 MTP speculative decoding 的 Flash-Next 路線。
TL;DR
- RTX PRO 5000 72GB 單卡可跑,完全不必編譯(release bundle 已內含 CUDA runtime)
- Decode 91–113 tok/s、Prefill 4.4–5.1K tok/s、VRAM 常駐 69 GB
- 250K context 可用,且品質零退化(含多跳推理)
prompt + max_tokens ≤ 262,136),超過直接 HTTP 400
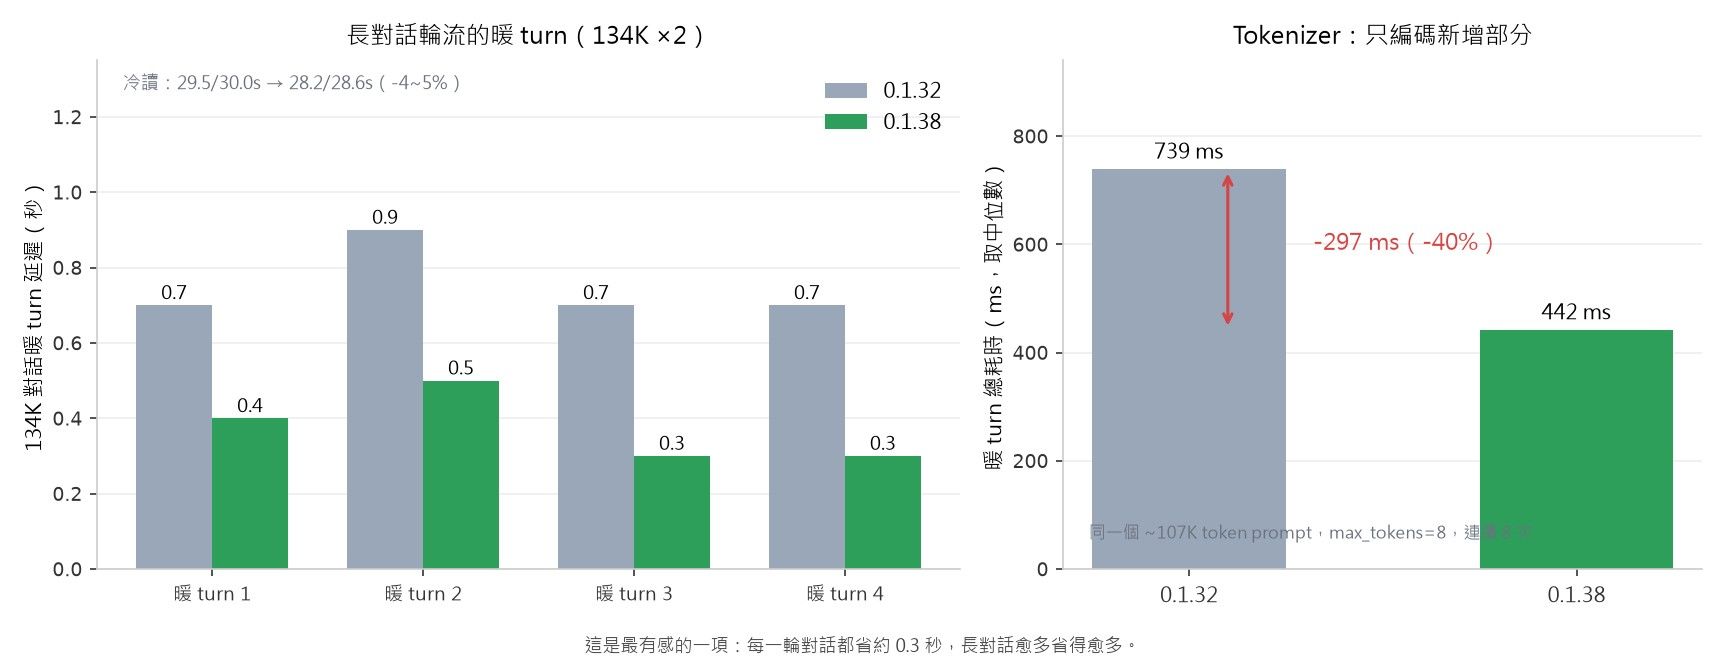
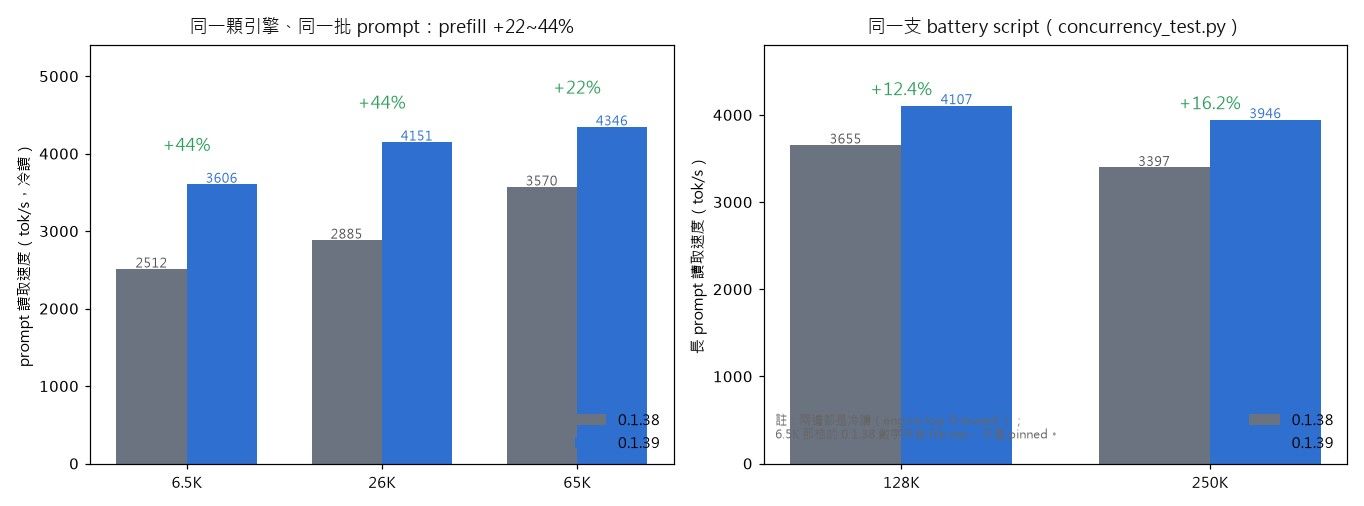
 最有感的一項:0.1.38 的 tokenizer 只編碼新增部分 —— 同一個 107K prompt,暖 turn 由 739 ms → 442 ms(-40%)