
Strata NVFP4 版本更新實測 —— 0.1.38 → 0.1.39:prefill 快 22~44%、加了「並行」
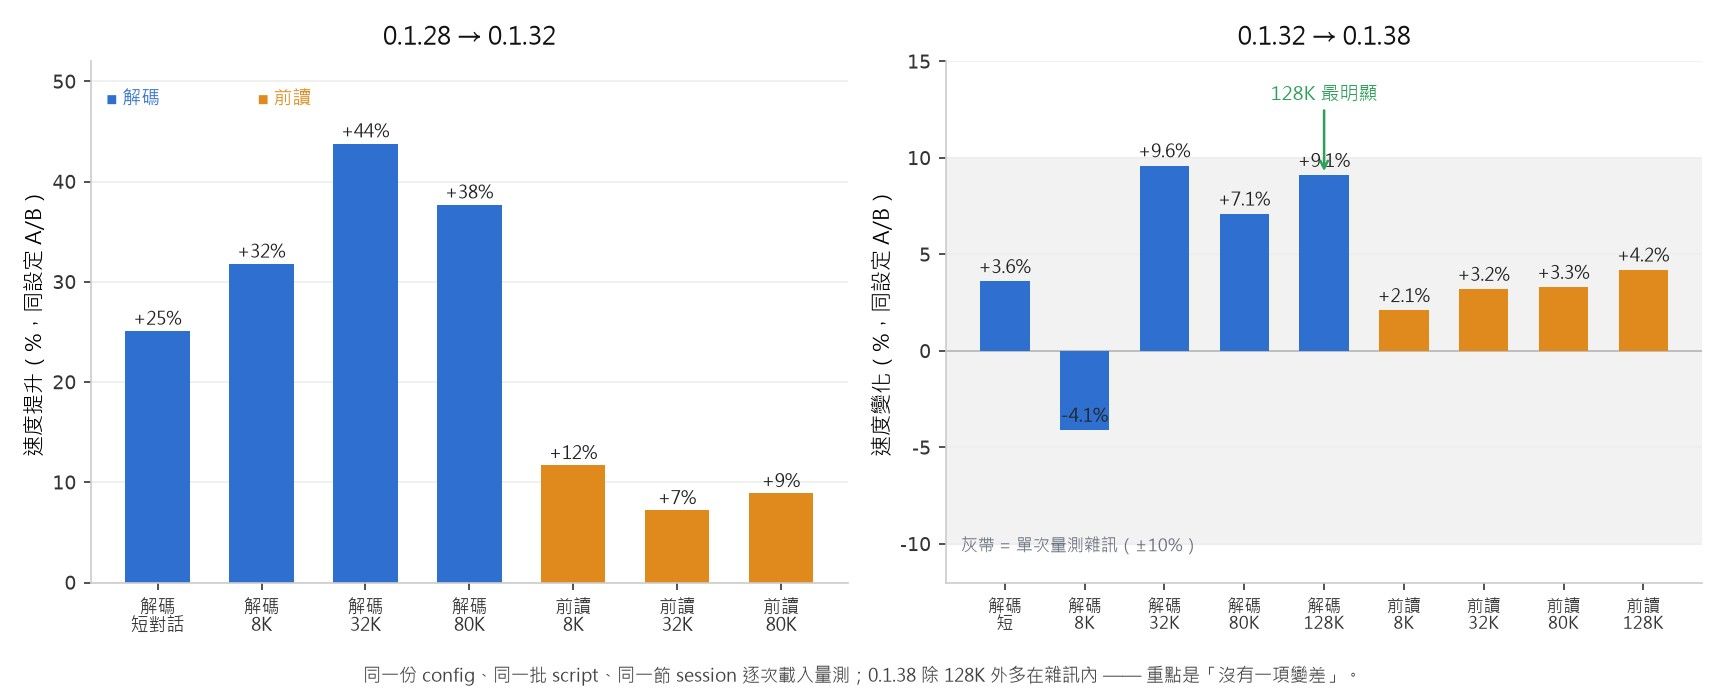
上次在同一塊板貼過 72GB 單卡跑 Qwen3.8-Flash-Next(176B MoE)+ Strata NVFP4 的完整數據(0.1.28 → 0.1.32 → 0.1.38)。這次補 0.1.38 → 0.1.39。
這版官方 release note 寫得很少(「verify pass 少幾個 launch、long prompt ring 改成按 bytes 計」),我本來以為只是小更新。實測之後不是 —— 這版有一個對「像我這種用 file-tier 的人」影響很大的修正,而且第一次出現引擎層的並行。
先講結論:
TL;DR
0.1.39 修好了 #577:0.1.38 在「有 RAM budget」的設定下把 prompt 讀取判斷錯了,每個 prompt 之後都去讀硬碟 → 我這裡冷讀 prefill 是 2,511 / 2,885 / 3,570 tok/s,升上 0.1.39 變成 3,606 / 4,151 / 4,346(+44% / +44% / +22%)
️ 上游和 fork 都說這版 prefill「沒變」 —— 因為他們的測試機把 experts 全放 RAM;#577 只在 file-tier / 有
--ram-budget的設定才咬。所以:你是 file-tier 就賺到,是 pinned 就無感。怎麼分辨我寫在第 2.3 節
"parallel": N(2~8):引擎層同時解碼 N 條對話。 上限 8 格;我這裡一條不慢(N=2 幾乎零、N=3 只 −3%),3 條同時反而總吞吐更高(114 → 128 tok/s)--conversation-cache-mib。 關掉對話 cache 之後,3 條 134K 對話交替,每一輪都退回冷讀 23~26 秒 —— 三條長對話保溫靠的是對話 cache,不是 slot--expert-cache」的 co-run 模式裡,slot 是加在 cache 上面 → H3 模式讓出的 36 GB 會變 25 GB!(要手動重啟引擎)
一、版本時間線
| 版本 | 日期 | 主打 |
|---|---|---|
| 0.1.39 | 10-04 | decode verify pass 少 launch(官方 12GB 卡 +6~7%)、long prompt ring 改用 bytes 計、--prefill auto 挑最大 chunk、>262K cells 的 attention top-k、/v1/responses(Codex 能用)、repeat_stop_tokens(同一 token 重複 256 次就收尾)、修 #577、"parallel": N |
| 0.1.39-nvfp4.1 | 10-04 | fork:decode round 短 7%(GPTQ+Q8_0-down pack:16.88 → 15.72 ms/round,答案逐位元相同);long prompt ring 少借 1.2 GiB VRAM |
| 0.1.39-nvfp4.2 | 10-05 | fork:NaN logits 之後自動開新引擎(見 3.3)+補完 #606 的 q8_1 clamp |
我這次是 0.1.38-nvfp4.2 → 0.1.39-nvfp4.2(跨 fork 的 .1、.2 兩版)。
二、效能差多少(同設定 A/B)
方法:新版解到另一個目錄、config 用絕對路徑指同一個
models\、同一個 port 逐次載入(69 GB + 60 GB 不可能同時放進 72 GB 卡),同一份 config、同一批 script、同一節 session。全部是 冷讀(engine log 自己那行prompt N tokens = 0 reused + N read確認),不是我猜的。
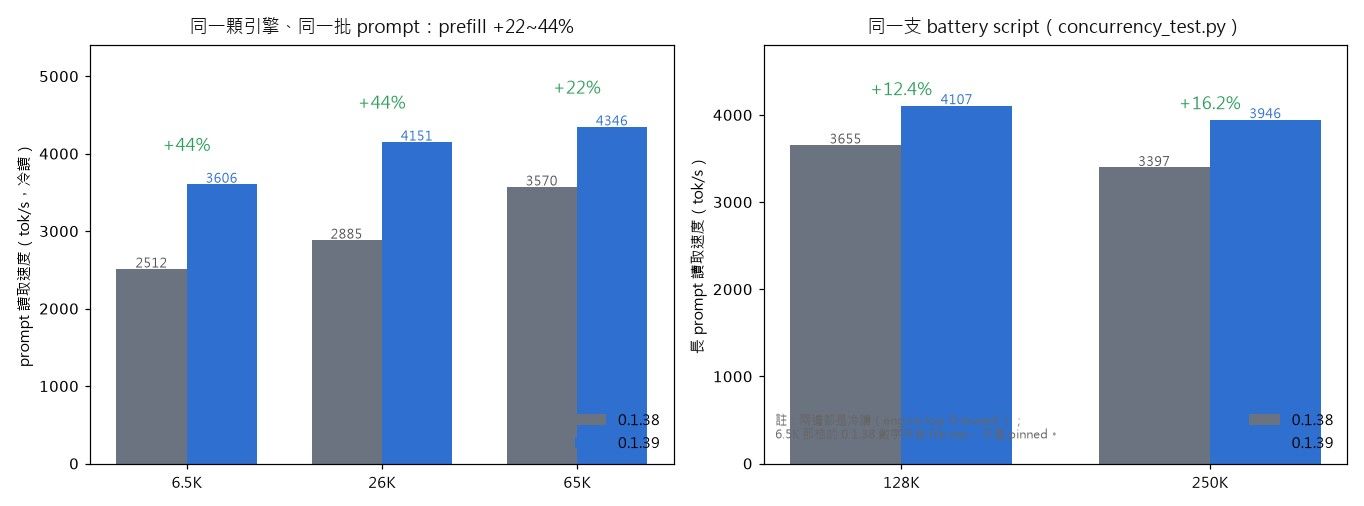
2.1 最大的差異在 prefill,不在 decode
| 冷讀 prompt | 0.1.38 | 0.1.39 | 差 |
|---|---|---|---|
| 6,551 tok | 2,608 ms(2,511 tok/s) | 1,817 ms(3,606) | +44% |
| 26,183 tok | 9,076 ms(2,885) | 6,308 ms(4,151) | +44% |
| 65,471 tok | 18,341 ms(3,570) | 15,066 ms(4,346) | +22% |
decode(同一個 prompt 之後):0.1.38 是 115~145 tok/s,0.1.39 是 140~162 tok/s —— 兩者都在 run-to-run 波動範圍內,看不出有意義的差別(官方說大卡上的 decode 增益「沒量到」,我這邊一致)。
2.2 同一支 battery script 的對照
| 0.1.38 | 0.1.39 | 差 | |
|---|---|---|---|
| prompt 讀取 32K | 942(量測假象,見第 6 節) | 3,417 | — |
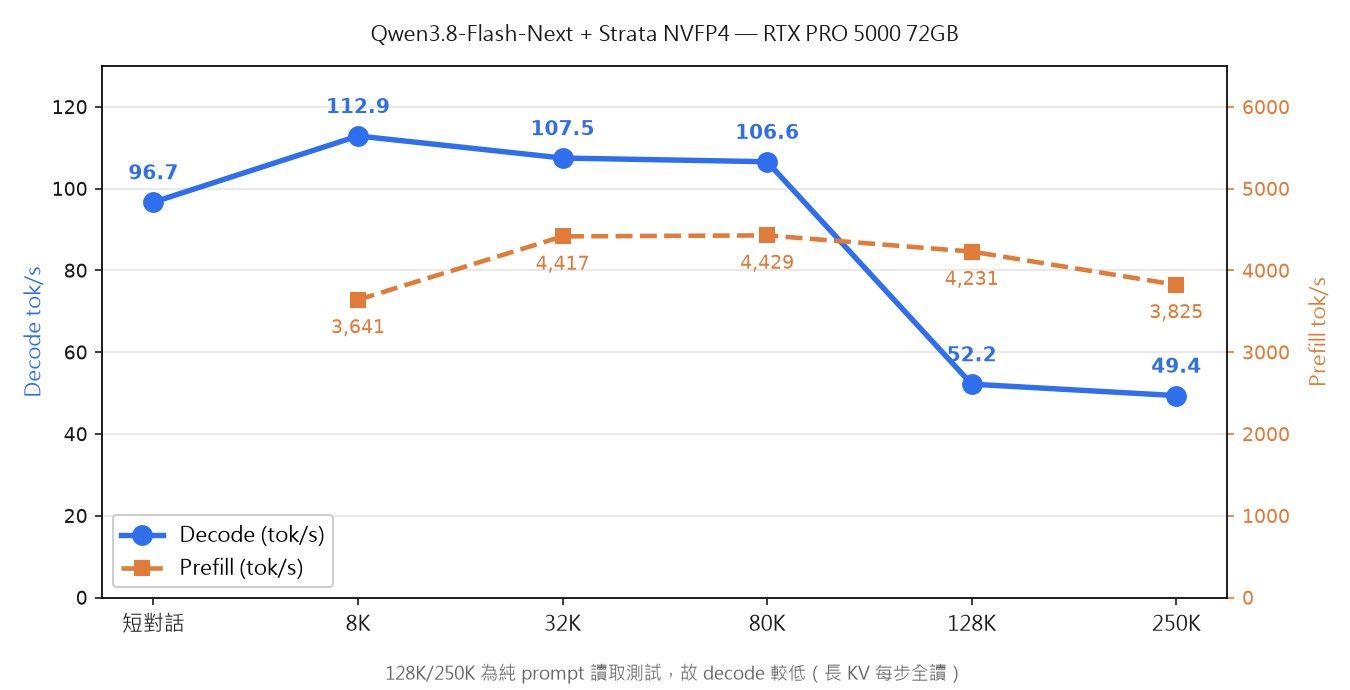
| prompt 讀取 128K | 3,655 | 4,107 | +12.4% |
| prompt 讀取 250K | 3,397 | 3,946 | +16.2% |
2.3 ️ 為什麼官方說「沒變」——這修正只咬 file-tier
#577 的原文是:0.1.38 太早決定要不要繞過 file cache,而且它拿「所有 model 檔的總大小」去比。 在 96 GB 機器 + 72 GiB budget 的設定下它判斷錯誤 → 每個 prompt 之後的 refill 都去讀硬碟,官方自己的說法是 prompts 慢 15–40%。
這完全對得上我這邊的量測(+22~44%)。側面證據:0.1.38 那個 arm 的 engine log 寫著 files 30,452 blobs 269,494.9 MB read —— 一趟測試從 SSD 讀了 269 GB。
為什麼上游與 fork 都回報「prefill 沒變」? 因為他們的測試機把 experts 全放進 RAM(pinned arena / 大 RAM 機器),#577 那條路根本不會走到。
你要怎麼知道自己會不會賺到? 看 engine log 有沒有這三行之一:
low RAM (below 96 GB installed ...
resident RAM mode: ... of experts in RAM ...
expert tiers: ... files N blobs ... MB read
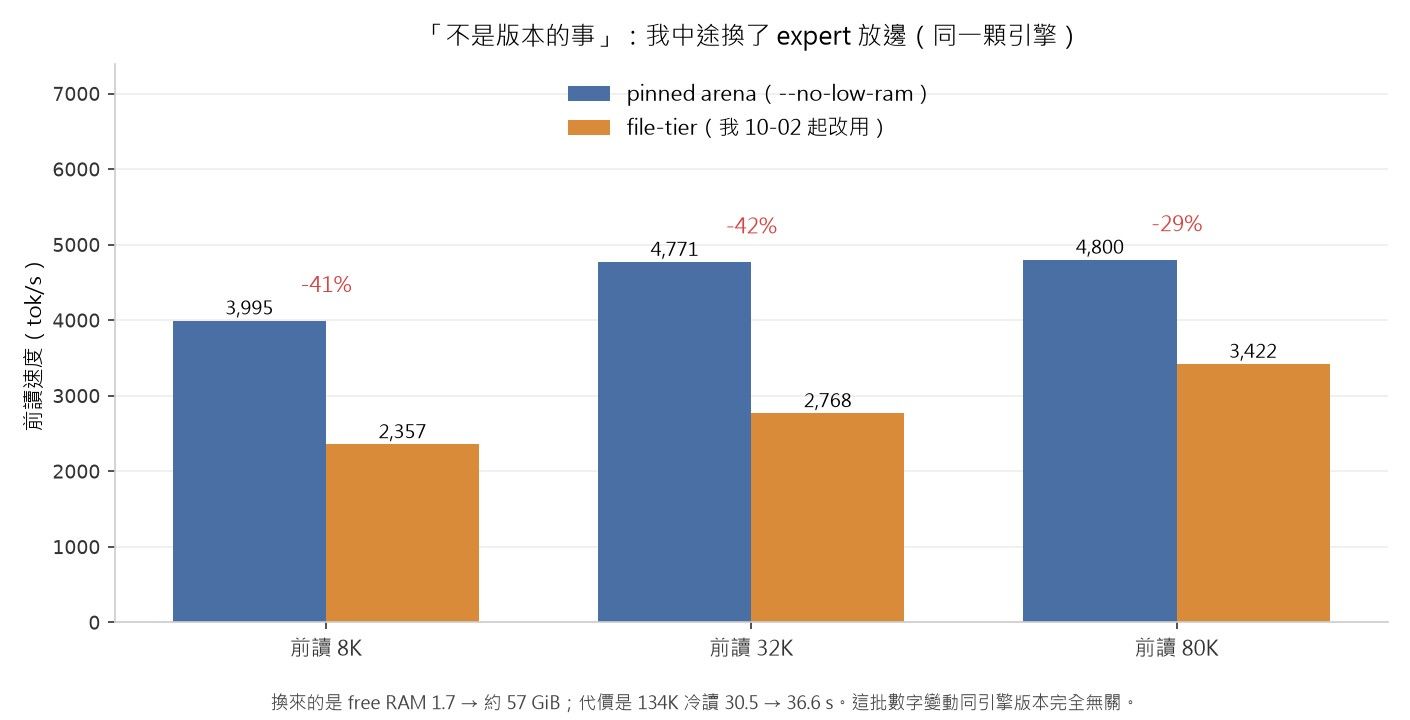
有的話你就在 file-tier,#577 對你有用。想回 pinned arena 就是 --no-low-ram(代價是少掉 ~56 GiB 可用 RAM,換 prompt 更快)。
三、0.1.39 加了什麼
3.1 實用功能
| 新增 | 為什麼有用 |
|---|---|
"parallel": N(2–8,預設關) |
引擎同時解碼 N 條對話。這是我這次最想要的東西(見第四節) |
/v1/responses |
OpenAI Responses API,Codex CLI 可以直接指向它。stateless、支援 function tools/tool results/reasoning effort/JSON schema/streaming events。不支援 previous_response_id、hosted tools、reasoning summaries |
repeat_stop_tokens(預設 256) |
同一個 token 連續出現 256 次就收尾。這是防「模型卡住一直吐同一個字」的保險(官方提到有人看到 36,689 個 !) |
| 修 #577 | 見第 2.3 節 —— 本版最有感的一項 |
--vram-elastic |
熱調整 VRAM(opt-in) |
"effort_position": "end" |
只改 effort 的 request 可以重用 cache(opt-in,預設關) |
3.2 順帶(我沒硬體,沒法測)
- 多 GPU:
--remote-expert-opt(作者實測雙 4090:混合文字 +63%、程式碼 +132%)、3+ 卡的 layer split 重疊更好(4×3060:prompt +10~28%)、STRATA_PREFILL_HELP=1讓閒置卡幫讀一個 chunk 的 experts。 - 舊 NVIDIA 卡(Pascal / Volta):CUDA 13 編不了,所以 setup 會多帶一顆 CUDA 12.9 編的引擎;
--cuda 12也是「驅動比 580 舊」的解法。 - Intel Arc:社群 SYCL port(Linux + oneAPI 自己編,沒有現成引擎)。
- 沒有 AVX2 的舊 CPU:AVX-only / SSE4.2-only 也能編(
STRATA_ISA_FLOOR=avx|none,編一次 10–20 分鐘),只有 i-quant 模型能跑。 - Linux expert arena 走 transparent huge pages;
STRATA_IQ256_GATHER=1(AVX2 codebook gather);>64 CPU 的 thread affinity。
3.3 ️ fork 這版修了一個很痛的東西(長對話變 !)
sergqwer/strata-nvfp4 的 release note 直說:一個 96K tokens 的長 Claude Code 對話中途變成一直吐 !,而且之後每一個 request 都只回 !,要手動重啟引擎才會好。
0.1.39-nvfp4.2 的做法:只要出現「token 0 連續重複」這種狀態,就為下一個 request 開一顆新引擎 —— 一次壞掉的回覆,而不是整個 session 壞死。
官方也老實說:到底什麼把那顆引擎的狀態弄壞,還沒找到(expert arena、deterministic replay、elastic K/V、prompt loan、checkpoints、captured graphs 都排除過了)。
如果你會跑很長的 agent 對話,這個修正是升級的獨立理由。
四、新功能實測:parallel(並行)
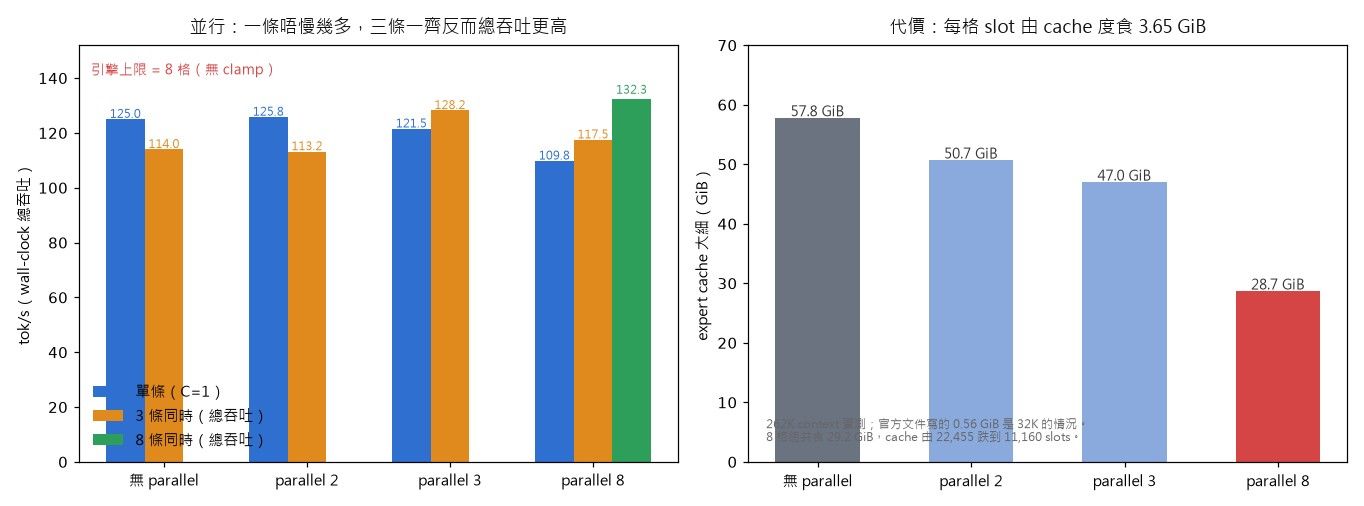
4.1 上限是 8 格,短 context 的速度如下
方法:par_bench.py 發 C 條不同題目(220 token、greedy、thinking off),取 wall-clock 總吞吐(總 output tokens ÷ 總秒數 —— 不能把各 request 自報的 tok/s 相加,那會浮報)。
| 設定 | slots · cache | 單條(C=1) | 3 條同時(總吞吐) | 3 條各自完成時間 |
|---|---|---|---|---|
| 無 parallel | 22,455 · 57.8 GiB | 125.0 | 114.0 | 2.1 / 4.1 / 5.8 s(排隊) |
parallel: 2 |
19,675 · 50.7 GiB | 125.8(−0%) | 113.2 | 3.8 / 4.0 / 5.8 s |
parallel: 3 |
18,256 · 47.0 GiB | 121.5(−3%) | 128.2 | 5.1 / 5.1 / 5.1 s |
parallel: 8 |
11,160 · 28.7 GiB | 109.8(−12%) | 117.5 | 5.5 / 5.6 / 5.6 s |
- 引擎上限 = 8 格(
GET /v1/status→"concurrency": {"serving": 8, "requested": 8},沒有 clamp;engine log:--batch: 8 slot sessions on CUDA0 (3.65 GiB each))。 - 真正的好處是公平:沒有並行時第 3 條要等 3.7 秒才開始;開了之後三條一起跑、一起收。
- 單條的代價比官方在 12GB 卡上的數字輕很多(官方:2 格 −11%、4 格 −24%;我這邊 2 格 −0%、3 格 −3%)—— 因為大 VRAM 卡把大部分 experts 留在 VRAM,官方文件自己也是這樣建議的。
- 順帶:burst 掃描(1/2/4/8/16/24/32 條同時)在
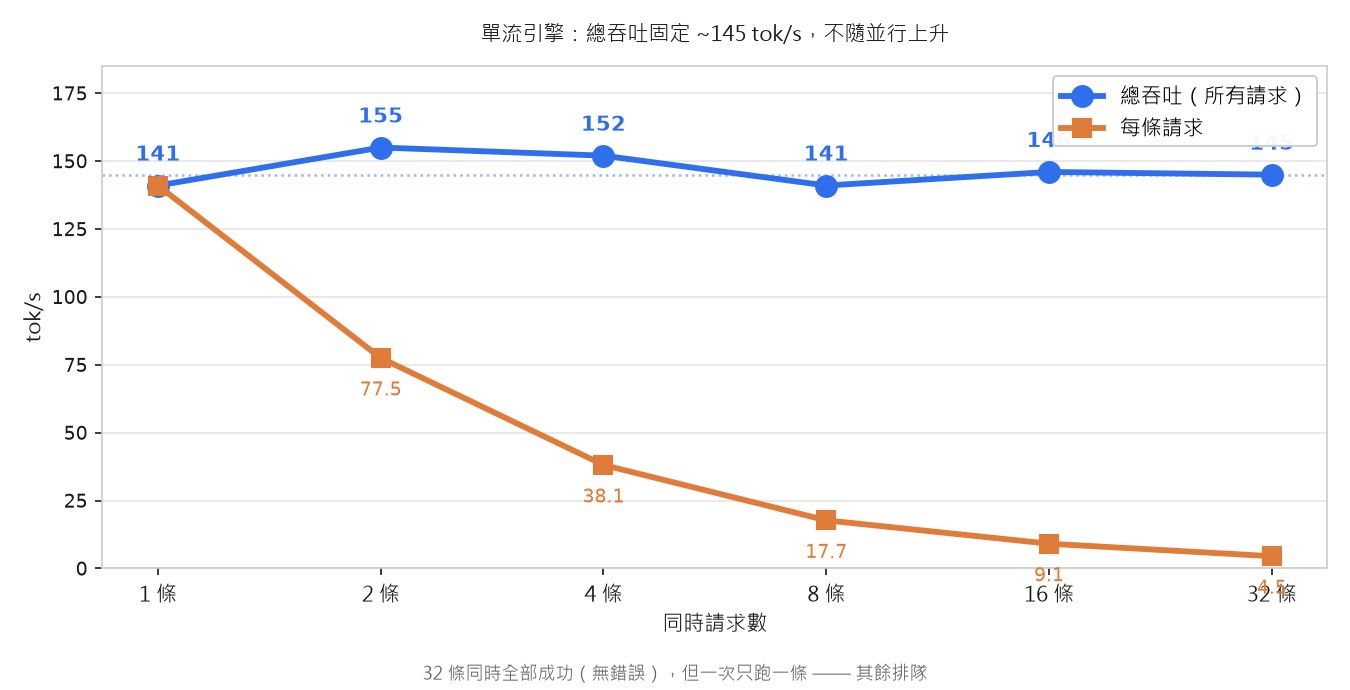
parallel: 3之下總吞吐是 100.8 / 130.2 / 155.2 / 156.5 / 147.6 / 148.7 / 149.1 tok/s,比不開時的高段(136~145)高 5~10%。
4.2 ️ 每一格 slot 的真實成本:262K 之下是 3.65 GiB
官方 docs/BATCHING.md 寫「每格 slot 0.56 GiB」——那是 32K context 的數字。你在 262K 之下實際是 3.65 GiB / 格:
| 格數 | slot 總佔用 | expert cache |
|---|---|---|
| 2 | 7.31 GiB | 57.8 → 50.7 GiB(22,455 → 19,675 slots) |
| 3 | 10.96 GiB | 57.8 → 47.0 GiB(→ 18,256 slots) |
| 8 | 29.23 GiB | 57.8 → 28.7 GiB(→ 11,160 slots) |
重點:成本是「slot sessions」本身,不是「你用到幾條」。 開 8 格就算你只跑 3 條,還是付 29 GiB 的帳(單條 −12%、C=2 總吞吐由 109 掉到 88)。
4.3 長 context × 並行:能跑,而且不變慢
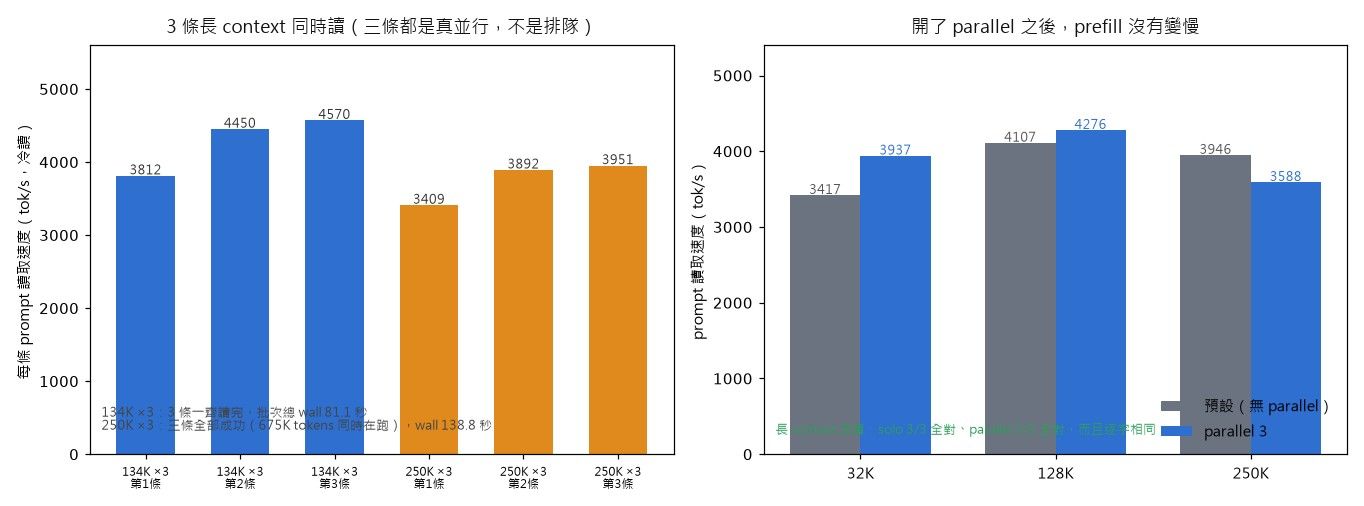
測試(parallel: 3,cache 47.5 GiB) |
結果 |
|---|---|
| 2 × 134K 同時、2 × 250K 同時 |  兩條都成功,讀取時間重疊 |
| 3 × 134K 同時 | 三條冷讀同時進行:29.2 / 25.1 / 24.6 秒,各 3,812 / 4,450 / 4,571 tok/s(不是排隊 —— 排隊的話三條會是 25+25+25 秒) |
| 3 × 250K 同時 | 三條全部成功:224,389 / 224,919 / 225,352 tokens = 675K tokens 的 context 同時在跑,各 3,409 / 3,892 / 3,951 tok/s,批次總 wall 138.8 秒 |
| prefill 有沒有變慢? | 沒有:32K 3,937 / 128K 4,276 / 250K 3,588 vs 預設的 3,417 / 4,107 / 3,946(128K 還更高) |
| 長 context 答案有沒有變? | 沒有:250K 品質測試(3 個針 + 1 個需要跨兩處事實組合的多跳題)solo 3/3 全 4/4、並行 3/3 全 4/4,而且逐字相同 |
官方說「batch window 裡的 greedy 答案會和單獨跑相同」,但也提醒預設設定下長 prompt 的 bits 會變、輸出可能漂移。我這台在 250K 之下量到的結果是逐字一致 —— 但那是我的環境,別當成普遍保證。
4.4 ️️ 並行不能取代對話 cache(否定結果)
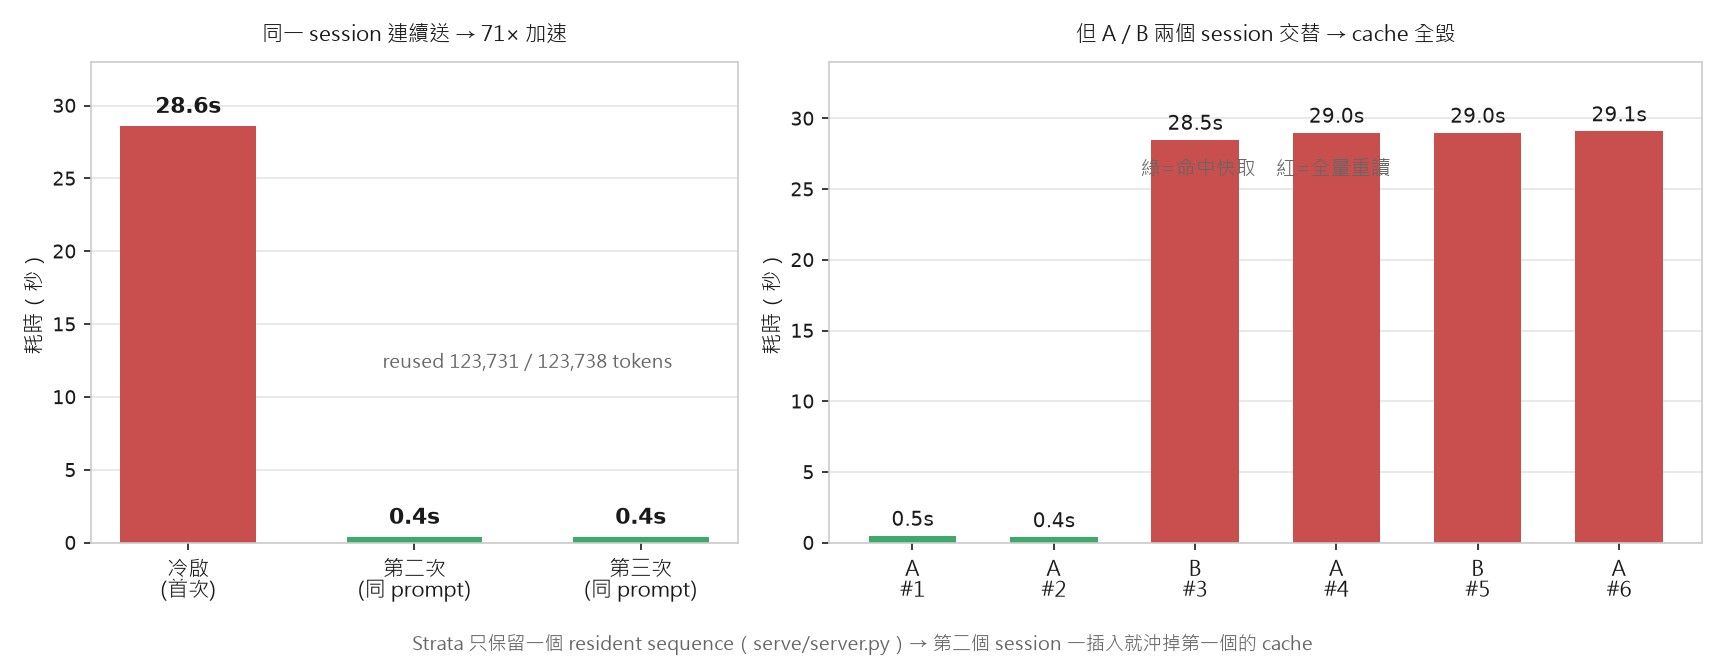
我原本的假設是:既然 BATCHING.md 說「each slot is a conversation cache」,那三個 slot 應該能讓三條長對話保持 warm,說不定可以省掉 --conversation-cache-mib 的 host RAM。
實測答案:不行。 用同一組 3 條 ~134K 對話交替(A A B C A B C A):
| 設定 | 結果 |
|---|---|
parallel: 3 + 對話 cache 開著 |
三次冷讀之後,每一輪都是暖的(0.2~0.7 秒,engine log 顯示 reused + 7 read) |
parallel: 3 + 對話 cache 關掉 |
只有「緊接著重複同一條」才會暖(0.1 秒);一交錯到 B / C,之後每一輪都退回冷讀 23~26 秒 |
→ 三條長對話保溫靠的是對話 cache,不是 slot。 並行只加快「同時打」和 burst 的吞吐,不會讓 slot 自己記住對話狀態。
五、我最後一輪完整重測(0.1.39-nvfp4.2)
用原封不動的 script 重跑裝機當天那套測試,全部打 live server(full/auto)。
| 項目 | 0.1.38(上次) | 0.1.39(本次) |
|---|---|---|
| prompt 讀取 32K / 128K / 250K | 942(假象)/ 3,655 / 3,397 | 3,417 / 4,107 / 3,946 |
| 並行總吞吐 N=1/2/4/8/16/32 | 103 / 149 / 149 / 145 / 137 / 136 | 97 / 155 / 153 / 144 / 148 / 147 |
| 單針檢索(4 個深度 × 32K~250K) | 全中 | 全中 |
| 5 針一次問齊(32K / 250K) | 5/5、5/5 | 5/5、5/5 |
| 多跳推理(2K→250K) | 全部一致 | 全部一致 |
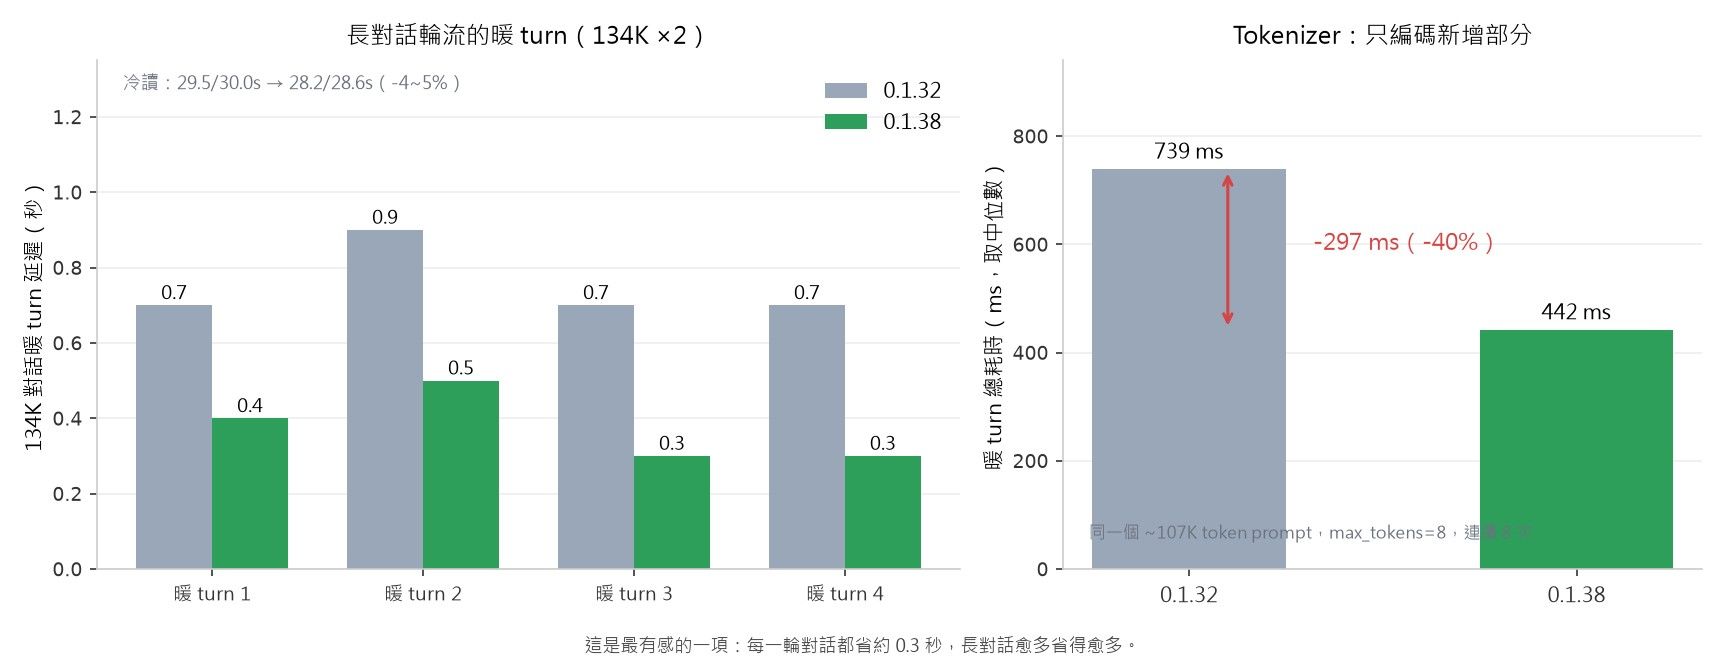
| 同 session prefix cache | 冷 55.1s → 0.8s(69×) | 冷 30.5s → 0.8s(reused 110,250/110,257) |
| 讀圖 5 個尺寸(256² → 3840×2400) | 0.8 / 2.1 / 6.1 / 8.4 / 8.6 s | 0.8 / 2.2 / 6.1 / 8.2 / 8.1 s |
| frames 8 / 16 / 32 / 64 | 11.9 / 21.6 / 42.9 / 88.4 s | 11.4 / 20.9 / 42.6 / 86.5 s |
| frames 96 / 128 / 200 | 全部失敗 | 全部失敗(64 張上限的 server bug 仍在) |
| warm talk(8 條同時、900 tok) | — | 8.0 秒 = 111.9 tok/s 總吞吐 |
| 134K 冷讀 | 35.2 / 35.3 / 36.2 s | 23.5~26.0 s(同一批 prompt,file cache 較暖) |
沒有一項變差。
六、升級與設定要留意(我踩過/核過)
-
升級會蓋掉 3 個檔案,要自己 re-apply(
models\與.venv-serve不在 zip 內,會保留、不用重轉):config\strata-nvfp4.json(我的是host: 0.0.0.0+--conversation-cache-mib 9216)start-server.cmd(--port 8097)- ️
serve\server.py若你改過(我加了CREATE_NO_WINDOW防 cmd 彈窗)不能照抄舊檔 —— 每個版本的server.py都不同,要重新打 patch。這次 0.1.39 的server.py比 0.1.38 又多了一堆東西(serve/responses.py、batch slots、/v1/vram、/config…),Popen的位置也全部搬家。
-
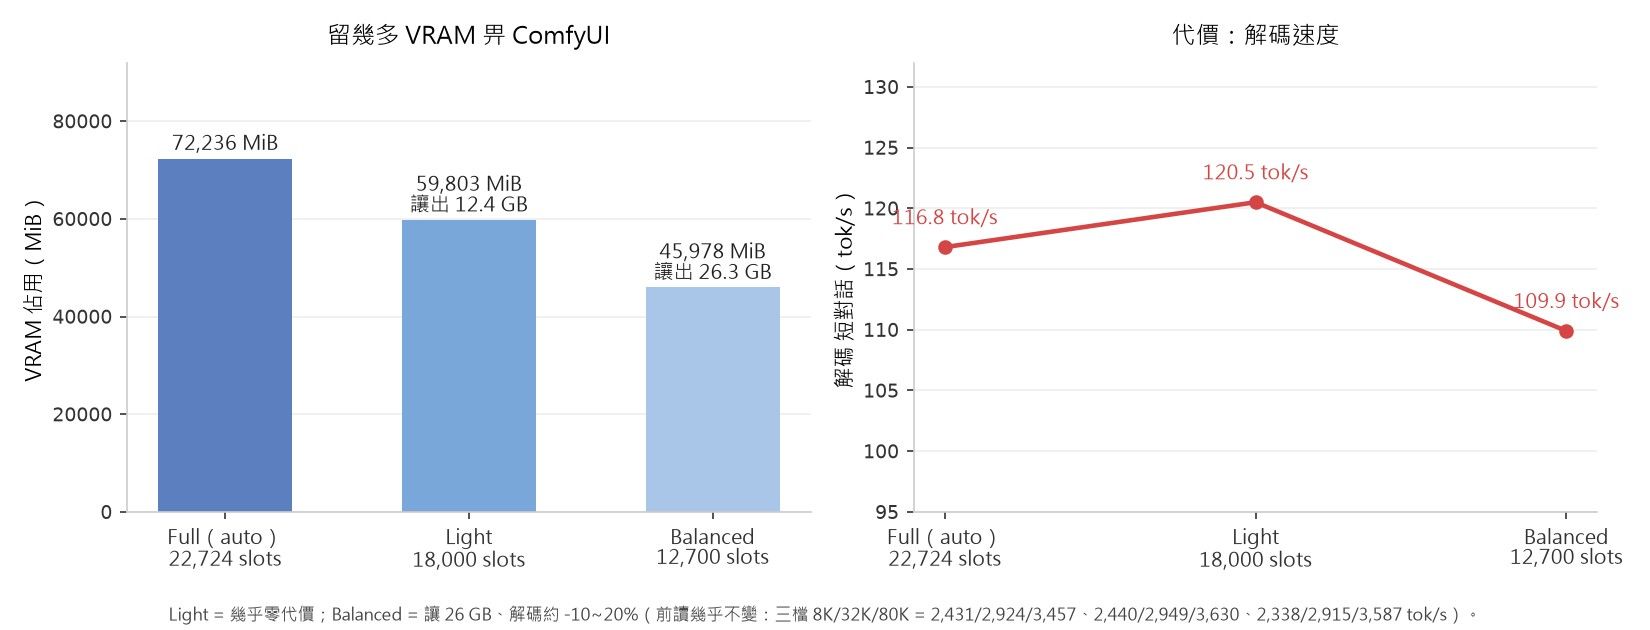
️ 想給 ComfyUI 出圖:並行在 co-run 模式是「加在上面」(下圖)
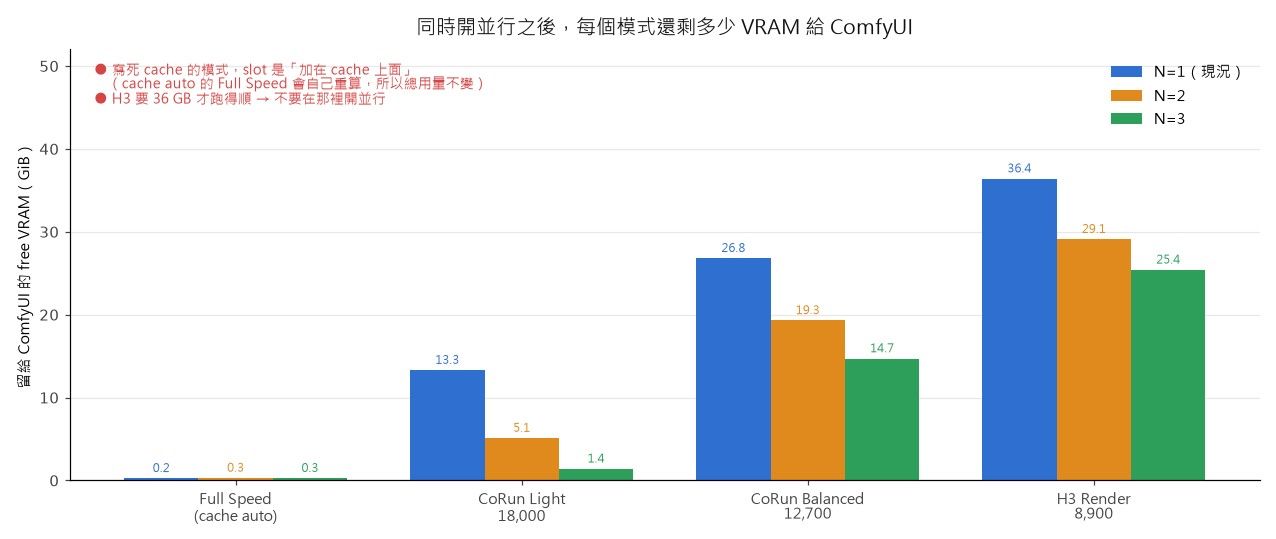
| 模式 | cache | N=1 剩 | N=2 剩 | N=3 剩 |
|---|---:|---:|---:|---:|
| Full Speed(cache auto) | auto | 0.2 GiB | 0.3 GiB | 0.3 GiB |
| CoRun Light | 18,000 | 13.3 GiB | 5.1 GiB | 1.4 GiB |
| CoRun Balanced | 12,700 | 26.8 GiB | 19.3 GiB | 14.7 GiB |
| H3 Render | 8,900 | 36.4 GiB | 29.1 GiB | 25.4 GiB |
--expert-cache auto 會在開機時重算 cache(所以 Full Speed 開並行總用量不變);但寫死數字的模式會保留 cache、slot 加在上面 → Light 由 13.3 掉到 5.1、H3 由 36.4 掉到 29.1。H3 需要 ~36 GB 才跑得順,就不要在那裡開並行。
-
我自己最後的設定(給你參考):Full Speed 開
parallel: 3(日常零 VRAM 代價)、三個 render 模式都不開;另外做了light 2N/balanced 2N兩個變體,需要「出圖 + agent 同時跑」時才切。 -
️ 如果你自己寫 script 切換模式:模式身分不能只看 expert-cache slots。我踩到兩個坑 —— ①
light和light 2Ncache 一樣是 18,000(分不開);② Full Speed 用cache auto,slots 會飄(我是 18,384~22,798),開了parallel: 3之後是 18,384,比「≥20,000 就算 full」的舊判斷還低。0.1.39 的GET /v1/status有concurrency.serving,用 (cache, parallel) 兩個條件一起判斷。 -
長 context prefill 不要只取第一行:切模式/重載之後第一個長 prompt 會重新熱身 expert cache,可能量到 942 tok/s 這種假數字(log 原文:33.9 秒內由 SSD 讀了 89 GB)。緊接的第二、三個才反映穩定表現。
-
沒變的東西:預設仍是單流(要並行要自己開)、~245.7K 的 per-request 硬牆(
prompt + max_tokens ≤ 262136,超過是 400 而不是慢慢變差)、STRATA_ADAPT_WAIT仍 opt-in(所以 greedy 答案仍不保證逐位元可重現)、64 張圖/request 的 bug 仍在。
七、結論
| 0.1.38 → 0.1.39 | |
|---|---|
| prompt 讀取(file-tier) | +22~44%(短)· +12~16%(128K/250K) |
| decode | 看不出有意義差異(波動內) |
| 長 context 品質 | 不變(並行之下逐字相同) |
| 並行 | 新增;上限 8 格;單條 −0~3%(2~3 格),3 條同時總吞吐 +12% |
| 有沒有變差 | 沒有 |
值不值得升?對我值得,而且理由和官方寫的不一樣:
- 如果你是 file-tier(RAM < 96 GB 被自動開,或你像我一樣手動選它)→ #577 的修正直接送你 +22~44% 的 prompt 讀取,這是這次升級最大的價值,官方 release note 幾乎沒提。
- 如果你是 pinned arena → 這版對你主要是「多了並行 + Codex 支援 + NaN logits 保險」,效能上接近平手。
- 如果你跑很長的 agent 對話 → 0.1.39-nvfp4.2 的「NaN logits 自動重開引擎」是獨立於效能的保險。
升級動作就是「解壓蓋上去、保留 models\ 與 .venv-serve、re-apply 上面那 3 個檔案」。
 HTTP 400