@kos-or 纯粹是超白金太厚了 x99插第一个pcie口直接把第二个挡住了 涡轮卡也好方便后期扩展
-
蓝宝石官方用9070xt氮动换7900xtx超白金 -
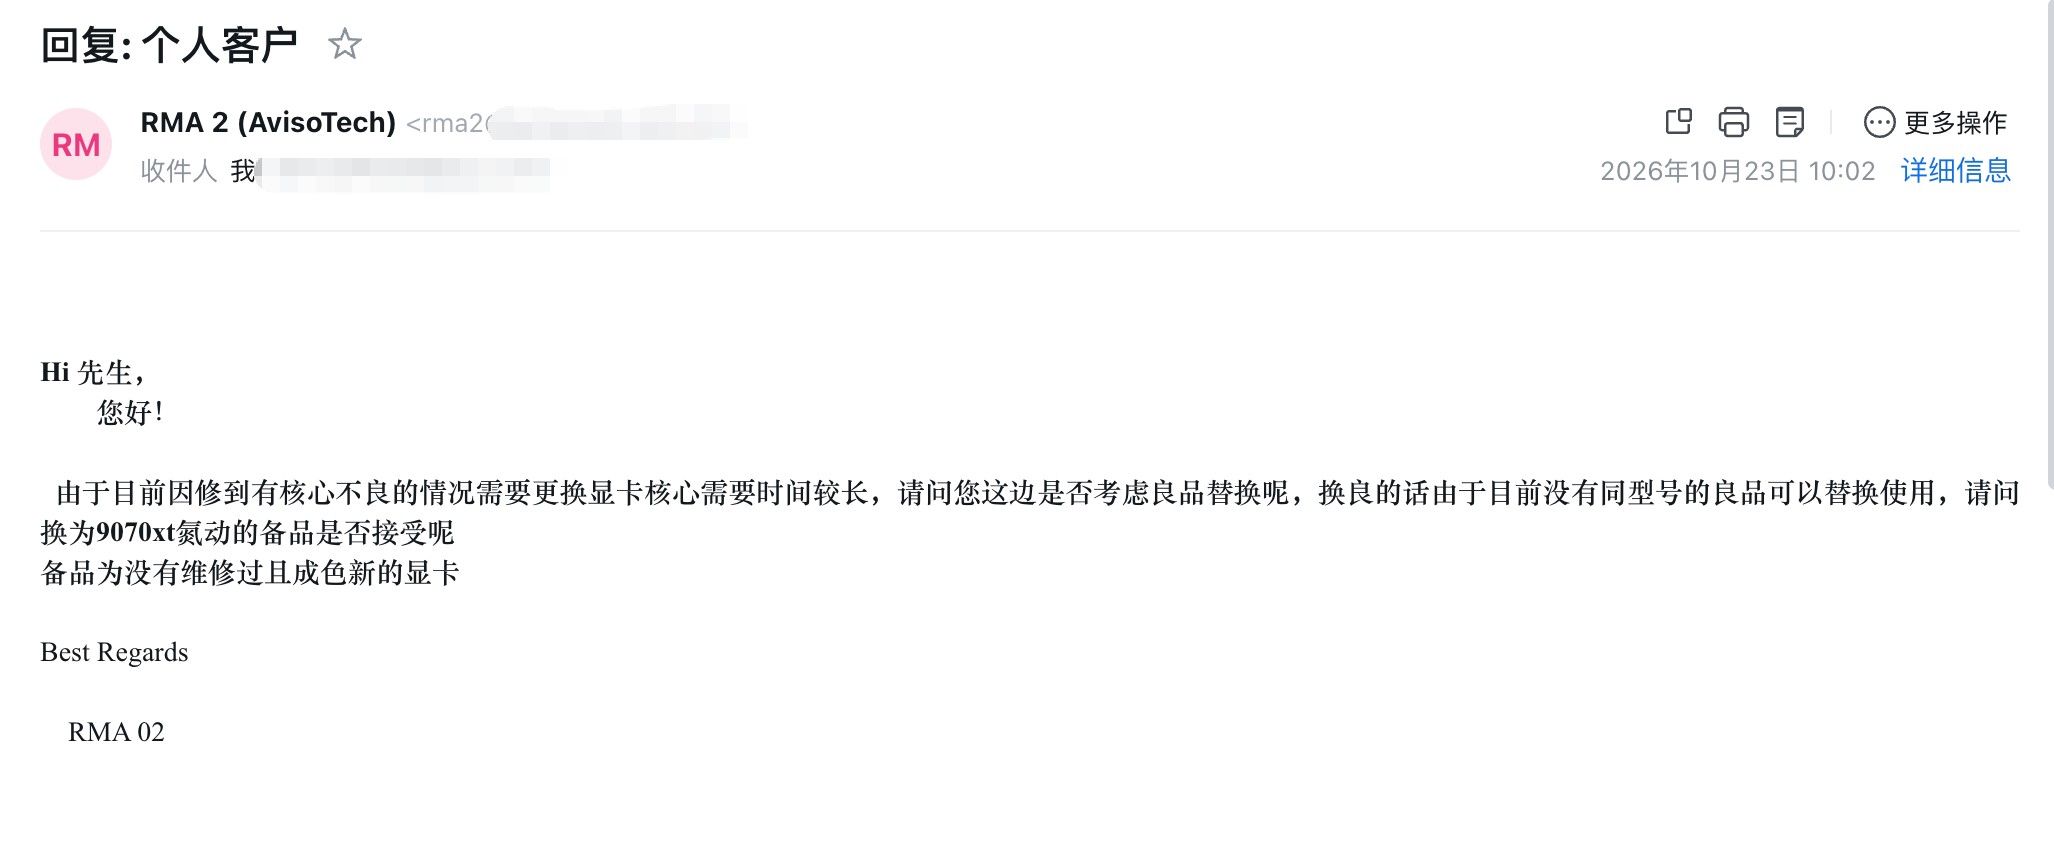
蓝宝石官方用9070xt氮动换7900xtx超白金顶一下贴子。。。
-
蓝宝石官方用9070xt氮动换7900xtx超白金@williamlouis 哈哈 我挺想要的 现在这个卡实在是太厚了
-
蓝宝石官方用9070xt氮动换7900xtx超白金@Nero丶畅畅 我甚至觉得他在框我 想拿7900xtx的核心去做涡轮卡
-
蓝宝石官方用9070xt氮动换7900xtx超白金@Bunsei 是我从未设想的方案 两个9070能跑啥模型啊现在
-
蓝宝石官方用9070xt氮动换7900xtx超白金@懒人烘培 倒不是急着用卡 就是在想是不是同意换9070xt还是继续等他们修我的7900xtx 其实我倒是想要一张京东蓝宝石在卖的 7900xtx的涡轮卡 至少没有超白金那么厚
-
蓝宝石官方用9070xt氮动换7900xtx超白金但我看京东都在卖7900xtx的涡轮卡了 跟我说没核心了 9070xt跑ai不太行啊
-
蓝宝石官方用9070xt氮动换7900xtx超白金 -
蓝宝石官方用9070xt氮动换7900xtx超白金之前咸鱼买的还剩两年保修的7900xtx超白金 跑了一段时间后突然卡b2无法开机了 国庆的时候就个人送保了 最近发邮件给我说给我换9070xt氮动 说是目前没有旧的7900xtx核心了 大家怎么看 目前手里是有一张r9700+64gb ddr4 打游戏也有一张7700xt在用 目前也不是特别着急 大家怎么看
-
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4还是前缀缓存命中了?
-
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4@paul-hou profill速度怎么那么快 是因为量化等级小吗
-
AMD R9700 實測:ROCm 10,Qwen38-27B-UD-Q6_K、128K context 和 MTP@heheimback 是这么回事 跑llm的话 不如7900xtx的960gb的带宽 快很多 跟4090的带宽是一个级别的
-
咨询一下,4090魔改卡风扇转速问题@terry vbios固件已经写死 没有使用率也是60%的风扇空转 要改只能刷固件 你那块卡明显就是低转速的vbios 出厂的厂家不一样
-
X99+7900 XTX+7700 XT 跑 vLLM实测已改成精简版帖子,只保留 vLLM 操作和实测。注释 1
X99+7900 XTX/7700 XT 跑 vLLM:128K、缓存及 MTP 实测
配置:X99-AD4、E5-2686 v4、64GB、7900 XTX 24GB+7700 XT 12GB。
模型:
Vishva007/Qwen3.8-27B-W4A16-AutoRound-GPTQ,vLLM 0.28.0、ROCm 7.2.3 wheel。1. 做了哪些修改
操作 实验结果 开启 Above 4G Decoding、ReBAR 双卡进入 Ubuntu,大 BAR 生效 给主机桥 8086:6f00加 P2PDMA 白名单,编译实验内核缺 gawk失败一次,补齐后完成,累计编译约54分钟;HIP peer 双向由0变1,复制和IPC校验通过换用 AMD RCCL build 38,移除 LD_PRELOAD 解决原库双卡 AllReduce 段错误,集合通信通过 修正 GPTQ 零点传参、按显卡读取CU数量、开启decode graph,并加入MTP3 TP2下1K输入TG从5.87提高到47.26 移植 JartX 的 RDNA3 prefill 调度参数 16K PP提高21.4%,32K提高42.2% 改为不等量分层,让XTX承担更多层 长上下文PP提高,跑通128K 注意:最终 RCCL 仍走 SHM,不能宣称高速P2P已打通;也未证明实验内核是最终方案的必要条件。
2. PP/TG 实测
JartX prefill 调整前后,保持TP2+MTP3:
输入 调整前PP 调整后PP 调整后TG 16K 561.8 682.2 29.23 32K 452.9 644.0 17.89 之后改成 TP1+PP2、7700 XT前20层/XTX后44层,无MTP、无缓存。单请求生成256 token:
实际输入token PP(tok/s) TG(tok/s) 4,096 1,016.56 27.55 16,384 995.61 24.94 32,768 933.16 24.78 130,816 670.88 18.06 最后一项输入+输出共131,072,整次请求209.1秒。分层后短上下文TG不如早期TP2+MTP3,但PP更高,32K生成也更快。
3. 最终使用配置
接入视觉后重新平衡显存,改成 18/46分层、128K、前缀缓存、最多4并发。batch预算1024,显存预算0.948,无MTP。
测试 结果 约3K输入/256输出 TG 28.74/28.93 tok/s 7,552 token文本首次/重复请求 首token 7.451秒/0.788秒 图片首次/重复请求 首token 2.146秒/0.591秒,均识别出数码管 Ab保留视觉编码器,131,008输入+64输出 满128K请求186.1秒完成 并发调优阶段,约7.5K输入/160输出、缓存已热:
并发 每路TG 首token延迟 2 18.83–20.46 0.828–1.630秒 4 15.02–18.59 0.928–3.092秒 这组并发数据使用0.94显存预算。前面的完整长上下文表属于纯文本20/44方案,不是最终视觉配置的成绩。四并发也不代表能同时容纳四个独立满128K请求。
4. 为什么最终没留MTP
适配PP+MTP后,约3K输入、256输出:
配置 两次TG(tok/s) 无MTP 28.62/28.80 MTP1 14.88/15.06 MTP2 16.59/16.50 MTP3 18.55/18.83 MTP实验为8K、无缓存,基线为128K+缓存,是部署方案对比而非严格单变量实验。虽然成功运行,但TG下降,因此撤回。
DFlash2也试过:1K输入TG从30.01到32.58,但受显存限制,完成测试的上下文上限只有2304;runner与缓存配置也不同,不能视为严格加速对照,最终放弃。
目前保留无MTP的128K+视觉+缓存方案,DSH和公网接口均已接通。单流约3K上下文TG为29 tok/s,多会话主要依靠前缀缓存减少重复处理。
以上均为短期实测:128K验证的是容量,不是长期稳定性或长上下文语义能力。
-
请教:AMD R9700 还是 Mac Studio?r9700我看京东自营又涨了1000 哈哈哈
-
昨天出了5090+Pro 6000。@张光璞 同问 这个又不是随便就能扩容的 得有vbios啊 而且得是官方“不小心” 泄露出来
-
Asus Ascent GX10到货,双gb10的DSV4-Flash集群全程hermes远程部署好厉害 同问测试数据
-
rtx8000 工作站卡 突然在闲鱼刷到 是我被信息差了吗@Kirin-H. 数据中心机房的环境肯定比挖矿的要好吧 挖矿是超频的
-
rtx8000 工作站卡 突然在闲鱼刷到 是我被信息差了吗@李源 我还看到咸鱼卡贩子打包出170hx的 说单张不卖的 不敢想象都是谁在买
-
rtx8000 工作站卡 突然在闲鱼刷到 是我被信息差了吗@terry 等一个大船靠岸A100 啊哈哈