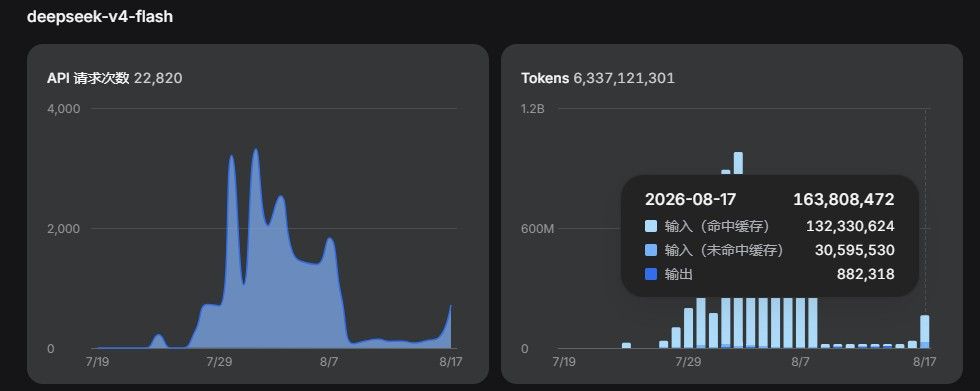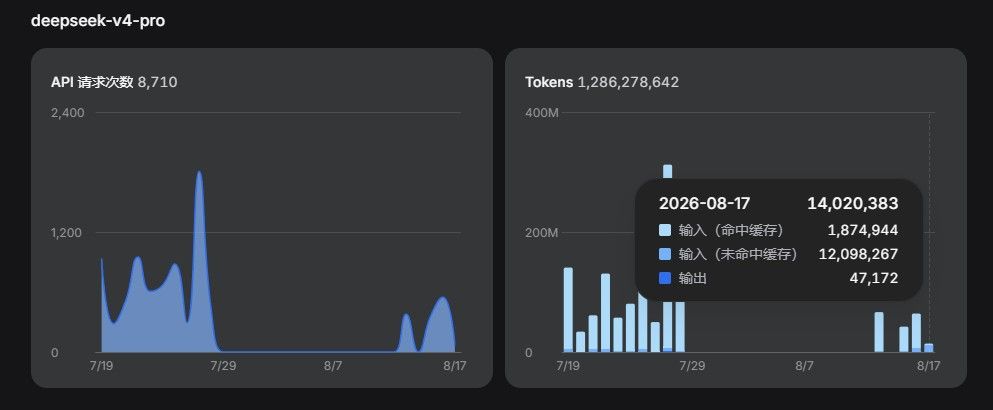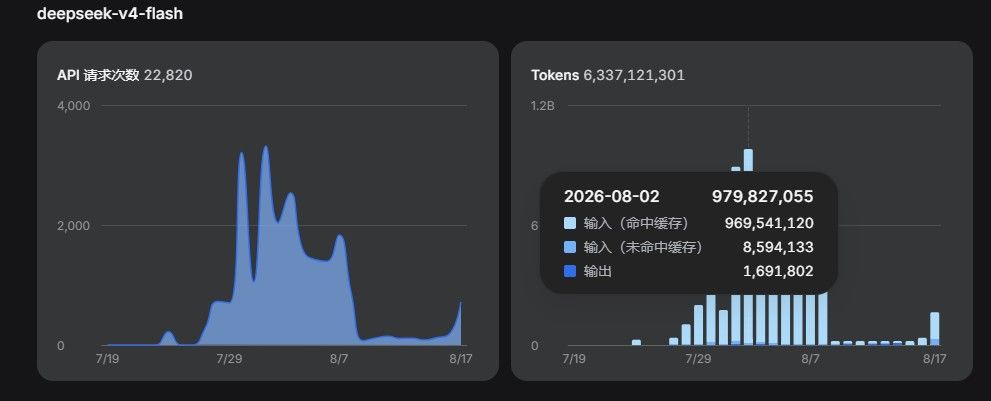
这种还是要弄个定时备份任务,传到NAS后者云服务器,最多损失一天数据
-
求助!我这种情况,怎么恢复hermes skill -
关于DEEPSEEK V4 PRO和GLM 5.3的价格对比! -
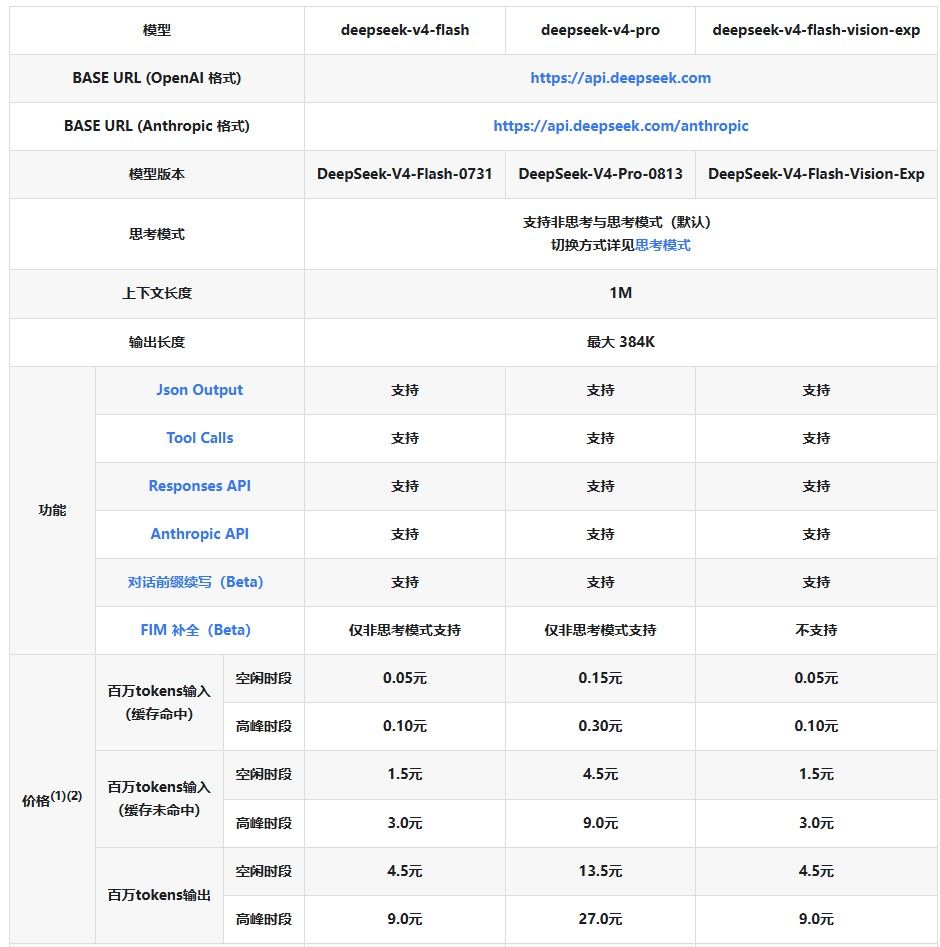
关于DEEPSEEK V4 PRO和GLM 5.3的价格对比!首先第一点,个人觉得GLM的编程能力比PRO要强一点,所以相同价格情况下肯定是GLM更好一点;
然后是价格对比,GLM我订阅的400多那个档次,连续包月大概是430块的样子,我就取整为450元!而且V4 PRO以最低价来计算!
然后我们以450元的这个价格来计算两者的tokens额度差异;
我以全缓存命中来计算的话V4 PRO的额度算下来约为3000M的用量,实际上应该是不会超过这个的因为缓存命中肯定不可能100%;
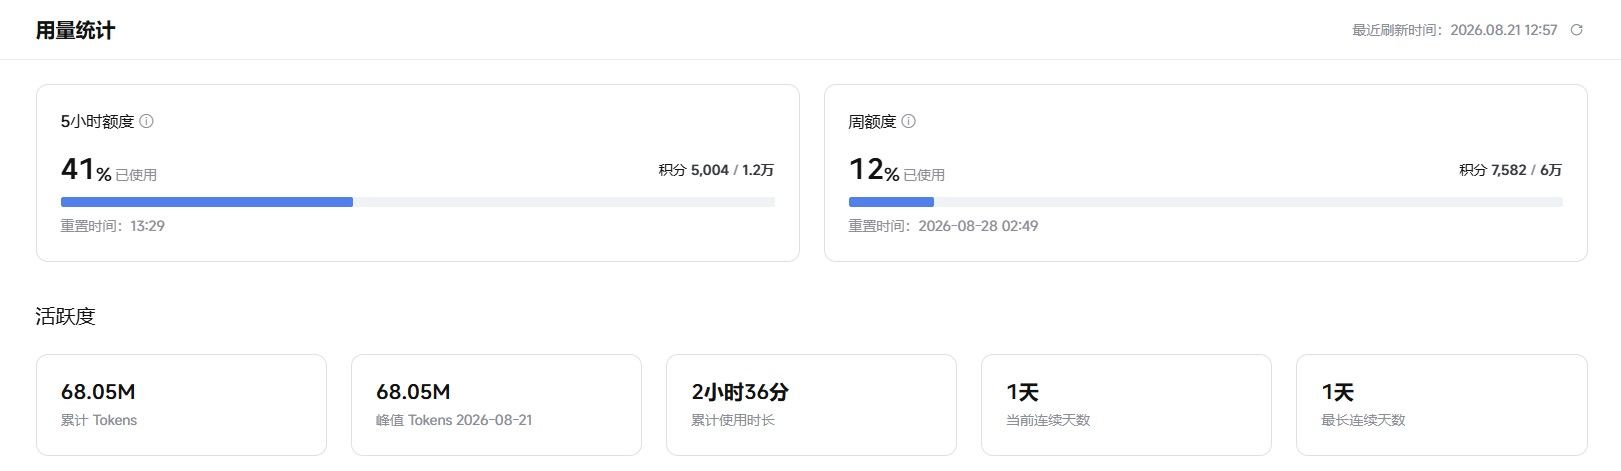
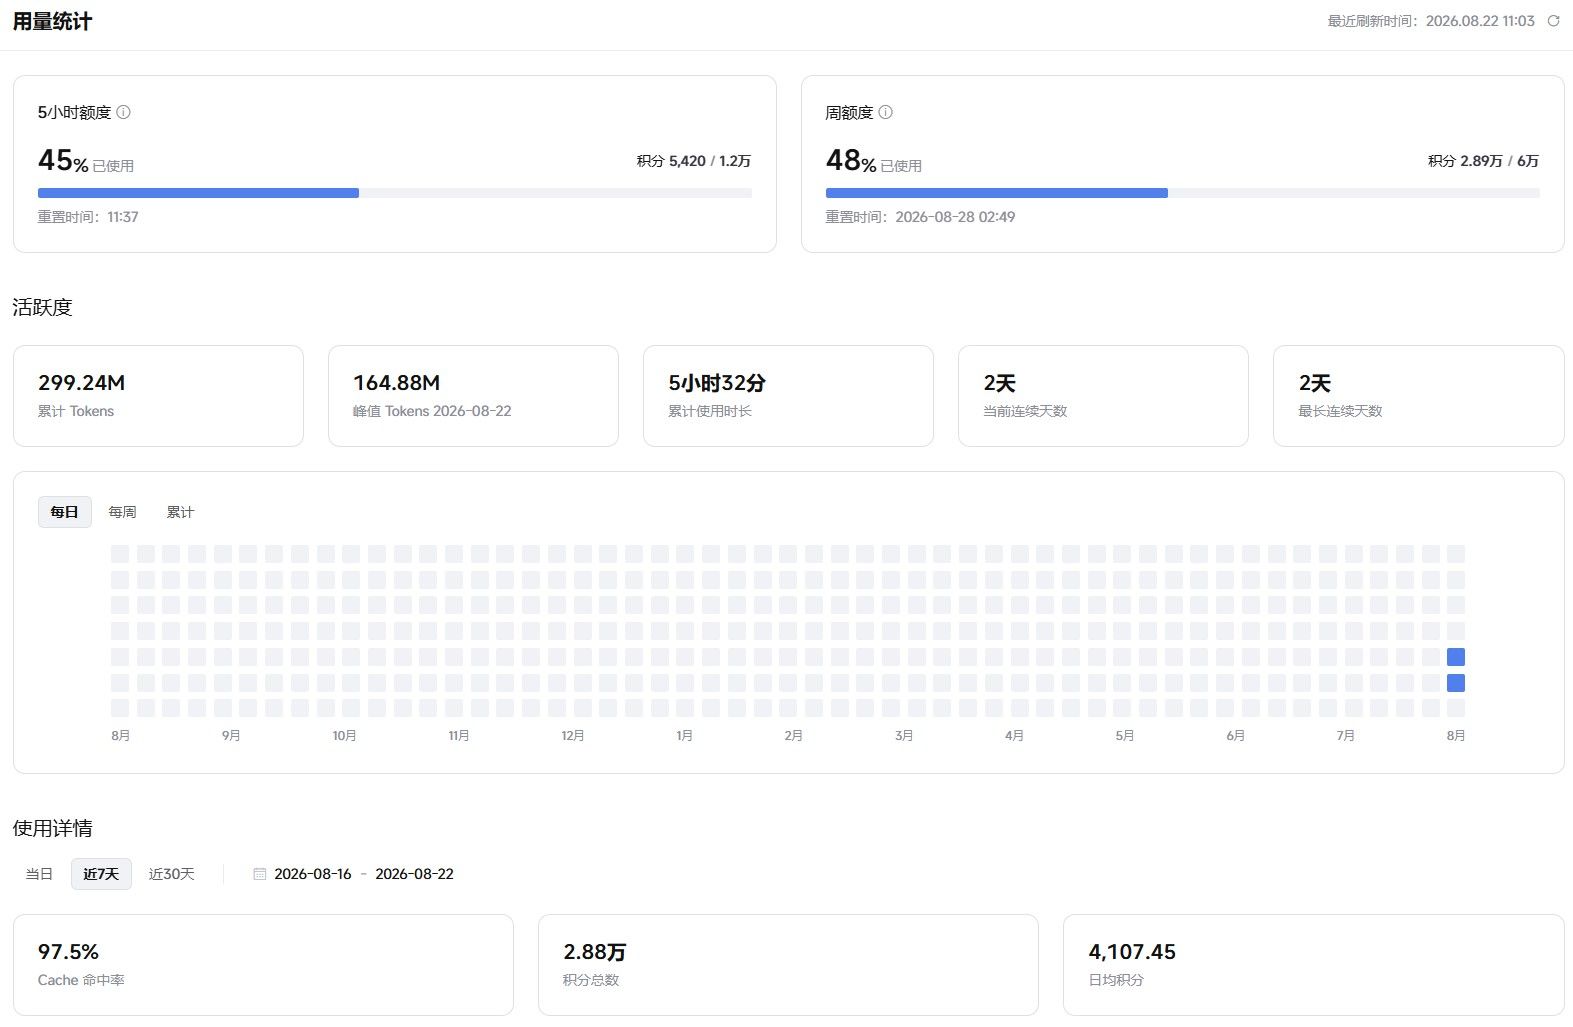
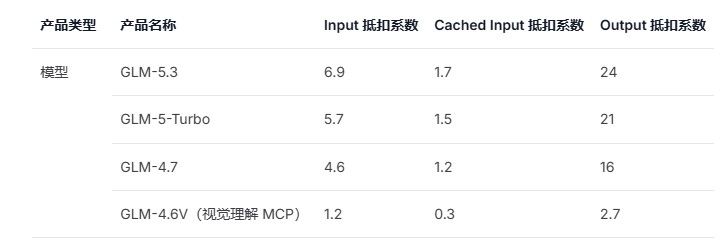
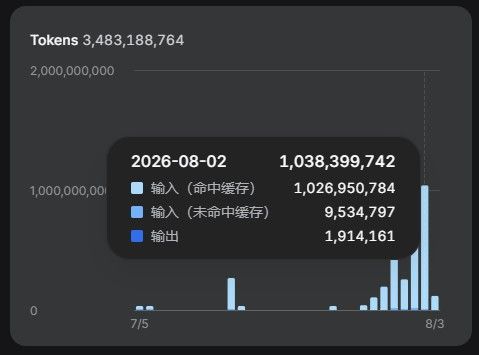
然后是GLM这边,他采用的积分那种计费模式,我正常的编程缓存率如图大概就是97%以上,然后用用图里面数据算下来每周大概是622M的样子,然后就可以大致推算出月额度在622M/7*30=2669M的样子!然后说一下实际情况V4 PRO未命中算4.5元,是缓存命中价格的30倍;GLM这边未命中的倍数大概只有4倍,输出的倍数都差不太多,因为输出一般占比比较小,所以也就不做比较了!
总结下来就是:
V4 PRO在同等情况以最低价格来计算额度其实可能和GLM 5.3差不多的!
如果考虑到还有高峰期的情况,V4 PRO完全不占据优势了,V4 PRO每天高峰7个小时还不区分周末,GLM则是每天4个小时算作高峰,周末还不算高峰!
最终的个人结论就是:GLM在提供更强能力情况下是非常值得选择的,如果是高峰时期都必须用到的那GLM优势更大!
-
DeepSeek V4 Flash Vision实测:识图白菜价,DeepSeek Harness开发App真能放手干了? -
DeepSeek API价格暴涨最高10倍,中美AI竞争进入下半场:中国真正的优势在哪里? -
DeepSeek API价格暴涨最高10倍,中美AI竞争进入下半场:中国真正的优势在哪里? -
随手记录:Qwen3.8:27b vs Qwen3.6:27b 实测对比 🧪 -
Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平 -
Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平 -
Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平 -
Qwen3.8 27B AA综合评分与 DeepSeek V4 Flash 持平 -
DeepSeek V4涨价后,账单起飞同时缓存命中率骤降,大家有这个情况吗? -
DeepSeek V4涨价后,账单起飞同时缓存命中率骤降,大家有这个情况吗? -
H100 4卡 96*4显存,想做视频制作服务器 -
重来一次,使用Minimax H3 生成一段40s动画 (升级第三版sage att 优化) -
MiniMax H3 FP8版本 4090 48G实测,效果惊艳,语义理解远好于传统模型Wan LTX等,但是速度有点慢! -
今天开始V4 flash开始出现卡顿了,大家感受到了吗?@laobenxiong 本来还纠结GLM-5.2抢不到,现在完全不想抢!
-
今天开始V4 flash开始出现卡顿了,大家感受到了吗? -
用DEEPSEEK V4 FLASH造了两天卫星,实测模型能力提升巨大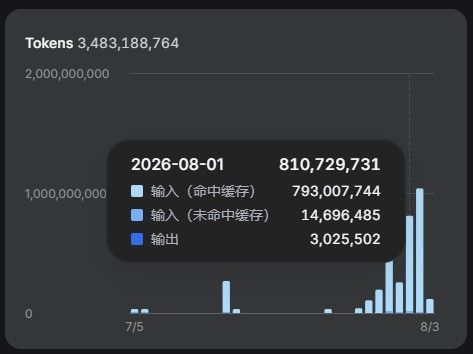
FLASH版本更新之后进行了两天较高强度的工作,感觉模型能力提升非常大。
第一天我把主力Hermes的全部技能进行了修正优化,把Hermes的智力提升了一个档次,当然智力的提升和FLASH能力的提升也有很大关系,主要是对技能重构,精练语言,查漏补缺等操作,降低后续Hermes使用过程中的token消耗;
第二天我是基于QWEN TTS的一个版本进行了系统化的升级,根据我自己的使用方案进行了详细调整,最后文本转语音效果达到我的预期;整体使用下来FLASH最大的进步就是知道自己该干什么了,不像以前你要一步一步的进行指导,思考能力上了一个大的台阶,而且还能主动进行周边的信息参考和探索保证不会出现意外的BUG。
-
请教一下大家deepseek v4 flash驱动hermes都开推理吗?