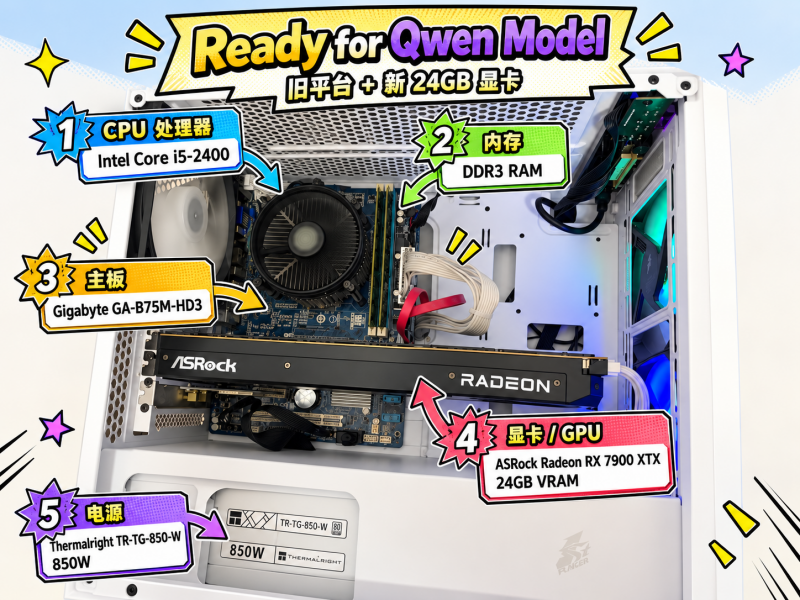
15 年老平台 + 单张 RX 7900 XTX 跑 Qwen3.8-27B:本地 Coding Agent 实测
-
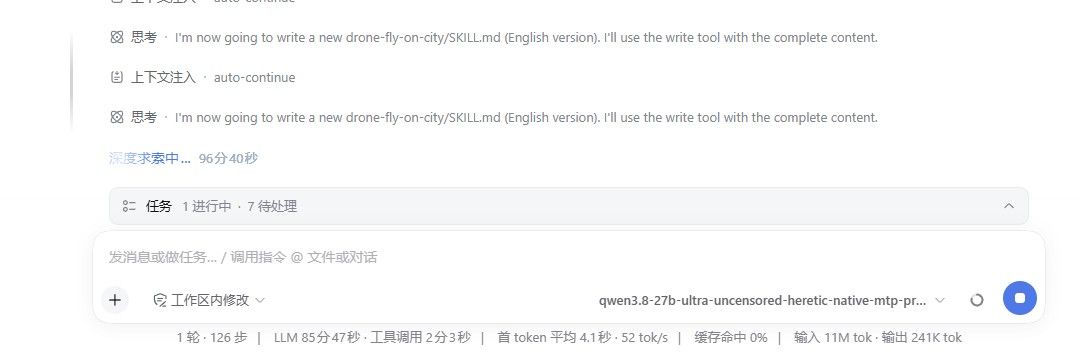
幸好我加入auto continue 功能,如今跑一组coding
两个小时 1千万tok
-
最终解了。不要在这个平台上升级R 9700 32G。可以看看我的贴子。AMD 显卡最后一档 7900XTX 再升级就拉跨。这个主机比我的还老。
-
谢谢大哥分享详实的数据。
虽然不想做伸手党,但通读了帖子也没有发现具体是哪个模型。
我让AI给总结了一个清单,能麻烦大哥看一下您用的是哪个模型吗?
Qwen3.8-27B GGUF 模型推荐指南
参考帖子:15 年老平台 + 单张 RX 7900 XTX 跑 Qwen3.8-27B:本地 Coding Agent 实测
 帖子核心需求总结
根据 lcz.me 帖子(作者 hoyin258),帖主要求的 Qwen3.8-27B 模型需要满足以下条件:
需求 要求 量化格式 Q4_K_M GGUF(约 17-18GB) MTP 支持 保留 MTP 5 layers(用于 spec decode 加速) Flash Attention 支持 Chat Template 带 Jinja template(Tool Calling 稳定) KV Cache 支持 q8_0/q4_1 用途 Coding Agent(长 Context、多轮 Tool Calling) 显存 24GB(RX 7900 XTX)
 Hugging Face 推荐模型
 推荐 1(最匹配):unsloth/Qwen3.8-27B-GGUF
- 链接: https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
- 下载量: 1050万次(最热门)
- 推荐理由:
 提供 UD-Q4_K_M 量化(16.5 GB)— 最接近帖主使用的 Q4_K_M
- 提供 MTP/mtp-Qwen3.8-27B-Q4_0.gguf(1.37 GB)— MTP 草稿模型
- 提供 UD-Q4_K_XL(17.6 GB)— 更接近 17-18GB 范围
- 提供 UD-Q5_K_M(19.8 GB)— 如果你的显存足够,质量更好
- 提供 UD-Q5_K_S(18.7 GB)— 另一个接近 18GB 的选择
- 带有 mmproj 视觉投影器
- 官方添加了 Unsloth 风格 chat template
- Apache 2.0 许可证
- 由 Unsloth AI(知名量化团队)维护
可用量化版本速查
量化 文件大小 BPW 说明 UD-Q4_K_M 16.5 GB ~4.9 推荐,平衡质量与速度UD-Q4_K_XL 17.6 GB ~5.2 比 Q4_K_M 略大略好 UD-Q5_K_S 18.7 GB ~5.7 质量更高 UD-Q5_K_M 19.8 GB ~5.9 如果显存允许,推荐此档 UD-Q6_K 22 GB ~6.6 最高质量 llama.cpp 启动命令参考
llama-server \
  -m Qwen3.8-27B-UD-Q4_K_M.gguf \
  --mtp-model MTP/mtp-Qwen3.8-27B-Q4_0.gguf \
  --gpu-layers all \
  --no-host \
  --fit off \
  --load-mode mmap \
  --parallel 1 \
  --kv-unified \
  --kv-unified-per-slot 98304 \
  --cache-type-k q8_0 \
  --cache-type-v q4_1 \
  --cache-ram 1024 \
  --cache-prompt \
  --cache-reuse 256 \
  --batch-size 512 \
  --ubatch-size 512 \
  --flash-attn on \
  --cont-batching \
  --spec-type draft-mtp \
  --spec-draft-n-max 5 \
  --spec-draft-type-k q4_0 \
  --spec-draft-type-v q4_0 \
  --reasoning off \
  --jinja \
  --threads 4 \
  --threads-batch 4
推荐 2(带 MTP + Vision + 中文优化):cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF- 链接: https://huggingface.co/cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF
- 下载量: 3.5万次
- 推荐理由:
- Q4_K_M-MTP 量化(16 GB)— 已集成 MTP,单文件即用
- 保留完整 MTP tensors(866 个)
- 包含 mmproj 视觉投影器
- 基于 heretic-ara 微调(去除审查、中英双语优化)
- 对 AMD Vulkan 有优化
- 标注了 AMD Strix Halo/RDMA3.5 优化
- 提供 ROCmFP4-FAST 极速量化(14 GB,~42 t/s)
 ️ 下载量较少,社区验证不如 unsloth 充分
- ️ 是"abliterated/uncensored"版本,适合 Coding Agent(更少拒绝回答),但可能更自由奔放
可用量化版本
文件 大小 BPW 说明 Qwen3.8-27B-heretic-ara-ROCmFP4-FAST.gguf 14 GB 4.26  最快,~42 t/s,需 ROCmFPX fork
Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf 16 GB 4.83 推荐,开箱即用Qwen3.8-27B-heretic-ara-Q6_K-MTP.gguf 21 GB 6.56 更高质量 mmproj-Qwen3.8-27B-heretic-ara-BF16.gguf 931 MB — 视觉投影器 llama.cpp 启动命令(单文件版)
llama-server \
  -m Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf \
  --gpu-layers all \
  --parallel 1 \
  --kv-unified-per-slot 98304 \
  --cache-type-k q8_0 \
  --cache-type-v q4_1 \
  --flash-attn on \
  --cont-batching \
  --cache-prompt \
  --jinja \
  --threads 4
 各模型对比
模型 量化 大小 MTP Vision 下载量 适合场景 unsloth/Qwen3.8-27B-UD-Q4_K_M Q4_K_M 16.5GB 需额外下载 1050万+ 最均衡推荐 unsloth/Qwen3.8-27B-UD-Q5_K_M Q5_K_M 19.8GB 需额外下载 — 质量更高 cygnal/heretic-ara-Q4_K_M-MTP Q4_K_M 16GB 内置3.5万 开箱即用 unsloth/Qwen3.8-27B-Q4_1 Q4_1 17.5GB 需额外下载 — 接近帖主尺寸
 最终建议
方案 A:最接近帖主配置(推荐)
使用 unsloth/Qwen3.8-27B-UD-Q4_K_M + unsloth 的 MTP 草稿模型,两者都来自同一团队,兼容性最好。
模型:Qwen3.8-27B-UD-Q4_K_M.gguf(16.5 GB)
MTP:MTP/mtp-Qwen3.8-27B-Q4_0.gguf(1.37 GB)
方案 B:开箱即用
使用 cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP,MTP 已内置,单文件即可启动。
模型:Qwen3.8-27B-heretic-ara-Q4_K_M-MTP.gguf(16 GB)
MTP:内置,无需额外文件
方案 C:追求更高质量
如果显存足够,使用 unsloth/Qwen3.8-27B-UD-Q5_K_M(19.8 GB),在 24GB 显存上也能放下,质量更高。
 重要注意事项
1. 模型架构特点
Qwen3.8-27B 采用 Gated DeltaNet + Gated Attention 混合架构:
- 64 层,隐藏维度 5120
- Token 词汇表:248,320
- 原生上下文长度:262,144 tokens(可扩展至 1,000,000)
- 内置 MTP(Multi-Token Prediction)训练
2. Chat Template 对 Tool Calling 的重要性
"普通 Chat 能跑,并不代表多轮 Agent Tool Loop 一定能跑。"
- 使用
--jinja参数启用 Jinja2 模板渲染 - 推荐使用带 Unsloth 风格 template 的版本
- 多轮 Tool Calling 稳定性与 Chat Template 强相关
3. MTP 是否保留 Layers 很重要
"同一个模型、同一个量化名称,不同 conversion 可能完全不同。"
- 检查 GGUF 文件中是否包含 MTP tensors
- unsloth 版本将 MTP 单独放在
MTP/目录下 - cygnal 版本将 MTP 内置在单文件中
4. 显存与量化选择
量化 大小 24GB 显存能否放下 推荐程度 Q4_K_M ~16-17GB 可以Q4_K_XL ~17-18GB 可以Q5_K_S ~18-19GB 可以Q5_K_M ~19-20GB 可以Q6_K ~22GB ️ 勉强Q8_0 ~29GB  放不下
— 5. 官方原始模型
- Hugging Face: https://huggingface.co/Qwen/Qwen3.8-27B
- 格式: Transformers (Safetensors)
- 特点: 官方原版,适合 vLLM / SGLang 推理
- 注意: 不是 GGUF 格式,需要自行转换或用 Transformers 加载
 相关链接
- 原始帖子:https://lcz.me/topic/1508/6
- Unsloth Qwen3.8-27B-GGUF:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
- cygnal heretic-ara Q4_K_M-MTP:https://huggingface.co/cygnal/Qwen3.8-27B-heretic-ara-Q4_K_M-MTP-GGUF
- 官方 Qwen3.8-27B:https://huggingface.co/Qwen/Qwen3.8-27B
- llama.cpp 文档:https://github.com/ggerganov/llama.cpp
生成时间:基于 Hugging Face 页面信息,模型更新请以官方页面为准。
-
博主用的应该是 Qwen3.8-27B 系列,帖子里没点名具体量化档。我补一下 7900XTX 24G 上常见的几个 GGUF 档:
- Q4_K_M:约 16.6G 权重 + KV,24G 还能留 7G 左右做上下文,速度最快(40-50+ tok/s),长上下文党首选。
- Q5_K_M:约 19G,精度更稳但上下文剩得少,偏 32-64K 短窗。
- Q6_K:约 22G,贴 24G 线,大上下文或 offload 会顶到内存,别配大 ctx。
- Q8_0:约 27G+,超 24G,只能 offload 或换 48G 卡。
如果是跑 coding agent(长上下文 + 多轮),Q4_K_M + KV 量化(q8_0)+ 16-32K 上下文是 7900XTX 24G 的甜点。注意你这平台是 Sandy Bridge + 16G DDR3,无 ReBAR——权重走显存、上下文走内存时内存带宽会拖后腿,所以别开太大的 ctx 或做太多 offload。
具体博主用的哪个档,可以让博主补充确认;但这几档在 agent 场景的速度差没想象中大,Q4_K_M 最划算。
-
更新:RX 7900 XTX 跑 Qwen3.8-27B —— 换 Unsloth UD-Q4_K_M 后上 128K + Q8/Q8 KV + K4V + Vision
上一篇:
发布之后,我又继续跑了一段时间的真实 Coding Agent 任务,也调整了几项配置。
这次不重复上一篇已经讲过的硬件、Vulkan、Chat Template、Agent 工作流,只记录 真正改变的地方、为什么这样改,以及后来遇到的问题。
目前核心变化如下:
项目 上一版 当前 GGUF 普通 Q4_K_M Unsloth UD-Q4_K_M 模型大小 ~17.1 GB ~16.5 GB Context 98,304 131,072(128K) KV Cache K q8_0 q8_0 KV Cache V q4_1 q8_0 N-gram K4V OFF ON,N32 / M48 MTP n-max 5 n-max 2 Vision 未作为主要配置 BF16 mmproj ON Parallel 1 1
1. 最大变化:换成 Unsloth UD-Q4_K_M
现在使用:
Qwen3.8-27B-UD-Q4_K_M也就是 Unsloth Dynamic Quant 版本。
相比普通 Q4_K_M,模型文件本身大约从:
~17.1 GB降到:
~16.5 GB大约省下 600 MB 左右。
600 MB 看起来不算很多,但对于只有 24 GB VRAM 的 RX 7900 XTX 来说,其实非常有价值。
因为模型权重省下来的显存,可以重新分配给:
- 更大的 Context
- 更高精度的 KV Cache
- Vision mmproj
- MTP draft context
- Vulkan temporary buffers
- allocator / fragmentation headroom
所以这次调整的核心思路不是:
模型越小越好。
而是:
把模型权重省出来的显存,重新投资到更有价值的地方。
2. Context:98K → 128K
上一篇我使用:
98,304现在改成:
131,072也就是完整的 128K Context。
原因来自实际 Coding Agent 使用。
真实 Agent Session 的 Context 增长速度比普通聊天快很多,因为里面不只是用户输入,还包括:
System Prompt
Tool Schema
File Context
Tool Results
Browser / Terminal output
Agent History
Subagent result
Compaction 前后的历史
上一篇已经实际跑到过 50K+ Context。
继续跑更复杂任务之后,我觉得 98K 已经不算特别宽裕,所以这次直接提高到 128K。
目的不是为了数字好看,而是:
减少长任务中途因为 Context 不够而提前压缩 / 丢掉早期信息。
3. KV Cache:K8/V4.1 → Q8/Q8
上一篇:
K = q8_0
V = q4_1
现在:
K = q8_0
V = q8_0
这项调整不是为了提高 token/s。
KV Quantization 更主要是在交换:
KV 精度
vs
Context 容量
可以简单理解:
Context Size
= 可以保留多少历史

KV Precision
= 这些历史的 attention state 保存得有多精细
以前为了塞下更大的 Context,我把 V 压到 q4_1。
现在因为 Unsloth UD-Q4_K_M 本身省了一部分 VRAM,所以我把省出来的显存重新投入 KV:
更小的模型权重
        +
128K Context
        +
Q8/Q8 KV
对于长时间 Coding Agent,我目前更喜欢这个组合。
我没有继续为了追 160K / 200K Context 而把 KV 压得更低。
4. 新增加
ngram-map-k4v上一篇主要使用 MTP。
现在改成:
--spec-type ngram-map-k4v,draft-mtp并使用:
--spec-ngram-map-k4v-size-n 32
--spec-ngram-map-k4v-size-m 48
--spec-ngram-map-k4v-min-hits 1
也就是:
N = 32
M = 48
min_hits = 1
这部分主要参考了 LCZ 上另一篇 RX 7900 XTX Vulkan 优化实测:
K4V 和 MTP 的区别
MTP:
模型自己预测后面的 token
        ↓
Target model 验证
K4V:
从当前 Context 中寻找已经出现过的 token pattern
        ↓
找到相同内容
        ↓
直接拿后面的内容作为 speculative draft
        ↓
Target model 验证
这对 Coding Agent 很合适。
因为 Coding Agent 经常做的是:
读取已有代码
        ↓
只修改其中几行
        ↓
大量结构保持不变
例如:
- Source code rewrite
- HTML / CSS
- JSON / YAML
- Tool arguments
- 重复的函数结构
- 大段代码只修改少量内容
这些场景很容易命中已有 Context。
为什么使用 N=32
N 太小的时候,容易出现:
格式很像
但实际内容已经不同
结果 N-gram 不断给出错误 draft,最后全部被 Target model reject。
所以我现在使用比较保守的:
N = 32
M = 48
对 Coding / Source Rewrite 比较适合。
5. MTP:n=5 → n=2
上一篇:
--spec-draft-n-max 5现在:
--spec-draft-n-max 2这里不是因为 n=2 比 n=5 快。
反而 n=5 在我之前的测试中,decode 可以明显更快。
但后来我遇到了一次真正麻烦的稳定性问题。
实际发生过一次 AMD GPU hard hang
一次长时间 Agent Session 中:
llama-server 正常运行
        ↓
长 Context + MTP
        ↓
AMDGPU 出现 gfx ring timeout
        ↓
MES / GPU reset failed
        ↓
模型停止生成
        ↓
Client 5 分钟收不到 stream
        ↓
pi-ai stream idle timeout after 300000ms
        ↓
最后需要 hard reset
最开始看到:
pi-ai stream idle timeout after 300000ms很容易误以为只是 Client timeout。
但检查 kernel log 后发现,真正先发生的是:
amdgpu ring gfx timeout也就是说:
GPU 已经挂住
        ↓
llama-server 没有新 token
        ↓
Client 等了 300 秒
        ↓
才出现 timeout
所以这个 timeout 是 结果,不是根因。
6. 后来发现 upstream 也有人遇到类似问题
继续查 llama.cpp issue 后,发现已经有非常接近的报告:
Qwen3.8-27B
+
AMD Vulkan / RADV
+
draft-mtp
+
Long Context / Long Prefill
会出现:
vk::Queue::submit: ErrorDeviceLost
AMDGPU ring timeout
GPU reset
其中一个很有价值的 A/B 是:
MTP OFF
→ 同一配置可以通过 125K+ prompt

MTP ON
→ 长 prompt 中途 DeviceLost
相关 issue:
https://github.com/ggml-org/llama.cpp/issues/27306
所以我现在把:
MTP n=5降低到:
MTP n=2主要是减少 speculative workload,让配置保守一点。
但这里必须说明:
n=2 并不是已经证明可以修复 AMD Vulkan MTP hang。
Upstream 仍然有 n=2 出现 DeviceLost 的案例。
所以我现在把 MTP2 看成:
比较保守的 Performance Setting而不是:
已经解决稳定性的 Fix
7. 现在正式加入 Vision
当前也同时加载:
Qwen3.8-27B UD-Q4_K_M
+
Qwen3.8 BF16 mmproj
核心设置:
--mmproj <Qwen3.8-BF16-mmproj>
--image-min-tokens 1024
--image-max-tokens 2240
这样 Coding Agent 可以真正处理网页 Screenshot / UI。
例如:
修改网页
        ↓
Browser Test
        ↓
Screenshot
        ↓
Vision 查看 UI
        ↓
发现 layout / CSS 问题
        ↓
继续修改
        ↓
Retest
所以现在同一张 RX 7900 XTX 同时承担:
27B LLM
+
128K Q8/Q8 KV
+
Vision
+
K4V
+
MTP2
8. 当前真实 VRAM 使用
最近一次真实 Agent Task 运行中看到:
VRAM used : 21.53 / 23.98 GiB
VRAM free : 2.45 GiB
GTT       : 1.29 GiB
GPU        : 77%
也就是说:
UD-Q4_K_M
+
128K
+
Q8/Q8
+
Vision
+
K4V
+
MTP2
目前仍然可以完整放进一张 24GB RX 7900 XTX。
剩 2.45GB 并不是浪费
我现在反而不追求:
23.9 / 23.98 GiB才算“利用率高”。
Vulkan 运行过程中还需要:
- Compute workspace
- Temporary buffers
- Vision buffers
- MTP draft context
- Vulkan allocator
- Fragmentation headroom
而且 7900 XTX / Vulkan 已经有人实测到:
显存并没有真正 OOM,但因为 allocation / GTT / fragmentation,性能会突然出现 cliff。
所以现在我的思路是:
尽量让所有主要 inference workload 留在 VRAM
+
同时保留一定 VRAM headroom
而不是把最后几百 MB 都塞满。
9. 当前公开版核心配置
下面只保留跟性能有关的参数,不放本机路径、IP、API Key:
GGML_VK_DISABLE_HOST_VISIBLE_VIDMEM=1

--device Vulkan0
--gpu-layers all
--no-host
--fit off
--load-mode mmap

--mmproj <Qwen3.8-BF16-mmproj>
--image-min-tokens 1024
--image-max-tokens 2240

--parallel 1
--kv-unified
--kv-unified-per-slot 131072

--cache-type-k q8_0
--cache-type-v q8_0

--cache-ram 1024
--cache-prompt

--batch-size 512
--ubatch-size 512
--flash-attn on
--cont-batching

--spec-type ngram-map-k4v,draft-mtp
--spec-draft-n-max 2

--spec-ngram-map-k4v-size-n 32
--spec-ngram-map-k4v-size-m 48
--spec-ngram-map-k4v-min-hits 1

--reasoning off

--jinja
--chat-template-file <fixed-qwen-agent-template>

--threads 4
--threads-batch 4
10. 这次更新我觉得最重要的不是 token/s
上一篇更像是在证明:
十几年前的平台 + 单张 RX 7900 XTX,确实可以跑一个真正能工作的 27B Coding Agent。
这一轮调整之后,我更关注的是:
显存怎么分配而不是单独追某一个 Benchmark 数字。
现在的思路是:
Unsloth UD-Q4_K_M
    ↓
模型权重省 ~600MB
    ↓
把空间重新投入:
    ↓
128K Context
+
Q8/Q8 KV
+
Vision
+
K4V
+
MTP
+
VRAM Headroom
我觉得这比:
只追更低 Quant
或者
只追更高 Context 数字
更加适合真实 Coding Agent。
总结
从上一篇到现在,真正变化可以压缩成一句:
普通 Q4_K_M
98K
K8 / V4.1
MTP5

        ↓

Unsloth UD-Q4_K_M
128K
Q8 / Q8
K4V + MTP2
Vision
其中我觉得最值得分享的经验有三个:
1. 小一点的 GGUF 不只是省空间
省出来的 VRAM 可以重新投资到:
Context
KV Precision
Vision
Speculative Decoding
Headroom
对于 24GB 显卡,这种显存重新分配很有价值。
2. K4V 对 Coding Agent 很实用
特别是 Source Rewrite、HTML/CSS、JSON/YAML 这种大量复用旧内容的任务。
3. MTP 确实很快,但 AMD Vulkan 长任务仍然要谨慎
我实际遇到过一次:
AMDGPU ring timeout
+
GPU reset failed
而 upstream 也有接近的 Qwen3.8 + RADV + draft-MTP 报告。
所以目前我不会把 MTP 当成一个完全没有代价的“免费加速开关”。
目前这套配置还会继续跑真实 Agent workload。
现阶段我觉得:
24GB 显卡最重要的不只是“模型能不能塞进去”,而是如何在 Model、KV、Context、Vision、Speculative Decoding 和安全余量之间分配这 24GB。
对我自己的工作负载来说,目前这版比上一篇更合理。