跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI Agent
  4. 7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比(续三)- 最终测试对比报告(基于自己的工作流)

7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比(续三)- 最终测试对比报告(基于自己的工作流)

已定时 已固定 已锁定 已移动 精华 热议 AI Agent
7900xtxsg-langvllm
33 帖子 11 发布者 1.2k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • GeekyangG Geekyang

    @Ben-Lee 其实我一直好奇,你机器里怎么摆进去两张7900xtx的

    farmer nodeF
    farmer nodeF
    farmer node
    德高望重 劳动模范
    编写于 最后由 编辑
    #18

    @Geekyang 可以不用机箱,用机架,开放式机架,只要主板支持,想放多少显卡都没问题

    1 条回复 最后回复
    0
    • A applejuice

      @张光璞 pcie switch 是pcie 4 还是5?
      我看到pcie 4 4 卡都要4000块..

      张光璞张
      张光璞张
      张光璞
      技术大牛 劳动模范
      编写于 最后由 编辑
      #19

      @applejuice 说:

      @张光璞 pcie switch 是pcie 4 还是5?
      我看到pcie 4 4 卡都要4000块..

      我有发贴,pcie4 的, 2380 ? 还是2350

      1 条回复 最后回复
      0
      • 懒人烘培懒
        懒人烘培懒
        懒人烘培
        德高望重 劳动模范
        编写于 最后由 编辑
        #20

        这一路也是跟着技术牛人们学习。
        “特别感谢公司给我创造了能够上班摸鱼完成这项测试”,嘿嘿

        双 7900 XTX:模型本地跑,Token 随便烧!

        1 条回复 最后回复
        0
        • GeekyangG Geekyang

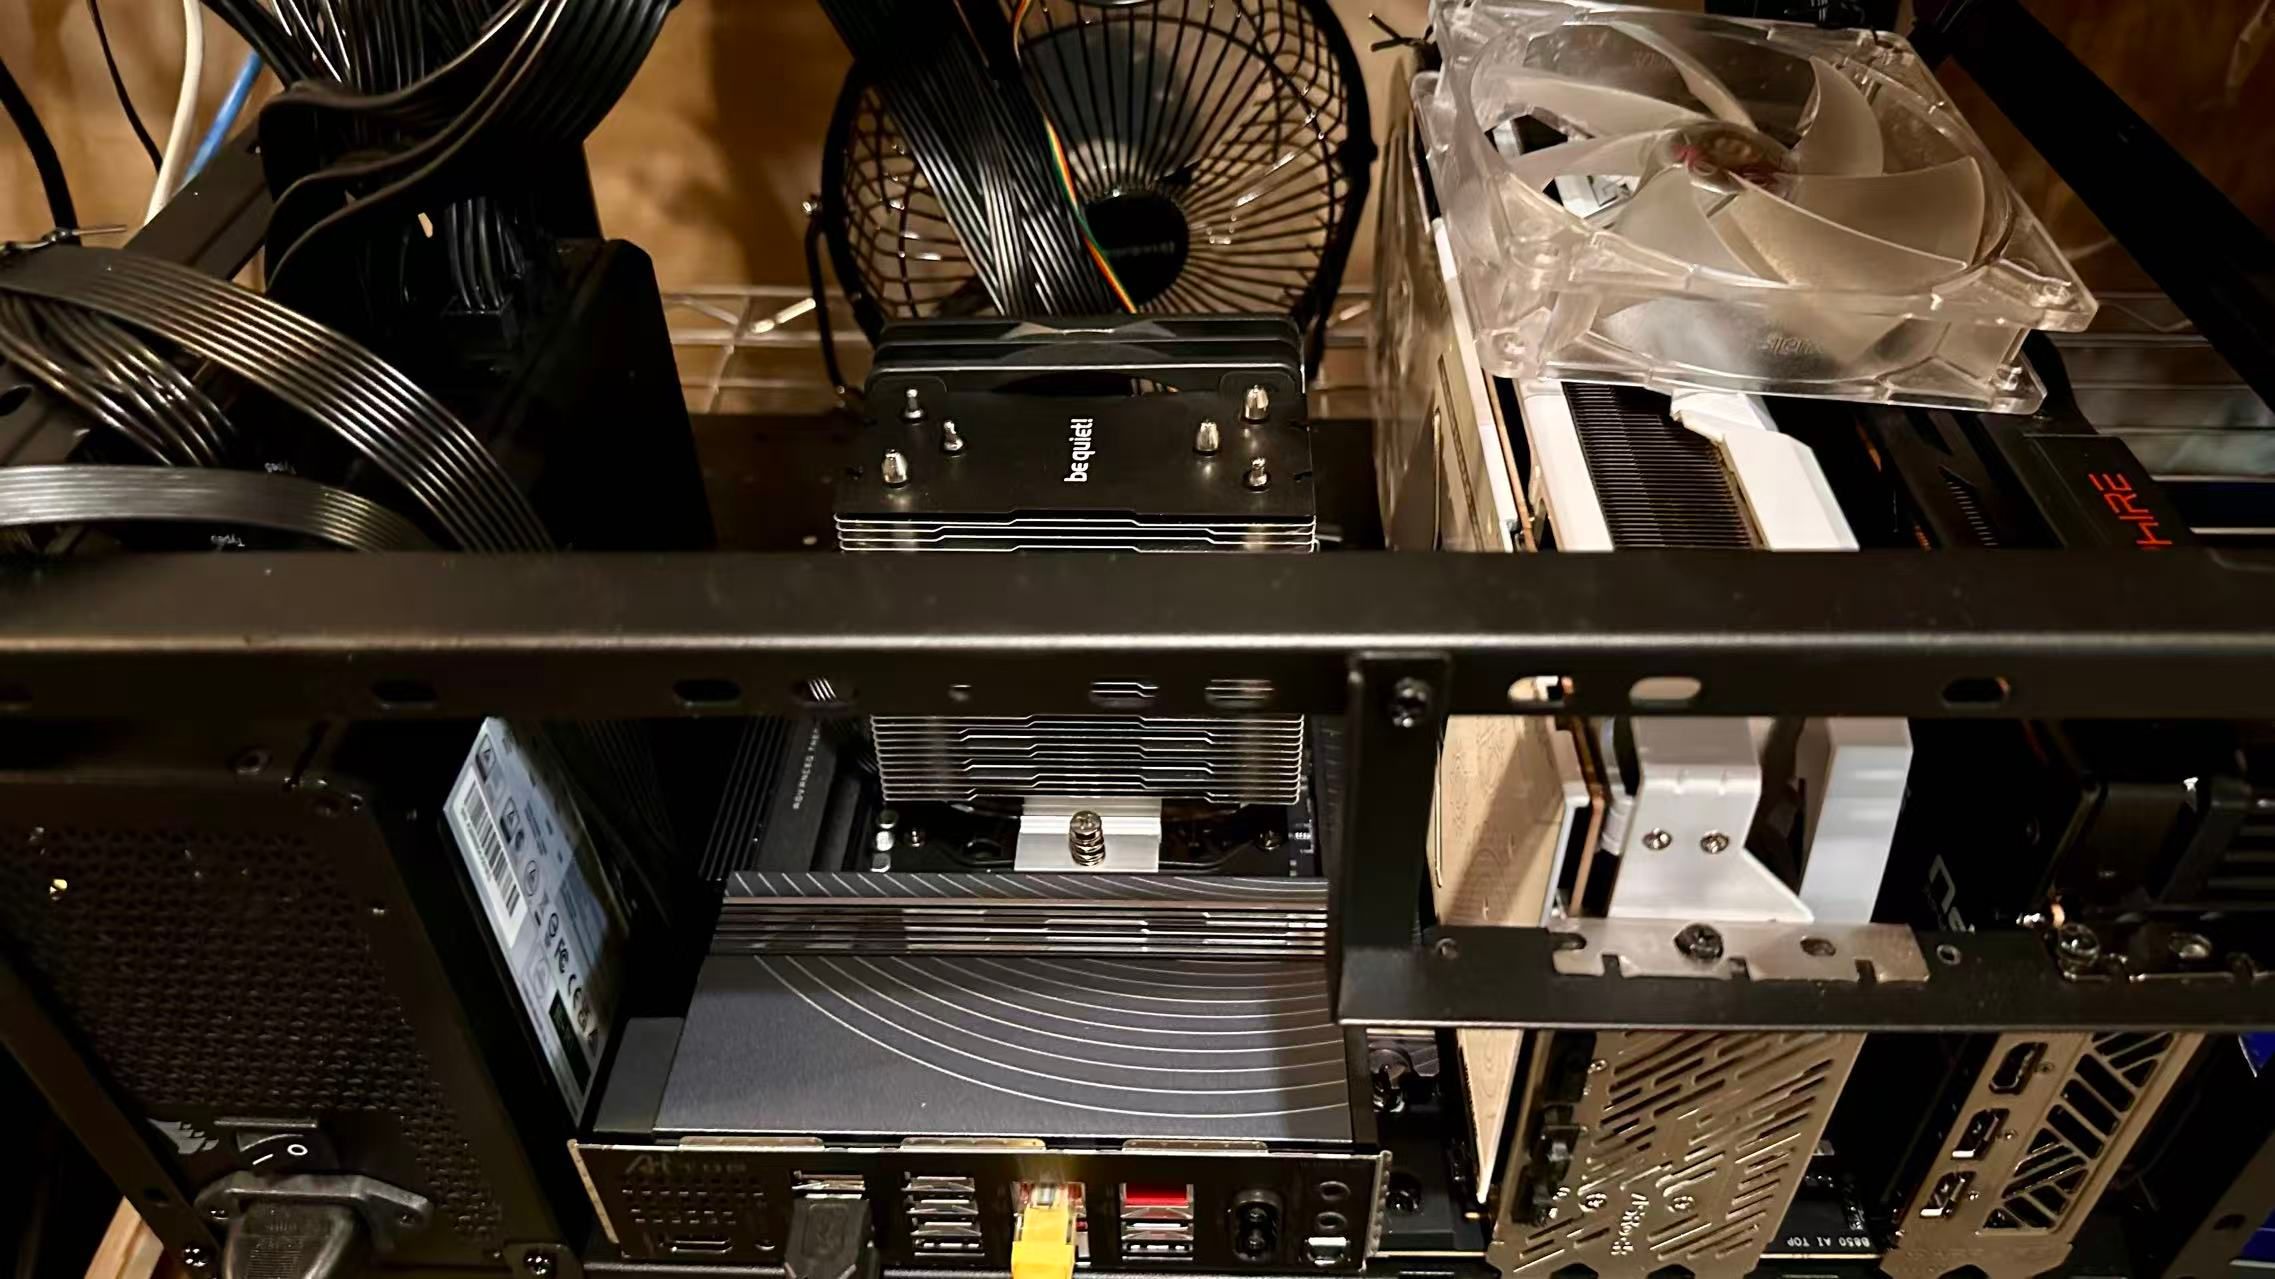
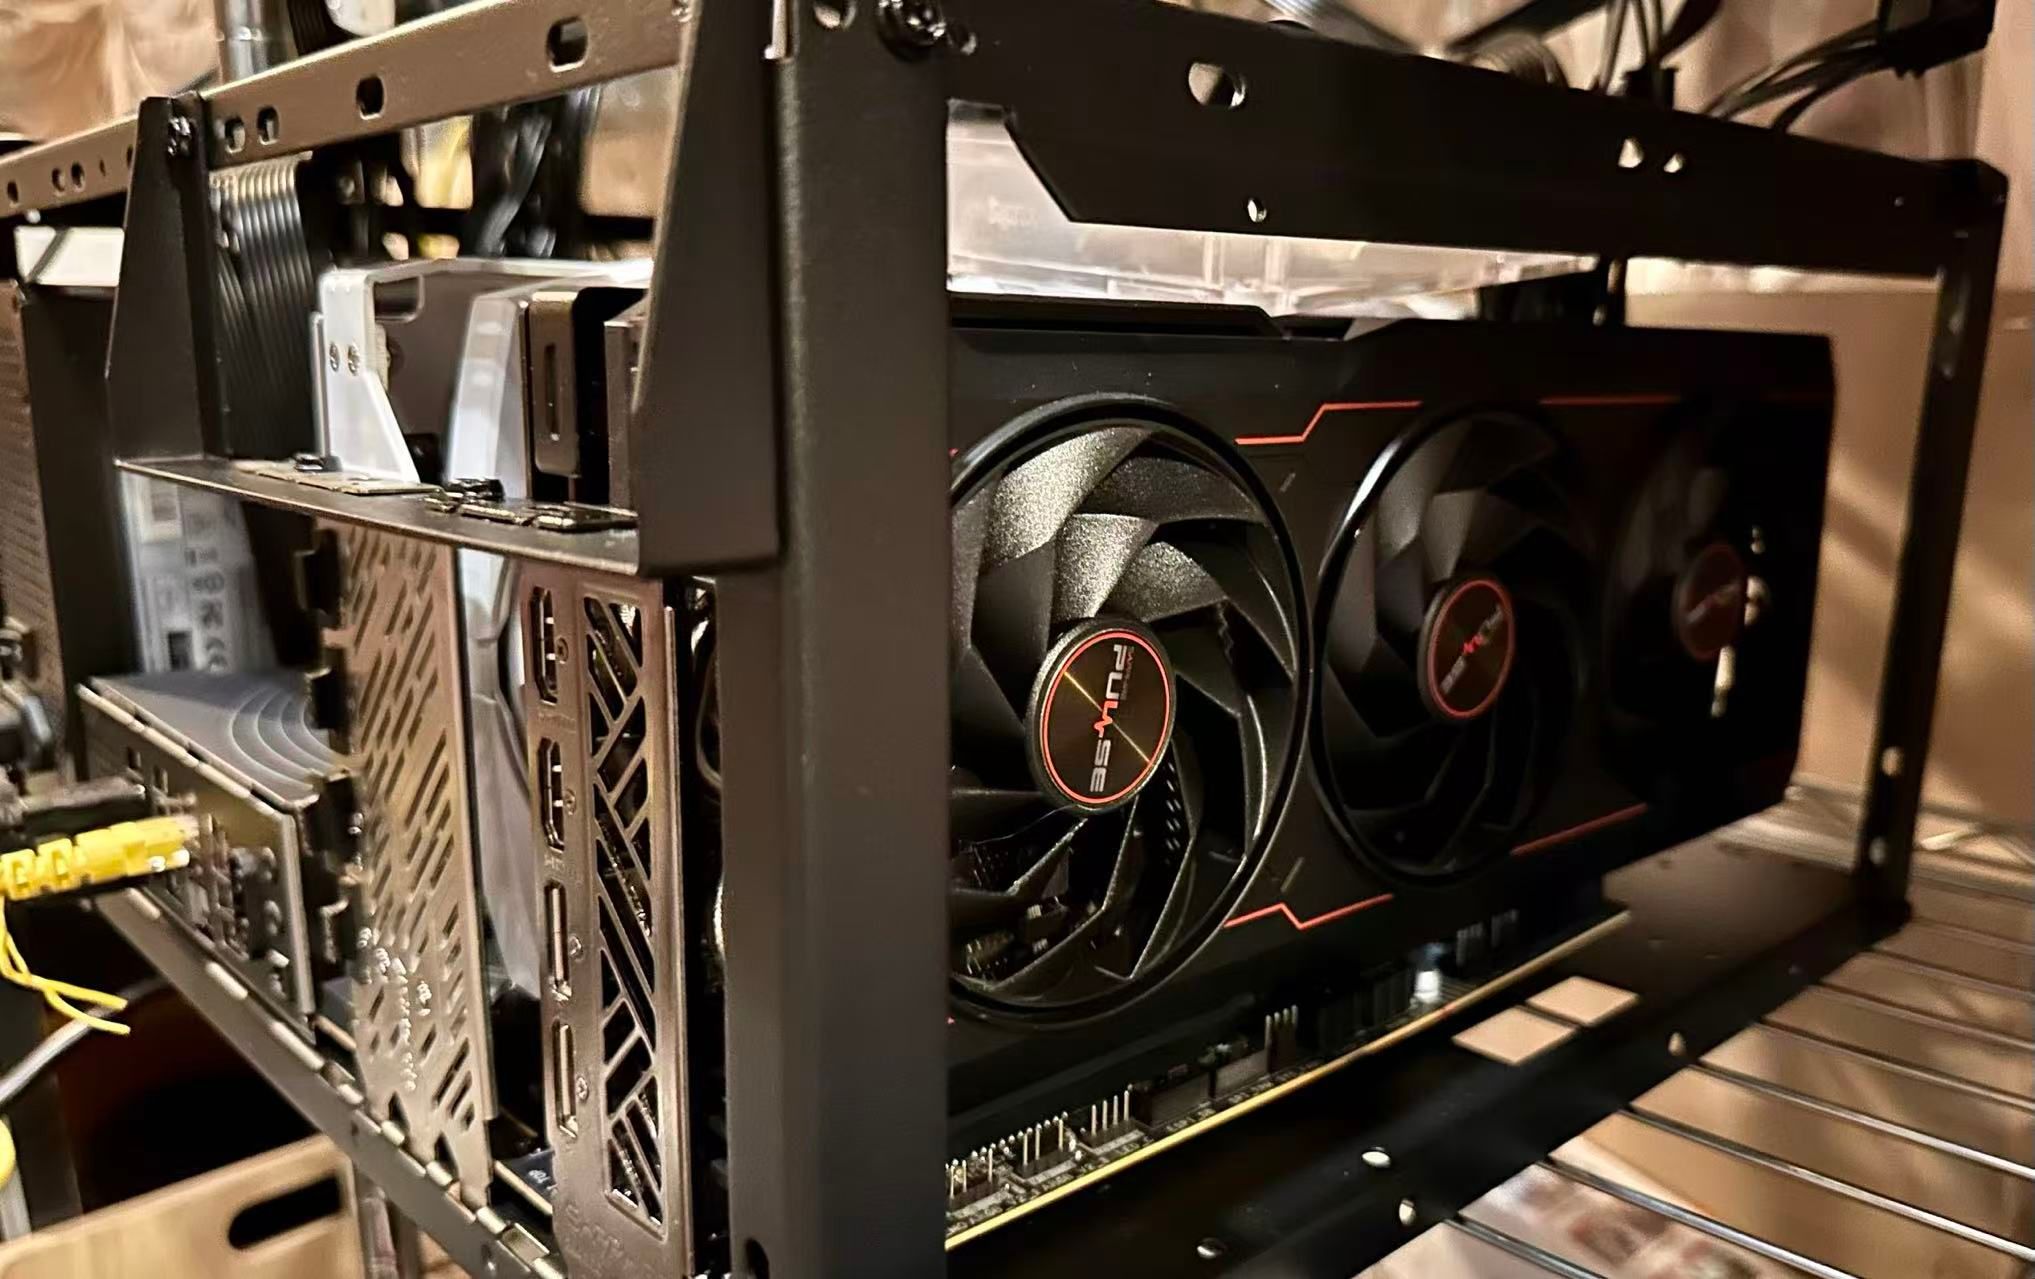
          @Ben-Lee 其实我一直好奇,你机器里怎么摆进去两张7900xtx的

          Ben LeeB
          Ben LeeB
          Ben Lee
          超凡大师
          编写于 最后由 编辑
          #21

          @Geekyang 对,我用的开放式机架

          215e3f9305b7cd16f8a0bdb5027edaee.jpg

          8934a6aa3a52062cac83b689c284d122.jpg

          1 条回复 最后回复
          2
          • farmer nodeF farmer node

            @Ben-Lee max-consecutive-prefill-batches 这个参数我看你之前 有加过 ,现在反而没见你加呢?

            Ben LeeB
            Ben LeeB
            Ben Lee
            超凡大师
            编写于 最后由 编辑
            #22

            @farmer-node 看的这么仔细啊,感谢关注哈~这个参数确实是我之前加过的。后来升级到新版 SGLang(f84475c)之后,官方把它移除了,我当时的第一反应真的就是"天塌了"😅 不过好在找到了替代方案 --enable-mixed-chunk,思路类似但实现更干净,效果还略好一丢,所以现在的 production 就没再单独加回那个参数了。

            这段过程我在续一里写过,在测试数据后面的"附录:小白折腾记"那部分,第一节”一、N=1 没了,天塌了“,有兴趣可以翻一下:https://lcz.me/topic/1740

            farmer nodeF 2 条回复 最后回复
            2
            • Ben LeeB Ben Lee

              @farmer-node 看的这么仔细啊,感谢关注哈~这个参数确实是我之前加过的。后来升级到新版 SGLang(f84475c)之后,官方把它移除了,我当时的第一反应真的就是"天塌了"😅 不过好在找到了替代方案 --enable-mixed-chunk,思路类似但实现更干净,效果还略好一丢,所以现在的 production 就没再单独加回那个参数了。

              这段过程我在续一里写过,在测试数据后面的"附录:小白折腾记"那部分,第一节”一、N=1 没了,天塌了“,有兴趣可以翻一下:https://lcz.me/topic/1740

              farmer nodeF
              farmer nodeF
              farmer node
              德高望重 劳动模范
              编写于 最后由 编辑
              #23

              @Ben-Lee 我可是跟着你的参数跑的,哈哈哈

              1 条回复 最后回复
              0
              • farmer nodeF farmer node

                @Ben-Lee 你这个方案是我sglang 本地的高速方案,我分享一下我本地的另一套vllm 的方案,不能用MTP ,Dflash2 加速,但是可以用 int8 KV, 真正的8并发,总吞吐 240
                左右:

                • GitHub 仓库:https://github.com/JartX/vllm
                • 分支:perf/rdna3_full_stack
                • 实测 Commit ID:c5647a6d4695279456d830d6c2f52edd4c54524a
                • 核心修复项:
                  1. QuickReduce 跨卡 PCIe 描述符修复(0x31014000):彻底消除 RDNA3 双卡通信读 0 乱码与静默死锁;
                  2. Qwen GDN MTP:修复预热阶段 index_copy_ 的 dtype 异常。

                二、 部署配置与显存 / KV Cache 切片

                1. 生产甜点位启动命令
                  bash
                  docker run -d
                  --name vllm-prod
                  --ipc=host
                  --network=host
                  --shm-size=32g
                  --device=/dev/kfd
                  --device=/dev/dri
                  --group-add video
                  -e HSA_OVERRIDE_GFX_VERSION=11.0.0
                  -e ROCR_VISIBLE_DEVICES=0,1
                  -e PYTHONPATH="/opt/rocm-7.2.4/share/amd_smi"
                  -v /home/kuma/models:/models:ro
                  jartx-vllm:latest
                  vllm serve /models/Qwen3.8-27B-W4A16-AutoRound
                  --host 0.0.0.0
                  --port 8080
                  --tensor-parallel-size 2
                  --kv-cache-dtype int8_per_token_head
                  --max-model-len 131072
                  --max-num-seqs 8
                  --max-num-batched-tokens 8192
                  --attention-backend TRITON_ATTN
                  --enable-prefix-caching
                  --enable-chunked-prefill
                  --gpu-memory-utilization 0.95
                  --trust-remote-code

                2. 显存分配切片(2×24GB 运行时抓取)

                • 单卡物理显存:23.98 GiB
                • 静态权重 + 基础开销:9.70 GiB
                • Peak Activation(峰值激活):2.41 GiB
                • CUDAGraph 内存:0.67 GiB
                • 动态 KV Cache 可用显存:10.68 GiB / 卡
                • 物理 KV Cache 总容量:638,075 tokens(约 63.8 万 tokens)
                • 单请求上下文上限 (max-model-len):131,072 tokens (131K)
                • 物理并发承载力:
                  • 131K 极限上下文:支持 4.87 倍并发(4 路 120K 超长文本吃满不排队)
                  • 32K Agent 常见上下文:支持 19.9 倍并发
                  • 8K 短对话:支持 79.7 倍并发

                三、 全梯队压测实测数据(纯并发模式,流式解耦)

                测试场景 / 上下文深度: 短文本 (1K~4K)
                并发路数: 1 路
                首字延迟 (TTFT): 0.40 s
                单路纯解码速率: 56.16 tok/s
                稳态聚合吞吐 (实测): 56.16 tok/s
                表现分析: 超过作者 49.2 t/s 基准 +15.5%
                ────────────────────────────────────────
                测试场景 / 上下文深度: 短文本 (1K~4K)
                并发路数: 2 路
                首字延迟 (TTFT): 0.54 s
                单路纯解码速率: 47.22 tok/s
                稳态聚合吞吐 (实测): 94.44 tok/s
                表现分析: 近似线性扩展
                ────────────────────────────────────────
                测试场景 / 上下文深度: 短文本 (1K~4K)
                并发路数: 4 路
                首字延迟 (TTFT): 1.00 s
                单路纯解码速率: 43.10 tok/s
                稳态聚合吞吐 (实测): 172.39 tok/s
                表现分析: 高吞吐甜点位
                ────────────────────────────────────────
                测试场景 / 上下文深度: 短文本 (1K~4K)
                并发路数: 8 路
                首字延迟 (TTFT): 2.11 s
                单路纯解码速率: 30.94 tok/s
                稳态聚合吞吐 (实测): 247.53 tok/s
                表现分析: 触及双卡 512GB/s 显存带宽物理极限
                ────────────────────────────────────────
                测试场景 / 上下文深度: 中长文本 (30K)
                并发路数: 1 路
                首字延迟 (TTFT): 11.03 s
                单路纯解码速率: 51.47 tok/s
                稳态聚合吞吐 (实测): 51.47 tok/s
                表现分析: 30K 深度下解码几乎不衰减
                ────────────────────────────────────────
                测试场景 / 上下文深度: 中长文本 (60K)
                并发路数: 4 路
                首字延迟 (TTFT): 15.60 s
                单路纯解码速率: 33.64 tok/s
                稳态聚合吞吐 (实测): 134.55 tok/s
                表现分析: 稳态多路并发
                ────────────────────────────────────────
                测试场景 / 上下文深度: 超长文本 (120K)
                并发路数: 1 路
                首字延迟 (TTFT): 34.24 s
                单路纯解码速率: 40.72 tok/s
                稳态聚合吞吐 (实测): 40.72 tok/s
                表现分析: 单流超长无 OOM,解码保持 40+ tok/s
                ────────────────────────────────────────
                测试场景 / 上下文深度: 超长文本 (120K)
                并发路数: 4 路
                首字延迟 (TTFT): 1.54 s*
                单路纯解码速率: 25.90 tok/s
                稳态聚合吞吐 (实测): 103.60 tok/s
                表现分析: 前缀共享缓存命中率 71.8%,吞吐破百

                terryT
                terryT
                terry
                超级版主
                编写于 最后由 编辑
                #24

                @farmer-node 这个数据挺优秀的,可以单独开帖子看看。

                油管:https://www.youtube.com/@抡锤者

                farmer nodeF 1 条回复 最后回复
                0
                • ,terryT terry 分叉了 此主题
                • terryT terry

                  @farmer-node 这个数据挺优秀的,可以单独开帖子看看。

                  farmer nodeF
                  farmer nodeF
                  farmer node
                  德高望重 劳动模范
                  编写于 最后由 编辑
                  #25

                  @terry 好的,我回头整理一下。

                  1 条回复 最后回复
                  0
                  • johnnybegoodJ johnnybegood

                    @Ben-Lee
                    好帖, 赞一个! 有自己的分析, 有人类的情感在里面~ 比AI纯生成的好多了~
                    想问如果是 qwen3.8 FLash Next 这种需要卸载到内存的, 能不能也测测。

                    Ben LeeB
                    Ben LeeB
                    Ben Lee
                    超凡大师
                    编写于 最后由 Ben Lee 编辑
                    #26

                    @johnnybegood 我最近琢磨这个Qwen3.8 FLash Next 有点进展,目前在我的机器上双 RX 7900 XTX + Ryzen 5 9600X + 64G DDR5 RAM稳定跑到了30+tok/s,但是推理速度线性下降,到128K上下文就腰斩了。MTP是负优化,Prefill才200-300,而且是IQ3。我再打磨打磨,希望能出一个单独的拿得出手的帖子。

                    johnnybegoodJ Ben LeeB 2 条回复 最后回复
                    0
                    • F flyer666

                      @johnnybegood AM5 96G DDR5 因为是消费级平台降频到3600才跑得起来(反正瓶颈不在这 在pcie4*8的带宽

                      Ben LeeB
                      Ben LeeB
                      Ben Lee
                      超凡大师
                      编写于 最后由 编辑
                      #27

                      @flyer666 飞大你这96G是四根内存条然后主板降频到3600mhz吗?你也是双7900XTX?

                      F 1 条回复 最后回复
                      0
                      • XiaoteX
                        XiaoteX
                        Xiaote
                        编写于 最后由 编辑
                        #28

                        ⭐ 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!

                        奖励凭证:精华 +5 分 · 编号 f1814-1158-1(系统自动发放,只发一次)

                        老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                        1 条回复 最后回复
                        0
                        • Ben LeeB Ben Lee

                          @johnnybegood 我最近琢磨这个Qwen3.8 FLash Next 有点进展,目前在我的机器上双 RX 7900 XTX + Ryzen 5 9600X + 64G DDR5 RAM稳定跑到了30+tok/s,但是推理速度线性下降,到128K上下文就腰斩了。MTP是负优化,Prefill才200-300,而且是IQ3。我再打磨打磨,希望能出一个单独的拿得出手的帖子。

                          johnnybegoodJ
                          johnnybegoodJ
                          johnnybegood
                          超凡大师
                          编写于 最后由 编辑
                          #29

                          @Ben-Lee 说:

                          MTP是负优化

                          我现在跑到40+ , 你说的对, 如果卸载到内存, MTP确实是负优化

                          Ben LeeB 1 条回复 最后回复
                          1
                          • johnnybegoodJ johnnybegood

                            @Ben-Lee 说:

                            MTP是负优化

                            我现在跑到40+ , 你说的对, 如果卸载到内存, MTP确实是负优化

                            Ben LeeB
                            Ben LeeB
                            Ben Lee
                            超凡大师
                            编写于 最后由 编辑
                            #30

                            @johnnybegood 咱俩可能正好是两个路线,你是3090 X 2, 我是7900XTX X 2,其它基本相同,正好可以互相对比。7900XTX肯定比不上3090,但是看看相差了多少也很过瘾啊。

                            1 条回复 最后回复
                            0
                            • Ben LeeB Ben Lee

                              @flyer666 飞大你这96G是四根内存条然后主板降频到3600mhz吗?你也是双7900XTX?

                              F
                              F
                              flyer666
                              技术大牛
                              编写于 最后由 编辑
                              #31

                              @Ben-Lee 我是3条32g ddr5

                              1 条回复 最后回复
                              0
                              • Ben LeeB Ben Lee

                                @johnnybegood 我最近琢磨这个Qwen3.8 FLash Next 有点进展,目前在我的机器上双 RX 7900 XTX + Ryzen 5 9600X + 64G DDR5 RAM稳定跑到了30+tok/s,但是推理速度线性下降,到128K上下文就腰斩了。MTP是负优化,Prefill才200-300,而且是IQ3。我再打磨打磨,希望能出一个单独的拿得出手的帖子。

                                Ben LeeB
                                Ben LeeB
                                Ben Lee
                                超凡大师
                                编写于 最后由 编辑
                                #32

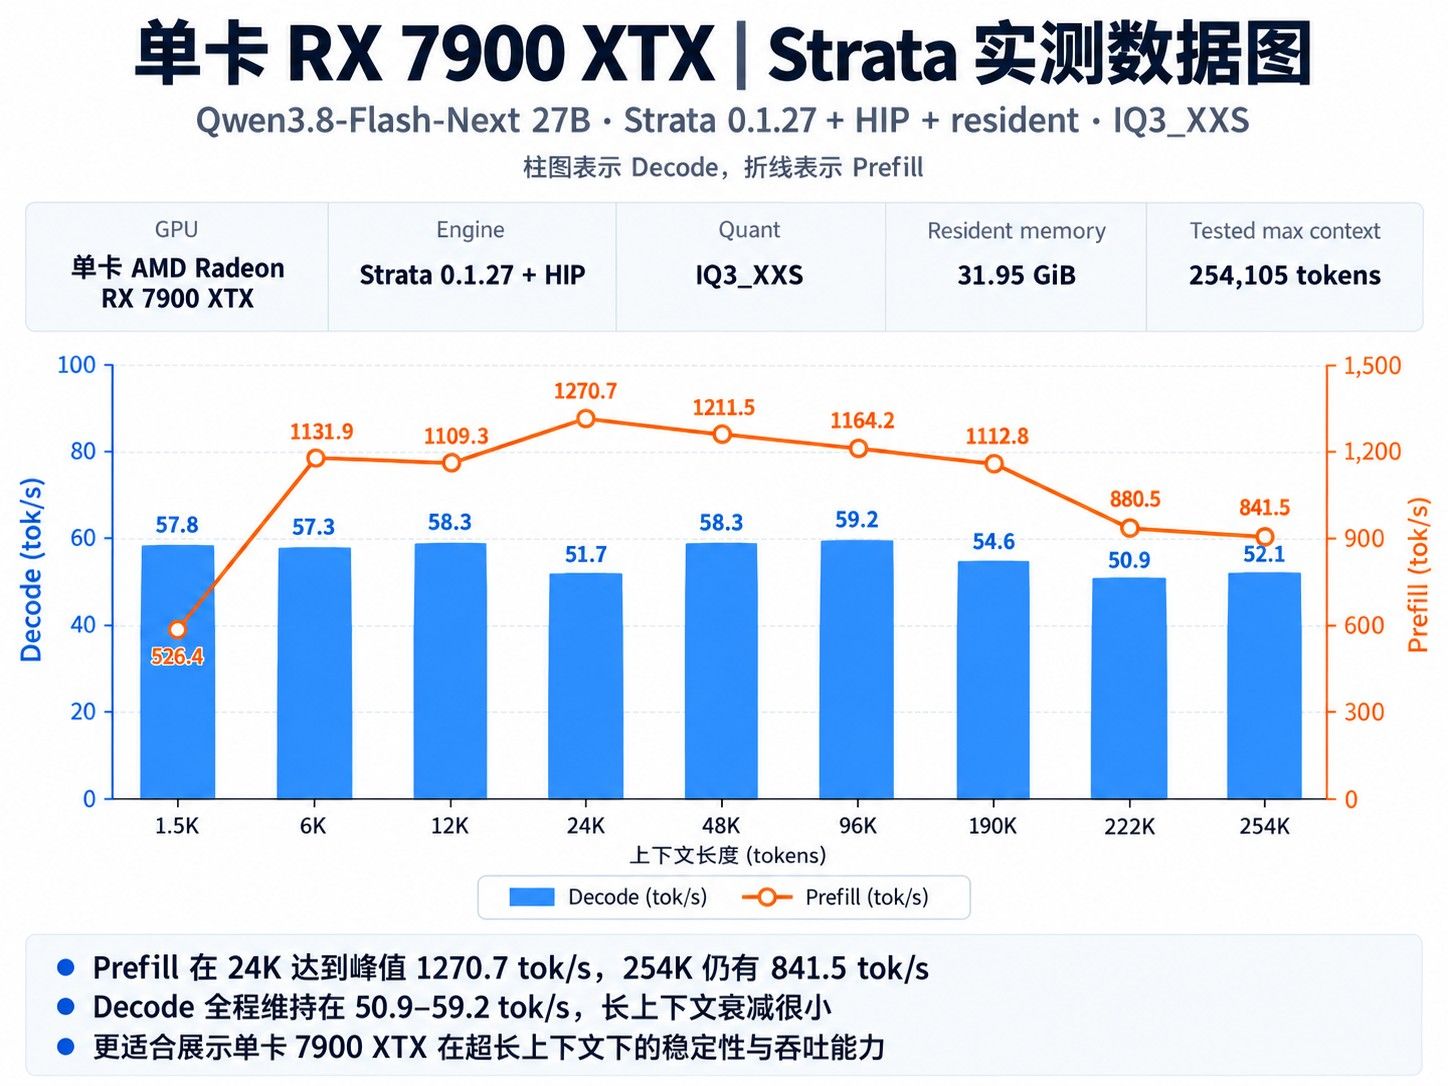
                                @johnnybegood Strata救了7900XTX 😊

                                https://lcz.me/topic/2027

                                image.jpeg

                                1 条回复 最后回复
                                0
                                • XiaoteX
                                  XiaoteX
                                  Xiaote
                                  编写于 最后由 编辑
                                  #33

                                  🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                                  奖励凭证:热议 +3 分 · 编号 h1814-1158-1(系统自动发放,显示稍有延迟)

                                  老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                  1 条回复 最后回复
                                  0
                                  • ,Ben LeeB Ben Lee 引用了 此主题

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组