
T7910 双卡本地推理全记录:7900 XTX 把两张卡跑掉总线,换 R9700 后大 BAR + P2P 一次打通,最后 4 并发 × 160K 稳跑
-
@terry 说实话双RDNA3跑起来没什么问题,楼主掉卡大概率是7910的1300w电源顶不住。7900xtx的瞬时功耗过高是出了名的,这卡刚上市的时候因为掉驱动的情况过渡,所以有很多峰值功率的实测,我记得单卡瞬时是能跑到700w的。我也是双RDNA3用了2000w电源,另外pcie通道确实要直连CPU。
-
T7910 双卡本地推理全记录:7900 XTX 把两张卡跑掉总线,换 R9700 后大 BAR + P2P 一次打通,最后 4 并发 × 160K 稳跑
平台:Dell Precision Tower 7910(双路 Xeon E5-2683 v4 / 128 GB ECC / 无 BMC)
本文是合集:前一半是先前那篇《双 7900 XTX 经 PCIe 交换机跑社区魔改 SGLang:TP=2 真跑到 100 tok/s,但一条卡死的请求把两张卡打掉了总线》的压缩版,后一半是换卡之后的新进展。没看过前篇的可以直接从这篇读起。
两阶段的实测数字不能直接互相比较(模型、量化档、框架、prompt 全变了),所以本文只比「形态与能力」,速度账单独列表并标口径。
TL;DR
结果  第一阶段(2× 7900 XTX 经 PCIe 交换机 / SGLang + W4A16 GPTQ + EAGLE MTP-3)
TP=2 真跑起来了:100 tok/s、MTP 接受率 0.86、KV 243,403 token @196K —— 速度达标  但服务在第 6 分钟被一条卡死的请求把两张卡打成
device lost from bus驱动连试 8 次复位全部失败( ret = -19),只能重启救回。根因不是供电也不是过热(掉卡瞬间仅 272 W / 54 °C) ️ 那代卡的死结
7900 的 VBIOS 开机只申请 256 MB BAR ⇒ 这台机器拿不到大 BAR、也就没有 P2P;跨卡通信退回 NCCL,且经交换机有 4 跳只跑 Gen2 ⇒ 一切能跑,但脆弱  转折(本文主线)
换成 2× R9700 32 GB,插 CPU 直连槽,再给自编内核的 p2pdma白名单加一行 ⇒ 大 BAR 32 GB 与 P2P 一次打通,卡间带宽 2.39 → 10.26 GB/s 现在的形态双卡 TP=2 + MXFP4 量化 + 4 并发 × 单请求 163,840 上下文(KV 717,986 token / 4.38×),单流贪心 43 tok/s,已连续稳定运行(含重启在内 0 次掉卡) 🧱 本轮撞的三面新墙 ① 掉电写坏编译缓存 ⇒ 容器每 4~5 分钟静默死;② OD 偏移(时钟)才是速度旋钮;③ 160K 的代价 100% 落在投机接受长度上  最反直觉的一条
投机解码的接受率与「精度」无关 —— 草稿 token 一律经主模型验证,接受率掉只掉速度;决定精度的是主模型量化档 + 上下文长度。别为了接受率去牺牲别的东西  结论
这台机器上「大 BAR / P2P」不是玄学,是卡 VBIOS 的申请尺寸决定的。同一台 T7910,换一代卡就能从「能跑但会掉」变成「稳跑」——而你不需要换主板、不需要刷 UEFI
一、平台与环境
项 值 主机 Dell Precision Tower 7910,双路 Xeon E5-2683 v4 @2.10 GHz(16C/32T×2),128 GB DDR4 ECC,BIOS A34(2020) 系统 Ubuntu 24.04;自编内核 7.0.14-p2pdma(含下文那 4 行白名单补丁);Secure Boot 关; CONFIG_PCI_P2PDMA=y供电 显卡与 PCIe 交换机走独立一台 1500 W 电源(与主机电源分开);主机侧另有外接显卡供电 阶段一显卡 2× RX 7900 XTX 24 GB(RDNA3 / gfx1100),挂在 PLX88096 PCIe 交换机下游 阶段二显卡 2× AMD Radeon AI PRO R9700 32 GB(RDNA4 / gfx1201),插 CPU 直连槽(不经交换机) 阶段一软件栈 ROCm 7.2 + StevenChenSE/sglang@gfx1100-support分支 + Qwen3.8-27B W4A16 AutoRound GPTQ阶段二软件栈 社区容器 magiccodingman/vllm-radiance(版本串0.9.3-dev.vllm0.28.0-r4d0.5.0-mxfp4.rx4.dflash2…)+ Qwen3.8-27B MXFP4(AWQ/Quark 量化)两种形态对照(这才是本文的主线):
阶段一:7900 XTX + PCIe 交换机 阶段二:R9700 + CPU 直连槽 大 BAR(Resizable BAR) 256 MB(lspci支持列表里明明有 32 G,VBIOS 只申请 256 M) 32768 MB(启动日志 Detected VRAM RAM=32624M, BAR=32768M)P2P(卡对卡) canAccessPeer双向 = 0 P2P access : ENABLED 0↔1卡间链路 交换机下游 4 跳只跑 Gen2(5 GT/s) 根口 Gen4 x16 跨卡通信方式 退回 NCCL(自带的 PCIe All-Reduce 在 gfx1100 上编不过) 容器自带的 R4D one-shot all-reduce(走 P2P,byte-identical to RCCL) 卡间实测带宽 2.39 GB/s(all-reduce 峰值,延迟主导) 10.26 GB/s 单向 / 19.71 GB/s 双向 结果 100 tok/s,但第 6 分钟掉总线 长跑稳定,4 并发 × 160K
二、第一阶段(压缩版):能跑,但会掉
2.1 部署踩坑(严格按我踩到的顺序,压成一张表)
# 坑 症状 解法 1 魔改 fork 的依赖版本 README 说 torch 2.11, pyproject.toml实际要 2.13以 pyproject 为准,并用 constraints 锁死 ROCm 版 torch,否则依赖解析会把它换成 CUDA 版 2 torchvision 装成 CUDA 版 import sglang直接炸:operator torchvision::nms does not exist从 ROCm 源装 torchvision==0.26.0+rocm7.2 --no-deps3 (最阴)PyPI 的 sglang-kernel会盖住 fork 的 Python 层调度器初始化阶段挂: gptq_gemm() takes 7 positional arguments but 8 were given只覆盖 .so不够,Python 层也要整层覆盖4 kernels包与新版 transformers 冲突ValueError: Either a revision or a version must be specified.pip uninstall kernels(该代码在try/except ImportError里)5 AOT 内核编译 —— 唯一一步「照着走就行」: setup_rocm.py build_ext --inplace(本机双路 E7 单核弱,约 50 分钟)6 fork 自带的自定义 All-Reduce 编不过 __builtin_amdgcn_global_store_b128 needs target feature gfx940-insts(那是 MI300/CDNA3 专属指令)关掉,退回标准 RCCL: SGLANG_RDNA_CUSTOM_AR=07 (致命)无 P2P ⇒ 所有 symm-mem / multimem 路径都崩 一进 decode 就 SIGABRT,栈顶却是 logits_processor.py(极具误导性,实际炸在 decode CUDA Graph 捕获阶段建通信器时)① --disable-custom-all-reduce+SGLANG_OPT_USE_CUSTOM_ALL_REDUCE_V2=0;② 打补丁:给MultimemAllGatherer._build()首行插return None,强制走 NCCL all-gather8 起服务前没检查谁占着卡 一个 unless-stopped的旧容器在无限重启,每次抢走一张卡 23.7 GB ⇒ TP=2 直接被挡死rocm-smi --showmeminfo vram+docker inspect看重启策略坑 7 的结论值得单独记一句:无 P2P 的 RDNA3 是能跑 TP 的,前提是把跨卡通信全部退回 NCCL。
2.2 成绩单(数字取自引擎自己的日志,不是客户端计时)
双卡 TP=2 生成速度与 MTP 接受率 指标 实测值 生成速度 100.33 tok/s(稳定段;爬升过程 0.29 → 70.75 → 97.61 → 100.33) MTP 接受率 0.86(每轮 4 个草稿 token 实际接受 3.58 个) KV 容量 243,403 token 上下文 196,608 显存占用 卡0 22.46 GB / 卡1 22.19 GB(各 24.6 GB 可用) 权重加载 / 就绪 20 GB 用时约 77 s;服务就绪共 112 s 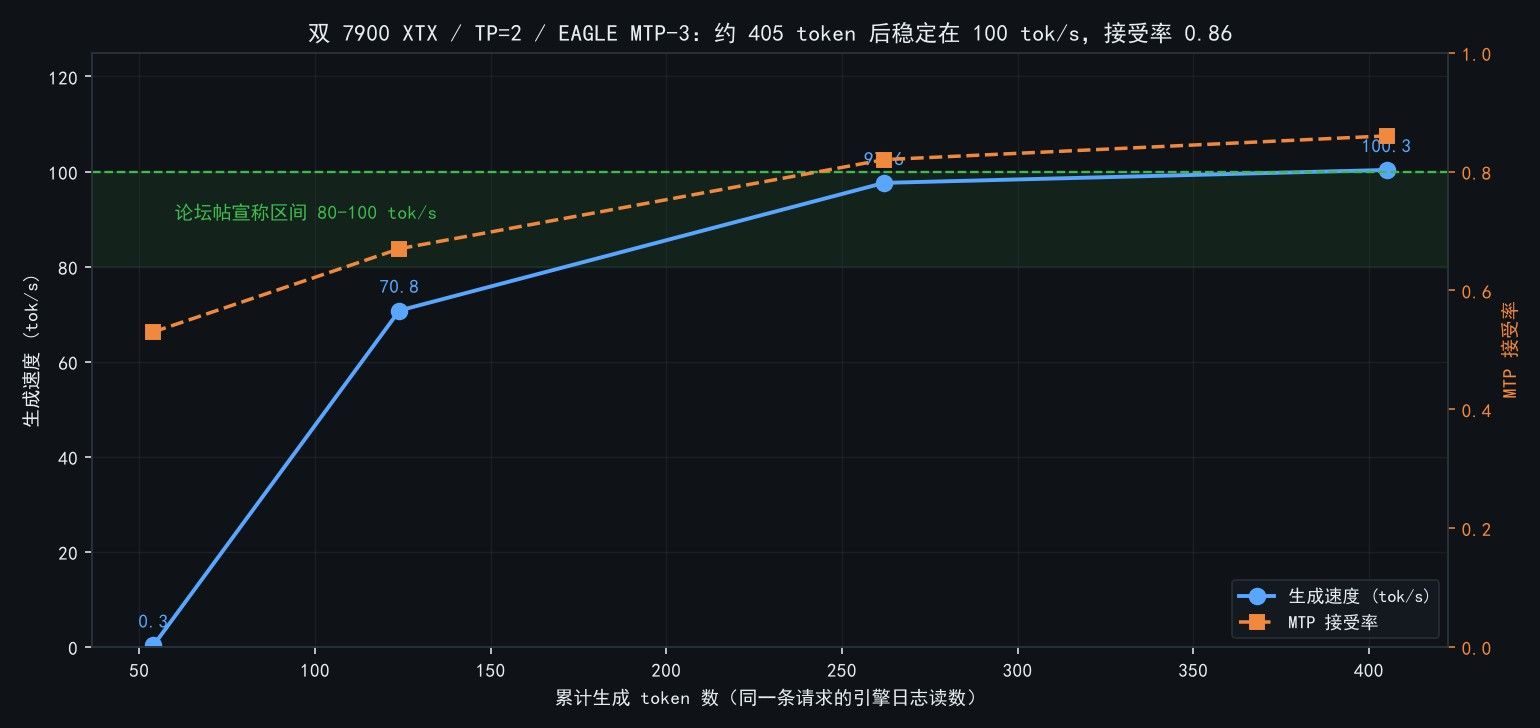
口径:W4A16 量化、单流、上下文 196 K、开启 EAGLE MTP-3;速度取自引擎日志
decode batch行(第 405 个 token 之后稳定),非多并发聚合、非客户端计时。
顺带一个教训:这个 100 tok/s 是强规律 prompt 下的成绩 —— 换成不可预测的 prompt 会掉到 43 tok/s(见 2.5 的 fig5)。2.3 掉卡全过程
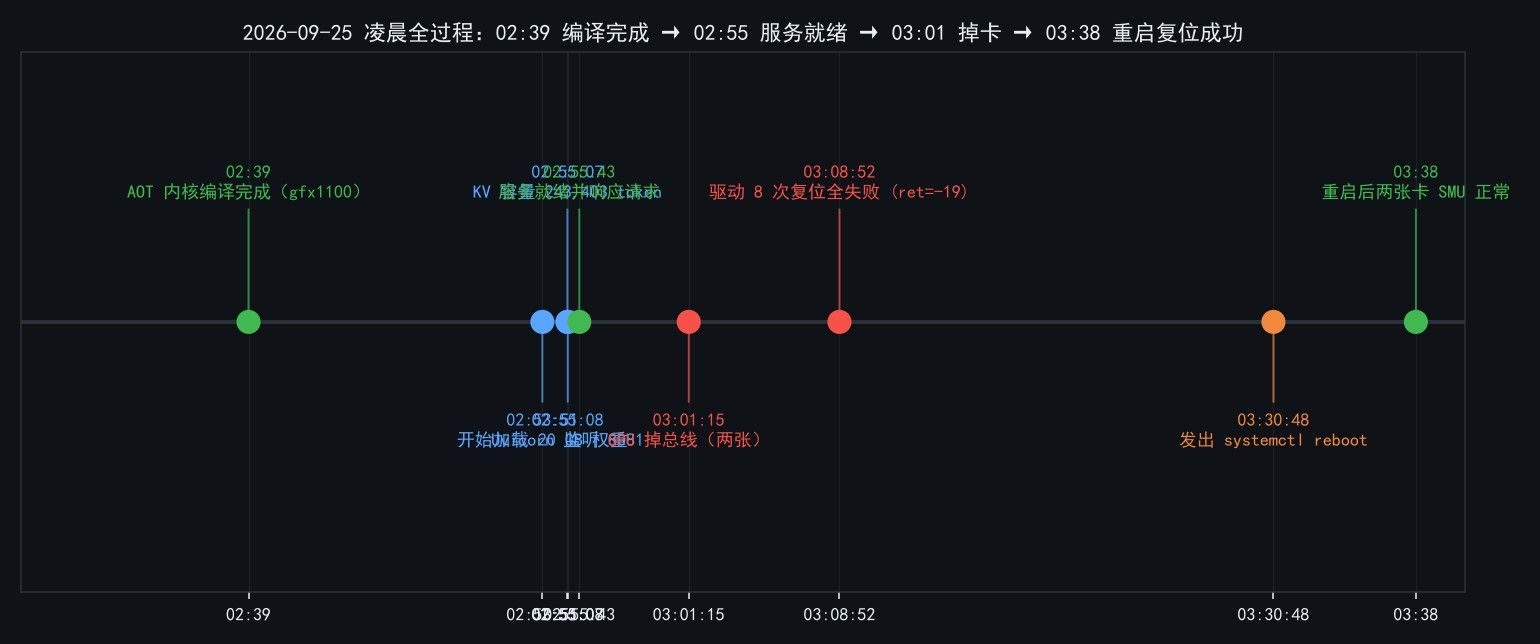
服务 02:55:43 就绪,我发了一条请求做基准 —— 那条请求卡住了(引擎两个进程各 200% CPU 空转),6 分钟后,卡崩了。
时间 事件 02:55:43 服务就绪、正常响应请求,速度见上图 03:01:15 卡0 爆 sq_intr着色器/队列错误,紧接着两张卡device lost from bus!03:08:52 驱动自救: ring sdma0 timeout→failed to reset legacy queue→GPU reset begin!→GPU reset end with ret = -19,连试 8 次全失败之后 SMU: bus error ... 0xFFFFFFFF无限刷;nvtop/rocm-smi读不到任何温度03:30:48 发出 reboot03:38 机器起来,两卡 SMU is initialized successfully!、device lost0 条 ⇒ 卡自己回来了![全过程时间线]
 转折点
掉卡前最后一条有效遥测(03:01:14):卡0 272 W / 56 °C,卡1 271 W / 54 °C,风扇刚爬到 799 / 642 RPM。
我最初的条件反射是「又是供电/过热把机器打死了」,但数据说 272 W 离 355 W 上限还差得远,54 °C 更是凉快。
![掉卡瞬间功耗曲线]
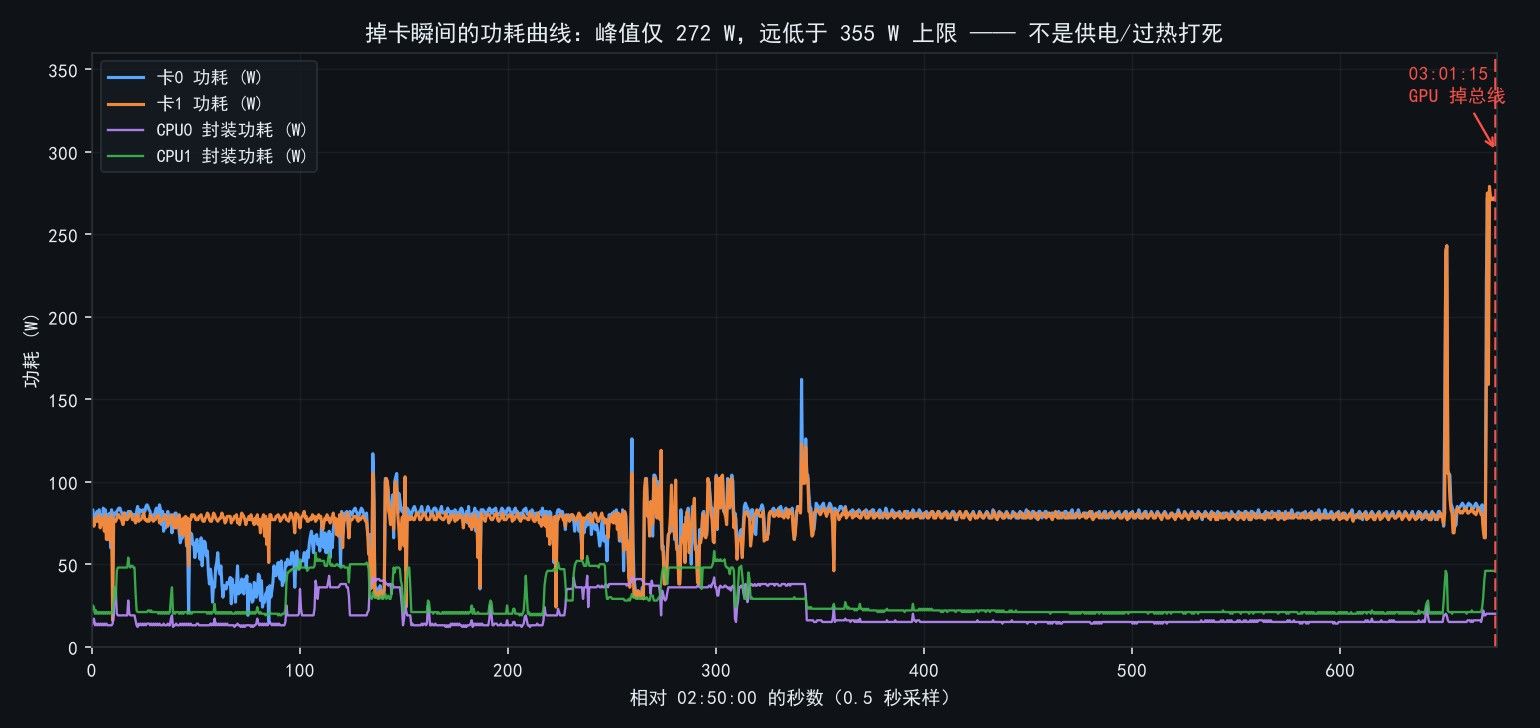
⇒ 方向立刻从「供电/散热」掰到「计算故障 + 驱动复位失败」。
# 假设 判据 结论 1 过热 掉卡瞬间 54–56 °C,风扇刚起转 排除2 供电瞬态尖峰(老毛病) 272/271 W,远低于 355 W cap;主机本身没断电 排除3 卡物理损坏 lspci仍枚举、驱动仍绑定;重启后完全恢复 排除4 驱动/固件崩 + 复位失败 sq_intr→device lost from bus→ 8 次GPU Recovery Failed: -19 就是这个5 触发源 时间线:一条卡死的请求在同一秒触发 sq_intr;此前 6 分钟完全正常 高置信我自己的责任:那条请求卡死后我拖了 18 分钟才发现,而崩卡发生在卡死的第 1 分钟内。如果 2 分钟内就杀进程,大概率不会有这次掉卡。这条已写成硬规矩:请求超时 3~5 倍、或引擎 CPU 拉满却没有吞吐日志 ⇒ 立刻杀进程。
2.4 想拿大 BAR / P2P 的三条路,全走死了
路径 结果 运行时扩 BAR( resource0_resize) 写值返回 I/O error,内核old value restored内核参数 pci=realloc 大 BAR 仍 256 M,桥窗口仍刷 mem size 0x800200000: failed to assign把 PLX 交换机从 CPU1 侧挪到 CPU0 侧 两卡都变成 numa_node=0、BAR 地址落在 CPU0 的 1 TiB 窗口内,大 BAR 仍 256 M机理:大 BAR 要求「先选 BAR 尺寸、后分配桥窗口」,而选尺寸的只能是 BIOS/VBIOS(驱动 probe 时再写 rebar 控制寄存器,桥窗口早已被固件定死)。
⇒ 根因唯一:7900 的 VBIOS 开机只申请 256 M。附一条容易踩的判据:别用 amdgpu 日志的「沉默」判断 P2P 可用 —— 大 BAR 那层的否决是静默的。只剩两张 7900 时日志里 P2P 判词是 0 条,看着像通过,但 HIP 实测
canAccessPeer双向都是 0。判据只能用hipDeviceCanAccessPeer+ 真跑的hipMemcpyPeer。2.5 附带实测:三张这次才补上的图
① 并发天花板是
max_running_requests,不是硬件;提高 OD 上限没有收益![并发基准与 OD 上限对照]
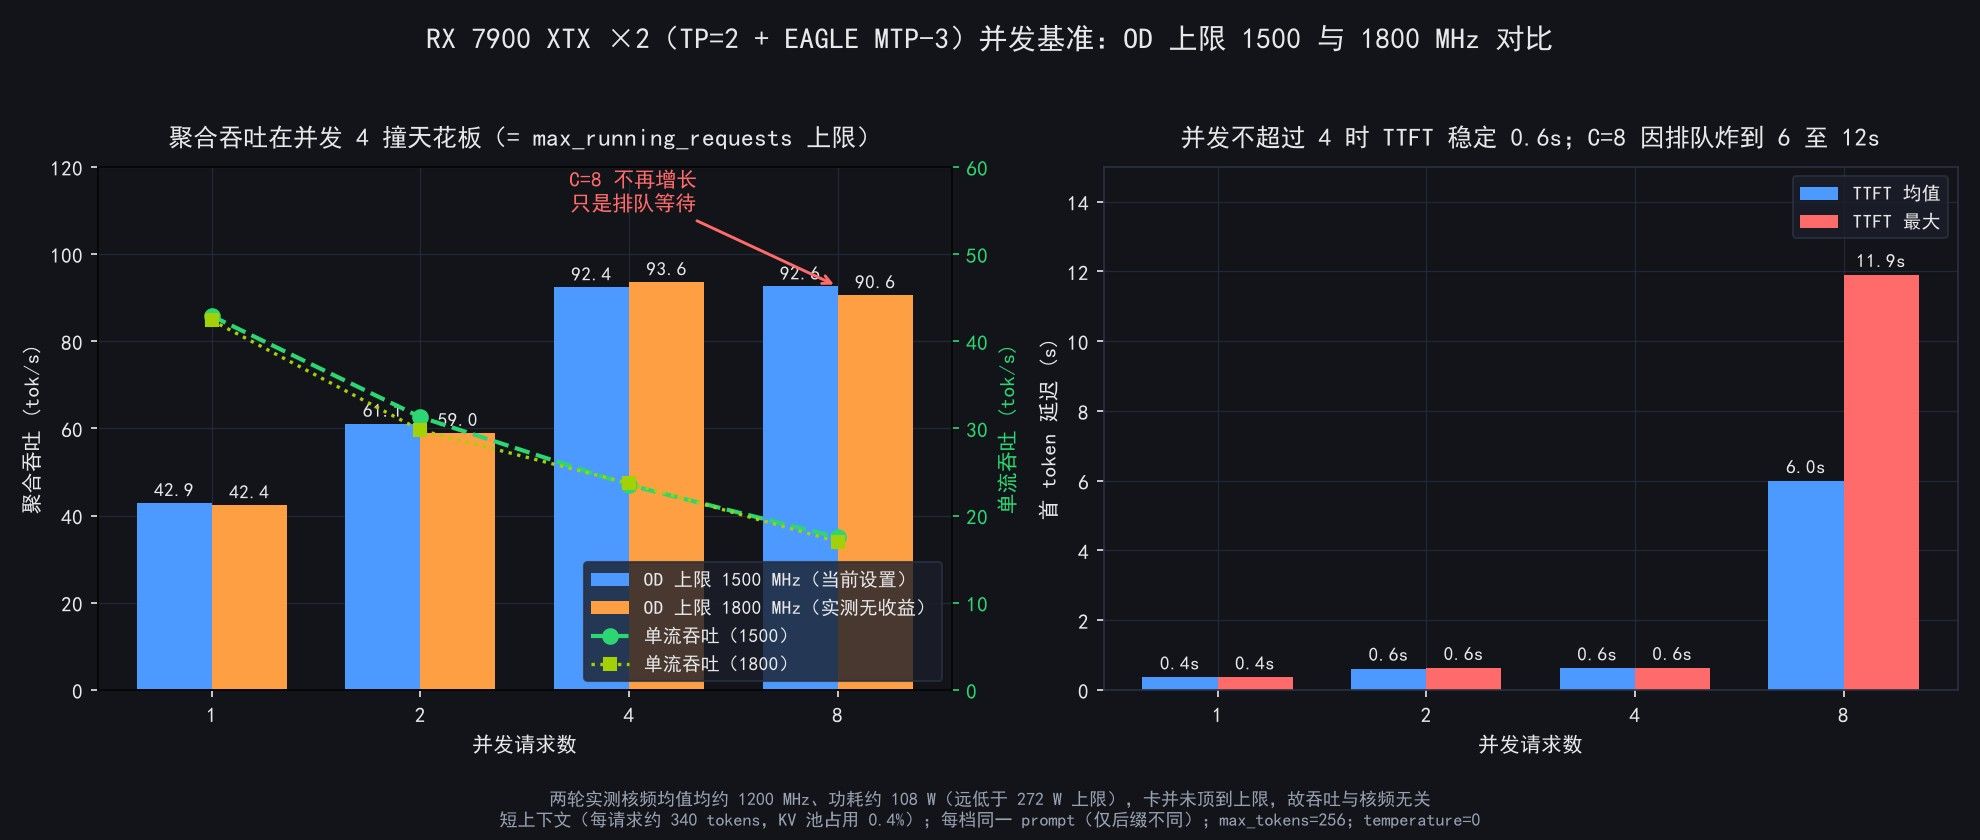
- 聚合吞吐在并发 4 撞天花板(92.4 tok/s),并发 8 不再增长(92.6),只是排队:TTFT 从 0.6 s 炸到均值 6.0 s / 最大 11.9 s。
- OD 上限 1500 MHz vs 1800 MHz:两轮核频均值都只有约 1200 MHz、功耗约 108 W —— 卡根本没顶到上限,所以提上限自然没收益。这个结论和本文第五章「时钟偏移才是旋钮」是一对,别混。
② 同样的并发,只换 prompt,吞吐差 55% —— 因为 MTP 接受率变了
![prompt 类型对接受率与吞吐的影响]
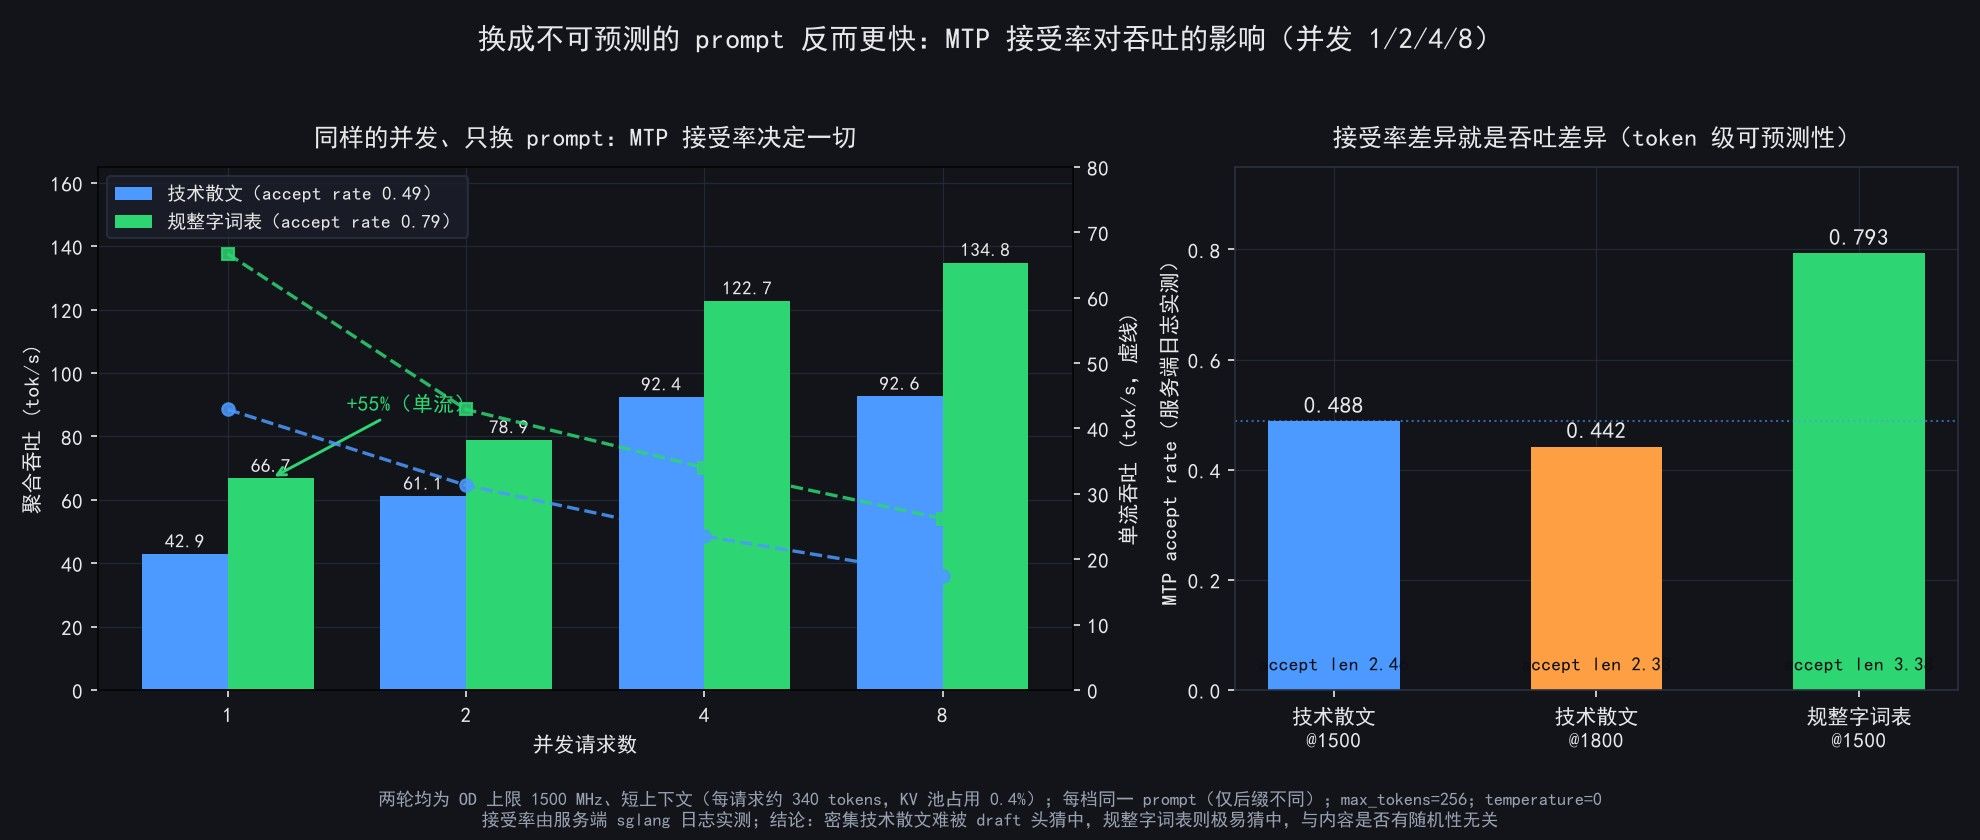
- 技术散文 accept rate 0.49 vs 规整字词表 0.79:单流吞吐 42.9 → 66.7 tok/s(+55%),并发 4 时聚合 92.4 → 122.7。
- 结论:接受率是 token 级可预测性的函数,跟你用不用随机内容无关。这条在第六章会再出现一次,但方向相反 —— 那时我们要说明接受率不影响精度。
③ 卡间通信:不是带宽不够,是链路太长 + 延迟太高
![卡间通信与 PCIe 链路实测]
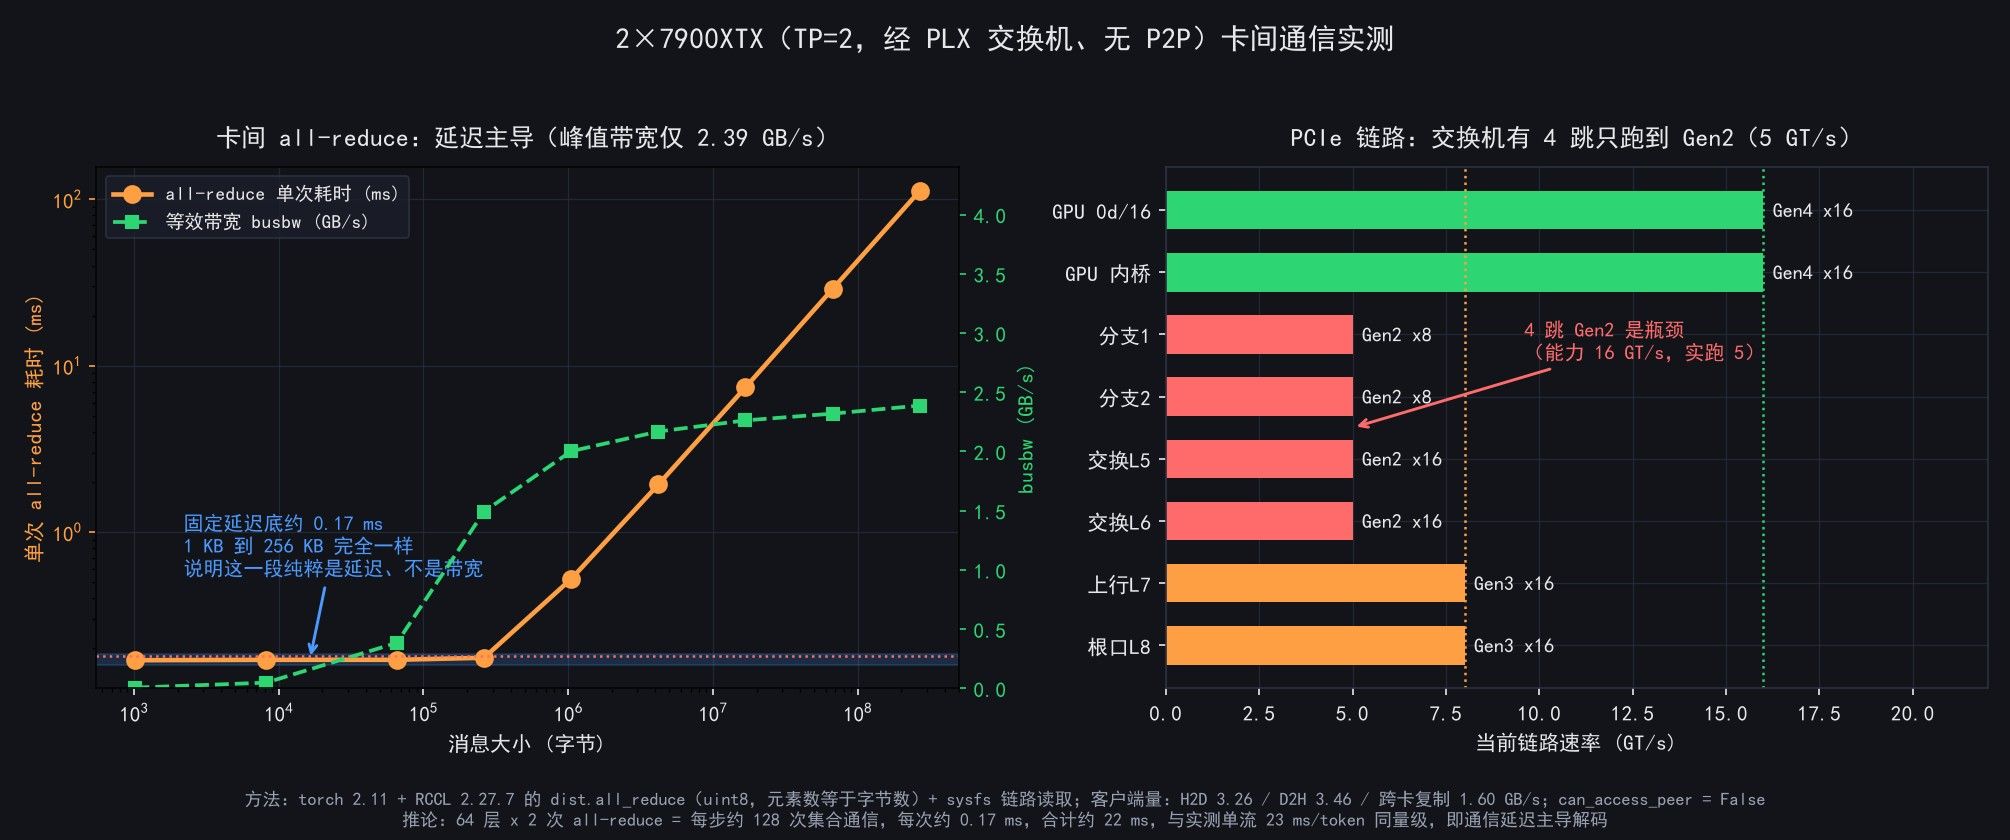
- all-reduce 峰值带宽仅 2.39 GB/s;1 KB 到 256 KB 的耗时完全一样(约 0.17 ms) ⇒ 这一段纯粹是延迟,不是带宽。
- 交换机下游有 4 跳只跑到 Gen2(实跑 5 GT/s,能力 16 GT/s)。
- 推算:64 层 × 2 次 all-reduce = 每步约 128 次集合通信,每次约 0.17 ms ⇒ 约 22 ms/步,与实测单流 23 ms/token 同量级 ⇒ 通信延迟主导解码。
这三张图的共同结论:在无 P2P 平台上跑 TP,你付的钱不是带宽,是延迟和脆弱性。
2.6 掉卡后的恢复动作(建议背下来)
- 先看内核日志定性:
journalctl -k | grep -iE 'device lost|sq_intr|Recovery Failed' - 先试
reboot,但要有耐心:本次 03:30:48 发出、03:38 才起来(约 7 分钟),期间全网段无响应、很像死机 —— 等满 10 分钟再判死 - 还没回来再冷断电:关机 → 断 PSU 30–60 s → 按顺序上电
- 绝对不要用
unbind/bind或resource0_resize去「救」一块 AMD 卡 —— 我曾这么干过一次,直接内核 NULL 指针 panic + 整机紫屏
三、转折:换 R9700,大 BAR 与 P2P 一次打通
拆掉两张 7900 XTX,换成两张 R9700 32 GB,插到 CPU 直连槽(不经交换机),然后给自编内核打了一行补丁:
/* drivers/pci/p2pdma.c —— 让同/跨 Root Port 的 GPU 之间允许 P2P(本机 host bridge 8086:6f00)*/ {PCI_VENDOR_ID_INTEL, 0x6f00, REQ_SAME_HOST_BRIDGE},三条判据一次性全绿(都来自启动日志与 sysfs,不是「感觉能行」):
# ① 大 BAR 拿满 Detected VRAM RAM=32624M, BAR=32768M (两卡各 32 GiB) # ② 可见显存 == 实际显存(大 BAR 生效的零成本判据) card0 34208743424 / vis=34208743424 card1 34208743424 / vis=34208743424 # ③ P2P 打开 + 容器自己的互访矩阵全 1 P2P access : ENABLED 0↔1 rocm-bandwidth-test: Inter-Device Access(2 号/3 号设备之间 = 1) RADIANCE_USE_R4D_AR P2P one-shot all-reduce for TP=2, byte-identical to RCCL卡间带宽对照(阶段一 2.39 GB/s 是 all-reduce 峰值;阶段二为卡对卡拷贝):
阶段一 7900 XTX(经交换机、无 P2P) 阶段二 R9700(直连、开 P2P) 卡间有效带宽 2.39 GB/s 10.26 GB/s 单向 / 19.71 GB/s 双向 每次通信的固定延迟 约 0.17 ms(1 KB~256 KB 都一样) 每次 all-reduce 不再绕 NCCL,走 P2P one-shot ![换卡前后:大 BAR / P2P / 卡间带宽对照]
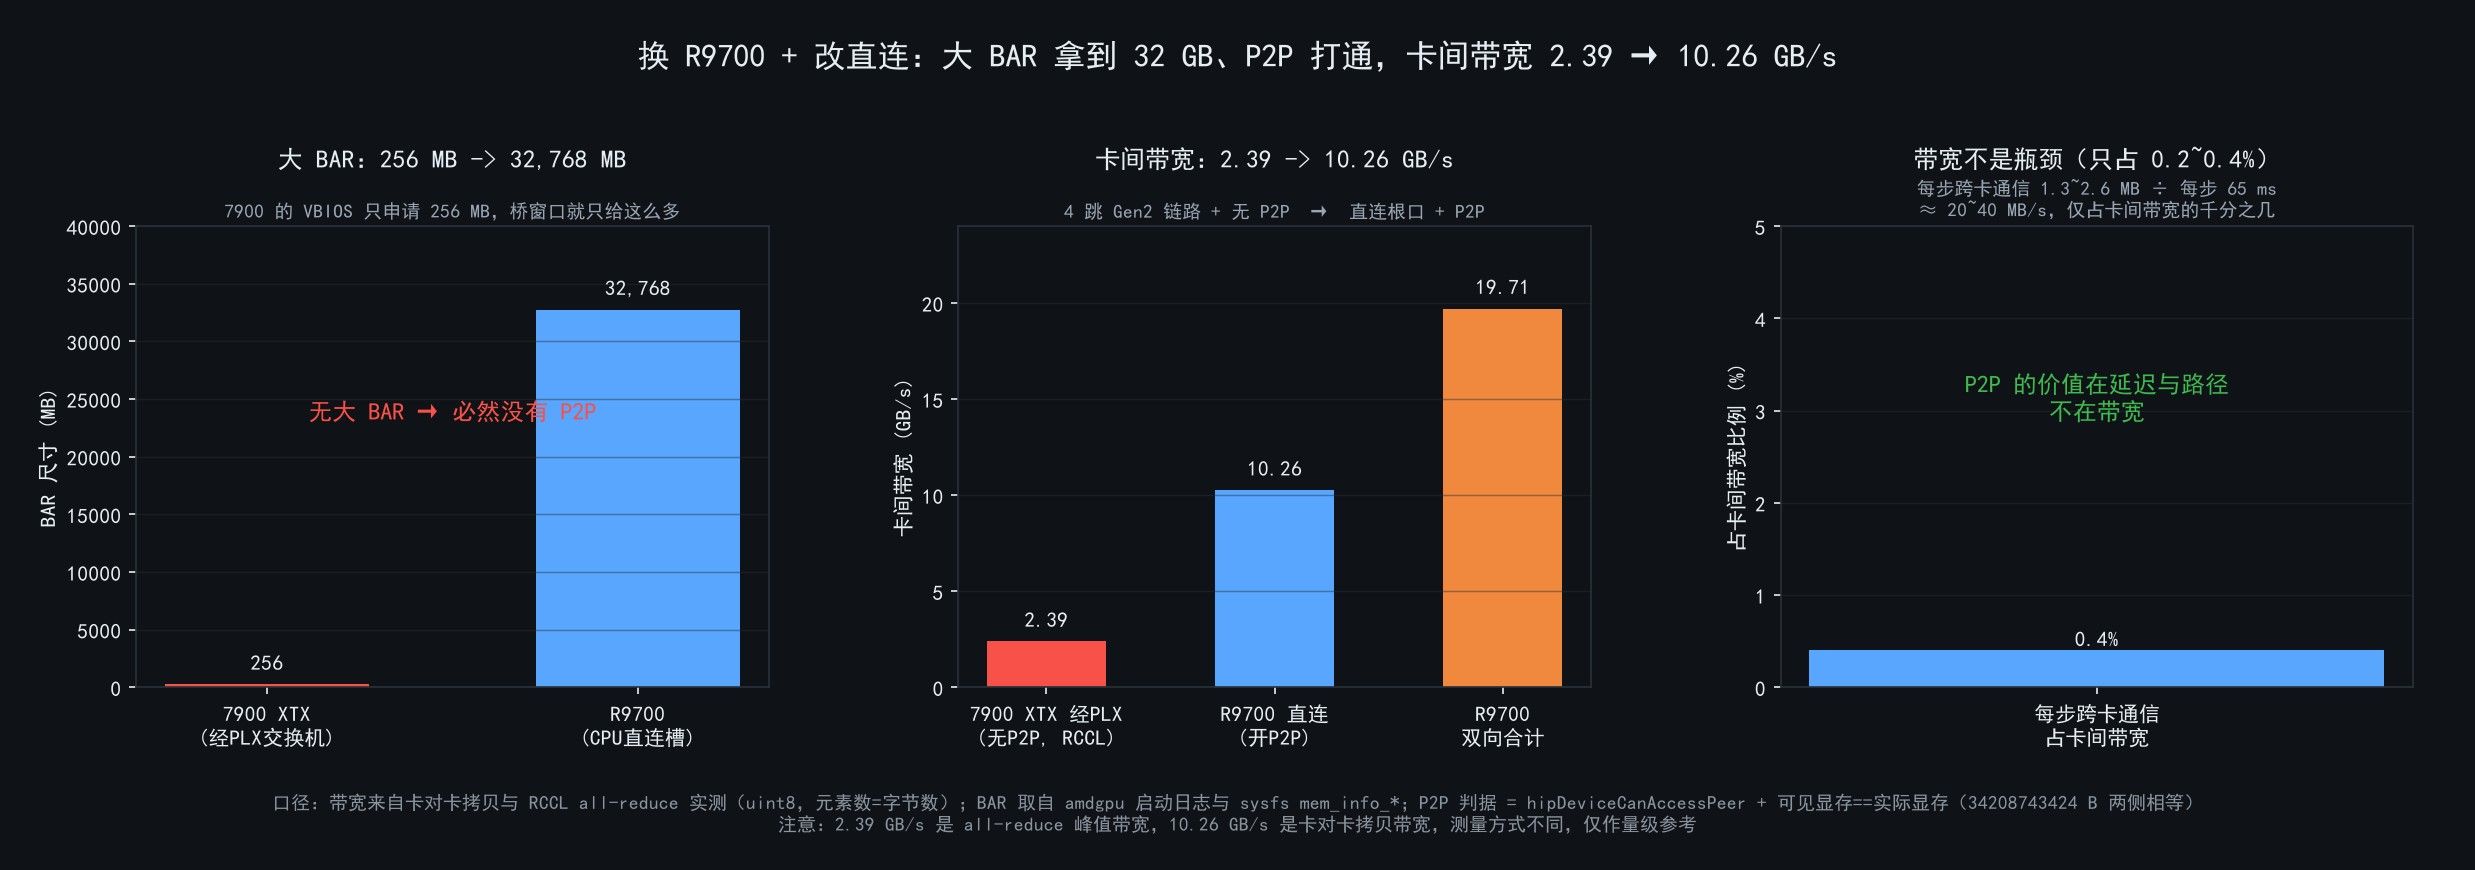
但请注意最后那个 0.2~0.4%:这套部署里每步跨卡通信量只有 1.3~2.6 MB,跟 10.26 GB/s 比只占千分之几。⇒ P2P 的价值不在带宽,在于「能开起来」和「延迟低、路径短」。反过来说:如果你为了带宽去折腾 P2P,方向就错了。
换卡后立刻要做的三件事(顺序别反):
- 先
unbind旧卡 → 断电 → 插新卡(动卡必须断电) - 先给交换机/显卡那台独立电源通电,再开主机
- 起来先验上面三条判据,再去装模型服务 —— 判据不过就别浪费时间调服务
四、新墙 ①:掉电写坏编译缓存 ⇒ 容器每 4~5 分钟静默死
这是本轮最阴的一个坑,也是最值得抄走的排查路径。
症状
服务跑起来又自己死,而且非常规律:
时间 事件 22:41:50 主机硬掉电(日志戛然而止,无 shutdown / Oops / panic —— 上电后对比新 boot 才确认是掉电) 22:45 冷启动回来(此时 160K 的 KV 分配已经成功过: 731,270 tokens, 4.46x @163,840)22:50:34 容器起后 约 4 分钟死亡( RestartCount 1)22:54:24 再起,又是 4 分钟死亡( RestartCount 2)—— docker inspect:退出码 0、OOMKilled=false、内核无 amdgpu 报错、entrypoint 里没有看门狗22:57 隔离整套编译缓存 23:02 → 23:11 从零重编,一次通过、再没崩过 三条判据(缺一条都会误判)
- 它不是随机掉电:两轮死亡时间几乎相同(4 分钟),稳定复现 ⇒ 确定性病因
- 它不是被杀的:退出码 0 + 无 OOM + 内核无告警 ⇒ 进程是「自己走完」的
- 日志停在 CUDA Graph 捕获阶段,但显存监控证明权重已经加载到 29.4 GB ⇒ 日志随进程缓冲一起丢了,别拿日志位置当「没跑起来」的证据
真凶判据(一条命令)
# 数「掉电瞬间正在被写」的缓存文件 find <缓存目录> -path '*BROKEN*' -prune -o -type f -size 0 ! -name '*.lock' -print | wc -l # 隔离前 = 49(全是 torch_aot_compile/*/inductor_cache/ 下的 .py / *.best_config) # 隔离后 = 0因果链:掉电砸在首次编译过程中(掉电窗口里 40 个文件正在写)⇒ 留下 49 个 0 字节缓存文件 ⇒ 之后每次启动都读这份坏缓存,在 cudagraph 捕获阶段稳定死。
(为什么是首次编译?因为我把max_model_len改成 163,840 触发了 AOT 缓存从零重建 —— 改这类参数会重编,重编期断电就是灾难。)修法:隔离,不要删
mv torch_compile_cache{,.BROKEN-<日期>-<原因>}   # 整套改名保留,出问题时还能回查证据
mv triton/<相关键目录>{,.BROKEN-...}             # 同一时刻在写的 triton 键目录一起隔离
# 然后重启服务,让它从零重编
![掉电写坏编译缓存:崩循环与判据]
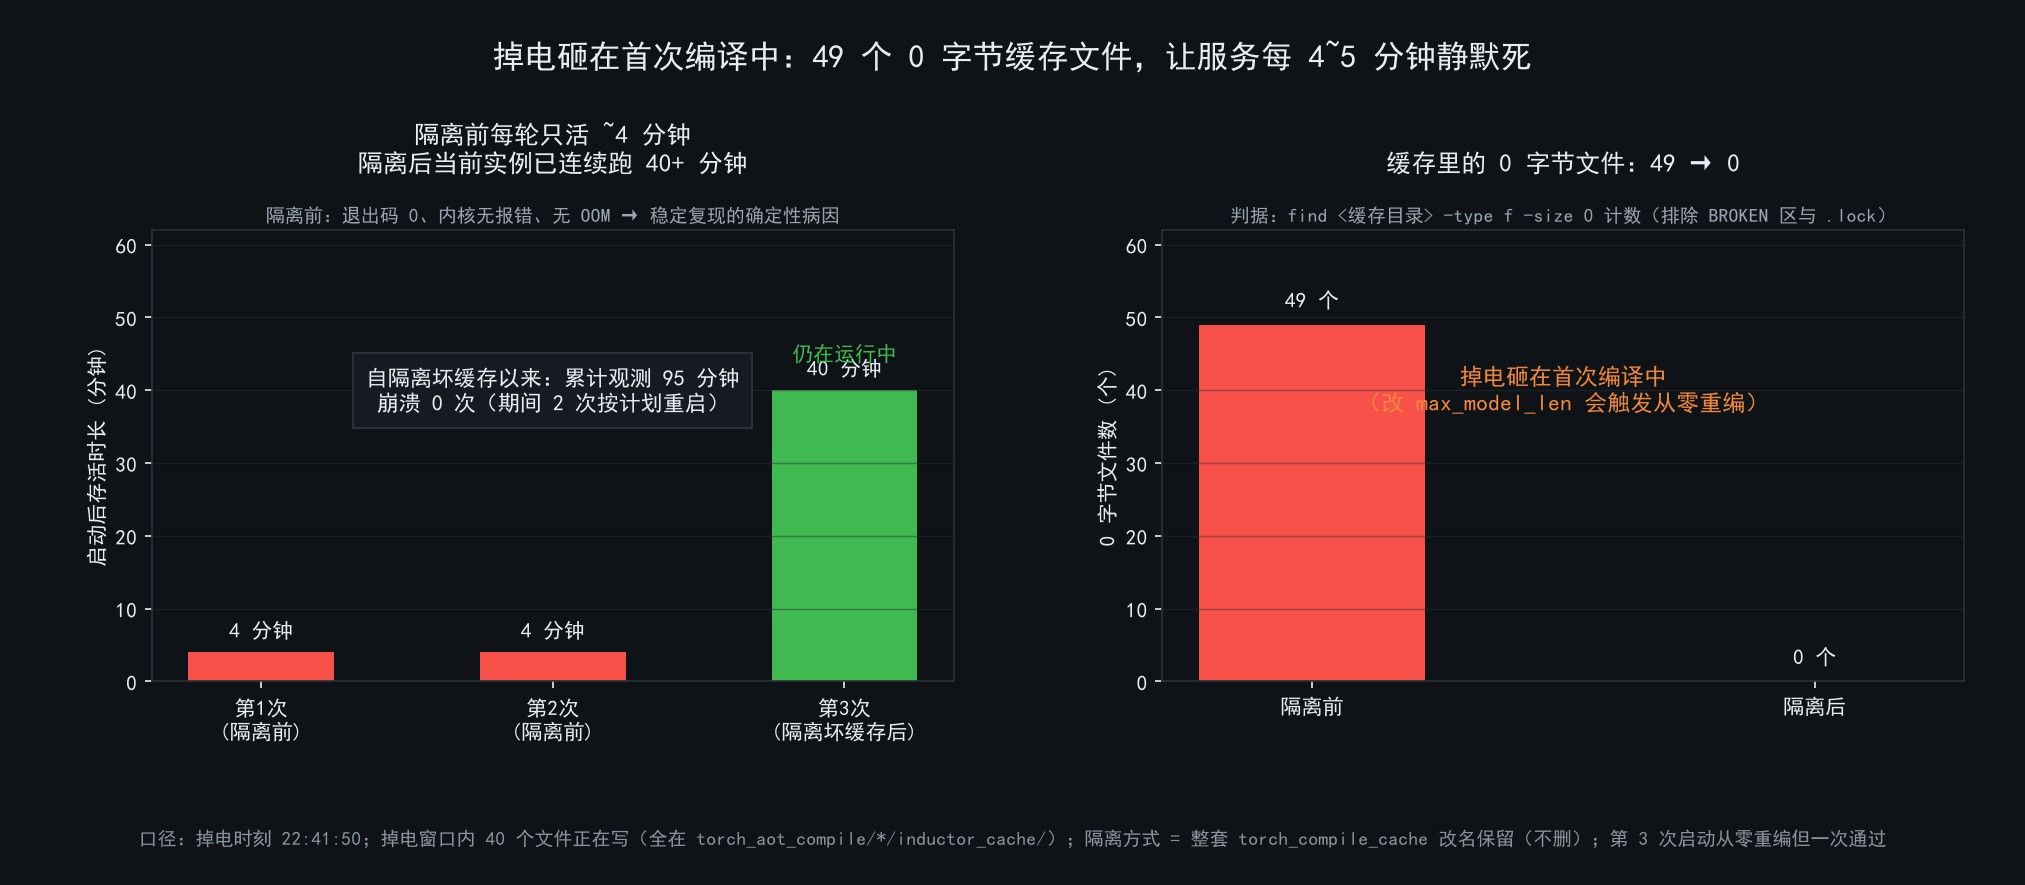
收进习惯:① 只要「服务起得来但总在几分钟内自己死」,先查 0 字节缓存;② 隔离而不是删除,保留证据;③ 编译期尽量别断电(真要改配置,先确认不会触发首编,或者编完再断电)。
五、新墙 ②:慢的不是功率上限,是时钟偏移
阶段一那张 fig4 说「提高 OD 上限没有收益」,因为它测的是 cap。本轮踩的是另一个旋钮:偏移(offset)。
我把供电护栏从「激进」调到「保守」时,顺手把 SCLK 偏移从 −250 MHz 改成 −500 MHz,结果每步耗时稳定 +13%:
SCLK 偏移 每步耗时(多次实测) 均值 贪心接受长度 −500 MHz 75.1 / 75.2 / 75.9 ms 75.4 ms 26.1% / 27.5% −250 MHz 65.5 / 65.6 / 66.1 / 66.7 ms 66.0 ms 26.1%(一丝不动) ![SCLK 偏移与每步耗时:纯时钟账]
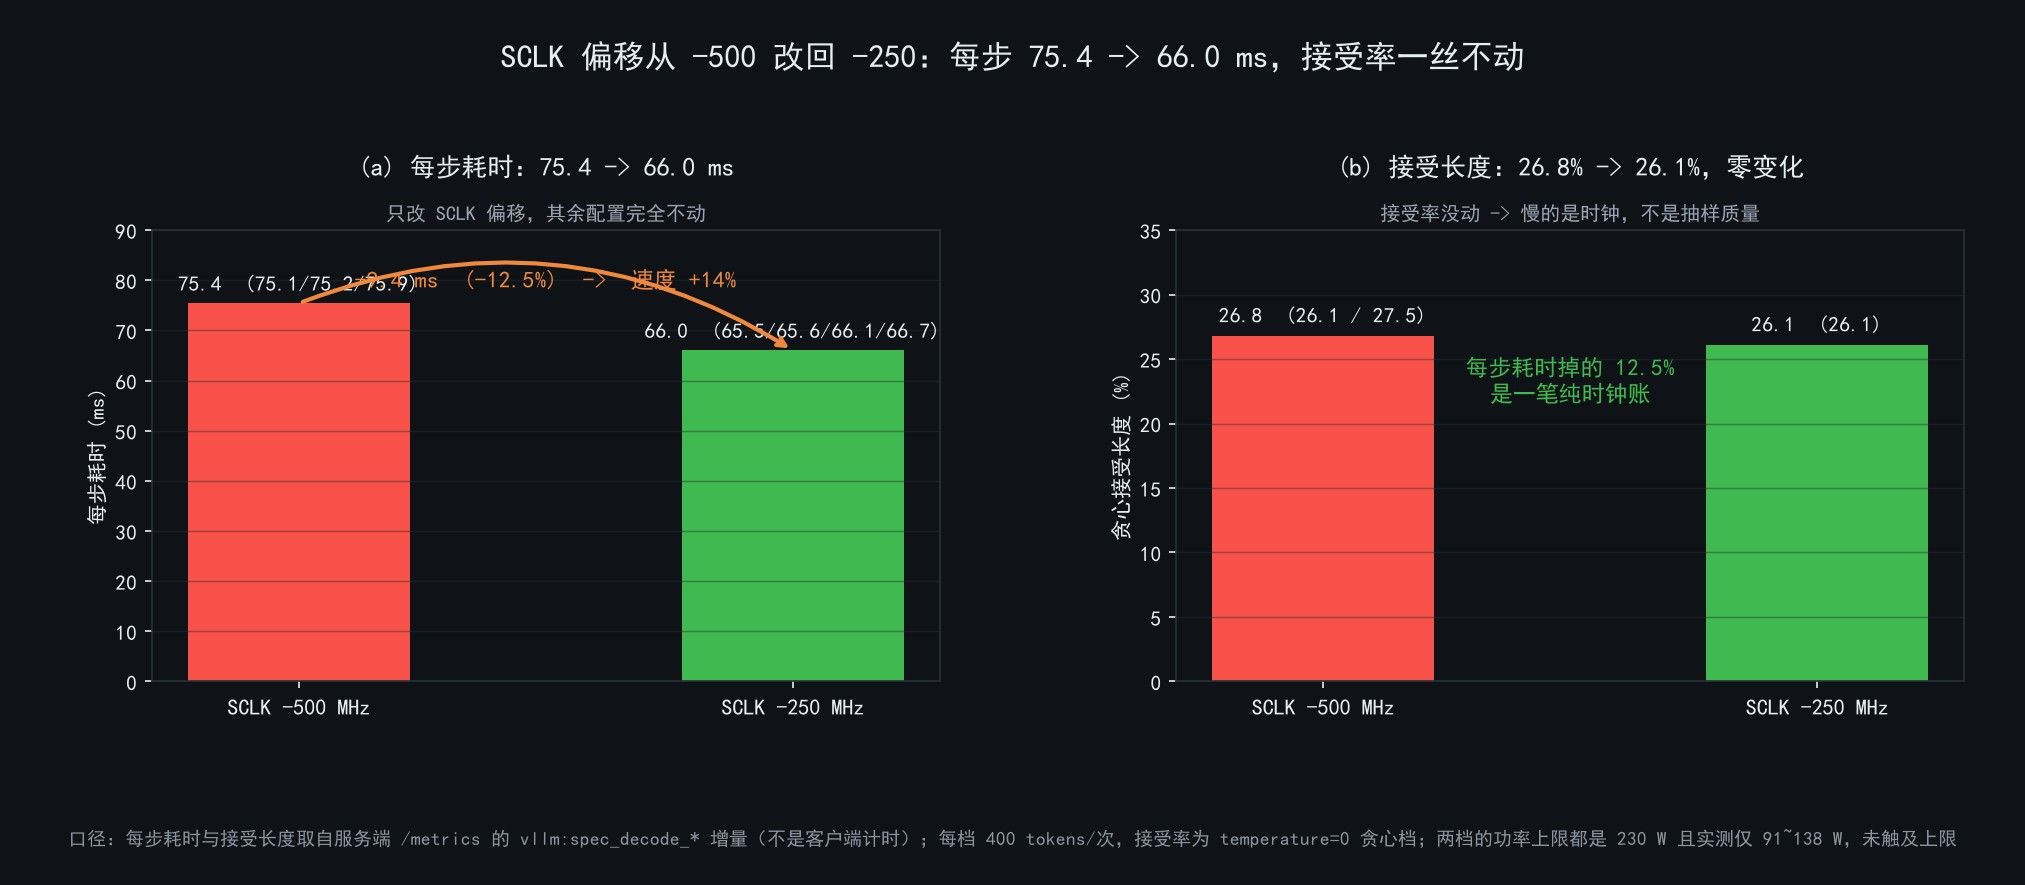
归因很干净:只改 SCLK 偏移,接受长度完全没变(26.1% 一模一样),而每步耗时掉了 12.5%、速度 +14%。
⇒ 这就是一笔纯时钟账,跟「功率上限」「量化档」「上下文」都无关。判据写法备忘:验证这类偏移有没有真正落到硬件,不能只看
--show的回读值(那只是 sysfs 写回什么就显示什么),要用「每步耗时」这种端到端指标去反证。另外,一次性写两张卡的 OD 有竞态,可能存在「只配到一张卡」的情况 —— 回读两张卡各自的节点、并跑一段负载看两卡是否对称。现在的供电护栏(这台机器有过 PSU 瞬态过载史,护栏是必要的):
项 值 功率上限 230 W(出厂 300 W,下限 210 / 上限 330) SCLK 偏移 −250 MHz VDDGFX 偏移 −75 mV 实测表现 两卡 91~138 W、温度 38~42 °C —— 离上限很远,慢不是 cap 造成的 稳定性 本阶段长跑 0 次掉卡;内核侧保留 kernel.panic=15(掉卡能自愈重启)
六、新墙 ③:160K × 4 并发,代价 100% 落在「接受长度」上
服务是社区容器
magiccodingman/vllm-radiance,双卡 TP=2、MXFP4 权重、4 并发 × 单请求 163,840 上下文。容量账(引擎自己算的)
GPU KV cache size: 717,986 tokens
Maximum concurrency for 163,840 tokens per request: 4.38x
Available KV cache memory: 14.28 GiB        (权重 ~9.5 GiB/卡,两卡各占 ~30 GB)
⇒ 4 并发 × 160K 是这套组合的上限档,再想加并发就得牺牲单请求上下文。
128K → 160K 的完整取舍账(同机、同脚本、单流、贪心)
131,072 上下文 163,840 上下文 KV 容量 679,300 token(5.18×) 717,986 token(4.38×) 每步耗时 63.9 / 64.4 ms(均 64.2) 65.5 / 66.7 ms(均 66.0)(+2.8%,几乎没变) 单流吞吐(贪心) 52.45 tok/s 43.02 tok/s(−18%) 贪心接受长度 33.6% 26.1% ![160K 与 128K 的取舍账]
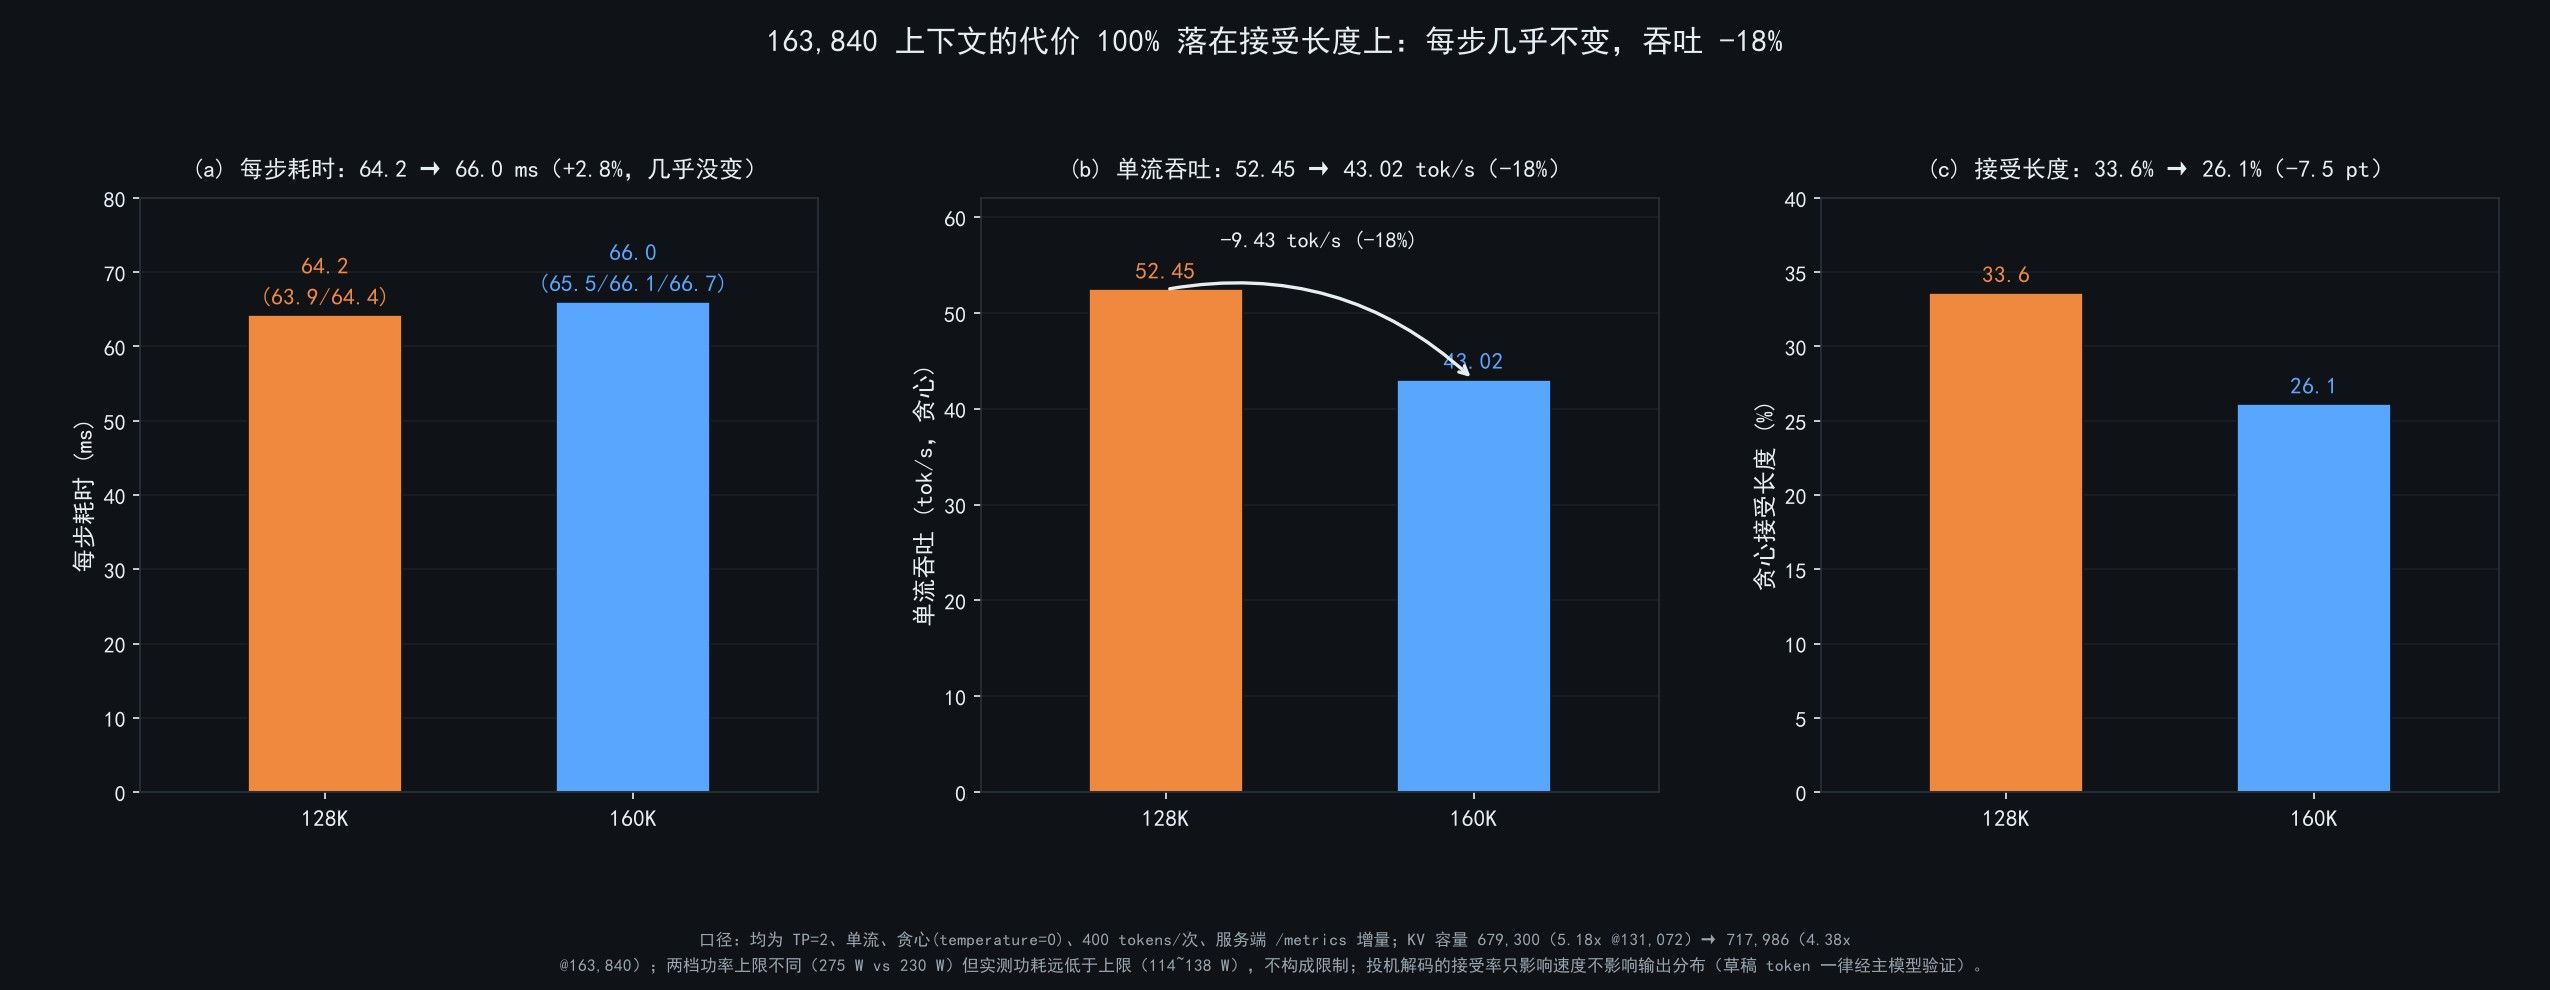
结论很干脆:多出 25% 的上下文,每步耗时几乎不动,代价 100% 落在接受长度上(33.6% → 26.1%)。
⇒ 想要 52 tok/s 就得回 128K;想要 160K 就是 43 tok/s。这是一笔纯速度交易,不是质量交易(见下)。 概念更正:接受率与精度无关这是本轮最该讲清楚的一条,因为论坛上经常被当成一回事:
- 投机解码是无损的:草稿模型提出的 token,一律要经主模型验证才被接受 ⇒ 贪心解码下与不用投机逐 token 等价,采样解码下分布无偏。
- 所以接受长度掉,只掉速度,不掉质量。决定输出质量的是:主模型的量化档(这里 MXFP4)+ 上下文长度(这里 163,840)+ 采样参数。
- 反过来讲也很重要:不要为了让接受率好看,去动主模型的量化或上下文 —— 那是拿质量换速度,方向错了。
采样档的真实表现(同一个脚本的 T=1.0 两次)
档 速度 每步 接受长度 贪心 T=0.0 42.73 / 43.02 tok/s 66.1 / 65.6 ms 26.1% / 26.1% 采样 T=1.0 36.02 / 29.57 tok/s 66.7 / 65.5 ms 20.0% / 13.4% 注意每步耗时两档几乎一样(65.5~66.7 ms),而吞吐差了 30% —— 又一条「速度差异来自接受长度,不是引擎慢」的证据。顺便说明:采样会显著拉低接受率,所以报 tok/s 必须写清温度档。
口径:每次 400 tokens,脚本交替跑 T=0.0 / T=1.0 各两次;接受率取自服务端/metrics的vllm:spec_decode_num_accepted_tokens_total ÷ num_draft_tokens_total增量,不是客户端计时。
七、顺手做的:把这台服务接进自己的 agent 工作流
服务稳定之后,就该让它被工具链用上。这一段踩的是网关层的坑(和 GPU 无关,但同样费时间):
坑 症状 解法 网关的上游模型名必须等于后端的 served_model_name 网关报 The model 'Qwen3.8' does not exist,然后回退到一个已停的后端再报连接错误,表象像「网关坏了」别名是别名,上游名要写后端真正 serve 的名字(这里是 qwen3.8-27b-mxfp4)改配置时别做字符串替换 同一份配置里别的路由上游名以相同前缀开头( Qwen3.8-27B-Uncensored-…),一替换就误伤整行精确匹配改,改完把整段读回来对账 网关启动会去联网拉价格表 内网连不上 ⇒ 3 次超时重试 ⇒ 启动白等约 50 秒,期间端口不监听、curl 返回空(极易误判为「配置改坏了」) 加环境变量 LITELLM_LOCAL_MODEL_COST_MAP=True用内置表 ⇒ 启动 50 s → 9 s(实测)客户端默认模型指向已退役的服务 新开会话先去撞一个没人监听的端口 退役服务就把指向它的 provider / 别名一起清掉,别只停服务 一条通用判据:
/v1/models列出别名不代表路由可用 —— 必须拿一次真实 chat completion 走通才算数。
八、给后来人的清单
买之前
- 想跑TP/张量并行才需要 P2P;只跑「层拆分」或「一卡一模型」根本不需要,别为 P2P 折腾硬件
- 先查卡的 VBIOS 会不会申请大 BAR —— 这比主板型号重要得多。RDNA3(7900 系)在多数平台上只申请 256 M;RDNA4(R9700 等)能申请满 32 G
- 同样两张卡,插 CPU 直连槽和经 PCIe 交换机是两种命运:交换机会吃掉链路层级(本次实测 4 跳掉到 Gen2)
- 多卡要算供电账:显卡+交换机走独立电源,别和主机共用一个
装机时
- 动卡必须断电;独立供电的设备开机顺序是「先显卡/交换机通电,再开主机」
- PCIe 交换机链路里,卡必须挂在同一个交换机下(板载两个 PLX、两卡各挂一个 = 无效)
- 上机先验三条判据:
BAR=32768M/ 可见显存 == 实际显存 /P2P access : ENABLED+ 互访矩阵
调优/部署时
- 魔改 fork 的依赖以
pyproject.toml为准,别信 README;用 constraints 锁死 ROCm torch - 无 P2P 平台跑 TP:
--disable-custom-all-reduce+ 自定义 AR 环境变量关掉 + 给 symm-mem 的_build()打return None补丁 - 报 tok/s必须带四件套口径:量化档、单流还是并发聚合、上下文深度、是否开投机;再加采样温度与时长
- 想要上下文就别指望速度:每步耗时基本不变,掉的是接受长度(实测 −18% 吞吐换 +25% 上下文)
排障时
- 请求卡死 = 立刻杀进程(本文最贵的一条教训):引擎 CPU 拉满却没有吞吐日志,超过正常耗时 3~5 倍就动手
- 服务「起得来但几分钟内自己死」⇒ 先查 0 字节缓存文件(
find … -type f -size 0 | wc -l) - 编译期/首编期断电会留下坏缓存;隔离而不是删除(
mv成.BROKEN-日期-原因) - 验证 OD 偏移要用端到端指标(每步耗时),别信
--show的回读值;一次性写两张卡有竞态,回读要逐卡看 - 客户端一律带超时,别用裸流式客户端读服务(会静默挂住、掩盖服务端问题)
- 掉卡后先
reboot(等满 10 分钟),不行再冷断电;永远不要unbind/bind
九、当前状态 + 下一步
当前形态(已实测验收)
双卡 R9700 32G(CPU 直连)× 2 · TP=2 · MXFP4 权重 · 4 并发 × 163,840 上下文
KV 717,986 token / 4.38×      P2P ENABLED 0↔1      卡间 10.26 GB/s 单向
每步 65.5~66.7 ms             单流贪心 43 tok/s     采样 29.6~36.0 tok/s
供电护栏 230 W / SCLK −250 MHz / VDD −75 mV        温度 38~42 °C
下一步想做的
- 长上下文实测(把 160K 真的填到 10 万 token 以上,看 prefill 与首 token 延迟)
- 把并发从 4 往上试探,量清「并发 × 上下文」的等代价曲线(现在只有两个端点)
- 换更快的草稿路径(容器本身支持多条 draft 分支,当前用的是 stock MTP)
- 把掉电/掉卡时的看门狗做成常驻(请求超时自动杀 + 内核事件告警),不再靠人盯
一句话总结
这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
这个帖子关于 rebar 的分析是值得推敲的. kernel rescan 的逻辑相当复杂, 主要是历史原因造成的. 简单说 7900xtx 不能自动 rebar 到 24G(32G) bar 空间好像是有疑问的. 根据我的测试经验, 如果在交换机下游只插一张卡, 24G bar 没有问题. 如果同时插两张卡, 就都退回到 256M. 问题出在 kernel rescan 的逻辑上, 需要 patch内核, 最终是可以做到两张卡都有24G bar size.
总之, 这个帖子给了一组测试的实际表现, 是值得借鉴的. 但如果要把这些结果直接外推到其它场景, 就需要一定的判断力了.
-
这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
这个帖子关于 rebar 的分析是值得推敲的. kernel rescan 的逻辑相当复杂, 主要是历史原因造成的. 简单说 7900xtx 不能自动 rebar 到 24G(32G) bar 空间好像是有疑问的. 根据我的测试经验, 如果在交换机下游只插一张卡, 24G bar 没有问题. 如果同时插两张卡, 就都退回到 256M. 问题出在 kernel rescan 的逻辑上, 需要 patch内核, 最终是可以做到两张卡都有24G bar size.
总之, 这个帖子给了一组测试的实际表现, 是值得借鉴的. 但如果要把这些结果直接外推到其它场景, 就需要一定的判断力了.
这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
这个帖子关于 rebar 的分析是值得推敲的. kernel rescan 的逻辑相当复杂, 主要是历史原因造成的. 简单说 7900xtx 不能自动 rebar 到 24G(32G) bar 空间好像是有疑问的. 根据我的测试经验, 如果在交换机下游只插一张卡, 24G bar 没有问题. 如果同时插两张卡, 就都退回到 256M. 问题出在 kernel rescan 的逻辑上, 需要 patch内核, 最终是可以做到两张卡都有24G bar size.
总之, 这个帖子给了一组测试的实际表现, 是值得借鉴的. 但如果要把这些结果直接外推到其它场景, 就需要一定的判断力了.
我现在把系统回归到在单机了,等有空了再测试单张卡的效果。
-
7900XTX没办法折腾吗?那还是R9700买X99,XTX继续用X570 670等稍微新点的平台?继续研究,分享很重要。我年底给Lisa Su发个邮件,让她把AMD的消费硬件研发费用10%拨给我们论坛

7900XTX没办法折腾吗?那还是R9700买X99,XTX继续用X570 670等稍微新点的平台?继续研究,分享很重要。我年底给Lisa Su发个邮件,让她把AMD的消费硬件研发费用10%拨给我们论坛
我觉得如果想P2P 还是老老实实用新的平台比较好。amd的卡最好配amd 的芯片组。
-
@terry 说实话双RDNA3跑起来没什么问题,楼主掉卡大概率是7910的1300w电源顶不住。7900xtx的瞬时功耗过高是出了名的,这卡刚上市的时候因为掉驱动的情况过渡,所以有很多峰值功率的实测,我记得单卡瞬时是能跑到700w的。我也是双RDNA3用了2000w电源,另外pcie通道确实要直连CPU。
-
7900XTX没办法折腾吗?那还是R9700买X99,XTX继续用X570 670等稍微新点的平台?继续研究,分享很重要。我年底给Lisa Su发个邮件,让她把AMD的消费硬件研发费用10%拨给我们论坛
我觉得如果想P2P 还是老老实实用新的平台比较好。amd的卡最好配amd 的芯片组。
-
@terry 说实话双RDNA3跑起来没什么问题,楼主掉卡大概率是7910的1300w电源顶不住。7900xtx的瞬时功耗过高是出了名的,这卡刚上市的时候因为掉驱动的情况过渡,所以有很多峰值功率的实测,我记得单卡瞬时是能跑到700w的。我也是双RDNA3用了2000w电源,另外pcie通道确实要直连CPU。
-
-
@张光璞 我就是从x99 跳去 epyc
我不听 卖家劝 一开始如果上epyc 省2千 -
电源问题 换个电源还是最简单最保险
-
这套机器上,两张卡能不能稳跑 TP,不取决于你多会调参,取决于卡 VBIOS 愿不愿意问 BIOS 要那 32 GB;而它稳不稳,往往取决于你有没有在编译期断过电、以及你有没有在数据说「不是热、不是电」的时候,肯换掉自己那个想当然的假设。
这个帖子关于 rebar 的分析是值得推敲的. kernel rescan 的逻辑相当复杂, 主要是历史原因造成的. 简单说 7900xtx 不能自动 rebar 到 24G(32G) bar 空间好像是有疑问的. 根据我的测试经验, 如果在交换机下游只插一张卡, 24G bar 没有问题. 如果同时插两张卡, 就都退回到 256M. 问题出在 kernel rescan 的逻辑上, 需要 patch内核, 最终是可以做到两张卡都有24G bar size.
总之, 这个帖子给了一组测试的实际表现, 是值得借鉴的. 但如果要把这些结果直接外推到其它场景, 就需要一定的判断力了.
我现在把系统回归到在单机了,等有空了再测试单张卡的效果。
-
-
电源问题 换个电源还是最简单最保险
我买了台达1500 , 但线不够 。
今天顺丰送到,到了我再试试。
我这里蓝宝石的1200W带两张7900xtx目前没碰到问题: 一张卡用 12VHPWR转3个8pin(外加MB 24pin给槽供电), 另一张卡用3xpcie 8pin (外加 cpu转pcie给槽供电).
-
我现在把系统回归到在单机了,等有空了再测试单张卡的效果。
对了, 你那个"交换机下游 4 跳只跑 Gen2(5 GT/s)"是怎么回事? gen4的交换机, gen4的卡(7900xtx), 走线都在PCB上, 为啥只能到 gen2?

