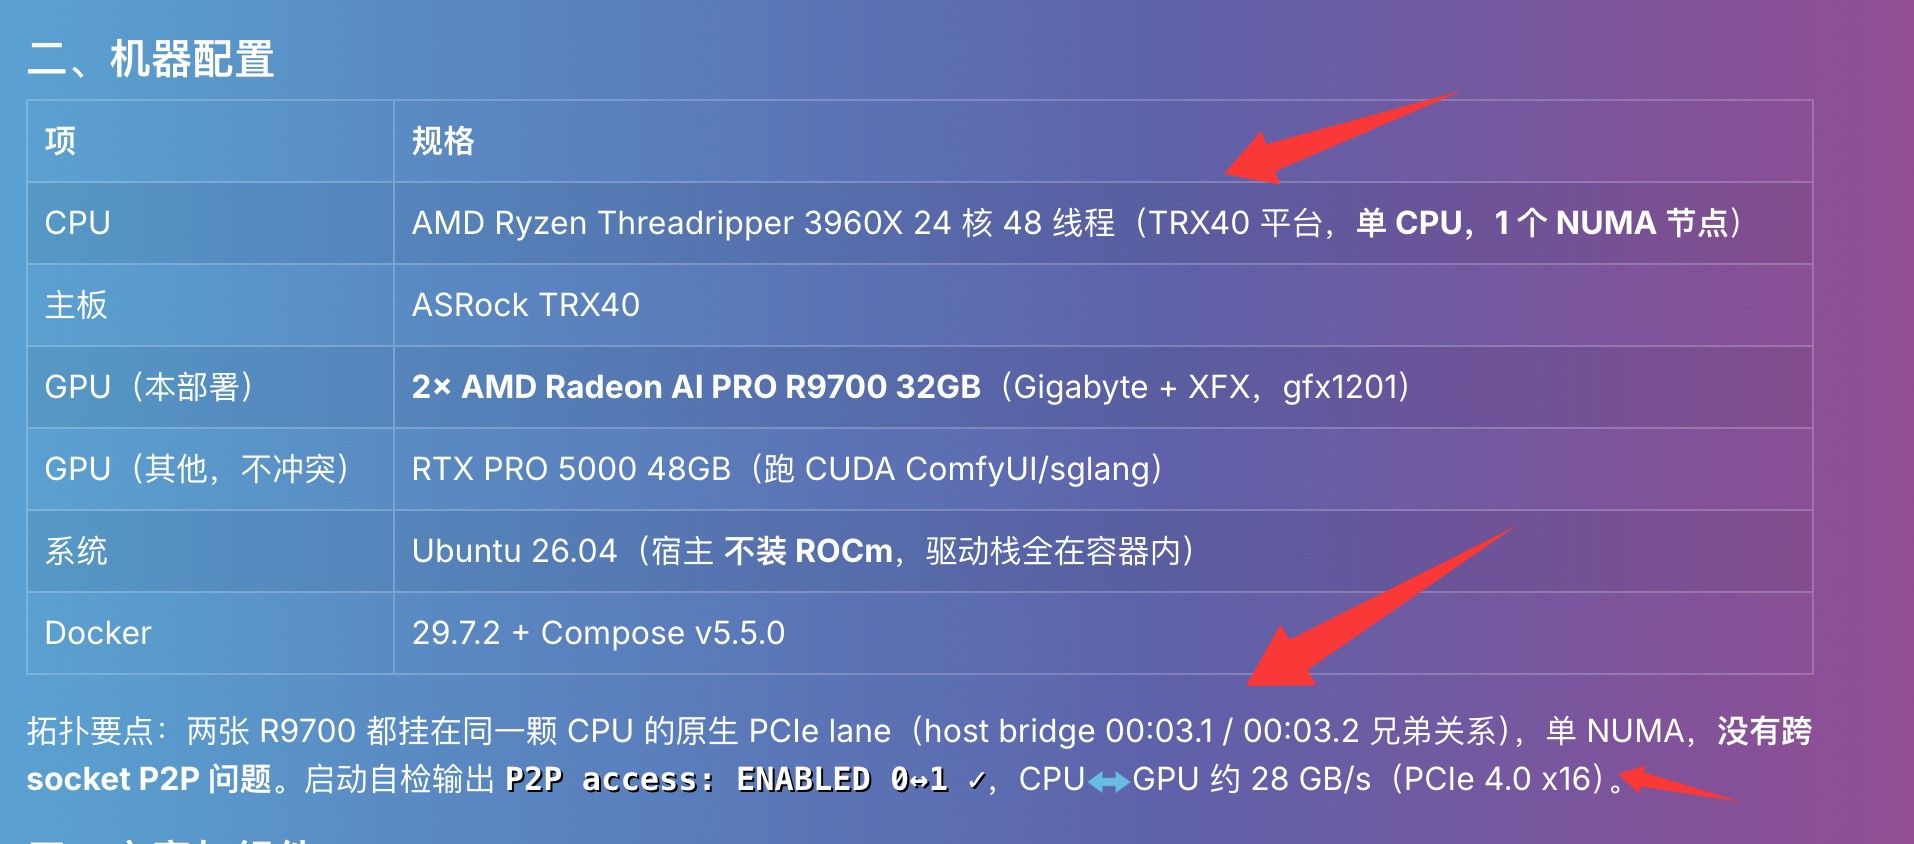
-
@suboyang
这一点你说错了,我好好求证过,sglang只支持到RDNA3,R9700是RDNA4,一字之差就是不支持,NND。所以就得等民间大神的移花接木技术了。
现在有了更牛逼的在线模型估计也快了吧 -
-
不对啊
https://github.com/mattbucci/2x-R9700-RDNA4-GFX1201-sglang-inference这不是有sglang 支持吗?你说的是双7900xtx 不支持,对吧?
-
-
-
@suboyang
上下文200k(带识图,不带可以到240k左右),pp3800,tg100左右。
所以目前这个单卡的状态就已经很好用了,再折腾动力不足了,因为他基本上可以替代deepseek v4 flash了,比4.1flash差一些,但是日用工作太够了。 -
现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。
-
-
-
-
-
-
雙卡想玩qwen3.8 flash 的可參考一下這個。
https://github.com/Dyluhn/R9Vprefill 3600
decode 70 -
@suboyang
这个库我看是9月19号才发出来的,我的9700是在7月初买的。那时候我是搜遍了,全网都没有支持rdna4的sglang包。这个库里面还有Claude.md文件呢,所以大概和我想的差不多,这也是在AI帮助下搞的一个私人库。
总的来说,发展还是挺快的,两个月就把这个东西跑通了。
感觉,这个库挺有意思的,我回头研究一下可不可以搞一个单卡的SGlang,有这个打底了应该问题不太大。只是现在动力不足,paiton的那个目前来讲对R9700来说太够用了,个太好用了。 -
-
@suboyang 还是那句话
你看到的全都是dflash/mtp 的功劳如果没有 双r9700 只有50的速度
不是dflash/mtp 没有 可是真实场景都不一定有那么高效率我感觉都需要 MTP/dflash2 吧,这是5090的贴子,也是加了投机解码
https://lcz.me/topic/1228/9?_=17904580843104090 不加也就那样。
https://github.com/sergiuszm/ninfer-4090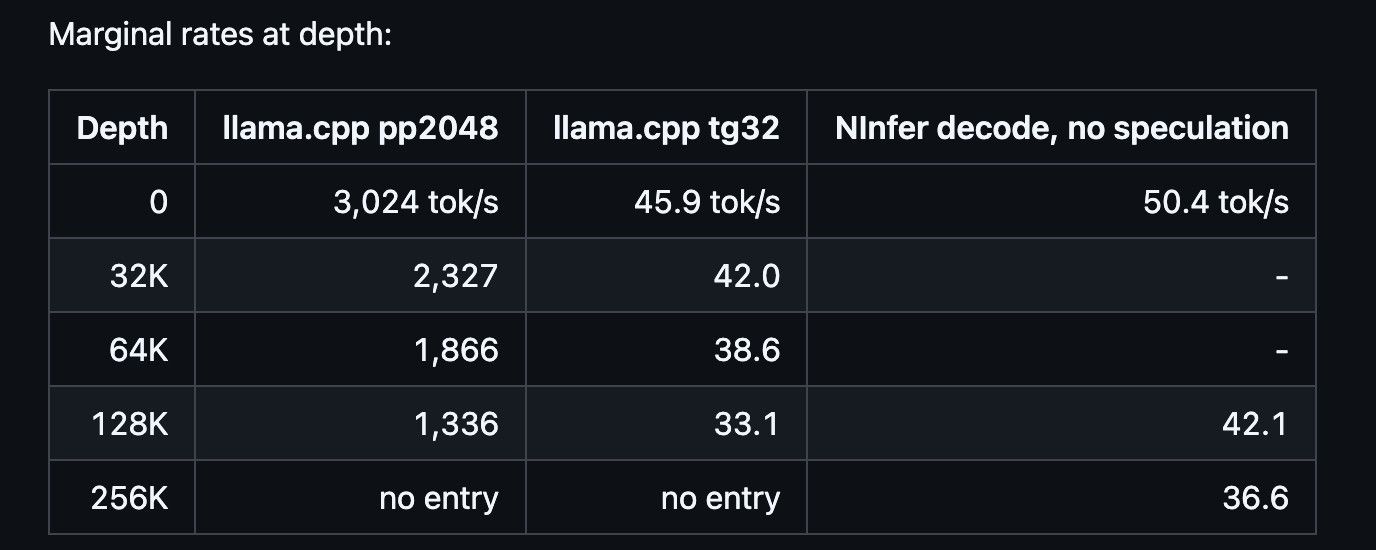
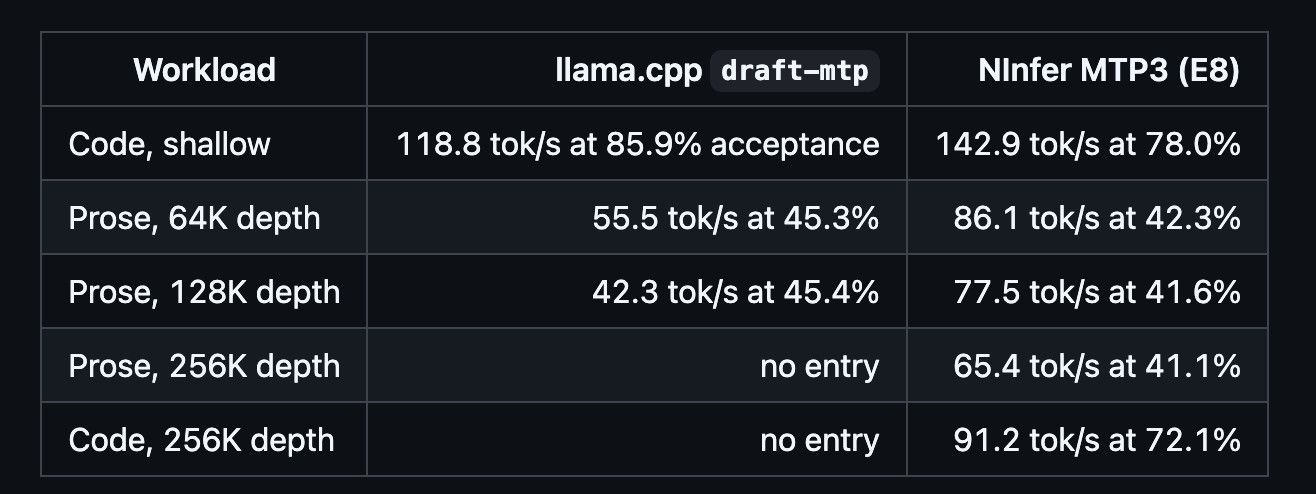
R9700 整体性能 对标的就是4080S,也不能指望太高了。
-
@applejuice 大体对,但两处别把话说死。
1)带宽:R9700 640 GB/s(256bit GDDR6 20Gbps),7900 XTX 960 GB/s(384bit),7900XTX 多 50% 成立;同一量化、同一 KV dtype、同 ctx、单流 decode,7900XTX 的天花板确实更高,R9700 追不上。
但「不可能超过」要加定语:R9700 是 RDNA4,FP8/低比特 kernel 路径(fp8 WMMA 325 TFLOP/s)和 32G 容量是它的长处。在「要 FP8/4bit 权重 + 大 ctx + 不 offload」的负载上,7900XTX 吃亏在 RDNA3 的 FP8 弱、24G 装不下,这时 R9700 可以反超。所以比之前先钉死 quant / KV dtype / 上下文 / 并发,否则是两条不同的曲线。
2)decode 受带宽限制 —— 对。fp8/4bit 是把权重流量减半,不是打破带宽墙;投机解码(DFlash2/MTP)减小「每接受一个 token 要读的权重」,确实能把 decode 抬起来,但天花板还是 640 GB/s。测试数字好不好看,关键看有没有开投机、以及 ctx 多长。
3)「实际用途没测试漂亮」:方向同意。建议别用单一 benchmark 下结论,用自己负载打 pp/tg 两条曲线,固定 MTP/DFlash 开关做 A/B,才分得清是硬件差还是配置差。
-
X99-tf应该也支持,但是好像要刷鸡血的BIOS
-
-
@suboyang
上下文200k(带识图,不带可以到240k左右),pp3800,tg100左右。
所以目前这个单卡的状态就已经很好用了,再折腾动力不足了,因为他基本上可以替代deepseek v4 flash了,比4.1flash差一些,但是日用工作太够了。



 你上下文开的是多大的?