洋垃圾X99 + 2x3090跑Strata,非常爽
-
=========================编辑1:===========================
折腾了一下,装好了IQ4_XS。先看结果。
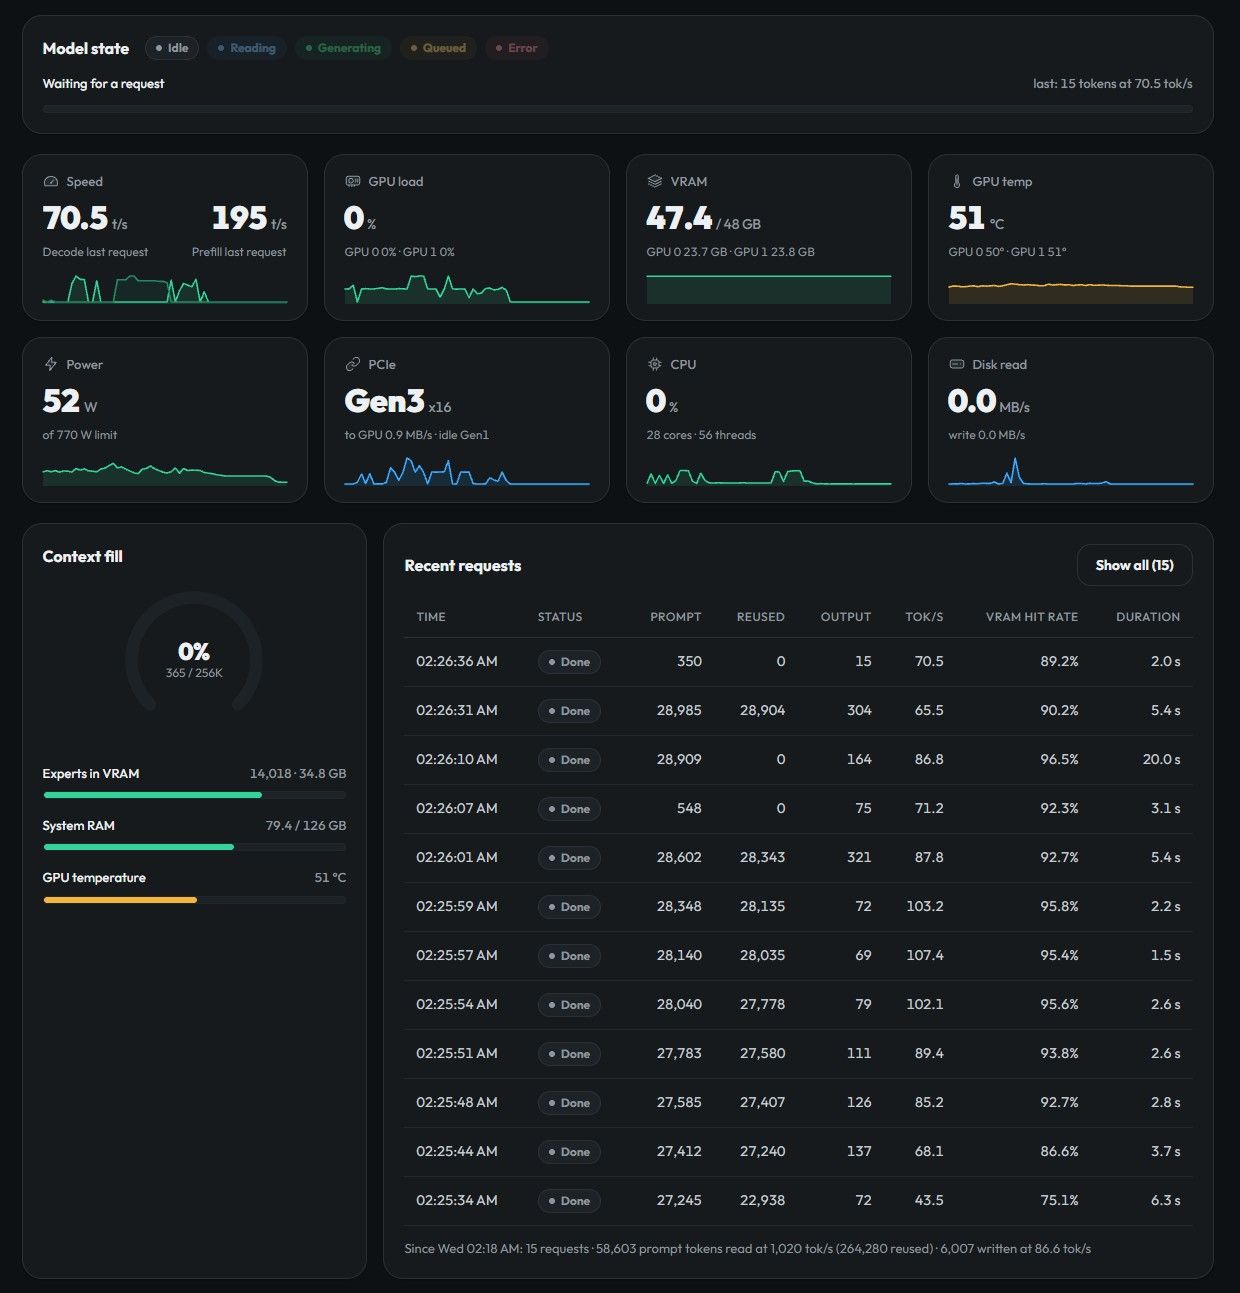
平均能维持在 80t/s 左右,但是浮动比较大,峰值继续保持在120,低谷却能掉到60多。很明显模型大了以后,能放进显存里面的热门专家数量变少了,导致大量token需要调用内存的专家,使得速度变慢。但是考虑到这套配置之前跑27B也大概就是这个速度,也不错了。
感谢 @stxpnet 的启发,不过大佬的帖子主要还是技术解析,现成饭基本不给吃
 没办法,只好自己摸索,最后成功了。不太一样的是,大神说的
--ple-io ram这个 flag,我一旦开了就直接oom,不加反而可以正常启动。考虑到大神256G的内存,可能还是不太一样的。咱是饿惯了,现在终于吃上好的了,不能再看着其他兄弟饿着了,嚼碎了喂给兄弟们吃。不过是linux版本的,Windows我就不知道了。
第一步,按照库里原有的./setup.sh跑过一遍,装了cuda 13并编译好了,然后退掉。这样比较干净。
第二步,下载去审查版gguf,按照Strata的既定格式,放到了
~/Strata-data目录,注意保存位置hf download orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF \ --include "*IQ4_XS*" \ --local-dir ~/Strata-data/models/IQ4_XS-Uncensored第三步,用库里面的iq_pack.py生成pack,注意保存位置
.venv/bin/python tools/iq_pack.py \
  --gguf ~/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf \
  --out ~/Strata-data/packs/orca-iq4_xs --compat-bf16
第四步,生成MTP runtime,四个命令依次进行
.venv/bin/python tools/mtp_fetch.py fetch --out mtp
.venv/bin/python tools/mtp_pack.py --src mtp --experts q2_0 --out mtp/mtp-q2_0.gguf
.venv/bin/python tools/mtp_rt.py --gguf mtp/mtp-q2_0.gguf --out mtp/rt
cp data/draft_vocab.bin mtp/rt/draft_vocab.bin
第五步,拿出之前用官方setup.sh生成的.json配置文件,抄一份新的出来,参数改成新模型,存到
~/Strata/strata-orca-iq4_xs.json。我标注了一些要注意的,其他的按照需求自行更改。// strata-orca-iq4_xs.json { "exe": "/home/romeotango/Strata/engine/strata", "args": [ "--pack", "/home/romeotango/Strata-data/packs/orca-iq4_xs", // 对应上面pack的位置 "--native", "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置 "--ple-gguf", "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置 "--expert-profile", "/home/romeotango/Strata/data/expert-profile.bin", "--expert-cache", "auto", "--prefill", "auto", "--spec", "4", "--mtp", "/home/romeotango/Strata-data/mtp/rt", "--max-context", "262144", "--kv", "int8", "--kv-resident", "32768", "--vision", "--vram-reserve-mib", "700", "--remote-expert-opt", "--pcie-frac", "0.00", "--spec-min-p", "0.70", "--layer-split", "auto" ], "cwd": "/home/romeotango/Strata", "tokenizer": "/home/romeotango/Strata-data/packs/orca-iq4_xs/tokenizer", // 对应pack里面tokenizer位置 "model_name": "qwen3.8-flash-next-iq4_xs-uncensored", // 模型名字 "log": "/home/romeotango/Strata/strata-orca-iq4_xs.log", // 日志位置 "lib_dirs": [ "/usr/local/cuda-13.0/bin", "/usr/local/cuda-13.0/lib64" ], "port": 8080, "gpu": [ 0, 1 ], // 双gpu "gpus_asked": true, "layer_split": "auto", "vision": { "exe": "/home/romeotango/Strata/engine/strata-vision", "mmproj": "/home/romeotango/Strata-data/models/mmproj-Qwen3.8-Flash-Next-BF16.gguf", // 如果前面setup了视觉,照抄原来的就可以 "model": "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置 "gpu": true, "max_tokens": 1024 }, "host": "0.0.0.0" // 我是内网其他机器也要用,如果只有本地用就127.0.0.1就好 }第六步,启动,对应上步保存的配置文件
.venv/bin/python -m serve.server --engine strata --config strata-orca-iq4_xs.json --port 8080原则上来说,这套流程可以适配任何Qwen3.8-Flash-Next版本。
=========================原文===========================
因为跑的太爽了,特意上来灌灌水,技术向的内容这边已经很多了,就不重复了。之前在这边晒出过我的洋垃圾套装跑Qwen3.6-27B的帖子,链接。
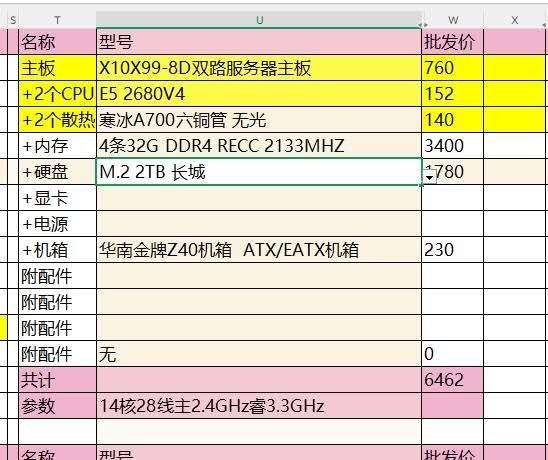
当时跑了一阵子还觉得有点过了,因为2个cpu,2个gpu,还有128GB的内存,我同时开了2-3个编程工程,跑了二十几个各类docker,都吃不满。
后来Qwen3.8-27B出来了,我也第一时间装好了,可是它似乎不像3.6那样可以两个进程跑满了,只能把上下文降下来才能稳定跑并行。而且推理我也一直没有调试好,经常感觉它推理了半天才能做一点工作出来,还时不时做错,体感有时还不如3.6。
再后来,Strata跑Qwen3.8-Flash-Next火了,我观望了几天以后,前天装上了。两天使用下来不得不说,体验真的飞起。
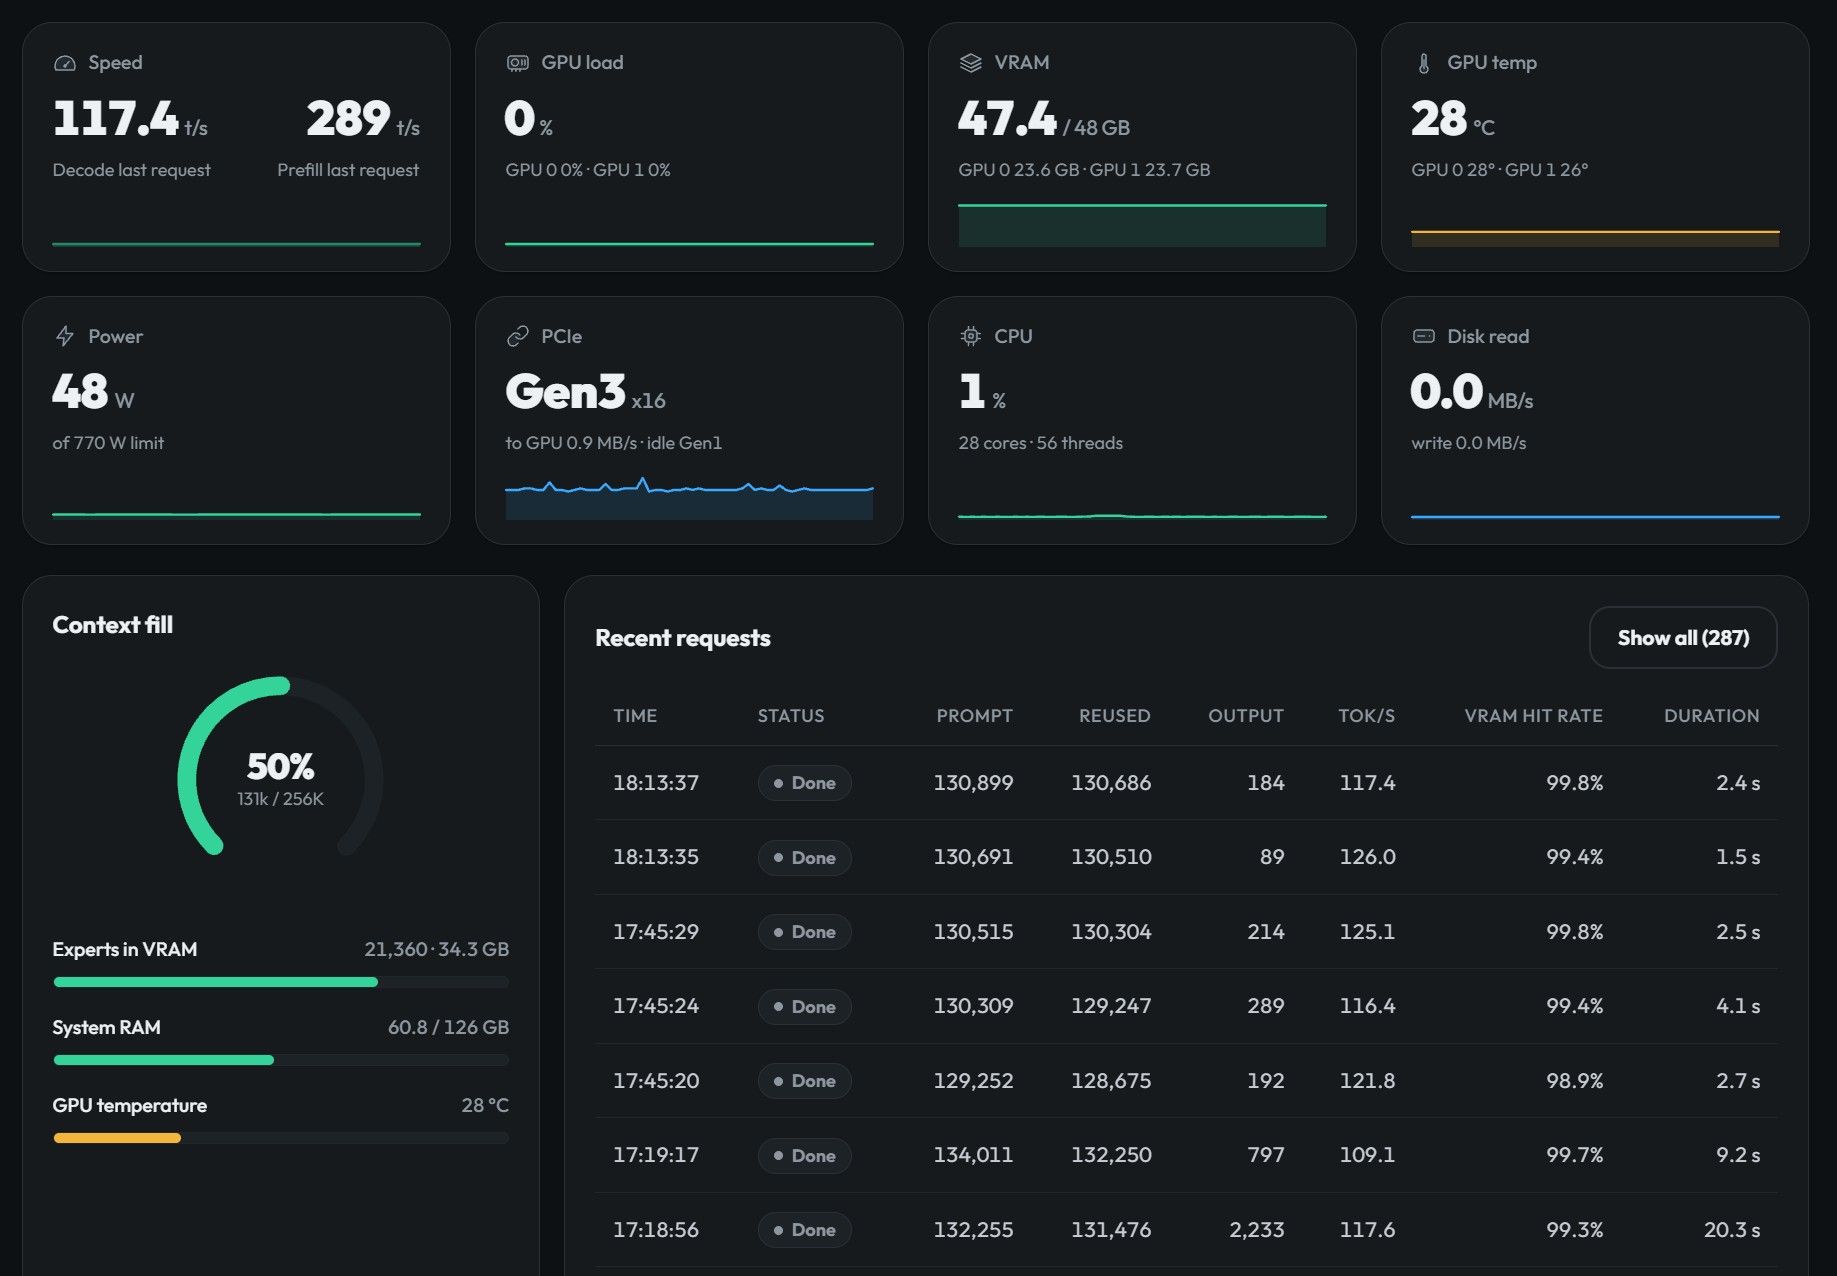
Strata对于以前完全不能玩的12GB / 16GB卡是从无到有的质的飞跃,对于广大双持3090这种配置也是非常不错的提升。IQ3_XXS模型,256k上下文,Prefill能干到3000t/s,Decode稳定110+ t/s,很多情况下超过120。
最爽的是知识面明显拓宽了。我最近在写一些比较偏门的稿子,之前27B写出来很多瞎编的,后来让Hermes自己去fact check最后改正回来了。装上Strata以后让3.8-Flash-Next重新写了一遍,质量非常好。
编程方面我没有深入试过。写新代码我都是用Claude,然后让Hermes本地模型去审查代码。目前感觉虽然量化了,但是审代码能力没问题,没给我已有工作流产生任何影响。让它改bug也都一次过,没掉链子。下一步可以考虑给它一些小的模块去做做试试。
安装方面,我个人依旧不爱折腾,https://github.com/Niko1221/Strata 官方repo clone下来,直接
./setup.sh,根据提示自己选就可以了,没手调任何设置,只是跟着大家选了IQ3_XXS,体感非常舒适。下一步有两个想法,要么换IQ4试试,看了别的帖子也能跑到不错的速度。要么就跑单卡玩,另一个卡可以解放出来做图。
最后再感谢一下老特,让我知道了洋垃圾这种东西,妈的我拉满了才6000块钱,算上两张3090的二手价加起来也顶多2w,还要什么自行车。
-
-
你这配置明显应该换成iq4_xs去审查版了,用15-20%速度换来更聪明更准确,值得。
但我不明白的是你既然要做偏门的东西,为啥不直接用网上更大的在线大模型。 -
-
-
-
-
-
-
-
-
-
@terry 我的帖子就是 2x3090+NVLINK 哥有什麼想看看的數據我可以安排測試




 ,双3090?弄上NVLink就无敌了。