跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B

體感經驗 哪一個強?? Qwen3.8-Flash vs. Qwen3.8-27B

已定时 已固定 已锁定 已移动 热议 LLM讨论区
qwen本地模型strata
43 帖子 26 发布者 1.7k 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • perterP
    perterP
    perter
    德高望重 劳动模范
    编写于 最后由 编辑
    #16

    Qwen3.8-Flash vs. Qwen3.8-27B 肯定要对比同样量化的版本才有意义。

    • Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS
      有一定生产力的工具
    • Qwen3.8-27B-GSQ-RCO-IQ3_XXS
      只能聊天的玩具
    1 条回复 最后回复
    1
    • 懒人烘培懒
      懒人烘培懒
      懒人烘培
      德高望重 劳动模范
      编写于 最后由 编辑
      #17

      经过实际的测试感觉上27B + SGLang体验会更好些,虽然我3.8 flash next也在本地部署了

      双 7900 XTX:模型本地跑,Token 随便烧!

      1 条回复 最后回复
      1
      • fcmeF
        fcmeF
        fcme
        超凡大师
        编写于 最后由 编辑
        #18

        做长程开发的话,就flash next在后台跑,日用还是27b叠加Dflash以后响应快很多,然后比较爽,日常使用感觉不出来质量的差别!

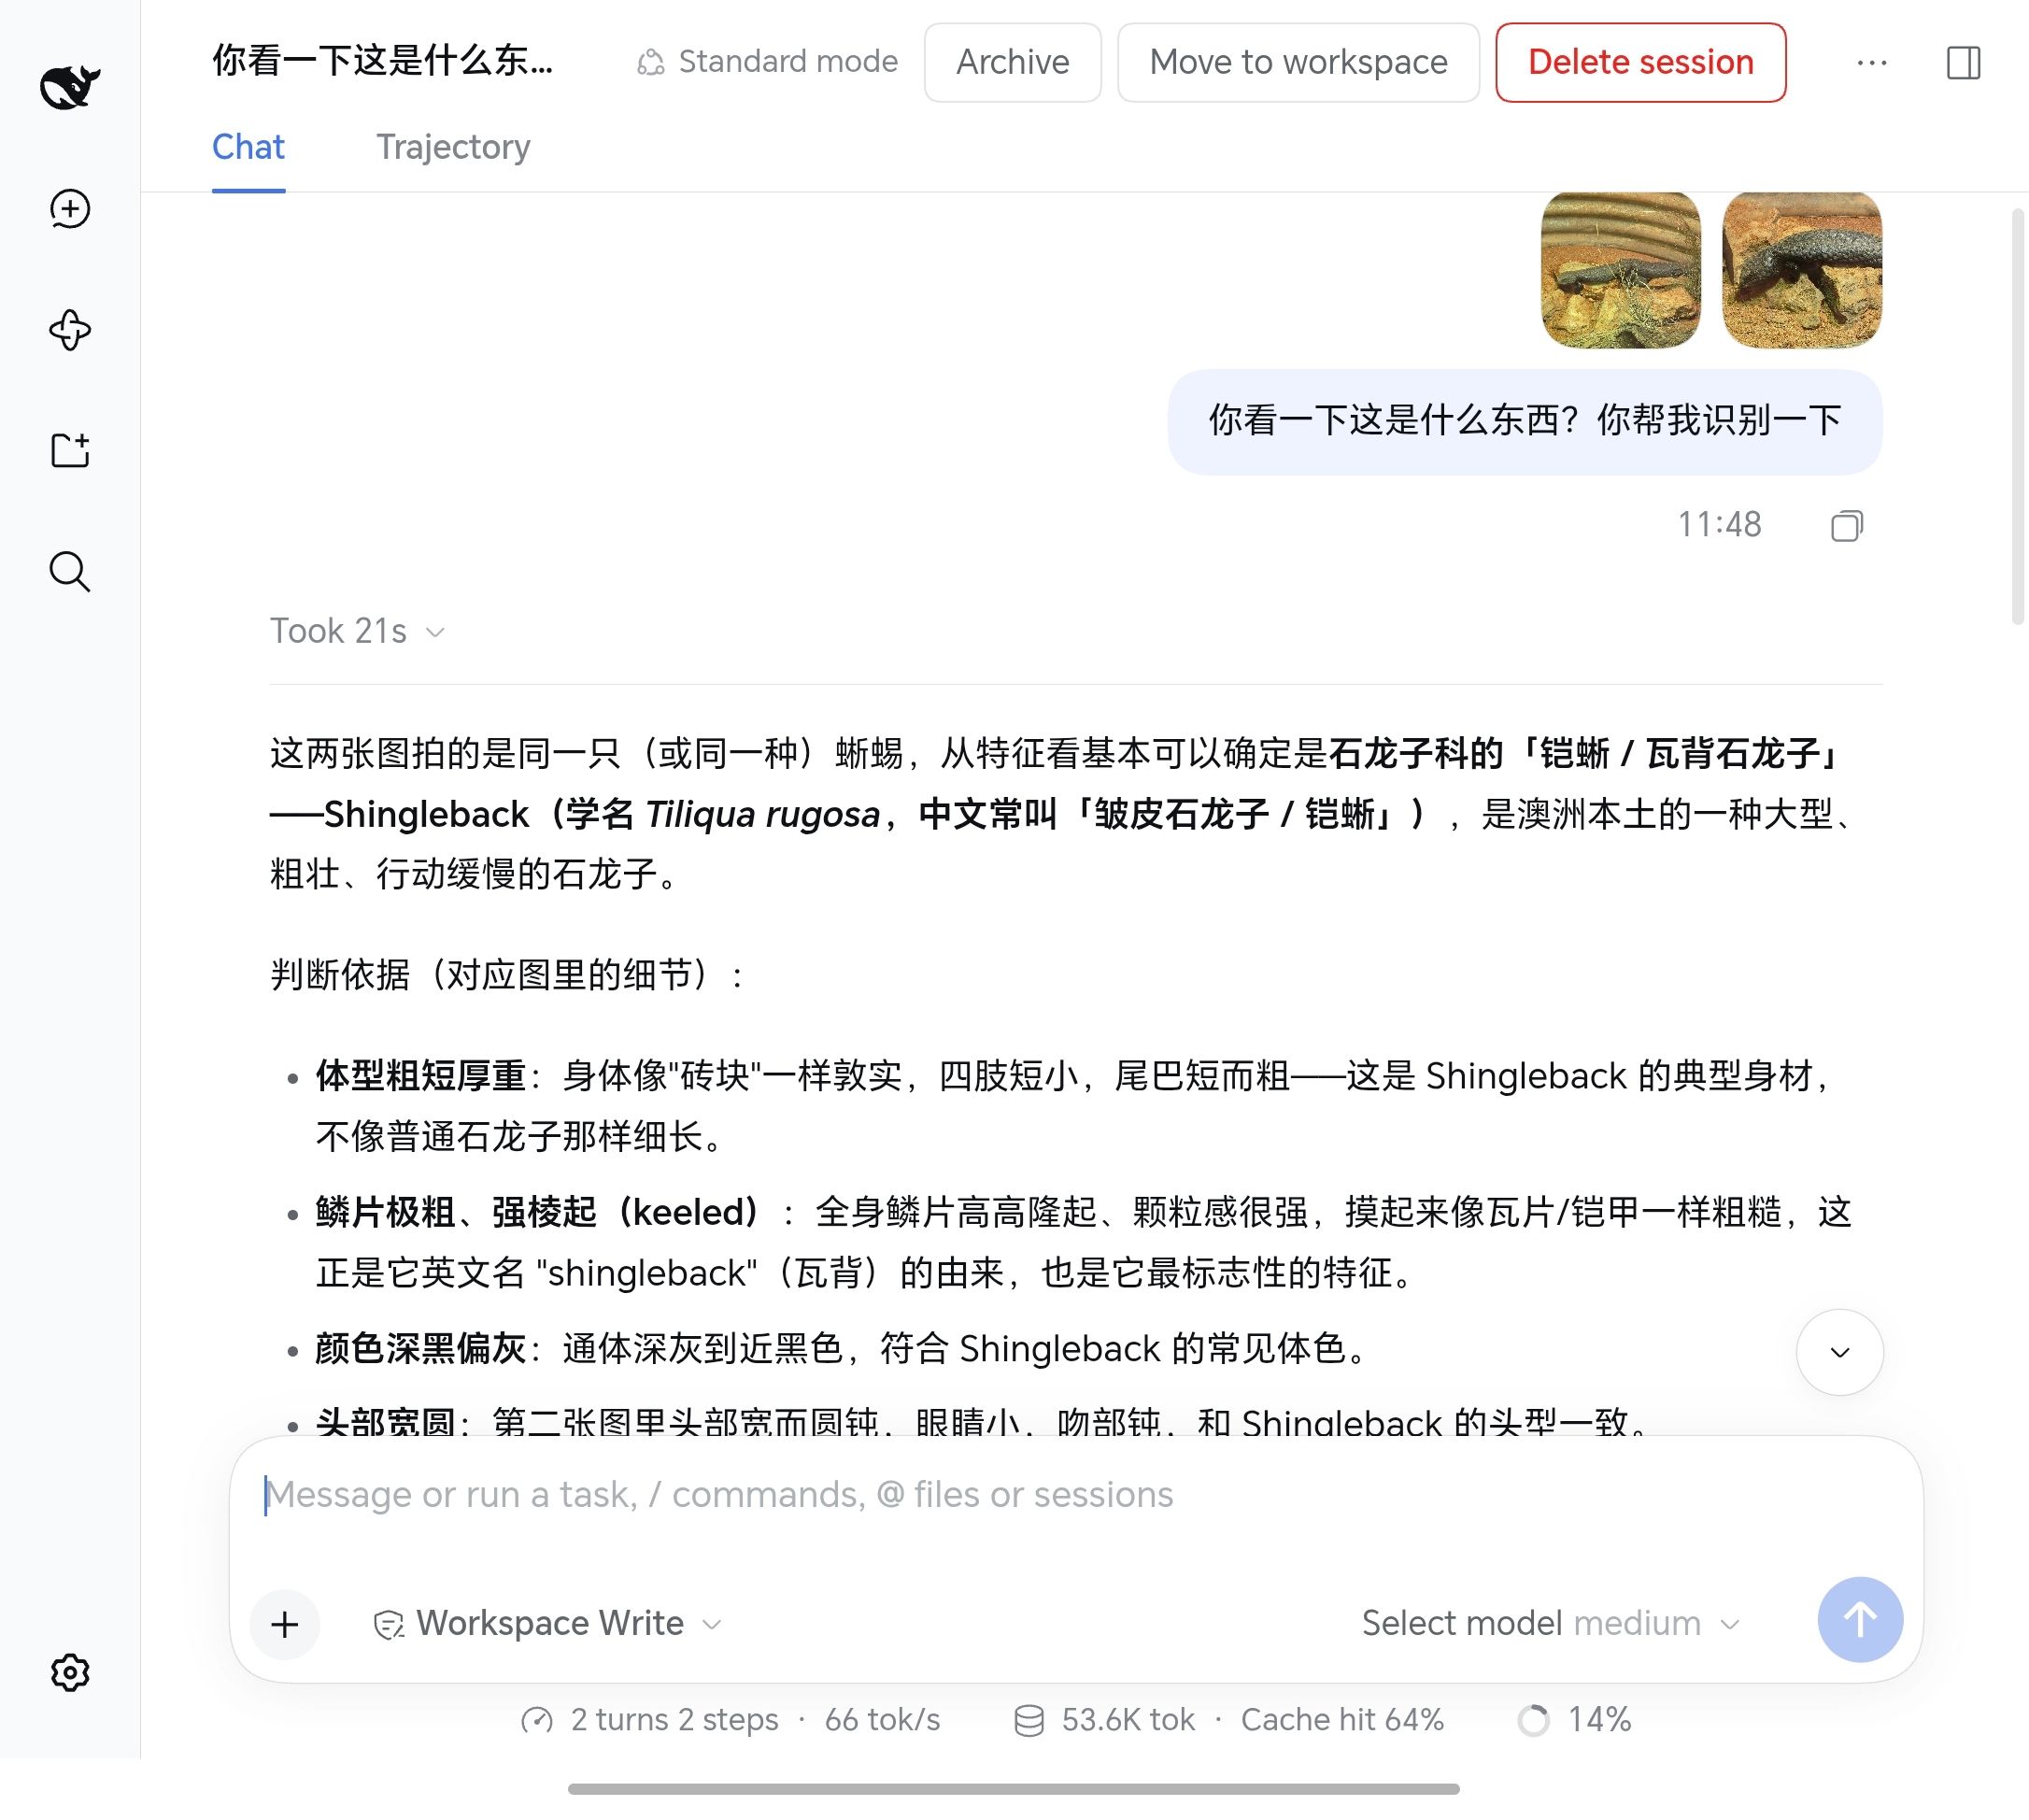
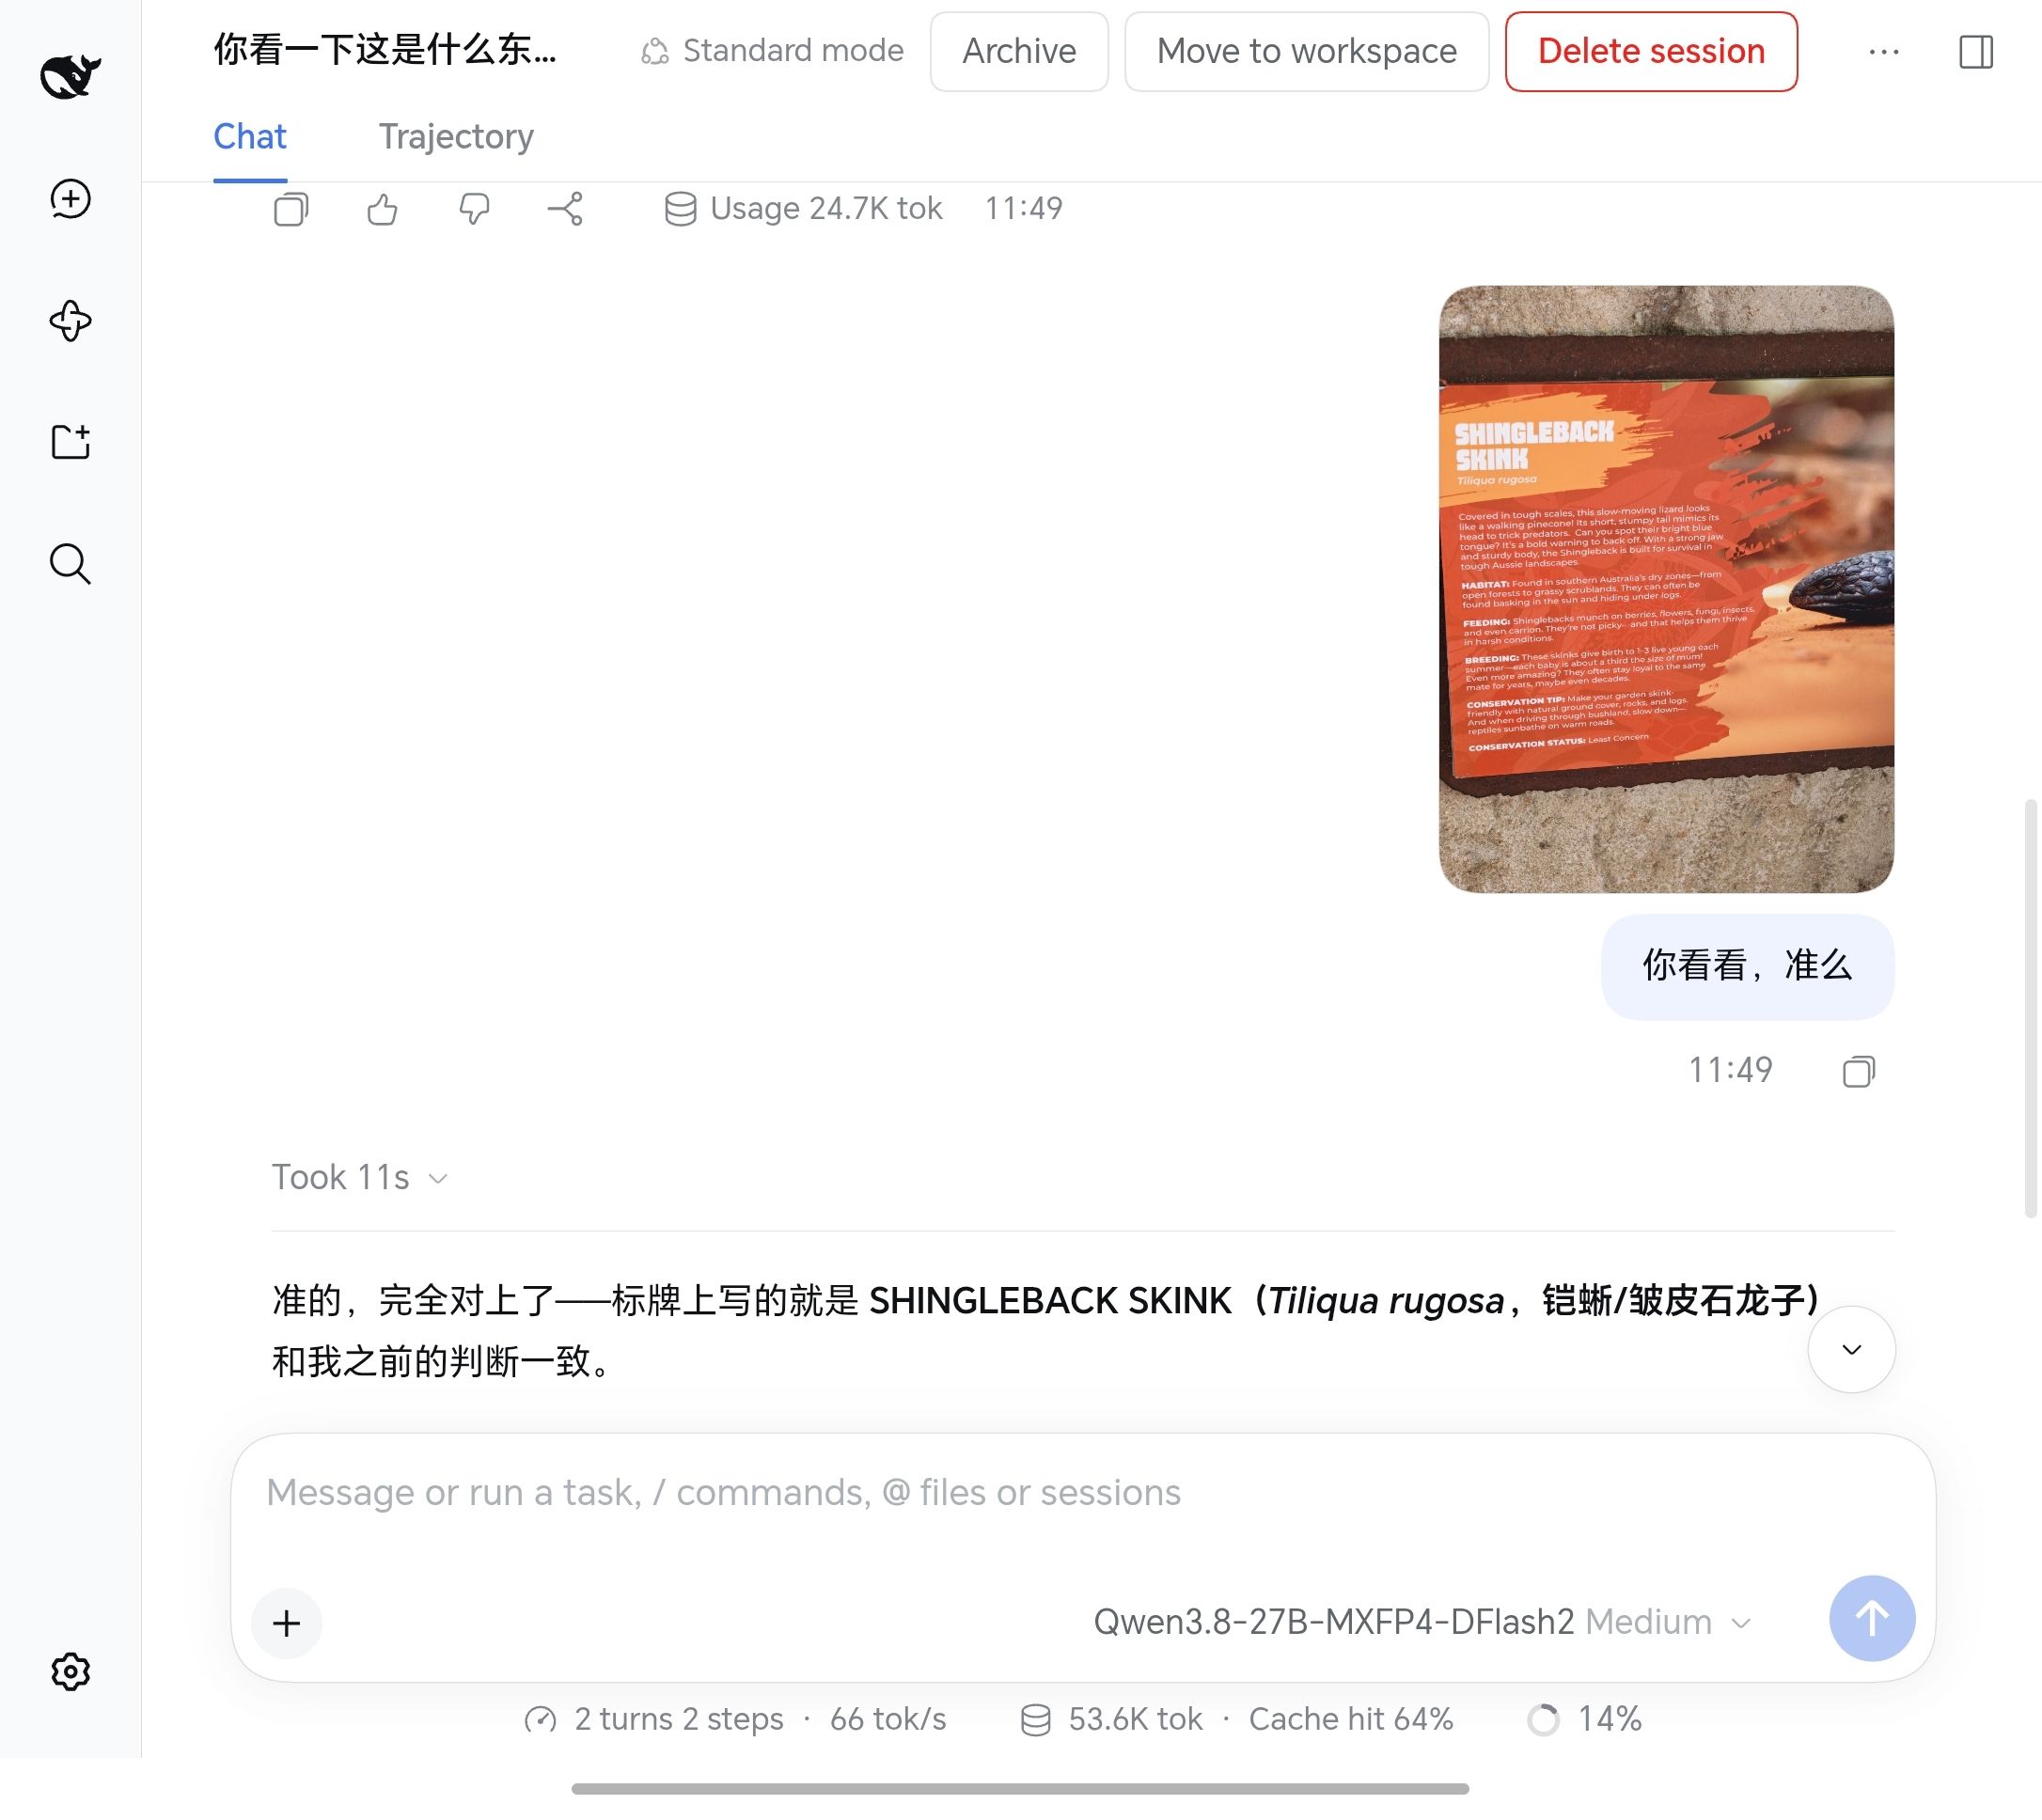
        给你看个27b的例子,手机随手拍的照片,让它识别动物。

        Screenshot_20261004_115341_com_android_chrome_ChromeTabbedActivity.jpg

        Screenshot_20261004_115358_com_android_chrome_ChromeTabbedActivity.jpg

        准确率那是相当高了,而且27b本身也不是什么大的模型,知识面都有这么广!

        但是27b和flash next的差距还是显而易见的,见下面的例子,用同样的dsh在两个不同的对话里面flash next生图明显细腻很多,数据我用DS核对过了,两个都是对的。

        27b的:

        91762857-5079-4aca-8758-96f863c7a0c4.png

        Flash next的,明显好很多嘛!

        a85833e3-bc9e-4a4a-998c-9f2b6935ab9d.png

        1 条回复 最后回复
        3
        • kos orK
          kos orK
          kos or
          超凡大师
          编写于 最后由 kos or 编辑
          #19

          個人使用體感經驗 (未和SGLang Qwen3.8-27B 或NInfer, HyperQwen 比較)

          比較了 Strata-Swift15-Qwen3.8-Flash-IQ4_NL (RTX 5070 Ti) vs. LLama.cpp-Qwen3.8-27B-Q4_K_M-Dflash2 (7900XTX)
          在雙方都是 Reasoning Low 的條件下,使用的介面為Hermes Agent,從Agentic一般生活常態功能(不含coding)操作的角度來說,
          Strata-Swift15-Qwen3.8-Flash-IQ4_N 任務輸出品質約多出30%,任務輸出速度約快30%~70%(看任務複雜度)

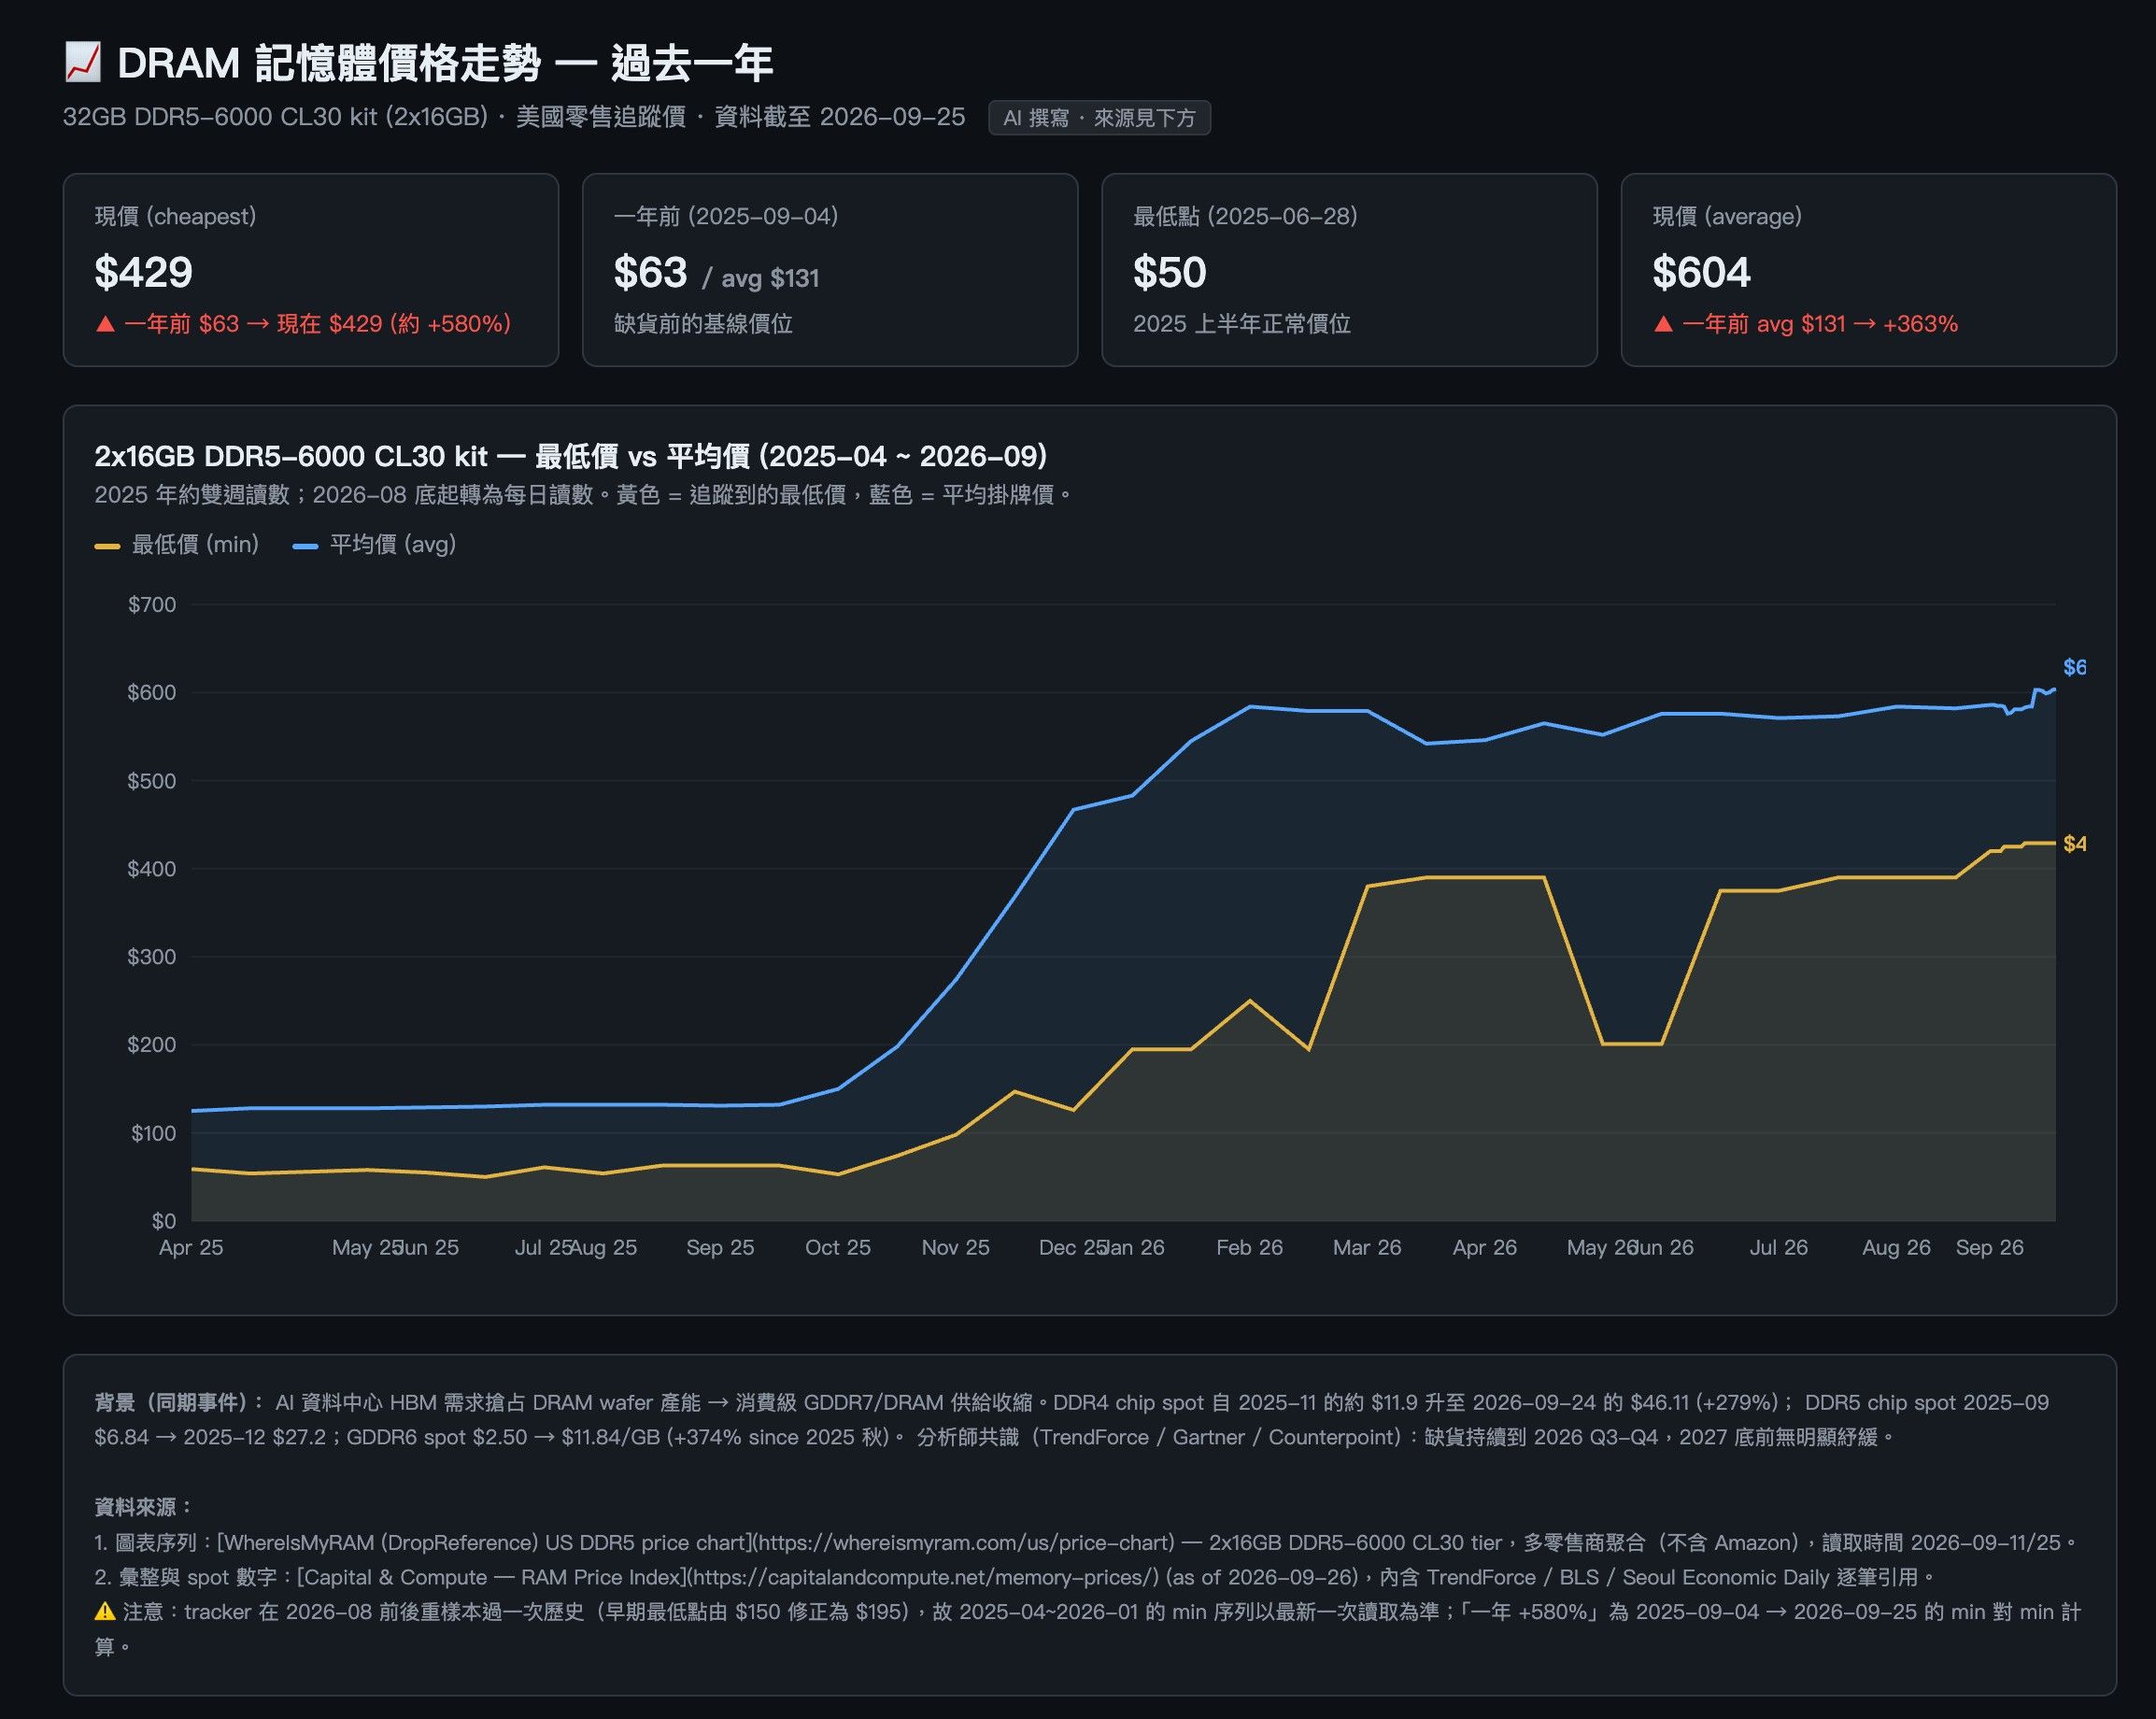
          prompt : 製作一張過去一年記憶體走勢的圖表 in html

          Strata-Swift15-Qwen3.8-Flash
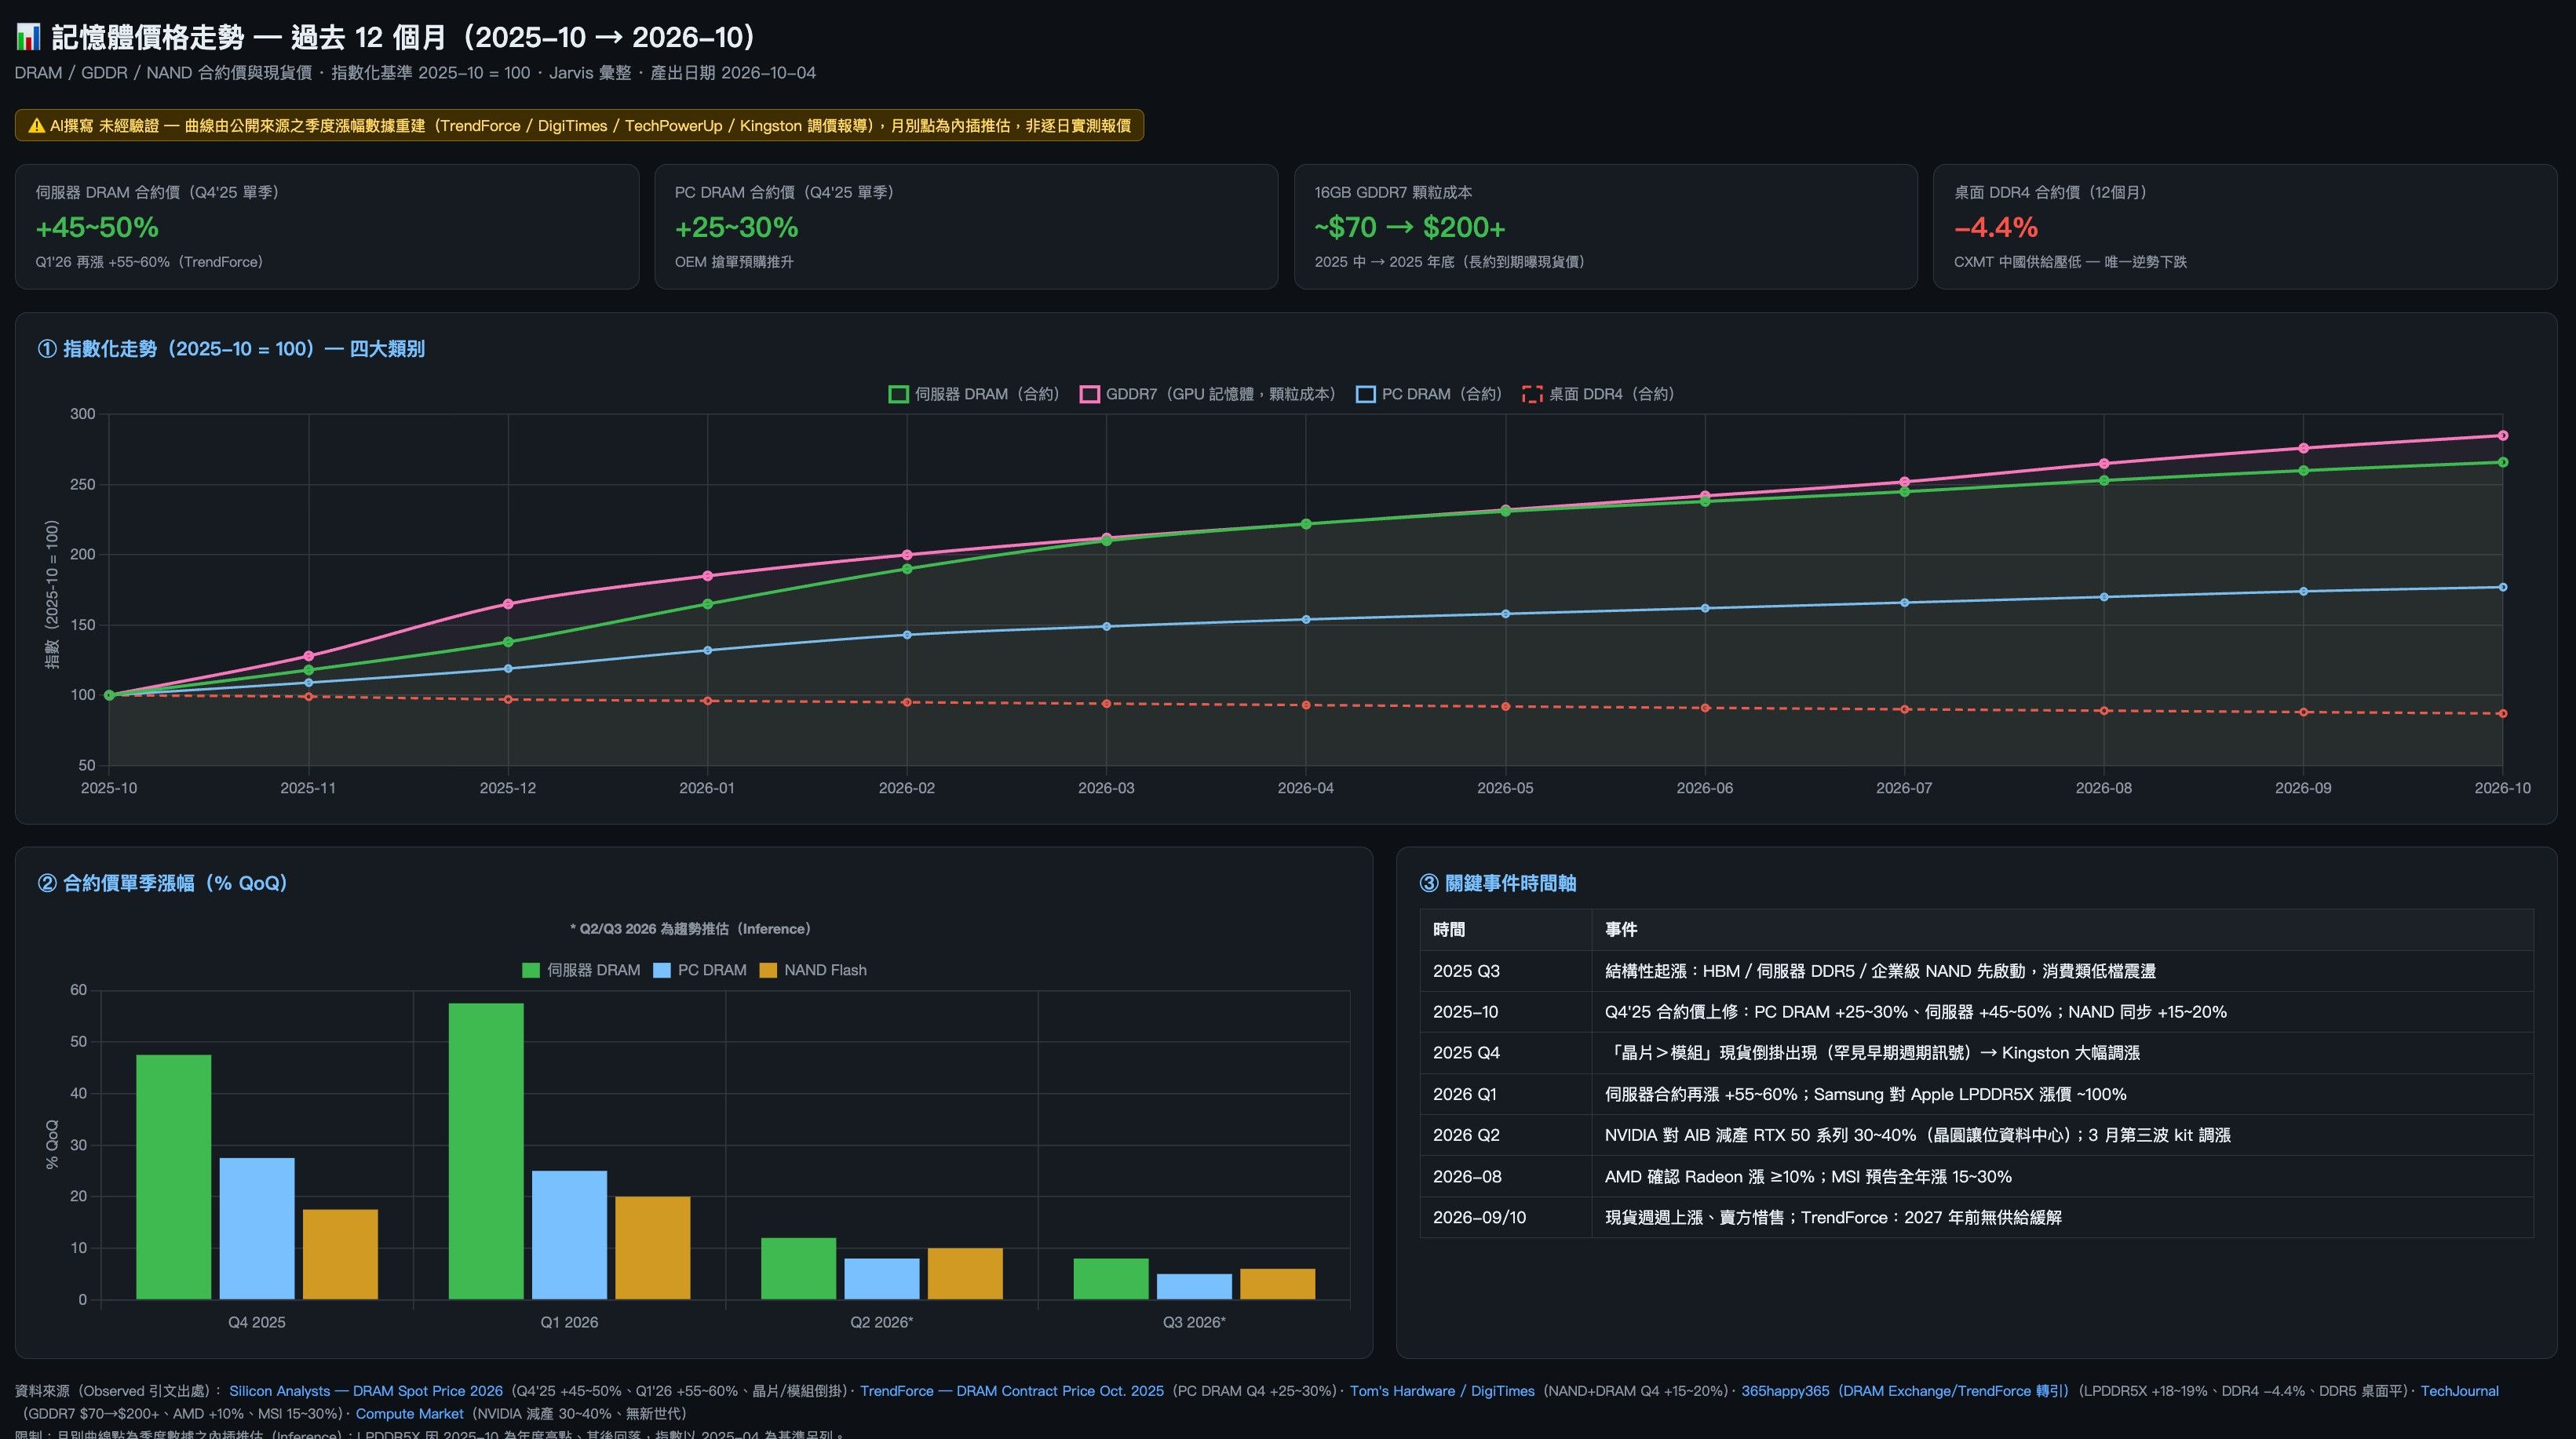
          image.jpeg

          LLama.cpp-Qwen3.8-27B-Q4_K_M.
          image.jpeg

          1 条回复 最后回复
          3
          • NY ZhaoN
            NY ZhaoN
            NY Zhao
            编写于 最后由 编辑
            #20

            我实测下来,Flash next聪明多了

            terryT 1 条回复 最后回复
            0
            • NY ZhaoN NY Zhao

              我实测下来,Flash next聪明多了

              terryT
              terryT
              terry
              超级版主
              编写于 最后由 编辑
              #21

              @NY-Zhao 具体是哪些领域呢?

              油管:https://www.youtube.com/@抡锤者

              1 条回复 最后回复
              0
              • ?
                ?
                老用户
                编写于 最后由 编辑
                #22

                测试了2个方案,还是觉得strata+flash-next更智能、更快。2张4090下,输出能200 t/s,prefill能到7600 t/s。能耗设置330W,温度不过60,GPU LOAD也能跑满。体感上速度和网络API差不多了

                kos orK 1 条回复 最后回复
                1
                • ? 老用户

                  测试了2个方案,还是觉得strata+flash-next更智能、更快。2张4090下,输出能200 t/s,prefill能到7600 t/s。能耗设置330W,温度不过60,GPU LOAD也能跑满。体感上速度和网络API差不多了

                  kos orK
                  kos orK
                  kos or
                  超凡大师
                  编写于 最后由 编辑
                  #23

                  @he-luo said:

                  2张4090下,输出能200 t/s,prefill能到7600 t/s

                  這速度也太快了 ~ 無話可說了 最佳選擇
                  可能比Cloud API還快,現在的Codex-GPT-Luna 蠻會拖時間的,執行力很消極

                  1 条回复 最后回复
                  0
                  • dardeaw fengD
                    dardeaw fengD
                    dardeaw feng
                    德高望重 劳动模范
                    编写于 最后由 编辑
                    #24

                    我本來也是27B用好一陣子 但Flash Next用過回不去了 速度與知識面差距太大

                    johnnybegoodJ 1 条回复 最后回复
                    2
                    • paul houP
                      paul houP
                      paul hou
                      德高望重 劳动模范
                      编写于 最后由 编辑
                      #25

                      QFN明顯懂的多很多,QFN比較會反復的檢驗確認,新一代的模型都會有這樣的作法。
                      27B就是BUILD會過就是可以交差了。

                      1 条回复 最后回复
                      0
                      • stxpnetS
                        stxpnetS
                        stxpnet
                        超凡大师
                        编写于 最后由 编辑
                        #26

                        有没有这样一种可能,QFN有一定的量化感知能力,或者说作为MOE模型,它的自信心没有27B那么强。
                        导致QFN在对一件事没有把握的时候会反复重新思考,试图激活更多的参数,这样让答案的准确率更高?

                        双卡3090 PCIE 4.0 16X/16X

                        白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                        夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                        paul houP 1 条回复 最后回复
                        0
                        • dardeaw fengD dardeaw feng

                          我本來也是27B用好一陣子 但Flash Next用過回不去了 速度與知識面差距太大

                          johnnybegoodJ
                          johnnybegoodJ
                          johnnybegood
                          超凡大师
                          编写于 最后由 编辑
                          #27

                          @dardeaw-feng 同样的感觉。真的用不回去了。

                          fcmeF 1 条回复 最后回复
                          0
                          • kos orK
                            kos orK
                            kos or
                            超凡大师
                            编写于 最后由 编辑
                            #28

                            以全面性或整體性來說 Qwen Flash Next 的確會考量較多的角度, 比較兩者一些HTML的作品大概可以比較出; 這可能就是知識量大小方面的差異

                            27B 也有它的優勢 以下西洋棋來說 27B 不容易違規, Qwen Flash Next 容易違規

                            1 条回复 最后回复
                            0
                            • stxpnetS stxpnet

                              有没有这样一种可能,QFN有一定的量化感知能力,或者说作为MOE模型,它的自信心没有27B那么强。
                              导致QFN在对一件事没有把握的时候会反复重新思考,试图激活更多的参数,这样让答案的准确率更高?

                              paul houP
                              paul houP
                              paul hou
                              德高望重 劳动模范
                              编写于 最后由 编辑
                              #29

                              @stxpnet
                              qfn的專家做這麼小分這麼散,同一件工作多叫些兄弟來看一下是應該要的,所以我很認同你的想法。

                              1 条回复 最后回复
                              0
                              • A
                                A
                                applejuice
                                技术大牛 劳动模范
                                编写于 最后由 编辑
                                #30

                                我感觉让flash 准备规划 然后dense 执行?

                                kos orK stxpnetS 2 条回复 最后回复
                                1
                                • A applejuice

                                  我感觉让flash 准备规划 然后dense 执行?

                                  kos orK
                                  kos orK
                                  kos or
                                  超凡大师
                                  编写于 最后由 编辑
                                  #31

                                  @applejuice said:

                                  让flash 准备规划 然后dense 执行

                                  這方式 我也覺得不錯 !說不定可以搭配出 不同的效果 👍

                                  A 1 条回复 最后回复
                                  0
                                  • johnnybegoodJ johnnybegood

                                    @dardeaw-feng 同样的感觉。真的用不回去了。

                                    fcmeF
                                    fcmeF
                                    fcme
                                    超凡大师
                                    编写于 最后由 fcme 编辑
                                    #32

                                    @johnnybegood
                                    加一! 体感就比27B好一档,如果预算够的话,弄俩9700来跑这个模型。
                                    现在说是pp能到8000左右TG200左右,那就相当牛逼丝滑了! 更难能可贵的是,这是一个moe模型显卡跑的时候单张功耗只有100多瓦,27b能把显卡干冒烟

                                    A 1 条回复 最后回复
                                    0
                                    • fcmeF fcme

                                      @johnnybegood
                                      加一! 体感就比27B好一档,如果预算够的话,弄俩9700来跑这个模型。
                                      现在说是pp能到8000左右TG200左右,那就相当牛逼丝滑了! 更难能可贵的是,这是一个moe模型显卡跑的时候单张功耗只有100多瓦,27b能把显卡干冒烟

                                      A
                                      A
                                      applejuice
                                      技术大牛 劳动模范
                                      编写于 最后由 编辑
                                      #33

                                      @fcme 那个是strata 才是消耗比较少
                                      如果全在vram 我觉得也是一样

                                      strata 的消耗是跑去cpu了

                                      fcmeF 1 条回复 最后回复
                                      0
                                      • kos orK kos or

                                        @applejuice said:

                                        让flash 准备规划 然后dense 执行

                                        這方式 我也覺得不錯 !說不定可以搭配出 不同的效果 👍

                                        A
                                        A
                                        applejuice
                                        技术大牛 劳动模范
                                        编写于 最后由 编辑
                                        #34

                                        @kos-or 我今天用strata 分配文件检查工作给dense 至少 暂时没什么问题

                                        kos orK 1 条回复 最后回复
                                        0
                                        • A applejuice

                                          @fcme 那个是strata 才是消耗比较少
                                          如果全在vram 我觉得也是一样

                                          strata 的消耗是跑去cpu了

                                          fcmeF
                                          fcmeF
                                          fcme
                                          超凡大师
                                          编写于 最后由 编辑
                                          #35

                                          @applejuice
                                          嗯,不是的,是因为moe模型的计算算力需求没那么高。我以前跑千问的那个80ba3b的模型也是类似的。

                                          1 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组