跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 工控从业者到底是用Qwen3.8 27B模型还是FlashNext?

工控从业者到底是用Qwen3.8 27B模型还是FlashNext?

已定时 已固定 已锁定 已移动 热议 LLM讨论区
16 帖子 13 发布者 228 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • A applejuice

    @wei-Dai 说:

    抡锤者他们玩的什么视频生成、文生图之类的赛道,对我来说就是绝缘的。

    我也是 不搞视频
    视频真的只是玩 基本上没动过

    本地模型是帮助我工作

    Ben LeeB
    Ben LeeB
    Ben Lee
    超凡大师
    编写于 最后由 编辑
    #7

    @applejuice 嗯嗯,我也试过用Flash Next
    驱动,感觉比27B聪明和广一些。我是因为有那个DanielMTP加了24G的(RAM Cache Ram =24G) 做KV缓存,用习惯了。几周前的那个Strata因为只能单slot会话,我实测如果连续输入多个大的长上下文(>32K的文件)就会导致卡顿(cold prefill),用SGLang,或者哪个加了内存缓存的27B就好很多。不过因为我是数据分析需要一直喂数据文件,所以情况特殊,可能别的应用场合差别不大。

    1 条回复 最后回复
    0
    • imbiplaza ASUSI
      imbiplaza ASUSI
      imbiplaza ASUS
      谪仙人
      编写于 最后由 编辑
      #8

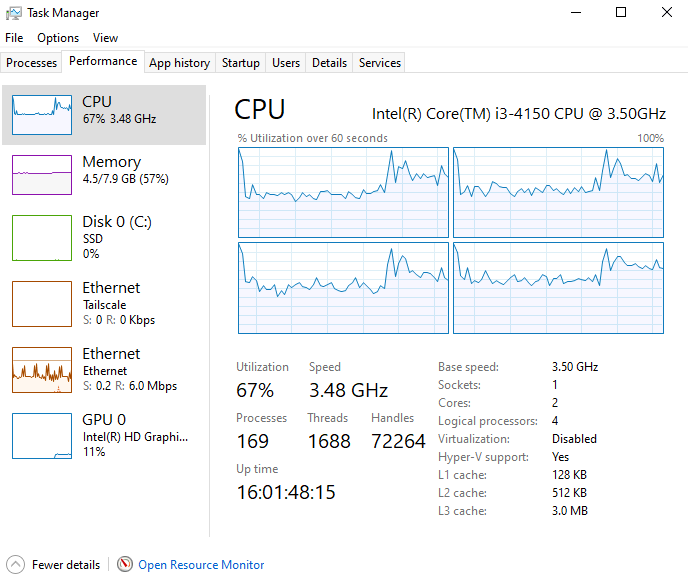
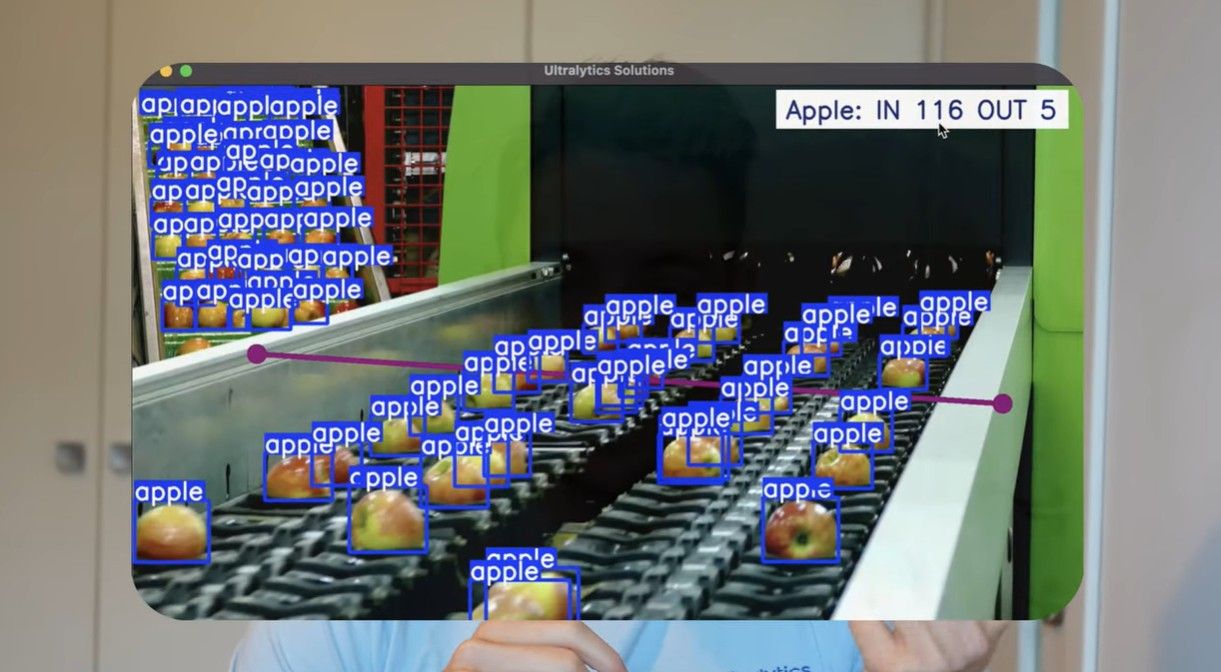
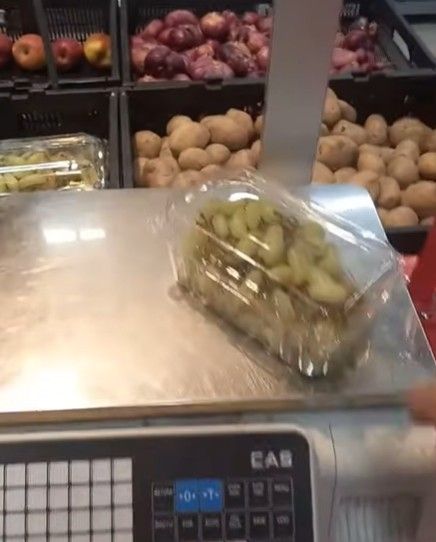
      我也不懂什么叫做工控。。。我的不用什么加速器,单靠十多年前的cpu,使用最新的yolo 去检测。。

      有cuda当然是更好,正叫顾客order rtx 3050 6gb,这种小事情不用用到high end GPU, 我家里的游戏卡刚好是rtx3050 6gb, 实测了才建议顾客去买。。。
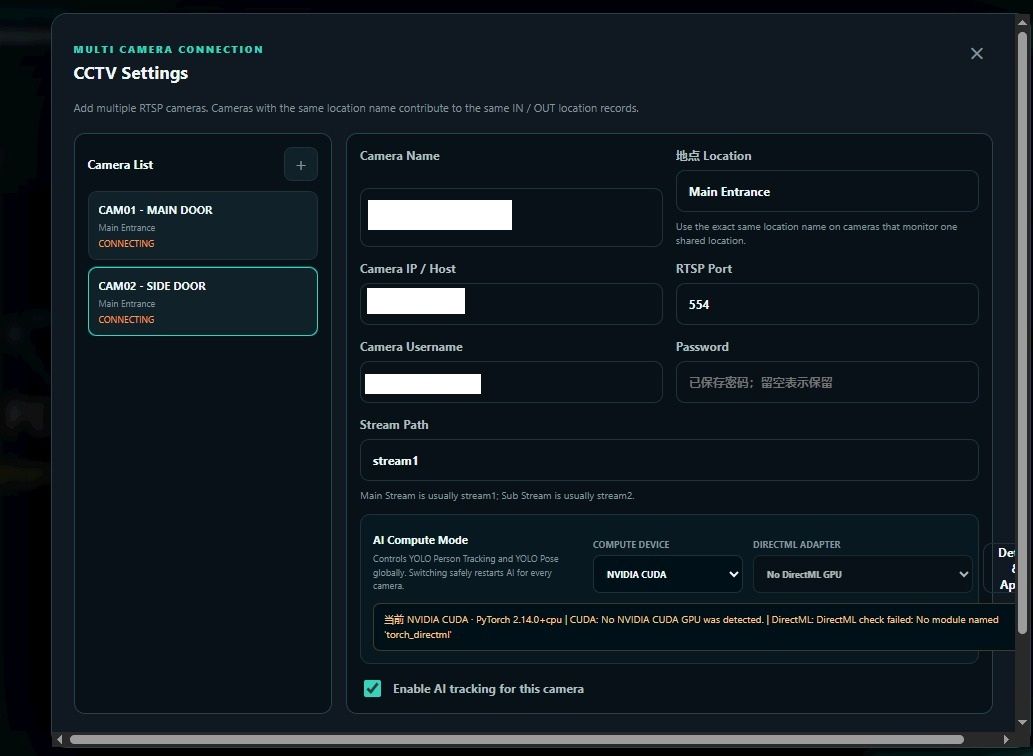
      setting.jpeg

      没有放实际照片,但是这个设计表是呈给顾客的构思,按照设计表去把事情做出来。。
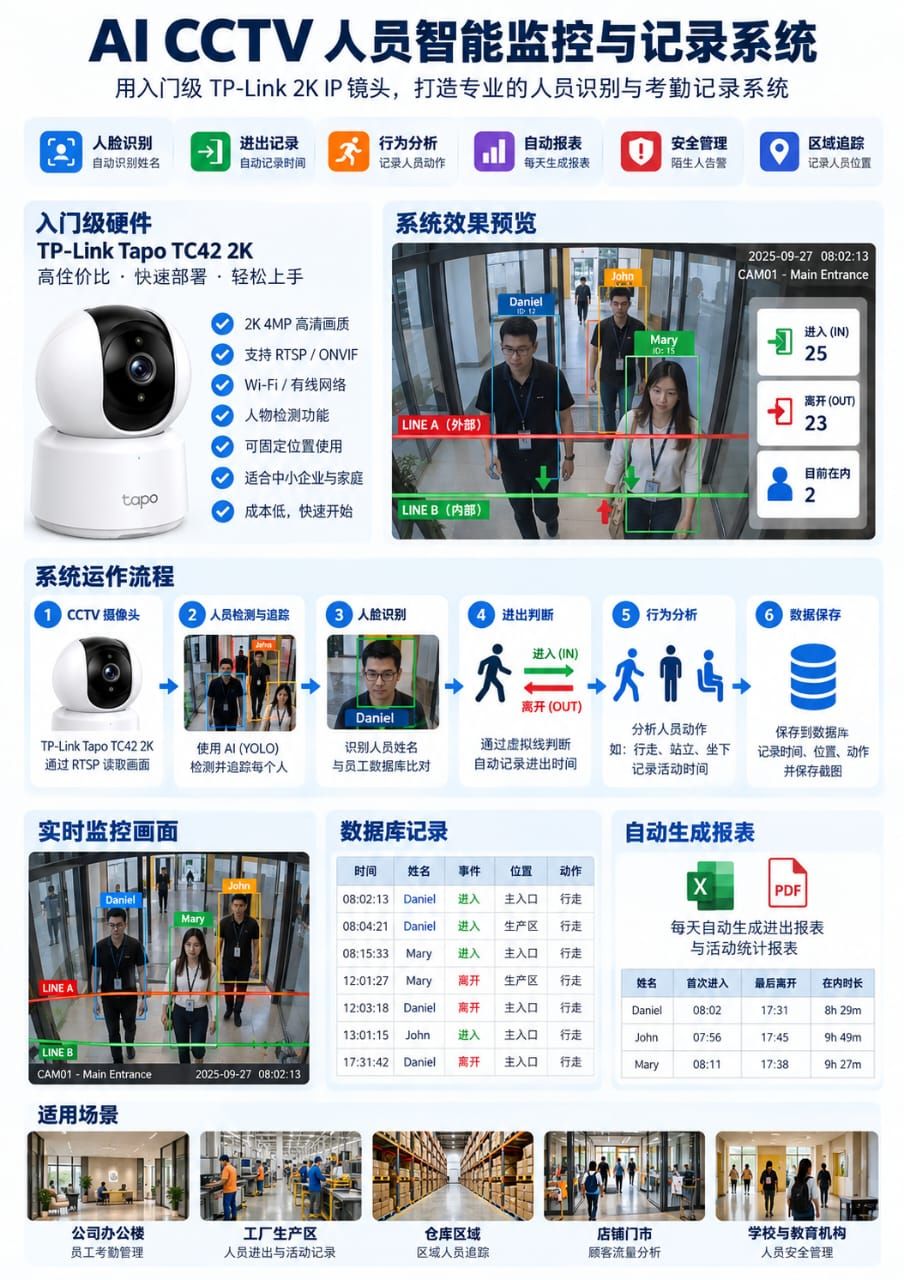
      ai cctv.jpeg

      实际的cpu 运行状态,

      Screenshot 2026-10-12 143129.png

      另外一种就是放在传送带算东西的。。。

      image.jpeg

      还要另外一种是放在秤上

      image.jpeg

      1 条回复 最后回复
      2
      • stxpnetS
        stxpnetS
        stxpnet
        超凡大师
        编写于 最后由 编辑
        #9

        我以前也说过,MOE就是文科生,擅于发散思维,写产品需求,写文案比较厉害 。 DENSE是理科生,像数学家一样冷酷(温度调0.6以下),擅长抽象思维,把需求转成冰冷的代码(1就是1,2就是2 )。 如果相互去做对方的事情,肯定比不过对方 (同样算力,差不多调校的模型做对比) 。

        双卡3090 PCIE 4.0 16X/16X

        白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
        夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
        1 条回复 最后回复
        4
        • Ben LeeB Ben Lee

          我也发现相同的问题,27B和Flash Next各有利弊,27B还快些。我数据分析的活儿比较多,用27B做初稿,然后又Flash Next复核,确实能发现问题,多花时间但是得到了保障。 另外, Flash Next的图表做的比27B好。期待看看4.0 27B出来会是什么表现

          terryT
          terryT
          terry
          超级版主
          编写于 最后由 terry 编辑
          #10

          @Ben-Lee
          4.0 27B绝对是一场狂欢。4.0 Flash不确定什么时候发,27B是官宣。

          油管:https://www.youtube.com/@抡锤者

          rock shiR 1 条回复 最后回复
          1
          • shro11S
            shro11S
            shro11
            编写于 最后由 编辑
            #11

            MOE模型天生有缺陷,快是有代价的,看怎么扬长避短

            1 条回复 最后回复
            0
            • terryT terry

              @Ben-Lee
              4.0 27B绝对是一场狂欢。4.0 Flash不确定什么时候发,27B是官宣。

              rock shiR
              rock shiR
              rock shi
              德高望重 劳动模范
              编写于 最后由 编辑
              #12

              @terry 10月底,马上了。激动的心颤抖的手

              主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
              副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

              1 条回复 最后回复
              0
              • zzz zzZ
                zzz zzZ
                zzz zz
                编写于 最后由 编辑
                #13

                同样工控行业,没你玩的那么高深。

                1 条回复 最后回复
                0
                • XiaoteX
                  XiaoteX
                  Xiaote
                  编写于 最后由 编辑
                  #14

                  🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                  奖励凭证:热议 +3 分 · 编号 h2275-4308-1(系统自动发放,显示稍有延迟)

                  老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                  1 条回复 最后回复
                  0
                  • E
                    E
                    exllm
                    德高望重
                    编写于 最后由 编辑
                    #15

                    个人体验 QFN 挺好的, 27B 上下文长就很慢

                    1 条回复 最后回复
                    0
                    • fcmeF
                      fcmeF
                      fcme
                      超凡大师
                      编写于 最后由 编辑
                      #16

                      现在的大模型本质上是基于概率预测的,所以你如果不限定格式输出的话,永远得不到一样的答案。肯定会有出错的地方,这个你用云端模型也没有办法避免。我本职也是做工程的,我自己用的体验就是倾向于让他们先结构化的那个输出内容生成文件,因为这个在agent时代是很好做的,然后后续如果有新的输出,就让他修改文件就可以了,因为这样的话相当于给他的输出给了一个框架,这样你得到的东西就是确定性的。
                      当然玩的更高级的,比如说像那种嗯有些需要用到数据库的,那就更方便了,先把数据库里面相应的数据填充了,然后再做一套校验的系统就可以了,不管是用脚本也好,软件也好,这个就得你自己发挥了,反正思路的话,个人用下来大致是这么个思路。

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组