電腦的HERMES讀取GB10的模型
-
-
-
你把跑Hermes的那台机器配好到4台GB10的 ssh key. 然后告诉它直接去安装. 它应该就可以搞定. 安装的时候, 让Hermes用个聪明一点儿的在线模型, 确保长线任务的稳定性.
至于去审查版本, 你让Hermes上网去查, 找适合你配置的, 评价比较高的版本, 也上网去找安装方法做参考.
总之, 直接交给Hermes, 应该能行.
-
-
@Tony-Wang 您好,我的HERMES沒有雲端模型,用Codex跟Claude桌面板可以嗎?
該怎麼跟他說呢?謝謝@Tony-Wang 您好,我的HERMES沒有雲端模型,用Codex跟Claude桌面板可以嗎?
該怎麼跟他說呢?謝謝原则上也可以, 不过codex和claude缺省对本地操作的限制很多. 直接操作你的机器有点儿麻烦.
你去买一点儿Deepseek的api token, 100-200元人民币, 把它配置到你的hermes的模型里面. 就够用很久了. 我上次用Hermes+deepseek v4 flash 给我安装SGlang Qwen3.8 27B, 一共用了1.7元 RMB. 日常的轻量级任务, 还是用 Hermes+本地llm, 节省费用.
下面是Hermes+27B 自动生成, 供你参考, 你把下面的内容, 和任务书, 丢给Hermes.
配置:
Hermes 支持 OpenAI 兼容接口,在模型面板里加一个自定义 provider——base URL 填
https://api.deepseek.com/v1,模型填deepseek-flash,key 填你的 API key。顺便说一句,deepseek-flash就是你想要本地跑的那个模型:DeepSeek-V4.1-Flash-1017,支持 tool calls,跑这种长 agent 任务正合适。配好之后,你跟 Hermes 这么说(把 4 个 IP 填上):
我有 4 台 GB10,IP 分别是 ×××、×××、×××、×××,我需要把它们 4 台串起来部署 DeepSeek-V4.1-Flash。按我给你的任务书执行:每一步把进度写进 task-log.md,断线了能接着跑。
要点:
- 前置检查:Hermes 主机到 4 台 GB10 的免密 ssh、环形线已布好、有可用在线模型 API——缺一项就停下来报,不许猜
- 阶段一: 强制先调研后动手:官方渠道核实参数/精度/未审查版、算 512GB 装不装得下、找 GB10 多机最新 recipe(NCCL 环形 + 推理框架选型),出 plan.md 给主人过目
- 阶段二/三:逐机盘点 → 安装 → 下载模型 → nccl-tests 验证带宽 → 起服务 → 真实请求验收 + 确认 4 台都参与 + 记性能数字
- 红线:重启/清数据先问、不自己花钱、每步写 task-log.md 可断点续跑、实测不了就如实报不许编
任务书:
-
又让 Hermes 上网查了, 补两个问题的答案. 这部分内容, 你也给你的Hermes.
1. 去审查版, 有.
最对口 1017 的:
dealignai/DeepSeek-V4.1-Flash-1017-UNCENSORED-FP8: 就是 1017 官方 checkpoint 做的权重级 abliteration (逐层消融拒绝方向), 非量化衍生, 非 jailbreak, 非 LoRA, 和官方版权节兼容 — 能加载官方版的就能加载它. 510GB, FP8+FP4, 1M 上下文, 视觉 / 工具 / 思考档位都保留, MMLU 掉 3.86pp. Gated repo, Hermes 要先申请一下权限.AtomicChat/DeepSeek-V4.1-Flash-1017-Uncensored-GGUF: 同一套消融打进 GGUF (3.58bpw 磁盘约 335GB), 还附带一个 rank-1 LoRA adapter — 挂在任意 1017 GGUF 上就有去审查效果. 需要带 V4.1 支持的 llama.cpp (unsloth full-stack pin, 上游还没合并).
基础版 (9 月版) 的去审查版下载量最大的是
dealignai/DeepSeek-V4.1-Flash-UNCENSORED-FP8(51.4K 下载).2. 4 台 + 无交换机环接, 有现成 recipe.
NVIDIA 官方论坛上的
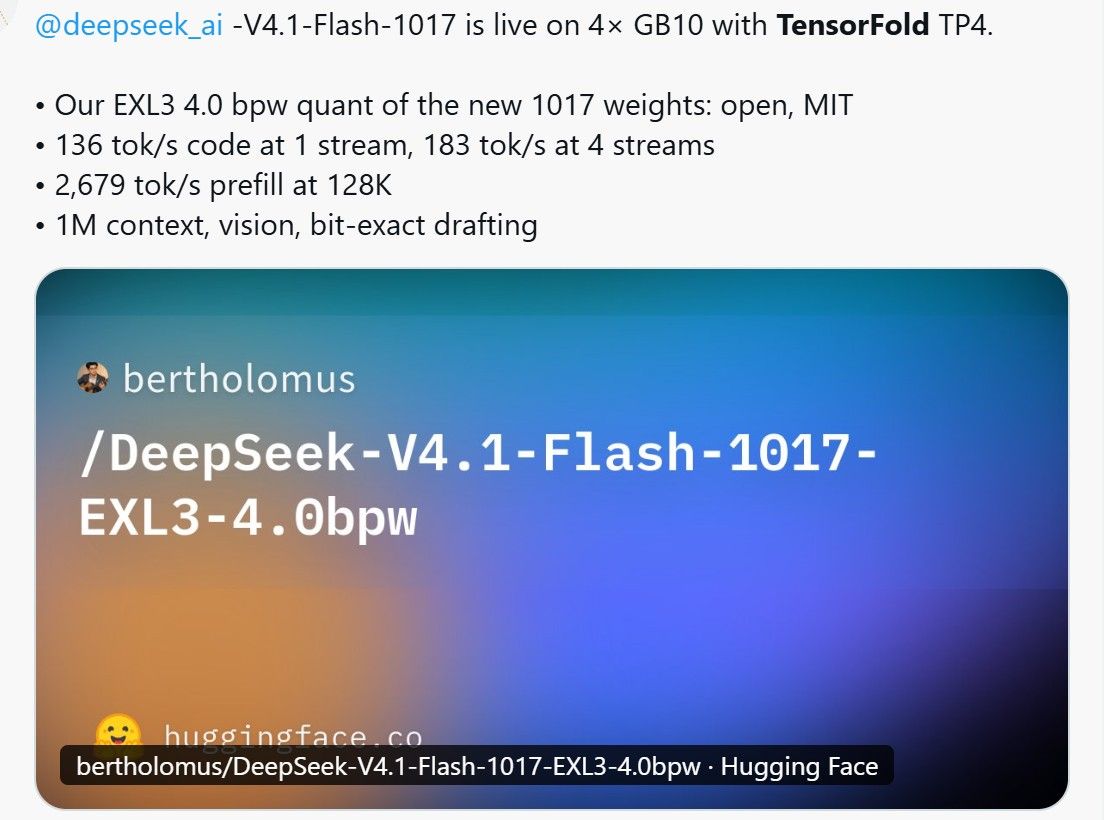
christopherowen/spark-ds41f, 正好就是你这台配置: vLLM, 4×Spark TP4 环接, all-to-all 自动绕开无交换机的环形拓扑, 生产环境就在跑 DeepSeek-V4.1-Flash-1017, 1M 上下文, 16 并发序列. 任务书第一阶段的"找最新 recipe", 让它从这个 repo 起手.选去审查版要注意:
- 原生 FP8 是 510GB, 光权重就快吃完 4×128GB, KV cache 很紧. 想要宽裕看量化去审查版 (EXL3 2.9bpw 约 270GB, 或上面的 GGUF).
- 第三方权重产物: 下载后校验完整性, 隔离环境跑.
- 去审查后没有安全兜底, 输出全是你自己的责任.
- MMLU 掉约 4pp, 是去审查的代价, 可接受.
-
@Tony-Wang 太感謝您了,我自己都不知道該怎麼問AI,
我把你說的全部餵給HERMES試試,謝謝 -
-
-
-
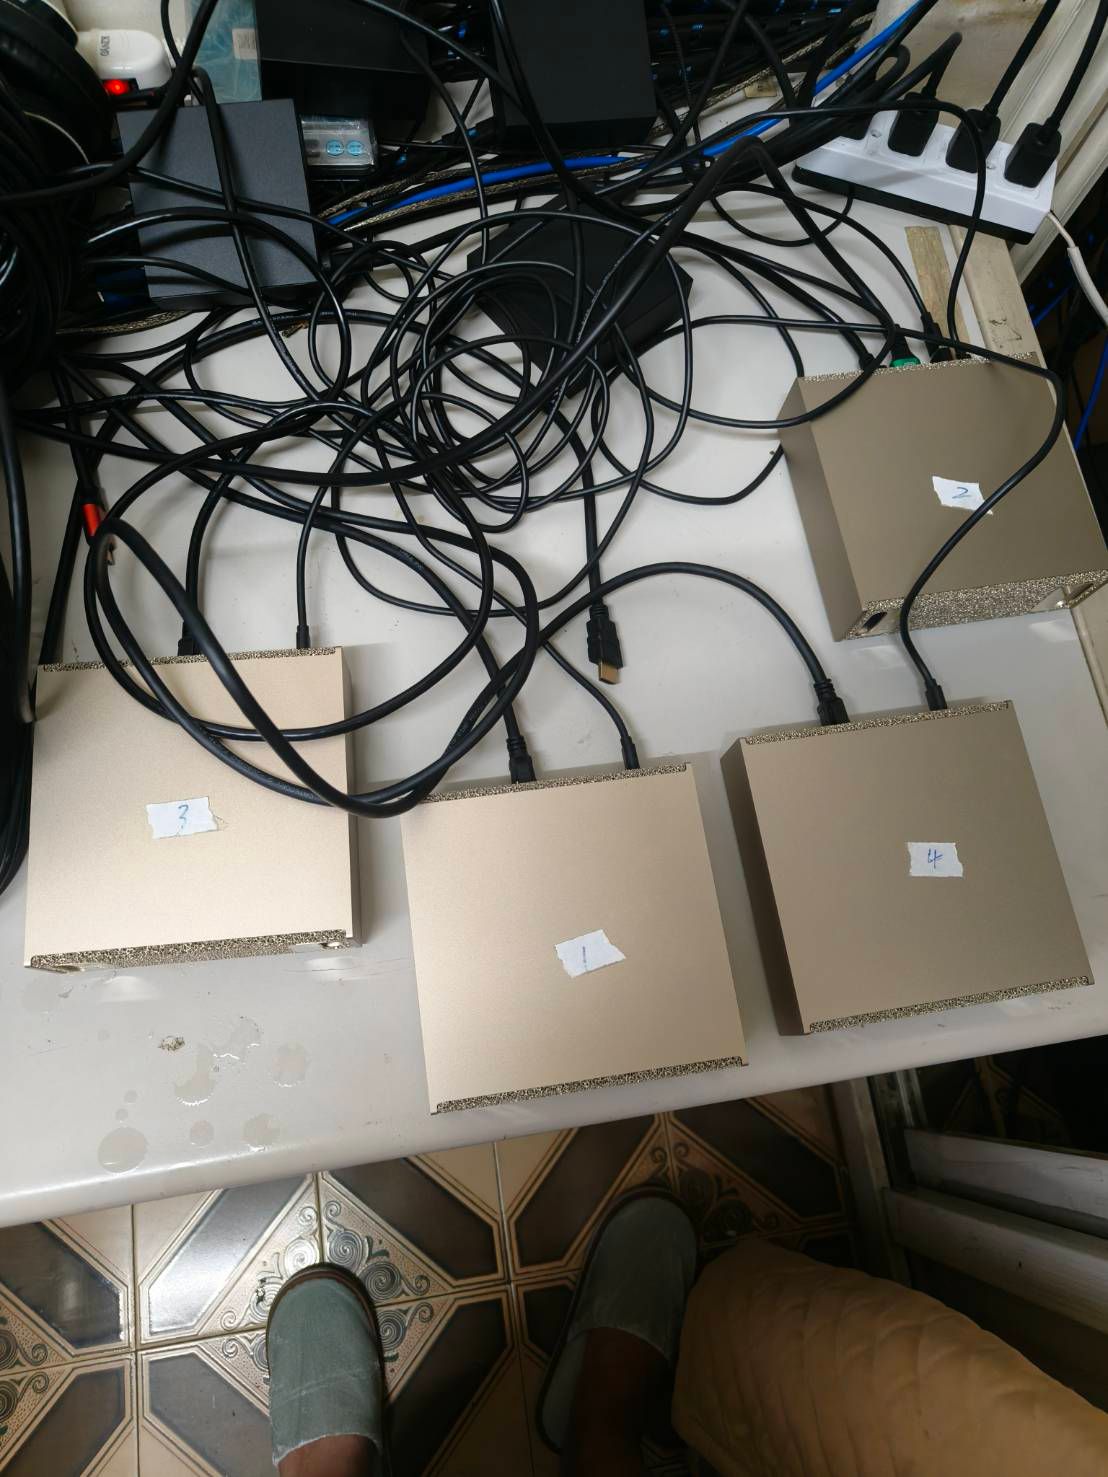
忙了一天,終於把4台的基本安裝設定好了,
請問各位前輩,
接下來要下載哪一個版本的deepseek v4 1 flash 1017
比較適合4台串聯呢?這一版的有無審查版本了嗎?
我想透過電腦的HERMES來讀取4台GB10的模型
有這方面的實例可以參考嗎?
謝謝大家
-
-
,
G gao Gao 引用了 此主题
-
其实,
- 你只要多跟AI聊天, 把你的情况, 你想做什么告诉它, 让它上网搜索, 核实, 并给你相应的方案.
- 然后把相应的方案给Agent, 让它再细化一遍. 最后再让Agent去执行.
- 长线的复杂任务, 最好让在线模型去执行, 它们的上下文比较长, 跑起来不容易出错. 智力也会高一点点.
@Tony-Wang 我哥你说什么都对,你是社区哲学家,科学家是我弟 @imbiplaza-asus 。
你俩一个是社区康德,一个是社区达文西。
卧龙凤雏皆不世之材,得一可安天下,兄弟我看来是要发家了。