
【交作业】双 7900 XTX跑Strata IQ3_S:262K实测,Prefill 5,147 tok/s 可抄作业
-
写此文章受到【双 R9700 折腾记】从 Strata 到 Radiance 的启发,Radiance不支持7900XTX,经过查询作者有意加入但是无具体交付时间,所以只有使用strata 多卡分层技术了。
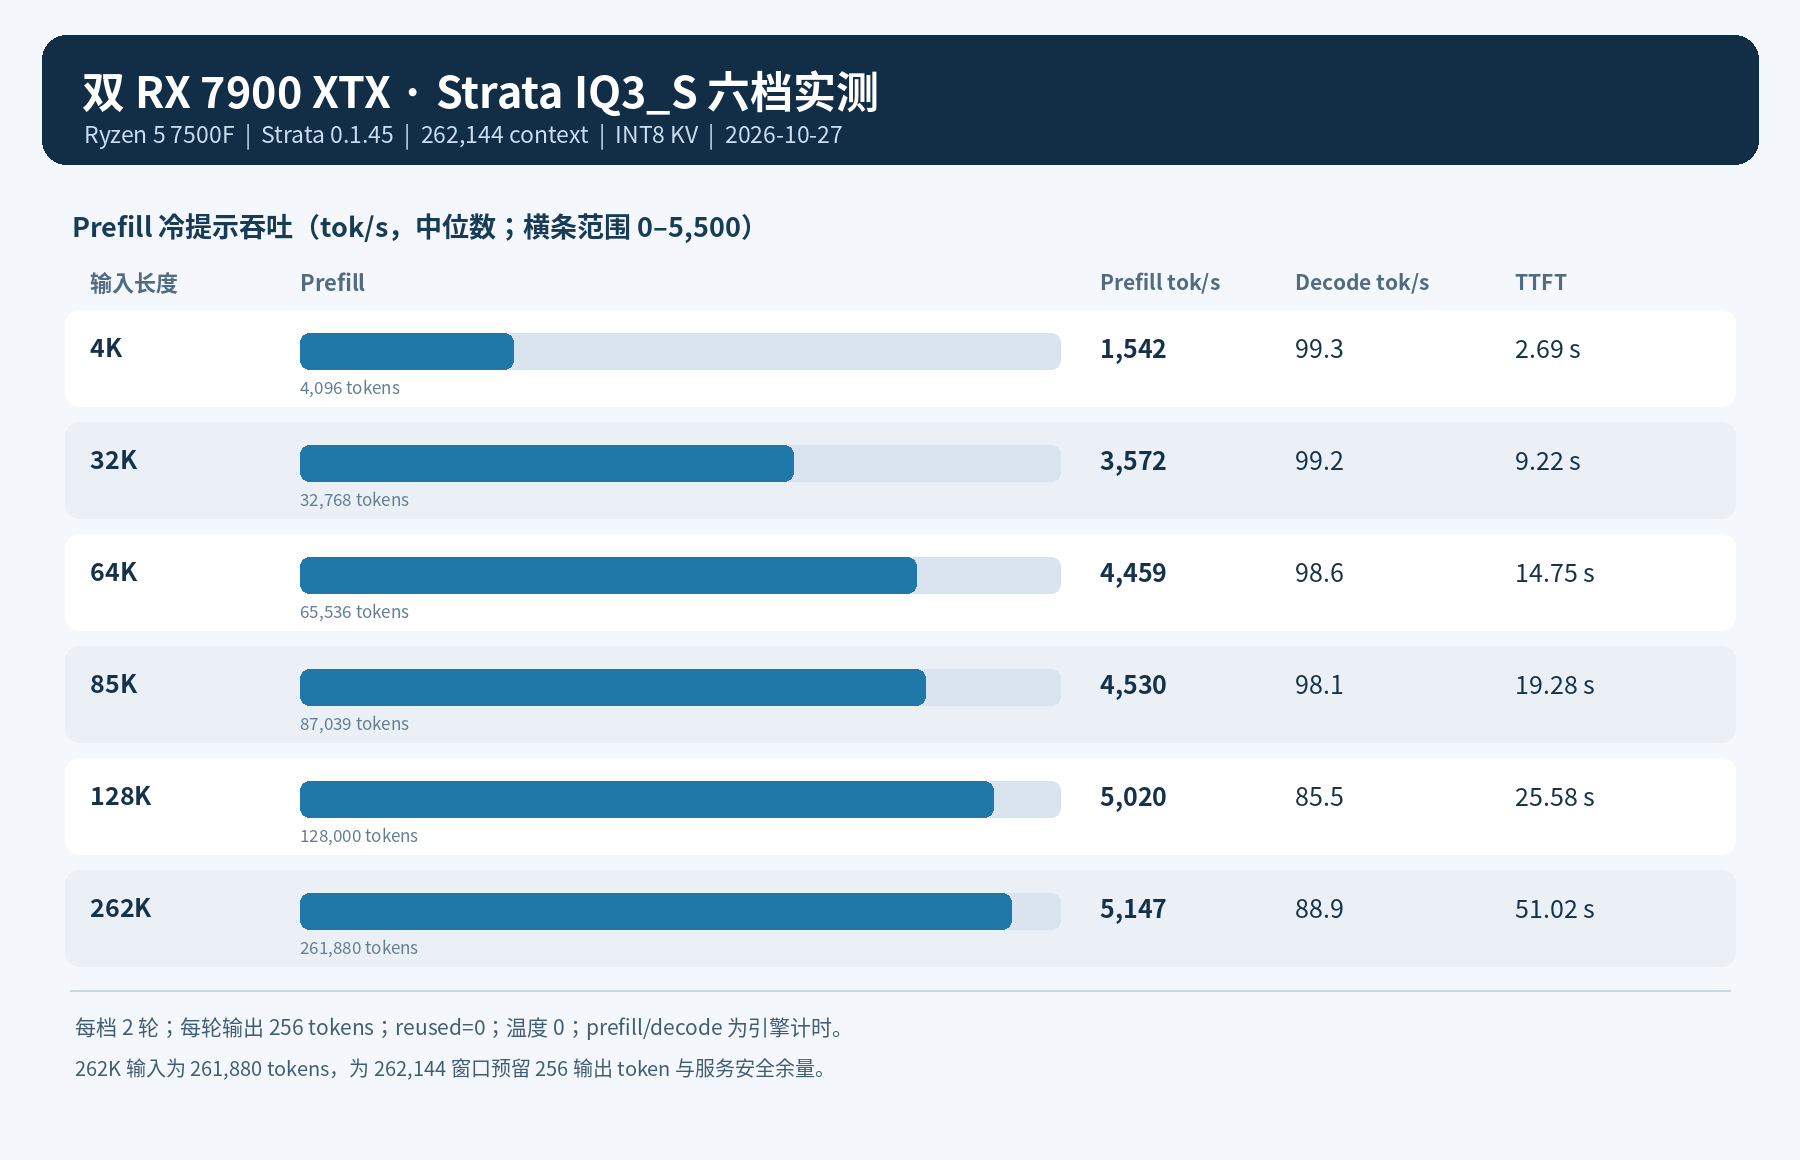
主机是 Ryzen 5 7500F + 双 RX 7900 XTX,Strata 0.1.45,Qwen3.8-Flash-Next GSQ-RCO IQ3_S。固定 262K context,分别测六档冷提示;每档 2 轮、每轮输出 256 token,提示缓存命中为 0。下列数值取中位数。
六档速度
 4K:Prefill 1,542 tok/s · Decode 99.3 tok/s · TTFT 2.69 秒
- 32K:Prefill 3,572 tok/s · Decode 99.2 tok/s · TTFT 9.22 秒
- 64K:Prefill 4,459 tok/s · Decode 98.6 tok/s · TTFT 14.75 秒
- 85K:Prefill 4,530 tok/s · Decode 98.1 tok/s · TTFT 19.28 秒
- 128K:Prefill 5,020 tok/s · Decode 85.5 tok/s · TTFT 25.58 秒
 262K:Prefill 5,147 tok/s · Decode 88.9 tok/s · TTFT 51.02 秒
测试配置
CPU: Ryzen 5 7500F
GPU: RX 7900 XTX × 2 (gfx1100), HIP, layer split 24
RAM: 96 GB
Strata engine: 0.1.45
Model: Qwen3.8-Flash-Next GSQ-RCO IQ3_S
Context: 262144
Prefill: 16384
KV: INT8, kv-resident 20480
VRAM reserve: 2048 MiB
Expert cache: auto; pipeline windows: 2
MTP: spec 3, spec-min-p 0.5, suffix-draft 4
Threads: 8
hipBLASLt: gfx1100 100401 tuning table calibrated for 16K prefill
环境变量:
STRATA_STAGE_TRIM=1
STRATA_PCIE_AUTO_SPLIT=1
STRATA_PF_FUSED=1
STRATA_PF_GEMM=1
STRATA_GDN_CHUNKED=1
STRATA_HIP_WMMA=1
STRATA_SCORES_THREAD=1
STRATA_SELECT_SIMT=1
STRATA_HIPBLASLT_TUNING=/path/to/gfx1100-hipblaslt-100401-262k.txt
262K Prefill 调优对照
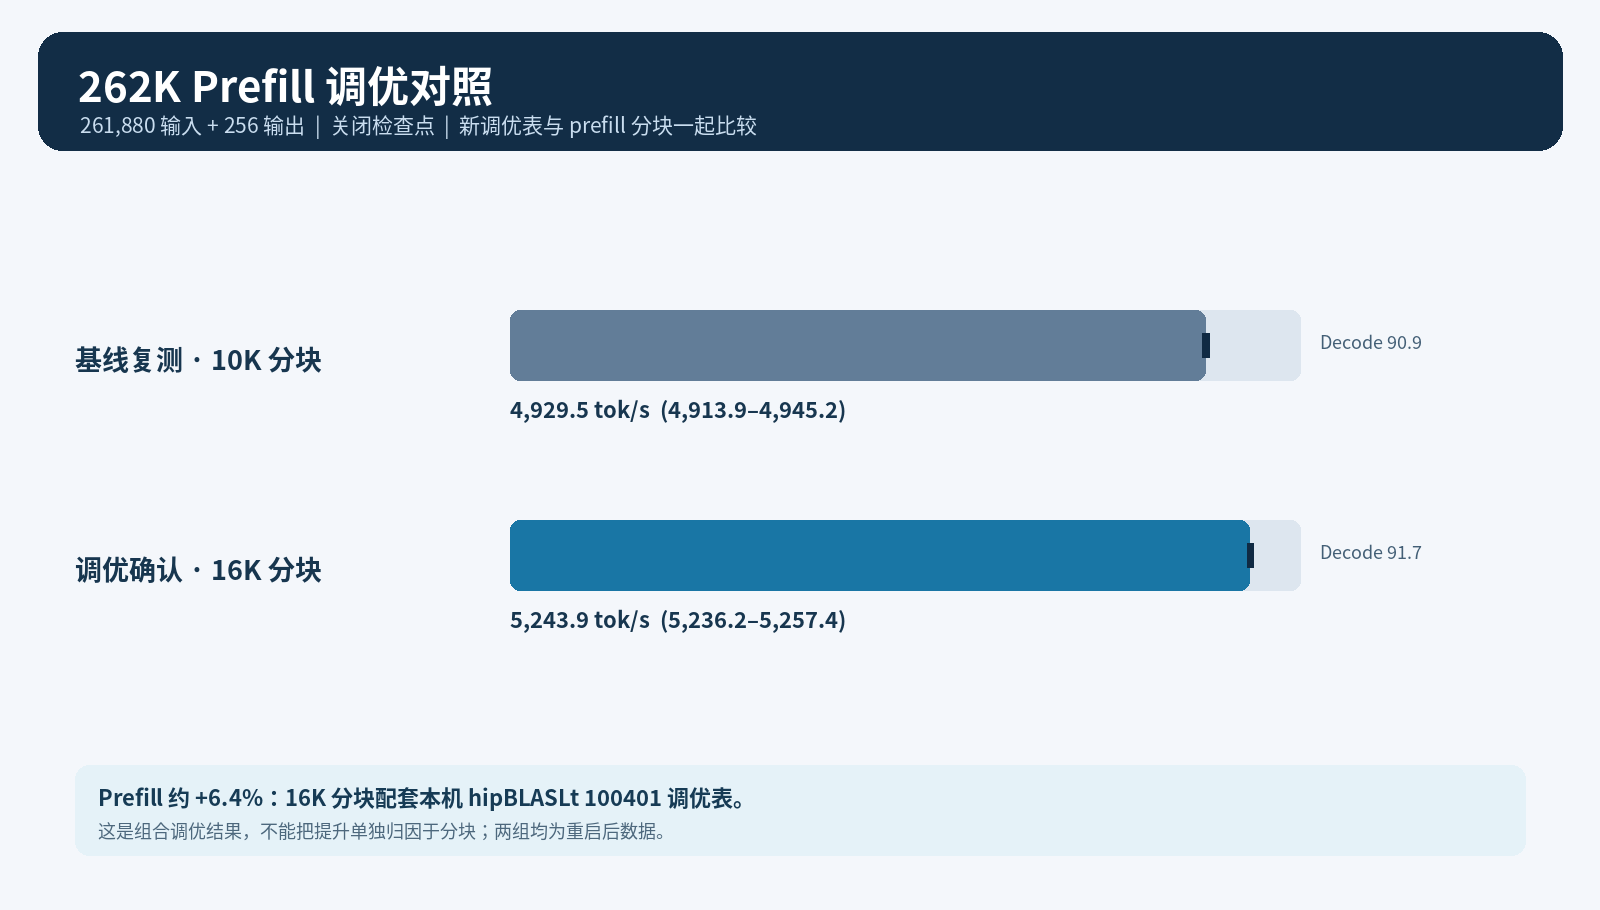
固定 261,880 输入 + 256 输出、关闭检查点:10K 分块基线重启复测为 4,929.5 tok/s;16K 分块配套校准表重启确认 5,243.9 tok/s,约提升 6.4%。这是组合调优结果,不能单独归因于分块。日常配置保留 2 GiB 显存预留;1 GiB 只快约 0.7%,但加载后总余量约 1,006 MiB。
测试环境为 Ubuntu 24.04.5、HIP 7.14.60850。以上是单机实测。欢迎贴 Strata 版本、KV、prefill、显存预留和原始复测数据交流。
双 7900 XTX:模型本地跑,Token 随便烧!
-
写此文章受到【双 R9700 折腾记】从 Strata 到 Radiance 的启发,Radiance不支持7900XTX,经过查询作者有意加入但是无具体交付时间,所以只有使用strata 多卡分层技术了。
主机是 Ryzen 5 7500F + 双 RX 7900 XTX,Strata 0.1.45,Qwen3.8-Flash-Next GSQ-RCO IQ3_S。固定 262K context,分别测六档冷提示;每档 2 轮、每轮输出 256 token,提示缓存命中为 0。下列数值取中位数。
六档速度
- 4K:Prefill 1,542 tok/s · Decode 99.3 tok/s · TTFT 2.69 秒
- 32K:Prefill 3,572 tok/s · Decode 99.2 tok/s · TTFT 9.22 秒
- 64K:Prefill 4,459 tok/s · Decode 98.6 tok/s · TTFT 14.75 秒
- 85K:Prefill 4,530 tok/s · Decode 98.1 tok/s · TTFT 19.28 秒
- 128K:Prefill 5,020 tok/s · Decode 85.5 tok/s · TTFT 25.58 秒
- 262K:Prefill 5,147 tok/s · Decode 88.9 tok/s · TTFT 51.02 秒
测试配置
CPU: Ryzen 5 7500F
GPU: RX 7900 XTX × 2 (gfx1100), HIP, layer split 24
RAM: 96 GB
Strata engine: 0.1.45
Model: Qwen3.8-Flash-Next GSQ-RCO IQ3_S
Context: 262144
Prefill: 16384
KV: INT8, kv-resident 20480
VRAM reserve: 2048 MiB
Expert cache: auto; pipeline windows: 2
MTP: spec 3, spec-min-p 0.5, suffix-draft 4
Threads: 8
hipBLASLt: gfx1100 100401 tuning table calibrated for 16K prefill
环境变量:
STRATA_STAGE_TRIM=1
STRATA_PCIE_AUTO_SPLIT=1
STRATA_PF_FUSED=1
STRATA_PF_GEMM=1
STRATA_GDN_CHUNKED=1
STRATA_HIP_WMMA=1
STRATA_SCORES_THREAD=1
STRATA_SELECT_SIMT=1
STRATA_HIPBLASLT_TUNING=/path/to/gfx1100-hipblaslt-100401-262k.txt
262K Prefill 调优对照
固定 261,880 输入 + 256 输出、关闭检查点:10K 分块基线重启复测为 4,929.5 tok/s;16K 分块配套校准表重启确认 5,243.9 tok/s,约提升 6.4%。这是组合调优结果,不能单独归因于分块。日常配置保留 2 GiB 显存预留;1 GiB 只快约 0.7%,但加载后总余量约 1,006 MiB。
测试环境为 Ubuntu 24.04.5、HIP 7.14.60850。以上是单机实测。欢迎贴 Strata 版本、KV、prefill、显存预留和原始复测数据交流。
@懒人烘培 兄弟你好香。
咱俩的硬件配置相当,你的作业我可以闭眼抄 -
@懒人烘培 兄弟你好香。
咱俩的硬件配置相当,你的作业我可以闭眼抄 -
-
这数字绝对啊,XTX你不是双卡吗我弟,你去测试下这个帖子啊:https://lcz.me/topic/2582
我就等着你的数据水视频了。 -
希望能有单卡优化的方法
-
这数字绝对啊,XTX你不是双卡吗我弟,你去测试下这个帖子啊:https://lcz.me/topic/2582
我就等着你的数据水视频了。 -
@懒人烘培 赶紧的,就等你和 @xiongjie-gao 了,我先水一期,留个悬念。

-
@懒人烘培 赶紧的,就等你和 @xiongjie-gao 了,我先水一期,留个悬念。
-
-
-
-
@Enigma 是呀,@xiongjie-gao 作业抄得如何?
-
-
@Enigma 是呀,@xiongjie-gao 作业抄得如何?
@懒人烘培 你把我的预设打破了,你这双并发的数据比我两组两槽四并发的方案好太多,我都怀疑我这边的调教空间了。
所以多做了几组方案的优化,事实证明是我贪了。超预期那波提升是你的CPU承担了部分MOE的计算工作。但你这数据是有干货的。
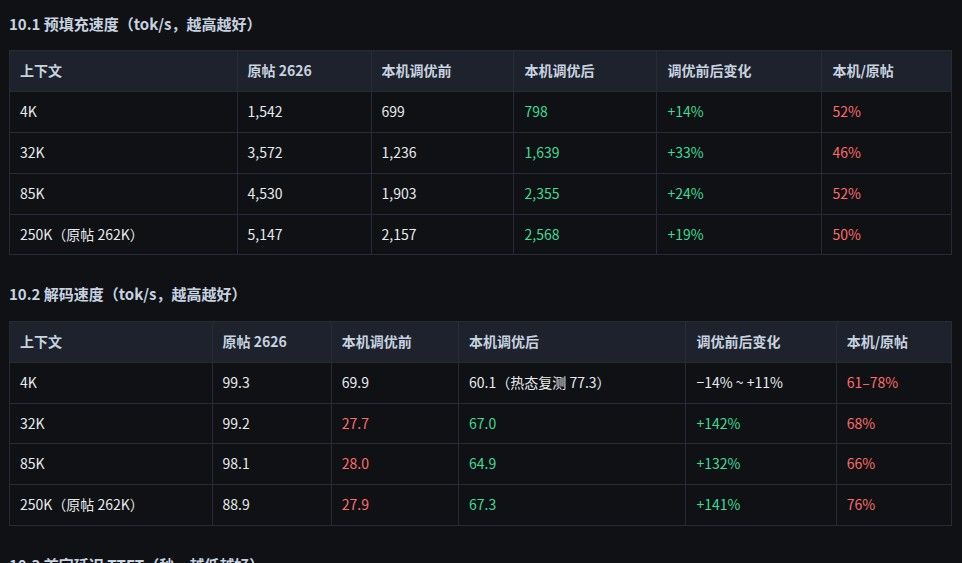
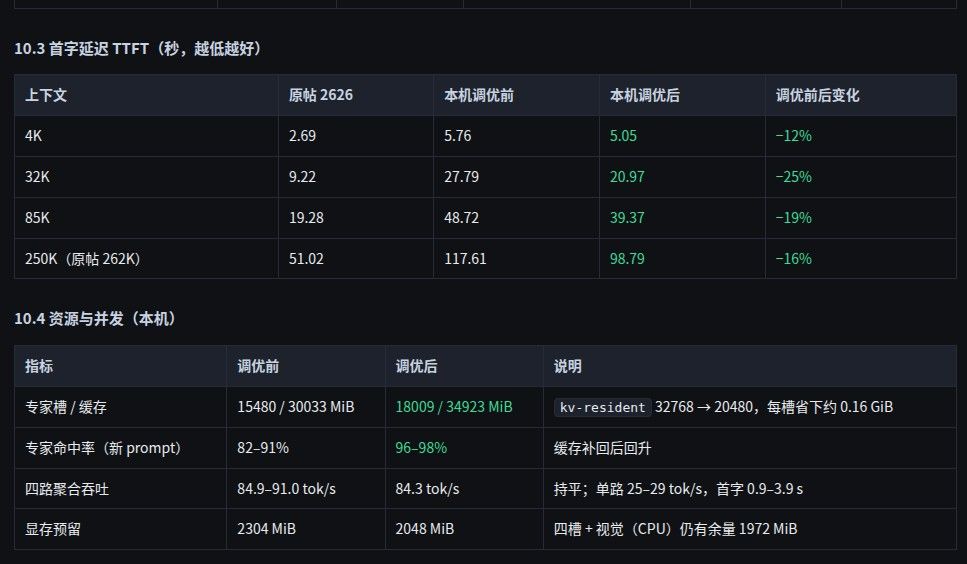
基本结论是以15%左右的TTFT延时,取得40%左右的关键数据提升。这生意是挣的
日子也是好起来,从最初未优化40token/s到现在90+,仍觉得还有优化的空间。 -
@懒人烘培 你把我的预设打破了,你这双并发的数据比我两组两槽四并发的方案好太多,我都怀疑我这边的调教空间了。
所以多做了几组方案的优化,事实证明是我贪了。超预期那波提升是你的CPU承担了部分MOE的计算工作。但你这数据是有干货的。
基本结论是以15%左右的TTFT延时,取得40%左右的关键数据提升。这生意是挣的
日子也是好起来,从最初未优化40token/s到现在90+,仍觉得还有优化的空间。 -
@terry 刚刚又研究了一下博主文章他这个用得是Radiance 只支持RDNA4,不支持RDNA3,问了gpt也是这样的结论。如果一定要用,需要自行补齐 RDNA3 内核支持。我也开始尝试移植,看能否成功
-
@懒人烘培 可以跑,W7900已经跑通了,它实际上就是7900XTX 48G,你让Agent研究下。主要不是跑起来,而是整个流程的效率提升。目前看测试是单步提升很大,但是总体上只快了一半。
-
-
github上看到了这个https://github.com/nicejunjie/Strata-rdna3,作者好像就是AMD的人,双7900xtx prefill能干到6000+了




