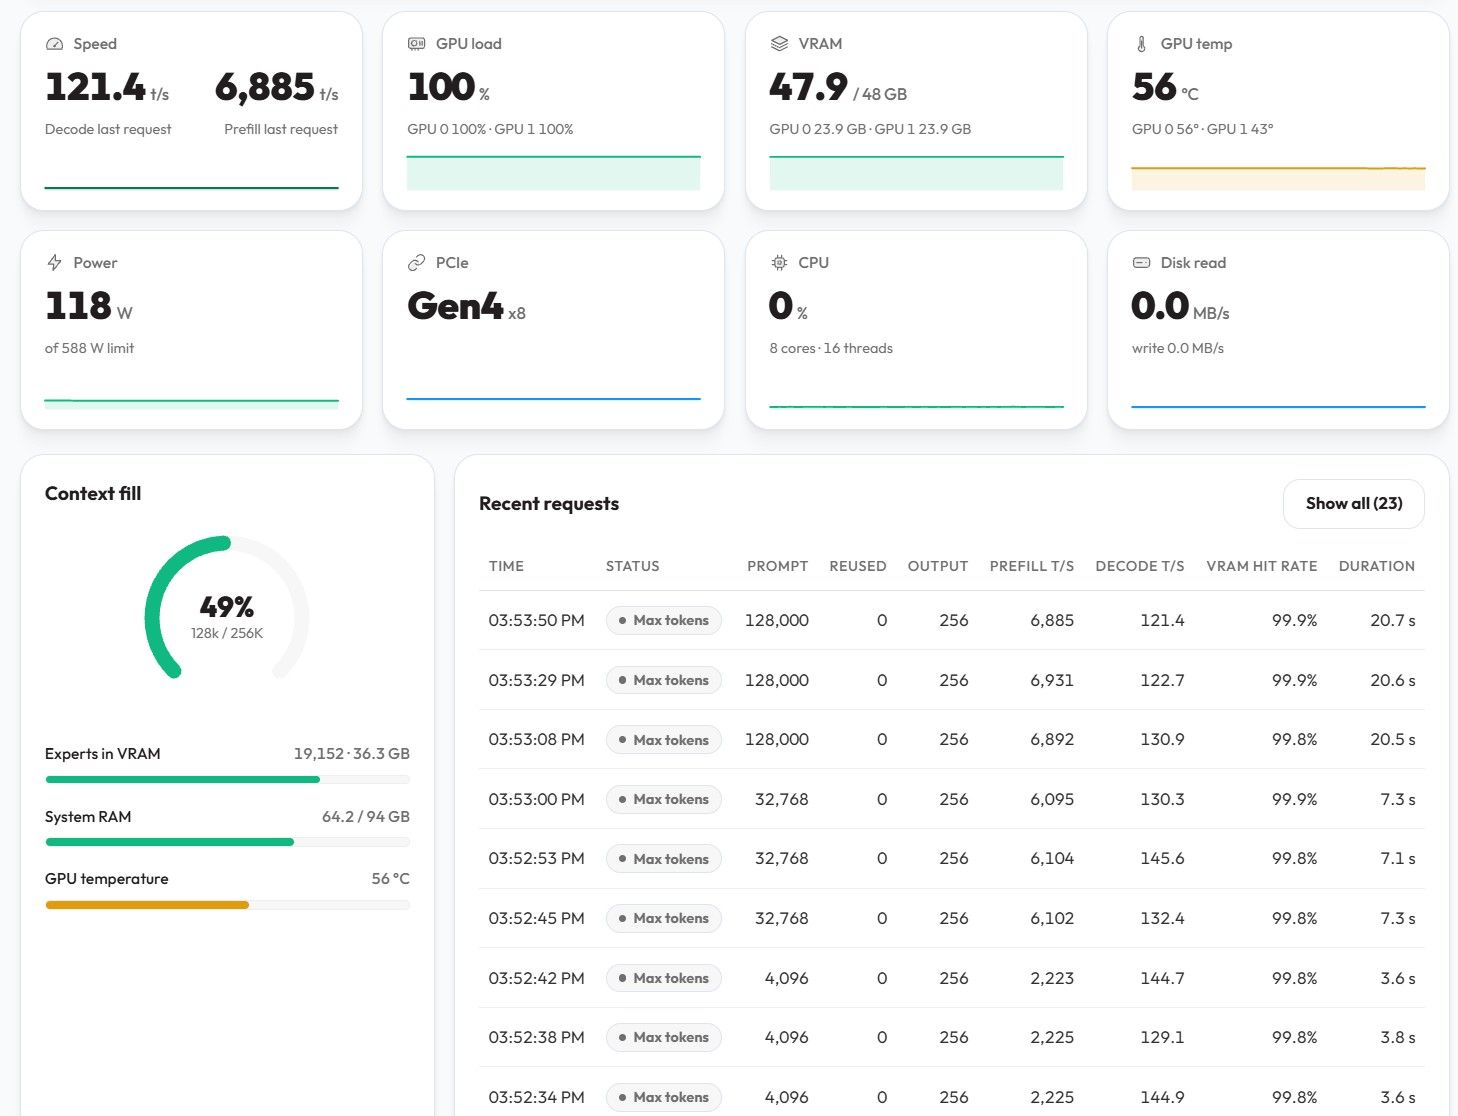
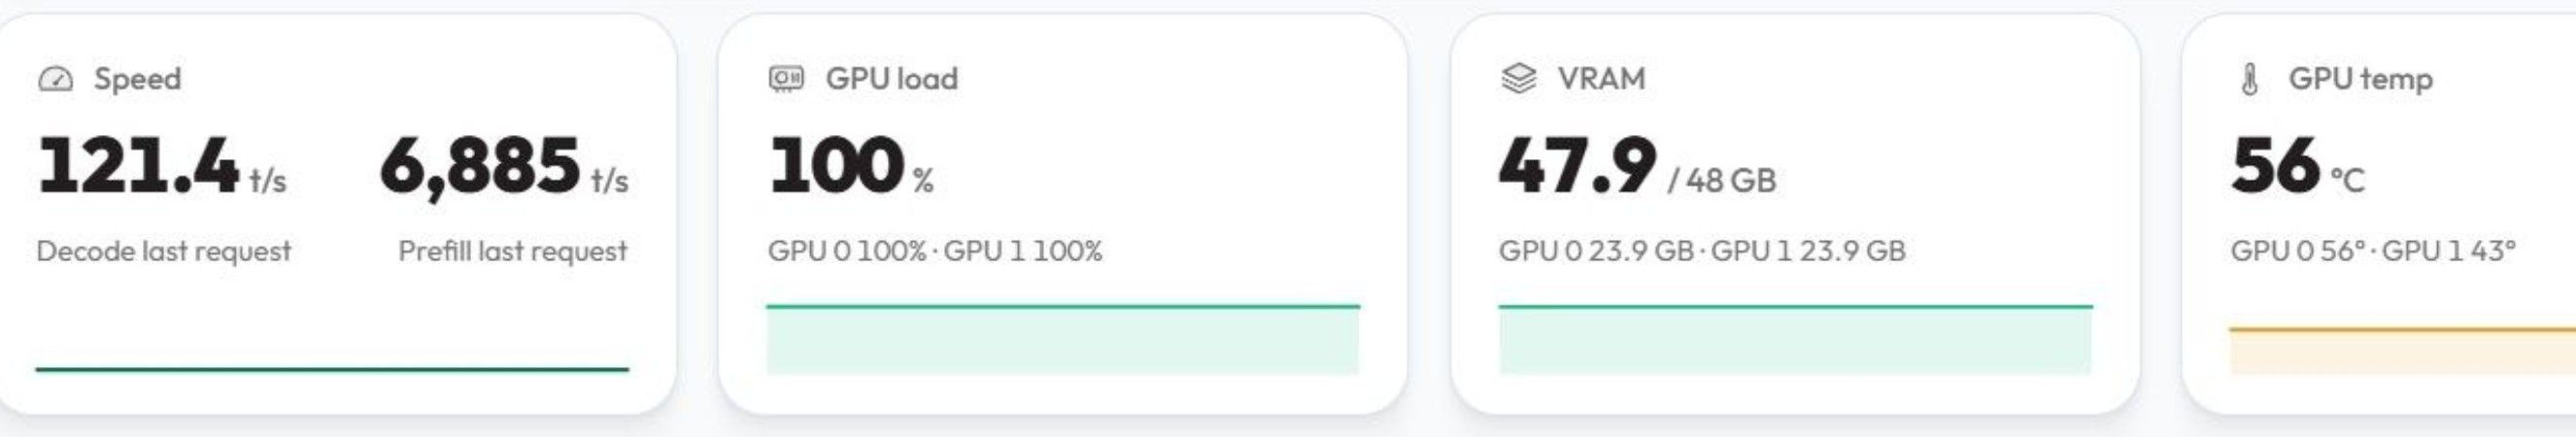
【交作业】双 7900 XTX跑Strata IQ3_S:262K实测,Prefill 5,147 tok/s 可抄作业
-
-
@Enigma 是呀,@xiongjie-gao 作业抄得如何?
@懒人烘培 你把我的预设打破了,你这双并发的数据比我两组两槽四并发的方案好太多,我都怀疑我这边的调教空间了。
所以多做了几组方案的优化,事实证明是我贪了。超预期那波提升是你的CPU承担了部分MOE的计算工作。但你这数据是有干货的。
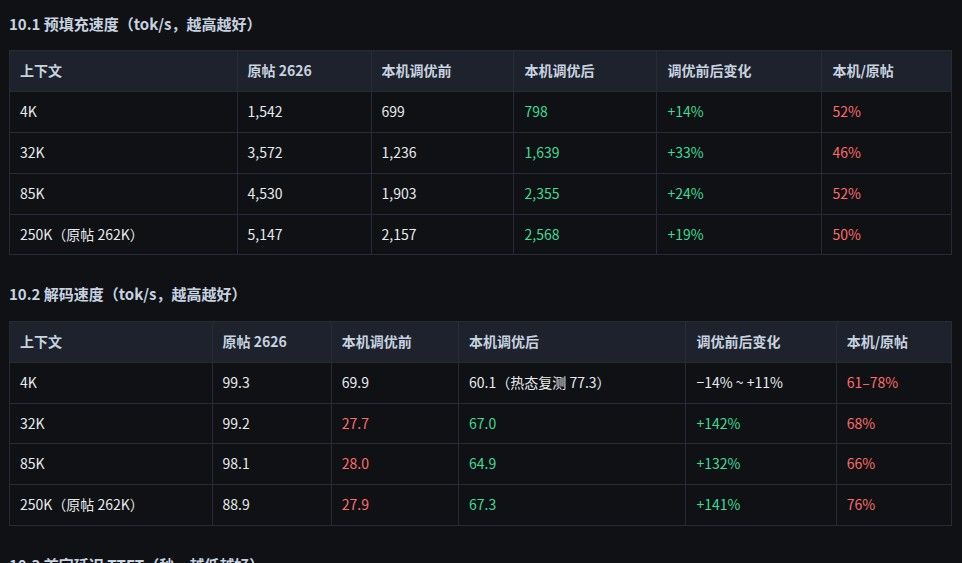
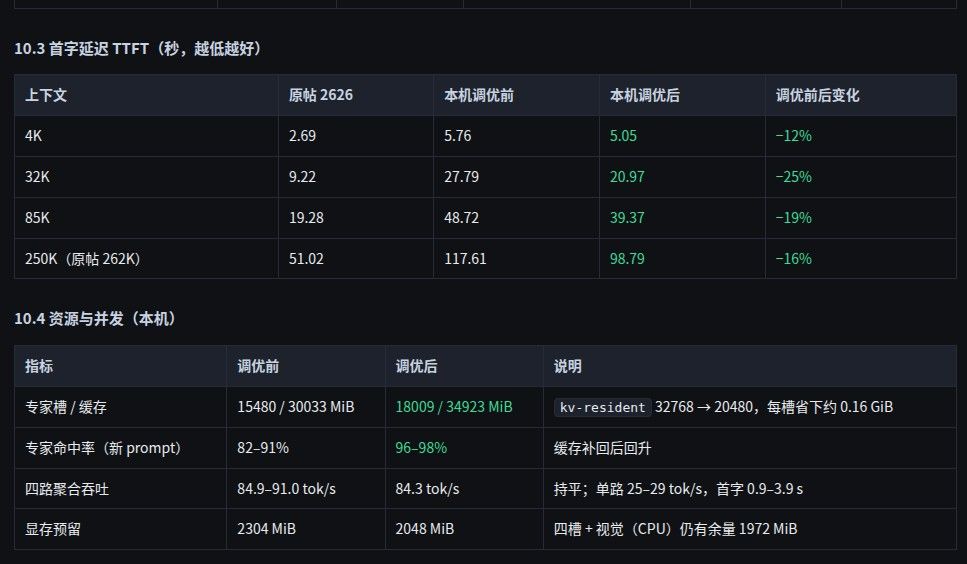
基本结论是以15%左右的TTFT延时,取得40%左右的关键数据提升。这生意是挣的
日子也是好起来,从最初未优化40token/s到现在90+,仍觉得还有优化的空间。 -
@懒人烘培 你把我的预设打破了,你这双并发的数据比我两组两槽四并发的方案好太多,我都怀疑我这边的调教空间了。
所以多做了几组方案的优化,事实证明是我贪了。超预期那波提升是你的CPU承担了部分MOE的计算工作。但你这数据是有干货的。
基本结论是以15%左右的TTFT延时,取得40%左右的关键数据提升。这生意是挣的
日子也是好起来,从最初未优化40token/s到现在90+,仍觉得还有优化的空间。 -
@terry 刚刚又研究了一下博主文章他这个用得是Radiance 只支持RDNA4,不支持RDNA3,问了gpt也是这样的结论。如果一定要用,需要自行补齐 RDNA3 内核支持。我也开始尝试移植,看能否成功
-
@懒人烘培 可以跑,W7900已经跑通了,它实际上就是7900XTX 48G,你让Agent研究下。主要不是跑起来,而是整个流程的效率提升。目前看测试是单步提升很大,但是总体上只快了一半。
-
-
github上看到了这个https://github.com/nicejunjie/Strata-rdna3,作者好像就是AMD的人,双7900xtx prefill能干到6000+了
-
@yin-meng 我测试过了,贼强,他的master只支持avx512 cpu, avx2的cpu要用这个分支 https://github.com/nicejunjie/Strata-rdna3/pull/1
-
github上看到了这个https://github.com/nicejunjie/Strata-rdna3,作者好像就是AMD的人,双7900xtx prefill能干到6000+了
-
@yin-meng 我测试过了,贼强,他的master只支持avx512 cpu, avx2的cpu要用这个分支 https://github.com/nicejunjie/Strata-rdna3/pull/1
-
-
-
-
-
-
-
-
我用作者的方法 跑了3090 x2
ukisai/Swift-1.5-Qwen3.8-Flash-Next-GGUF, IQ4_XS
Setup 19K 43K 89K 123K Decode Production, 250 W 3,198 3,823 3,762 3,647 112 / 118 / 116 / 198 Fork, DP 16K chunks, 350 W 4,493 5,046 5,481 5,418 121 / 125 / 118 / 199 -
@applejuice 主要我这针对双7900XTX优化的,那成绩比之前的有所提高吗?
-





 我的测试结果是avx2 最快能顶到6000 pp 大部分是5100~5500, decode也非常牛,dsh 跑一个session下来平均117~120
 应该就是微调了hipblaslt的表。