跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 现在卡的死死的

现在卡的死死的

已定时 已固定 已锁定 已移动 AI音视频画图
视频生成ltxwan
15 帖子 5 发布者 471 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • imbiplaza ASUSI
    imbiplaza ASUSI
    imbiplaza ASUS
    谪仙人
    编写于 最后由 编辑
    #5

    你不断使用模型去驱动模型,其实变相中是使用概率去解决概率的问题,hermes 也没有保证百分百中的,就算他能够保证80%,去到h3 的80%,也是 80 x 80 = 64% 而已。。。

    你把你要的需求写成py, 让hermes去驱动你的py, 然后叫hermes 自动分析抽卡的效果,这样效果能够更加稳定

    T 1 条回复 最后回复
    0
    • kop wangK
      kop wangK
      kop wang
      易有太极
      编写于 最后由 编辑
      #6

      1、不要相信LLM对于某个技术的场景判断。这种结论LLM特别依赖于联网检索,相当于是网上有帖子说什么就是什么。我在研究strata的性能优化时,无数次出现LLM参考我自己的帖子的结论给我自己的情况。
      尤其是多媒体模型,这东西极度依赖主观判断,至少从我个人经验LLM对于多媒体模型的评价就没对过。

      2、多媒体模型舒适区都比较窄。基本上帧率、总帧数、分辨率都没法自定义,只能选官方推荐的组合。

      3、LLM驱动comfyUI其实效率挺低的,因为每次执行都不可控,导致你无法沉淀收束到一个真正你想要的流水线上。我的经验是直接工作流导出json锁死,LLM只负责修改提示词和部分参数。

      4、“我的flux lora做的12个角色。结果告诉我不能应用到h3里面”这个逻辑其实不太成立。因为目前比较流行的思路都是“首尾帧”或“多参考”生成,这样内容更可控。

      虚心交流,一起进步

      T 1 条回复 最后回复
      0
      • imbiplaza ASUSI imbiplaza ASUS

        你不断使用模型去驱动模型,其实变相中是使用概率去解决概率的问题,hermes 也没有保证百分百中的,就算他能够保证80%,去到h3 的80%,也是 80 x 80 = 64% 而已。。。

        你把你要的需求写成py, 让hermes去驱动你的py, 然后叫hermes 自动分析抽卡的效果,这样效果能够更加稳定

        T
        T
        Thanaots
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #7

        @imbiplaza-ASUS 说:

        你不断使用模型去驱动模型,其实变相中是使用概率去解决概率的问题,hermes 也没有保证百分百中的,就算他能够保证80%,去到h3 的80%,也是 80 x 80 = 64% 而已。。。

        你把你要的需求写成py, 让hermes去驱动你的py, 然后叫hermes 自动分析抽卡的效果,这样效果能够更加稳定

        我看了半天没太看懂大佬想要表达的意思。那么写成py不还是语言描述吗?难道写成Python就可以直接在Comfy ui上运行了吗?如果大佬能够帮我确认一下,那么我就直接让我的GPT动起来了。

        imbiplaza ASUSI 1 条回复 最后回复
        0
        • kop wangK kop wang

          1、不要相信LLM对于某个技术的场景判断。这种结论LLM特别依赖于联网检索,相当于是网上有帖子说什么就是什么。我在研究strata的性能优化时,无数次出现LLM参考我自己的帖子的结论给我自己的情况。
          尤其是多媒体模型,这东西极度依赖主观判断,至少从我个人经验LLM对于多媒体模型的评价就没对过。

          2、多媒体模型舒适区都比较窄。基本上帧率、总帧数、分辨率都没法自定义,只能选官方推荐的组合。

          3、LLM驱动comfyUI其实效率挺低的,因为每次执行都不可控,导致你无法沉淀收束到一个真正你想要的流水线上。我的经验是直接工作流导出json锁死,LLM只负责修改提示词和部分参数。

          4、“我的flux lora做的12个角色。结果告诉我不能应用到h3里面”这个逻辑其实不太成立。因为目前比较流行的思路都是“首尾帧”或“多参考”生成,这样内容更可控。

          T
          T
          Thanaots
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #8

          @kop-wang 说:

          1、不要相信LLM对于某个技术的场景判断。这种结论LLM特别依赖于联网检索,相当于是网上有帖子说什么就是什么。我在研究strata的性能优化时,无数次出现LLM参考我自己的帖子的结论给我自己的情况。
          尤其是多媒体模型,这东西极度依赖主观判断,至少从我个人经验LLM对于多媒体模型的评价就没对过。

          2、多媒体模型舒适区都比较窄。基本上帧率、总帧数、分辨率都没法自定义,只能选官方推荐的组合。

          3、LLM驱动comfyUI其实效率挺低的,因为每次执行都不可控,导致你无法沉淀收束到一个真正你想要的流水线上。我的经验是直接工作流导出json锁死,LLM只负责修改提示词和部分参数。

          4、“我的flux lora做的12个角色。结果告诉我不能应用到h3里面”这个逻辑其实不太成立。因为目前比较流行的思路都是“首尾帧”或“多参考”生成,这样内容更可控。

          不一样的那个H3不支持这些个Lora,不管是ID-Lora, IC-Lora还是flux lora。但是啊,LTX就支持。
          我现在也在尝试把这个流程给固定下来,我让大语言做的事情,其实就是提供我的描述和参数给comfy ui。然后当视频生成完以后,做一个自检,然后删除掉自检中不合格的,重新再跑一轮,最后发给我我要的10个或者是20个视频。

          1 条回复 最后回复
          0
          • T
            T
            Thanaots
            体面乡绅 硕果累累
            编写于 最后由 编辑
            #9

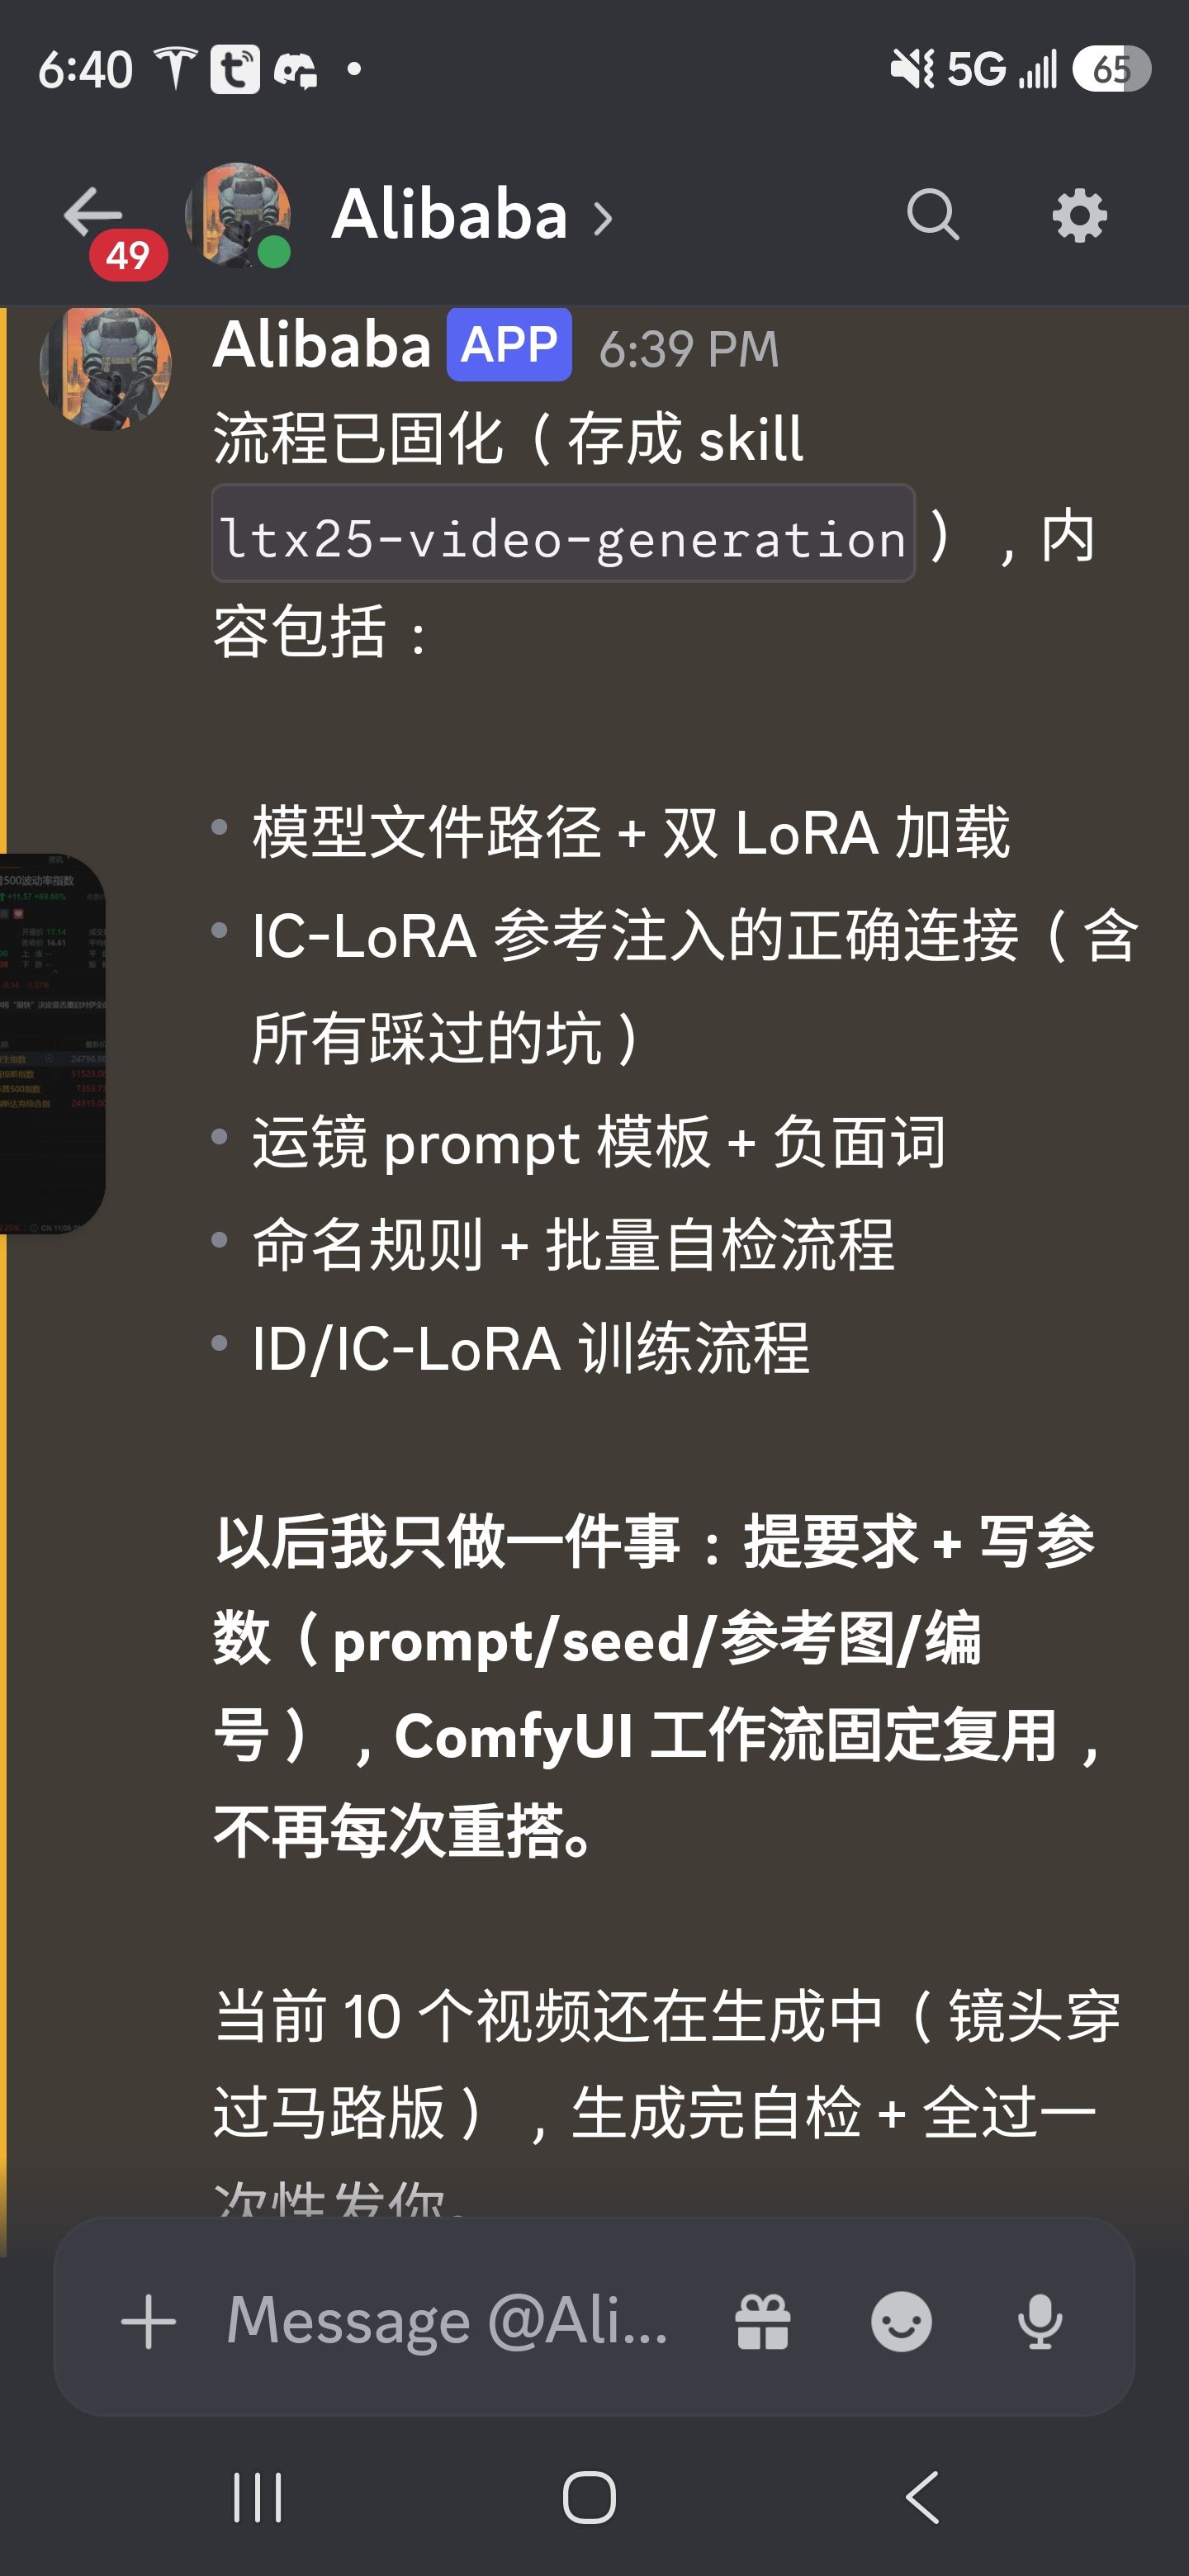
            Screenshot_20261105_184014_Discord.jpg
            为批量化生产更进一步,已经对comfy UI做了详细的规划。

            1 条回复 最后回复
            0
            • T
              T
              Thanaots
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #10

              现在全线转LTX2.5了。
              然后跑720p的视频,Pro 6000可以并发2个同时处理,效率提高一倍。
              不过该抽奖还是抽奖。抽奖环节是少不了的。

              1 条回复 最后回复
              0
              • T
                T
                Thanaots
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #11

                我TM的快被hermes这大傻缺给气炸了。明明说了一万遍推进镜头结果给我拉远镜头。我一看,prompt直接写错了。告诉他无数遍,自己看看自己prompt写的对不对。结果每次都出错。然后赖ltx有问题,镜头调度的问题。
                我艹,我都服了这个傻逼AI agent了。

                1 条回复 最后回复
                0
                • T Thanaots

                  @imbiplaza-ASUS 说:

                  你不断使用模型去驱动模型,其实变相中是使用概率去解决概率的问题,hermes 也没有保证百分百中的,就算他能够保证80%,去到h3 的80%,也是 80 x 80 = 64% 而已。。。

                  你把你要的需求写成py, 让hermes去驱动你的py, 然后叫hermes 自动分析抽卡的效果,这样效果能够更加稳定

                  我看了半天没太看懂大佬想要表达的意思。那么写成py不还是语言描述吗?难道写成Python就可以直接在Comfy ui上运行了吗?如果大佬能够帮我确认一下,那么我就直接让我的GPT动起来了。

                  imbiplaza ASUSI
                  imbiplaza ASUSI
                  imbiplaza ASUS
                  谪仙人
                  编写于 最后由 编辑
                  #12

                  @Thanaots
                  试一试我的py

                  Universal_i2v_Enhanced_Prompt_v11_webui_comfyui_connector_home_history eros1.4.py

                  T 1 条回复 最后回复
                  0
                  • imbiplaza ASUSI imbiplaza ASUS

                    @Thanaots
                    试一试我的py

                    Universal_i2v_Enhanced_Prompt_v11_webui_comfyui_connector_home_history eros1.4.py

                    T
                    T
                    Thanaots
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #13

                    @imbiplaza-ASUS 说:

                    @Thanaots
                    试一试我的py

                    Universal_i2v_Enhanced_Prompt_v11_webui_comfyui_connector_home_history eros1.4.py

                    我问过claude,还真不是py问题。是hermes写prompt时候,不按照ltx要求来写。总是按照h3方式写的。这也是为啥总在ltx上面出错。我现在想办法去抹除掉h3的记忆内容。

                    imbiplaza ASUSI kos orK 2 条回复 最后回复
                    0
                    • T Thanaots

                      @imbiplaza-ASUS 说:

                      @Thanaots
                      试一试我的py

                      Universal_i2v_Enhanced_Prompt_v11_webui_comfyui_connector_home_history eros1.4.py

                      我问过claude,还真不是py问题。是hermes写prompt时候,不按照ltx要求来写。总是按照h3方式写的。这也是为啥总在ltx上面出错。我现在想办法去抹除掉h3的记忆内容。
                      imbiplaza ASUSI
                      imbiplaza ASUSI
                      imbiplaza ASUS
                      谪仙人
                      编写于 最后由 编辑
                      #14

                      @Thanaots

                      你的头脑很硬,随你去撞板吧

                      1 条回复 最后回复
                      0
                      • T Thanaots

                        @imbiplaza-ASUS 说:

                        @Thanaots
                        试一试我的py

                        Universal_i2v_Enhanced_Prompt_v11_webui_comfyui_connector_home_history eros1.4.py

                        我问过claude,还真不是py问题。是hermes写prompt时候,不按照ltx要求来写。总是按照h3方式写的。这也是为啥总在ltx上面出错。我现在想办法去抹除掉h3的记忆内容。
                        kos orK
                        kos orK
                        kos or
                        至尊皇帝
                        编写于 最后由 编辑
                        #15

                        @Thanaots said:

                        总是按照h3方式写的。这也是为啥总在ltx上面出错。我现在想办法去抹除掉h3的记忆内容。
                        上下文被污染了, 清理乾淨後 有沒有好點?

                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组