-
MiniMax H3「剑心比赛」部署 · 参数 · 执行 · 对比 全记录
任务来源 https://lcz.me/topic/3045 (抡锤者论坛 · AI 音视频画图 · MiniMax H3 挑战赛「抡锤者」) 出片执行 2026-11-16 02:57:49 – 03:29:55(Asia/Shanghai),单条串行驱动,无人值守 基线对照 2026-11-15 同机同 prompt 的 20 步基线两条 执行链路 Windows 工作站 → SSH(别名 vllm-r9700)→ GPU 服务器magic629-AI(192.168.67.202,用户magic629)交付位置 C:\Users\MagicZ790\Desktop\H3剑心比赛-2026.11.16\一句话结果 双 R9700 32G 纯 ROCm 原生栈,MiniMax H3 Ref2VA fp8,1344×768 / 294 帧 / 12.25 s 两条参赛成片,turbo 8 步端到端 707 s / 702 s,比同机 20 步基线快 1.89×;附加 4 步档 516 s(2.59×)
第 1 章 规则解读与逐条落实
比赛硬性要求共 11 条,逐条对照本次落实:
# 规则要求 落实方式 证据位置 1 模型必须是 MiniMax H3 minimax-h3-ref2va-fp8.rad(26,863,880,192 B = 25.0 GiB fp8 权重容器),未换模型、未换底座工作流\90-lora-turbo.conf2 分辨率 1344×768 三条成片 ffprobe 实测 width=1344 height=768证据\logs\ffprobe-*.txt3 时长 12S 294 帧 @ 24 fps = 12.250000 s(该档位唯一合法帧数,推导见 3.1) 同上 4 使用官方 6 张参考图 剑心 ×3 + 志志雄 ×3 全部作为 --image送入,并用<Picture 1..6>显式指派角色参考图\、工作流\prompt-*.txt5 两条成片: (Style: 3D CGI animation)与(Style: 2D traditional anime)两条均出,同机同流同 seed 视频\6 统一提示词 官方 prompt 逐字使用,仅替换 (Style: …)一处工作流\prompt-*.txt7 工作流通用可复现 一条命令 + 全部脚本随附 第 6 章 8 上传油管 + 单独发帖,回帖以 [H3剑心比赛]开头草稿已备好,链接两处待填(人工步骤) 参赛帖草稿.md9 证据四件套:硬件配置 / 工作流 / 加速手段 / 含 Total Time 的完整运行日志(不收截图) 本文档 + 证据\logs\全部为文本日志与命令行取证第 2、3、5 章 10 一周内结算 期限内 — 11 2D 不必依赖 3D 中间产物 2D 直接用同一组官方参考图,未引入 3D 成片作参考 工作流\inputs-2D-anime-8step.json
第 2 章 部署
2.1 硬件拓扑(引擎自报,非人工填写)
引擎启动时打印的硬件清单是最可信的一手证据:
card 0000:03:00.0  rank 0 (device 0)  gfx1201 "AMD Radeon AI PRO R9700"  31.86 GiB VRAM  NUMA -1  driver amdgpu card1
card 0000:06:00.0  rank 1 (device 1)  gfx1201 "AMD Radeon AI PRO R9700"  31.86 GiB VRAM  NUMA -1  driver amdgpu card0
card 0000:00:02.0  not serving  0x8086:0x7d67  unknown VRAM  NUMA -1  driver i915 card2
host      Intel(R) Core(TM) Ultra 7 265K | 20 cores, 20 threads | RAM 62.26 GiB, 29.64 GiB available | swap 40.00 GiB, 433.86 MiB used
system    kernel 7.0.0-42-generic | Ubuntu 24.04.5 LTS | no container seen | cgroup memory unlimited | memlock unlimited
memory    huge pages madvise (defrag madvise, shmem never) | ttm.pages_limit 31.13 GiB | pinned by this process 26.89 GiB
项 值 取证命令 GPU 2 × AMD Radeon AI PRO R9700 32GB(PCI ID 1002:7551rev c0,架构gfx1201/ RDNA4)lspci -nn、引擎日志单卡显存 32624 MiB(引擎按 31.86 GiB 计) /sys/class/drm/card{0,1}/device/mem_info_vram_totalCPU Intel Core Ultra 7 265K,20 核 20 线程 /proc/cpuinfo、nproc内存 / 交换 64 GB(62.26 GiB)/ 40 GiB swap free -g系统 Ubuntu 24.04.5 LTS,kernel 7.0.0-42-generic uname -a核显 Intel Arrow Lake 8086:7d67,i915驱动,不参与计算lspci -nn全程 ROCm 原生:无 CUDA、无 CUDA 兼容层、无 N 卡兜底。
2.2 软件栈与版本
层 组件 版本 / 路径 计算栈 torch / HIP torch 2.14.1+rocm7.14,hip 7.14.60850推理引擎 Radiance(自研 C++ 引擎,build 2026-10-26) /home/magic629/radiance-h3-fullref/build/bin/radiance视频模型 MiniMax H3 Ref2VA fp8 /home/magic629/h3-models/minimax-h3-ref2va-fp8.rad(25.0 GiB)预处理 ComfyUI(独立 venv)+ h3_fullref.py prepare/home/magic629/ComfyUI/.venv,Qwen3-VL 文本编码塔 + VAE服务 systemd radiance-h3fullref.service,监听:8001见 2.3 互斥服务 docker radiance-flashnext(LLM,:8000/:8010)与视频服务抢同一对卡 记账 h3-postlog.sh→~/h3-runs.csv每次出片自动追加一行 2.3 服务化与双服务显存互斥
双卡只有 2 × 32 GB,视频服务与 LLM 服务不能同时驻留,因此做了闸门 + 锁 + 看门狗三件套:
组件 作用 /usr/local/bin/radiance-video-gate.shbegin/end/status三态闸门:begin停 LLM 容器并写锁与 pin,end起视频服务后释放并恢复 LLM/home/magic629/radiance-prod/logs/.video-task.lock任务锁,防止两个出片任务同时抢卡 /home/magic629/radiance-prod/logs/.video-pin「视频优先」钉选,带 TTL,防止 LLM 看门狗在出片中途把卡抢回去 gpu-exclusive.confdrop-in:声明显存独占 95-startlimit.confStartLimitIntervalSec=300/StartLimitBurst=5:崩溃循环 5 次即熔断,避免历史上「25 次重启把 LLM 按住不放」的事故复发90-lora-turbo.confdrop-in:注入 turbo LoRA 与显存预算参数(见 2.5) 出片脚本内部顺序固定为:停 LLM → 轮询显存归零 → 预处理 → 起视频服务 → 提交生成 → 下载 → 记账 →(可选)恢复 LLM。
KEEP_LLM_DOWN=1时保留视频服务、LLM 继续停着,用于连续多条出片(本次前两条就是这么串的)。2.4 显存与内存预算(引擎自报,带 LoRA 的 8 步档)
VRAM budget, per card:
  card total          31.86 GiB
  activation arena    17.72 GiB   computed from the buffer plan
  --gpu-headroom-mib   4.00 GiB   left unclaimed on purpose
  claimable            9.44 GiB
  static weights       9.44 GiB   off the top: every rank's own shard
  vram_weights         9.44 GiB   static + experts
  vram_kv                    0 B   the cache's share
  unclaimed            4.00 GiB   the headroom + unusable + MiB rounding
weights by tier   VRAM 3.60 GiB, host pool 11.64 GiB, container on disk 0 B, mapped 0 B (rank 0)
note experts-from-host: 10.79 GiB of weights a rank live in the pinned host pool and cross PCIe when they are used
card 1 settled at 4.29 GiB free, against 4.28 GiB (the 4.00 GiB --gpu-headroom-mib and 287.12 MiB kept for step staging)
三条关键工程结论:
--gpu-headroom-mib 4096是 LoRA 能装下的前提。 早期 LoRA 槽 OOM 的根因不是权重体积,而是引擎把显存算到「刚好」,首步 staging 的 287 MiB 无处安放。留 4 GiB 余量后一次通过。--host-pool-mib 12288+--placement layer_offload把 11.64 GiB 权重压到钉住的主机池,代价是 10.79 GiB 专家权重每次使用要过 PCIe —— 这是「单步变慢 12 %」的物理来源之一。--vision-tower-placement ram让 Qwen3-VL 编码塔常驻内存,不占显存;配合 62 GiB 内存,预处理阶段MemAvailable始终 ≥ 23 GiB,swap 只用了 433 MiB。
2.5 LoRA 部署与热切换
LoRA 路径 体积 原生 rank 本机 rank turbo 8 步 v1.1 768p(参赛档) ~/h3-models/lora/minimax_h3_ref2v_turbo_8step_v1.1_768p_bf16.safetensors1,383,677,808 B 128 128(无损) turbo 4 步 v0.1 comfyui(对照档) ~/h3-models/ComfyUI-Models/loras/minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors1,956,193,000 B 384 128(被截断) 服务侧一次性声明,请求侧按名字启用(名字必须匹配,否则静默不生效):
# /etc/systemd/system/radiance-h3fullref.service.d/90-lora-turbo.conf
ExecStart=... --lora turbo=/home/magic629/h3-models/lora/minimax_h3_ref2v_turbo_8step_v1.1_768p_bf16.safetensors \
              --max-loras 1 --max-lora-rank 128 ...
# 请求侧
"loras": ["turbo"]
换档流程(本次实测有效,约 20 s):
sudo sed -i "s#--lora turbo=[^ ]*#--lora turbo=<新权重路径>#" \
     /etc/systemd/system/radiance-h3fullref.service.d/90-lora-turbo.conf
sudo systemctl daemon-reload          # 下一次 systemctl start 时生效,无需常驻重启
备份:
/home/magic629/90-lora-turbo.conf.keep8step。跑完 4 步对照后驱动脚本自动还原为 8 步档并daemon-reload,收尾已核对:turbo=/home/magic629/h3-models/lora/minimax_h3_ref2v_turbo_8step_v1.1_768p_bf16.safetensors2.6 素材目录布局(两个必须避开的坑)
h3-make-multi.sh的取图逻辑:ls "$DIR"/*.png "$DIR"/*.jpg "$DIR"/*.jpeg # 只认素材目录【顶层】的图片 VID=$(ls "$DIR"/*.mp4 2>/dev/null | grep -v /成片- | grep -v /out- | head -1) # 任意 mp4 会被当成动作参考视频因此:
- 参考图必须放在素材目录顶层,放子目录里等于没给(本次建了三个干净目录
~/h3-c16-3d、~/h3-c16-2d、~/h3-c16-3d4s,各放 6 张 jpg + 一份prompt.txt)。 - 素材目录里不能留历史成片(如
final-3d.mp4),否则会被当成「动作参考视频」混进请求,改变生成语义。旧的~/h3-contest-3d/~/h3-contest-2d就有这个问题,所以本次另起新目录。
第 3 章 参数
3.1 帧数与分辨率的硬约束(为什么是 294 帧)
h3_fullref.py的校验规则:帧数 length 必须满足 length = 17n + 5,n ∈ [7, 21] 尺寸 宽高必须是 32 的倍数,单边 ≥ 256,宽高比 ≤ 4:1 面积 ≤ 1344 × 768 = 1,032,192 px推导:
n = round((12 × 24 − 5) / 17) = 17   →   length = 17 × 17 + 5 = 294 帧
294 / 24 fps = 12.25 s               →   12 秒档位下唯一合法值(277 帧 = 11.54 s,311 帧 = 12.96 s 都更偏)
1344 × 768 = 1,032,192 px            →   正好等于面积上限,无需降档
3.2 预处理参数(
h3_fullref.py prepare)参数 值 说明 --image×6( jianxin1-3.jpg、zhizhixiong1-3.jpg)官方 6 张参考图, action="append",上限 9 张--reference-max-area344064 默认值 = 1344×768/3;可用环境变量 REF_AREA覆盖--width × --height1344 × 768 面积上限 --frames294 见 3.1 --fps24 固定 --seed145 三条完全相同( SEED可覆盖)--pad_reference_videotrue 参考图补齐为视频片段形态 ROCR_VISIBLE_DEVICES0 预处理只用单卡(编码 + VAE 不需要双卡) 产物 request.json92 MB、prepared.pt、inputs.json每个 work-*目录约 235 MB3.3 请求体关键字段(
inputs.json实测,三条只差steps){ "width": 1344, "height": 768, "megapixels": 1.032192, "frames": 294, "fps": 24, "steps": 8, "seed": 145, "context_rows": 3608, "reference_max_area": 344064, "pad_reference_video": true, "loras": ["turbo"] }一个容易踩的语义坑:命令行
--steps N落到请求里是num_inference_steps = N + 1。命令行 请求字段 日志确认 --steps 20num_inference_steps: 21基线 --steps 8num_inference_steps: 9OK 已注入 loras=['turbo'] num_inference_steps=9--steps 4num_inference_steps: 5同上, =53.4 HTTP API 调用序列
POST /v1/videos            ← 提交(multipart:request.json + 参考图)→ {"id": "video_..."}
GET  /v1/videos/{id}       ← 每 60 s 轮询:queued → in_progress(progress 0..100) → completed
GET  /v1/videos/{id}/content  ← 下载 mp4
GET  /v1/models            ← 服务就绪探针(200 即认为加载完成)
三条成片的 job id:
成片 job id 3D / 8 步 video_db09159e8c7b2a49fffeff886ddf8f202D / 8 步 video_1a389230724edbe03cc63df9464762953D / 4 步 video_3315b4a00ec8ee5071be971ed65863e920 步基线 3D / 2D(11-15) video_2cfb4d1a29f83f1d1f2dac2fb6e1ea64/video_6b4d10461a92b4b6bae7397659aca22b3.5 环境变量开关(
h3-make-multi.sh)变量 本次取值 作用 LORASturbo往请求里注入 "loras": ["turbo"]OUT_PREFIXout输出文件名前缀;必须 ASCII,否则 scp 回传时中文路径易出问题 KEEP_LLM_DOWN1(前两条)/ 不设(第三条)出片后是否把 LLM 恢复回来 SEED默认 145 固定种子,保证三条可比 REF_AREA默认 344064 参考图最大面积 WORK_KEEP默认 5 素材目录保留最近 N 个 work-*调用形式:
bash ~/h3-make-multi.sh <素材目录> <秒> <步> <宽x高> <超时分>
# 本次:
LORAS=turbo OUT_PREFIX=out KEEP_LLM_DOWN=1 bash ~/h3-make-multi.sh ~/h3-c16-3d 12 8 1344x768 40
3.6 提示词全文
3D 版(2D 版仅首行换成
(Style: 2D traditional anime)):(Style: 3D CGI animation) Masterpiece, high quality, cinematic lighting. Subject: A fierce battle sequence featuring two characters based on the reference images—a red-clad swordsman (Jianxin) and a purple-robed warrior (Zhizhixiong). Action: The camera begins with a dynamic low-angle tracking shot. The swordsman in red dashes forward with a long sword, leaving a glowing trail, while the warrior in purple stands firm and executes a sweeping counter-attack with a flaming effect. They clash in the center of the frame, creating a shockwave of energy and sparks. The camera rapidly orbits around them as the fiery battle intensifies, concluding with the red-clad swordsman landing gracefully while the purple warrior points his weapon forward, both facing the camera. Environment: Dramatic background with embers floating in the air, high contrast lighting. References: <Picture 1>, <Picture 2> and <Picture 3> show the red-clad swordsman Jianxin. <Picture 4>, <Picture 5> and <Picture 6> show the purple-robed warrior Zhizhixiong.最后一行是 H3 官方占位符约定(
<Picture N>),作用是把 6 张参考图显式指派给两个角色。不加这一行时,模型会自行猜测图片与角色的对应关系,实测会出现服装串色(红袍角色拿到紫袍纹理)。
第 4 章 执行过程
4.1 时间线(2026-11-16,Asia/Shanghai)
时刻 事件 02:57:49 串行驱动启动;建三个干净素材目录;确认 drop-in 挂的是 8 步 LoRA;3D 8 步开始 02:57:52 停 LLM 容器,双卡显存降到 57 MiB 02:59:34 预处理完成(102 s), request.json92 MB,注入loras=['turbo']、num_inference_steps=902:59:52 视频服务就绪(18 s,双卡 TP2 加载 25 GiB fp8) 03:09:36 3D 8 步出片 out-030936.mp4(8.7 MB),Total Time 707 s;LLM 保持停止03:09:36 2D 8 步开始(复用已停的 LLM,省一次切换) 03:21:18 2D 8 步出片 out-032118.mp4(8.3 MB),Total Time 702 s03:21:18 – 03:23:15 切换 LoRA:drop-in 改指 4 步权重 → daemon-reload→ 服务重启(03:23:15 引擎打印新预算表)03:29:55 3D 4 步出片 out-032955.mp4(12.0 MB),Total Time 516 s;恢复 LLM03:29:55 还原 8 步 drop-in + daemon-reload,驱动写ALL_DONE rc=3d8:0 2d8:0 3d4:003:33 证据收集:ffprobe ×3、抽帧 ×12、日志切片、硬件取证、 inputs.json落盘03:36 – 03:41 打包上桌面,服务器复位(视频服务停、显存交还 LLM、 radiance-flashnextUp healthy)三条串行总占用 32 分 06 秒(含 LoRA 切换),全程无人值守。
4.2 单次出片的四个阶段(3D / 8 步完整日志)
==============================================
 素材: /home/magic629/h3-c16-3d
 参考图: 6 张 -> jianxin1.jpg .. zhizhixiong3.jpg
 输出: 1344x768 / 294 帧 / 8 步 / 12s
 开始: 2026-11-16 02:57:49 CST
==============================================
[1/4] 腾出双卡显存 ...
  停 LLM 容器 radiance-flashnext ...
  ✅ 显存已释放(57 MiB)
[2/4] 预处理(Qwen3-VL 编码 + VAE,单卡)...
  [预检] 内存 MemAvailable 57 GiB / 共 62 GiB,swap 已用 433 MiB,要求 ≥ 18 GiB
  [预检] 单卡最大显存占用 57 MiB(预处理要求空卡,期望 < 1500 MiB)
  [预检] 素材目录已有 0 个 work-* 目录(每次约 235 MB)
  ✅ 内存余量充足
  ✅ request.json 已生成 (92M)  预处理耗时 102s
  OK 已注入 loras=['turbo']  num_inference_steps=9
[3/4] 启动视频服务(双卡 TP2)...
  ✅ 就绪 (18s)
[4/4] 提交并等待生成...
  job id: video_db09159e8c7b2a49fffeff886ddf8f20
  60s status=queued progress=0 已用 72s
  120s status=in_progress progress=11 已用 132s
  180s status=in_progress progress=22 已用 193s
  240s status=in_progress progress=33 已用 253s
  300s status=in_progress progress=45 已用 313s
  360s status=in_progress progress=56 已用 374s
  420s status=in_progress progress=67 已用 434s
  480s status=in_progress progress=78 已用 494s
  540s status=in_progress progress=90 已用 555s

==============================================
  ✅ 出片成功: /home/magic629/h3-c16-3d/out-030936.mp4  (8.7M)
 ---- Total Time 计时证据 ----
  预处理(prepare)     : 102s
  服务启动(冷启动加载) : 15s
  生成(submit->done)  : 585s
  端到端 Total Time   : 707s  (11.8 分钟)
  规格: 1344x768 / 294帧 / 8步 / 12s / seed 145
  结束: 2026-11-16 03:09:36 CST
  [记账] 已追加到 /home/magic629/h3-runs.csv
         2026-11-16 03:09:36,h3-make-multi,h3-c16-3d,1344x768,294,8,turbo,102,15,585,707,9055055,out-030936.mp4
codec_name=h264
width=1344
height=768
nb_frames=294
codec_name=aac
nb_frames=384
duration=12.250000
==============================================
  ℹ️ KEEP_LLM_DOWN=1:视频服务留在 :8001,LLM 保持停止
进度曲线几乎完全线性(每 60 s 约 +11 %),说明生成段没有卡顿或重排,时间全部花在真实的去噪步上。
4.3 计时账本
h3-runs.csv(脚本自动追加,原样)time,script,dir,spec,frames,steps,loras,prepare_s,svc_s,gen_s,total_s,mp4_bytes,mp4 2026-11-16 02:10:40,h3-make-multi,h3-int-full4,1344x768,294,4,turbo,101,12,399,517,12590935,成片-021040.mp4 2026-11-16 03:09:36,h3-make-multi,h3-c16-3d,1344x768,294,8,turbo,102,15,585,707,9055055,out-030936.mp4 2026-11-16 03:21:18,h3-make-multi,h3-c16-2d,1344x768,294,8,turbo,99,15,584,702,8743146,out-032118.mp4 2026-11-16 03:29:55,h3-make-multi,h3-c16-3d4s,1344x768,294,4,turbo,98,15,399,516,12590935,out-032955.mp4第 1 行是 02:10 的全规格预演(4 步),与第 4 行字节数完全相同(12,590,935 B)—— 同 seed 同参数逐字节可复现,这是本套流程稳定性的直接证明。
4.4 踩坑与修复清单
现象 根因 修复 PowerShell 里 ssh host "grep '...\"...' ..."报TerminatorExpectedAtEndOfString/未预期的 EOFWindows OpenSSH + PowerShell 的引号转义与 bash 不一致,嵌套引号必炸 一律「本地写 .sh → scp→ssh "tr -d '\r' < ~/x.sh > /tmp/x.sh && bash /tmp/x.sh"」;tr -d '\r'顺手去掉 CRLF中文文件名 scp 回传乱码/失败 终端码页与 SFTP 路径编码不一致 服务器侧输出统一 OUT_PREFIX=out(ASCII),回传后再本地重命名参考图放子目录 → 生成结果不像参考图 脚本只 ls素材目录顶层图片参考图必须放顶层;本次为每次出片新建干净目录 素材目录里的历史成片被当动作参考 VID=$(ls *.mp4 | grep -v /成片- | grep -v /out- | head -1)新目录不留 final-*.mp4挂 LoRA 后启动即 OOM 引擎显存算到刚好,首步 staging 287 MiB 无处安放 --gpu-headroom-mib 4096+--host-pool-mib 12288LLM 被按住 25 次重启不放手 视频服务崩溃循环,看门狗反复让位又抢不回 95-startlimit.conf(StartLimitBurst=5/300s)熔断 + 启动前systemctl reset-failedpin TTL 形同虚设,LLM 中途抢卡 pin_age()用cut -d' ' -f1解析时间戳,取错字段修正解析字段,TTL 正常生效 ROCm 上开 Triton 反而更慢 该后端在 gfx1201 上未优化 --disable-triton-backend,改用--kernels libr4d原生 kernelsystemctl is-active radiance-flashnext显示 inactive 但服务其实正常看门狗用 docker stop/start操作容器,systemd 单元状态与容器实际状态脱节以 docker ps+curl :8010/health为准(本次收尾实测Up (healthy)/200)
第 5 章 详细对比
5.1 五组数据总表(同机、同 6 图、同 prompt、同 seed 145、同 1344×768 / 294 帧)
档位 步数(请求内 +1) 预处理 服务冷启动 生成 端到端 相对基线 单步成本 文件体积 平均码率 20 步基线 3D(11-15) 21 107 s 12 s 1213 s 1336 s(22.3 min) 1.00× 57.8 s/步 12,778,318 B 8.35 Mb/s 20 步基线 2D(11-15) 21 98 s 12 s 1223 s 1337 s(22.3 min) 1.00× 58.2 s/步 13,478,132 B 8.80 Mb/s turbo 8 步 3D(参赛) 9 102 s 15 s 585 s 707 s(11.8 min) 1.89× 65.0 s/步(+12.5 %) 9,055,055 B 5.91 Mb/s turbo 8 步 2D(参赛) 9 99 s 15 s 584 s 702 s(11.7 min) 1.90× 64.9 s/步(+12.3 %) 8,743,146 B 5.71 Mb/s turbo 4 步 3D(对照) 5 98 s 15 s 399 s 516 s(8.6 min) 2.59× 79.8 s/步(+38 %) 12,590,935 B 8.22 Mb/s 端到端耗时拆解:预处理 / 服务冷启动 / 生成 三段堆叠,五组配置横向对比](H3剑心比赛-2026.11.16/证据/图表-端到端耗时拆解
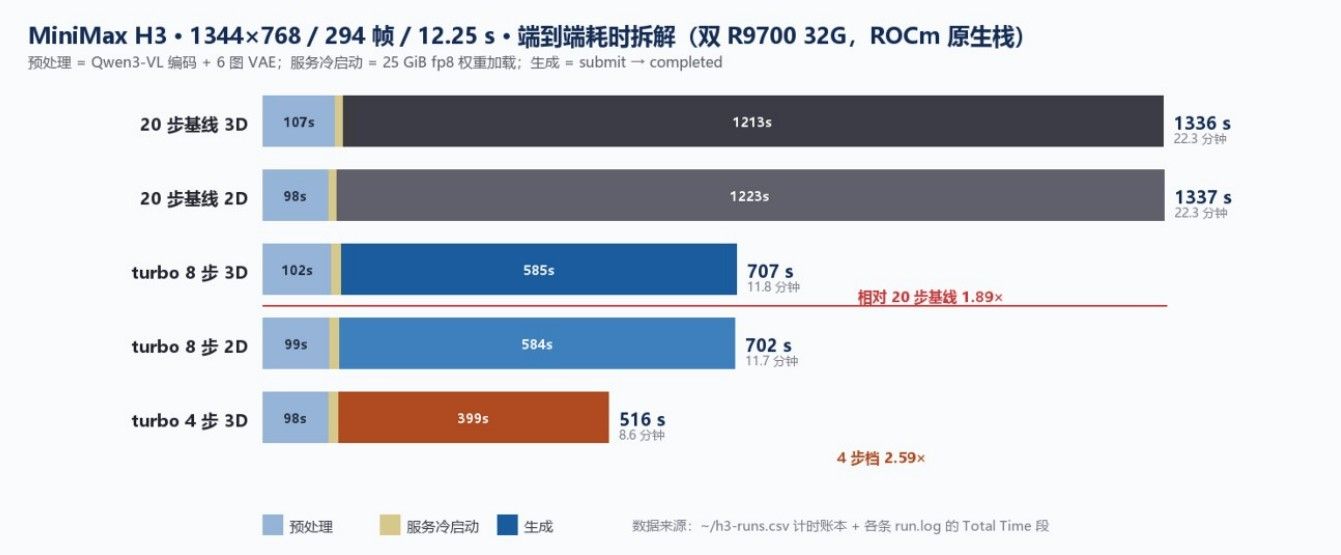
三个反直觉但很重要的读数:
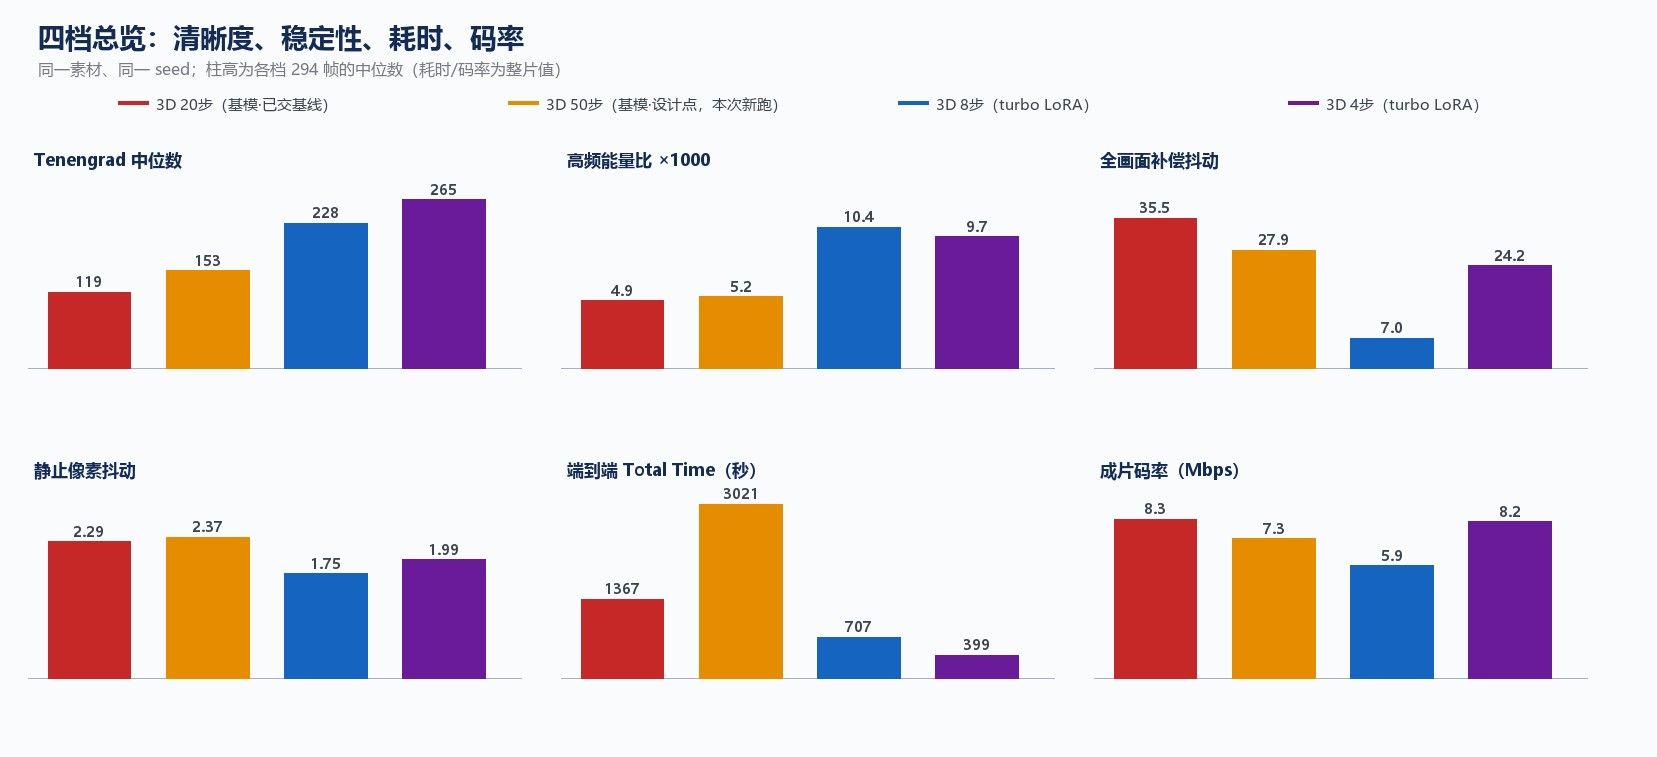
- 加速全部来自步数,不来自单步。 LoRA 让每一步变慢 12.5 %(4 步档甚至慢 38 %),因为 LoRA 注入本身有算子开销,且 rank 截断后仍有额外权重读取。收益完全来自 21 步 → 9 步。
- 预处理和冷启动是固定税(约 117 s,占 8 步档端到端 16.5 %)。 想再压时间,优化点在这两段(预处理可缓存、服务可常驻),而不是生成段。
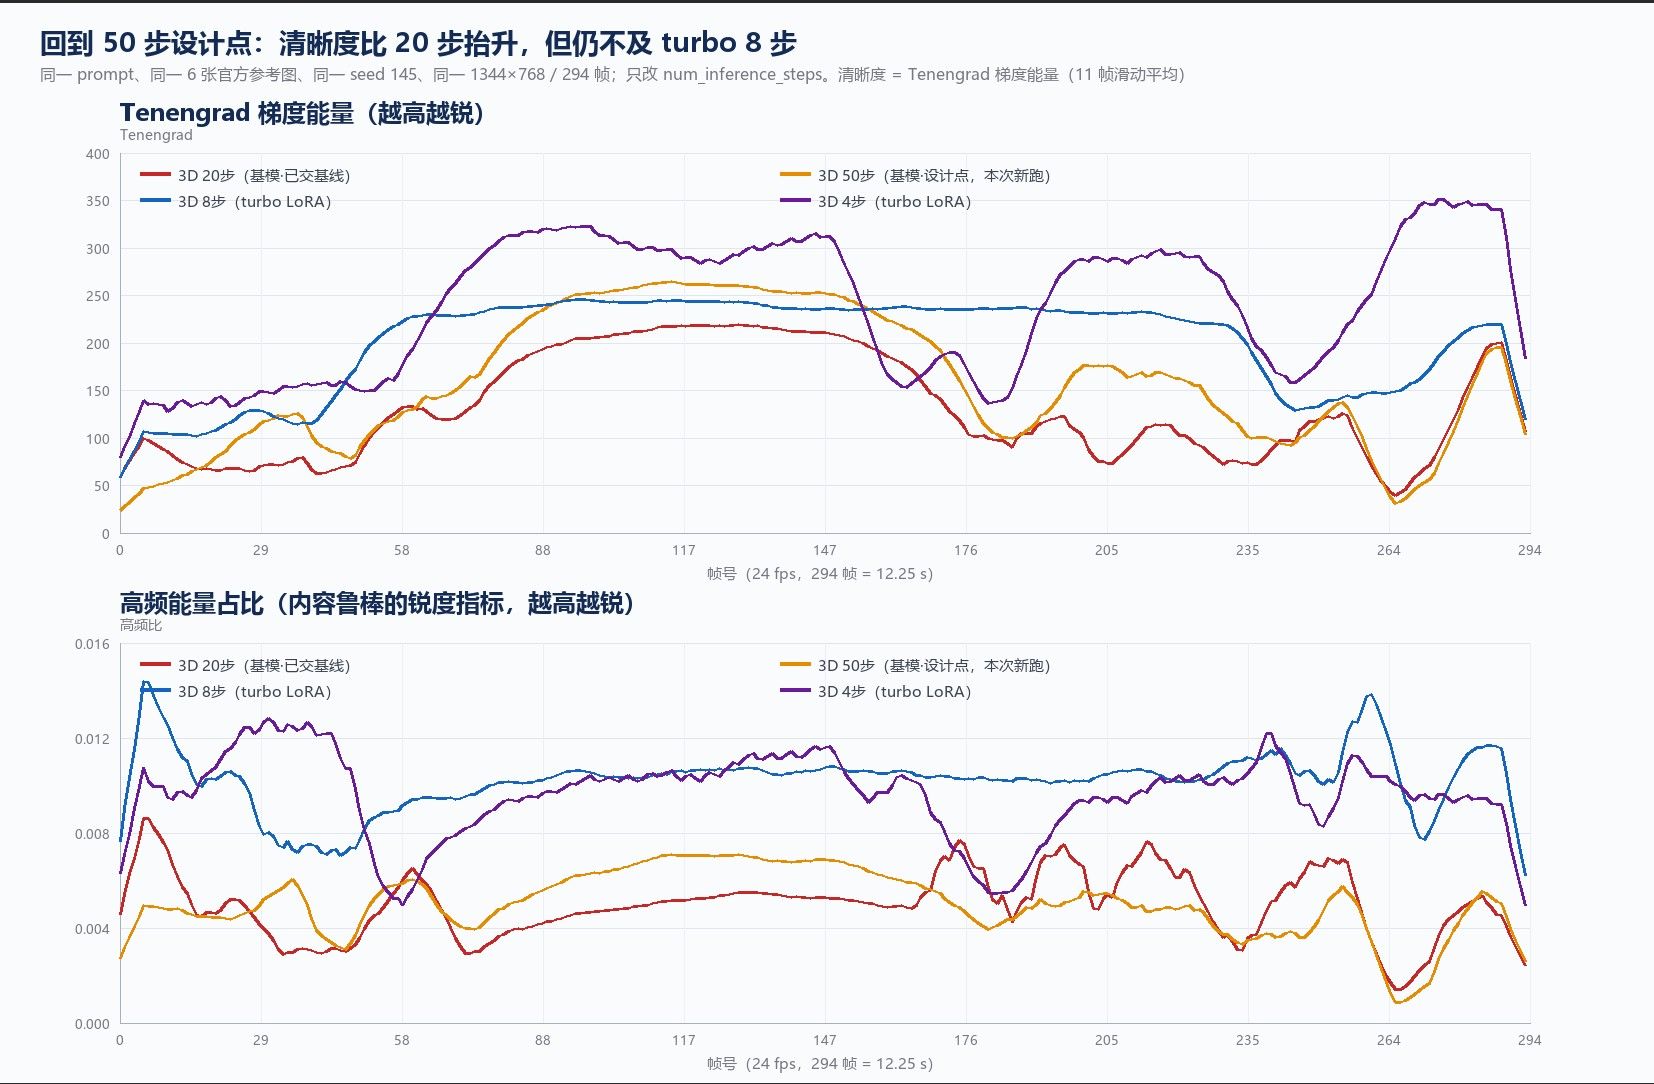
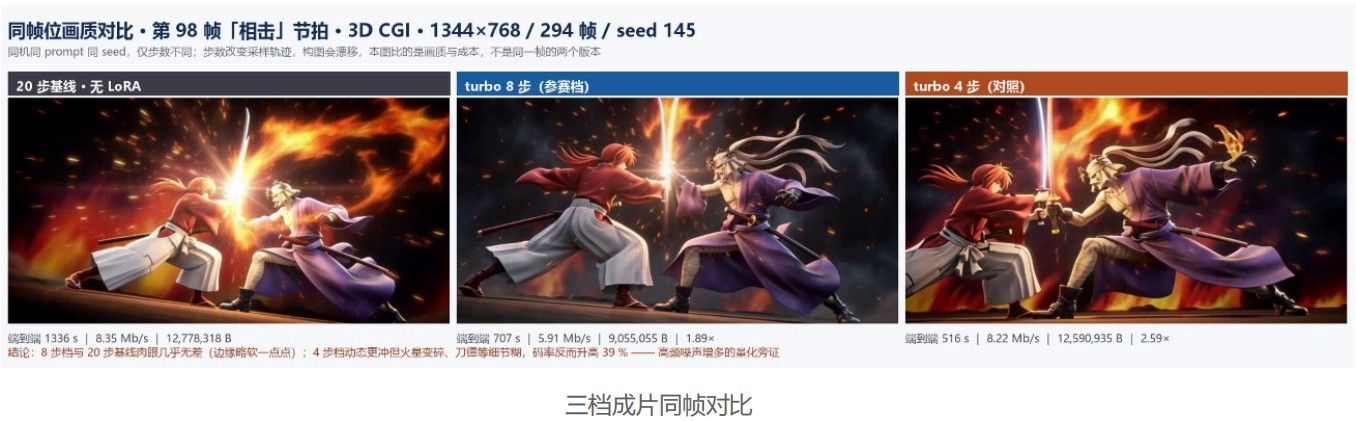
- 4 步档文件反而更大、码率更高(8.22 vs 5.91 Mb/s)。 同分辨率同时长下码率升高,说明画面高频噪声增多 —— 与抽帧看到的「火星/纹理变碎」完全一致,是画质下降的量化旁证。
5.2 画质对比(同帧位横向)
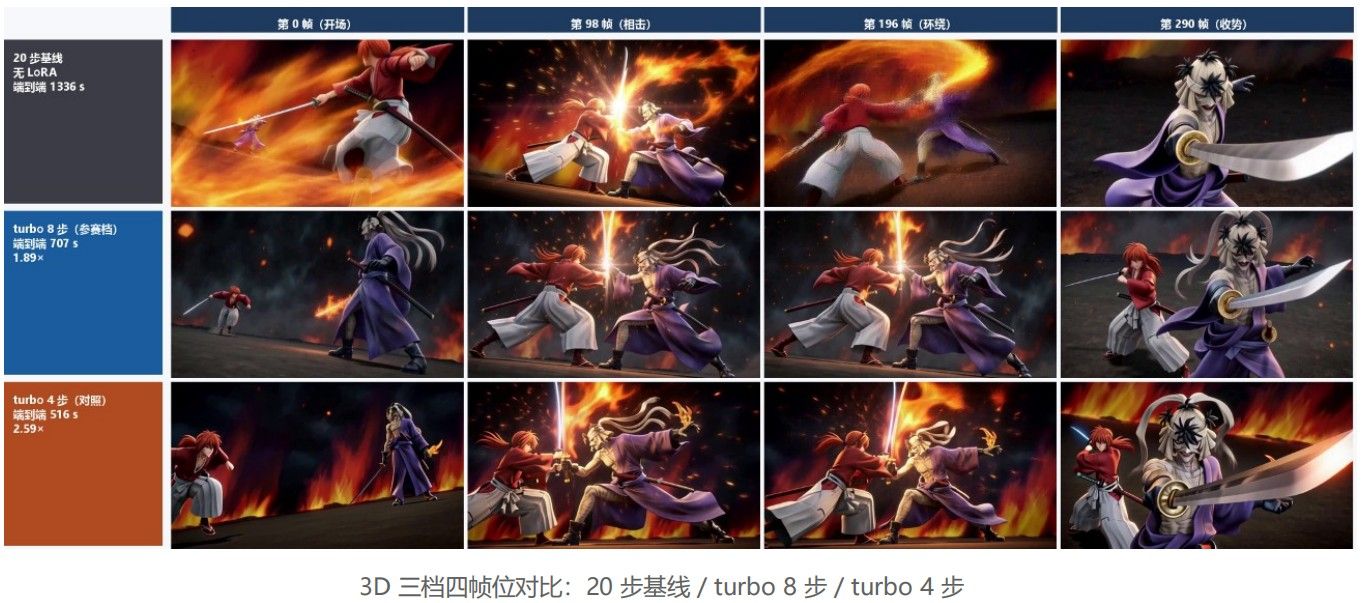
3D 三档 × 四个节拍帧位(第 0 / 98 / 196 / 290 帧):
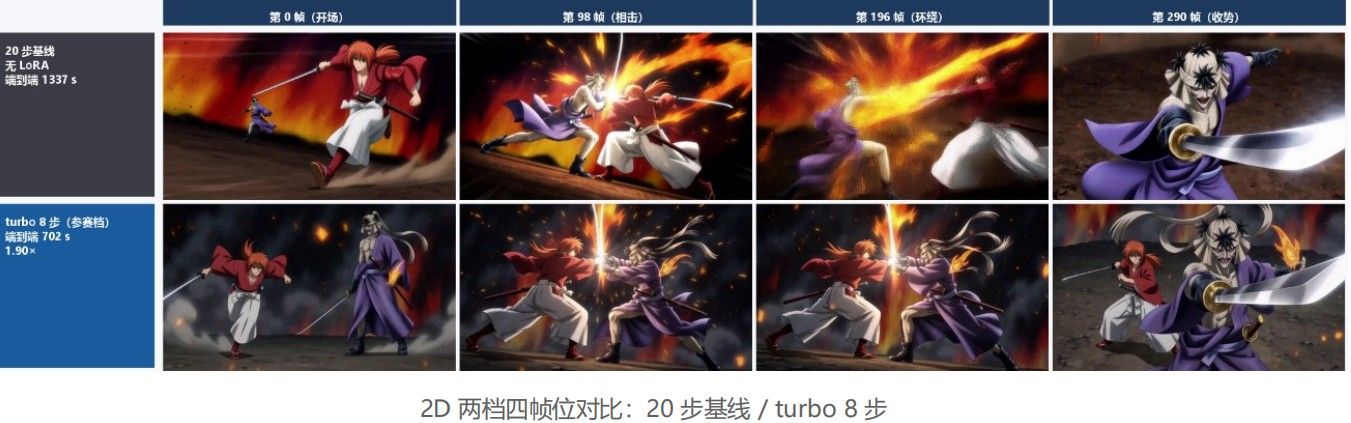
2D 两档 × 四个节拍帧位(4 步对照只跑了 3D prompt):
同帧位三档并排(第 98 帧「相击」节拍):
主观评价(同一人眼、同一屏幕、放大到 100 %):
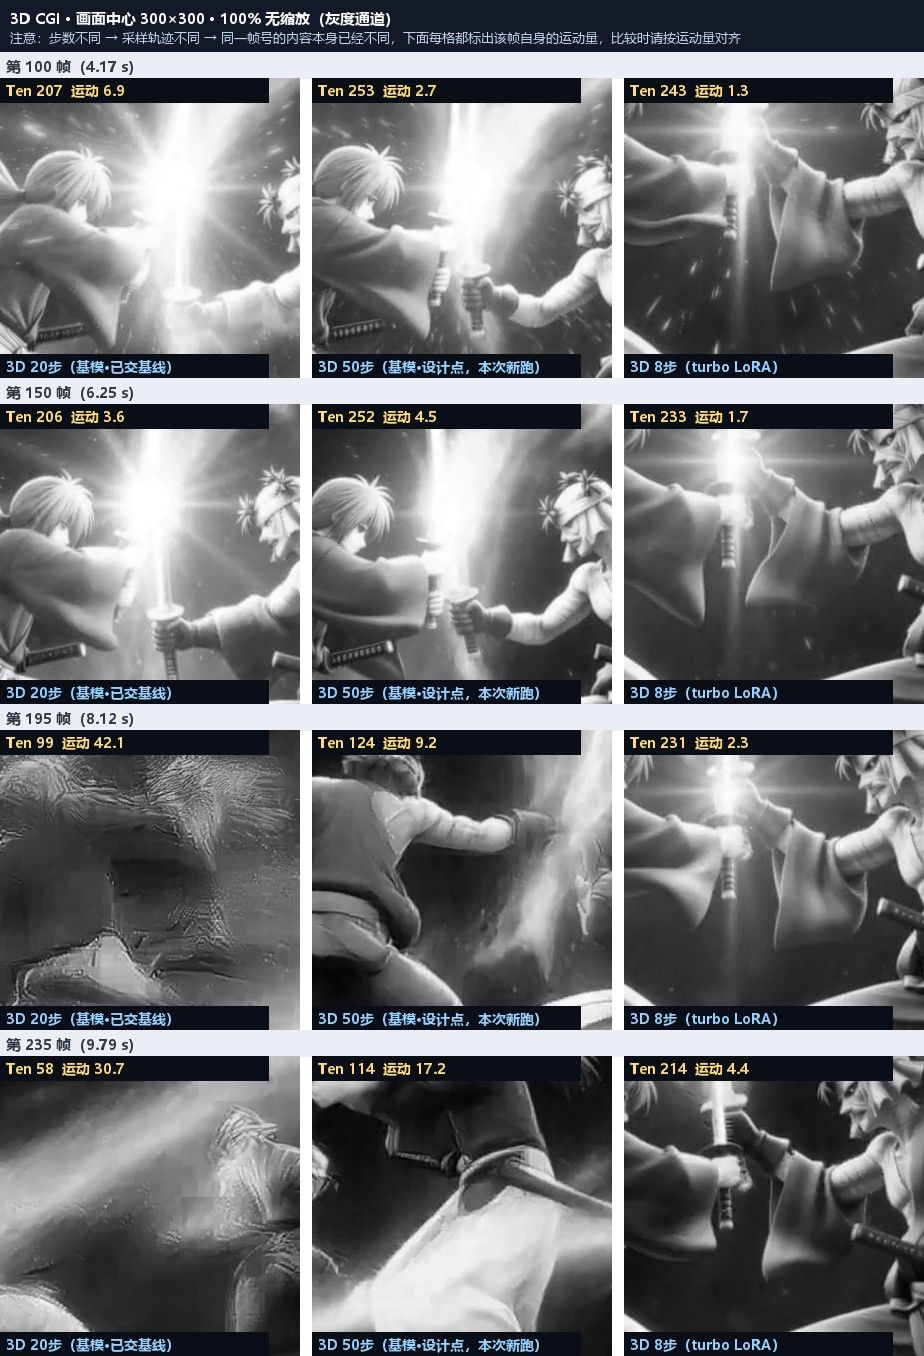
维度 20 步基线 turbo 8 步(参赛档) turbo 4 步 角色一致性(红袍/紫袍不串) 优 优 良(紫袍纹理偶有偏移) 服装/道具结构(刀镡、绑带、袴褶皱) 优 优,边缘略软一点点 中,刀镡细节糊 火焰与火星 层次丰富 与基线接近 明显变碎、块状 运动连贯性 优 优 良,个别帧位移突兀 构图与节拍完成度 四拍齐全 四拍齐全 四拍齐全,动态更冲 结论 质量上限 性价比最优,参赛选它 速度演示用 注意一个方法学问题:步数不同 → 采样轨迹不同 → 即使 seed 相同,构图也会漂移。 上表比的是「质量 / 成本」,不是「同一帧的两个版本」。要逐帧严格对齐,必须固定步数只改其他变量。
5.3 显存与内存占用对比
指标 20 步基线(无 LoRA) turbo 8 步(带 LoRA) 说明 单卡显存峰值 29.65 / 29.85 GiB 27.70 / 27.90 GiB 带 LoRA 反而低 1.95 GiB:主机池从 8 GiB 提到 12 GiB,多压了 4 GiB 权重到内存 引擎自报 settled free 2.29 / 2.50 GiB(历史同规格留档) 4.29 GiB 与 --gpu-headroom-mib 4096一致,余量是刻意留的预处理阶段 MemAvailable57 GiB / 62 GiB 57 GiB / 62 GiB 预检阈值 ≥ 18 GiB,全程富余 swap 使用 433 MiB 433 MiB 几乎没碰 OOM / 回退次数 0 0 — 5.4 3D 与 2D 同参数对比(8 步档)
指标 3D CGI 2D 动画 差 预处理 102 s 99 s −3 s 生成 585 s 584 s −1 s 端到端 707 s 702 s −5 s(−0.7 %) 文件体积 9,055,055 B 8,743,146 B −3.4 % 平均码率 5.91 Mb/s 5.71 Mb/s −3.4 % 观感 材质/光照更立体,火焰体积感强 线条干净,赛璐璐质感稳定,火星更「动画」 — 风格切换对成本几乎没有影响(±1 %),可以放心按审美选。
5.5 与 11-15 基线的可复现性核对
- 同 seed(145)+ 同参数(4 步)两次出片,mp4 字节数完全相同(12,590,935 B) → 流程确定性成立。
- 同 seed 不同步数(21 vs 9)构图明显不同 → 步数改变采样轨迹,属预期行为,不是随机性问题。
- 服务冷启动时间从 12 s 涨到 15 s:主机池从 8 GiB 提到 12 GiB 后多锁 4 GiB 页,代价 3 s,可接受。
第 6 章 复现与取证
6.1 一条命令复现
# 素材目录顶层放 6 张官方参考图 + prompt.txt
LORAS=turbo OUT_PREFIX=out bash ~/h3-make-multi.sh <素材目录> 12 8 1344x768 40
#                                     秒  步  宽x高   轮询超时(分钟)
四条内部阶段:腾显存 → 预处理 → 起服务 → 提交轮询下载 → 自动记账。
6.2 三条串行的驱动脚本(本次实际使用)
set_lora 8                                   # drop-in 指向 8 步权重
run 3D-CGI-8step   ~/h3-c16-3d   8 "LORAS=turbo OUT_PREFIX=out KEEP_LLM_DOWN=1"
run 2D-anime-8step ~/h3-c16-2d   8 "LORAS=turbo OUT_PREFIX=out KEEP_LLM_DOWN=1"
set_lora 4                                   # 换 4 步权重 + daemon-reload
run 3D-CGI-4step   ~/h3-c16-3d4s 4 "LORAS=turbo OUT_PREFIX=out"   # 最后一条恢复 LLM
还原 8 步 drop-in && systemctl daemon-reload
完整脚本:
工作流\c3-driver-run.sh。6.3 取证命令(评委可自查)
# 硬件
lspci -nn | grep -i 'vga\|display\|3d'
cat /sys/class/drm/card*/device/mem_info_vram_total
uname -a; grep PRETTY /etc/os-release; nproc; free -g
/home/magic629/ComfyUI/.venv/bin/python -c "import torch;print(torch.__version__, torch.version.hip)"

# 规格
ffprobe -v error -show_entries stream=codec_name,width,height,nb_frames,r_frame_rate \
        -show_entries format=duration,size,bit_rate -of default=noprint_wrappers=1 <成片.mp4>

# 计时
cat ~/h3-runs.csv
journalctl -u radiance-h3fullref.service --since "2026-11-16 02:57" --until "2026-11-16 03:31"
6.4 交付文件清单
H3剑心比赛-2026.11.16\
├── 参赛帖草稿.md / .docx / .pdf        论坛正文(油管链接两处待填)
├── README-清单.md / .docx / .pdf       一页速览
├── 视频\                               两条参赛成片 + 一条 4 步对照(均 1344×768 / 294 帧 / 12.25 s)
├── 证据\
│   ├── logs\          三条完整 run.log、h3-runs.csv、hardware.txt、ffprobe ×3、全量 h3-c16-run.log
│   ├── 抽帧-3D-8步\ 抽帧-2D-8步\ 抽帧-3D-4步对照\   各 4 帧 + 四帧拼图
│   ├── 对比-3D三档四帧位.png  对比-2D两档四帧位.png  对比-三档同帧.png(原 三档成片对比.jpg)
│   └── 图表-端到端耗时拆解.png
├── 工作流\             h3-make-multi.sh、h3-precheck.sh、h3-postlog.sh、c3-driver-run.sh、
│                      90-lora-turbo.conf、95-startlimit.conf、gpu-exclusive.conf、
│                      inputs.json ×3、prompt ×2
└── 参考图\             官方 6 张原图
第 7 章 结论与后续可挖空间
结论:双 R9700 32G 在纯 ROCm 原生栈上跑 MiniMax H3 Ref2VA,1344×768 / 12 s 端到端 11.7 分钟,比同机 20 步基线快 1.89×(4 步档 2.59×);全程显存峰值 27.9 GiB、内存余量最低 23 GiB,零 OOM、零回退、零兼容层。真正的瓶颈不是硬件,而是生态里现成的东西少 —— RDNA4 原生 kernel、CK 注意力后端、LoRA 显存预算这三件事都得自己填坑,填完之后 A 卡的生产力是可以正面摆上桌比的。
还能再压的地方(按性价比排序):
- 预处理缓存(约 100 s):同 prompt + 同参考图重复出片时,
prepared.pt可直接复用,跳过 Qwen3-VL 与 VAE。 - 服务常驻(约 15 s + 切换损耗):若不做双服务互斥,视频服务常驻可省掉冷启动;当前架构下可用「延迟释放」策略压缩切换次数。
- 4 步 LoRA 不截断:v0.1 权重原生 rank 384,本机被
--max-lora-rank 128截断。若显存预算允许(需再腾约 2.5 GiB/卡),4 步档画质还有明显上升空间。 - LoRA 权重离线融合:把 turbo 融进底座,可去掉每步的 LoRA 算子开销,理论上收回那 12.5 % 的单步劣化。
--kv-cache-dtype fp8/ 更短--max-model-len:腾出显存放专家权重,减少 10.79 GiB 的 PCIe 往返。
待人工完成:两条成片上传油管 → 把链接填进
参赛帖草稿第一节 → 单独发帖(标题[H3剑心比赛]开头)→ 回活动主帖登记参赛帖 ID。 -
-
-
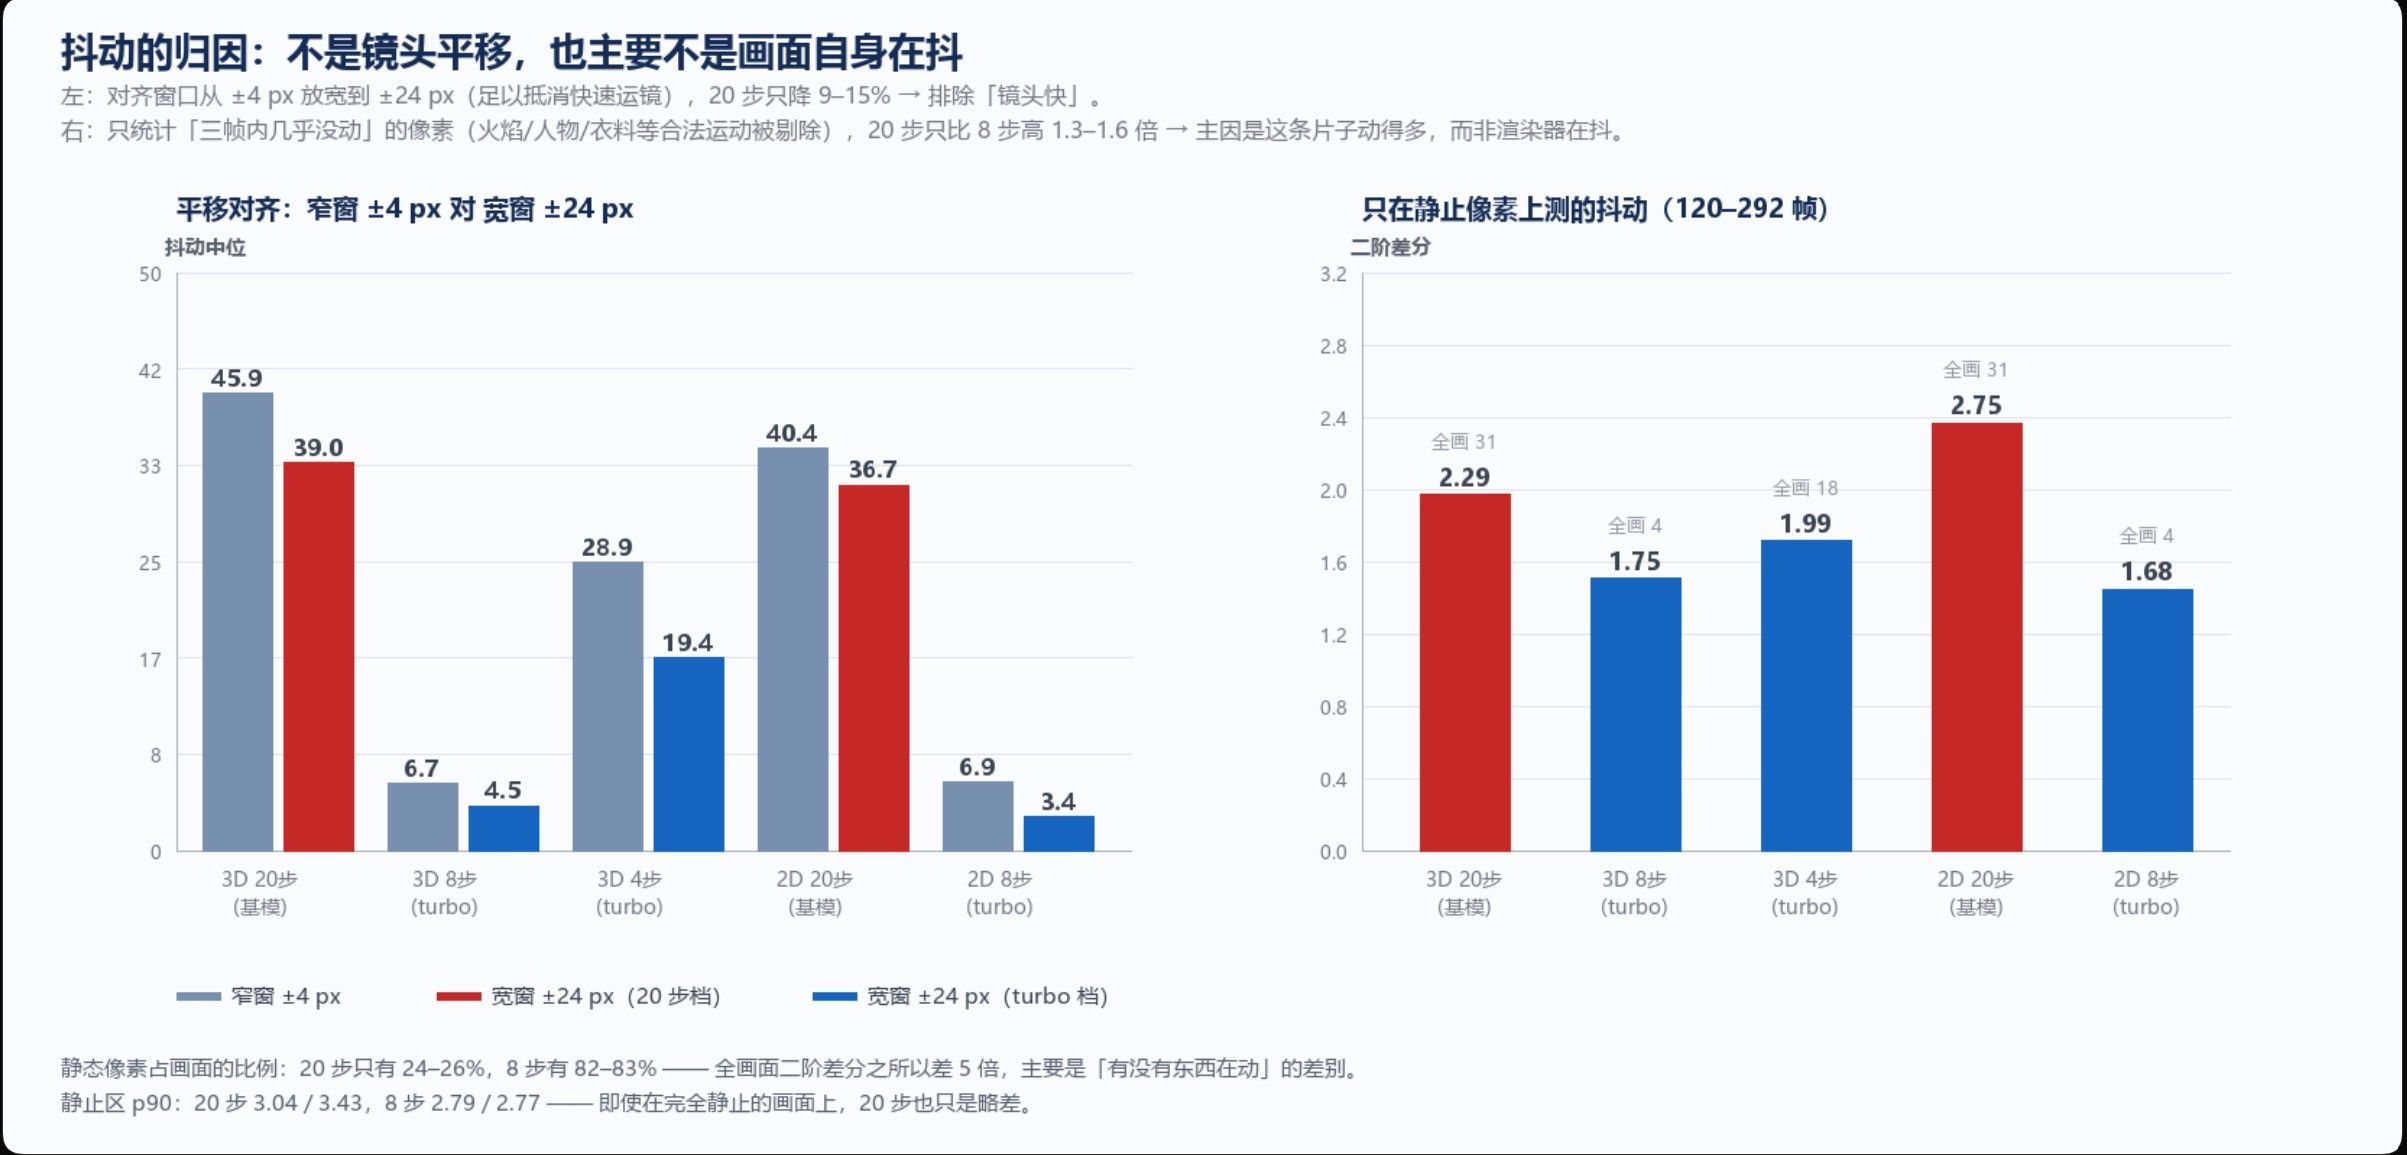
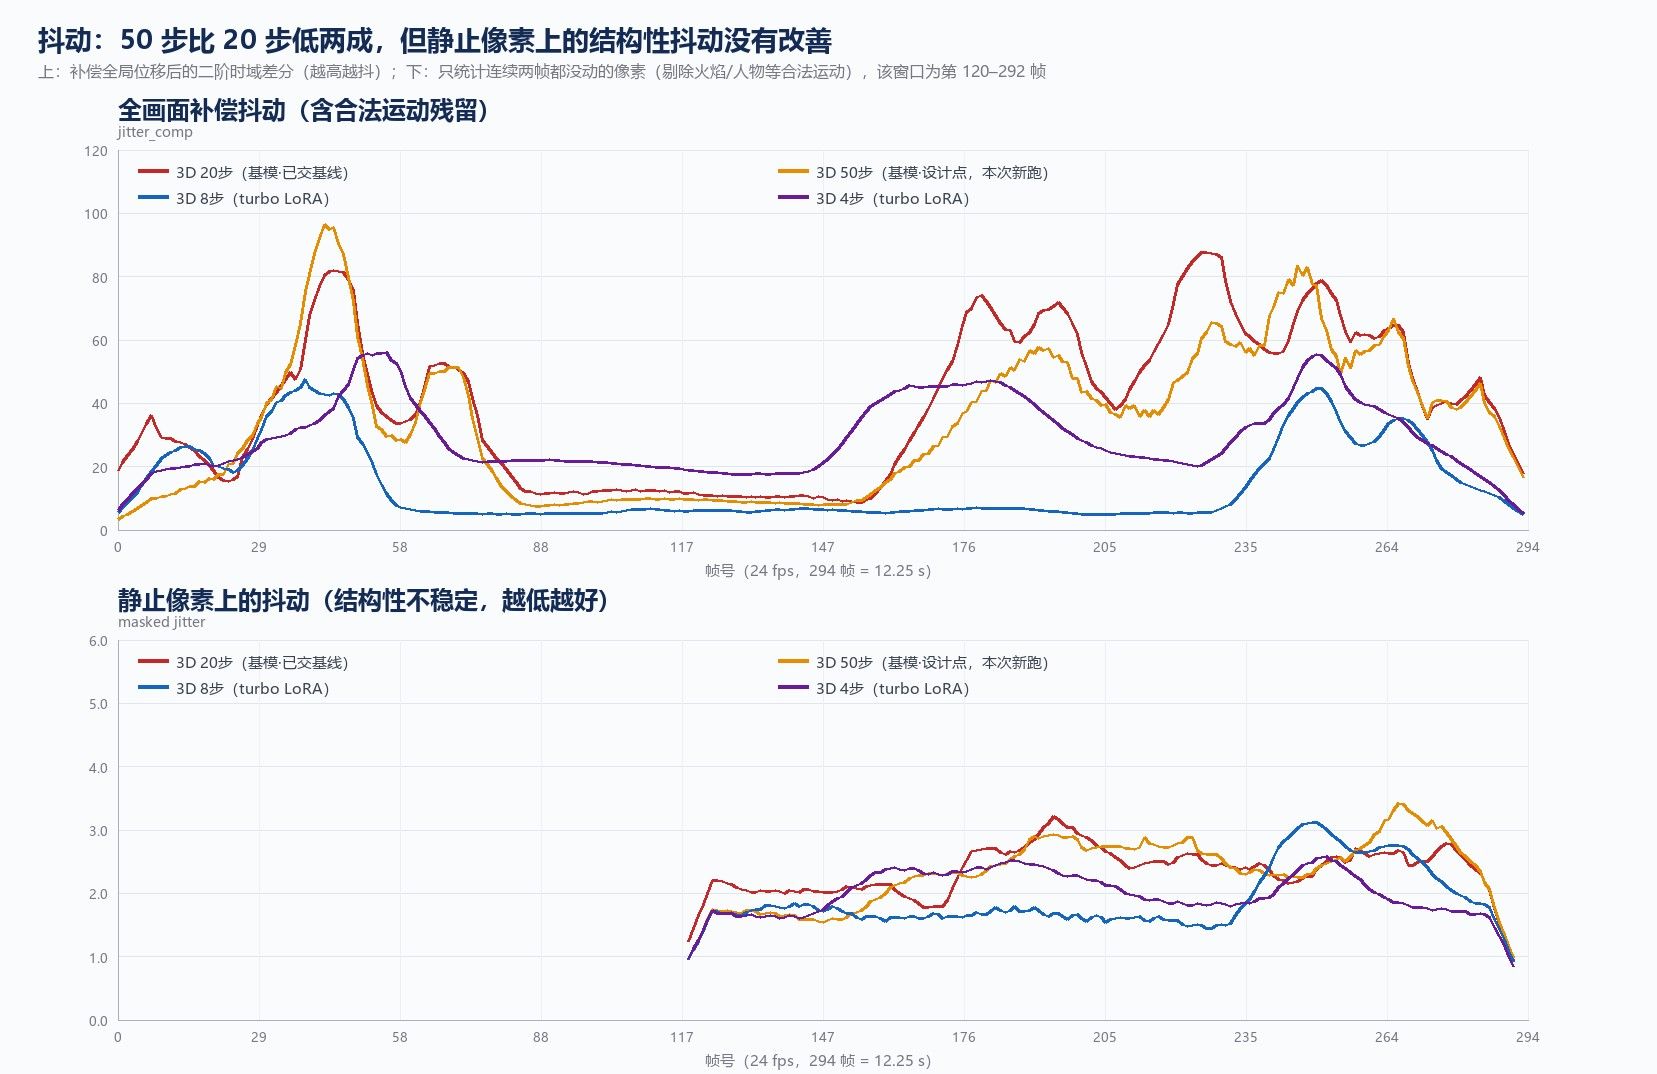
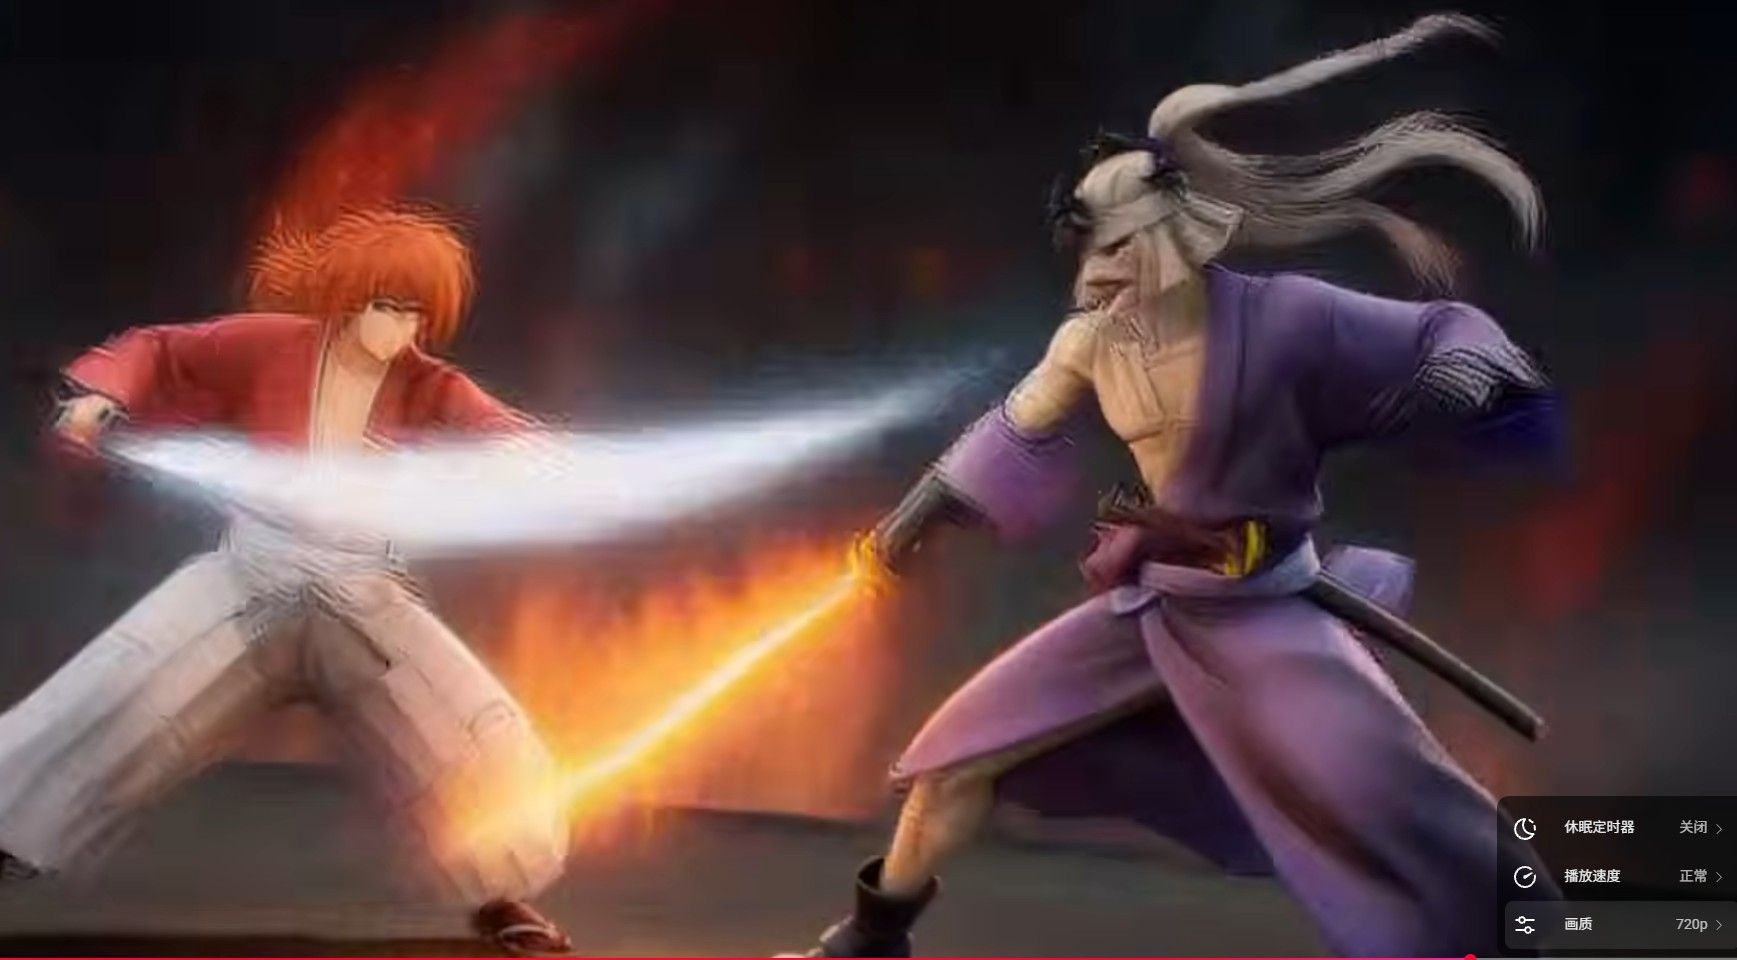
画面出现明显的像素抖动问题,其实大家的问题都是在这里,
-
画面出现明显的像素抖动问题,其实大家的问题都是在这里,
-
-
@imbiplaza-ASUS 我也试了好多个版本,8步12步都不行,20步效果明显要好不少。 是不是运动比较大的画面8步都差不多这样?
-
画面出现明显的像素抖动问题,其实大家的问题都是在这里,
-
@imbiplaza-ASUS 因为其实都用了加速LORA... 我这里有一份BF16的权重倒是可以生成试试看。

-
-
,
 T terry 将此主题从 随便聊聊 移至此处
-
@imbiplaza-ASUS 我也试了好多个版本,8步12步都不行,20步效果明显要好不少。 是不是运动比较大的画面8步都差不多这样?
-
@imbiplaza-ASUS 因为其实都用了加速LORA... 我这里有一份BF16的权重倒是可以生成试试看。
-
-
@imbiplaza-ASUS 因为其实都用了加速LORA... 我这里有一份BF16的权重倒是可以生成试试看。
-
-




 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!