跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. 想买两台华硕 DGX 跑 V4,论坛大神给个建议吧

想买两台华硕 DGX 跑 V4,论坛大神给个建议吧

已定时 已固定 已锁定 已移动 热议 AI硬件
dgxsparkdeepseek
25 帖子 12 发布者 1.1k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Bukong LiB
    Bukong LiB
    Bukong Li
    发表于 最后由 编辑
    #3

    我看网上测试有到80t/s .https://ai.rs/ai-developer/deepseek-v4-flash-304b-two-gb10?utm_source=chatgpt.com.线上api,我问v4,它说有110左右。

    1 条回复 最后回复
    0
    • terryT terry

      @Bukong-Li V4可以跑,你想和在线比肯定不行,小盒子速度慢是算力不足,带宽不足导致的,这个无解,理论性能没有实际测试过的,都是网上查到的,总体上就是能玩,但是不舒服。

      Bukong LiB
      Bukong LiB
      Bukong Li
      发表于 最后由 编辑
      #4

      @terry
      80t,你觉得有必要搞吗。会不会太慢了

      1 条回复 最后回复
      0
      • terryT
        terryT
        terry
        超级版主
        发表于 最后由 terry 编辑
        #5

        如果有这么快,你可以买,80t这都起飞了,你看多会话速度如何。而且prefill也很重要,但是sglang不怎么吃prefill说实话。

        油管:https://www.youtube.com/@抡锤者

        Bukong LiB 1 条回复 最后回复
        0
        • terryT terry

          如果有这么快,你可以买,80t这都起飞了,你看多会话速度如何。而且prefill也很重要,但是sglang不怎么吃prefill说实话。

          Bukong LiB
          Bukong LiB
          Bukong Li
          发表于 最后由 编辑
          #6

          @terry 上边
          那个链接里边测试说的。你看下靠谱吗

          1 条回复 最后回复
          0
          • terryT
            terryT
            terry
            超级版主
            发表于 最后由 编辑
            #7

            我看不出来是否靠谱,我得自己测试才知道,理论上2个盒子是能跑的,因为v4 flash是moe,激活推理参数不大。反正这事没有不靠谱的迹象,我只能这么说。

            油管:https://www.youtube.com/@抡锤者

            Bukong LiB 1 条回复 最后回复
            0
            • Bukong LiB
              Bukong LiB
              Bukong Li
              发表于 最后由 编辑
              #8
              此主題已被删除!
              1 条回复 最后回复
              0
              • terryT terry

                我看不出来是否靠谱,我得自己测试才知道,理论上2个盒子是能跑的,因为v4 flash是moe,激活推理参数不大。反正这事没有不靠谱的迹象,我只能这么说。

                Bukong LiB
                Bukong LiB
                Bukong Li
                发表于 最后由 编辑
                #9
                此主題已被删除!
                terryT 1 条回复 最后回复
                0
                • williamlouisW
                  williamlouisW
                  williamlouis
                  超级版主
                  发表于 最后由 编辑
                  #10

                  我看了很多 私人搭建这种 全量模型的帖子。
                  我个人认为都是纯娱乐性质。没有适配的需求环境投入生产都是测模大师。大投入,大折腾,最后出个帖子。有这钱直接在线api 接口用到死都够了。
                  运行起来也不会比 量化版聪明多少!而且很折腾。需要的调试时间很恐怖。
                  考虑隐私需求的话。千问 27B 目前没发现需要更高模型的需求。

                  个人主页:xlkj.org Telegram https://t.me/xlkjorg

                  1 条回复 最后回复
                  4
                  • kos orK
                    kos orK
                    kos or
                    超凡大师
                    发表于 最后由 kos or 编辑
                    #11

                    DGX Spark 顯存帶寬只有 273.2 GB/s, 比RTX 5060Ti 16GB 還慢
                    4090 有1000 GB/s
                    速度和容量兩者取捨的問題, 反正Nvidia 不會讓你滿足的 除非買企業等級的DGX Station 784GB, 但售價是10萬美金起跳

                    H 1 条回复 最后回复
                    1
                    • Bukong LiB Bukong Li
                      [[topic:post-is-deleted]]
                      terryT
                      terryT
                      terry
                      超级版主
                      发表于 最后由 terry 编辑
                      #12

                      @Bukong-Li 警告一次,以后严禁发垃圾帖子,禁言24小时,下次永久封号。违规帖子已经删除,以后发帖一定要自己看下,如果把论坛当作垃圾场,论坛也会这么对待你。

                      油管:https://www.youtube.com/@抡锤者

                      1 条回复 最后回复
                      1
                      • rock shiR
                        rock shiR
                        rock shi
                        德高望重 劳动模范
                        发表于 最后由 编辑
                        #13

                        agent场景下,多提交并发的时候你就知道多卡手了。速度直接砍半、等老半天,最关键还是能跑但是质量太差

                        主机:GPU0-3080 20g(H3),GPU1-3080 20g(Zimage)
                        副机:2x2080ti 22g,strata qwen3.8 next Flash iq3_s

                        1 条回复 最后回复
                        0
                        • A
                          A
                          applejuice
                          技术大牛 劳动模范
                          发表于 最后由 applejuice 编辑
                          #14

                          其实楼主大哥 已经比我的认知 多很多了
                          你已经在玩着 48gb 4090 我才玩 3090
                          dgx 两台 可以跑多少 我更觉得95% 论坛里的人都不懂
                          都只能网上看 问ai

                          也没有所谓值不值得,有需求可以负担 都值得
                          如果说值不值得 那我们全部都只用线上模型就好 别考虑什么性价比
                          可能dgx 两台也只是楼主的小开销

                          看了你给的链接
                          2000t/s pp 80t/s decode
                          我个人觉得是很好了

                          两台 dgx 价值在 可以用ds v4 flash
                          跑起来不会太慢 可用状态
                          一百万长上下文
                          也不会比27b dense 差
                          一个人用 agent 多并发也可以
                          大概decode 120t/s?但是prefill 还是很慢
                          一个人也不可能 6-7个并发吧?两 三个并发 勉强可用

                          比4090 5090 跑dense 当然没那么快
                          但是同等价值的4090 5090 也跑不到v4 flash

                          至于为什么低带宽 低算力 为什么在v4 flash 场景反而可用 我就不扮厉害了 我的知识从ai 来 你们了解可能都比我好

                          还是那句话,厂家的刀法很利落
                          我们只能选 我们只能需要的

                          要更好的用 v4 flash 只能上 6000 pro x2 了

                          1 条回复 最后回复
                          1
                          • kos orK kos or

                            DGX Spark 顯存帶寬只有 273.2 GB/s, 比RTX 5060Ti 16GB 還慢
                            4090 有1000 GB/s
                            速度和容量兩者取捨的問題, 反正Nvidia 不會讓你滿足的 除非買企業等級的DGX Station 784GB, 但售價是10萬美金起跳

                            H
                            H
                            happy
                            发表于 最后由 happy 编辑
                            #15

                            @kos-or

                            🙏感谢指出,这确实是个问题
                            不知道有没有在容量和带宽方面更均衡的选择?

                            kos orK 1 条回复 最后回复
                            0
                            • H happy

                              @kos-or

                              🙏感谢指出,这确实是个问题
                              不知道有没有在容量和带宽方面更均衡的选择?

                              kos orK
                              kos orK
                              kos or
                              超凡大师
                              发表于 最后由 kos or 编辑
                              #16

                              @happy

                              我覺得只有 魔改卡符合又大又快的要求 例如RTX 4090 48GB
                              一台放兩張 96GB , 三張144GB, 四張 192GB

                              目前Nvidia 的消費級市場區隔大概是
                              128GB 大又慢 300GB/s (是可以多台組在一起變快 有多快要問用過的人)
                              16GB 小但是有點快 900GB/s (RTX5070Ti, RTX5080)
                              32GB 大點用得爽(滿足各類需求) 速度超級快 1790 GB/s 但是溢價翻倍 (5090/RTX Pro 6000)

                              這樣他才能用不同的規格吸引各類消費族群購買

                              Nvidia 本來規劃要出 5070 Ti, 5080 Super 24GB(第一個容量甜蜜點) 版本 但是VRAM太貴了 目前暫時沒看到要上市的消息

                              1 条回复 最后回复
                              1
                              • soop ladiosS
                                soop ladiosS
                                soop ladios
                                劳动模范 技术大牛
                                发表于 最后由 soop ladios 编辑
                                #17

                                我已經用了好一陣子了, coding中速度30~70不定, pp約2000.
                                我來回答你的問題:
                                1. 两台 DGX Spark 跑 V4,实际生成速度大概能到多少 token/s?
                                測速約40~50, 實際coding使用視狀況約落在30~70不等.
                                2. 两台之间用 200G 网络互联,实际通信效率怎么样?
                                這有點複雜, 他每一個port有兩個rail, 各100G, 你可以用100G或200G, 看怎麼設. 我是用100G, 看他實際也沒用到100G, 就沒去搞200G了. 實測iperf約97G
                                3. 跑 V4 的时候,两台机器是比较接近“线性叠加”,还是通信开销会吃掉很多性能?
                                因為一台跑不了正常V4 flash, 所以沒辦法比較. 不過照之前別的模型的經驗,兩台速度約為一台的1.5倍左右. 我之前也跑過4台,速度又比兩台快上不少
                                4. 如果主要用途是编程、Agent、长上下文和日常本地 AI,两台 DGX Spark 是否值得?
                                我只用來編程, 主要是驅動韌體的開發跟debug, 跑claude code或codex cli , 兩台實際上約可以並行6個ctx 500K的session. 使用上是夠順了, 就看智力跟能力符不符合你的需求, 我是覺得不到優秀,但是堪用.
                                5. 有没有已经实际部署过 V4 的朋友,能分享一下真实测试数据?
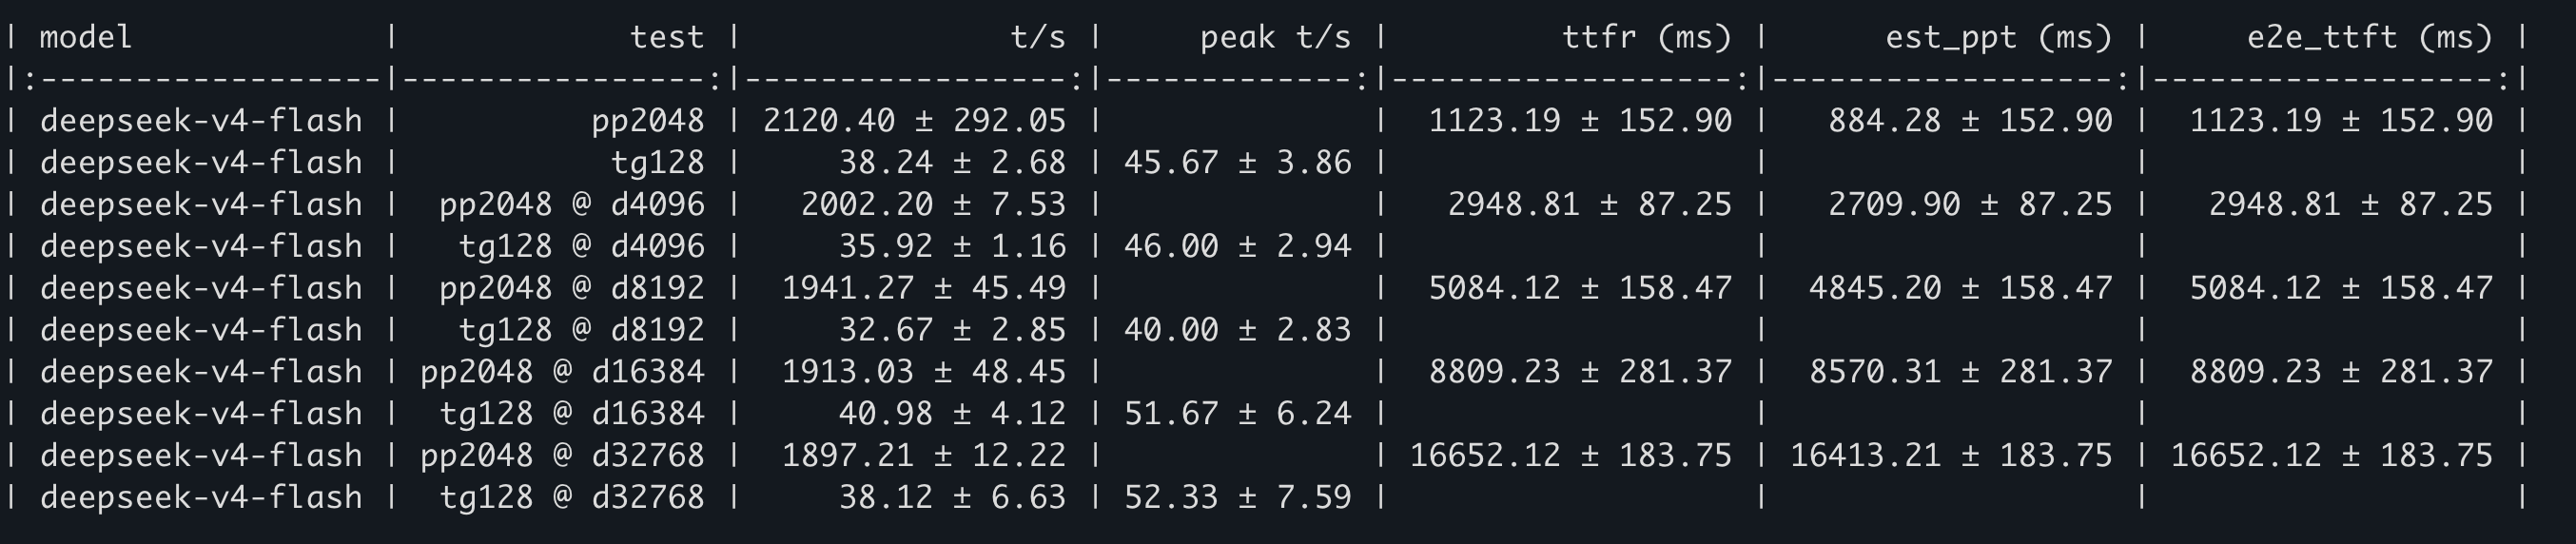
                                截圖 2026-08-15 上午8.14.24.png

                                6. 如果现在买,华硕、技嘉、微星等不同品牌的 DGX Spark,散热、SSD、稳定性方面有没有明显区别?
                                1TB 版本是不是就够了?后面自己升级 SSD 是否更划算?
                                我有華碩跟技嘉的, 感覺差不多. 兩台的話還好,反正也跑不了多大模型, 選擇也不多. 1T應該可以,有需要日後再換就好. 如果只用來跑模型的話, 速度瓶頸在頻寬, 長時間不間斷運轉可以考慮GPU降頻跑不會影響pp跟t/s太多, 溫度跟功耗會下降不少

                                最後應該考慮的是, 是否真的有這個需求? 這需要從用量跟隱私方面評估了. 兩台GB10不便宜, 漲價後更是誇張. 若是用量沒那麼多, 兩台GB10可能可以抵過10年的線上費用, 隱私又沒問題的話, 可以考慮線上使用就好. 本地用起來是舒適, 線上的是飛快, 爽度還是有差.

                                1 条回复 最后回复
                                4
                                • keding baoK
                                  keding baoK
                                  keding bao
                                  编写于 最后由 编辑
                                  #18

                                  我刚刚买了一台dell gb10 越是dgx的。之前vllm 跑125b的qwen 3.8. 速度不好,经常跑爆了。该优化也优化了。花了很多pro的codex astra , 今天在测试sgland +qwen3.8.我晚点报告token

                                  1 条回复 最后回复
                                  0
                                  • keding baoK
                                    keding baoK
                                    keding bao
                                    编写于 最后由 编辑
                                    #19

                                    image.jpeg
                                    44K prompt 冷 prefill ≈ 23–25s(codex 的 34s 略高,可能含网络/工具 schema 序列化或当时负载差异,属正常波动)
                                    prefill 吞吐 ≈ 1,900 tok/s
                                    解码吞吐 ≈ 15–16 tok/s
                                    缓存命中时首 token 仅 0.2s

                                    1 条回复 最后回复
                                    0
                                    • soop ladiosS
                                      soop ladiosS
                                      soop ladios
                                      劳动模范 技术大牛
                                      编写于 最后由 编辑
                                      #20

                                      可以用這個看看 https://github.com/blazux/qwen3.8-Flash-DGX
                                      decode約30 tok/s上下, prefill一千出頭. 品質穩定

                                      1 条回复 最后回复
                                      0
                                      • Bukong LiB Bukong Li

                                        最近准备认真折腾一下本地 AI,目标比较明确:想上两台华硕 DGX Spark,组起来跑 DeepSeek V4。

                                        目前纠结的点主要是:两台 DGX Spark 到底值不值得直接上,以及实际跑 V4 的体验究竟怎么样。

                                        我现在手上也有一张 48GB 显存的 4090,跑一些 20B~30B 级别模型没什么问题,但到了 V4 这种级别,单卡基本就不用想了。看了 DGX Spark 的资料,两台机器可以通过高速网络互联,所以理论上可以把显存和算力组合起来跑更大的模型。

                                        但我比较担心的是:理论性能和实际性能可能完全是两回事。

                                        尤其是 V4 这种超大 MoE 模型,除了显存容量,真正影响速度的还有 GPU、内存带宽、节点之间的互联带宽、推理框架以及多机通信效率。

                                        所以想请论坛里的大神帮忙判断一下:

                                        1. 两台 DGX Spark 跑 V4,实际生成速度大概能到多少 token/s?
                                        2. 两台之间用 200G 网络互联,实际通信效率怎么样?
                                        3. 跑 V4 的时候,两台机器是比较接近“线性叠加”,还是通信开销会吃掉很多性能?
                                        4. 如果主要用途是编程、Agent、长上下文和日常本地 AI,两台 DGX Spark 是否值得?
                                        5. 有没有已经实际部署过 V4 的朋友,能分享一下真实测试数据?
                                        6. 如果现在买,华硕、技嘉、微星等不同品牌的 DGX Spark,散热、SSD、稳定性方面有没有明显区别?
                                        7. 1TB 版本是不是就够了?后面自己升级 SSD 是否更划算?

                                        我不是单纯想追求“能不能跑起来”,更关心的是跑起来之后到底好不好用。

                                        如果两台 DGX Spark 能把 V4 跑到一个比较舒服的速度,那我觉得还是挺有吸引力的;但如果实际只有几十 token/s,而且多机通信损耗比较大,那可能就要重新考虑了。

                                        所以想请各位真正折腾过 DGX Spark、多机推理或者 V4 的大神给点建议。

                                        预算倒不是最大的问题,主要是不想花钱买回来以后发现实际体验和想象差太多。

                                        欢迎直接劝退,也欢迎晒实测数据 😂

                                        两台 DGX Spark 跑 V4,到底是不是目前个人/小工作室比较靠谱的方案?

                                        johnnybegoodJ
                                        johnnybegoodJ
                                        johnnybegood
                                        超凡大师
                                        编写于 最后由 编辑
                                        #21

                                        @Bukong-Li V4.1 已经出来, v4落地直接过时。 两台spark 又跑不了 v4.1 ,多么尴尬啊。 几个月后, 连4.1 都过时了, 到时候更新、智力更强的模型出来, 你怎么办?

                                        举个不恰当的例子, 本地模型只能是压缩饼干、应急食品,可以本地保存, 但是应急吃吃还行, 不适合天天吃, 填饱肚子可以, 但是没有那么香, 要想吃好, 还是得超市天天买,或者下馆子去吃。 除非你自己有非常明确的目的, 你的业务长年就用 deepseek V4就足够了, 不折腾, 收益也是明显的, 那我觉得可以自己部署, 即使这样, 我可能也是买二手的spark,尽量节省, 毕竟太贵了, 我一直觉得200多G的带宽,真的不算有性价比。

                                        1 条回复 最后回复
                                        0
                                        • soop ladiosS
                                          soop ladiosS
                                          soop ladios
                                          劳动模范 技术大牛
                                          编写于 最后由 编辑
                                          #22

                                          兩台可以跑跑glm 5.3 flash(兩台可以跑, 四台速度更快), 或是Qwen 3.8 flash next(一台也可以,但是兩台速度快很多), 這兩個評分都比Deepseek v4.1 flash高, 我實測起來的感覺也是如此.
                                          另外還讓本地glm 5.3(8台), glm 5.3 flash(2台), qwen 3.8 flash next(2台), deepseek v4.1 flash(4台)做幾個一模一樣的任務跟code review, 讓gpt-6-astra去評分, 排名大概是glm 5.3, glm 5.3 flash互有勝負, qwen 3.8 flash next 次之, deepseek v4.1 flash所有項目都墊底.
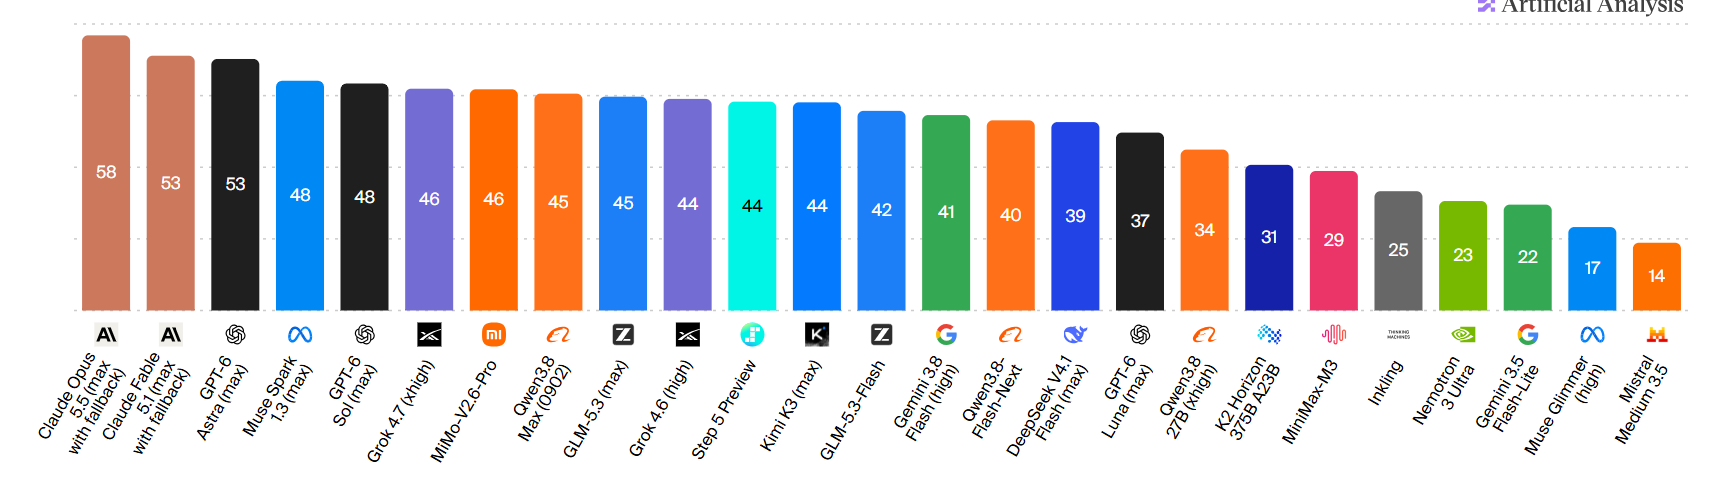

                                          螢幕擷取畫面 2026-09-28 150144.png

                                          1 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组