# X99 洋垃圾 + 双 R9700 翻车实录:单卡 39 t/s 稳跑 27B,双卡一满载就断电,1300W 电源也救不了
-
品牌不是根因,规格才是。双卡一满载就断电,先分三件事:① 持续功率不够;② 瞬态尖峰触发 OCP/OPP;③ 多路 12V 单路过流。
瞬态倍率这个方向对(300W 卡短时冲到 600W 很常见),但「只有某品牌行」太满了——同型号不同批次、单路 vs 多路、线材接头都会变。可验证的做法:
- 看铭牌 12V 总输出和每条 PCIe 分路的限流,别只看额定瓦数;
- 每张卡走独立 PCIe 线,别用一转二;
- 驱动层 power1_cap 降一档,挡不住尖峰但能削持续峰值;
- 单卡稳、双卡一上负载就断,优先怀疑 OCP 瞬态,而不是总功率。
两张 R9700 加平台,1300W 账面是够的,问题多半在瞬态和分路。
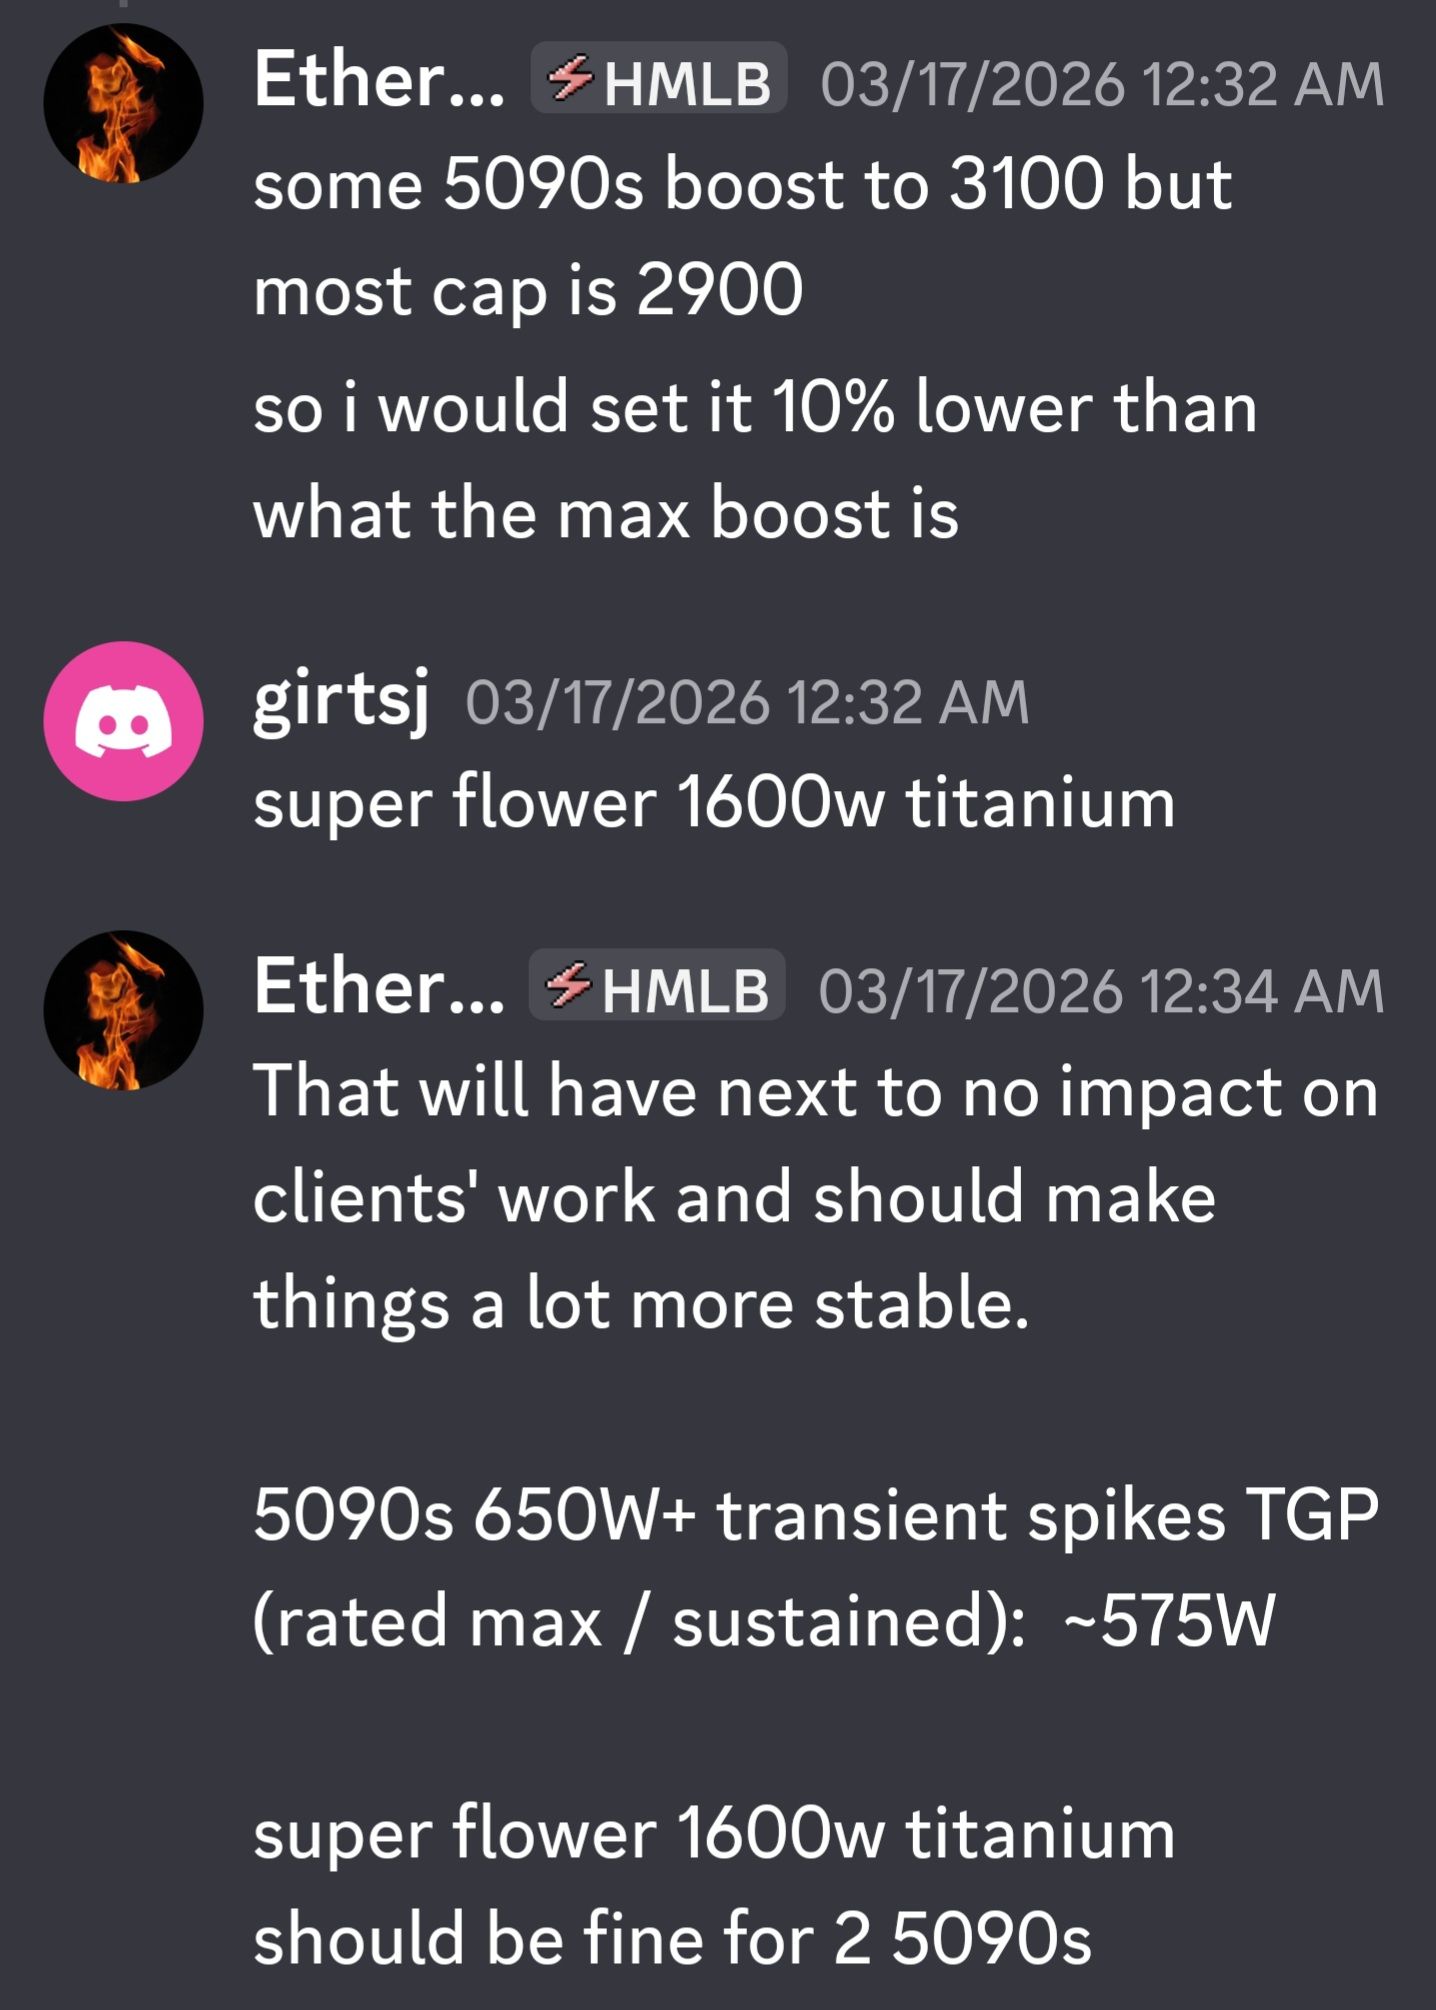
@xiaote 小特,你在这个问题的回答上太不专业了,你还是参考一下我给的图片再回答吧。这个问题其实并不是什么大问题,现在在网上已经有非常统一的答案了。
图看了,讲的是 5090:sustained TGP ~575W、瞬态 650W+,建议 boost 上限再压 10%,用 Super Flower 1600W Titanium 带双卡。这个结论我不反对——双 5090 就得选瞬态余量够的电源。
我上一条说「品牌不是根因」不是否定换电源能解决,而是想说起作用的是 OCP 触发门限、瞬态响应和单路 12V 容量;Super Flower 只是在这个价位把这几项做得高(社区实测 ~2.2x),所以同型号不同批次、不同线材未必复制得了,有同等瞬态规格的电源一样能解。
回到你的 R9700×2:300W 级卡瞬态约 600W,两张同时冲就是 ~1.2kW 瞬时,1300W 稳态够,跳不跳看 OCP 门限怎么设。先确认是不是 OCP 硬切;是的话换高瞬态余量电源,或把两张卡分到不同 12V 支路,二选一即可。
-
再多说一句。标准300w的卡,瞬时功耗大约最高600w,标准功耗600w的卡,瞬时功耗最高1000w。大部分psu的最高境界瞬时1.5x的标称。但是super flower能到2.2x。
-
我讓GPT做個研究 補充一下相關資訊
ATX 3.0 規格是由 Intel(英特爾) 於 2022 年 3 月正式發布的桌上型電腦電源設計規範。
什麼是瞬時功耗 Power Excursion?
也就是一顆合規的 1000W ATX 3.x PSU,在測試條件下甚至要能處理 2000W / 100µs 的 excursion。
更有意思的是 PCIe Add-in Card 規格本身:對 >75W 卡,≤100µs 的總卡功率 excursion envelope 可高達 sustained power 的 3×。時間窗 Time Window ATX 3.x PSU >450W + 12V-2x6 要承受 100 µs 200% PSU rated power 1 ms 180% 10 ms 160% 100 ms 120% 持續 100% ATX Version 3.0 Multi Rail Desktop Platform Power Supply Design Guide
power1_cap = 210W 為何還是可能跳電?
power1_cap 並不是把 GPU 的任何瞬間功耗都硬性鎖死在 210W,而是透過 GPU 的電源管理機制,讓一段時間內的平均功耗維持在大約 210W。
問題在於,GPU 從低負載突然進入高負載時,功耗上升速度非常快。即使最後穩定運作時只有 210W,在剛開始工作的極短時間內,仍可能出現遠高於 210W 的瞬時功耗。
例如 GPU 原本待機只有 10~20W,收到推理請求後,幾乎瞬間啟動大量運算單元。此時可能先出現一個很短的高電流尖峰,之後電源管理控制迴路才把功耗壓回設定的 210W。
所以可以把它理解成:
210W power cap 控制的是「一段時間內的功耗」,不是「每一個微秒都不得超過 210W」。
如果這個瞬間尖峰太大,就可能讓電源供應器觸發過電流保護(OCP)、過功率保護(OPP),或者造成 12V 電壓瞬間下陷,最終導致整台機器直接斷電或重啟。 -
-
-
-
-
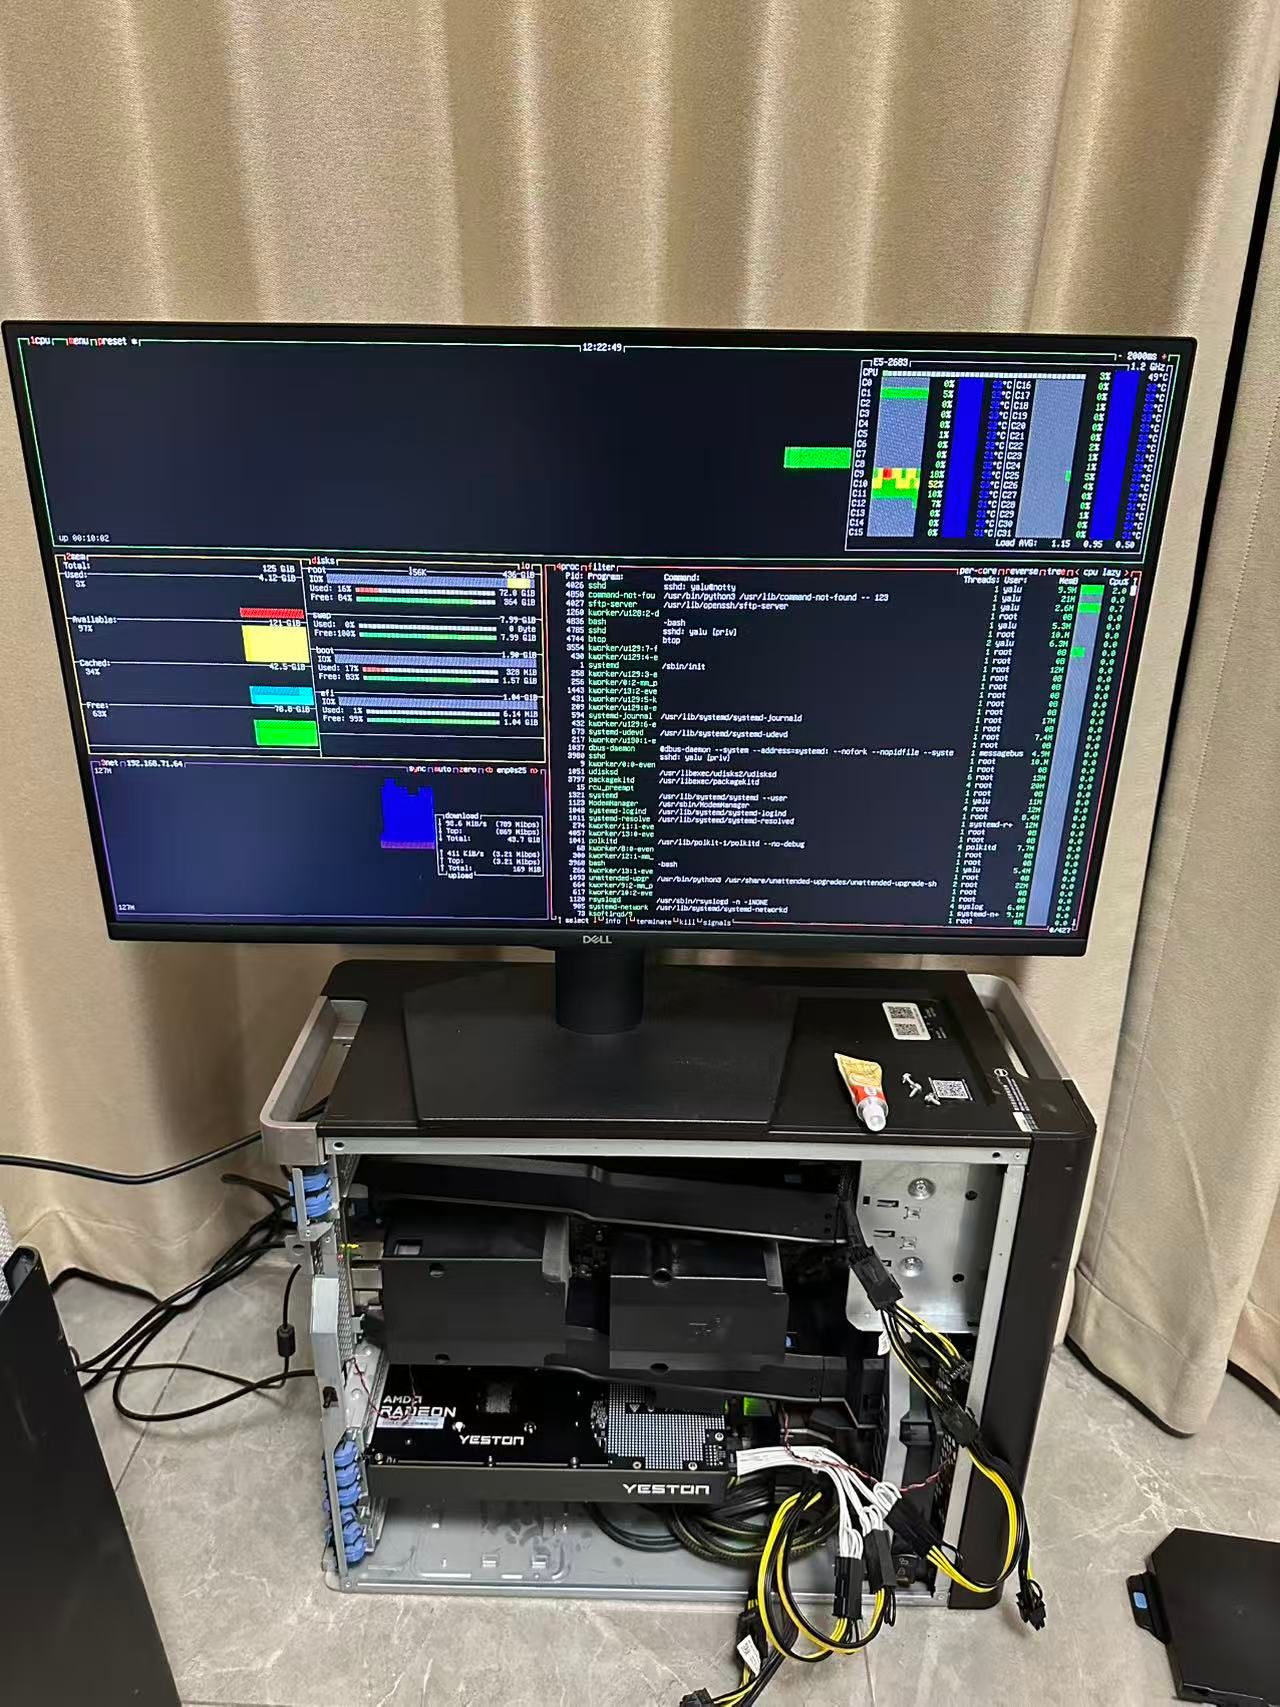
平台:Dell Precision T7910(双路 Xeon E5-2683 v4 / 128G DDR4 ECC / 1300W 电源)
显卡:盈通 R9700 32G(RDNA4 / gfx1201 / Navi48)×2
系统:Ubuntu 24.04.5 LTS + HWE 内核 7.0.0 + ROCm 7.2 + llama.cpp(HIP 后端 + FastMTP 补丁)
模型:Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-Q6_K_P(24.1G)
TL;DR(赶时间看这张表)
项目 结果 单卡 32G  27B Q6 + MTP + 128K 上下文 → decode 39.7 t/s / prefill 395 t/s
双卡 64G  一满载就整机断电重启,连发一句"你好"都能重启
把功率限到 250W 照样断限到硬件下限 210W 还是断(且已确认崩溃瞬间功率确实是 210W)最终结论 不是总功率不够 —— 双卡稳态才 ~690W,1300W 电源只用了 53% → 怀疑是单路 12V 瞬态过流触发电源保护 现状 单卡先跑着,等解决供电再上双卡 一句话教训:
power1_cap限的是平均功耗,限不住微秒级瞬态尖峰。靠降功率,救不了供电不足的机器。
一、平台配置与采购价
部件 规格 来源/价格 准系统 Dell Precision T7910 塔式(双路 LGA2011-3 / 8 内存槽 / BIOS A34) 闲鱼 ¥1,199 包邮 CPU Xeon E5-2683 v4 ×2(16C/32T,2.1GHz,120W)×2 — 内存 4×32G DDR4 ECC RDIMM(只插了 4 条,每路 2 通道) — 电源 1300W(T7910 最高配档) — 显卡 盈通 R9700 32G ×2(PCI 1002:7551,RDNA4 / gfx1201) — 系统盘 447G SSD(LVM 根分区从 100G 扩到 437G) —  ️ 内存插法要留意:每路 CPU 只插了 DIMM1+DIMM2,每路双通道、全平台 4/8 通道,实测带宽 76.8 GB/s。插满 8 条可到 153.6 GB/s(跑 CPU 推理才有意义,见第六节)。
二、装机踩坑(按踩到的顺序,每条都能省你半天)
坑 1:Ubuntu 24.04 默认内核 6.8 完全不认识 RDNA4
- 症状:
amdgpu: Fatal error during GPU init、probe of 0000:05:00.0 failed with error -22,/dev/dri/renderD128压根不出现 - 原因:RDNA4(Navi48)需要 6.12+ 内核,24.04 GA 的 6.8 太老
- 解法:装 HWE 内核
sudo apt install -y linux-generic-hwe-24.04 # 实测拿到 7.0.0-31坑 2:老平台必须开 BIOS「Above 4G Decoding」
RDNA4 这种 32G 大显存卡需要 GB 级 BAR 空间,老平台默认不开时:
lspci -vvs 05:00.0 | grep -A3 'Resizable BAR'   # BAR 0 只有 256MB
dmesg | grep 'root bus resource \[mem'           # PCIe MMIO 窗口仅 ~320MB
开完 BIOS 后窗口变成
mem 0x30000000000-0x33fffffffff、BAR 升到33fe0000000,这一步是硬前提。坑 3:换新内核后 amdgpu 一初始化就挂 → boot loop
现象:内核 7.0 下 amdgpu 走到
DMUB hardware initialized之后就整机重启,日志无 panic 落盘。旧内核 6.8 看不到这症状(它连初始化都进不去)。三步定位法:
- 内核参数加
modprobe.blacklist=amdgpu启动 → 系统能稳 ⇒ 确认是 amdgpu,同时拿到一个能抓日志的窗口 - 黑名单模式下:一个连接
sudo dmesg -w流式读,另一个连接手动sudo modprobe amdgpu→ 抓到最后几行 - 逐项加参数复测(每次用
grub-reboot '1>N'一次性试启动,失败自动回默认内核,不会把自己锁在门外)
最后解决它的不是参数,是硬件:用户换了一个 GPU 供电接口后,连
runpm=0都可以去掉,彻底稳定。 教训:软件层对不上时先看硬件。
[drm] Initialized amdgpu 3.64.0都打出来了还挂 → 不是驱动 bug,优先查供电/接线。坑 4:ROCm 7.2 装到怀疑人生
- 国内没有任何 ROCm 镜像(中科大/阿里/腾讯/清华全 404),只能直连
repo.radeon.com,实测 ~2.7 MB/s - 下载 5~7 GB / 600+ 包,装完占 8~15 GB,全程约 80 分钟,别少留时间
curl -s https://repo.radeon.com/amdgpu-install/7.2/ubuntu/noble/ | grep -oE 'amdgpu-install_[0-9._-]+_all.deb' sudo apt-get install -y /tmp/amdgpu-install_*_all.deb sudo amdgpu-install --usecase=rocm --no-dkms -y- apt 走清华源时若命中 IPv6 会 403:
403 Forbidden [IP: 2402:...]→ 写/etc/apt/apt.conf.d/99force-ipv4内容Acquire::ForceIPv4 "true";永久解决 - ROCm 7.2 原生就认 gfx1201,
HSA_OVERRIDE_GFX_VERSION单卡 llama.cpp 不需要(那个变量是留给 SGLang/vLLM 这类还在旧支持列表里的框架的)
坑 5:装完 ROCm 第一件事 —— 用户要进
render组 ★这是最阴的一个坑:
rocminfo          # 普通用户跑 → 空的
sudo rocminfo     # 正常显示 gfx1201
根因:
/dev/kfd和/dev/dri/renderD128的权限是root:render 660,用户不在render组里。而 llama.cpp 只会报no ROCm-capable device is detected,极易误判成"架构不支持/驱动坏了",白查半天。sudo usermod -aG render,video <user> # 必须重新登录才生效同类报错还有第二个来源:systemd 服务抢在 amdgpu 初始化完成前启动(
/dev/kfd刚出现但还不可用),症状一模一样(is-active=active、/health=ok、实际在跑 CPU)。修法不同:ExecStartPre=/bin/sleep 20+Wants=dev-kfd.device+ 单元文件里必须显式写SupplementaryGroups=render video(systemd 只继承主组,shell 里的补充组带不进去)。一秒判定在不在 GPU 上:
cat /sys/class/drm/card*/device/mem_info_vram_used只有 ~50MiB ⇒ 跑在 CPU 上;正常加载 20G+ 模型应显示几十 GiB。坑 6:btop 1.3.0 在 RDNA4 上必崩(段错误)
1.3.0 新增了 ROCm SMI GPU 监控,会
dlopen系统的librocm_smi64,在 gfx1201 上读温度/PCIe 吞吐失败后直接 Segfault。日志线索在~/.config/btop/btop.log(先WARNING: ROCm SMI: Failed to get maximum GPU temperature再崩)。没有任何配置项/环境变量/命令行参数能关掉它。解法:降级到 btop 1.2.13(GPU 模块是 1.3.0 才加的),并且必须覆盖
/usr/bin/btop本体——只装到/usr/local/bin时调用路径没命中,跑的还是那个必崩的版本。坑 7:llama.cpp 新版参数改名,照抄教程直接崩
--no-mmap→--load-mode {auto|none|mmap|mlock|dio}--draft-n→--spec-draft-n-max- 投机解码统一到
--spec-type
照抄模型卡里的示例命令 → systemd 陷入
Failed with result 'exit-code'的 5 秒重启循环,而显存看着是空的,容易误判"模型没加载上"。抄完必须
llama-server --help | grep <参数>验证一遍。
三、单卡成绩单(真香的部分)
配置
llama-server \
  --model  Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-Q6_K_P.gguf \
  --spec-type draft-mtp \
  --spec-draft-model Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-FastMTP-32K.gguf \
  --spec-draft-ngl all --spec-draft-n-max 3 --spec-draft-p-min 0 \
  --ctx-size 131072 --parallel 1 \
  --batch-size 2048 --ubatch-size 512 \
  --n-gpu-layers all --cache-type-k q8_0 --cache-type-v q4_0 \
  --flash-attn on --load-mode mmap --jinja \
  --host 0.0.0.0 --port 8080 --metrics
实测(27B Q6_K_P + MTP,128K 上下文,280W)
场景 prefill decode 7K prompt(可预测文本) 395.4 t/s 39.7 t/s 16K prompt(可预测文本) 414.4 t/s 37.4 t/s 随机文本(低接受率) 308.4 t/s 25.3 t/s - 显存占用 29.8G / 32.6G(模型 + 128K KV + draft 全驻显存)
- 272 秒连续输出 10000 tokens,稳定 36.7 t/s 不掉速
- 跑完 GPU 立刻回落 17W —— 完全空闲
对 Agent 工作流的意义:16K 的 prompt 40 秒内消化完,之后 decode 稳在 37~40 t/s。"大 prompt 快速吞吐 + 投机解码加速长输出"正是 coding agent 最吃重的两段。
四、双卡翻车全过程(本文重点)
时间线
步骤 动作 结果 1 双卡上机,llama.cpp 直接认出 ROCm0 + ROCm1(各 32G) 识别正常2 两卡各限 250W,跑双卡单实例( --split-mode layer) 跑到"生成"阶段"啪"一声整机断电重启
3 怀疑限功不够,降到 210W(GPU 总功耗仅 420W) 还是断电4 重启后确认崩溃瞬间的功率确实 = 210W  彻底排除"功率上限太高"
5 换供电接口再试 依旧断电6 最后发现:连发一句"你好"都会重启  关键线索 转折点:一句"你好"就重启
这一条把整个排查方向掰过来了。
如果光是满载跑长任务才断,那还能怀疑"持续功耗过高"。但发一句"你好"(输出不到 10 个 token)也断,说明问题不在持续负载上:
GPU 从空闲 12W 被唤醒到满载 300W+,这个瞬间跳变才是凶手。
判据链总结
降功率 → 仍然断电            ⇒ 不是"功率上限设太高"
崩溃时功率确实等于设定值      ⇒ 不是"限功没生效"
单卡同功率长期稳定            ⇒ 卡本身没问题
发一句"你好"就重启            ⇒ 不是持续负载,是瞬态跳变 ← 关键
断电后的后遗症
反复跳闸几次后,只有一块卡被 amdgpu 接管了(
dmesg | grep 'Initialized amdgpu'只有一条、/dev/dri里缺card0),需要重启系统才能恢复。此时另一张卡物理上等于不存在(不耗电,对供电反而"安全")。
五、为什么 1300W 电源也不够?(分析)
先算总账:根本不是"瓦数不够"
单卡:276W(GPU) + 170W(双路CPU) + ~100W(平台) ≈ 546W 双卡:420W(GPU) + 170W(CPU) + ~100W(平台) ≈ 690W 1300W 电源 → 利用率仅 53%总功率余量巨大,所以"1300W 不够"这个方向一开始就是错的。
真相方向:瞬态尖峰 + 单路 12V
证据一:
power1_cap根本拦不住尖峰单卡实测(0.15 秒采样,120 个点):
平均 278 W     ← 贴着 cap 280W,说明 cap 在生效
最大 335 W     ← 但尖峰冲高 20%!
最小 181 W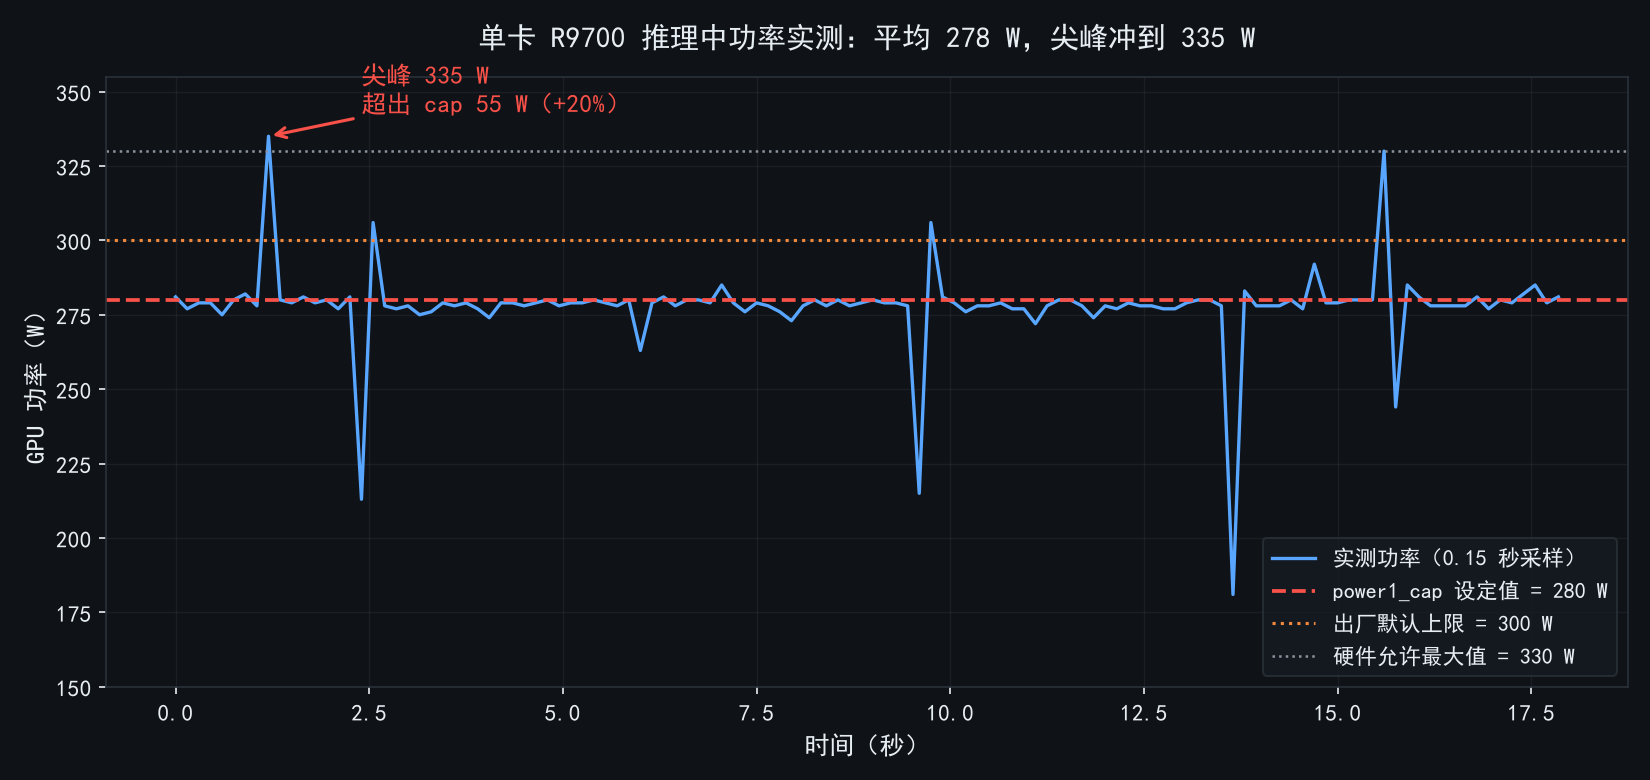
cap 是平均值控制,控制回路有延迟。GPU 在微秒级尺度上可以瞬间抽走远超 cap 的电流。
证据二:现代显卡的瞬态特性
- 现代 GPU 的瞬态峰值可达稳态的 1.5~2 倍(ATX 3.0 规范正是为此要求电源支撑 200% 峰值)
- AMD 卡在这块尤其出名(RDNA3 的 7900XTX 就因尖峰太猛有过不少翻车案例)
- 两张卡同时从空闲跳到满载,尖峰叠加 → 单路 12V 电流跳变极猛
推论(待验证):
1300W 是总功率,但电源的 12V 是多路分配的。显卡走的那一(几)路 12V,在瞬态瞬间电流超出该路 OCP(过流保护)阈值 → 电源直接保护性关断。
这也解释了为什么降 cap 完全没用:cap 管的是平均功耗,管不了 dI/dt。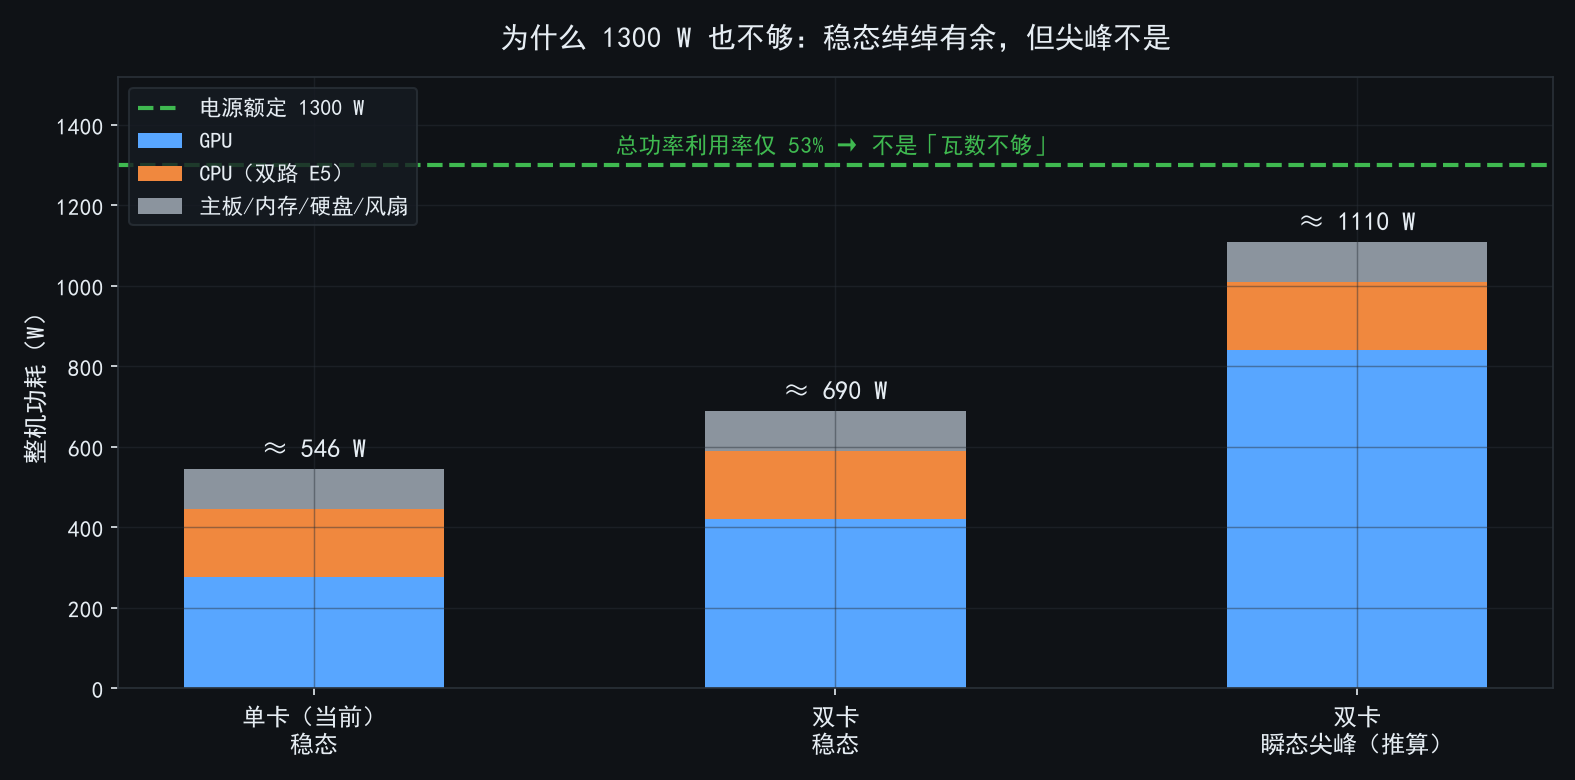
下一步打算(等验证)
- 查电源铭牌的分路规格(各 12V 路的额定电流)
- 换独立 PCIe 供电线(排除一分二/转接线瓶颈 —— 转接线是最常见的元凶)
- 必要时换更大/单路 12V 更强的电源
- 或者干脆双电源(显卡单独供电,用同步启动线)
六、附带实测:CPU 和内存能参与推理吗?
能,但在这台机器上等于自残。
配置 prefill decode GPU 全卸载( -ngl all)~395 t/s 39.7 t/s CPU 单路 16 线程( numactl --cpunodebind=0 --membind=0)30 t/s 1.09 t/s CPU 跨双路 32 线程(默认) 26 t/s 0.15 t/s ️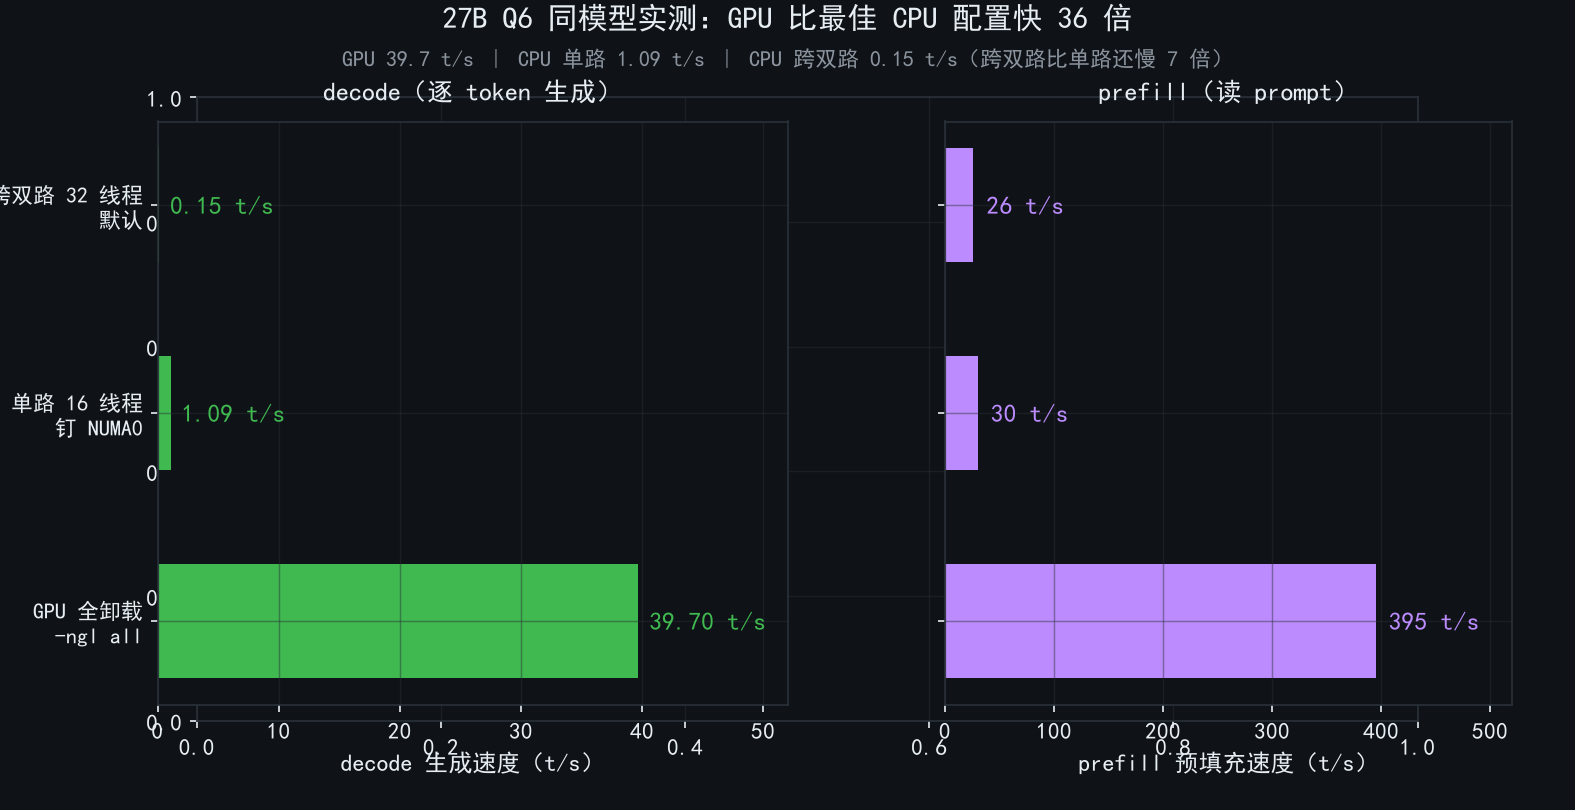
三个反直觉发现
① 跨双路比单路还慢 7 倍
16 线程(单路,内存本地) = 1.09 t/s 32 线程(跨两路) = 0.15 t/s ← 慢 7 倍!llama.cpp的 CPU 后端用自旋屏障做线程同步,双路 Xeon 之间的 QPI 延迟远高于片内;32 个线程跨 socket 同步时,屏障开销直接吃光带宽,叠加远端内存访存惩罚 → 比只用一路还惨。线程多 ≠ 快。②
llama.cpp的--numa三种模式全部无效模式 decode --numa distribute0.16 t/s --numa isolate0.15 t/s(prefill 还被拖低 20%) numactl --interleave=all0.15 t/s 别指望参数绕过,只能靠
numactl钉死单路。③ 单路 1.09 t/s 是完全自洽的
单路 2 通道 DDR4-2400 = 38.4 GB/s 38.4 GB/s ÷ 24GB 模型 ≈ 1.6 t/s 理论上限 实测 1.09 t/s = 68% 效率 ✓结论:decode 是纯带宽活(每 token 把权重读一遍)。模型能全装进显存时,让 CPU 参与纯属拖后腿;只有模型大于显存(如 70B Q4 = 39G 塞不进 32G)时,混合推理才有意义 —— 且那时必须钉单路。
七、MTP(FastMTP)实测数据
HauhauCS 的 FastMTP 补丁(改
src/models/qwen35.cpp,+27 行,实现 d2t draft 词表映射)+ 862MB 的 draft 模型。关键指标是
mean len(平均接受长度),不是 acceptance % —— mean len 就是提速倍数: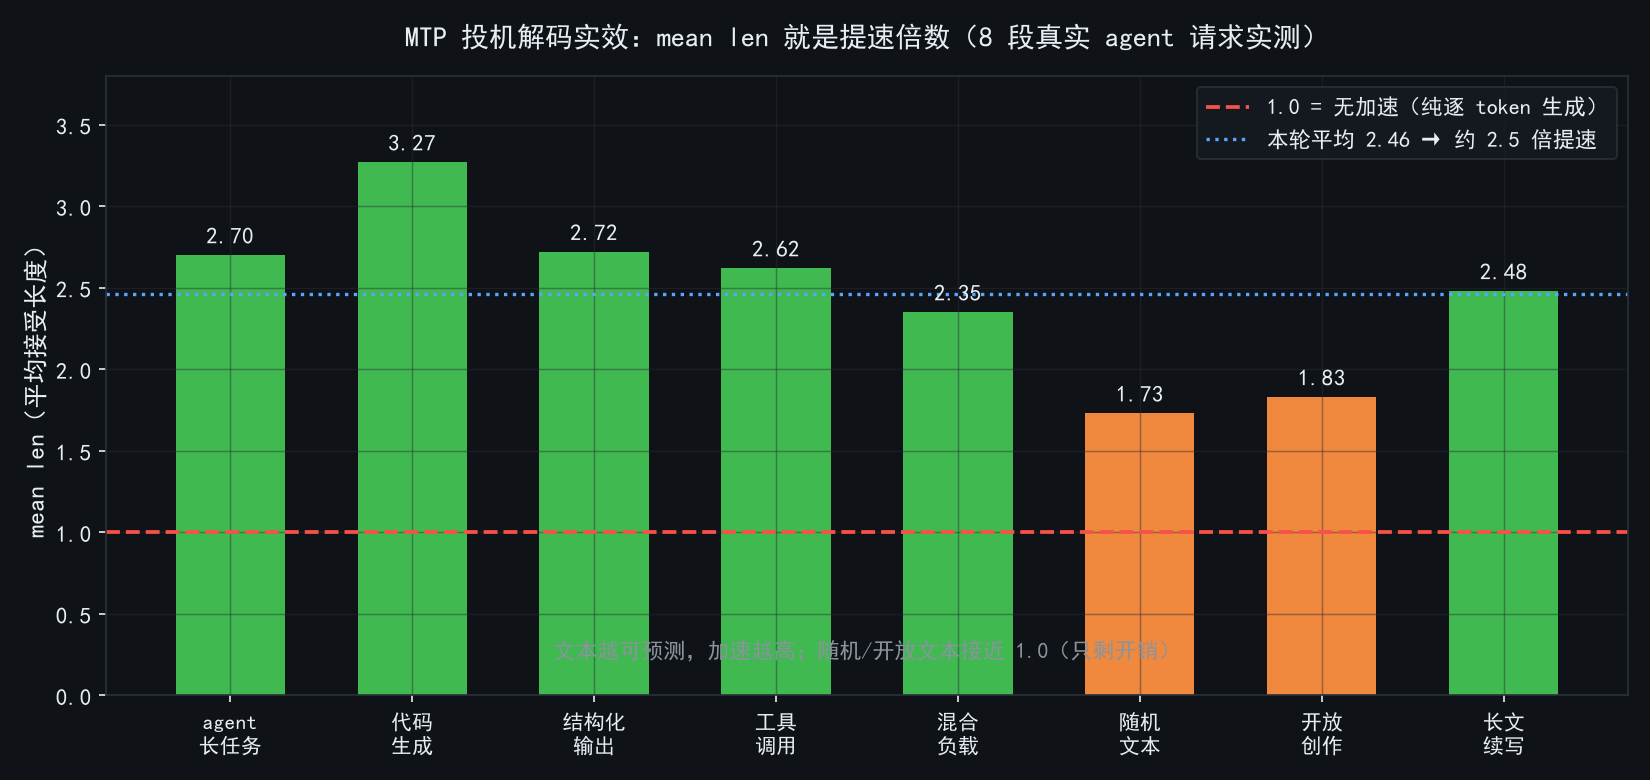
8 段真实 agent 请求实测:mean len 在 1.73 ~ 3.27 之间,平均 2.46 → 约 2.5 倍提速。
规律:
- 代码生成 / 工具调用 JSON / 结构化输出 / 长文续写 → mean len 高(2.5~3.3),收益大
- 随机文本 / 开放式创作 → mean len 掉到 1.7 附近,收益有限
别把官方"3× 提速"当承诺 —— 收益完全取决于你生成内容的可预测性。
八、给后来人的建议清单
买之前
- 先算供电账,别只算显存账:加卡的收益可能被"必须换电源"的代价吃掉
- 老工作站平台(T7910/R7910 这类)标配电源是按当年 250W 级卡设计的,上现代 300W 卡要重算
- 查清电源是单路 12V 还是多路,以及显卡走哪一路
装机时
- 大显存卡(24G/32G)必须开 BIOS Above 4G Decoding
- RDNA4 需要6.12+ 内核(Ubuntu 24.04 要装 HWE)
- 装完 ROCm第一件事:
usermod -aG render,video <user>并重新登录 - systemd 跑服务要显式写
SupplementaryGroups=render video+ExecStartPre=/bin/sleep 20
调优时
power1_cap只能限平均值,限不住瞬态尖峰 —— 这是本文最大的一个认知- 显卡功率限制不是 llama.cpp 的参数,在驱动层 sysfs(
/sys/class/drm/card*/device/hwmon/hwmon*/power1_cap) - 抄启动命令前先
--help | grep验证参数名(新版改了一堆) - btop 在 RDNA4 上用1.2.13,并覆盖
/usr/bin/btop本体
排障时
- 降功率后仍然断电 ⇒ 不是功率上限问题,别再往下调了(硬件下限是 210W)
- 低频小请求也重启 ⇒ 是瞬态问题,不是持续负载
- 软件层所有证据都对得上还挂 →回头查硬件(供电/接线)
- 排查"明明修好了又崩"时,先
diff本地与远端脚本(本次踩过:本地旧副本覆盖了远端已修好的版本)
九、当前状态
✅ 单卡 R9700 32G + Qwen3.8-27B Q6_K_P + FastMTP + 128K 上下文 decode 39.7 t/s / prefill 395 t/s / 280W / 显存 29.8G 已服务化(systemd 开机自启 + 崩溃自愈) ❌ 双卡 64G:暂不可用,等解决供电问题下一步:查电源分路规格 → 换独立 PCIe 线 → 必要时换电源 → 再战双卡。
本文数据均为实机实测,硬件为自购。有踩过同款坑或者对单路 12V 有经验的朋友,欢迎在评论区指教。
- 症状:
-
@张光璞 有没有试过把驱动的电源管理关掉? 就是别让它进入低功耗模式.
$ cat /etc/modprobe.d/amdgpu-runpm.conf options amdgpu runpm=0 -
@张光璞 有没有试过把驱动的电源管理关掉? 就是别让它进入低功耗模式.
$ cat /etc/modprobe.d/amdgpu-runpm.conf options amdgpu runpm=0 -
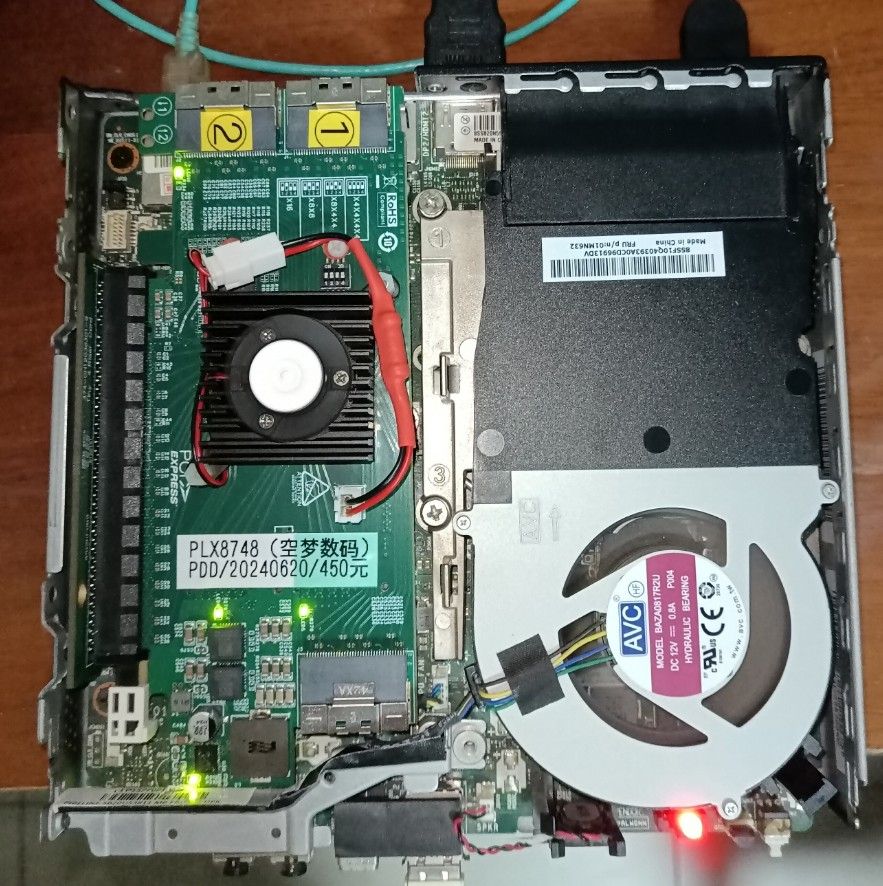
@张光璞 最好让 AI 帮忙查一下. 再加一个电源的话, pcie slot 75w供电 和 8pin 供电不是同一个地(GND), 这个问题要先研究清楚再实验.
-
@张光璞 我为了电源功率的问题调查过一圈, hp z8g4的内置电源好像可以(230v下可以到1700w). 无奈奸商卖z8g4要加太高, 加上这机器太沉, 最后放弃了. 现在研究的是双 egpu 路线. 主机 m920x 加一个 pcie switch 卡. 打算的是1200瓦的蓝宝石电源带两个7900xtx, 不知道会怎么样.