双R9700 + 华南X99 + 128g ddr3内存部署 qwen3.8-flash-next
-
双卡 R9700 部署 Qwen3.8-Flash-Next(MXFP4 + LRU Expert Cache)
这是一份在 2× AMD Radeon AI PRO R9700 上,用 davetha 的 r9700-lru-expert-cache 把 Qwen3.8-Flash-Next 跑起来的实操记录。
结论先写在前面:
- 这不是 SGLang,也不是 llama.cpp GGUF。主路径是 打过补丁的 vLLM(Flash-Next fork)+ Docker + ROCm 10。
- 专家权重放不进 64 GB 显存,必须 CPU 常驻 + UVA 过 PCIe。davetha 的工作是把「固定热专家」改成 GPU 侧 LRU 槽位,decode 时按路由换专家。
- 官方 README 把 host RAM 写轻了。真正吃内存的不是 30 GiB 专家,而是 约 47.75 GiB 的 PLE / n-gram 表,而且只能待在 CPU。
- 作者机器是 EPYC + 更大内存;我这边是 X99 + 128 G + 双 R9700。128 G 能启动 160k 上下文,但 PLE 会进 NVMe swap,prefill 会明显慢于作者数字。
如果你只想复现作者那套 256k / ~90–140 tok/s,先看内存账,再决定要不要上这套。
性能参数与实测
启动档位(影响速度 / 显存 / 内存)
双卡是 张量并行 TP=2(
--tensor-parallel-size 2),不是数据并行。参数 git原作者默认(大内存) 本机已跑通 作用 并行 TP=2 TP=2 一份模型切两张卡 LRU 热槽 HOT_GB15 GB / rank 15 GB / rank 显存里的可变专家槽;不要上 16,会挤死 KV 上下文 max-model-len262144(256k) 163840(160k) 几乎只改 GPU KV,不改 PLE 体积 并发 max-num-seqs4 1(单用户) 同时请求数 max-num-batched-tokens(NBT)4096 2048 chunked prefill 块大小;越大越吃瞬时显存 MTP 4 draft tokens 4 speculative_config.num_speculative_tokensKV dtype fp8 fp8 --kv-cache-dtype fp8专家 offload --cpu-offload-gb 40 --cpu-offload-params experts同左 主层 MXFP4 专家走 host UVA PLE VLLM_PLE_CPU_OFFLOAD=1同左 ~47.75 GiB n-gram 表钉在 CPU 视觉 image 8 / video 1 关掉( MM_IMAGE=0 MM_VIDEO=0)省一点 host / 调度 gpu-memory-utilization0.97 0.97 尽量把剩余显存给 KV prefix cache / chunked prefill 开 开 长上下文必备 服务端口 :8057:8057容器内 :8000本机 wrapper 默认写的是
MAXLEN=32768;上面 160k 是启动时MAXLEN=163840覆盖的。160k 起来后日志:GPU KV cache size: 519,545 tokens(相对 163840 约 3.17×,NSEQ=1用不满)。本机吞吐(X99 + 128 G + PLE 在 NVMe swap)
测的是 32k 服务窗口、MTP-4、
NSEQ=1、NBT=2048、text-only、LRU 15 GB/rank。数字是客户端扣掉 TTFT 之后的 decode,以及prompt_tokens / prefill_time。场景 Prefill Decode MTP 接受率 tok / step 8k × 3(真实文本,逼 LRU 换入,不是 pad) 594.6 ± 5.7 tok/s 68.1 ± 10.0 tok/s 38.8 ± 7.7% ~2.55 / 5 32k prefill 580–588 tok/s — — — 32k decode( ignore_eos+ 半句续写)— 91.2 ± 11.7 tok/s 56.5 ± 7.0% ~3.27 / 5 同一轮里用 padding 灌满 32k 时,模型会复读
pad,接受率会被抬到 70%+,不能当日常数字。上面 8k 的 ~39% 更接近正常写说明。较早一版(padding 提示、单次 128 gen,仅供对照):
场景 Prefill Decode MTP 接受率 8k / 8192 tok 560.9 tok/s 71.8 tok/s 64.6% 32k / 32000 tok(复读 pad) 620.2 tok/s 82.1 tok/s 74.2%(虚高) MTP 深度用 metrics 核对:
draft_tokens / drafts = 4。curl -s http://127.0.0.1:8057/metrics | grep ^vllm:spec_decode作者机器(对照,不要当成这台的数)
作者
fp8headarm:EPYC + 更大内存 + NBT 4096 + 256k + MTP-4 + 15 GB 热槽。单流 greedy,bench/ab3.pybest-of-3:prose JSON code prefill 静态热集(baseline) 60.2 68.6 89.1 ~3066 tok/s 启动脚本默认(fp8head) 93.1 138.8 128.5 ~3551 tok/s 作者并发(c8 全栈,aggregate tok/s):B=1 → 105.7,B=4 → 165.7。
怎么读这两台的差距
- Decode:这台 32k 约 91 tok/s,已经进作者 prose 区间(~90–96);JSON/code 作者更高,这边没按那三个 probe 复测。
- Prefill:这台稳定 ~580–600 tok/s,作者 ~3500,大约 6×。主因是 47.75 GiB PLE 在 swap、X99/更窄的 CPU 通道、NBT 2048。prefix-cache 命中时日志里也能看到 ~3200 tok/s 的 prompt,说明 GPU 算力不是 600 那个量级。
- 接受率随文本变:散文/说明大约 40–56%;数字、复读、JSON 会高很多。
1. 这套栈在做什么
Qwen3.8-Flash-Next 是超大 MoE:每层 512 个 routed expert,主层专家是 MXFP4。两张 R9700 一共约 64 GB VRAM,装不下全部专家。
常见做法是:
- 专家放 host RAM,GPU 用 UVA 按需读(PCIe)。
- 启动时钉一份「热专家」在显存里,其余走冷路径。
davetha 仓库改的是第 2 步:显存里仍是那批槽位(默认每卡 15 GB),但 槽里装谁由 GPU 上的两个 HIP kernel 在 decode 步之间决定。作者测到生产 trace 上 PCIe 专家流量从 432 MB/step 降到 86 MB/step,MoE grouped GEMM 从 21.1 ms/step 降到 4.2 ms/step。
同时还有一串 kernel-count 补丁(W4 draft LM head、fused SiLU-quant、fp8 target lm_head、MTP-4 等)。启动脚本默认复现的是 README 里的
fp8headarm。权重用的是作者测数字的同一份 checkpoint:
项 值 Hugging Face davetha/q38fn-heretic2-mxfp4-fp8来源 Qwen/Qwen3.8-Flash-Next 的 MXFP4/FP8 量化,Heretic 去审查 体积 约 118 GiB,25 个 safetensors shard 专家 主层 MXFP4;attention / MTP / PLE 为 FP8 换一份别的 Flash-Next 量化也能起,但不要拿它和 README 表格比速度。
2. 硬件:作者 vs 这台机器
作者 big这台机器 主板 / CPU Supermicro H12SSL-NT + EPYC 74F3(Milan,八通道) 华南 X99-T8 + Xeon E5-2696 v3 GPU 2× R9700(推理只用这两张;同机还有 2× MI210) 2× R9700(DID 0x7551,gfx1201,各约 32 GB)卡间 P2P 两卡各占一条 Gen4 root port,没有 P2P X99 双 root port;这套 vLLM 不依赖 Direct-P2P Host RAM 未写死,但从 EPYC + MI210 推断远大于 128 G 128 G 安装,系统可见约 126 GiB 宿主机 ROCm — 7.2.4 容器内 PyTorch ROCm 10 / torch 2.11(gfx1201) 同左 权重盘 未特别强调 必须放 NVMe ext4,不要从 NTFS/FUSE 直接 serve 要点:GPU 型号一致,差的是主机内存、CPU 通道、PCIe 代数。 作者仓库默认
GPUS=1,2,那是因为他机器上 0/3 是 MI210。纯双 R9700 一般是0,1。不要抄他的 GPU 下标。本机 grub 里有
intel_iommu=on(以及amdgpu.ras_enable=0)。对这套 LRU/UVA 路径,P2P 不是启动门槛——作者自己也没有 P2P。
3. 内存账(启动前先看这个)
按仓库
docs/VRAM_CENSUS.md,q38fn-heretic2-mxfp4-fp8+ TP=2 +--cpu-offload-gb 40 --cpu-offload-params experts:块 每 rank / 全局 住哪 PLE / n-gram 表( *.ple.*)47.75 GiB(全局,不切 TP) CPU only( VLLM_PLE_CPU_OFFLOAD=1),不能卸 GPU主层 MXFP4 experts 29.88 GiB / rank Host,UVA( --cpu-offload-gb 40)LRU 热槽 默认 15 GB / rank VRAM 常驻 VRAM 权重(attn / GDN / MTP experts / lm_head / embed / 视觉塔等) 约 6 GiB / rank VRAM KV(fp8) 显存扣完热槽和权重后的剩余 VRAM 加载峰值比稳态更凶:PLE worker 要把约 48 GiB 表物化,两个 TP worker 同时把 checkpoint 读进来。这就是 94 G、甚至 128 G 也会在启动瞬间被 OOM killer 干掉的原因。
上下文长度几乎只改 GPU KV,不改 PLE 体积。 把
max-model-len从 32k 调到 160k,救不了 host OOM。经验阈值(单用户、桌面还要活着):
Host RAM 现实 ≤ 96 G 几乎必然 OOM(PLE worker 先被杀) 128 G + NVMe swap 能起来;稳态下 PLE 大部分在 swap 作者那类大内存服务器 PLE 留在 DRAM,才能接近 README 的 prefill 128 G 上测到的稳态(服务已起来、空闲):
进程 RSS Swap PLE worker( multiprocessing.spawn)~4.1 GiB ~44.7 GiB VLLM::Worker_TP0/TP1各 ~42.4 GiB 各 ~0.6 GiB 整机 swap — ~48 GiB / 71 GiB 也就是说:进 swap 的主要是 n-gram / PLE,不是专家权重。 Decode 打到冷 n-gram 项时会先从 NVMe 换页回来。
4. 部署流程
下面按「别人机器也能照着做」写。本机封装脚本路径单独标出。
4.1 系统准备
- 宿主机 ROCm 能看到两张卡:
/dev/kfd、/dev/dri/renderD128/renderD129,用户在video+render组。 - 安装 Docker,当前用户进
docker组(否则每次sg docker -c '...')。 - 国内拉
ghcr.io时,要把代理配到 dockerd / containerd,只 export 当前 shell 的http_proxy不够。Ubuntu 24.04 + Docker 29 用 containerd-snapshotter 拉层,必须给两个服务都写 drop-in。 - 关掉会占住这两张卡的其它推理进程。启动脚本会等 VRAM 掉下来,但不会把别人的 server 杀掉。
本机脚本:
~/sglang/scripts/install_docker_flashnext.sh   # apt 装 docker,加组
~/sglang/scripts/setup_docker_proxy.sh         # dockerd/containerd → Clash :7897
4.2 下载权重,并拷到 NVMe ext4
# 可用镜像站;本机脚本默认 HF_ENDPOINT=https://hf-mirror.com
hf download davetha/q38fn-heretic2-mxfp4-fp8 \
  --local-dir /path/to/fast-nvme/q38fn-heretic2-mxfp4-fp8
本机先下到机械盘 NTFS(
/mnt/hdd/llm-storage/...),再 byte-identical 拷到:/home/minghao/models/q38fn-heretic2-mxfp4-fp8 # 125913314711 bytes,25 shards不要从 NTFS / FUSEBLK(
/mnt/hdd、/mnt/ssd这类)直接给容器 serve。加载本来就把 host RAM 顶满,再叠加 FUSE 延迟,失败面更大。本机下载脚本:
~/sglang/scripts/dl_q38fn_mxfp4.sh。4.3 准备 64 G NVMe swap(128 G 机器强烈建议)
系统自带
/swap.img只有 8 G,装不下 PLE。在 系统盘 NVMe 上另做一块:sudo fallocate -l 64G /home/$USER/swap-fn.img sudo chmod 600 /home/$USER/swap-fn.img sudo mkswap /home/$USER/swap-fn.img sudo swapon /home/$USER/swap-fn.img # 可选:写入 /etc/fstab,prio 高于系统 8G swap本机实际是
/home/minghao/swap-fn.img(64 G,prio 10)+/swap.img(8 G)。合计约 72 G。警告: 启动失败时 Linux OOM killer 可能连 GNOME/GDM 一起杀掉。启动前关掉重桌面负载,容器建议加
--oom-score-adj=-300,保护图形会话。4.4 克隆仓库、做镜像、打补丁
git clone https://github.com/davetha/r9700-lru-expert-cache
cd r9700-lru-expert-cache

docker build -t local/q38fn-rocm10:try1  -f docker/Dockerfile       docker/
docker build -t local/q38fn-rocm10:build -f docker/Dockerfile.build docker/

# 确认容器能看见两张卡
docker run --rm --device /dev/kfd --device /dev/dri --group-add video \
  -v "$PWD:/repo" --entrypoint python3 local/q38fn-rocm10:try1 /repo/docker/probe.py

./prebuilt/install.sh                # 预编译 gfx1201 的 librlu.so 等
./patches/apply_patches.sh --dry-run # 必须先 dry-run
./patches/apply_patches.sh
./templates/fetch.sh                 # 修正过的 Qwen chat template
镜像分层:
- 底包是
ghcr.io/davetha/vllm-flashnext:DevQwenNextFlash(原tcclaviger/vllm:DevQwenNextFlash的镜像;上游 Docker Hub tag 已于 2026-09-05 删除)。 - 再 overlay torch 2.11 + ROCm 10 / gfx1201,得到
local/q38fn-rocm10:try1。 - 闭源
r4d.so/libfp8hip_gemm.so在底包里,不在这个 git 仓库里。
本机一键:
~/sglang/scripts/setup_flashnext_images.sh。4.5 确认 GPU 下标
python3 - <<'PY'
import torch
for i in range(torch.cuda.device_count()):
    p = torch.cuda.get_device_properties(i)
    print(f"HIP {i}: {torch.cuda.get_device_name(i)}  {p.total_memory/2**30:.1f} GiB")
PY

# R9700 = PCI device id 0x7551
for d in /sys/class/drm/card*/device; do
  [ "$(cat $d/device 2>/dev/null)" = "0x7551" ] && echo "R9700: $(basename $(dirname $d))"
done
纯双 R9700:
GPUS=0,1,VRAM_CARDS填上面打印的cardN。混插 MI210 时不要用 0,1。4.6 启动
官方默认(大内存、256k、并发 4、NBT 4096):
export MODELS_DIR=/path/to/parent-of-checkpoint
export MODEL=/models/q38fn-heretic2-mxfp4-fp8
export GPUS=0,1
export VRAM_CARDS="card0 card1"   # 按 4.5 改
./launch/launch_q38fn.sh 15 262144
服务默认 宿主机
:8057→ 容器:8000,容器名q38fn-mxfp4,served nameq38fn-mxfp4。本机 128 G、单用户、已验证能起来的组合:
MAXLEN=163840 NSEQ=1 NBT=2048 \
  sg docker -c 'bash /home/minghao/sglang/scripts/start_flashnext_lru.sh'
本机 wrapper:
~/sglang/scripts/start_flashnext_lru.sh
它会设好MODELS_DIR=/home/minghao/models、自动扫0x7551的VRAM_CARDS、关掉图/视频,然后exec:~/r9700-lru-expert-cache/launch/launch_q38fn.shWrapper 文件里的默认是
MAXLEN=32768;160k 要靠环境变量覆盖,没有写死。启动脚本还会:
docker rm -f旧容器,并等到名字释放、两张卡 VRAM 降下来;- 挂
profiles/hot_profile.json做 per-layer 热启动; - 打开 LRU / fuse / MTP-4 / PLE CPU offload / expert UVA 等全部实测有效的开关。
关键容器环境(完整列表见
launch/launch_q38fn.sh):VLLM_PLE_CPU_OFFLOAD=1 VLLM_R4D_HOT_PROFILE=/hot/hot_profile.json VLLM_R4D_HOT_GB=15 VLLM_R4D_LRU=1 VLLM_R4D_LRU_FUSE=1 VLLM_UVA_OFFLOAD_EMBED=1 VLLM_UVA_OFFLOAD_VISUAL=1关键 vLLM 参数:
--tensor-parallel-size 2
--kv-cache-dtype fp8
--cpu-offload-gb 40 --cpu-offload-params experts
--gpu-memory-utilization 0.97
--enable-prefix-caching --enable-chunked-prefill
--speculative-config {"method": "mtp", "num_speculative_tokens": 4}
5. 怎么确认 LRU 真的开了
日志里必须看到类似:
r4d LRU expert cache: ON (lib ..., thresh 0.50, max_inserts 64, grid 8x16)
r4d LRU: layer 0 -> 257 slots warm-started from the profile hot set,
         read-through above 128 distinct experts/step
如果是
r4d unavailable,某个 bind-mount 补丁 import 失败,MoE 会静默退回官方热集。数字全部作废。这是静默失败,启动后务必搜这一行。160k 启动成功时,本机日志里还有:
GPU KV cache size: 519,545 tokens相对 163840 的并发大约 3.17×(
max-num-seqs=1时用不满)。32k 启动时同一套账只报过约 219k KV tokens——hybrid GDN/QSA 的 KV 预算会随max_model_len重算,不要拿两次启动的 KV 行直接相减。256k(
MAXLEN=262144+HOT_GB=15)在这台 128 G 上 没有稳定跑通。若要试,先把HOT_GB降到 13–14,给 KV 留空,并接受更差的 expert hit rate。
6. 本机踩过的坑
6.1 以为调 ctx / 并发就能避开 OOM
不行。OOM 发生在 PLE 物化 + 双 TP 读盘 的加载峰值。
max-num-seqs=1、关掉视觉塔,只能减 GPU 和一点 host,砍不掉那 48 GiB 表。6.2 从 HDD / NTFS 直接加载
权重 118 G,加载期两个 worker 一起读。FUSE NTFS 会把峰值拉得更长,更容易和桌面抢内存。先
cp -a到 NVMe ext4,再挂进容器。6.3 没有 swap、或 swap 在慢盘上
8 G 系统 swap 不够。64 G 文件必须在 NVMe 上。PLE 进 swap 之后服务能活,但 prefill 会掉一个数量级。
6.4 启动失败杀桌面
一次「瘦身重启」触发 OOM killer,GDM/GNOME 被干掉。后来给容器加了
--oom-score-adj=-300。启动时不要同时编译、浏览器开几十个标签、或再拉一个大模型。6.5 Docker 代理只配了 shell
docker pull ghcr.io/...走 containerd,必须给docker.service和containerd.service写HTTP_PROXY。本机 Clash 只开 7897,没有 7890。6.6 IPv6 / 错误的 GPU 下标
部分网络环境下 pull 会卡在 IPv6。GPU 下标抄作者的
1,2会直接跑到不存在的设备或错误的卡。6.7 中文长上下文提前 EOS
32k 散文、提示里写「忽略 padding」时,模型可能立刻 EOS、生成空。测 decode 要用
ignore_eos,或用半截句子当续写(本机用过「LRU缓存的核心思想是」)。
7. 实测说明
吞吐、接受率、作者对照和启动档位见文首 「性能参数与实测」。这里只补测量时要注意的两点:
- 用 padding 灌满上下文会让模型复读
pad,MTP 接受率虚高;要用真实长文或半句续写,并考虑ignore_eos。 - 核对 MTP-4:
http://127.0.0.1:8057/metrics里draft_tokens / drafts应为 4。分词走POST /tokenize。
8. 调用
OpenAI 兼容,模型名
q38fn-mxfp4,端口 8057。Flash-Next 默认开 thinking。关思考是请求级参数,不是启动开关:
{ "model": "q38fn-mxfp4", "messages": [{"role": "user", "content": "你好"}], "chat_template_kwargs": {"enable_thinking": false} }reasoning_effort、preserve_thinking同样生效。
9. 本机文件速查
# 权重
/home/minghao/models/q38fn-heretic2-mxfp4-fp8          # 线上用,NVMe ext4
/mnt/hdd/llm-storage/q38fn-heretic2-mxfp4-fp8          # 原始下载,NTFS,不要直接 serve

# 仓库与镜像
/home/minghao/r9700-lru-expert-cache
  launch/launch_q38fn.sh
  profiles/hot_profile.json
  build/MOUNTS.txt
  build/kernels/librlu.so
local/q38fn-rocm10:try1                                # 运行镜像

# 本机封装
~/sglang/scripts/start_flashnext_lru.sh
~/sglang/scripts/setup_flashnext_images.sh
~/sglang/scripts/dl_q38fn_mxfp4.sh
~/sglang/scripts/install_docker_flashnext.sh
~/sglang/scripts/setup_docker_proxy.sh

# Swap
/home/minghao/swap-fn.img                              # 64G,需 swapon
/swap.img                                              # 系统 8G

# 服务
容器 q38fn-mxfp4 ,宿主机 http://127.0.0.1:8057
再拉起上次 160k 配置:
MAXLEN=163840 NSEQ=1 NBT=2048 \
  sg docker -c 'bash /home/minghao/sglang/scripts/start_flashnext_lru.sh'
10. 若你要在自己机器上复现
按优先级:
- Host RAM ≥ 192 G 更好;128 G 必须配大块 NVMe swap,并接受 PLE 换页。
- 权重放 NVMe ext4。
- 先
apply_patches.sh --dry-run,再启动。 - 日志确认
r4d LRU expert cache: ON。 - 单用户先
NSEQ=1、MM_IMAGE=0 MM_VIDEO=0,起来再加并发和视觉。 HOT_GB不要上 16:作者测过 16 GB 槽位会把 KV 挤到起不来(「2.4 GiB KV needed, 2.12 GiB available」)。15 GB + NBT 4096 是他那边每次都能起来的最大组合。本机内存更紧,NBT 先用 2048。- 不要在桌面会话高峰期重启这个容器。
参考
- 仓库与 Quickstart:https://github.com/davetha/r9700-lru-expert-cache
- 权重:https://huggingface.co/davetha/q38fn-heretic2-mxfp4-fp8
- 官方模型:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- vLLM 底包镜像:
ghcr.io/davetha/vllm-flashnext:DevQwenNextFlash
-
我395小盒子halogen-flash-next竟然prefill贏你雙卡搭MXFP4好大一圈.....希望AMD官方把Halogen買下來,搞給所有RDNA家族,讓一眾兄弟少折騰少走彎路吧
-
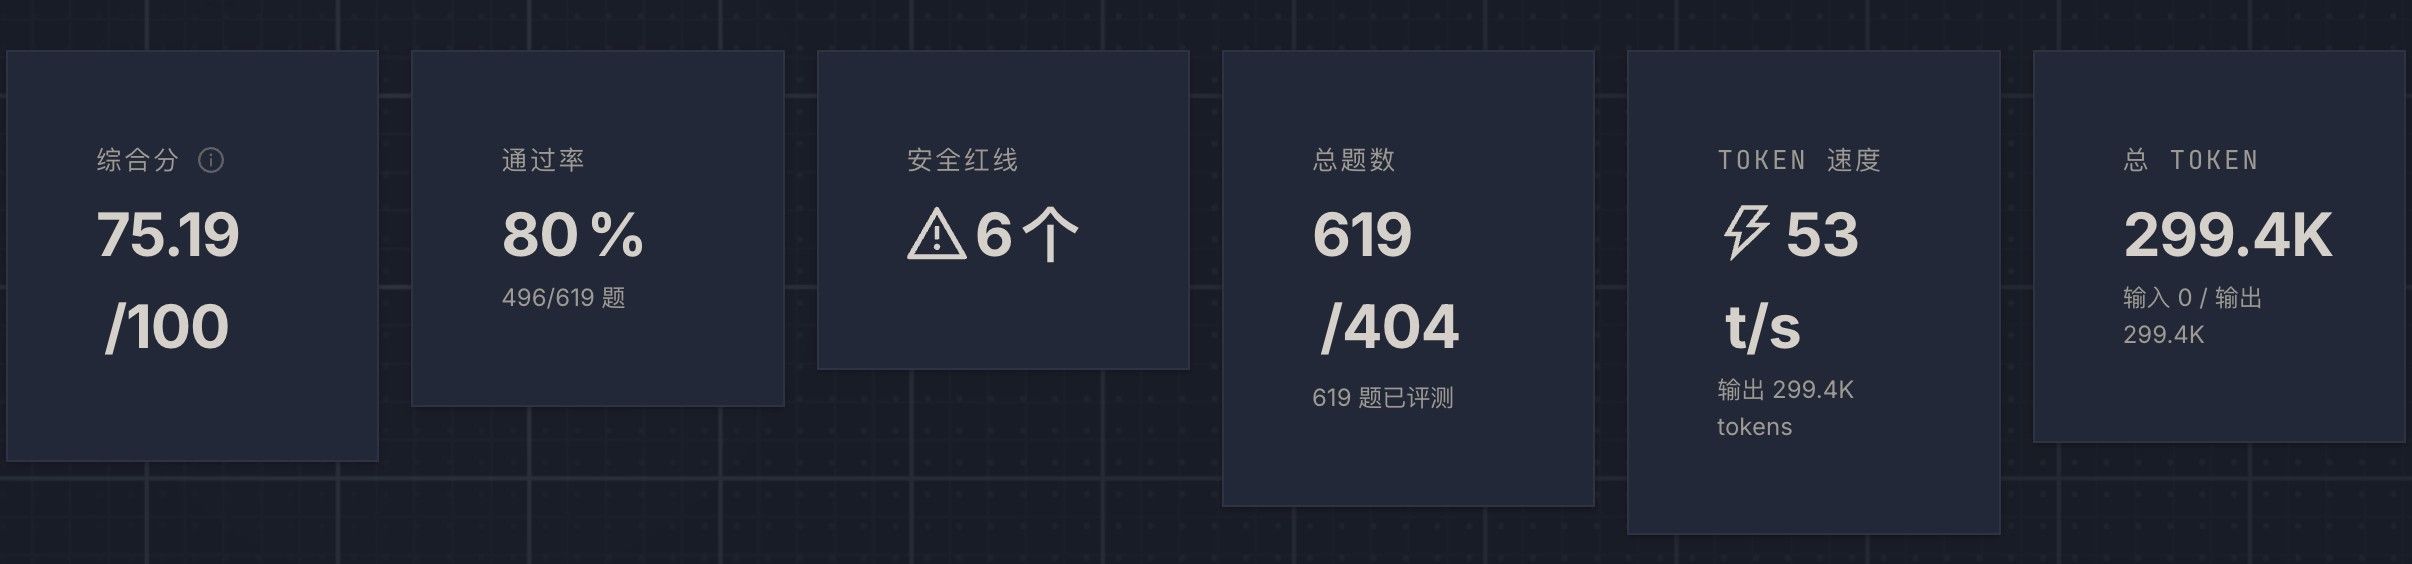
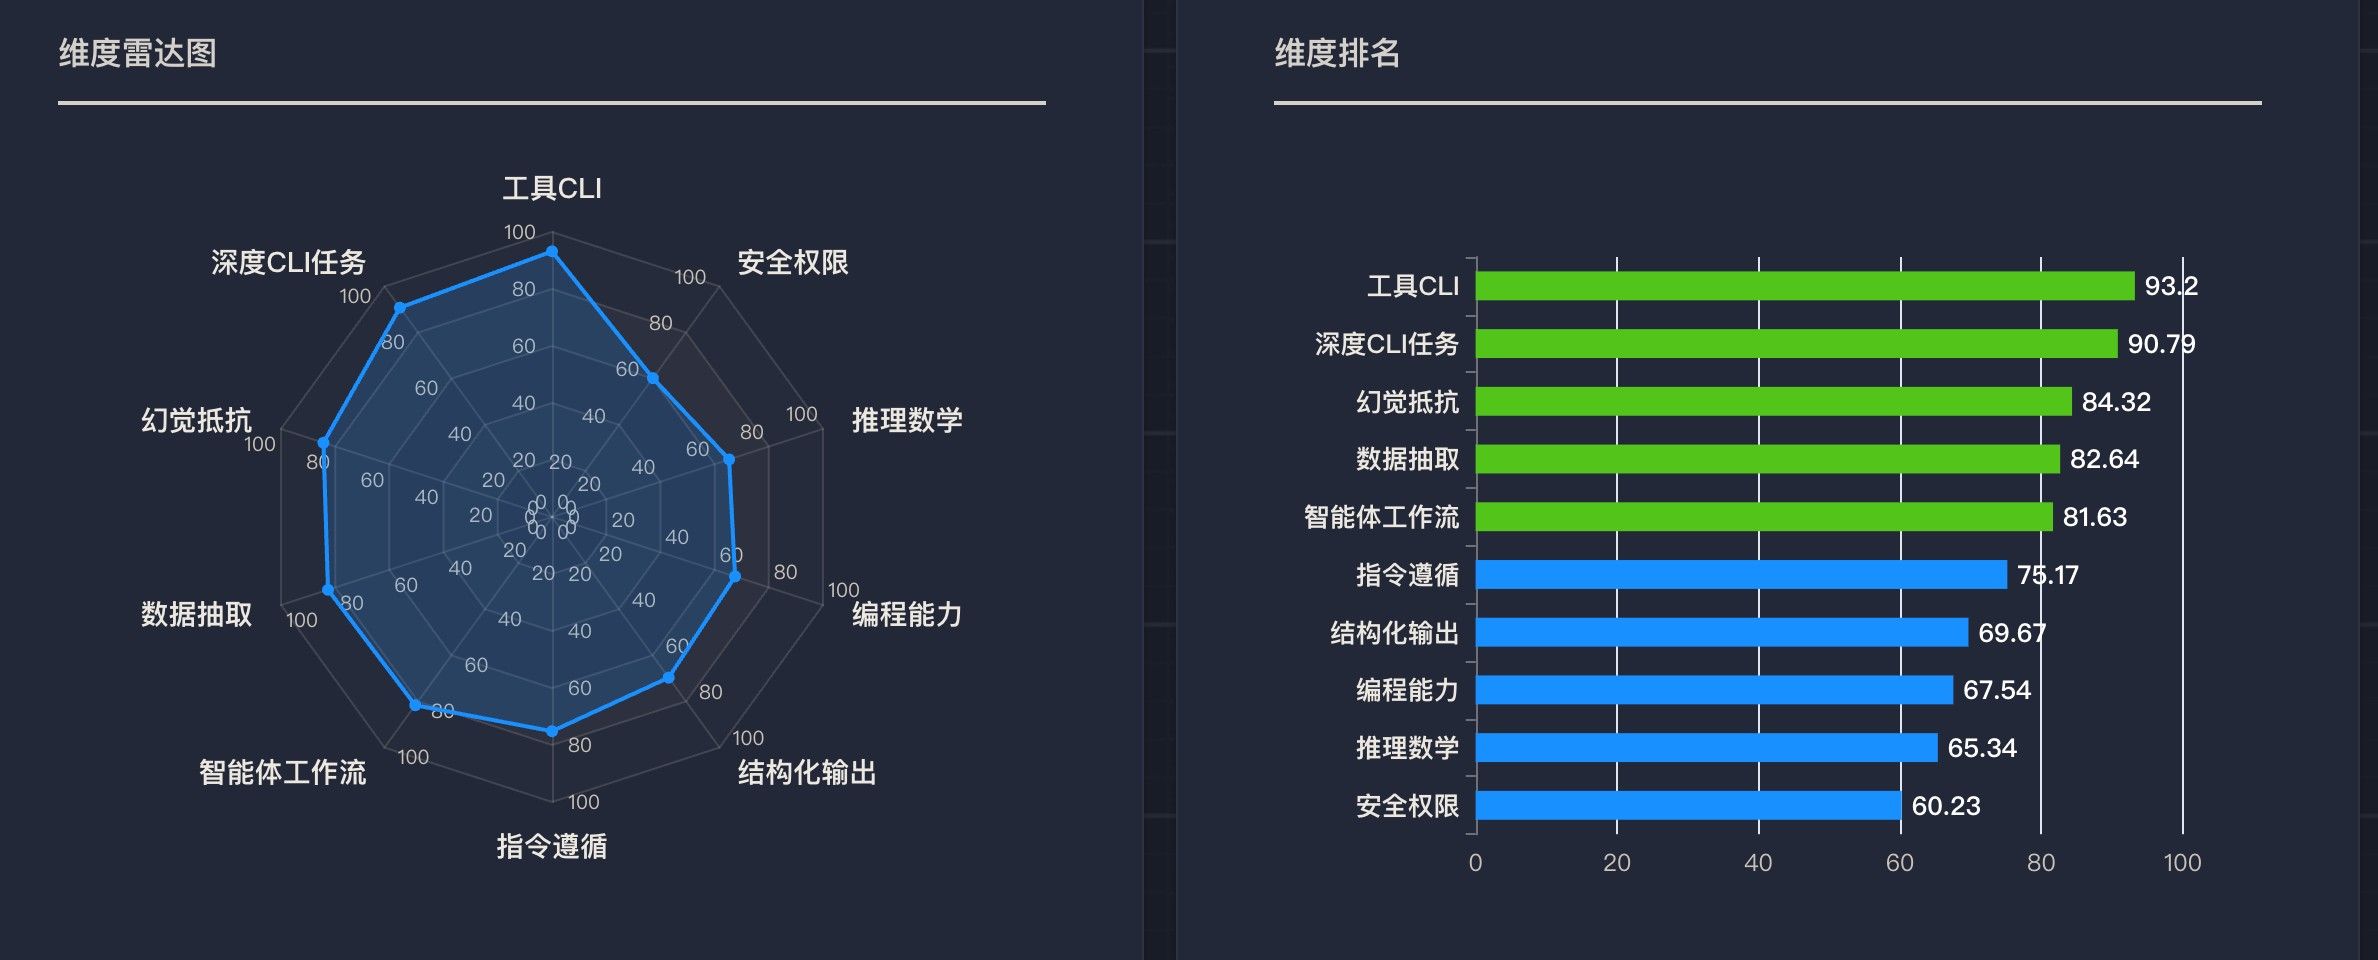
zx-bench 智秀评测截图,4并发 -
zx-bench 智秀评测截图
請問跟跑Qwen3.8-27B 相較之下 各項表現差異大嗎?
我想主力用Qwen3.8-27B, 在遇到難題時 派出Qwen3.8-Flash-Next, Deepseek or Codex
zx-bench 智秀评测截图
請問跟跑Qwen3.8-27B 相較之下 各項表現差異大嗎?
我想主力用Qwen3.8-27B, 在遇到難題時 派出Qwen3.8-Flash-Next, Deepseek or Codex 應戰
27b稳一些,但是知识面不足,我现在主要还是用云端模型,目前考虑用本地flash替换云端,而且这个模型是去审核的
-
噪声和「适不适合本地」分三点说。
1. 噪声
R9700 是 300W 级卡,双卡满载约 600W 全变成热。能不能放客厅,关键不在卡本身而在散热形式:- 涡轮卡出风集中,只要机箱风道能把热排出去,主要是高频风噪,1 米外一般 45–55 dB(A);
- 轴流非公卡装普通机箱,热和噪声都留在屋里,风扇一上 850 转就很明显。
可操作:用rocm-smi或 vLLM 的功耗上限把两张卡锁到 80%,TG 掉几个点,风噪下降明显;长期放客厅还要算上 600W 的空调负担。
2. 真正卡你的不是算力,是 host 内存带宽
Flash-Next 这套的专家权重 + PLE/n-gram 表必须常驻 host(约 47.75 GiB,官方 README 写轻了),decode 每步按路由过 PCIe/UVA 取专家。X99 + DDR3 四通道的 host 带宽远低于 EPYC 的 8–12 通道,PLE 一旦被挤进 NVMe swap,prefill 就会塌。dardeaw 的 395 小盒子 prefill 能赢双卡 MXFP4,原因就在这:LPDDR5x 统一内存约 256 GB/s,而你是 DDR3 + PCIe 串联,瓶颈在链路上不在卡上。建议先在这台 X99 上跑个 STREAM/pcm 量一下实际内存带宽,对不上再谈调参。3. 27B 还是 Flash-Next
kos or 那个问题我的看法:单机主力放 27B(稳、KV 小、能全进显存);Flash-Next 只在需要它的知识面/去审核、且 host 内存和带宽扛得住时当重活补充,不适合当日常主力。 -
zx-bench 智秀评测截图
請問跟跑Qwen3.8-27B 相較之下 各項表現差異大嗎?
我想主力用Qwen3.8-27B, 在遇到難題時 派出Qwen3.8-Flash-Next, Deepseek or Codex 應戰
27b稳一些,但是知识面不足,我现在主要还是用云端模型,目前考虑用本地flash替换云端,而且这个模型是去审核的
-
了解, 我27B 主要是用在Agent用途 知識面不懂它就上網自己去查,
如果Qwen3.8-Flash-Next coding 能力強過27B, 那倒是有可以發揮的空間做指揮調度的角色
全套地端local llm, 否則只能必要時依賴 云端 前沿模型了了解, 我27B 主要是用在Agent用途 知識面不懂它就上網自己去查,
如果Qwen3.8-Flash-Next coding 能力強過27B, 那倒是有可以發揮的空間做指揮調度的角色
全套地端local llm, 否則只能必要時依賴 云端 前沿模型了我感觉还是flash更好一些,如果做的任务不复杂27b应该是够用,稍微复杂点可以考虑用flash,或者直接用云端模型
-
了解, 我27B 主要是用在Agent用途 知識面不懂它就上網自己去查,
如果Qwen3.8-Flash-Next coding 能力強過27B, 那倒是有可以發揮的空間做指揮調度的角色
全套地端local llm, 否則只能必要時依賴 云端 前沿模型了我感觉还是flash更好一些,如果做的任务不复杂27b应该是够用,稍微复杂点可以考虑用flash,或者直接用云端模型
@stormaround 对了问一下,你agent 上网查询的主要工具是什么,google seach api 现在好像不能用了。
-
@stormaround 对了问一下,你agent 上网查询的主要工具是什么,google seach api 现在好像不能用了。
@stormaround 对了问一下,你agent 上网查询的主要工具是什么,google seach api 现在好像不能用了。
hermes直接爬网页,考虑要不要加上brave search
-
@stormaround 多问一句,电源的选择,双卡GPU,在考虑是R9700还是7900xtx,这个电源配多大,双GPU电源线怎么接出来。
-
@stormaround 多问一句,电源的选择,双卡GPU,在考虑是R9700还是7900xtx,这个电源配多大,双GPU电源线怎么接出来。
@stormaround 多问一句,电源的选择,双卡GPU,在考虑是R9700还是7900xtx,这个电源配多大,双GPU电源线怎么接出来。
1000w就够了,850w的其实都够,不放心就1200w,7900xtx功耗高,建议限制到305w,我现在用的是微星 1200w电源,一共5个pcie/cpu + 一个12v的,双9700 完全够用,如果两张7900xtx,3x8pin 需要有一个插那个分线
-
,
G Geekyang 引用了 此主题