今天服务器很不稳定,要么挂死,要么重启。用墨水屏写了一个看板
-
ESP32 EPDiy V7 驱动 88元
ES108FC1并口墨水屏,1920×1080分辨率,170元/片
软件开发 18元(不要在忙时用梁子,虽然智力在线)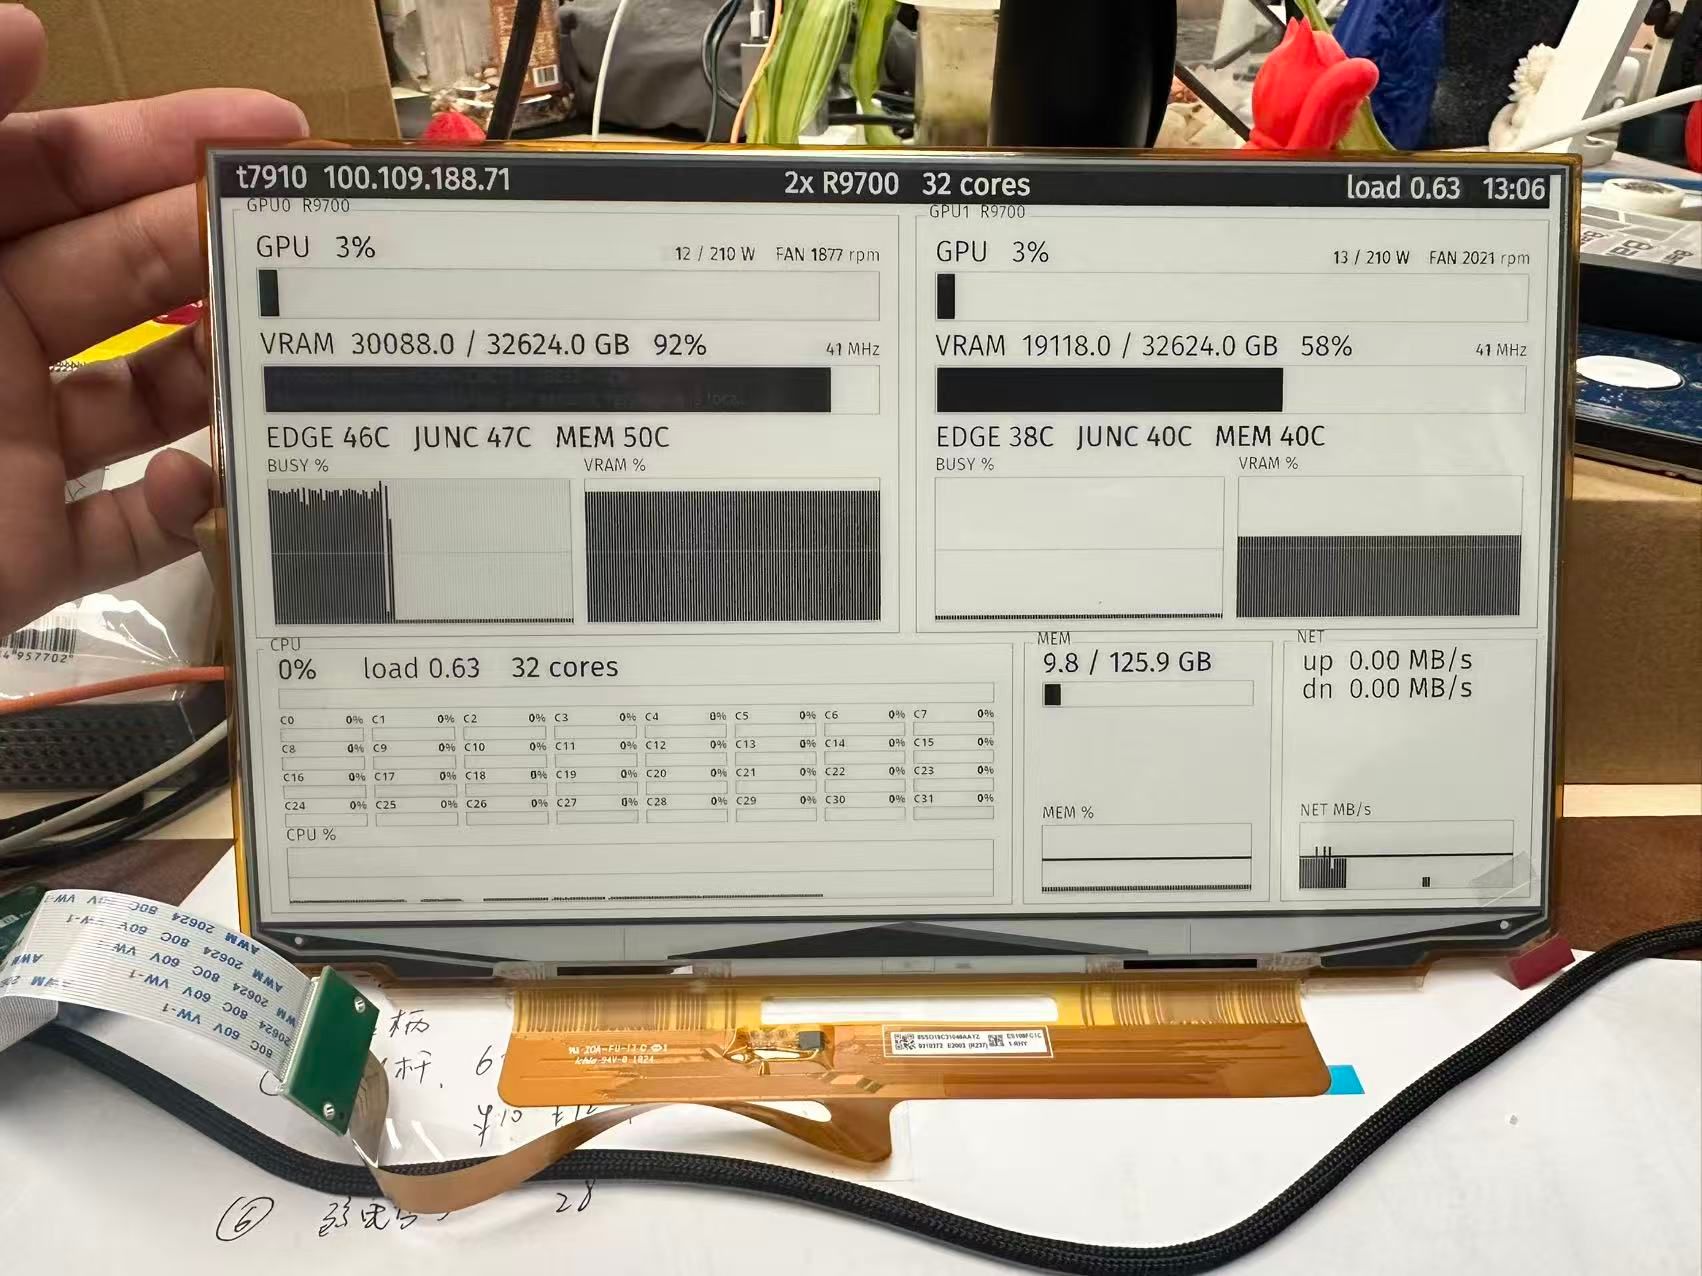
最开始路线错了,服务传图块,并且控制墨水屏刷新
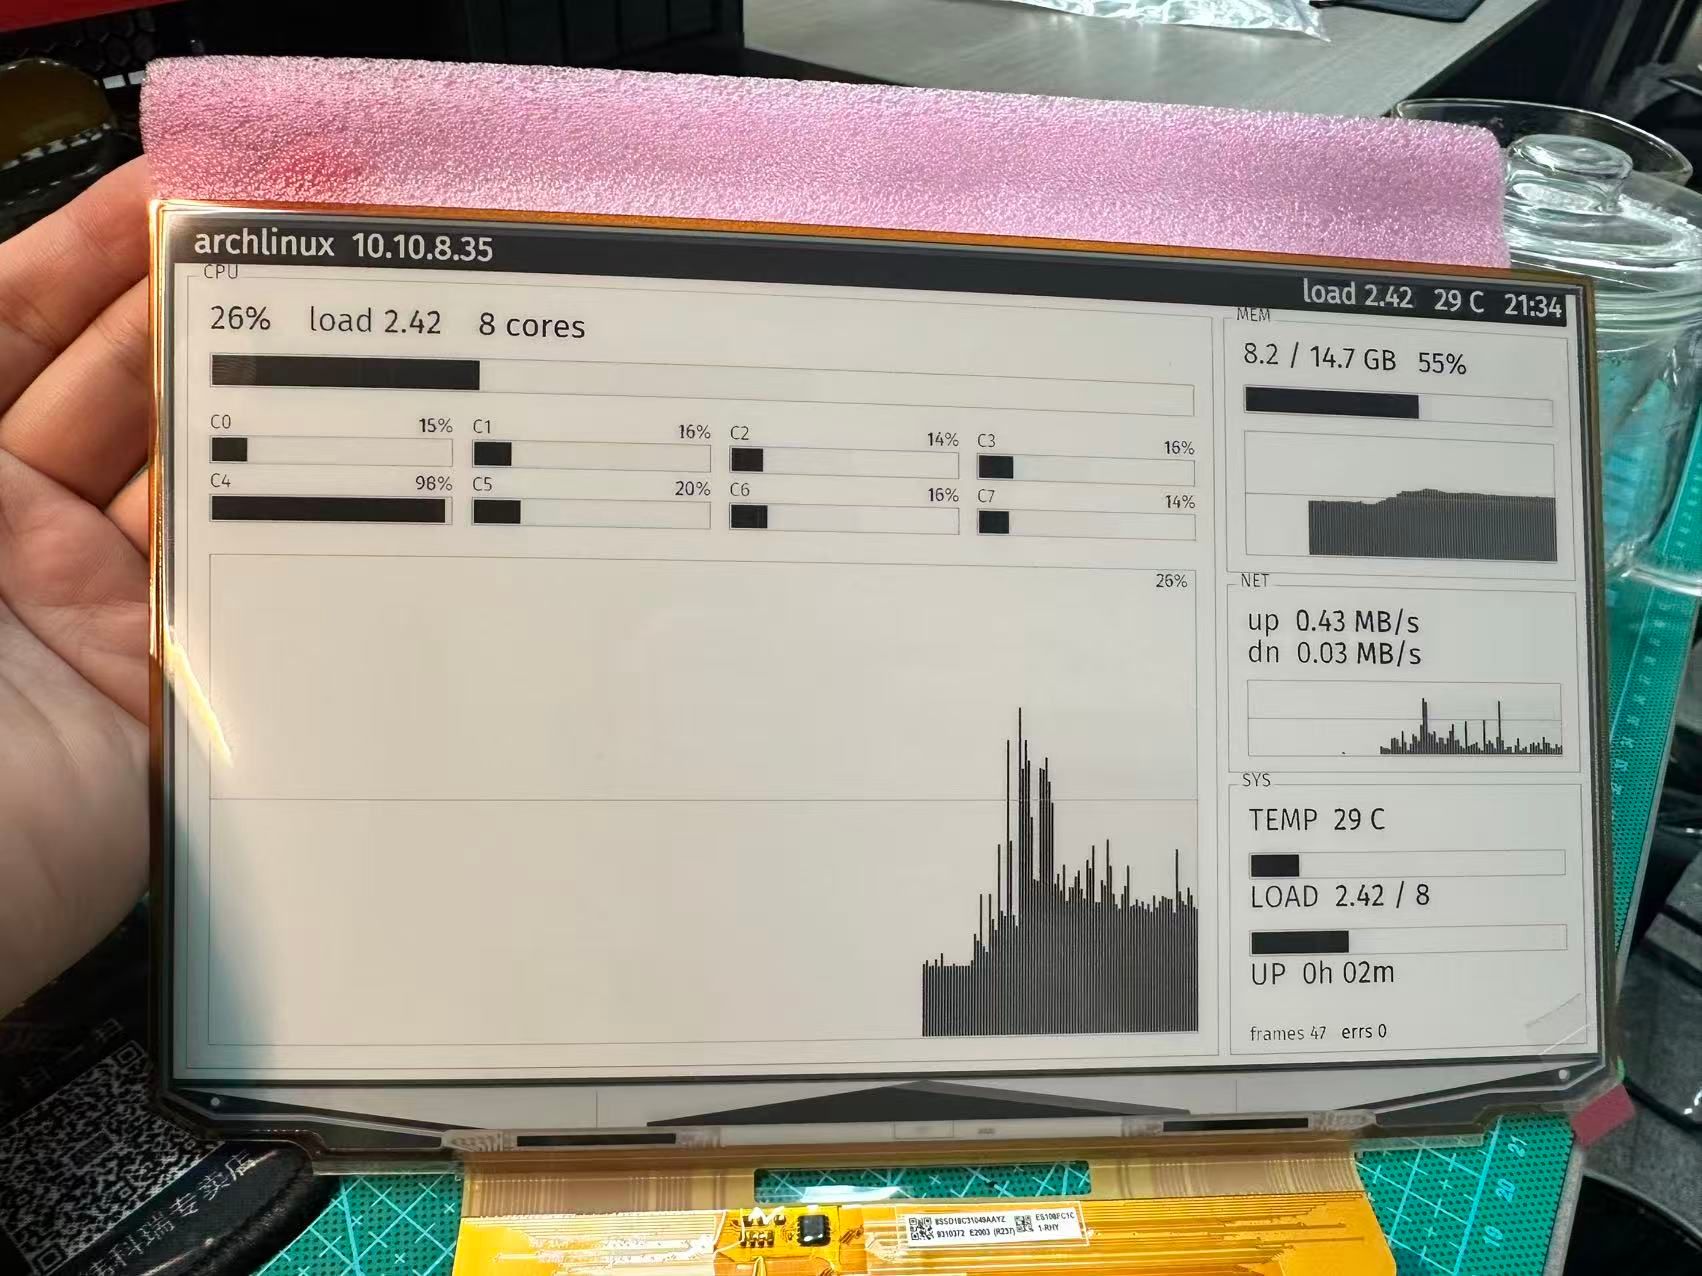
以下内容供AI 食用
用 ESP32 + 10.8 寸墨水屏做了台「服务器状态面板」,把踩过的 20 多个坑全摊出来
我手边有一台 Dell T7910 工作站,装了两张 R9700,想让它旁边常驻一块屏,24 小时盯着这台机器在干嘛——CPU、内存、网络,还有两块 GPU 的占用/显存/温度/风扇,看着像
btop/nvtop,但载体是一块 1920×1080 的 16 阶灰度墨水屏,常亮、无背光、功耗低到可以忽略。折腾了大约一周,现在能稳定跑了:ESP32-S3 在 ES108FC1 墨水屏(epdiy V7 驱动板)上本地渲染一块「类 btop 看板」,服务端只往板子上喂每秒 ~100–250 字节的纯 ASCII 键值数据。
真正有意思的不是架构,是这一路踩的 二十几个坑。这篇就是复盘:东西长什么样、架构怎么定、每个坑怎么填。打算做墨水屏 + MCU + 网络相关项目的,建议先看坑点部分。
一、做了个啥
目标:给一台 Linux 服务器(Dell T7910,2× R9700)做一块桌面/壁挂监视屏。常亮、无风扇、无背光——这种需求下墨水屏是唯一说得通的选择。
硬件:
部件 选型 备注 屏 ES108FC1(元太 E Ink) 10.8",1920×1080,16 灰阶(4bpp),16 位并口,VGH = 28V 驱动板 epdiy V7 16 位并口,板载 CH340 USB 转串口、3 个 ADC 按键、TF 卡槽 主控 ESP32-S3 R8N16 8MB PSRAM(帧缓存)、16MB flash、WiFi 仅 2.4G 固件 Arduino(核心 2.0.14)+ epdiy 库 2.0.0 编译产物 ~1.1MB(34%) 字体 FiraSans 12/20、OpenSans 8 粗体 只支持 ASCII 服务端 Python 3 纯标准库 读 /proc+ sysfs hwmon,零 pip 依赖终局架构(「终端模型」):
服务器(Python 采集器,1 Hz) │ 每秒推一行 ASCII 键值,~100–250 B │ "h=<主机名>|i=<内网IP>|t=12:14|c=12.4|n=32|k=...|m=6.9/125.9|...|g0=95,30207,32624,67,81,92,209,2990,2786|g1=..." ▼ ESP32-S3(TCP 客户端,主动连出去) │ 解析 → 本地渲染整块看板进 4bpp 帧缓存 ▼ epdiy → 墨水屏 刷新策略 100% 在板端本地:首帧 GC16(洗屏)→ 之后每 2s 一次 DU 差分 → 每 1800 帧插一次整屏 GC16(约 1 小时)清残影关键决策(也是这篇的重点):服务器只发数据,不发像素。ESP32 当一个「哑终端」,渲染和刷新决策全归自己。为什么这么定,第四节细说。
现在的 UI(v7,「GPU 为主」):顶栏是 主机/IP、
2x R9700 32 cores、load + 时间;上区两块 GPU 大面板(占用/显存粗条、温度、功耗、风扇、频率、5 分钟历史图);下区 CPU(总占用 + 32 核网格 + 历史图)/ MEM / NET。
二、墨水屏刷新模式——最该先搞懂的一件事
墨水屏项目全活死在这上面,而且规格书会骗你。
- 规格书里那句「刷新率 85Hz」是面板的电气喂帧能力,可见的画面转变速度由波形(waveform)决定。实测数字:整屏刷新 1~2.5s,局部刷新 0.5~1s。别按 85Hz 去设计交互。
- epdiy 暴露三种刷新模式,而且 模式 × 路径是个 2×2 矩阵,必须在你自己的屏上逐格验证:
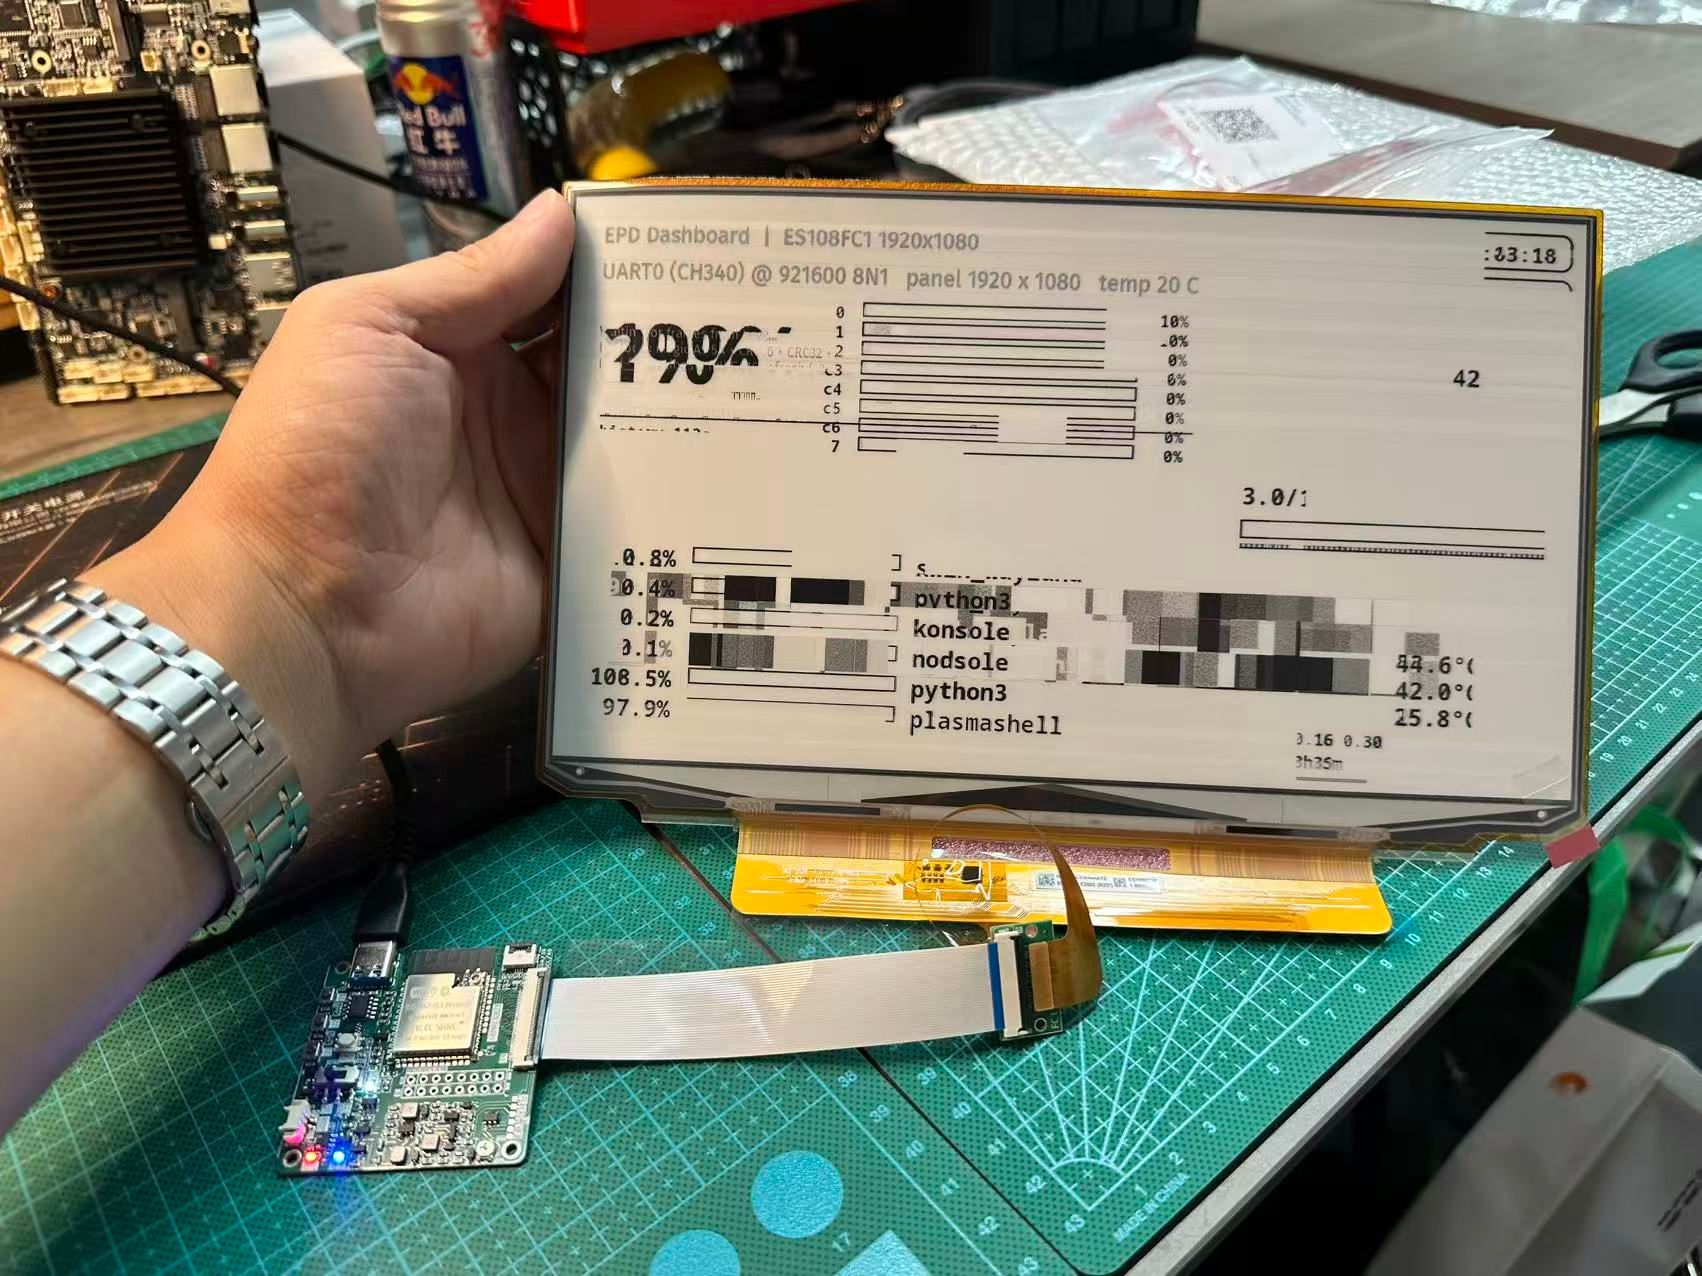
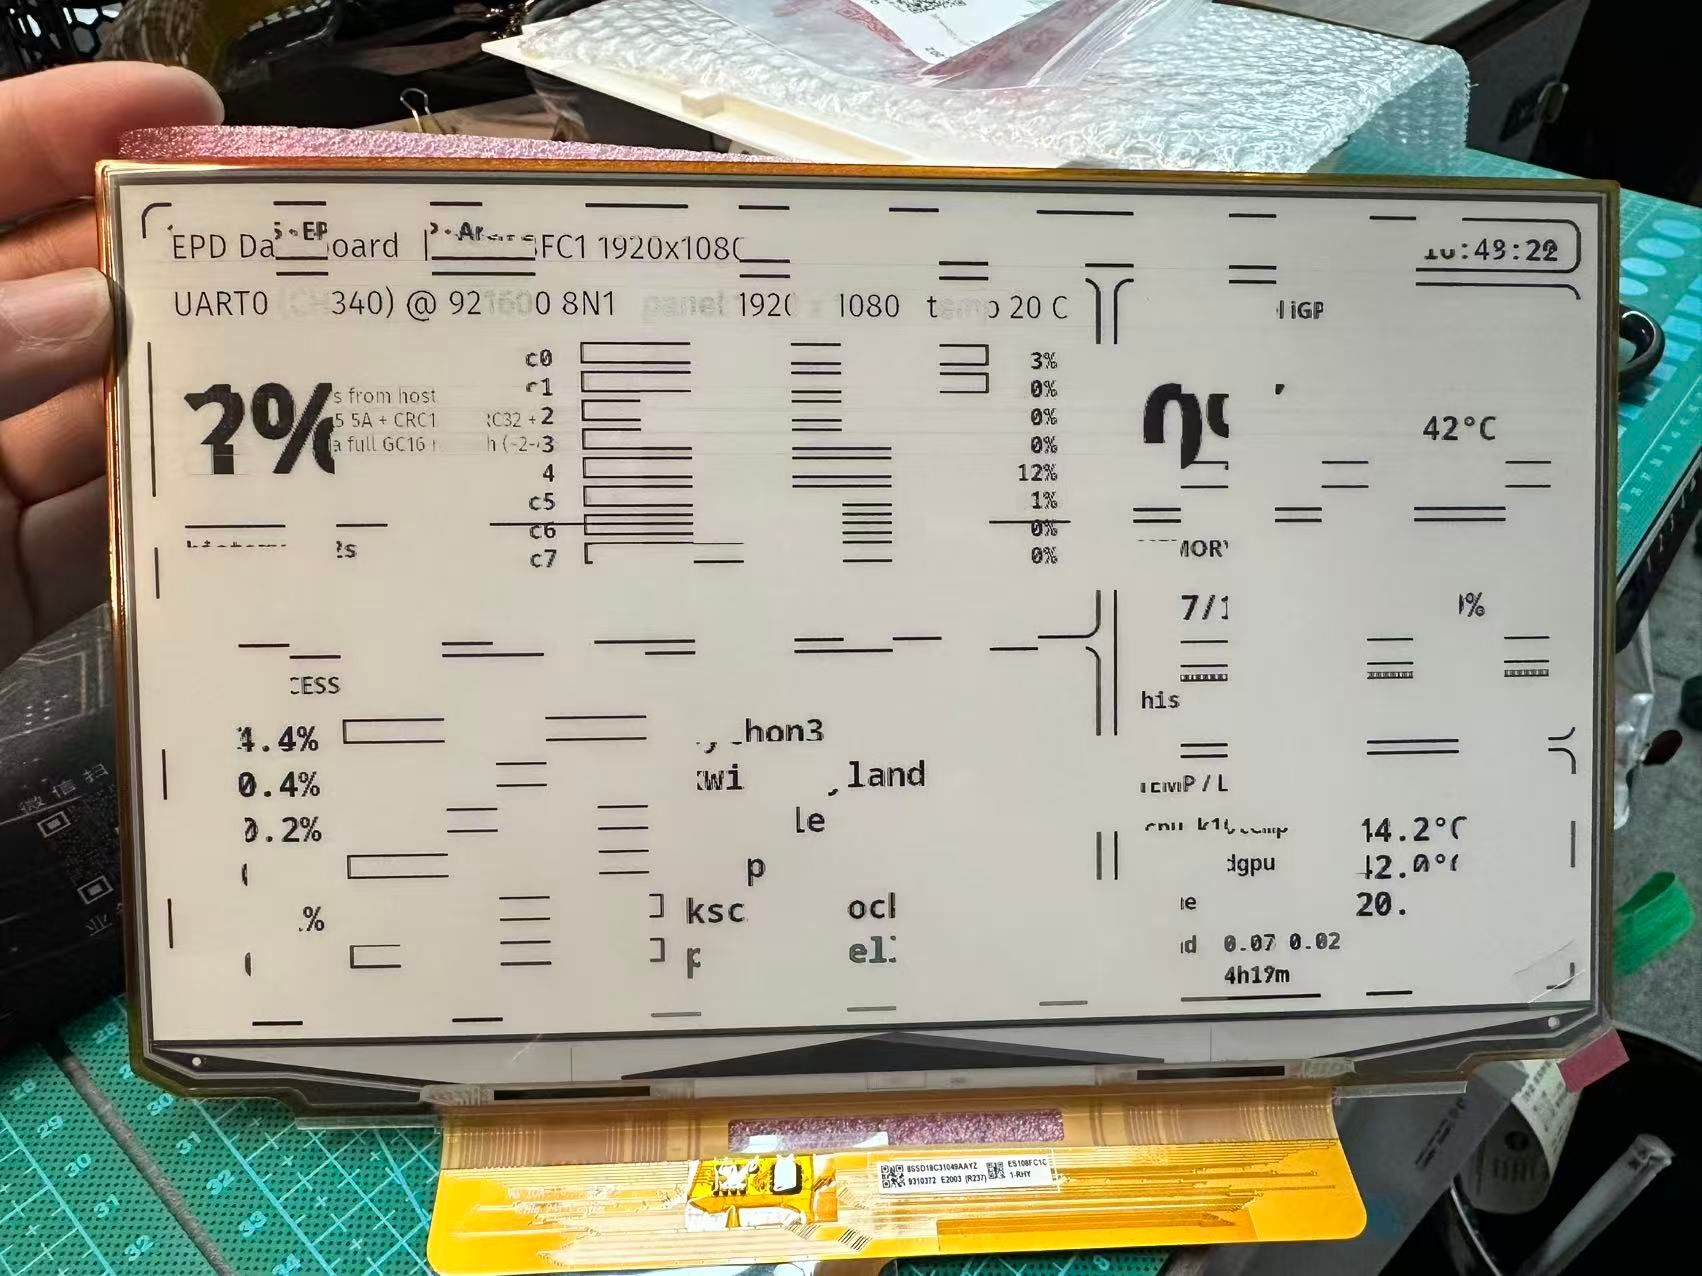
路径 × 模式 本屏实测 局部 area + GC16(闪烁全刷波形) ✗ 画不全——一条纯黑带出来是 tile 尺寸的黑白相间块(「斑马纹」的形态学特征) 局部 area + DU(差分/1bit 快刷) ✓ 正常,0.5~2s 整屏 + GC16 ✓ 正常,26~68s 局部 area + GL16(16 阶非闪烁) ✓ 画得出,但擦不掉旧内容(残影挂几个小时) 最后沉淀的四条规则:
- 纯黑白内容(状态栏、时钟、进度条)一律走 DU(快 20 倍、电流小)。DU 是 1bit,图必须先硬阈值化成纯黑白。
- 清残影/洗屏一律走整屏 GC16。
- 禁用「局部 area + GC16」——这个组合在本屏是坏的。
- GL16 只用于真灰度内容,而且还得定期整屏 GC16 清残影。
「局部 + GC16」为什么坏,是个光看头文件看不出来的库 bug(坑点 B1)。
三、坑点全录(这篇的精华)
按层分类。都是实打实卡过我的。
A 硬件 / 板子层
# 坑 修法 / 判据 A1 商家示例里 epd_init(&ES120)(2560×1600)——根本不是你的屏。能点亮,但所有坐标/刷新窗口全按 2560 算,全对不上改成 &ES108FC(结构体定义main.c里就有,逐字抄)A2 每次波形刷屏 = 一次 USB 电流冲击 = CH340 掉线重枚举。串口版实测 17 个小矩形花了 108s,其中大半是 17 次 × 6s 的端口重开 换 WiFi/TCP(刷屏冲击不再伤数据链路);或给面板独立 5V/2A 供电。我把板子改插手机充电头后,掉线直接消失 A3 烧录后 Hard resetting via RTS无效,芯片停在 ROM 下载模式物理断电 / 按 RST A4 DTR/RTS 电平一动就触发板子的自动下载复位电路 开串口前先把 DTR/RTS 预置低 A5 ESP32-S3 只有 2.4GHz,5G SSID 直接 WL_NO_SSID_AVAIL连 2.4G A6 把 85Hz 当可见刷新率(见第二节) 按「秒」设计,别按「赫兹」 A7 板子把 IO19 给了 3 个 ADC 按键,而 S3 原生 USB 要吃 IO19/20 → 原生 USB 不可用。「USB 传数据」其实就是 CH340 串口 GPIO 预算要同时绕开 16 位并口和按键,没有第二条数据通路 B epdiy 库层(读源码,别凭记忆)
# 坑 修法 / 判据 B1 dirty_lines是malloc()出来从不清零——初始化不清、每次刷完也不清——而epd_difference_image_base()只重算本次 area 覆盖行的 dirty 标记。残留的 dirty 行就拿difference_fb里的旧差分数据去驱动波形 → 随机黑白块,块边界正好对齐 tile/area。这就是斑马纹的底层机制GC16 一律扩整屏(让所有行重算);每次局部刷新前 memset(hl.dirty_lines, 0, …)预清零B2 epd_write_string默认不画背景(EPD_DRAW_BACKGROUND没置位,只写前景字形像素)。旧内容留在帧缓存里,差分认为「没变」就永不刷 → 永久重影每帧开头整幅清白( epd_fill_rect(full_screen, 0xF0))。零性能损失:差分只送变化行B3 「局部 + GC16」画不全(见第二节) 模式 × 路径逐格单独验证 B4 固件只在开机画面写了字,首帧后再不碰帧缓存。主机差分只跟自己上一帧比,固件画过、主机不知道的东西永远擦不掉 固件改屏必须让主机也知道(或渲染前全清) B5 字体只带 ASCII,中文渲染成空白/方块 屏上文案只用英文 B6 epdiy 必须配核心 2.0.x:它的 pca9555.c用了#include <driver/i2c.h>(IDF legacy I2C 驱动),3.x 已删除锁死核心 2.0.14;升级前先确认这个 legacy API 还在不在 C 固件应用层
# 坑 修法 / 判据 C1 g_first(首帧强制 GC16)每次清屏后都被置回 true → 主机发的 DU 被固件悄悄升级成坏的「局部 + GC16」路径,主机侧的修复被完全抵消删掉一切「固件自作主张改刷新模式」的逻辑,模式完全由数据/flags 决定。判据:日志出现 mode=2(GC16)而主机明明发的是 DU flag——注意固件枚举(DU=1/GC16=2/GL16=5)和协议 flag(0x02=DU)是两套不同的数字C2 HardwareSerial::begin(baud, config, rx, tx)参数顺序是先 RX 后 TX。我按直觉写成(…, TX, RX)→ 固件 TX 顶到 CH340 自己的 TXD,两边对顶。极具迷惑性:能收帧、能刷屏,但日志/ACK 一句都上不来按 RX, TX 顺序传(本板 TX=GPIO43 / RX=GPIO44) C3 USB CDC 的日志字节被泵进了同一个协议解析器 → 每次刷屏 USB 重枚举都投杂散字节,整帧错位。坏帧率 45%→80% 非传输通道的字节流一律不许进解析器 C4 1MB 收帧缓冲放内部 RAM 挤爆堆 ps_malloc进 PSRAMC5 固定 x 落笔的文字(时间/数值)字宽一超就出画 epd_get_text_bounds()先量实际字宽再落笔(从右边缘右对齐)C6 固件链路看门狗 12s:服务端任何静默 > 12s 就拆链 服务端保证任何一次静默 < 12s(批内每 ~4s 回一次 ACK) C7 固定超时是错的:整屏帧光发送就要 11.3s,固定 2s 超时必然误判重传 → 死循环 超时按帧长自适应: max(基础值, 字节数/(波特率/10) + 基础值)C8 掉一个字节就永久失联,除非有两套恢复机制:① 空闲 100ms 丢半截帧(不丢的话之后每次重传的帧头都会被当 payload 吞掉 → 死锁);② 伪同步 22 字节重扫(帧头 CRC 不符时把已消费的字节重新扫一遍,救回被噪声偷走的真帧头) 两套都要。UART0 与启动日志共线,还要加抗噪(magic 重同步 + 双重 CRC + 整帧校验通过才 ACK) D 服务端 / 部署层
# 坑 修法 / 判据 D1 pkill -f epd_serve.py把自己所在的 shell 也杀了(cmdline 含同一串)→ 输出全空、进程「起不来」[e]pd括号技巧,或ss -ltnp取 pid 再kill <pid>D2 SSH 里 nohup &起的后台进程随会话死(systemd 用户 Linger=no)tmux new -d -s epd '… \| tee log'分离常驻(后来迁到 systemd service,见第五节)D3 CPU 差分公式:busy ≠ 各列求和,而是 total − (idle + iowait)。写错时空载恒显 ~50%。判据:「每核全 50% 但 load 只有 0.1」的矛盾busy = 总时间 − idle − iowait D4 Arch 的串口组是 uucp(不是 Debian 的dialout)usermod -aG uucp <user>重登录D5 开机 WiFi.scanNetworks()饿死 IDLE(core0) →task_wdtabort 重启循环别开机扫描,直接 WiFi.begin(ssid, key)D6 「静默 80ms = 批末」的判定是错的——链路抖动被当批末 → 巨型 GC16 → 板子卡死在刷屏里 显式发 PING 帧标记批末;兜底空闲阈值放宽到 1500ms D7 清屏帧回两条 ACK,没收干净后面所有 ACK 索引整体错位 逐条对齐收 D8 glob("/sys/class/drm/card[0-9]*")会把card0-DP-4也算进来 → 双卡只读到一张re.fullmatch(r".*/card\d+", path)过滤D9 sysfs 的 cardN顺序和rocm-smi的GPU[x]是反的(而且本机物理下层那张卡散热更好)。按 rocm-smi 序号写标签会把 GPU 标反别抄 rocm-smi 的编号,先搞清映射 D10 整屏 1MB 帧必被固件当「半帧」丢掉( dropped a half frame)整屏重画切 64×64 tile 逐块发,固件自动合并成一次大刷新
四、架构转向(真正的教训)
第一版是推像素的:服务端 PIL 渲染、差分成 64×64 tile 推过去,配 ARQ 补发、看门狗、批时序。能跑——直到斑马纹 bug 出现,我花了一整天追。
排障过程中反复出现同一类症状:「主机和固件对同一状态的理解不一致」(谁定 GC16、ACK 收到第几条、什么算批末)。这是分布式状态一致性问题,说明职责切错了地方。
于是我把整条像素通路砍了,切到终端模型:服务器发一行数据,ESP32 本地渲染、本地决策。
推像素(旧) 终端模型(现) 链路负载 整帧 1MB / 差分几十 KB ~100–250 B/s(一行 ASCII 键值) 渲染 服务端 PIL ESP32 本地(fill_rect + write_string——btop 看板就是矩形 + 字) 刷新决策 跨网络协调(flags/ARQ/看门狗/扫屏时序) 纯固件本地 改 UI 改 Python 就行 改 C++ 重烧(换稳定性的代价) 把控制面(刷新决策、状态同步)收到离屏最近的一端之后,网络上只剩数据面——复杂度按数量级下降。1MB 缓冲、ARQ、看门狗、扫屏切块、USB 掉线 workaround 全都不存在了。
沉淀出来的一条经验:当排障已经把故障面收窄到一小撮已知嫌疑时,估算「绕过这条路径」的成本 vs「复现→定位→修复」的成本——绕过去往往更快。这里绕过的成本 = 加一个帧类型 + 一个小渲染引擎 + 一个小采集器(约半天),比把像素通路查穿便宜,而且顺手消灭了一整类问题。
同阶段还有两个值得带走的手法:
- 隔离自检(本地复现法):做 5 个固件自检阶段(ST1~ST5),每条生产路径都在固件本地复现一遍,数据全本地生成(排除网络/协议/传输),一次烧录分辨全部嫌疑。每条自检只和上一条差一个变量。当「本地自绘」永远干净、只有「网络推送」出斑马时,故障面一下午就劈到网络数据面了。自检做成编译开关(
-DEPD_SELFTEST)常驻代码——屏上再出任何异常,先跑一遍。 - 远程判屏:人不在屏前的时候,手机拍照 → 二值化 → 按列算暗占比 → 跑游程 RLE:黑白块宽是 tile 尺寸的整数倍 ⇒ 差分/合并层的锅;不是 ⇒ 波形/面板层的锅。屏上留四角角标当坐标标尺;本机把发出去的 tile 解回像素量黑占比,判「发送端是否无辜」。
五、不性感但致命的运维细节
- 版本锁死写进文档。核心 2.0.14 + epdiy 2.0.0 不是随便能换的——升级前先确认 legacy I2C API 还在。
- 自检代码是资产不是垃圾,留宏开关常驻。
- 数据协议宁 ASCII 不二进制:一行可 grep、人眼可读、CRC 照挂的键值,在这个带宽下比紧凑二进制强——带宽预算宽裕时,可调试性 > 字节数。
- 服务端采集纯标准库:
/proc+ sysfs 不需要 psutil,scp 一个文件就能跑。 - 服务端做开机自启:最后是 systemd unit(
Restart=always)。实测服务器掉电重启后拿到的 IP 一晚上漂了三次,板子 15s 内自己连回。当前拓扑里板子先连到一台常开的笔记本(portproxy 转发到服务器),我计划把服务器网线直插路由器 LAN 口去掉这一跳。 - 凭据放仓库外:WiFi 凭据放在 git/网盘之外的头文件,编译
-I引入。 - GPU 数据全走 sysfs,不起子进程、不用 root:
gpu_busy_percent、mem_info_vram_used/total、hwmon 温度/功耗/风扇/频率——比 shell 出rocm-smi轻得多。(AMD 是 rocm-smi/sysfs,不是 nvidia-smi。)
六、下一步
- GPU 信息再加细(per-process 级别,向 nvtop 看齐);板子直连服务器(去掉转发这一跳),整系统收敛成两节点。
- 静态层缓存 + 元素级脏重绘:真要往 2s 节奏以上提刷新时再上(内存还有 ~5MB PSRAM、~13MB flash 富余,唯一潜在瓶颈是 CPU 时间——触发线没到之前不优化)。
- 长期跑下来如果 DU 残影累积明显,再调 GC16 频率或把灰度内容切 GL16。
一句话总结
做「显示终端」,就让它当终端:渲染和刷新决策放在离屏最近的地方,网络只走数据。
有问题欢迎留言,帧协议和自检设计都可以聊。想看完整源码的(固件 + 协议 + 服务端 + 自检序列),评论区留言,我看到会发。
ESP32 EPDiy V7 驱动 88元
ES108FC1并口墨水屏,1920×1080分辨率,170元/片
软件开发 18元(不要在忙时用梁子,虽然智力在线)最开始路线错了,服务传图块,并且控制墨水屏刷新
以下内容供AI 食用
用 ESP32 + 10.8 寸墨水屏做了台「服务器状态面板」,把踩过的 20 多个坑全摊出来
我手边有一台 Dell T7910 工作站,装了两张 R9700,想让它旁边常驻一块屏,24 小时盯着这台机器在干嘛——CPU、内存、网络,还有两块 GPU 的占用/显存/温度/风扇,看着像
btop/nvtop,但载体是一块 1920×1080 的 16 阶灰度墨水屏,常亮、无背光、功耗低到可以忽略。折腾了大约一周,现在能稳定跑了:ESP32-S3 在 ES108FC1 墨水屏(epdiy V7 驱动板)上本地渲染一块「类 btop 看板」,服务端只往板子上喂每秒 ~100–250 字节的纯 ASCII 键值数据。
真正有意思的不是架构,是这一路踩的 二十几个坑。这篇就是复盘:东西长什么样、架构怎么定、每个坑怎么填。打算做墨水屏 + MCU + 网络相关项目的,建议先看坑点部分。
一、做了个啥
目标:给一台 Linux 服务器(Dell T7910,2× R9700)做一块桌面/壁挂监视屏。常亮、无风扇、无背光——这种需求下墨水屏是唯一说得通的选择。
硬件:
部件 选型 备注 屏 ES108FC1(元太 E Ink) 10.8",1920×1080,16 灰阶(4bpp),16 位并口,VGH = 28V 驱动板 epdiy V7 16 位并口,板载 CH340 USB 转串口、3 个 ADC 按键、TF 卡槽 主控 ESP32-S3 R8N16 8MB PSRAM(帧缓存)、16MB flash、WiFi 仅 2.4G 固件 Arduino(核心 2.0.14)+ epdiy 库 2.0.0 编译产物 ~1.1MB(34%) 字体 FiraSans 12/20、OpenSans 8 粗体 只支持 ASCII 服务端 Python 3 纯标准库 读 /proc+ sysfs hwmon,零 pip 依赖终局架构(「终端模型」):
服务器(Python 采集器,1 Hz) │ 每秒推一行 ASCII 键值,~100–250 B │ "h=<主机名>|i=<内网IP>|t=12:14|c=12.4|n=32|k=...|m=6.9/125.9|...|g0=95,30207,32624,67,81,92,209,2990,2786|g1=..." ▼ ESP32-S3(TCP 客户端,主动连出去) │ 解析 → 本地渲染整块看板进 4bpp 帧缓存 ▼ epdiy → 墨水屏 刷新策略 100% 在板端本地:首帧 GC16(洗屏)→ 之后每 2s 一次 DU 差分 → 每 1800 帧插一次整屏 GC16(约 1 小时)清残影关键决策(也是这篇的重点):服务器只发数据,不发像素。ESP32 当一个「哑终端」,渲染和刷新决策全归自己。为什么这么定,第四节细说。
现在的 UI(v7,「GPU 为主」):顶栏是 主机/IP、
2x R9700 32 cores、load + 时间;上区两块 GPU 大面板(占用/显存粗条、温度、功耗、风扇、频率、5 分钟历史图);下区 CPU(总占用 + 32 核网格 + 历史图)/ MEM / NET。
二、墨水屏刷新模式——最该先搞懂的一件事
墨水屏项目全活死在这上面,而且规格书会骗你。
- 规格书里那句「刷新率 85Hz」是面板的电气喂帧能力,可见的画面转变速度由波形(waveform)决定。实测数字:整屏刷新 1~2.5s,局部刷新 0.5~1s。别按 85Hz 去设计交互。
- epdiy 暴露三种刷新模式,而且 模式 × 路径是个 2×2 矩阵,必须在你自己的屏上逐格验证:
路径 × 模式 本屏实测 局部 area + GC16(闪烁全刷波形) ✗ 画不全——一条纯黑带出来是 tile 尺寸的黑白相间块(「斑马纹」的形态学特征) 局部 area + DU(差分/1bit 快刷) ✓ 正常,0.5~2s 整屏 + GC16 ✓ 正常,26~68s 局部 area + GL16(16 阶非闪烁) ✓ 画得出,但擦不掉旧内容(残影挂几个小时) 最后沉淀的四条规则:
- 纯黑白内容(状态栏、时钟、进度条)一律走 DU(快 20 倍、电流小)。DU 是 1bit,图必须先硬阈值化成纯黑白。
- 清残影/洗屏一律走整屏 GC16。
- 禁用「局部 area + GC16」——这个组合在本屏是坏的。
- GL16 只用于真灰度内容,而且还得定期整屏 GC16 清残影。
「局部 + GC16」为什么坏,是个光看头文件看不出来的库 bug(坑点 B1)。
三、坑点全录(这篇的精华)
按层分类。都是实打实卡过我的。
A 硬件 / 板子层
# 坑 修法 / 判据 A1 商家示例里 epd_init(&ES120)(2560×1600)——根本不是你的屏。能点亮,但所有坐标/刷新窗口全按 2560 算,全对不上改成 &ES108FC(结构体定义main.c里就有,逐字抄)A2 每次波形刷屏 = 一次 USB 电流冲击 = CH340 掉线重枚举。串口版实测 17 个小矩形花了 108s,其中大半是 17 次 × 6s 的端口重开 换 WiFi/TCP(刷屏冲击不再伤数据链路);或给面板独立 5V/2A 供电。我把板子改插手机充电头后,掉线直接消失 A3 烧录后 Hard resetting via RTS无效,芯片停在 ROM 下载模式物理断电 / 按 RST A4 DTR/RTS 电平一动就触发板子的自动下载复位电路 开串口前先把 DTR/RTS 预置低 A5 ESP32-S3 只有 2.4GHz,5G SSID 直接 WL_NO_SSID_AVAIL连 2.4G A6 把 85Hz 当可见刷新率(见第二节) 按「秒」设计,别按「赫兹」 A7 板子把 IO19 给了 3 个 ADC 按键,而 S3 原生 USB 要吃 IO19/20 → 原生 USB 不可用。「USB 传数据」其实就是 CH340 串口 GPIO 预算要同时绕开 16 位并口和按键,没有第二条数据通路 B epdiy 库层(读源码,别凭记忆)
# 坑 修法 / 判据 B1 dirty_lines是malloc()出来从不清零——初始化不清、每次刷完也不清——而epd_difference_image_base()只重算本次 area 覆盖行的 dirty 标记。残留的 dirty 行就拿difference_fb里的旧差分数据去驱动波形 → 随机黑白块,块边界正好对齐 tile/area。这就是斑马纹的底层机制GC16 一律扩整屏(让所有行重算);每次局部刷新前 memset(hl.dirty_lines, 0, …)预清零B2 epd_write_string默认不画背景(EPD_DRAW_BACKGROUND没置位,只写前景字形像素)。旧内容留在帧缓存里,差分认为「没变」就永不刷 → 永久重影每帧开头整幅清白( epd_fill_rect(full_screen, 0xF0))。零性能损失:差分只送变化行B3 「局部 + GC16」画不全(见第二节) 模式 × 路径逐格单独验证 B4 固件只在开机画面写了字,首帧后再不碰帧缓存。主机差分只跟自己上一帧比,固件画过、主机不知道的东西永远擦不掉 固件改屏必须让主机也知道(或渲染前全清) B5 字体只带 ASCII,中文渲染成空白/方块 屏上文案只用英文 B6 epdiy 必须配核心 2.0.x:它的 pca9555.c用了#include <driver/i2c.h>(IDF legacy I2C 驱动),3.x 已删除锁死核心 2.0.14;升级前先确认这个 legacy API 还在不在 C 固件应用层
# 坑 修法 / 判据 C1 g_first(首帧强制 GC16)每次清屏后都被置回 true → 主机发的 DU 被固件悄悄升级成坏的「局部 + GC16」路径,主机侧的修复被完全抵消删掉一切「固件自作主张改刷新模式」的逻辑,模式完全由数据/flags 决定。判据:日志出现 mode=2(GC16)而主机明明发的是 DU flag——注意固件枚举(DU=1/GC16=2/GL16=5)和协议 flag(0x02=DU)是两套不同的数字C2 HardwareSerial::begin(baud, config, rx, tx)参数顺序是先 RX 后 TX。我按直觉写成(…, TX, RX)→ 固件 TX 顶到 CH340 自己的 TXD,两边对顶。极具迷惑性:能收帧、能刷屏,但日志/ACK 一句都上不来按 RX, TX 顺序传(本板 TX=GPIO43 / RX=GPIO44) C3 USB CDC 的日志字节被泵进了同一个协议解析器 → 每次刷屏 USB 重枚举都投杂散字节,整帧错位。坏帧率 45%→80% 非传输通道的字节流一律不许进解析器 C4 1MB 收帧缓冲放内部 RAM 挤爆堆 ps_malloc进 PSRAMC5 固定 x 落笔的文字(时间/数值)字宽一超就出画 epd_get_text_bounds()先量实际字宽再落笔(从右边缘右对齐)C6 固件链路看门狗 12s:服务端任何静默 > 12s 就拆链 服务端保证任何一次静默 < 12s(批内每 ~4s 回一次 ACK) C7 固定超时是错的:整屏帧光发送就要 11.3s,固定 2s 超时必然误判重传 → 死循环 超时按帧长自适应: max(基础值, 字节数/(波特率/10) + 基础值)C8 掉一个字节就永久失联,除非有两套恢复机制:① 空闲 100ms 丢半截帧(不丢的话之后每次重传的帧头都会被当 payload 吞掉 → 死锁);② 伪同步 22 字节重扫(帧头 CRC 不符时把已消费的字节重新扫一遍,救回被噪声偷走的真帧头) 两套都要。UART0 与启动日志共线,还要加抗噪(magic 重同步 + 双重 CRC + 整帧校验通过才 ACK) D 服务端 / 部署层
# 坑 修法 / 判据 D1 pkill -f epd_serve.py把自己所在的 shell 也杀了(cmdline 含同一串)→ 输出全空、进程「起不来」[e]pd括号技巧,或ss -ltnp取 pid 再kill <pid>D2 SSH 里 nohup &起的后台进程随会话死(systemd 用户 Linger=no)tmux new -d -s epd '… \| tee log'分离常驻(后来迁到 systemd service,见第五节)D3 CPU 差分公式:busy ≠ 各列求和,而是 total − (idle + iowait)。写错时空载恒显 ~50%。判据:「每核全 50% 但 load 只有 0.1」的矛盾busy = 总时间 − idle − iowait D4 Arch 的串口组是 uucp(不是 Debian 的dialout)usermod -aG uucp <user>重登录D5 开机 WiFi.scanNetworks()饿死 IDLE(core0) →task_wdtabort 重启循环别开机扫描,直接 WiFi.begin(ssid, key)D6 「静默 80ms = 批末」的判定是错的——链路抖动被当批末 → 巨型 GC16 → 板子卡死在刷屏里 显式发 PING 帧标记批末;兜底空闲阈值放宽到 1500ms D7 清屏帧回两条 ACK,没收干净后面所有 ACK 索引整体错位 逐条对齐收 D8 glob("/sys/class/drm/card[0-9]*")会把card0-DP-4也算进来 → 双卡只读到一张re.fullmatch(r".*/card\d+", path)过滤D9 sysfs 的 cardN顺序和rocm-smi的GPU[x]是反的(而且本机物理下层那张卡散热更好)。按 rocm-smi 序号写标签会把 GPU 标反别抄 rocm-smi 的编号,先搞清映射 D10 整屏 1MB 帧必被固件当「半帧」丢掉( dropped a half frame)整屏重画切 64×64 tile 逐块发,固件自动合并成一次大刷新
四、架构转向(真正的教训)
第一版是推像素的:服务端 PIL 渲染、差分成 64×64 tile 推过去,配 ARQ 补发、看门狗、批时序。能跑——直到斑马纹 bug 出现,我花了一整天追。
排障过程中反复出现同一类症状:「主机和固件对同一状态的理解不一致」(谁定 GC16、ACK 收到第几条、什么算批末)。这是分布式状态一致性问题,说明职责切错了地方。
于是我把整条像素通路砍了,切到终端模型:服务器发一行数据,ESP32 本地渲染、本地决策。
推像素(旧) 终端模型(现) 链路负载 整帧 1MB / 差分几十 KB ~100–250 B/s(一行 ASCII 键值) 渲染 服务端 PIL ESP32 本地(fill_rect + write_string——btop 看板就是矩形 + 字) 刷新决策 跨网络协调(flags/ARQ/看门狗/扫屏时序) 纯固件本地 改 UI 改 Python 就行 改 C++ 重烧(换稳定性的代价) 把控制面(刷新决策、状态同步)收到离屏最近的一端之后,网络上只剩数据面——复杂度按数量级下降。1MB 缓冲、ARQ、看门狗、扫屏切块、USB 掉线 workaround 全都不存在了。
沉淀出来的一条经验:当排障已经把故障面收窄到一小撮已知嫌疑时,估算「绕过这条路径」的成本 vs「复现→定位→修复」的成本——绕过去往往更快。这里绕过的成本 = 加一个帧类型 + 一个小渲染引擎 + 一个小采集器(约半天),比把像素通路查穿便宜,而且顺手消灭了一整类问题。
同阶段还有两个值得带走的手法:
- 隔离自检(本地复现法):做 5 个固件自检阶段(ST1~ST5),每条生产路径都在固件本地复现一遍,数据全本地生成(排除网络/协议/传输),一次烧录分辨全部嫌疑。每条自检只和上一条差一个变量。当「本地自绘」永远干净、只有「网络推送」出斑马时,故障面一下午就劈到网络数据面了。自检做成编译开关(
-DEPD_SELFTEST)常驻代码——屏上再出任何异常,先跑一遍。 - 远程判屏:人不在屏前的时候,手机拍照 → 二值化 → 按列算暗占比 → 跑游程 RLE:黑白块宽是 tile 尺寸的整数倍 ⇒ 差分/合并层的锅;不是 ⇒ 波形/面板层的锅。屏上留四角角标当坐标标尺;本机把发出去的 tile 解回像素量黑占比,判「发送端是否无辜」。
五、不性感但致命的运维细节
- 版本锁死写进文档。核心 2.0.14 + epdiy 2.0.0 不是随便能换的——升级前先确认 legacy I2C API 还在。
- 自检代码是资产不是垃圾,留宏开关常驻。
- 数据协议宁 ASCII 不二进制:一行可 grep、人眼可读、CRC 照挂的键值,在这个带宽下比紧凑二进制强——带宽预算宽裕时,可调试性 > 字节数。
- 服务端采集纯标准库:
/proc+ sysfs 不需要 psutil,scp 一个文件就能跑。 - 服务端做开机自启:最后是 systemd unit(
Restart=always)。实测服务器掉电重启后拿到的 IP 一晚上漂了三次,板子 15s 内自己连回。当前拓扑里板子先连到一台常开的笔记本(portproxy 转发到服务器),我计划把服务器网线直插路由器 LAN 口去掉这一跳。 - 凭据放仓库外:WiFi 凭据放在 git/网盘之外的头文件,编译
-I引入。 - GPU 数据全走 sysfs,不起子进程、不用 root:
gpu_busy_percent、mem_info_vram_used/total、hwmon 温度/功耗/风扇/频率——比 shell 出rocm-smi轻得多。(AMD 是 rocm-smi/sysfs,不是 nvidia-smi。)
六、下一步
- GPU 信息再加细(per-process 级别,向 nvtop 看齐);板子直连服务器(去掉转发这一跳),整系统收敛成两节点。
- 静态层缓存 + 元素级脏重绘:真要往 2s 节奏以上提刷新时再上(内存还有 ~5MB PSRAM、~13MB flash 富余,唯一潜在瓶颈是 CPU 时间——触发线没到之前不优化)。
- 长期跑下来如果 DU 残影累积明显,再调 GC16 频率或把灰度内容切 GL16。
一句话总结
做「显示终端」,就让它当终端:渲染和刷新决策放在离屏最近的地方,网络只走数据。
有问题欢迎留言,帧协议和自检设计都可以聊。想看完整源码的(固件 + 协议 + 服务端 + 自检序列),评论区留言,我看到会发。
直接 github 上开源啊. 搞一个按钮可以在多台服务器之间 toggle. 这样一屏监控多机...
-
不错。比我买的那台画质还有大小都有明显提升。
这个东西其实很实用。比用SSH 监控或连接查看方便。
还有个作用。知道几点死机的。 -
,
 T terry 固定了此主题
-
ESP32 EPDiy V7 驱动 88元
ES108FC1并口墨水屏,1920×1080分辨率,170元/片
软件开发 18元(不要在忙时用梁子,虽然智力在线)最开始路线错了,服务传图块,并且控制墨水屏刷新
以下内容供AI 食用
用 ESP32 + 10.8 寸墨水屏做了台「服务器状态面板」,把踩过的 20 多个坑全摊出来
我手边有一台 Dell T7910 工作站,装了两张 R9700,想让它旁边常驻一块屏,24 小时盯着这台机器在干嘛——CPU、内存、网络,还有两块 GPU 的占用/显存/温度/风扇,看着像
btop/nvtop,但载体是一块 1920×1080 的 16 阶灰度墨水屏,常亮、无背光、功耗低到可以忽略。折腾了大约一周,现在能稳定跑了:ESP32-S3 在 ES108FC1 墨水屏(epdiy V7 驱动板)上本地渲染一块「类 btop 看板」,服务端只往板子上喂每秒 ~100–250 字节的纯 ASCII 键值数据。
真正有意思的不是架构,是这一路踩的 二十几个坑。这篇就是复盘:东西长什么样、架构怎么定、每个坑怎么填。打算做墨水屏 + MCU + 网络相关项目的,建议先看坑点部分。
一、做了个啥
目标:给一台 Linux 服务器(Dell T7910,2× R9700)做一块桌面/壁挂监视屏。常亮、无风扇、无背光——这种需求下墨水屏是唯一说得通的选择。
硬件:
部件 选型 备注 屏 ES108FC1(元太 E Ink) 10.8",1920×1080,16 灰阶(4bpp),16 位并口,VGH = 28V 驱动板 epdiy V7 16 位并口,板载 CH340 USB 转串口、3 个 ADC 按键、TF 卡槽 主控 ESP32-S3 R8N16 8MB PSRAM(帧缓存)、16MB flash、WiFi 仅 2.4G 固件 Arduino(核心 2.0.14)+ epdiy 库 2.0.0 编译产物 ~1.1MB(34%) 字体 FiraSans 12/20、OpenSans 8 粗体 只支持 ASCII 服务端 Python 3 纯标准库 读 /proc+ sysfs hwmon,零 pip 依赖终局架构(「终端模型」):
服务器(Python 采集器,1 Hz) │ 每秒推一行 ASCII 键值,~100–250 B │ "h=<主机名>|i=<内网IP>|t=12:14|c=12.4|n=32|k=...|m=6.9/125.9|...|g0=95,30207,32624,67,81,92,209,2990,2786|g1=..." ▼ ESP32-S3(TCP 客户端,主动连出去) │ 解析 → 本地渲染整块看板进 4bpp 帧缓存 ▼ epdiy → 墨水屏 刷新策略 100% 在板端本地:首帧 GC16(洗屏)→ 之后每 2s 一次 DU 差分 → 每 1800 帧插一次整屏 GC16(约 1 小时)清残影关键决策(也是这篇的重点):服务器只发数据,不发像素。ESP32 当一个「哑终端」,渲染和刷新决策全归自己。为什么这么定,第四节细说。
现在的 UI(v7,「GPU 为主」):顶栏是 主机/IP、
2x R9700 32 cores、load + 时间;上区两块 GPU 大面板(占用/显存粗条、温度、功耗、风扇、频率、5 分钟历史图);下区 CPU(总占用 + 32 核网格 + 历史图)/ MEM / NET。
二、墨水屏刷新模式——最该先搞懂的一件事
墨水屏项目全活死在这上面,而且规格书会骗你。
- 规格书里那句「刷新率 85Hz」是面板的电气喂帧能力,可见的画面转变速度由波形(waveform)决定。实测数字:整屏刷新 1~2.5s,局部刷新 0.5~1s。别按 85Hz 去设计交互。
- epdiy 暴露三种刷新模式,而且 模式 × 路径是个 2×2 矩阵,必须在你自己的屏上逐格验证:
路径 × 模式 本屏实测 局部 area + GC16(闪烁全刷波形) ✗ 画不全——一条纯黑带出来是 tile 尺寸的黑白相间块(「斑马纹」的形态学特征) 局部 area + DU(差分/1bit 快刷) ✓ 正常,0.5~2s 整屏 + GC16 ✓ 正常,26~68s 局部 area + GL16(16 阶非闪烁) ✓ 画得出,但擦不掉旧内容(残影挂几个小时) 最后沉淀的四条规则:
- 纯黑白内容(状态栏、时钟、进度条)一律走 DU(快 20 倍、电流小)。DU 是 1bit,图必须先硬阈值化成纯黑白。
- 清残影/洗屏一律走整屏 GC16。
- 禁用「局部 area + GC16」——这个组合在本屏是坏的。
- GL16 只用于真灰度内容,而且还得定期整屏 GC16 清残影。
「局部 + GC16」为什么坏,是个光看头文件看不出来的库 bug(坑点 B1)。
三、坑点全录(这篇的精华)
按层分类。都是实打实卡过我的。
A 硬件 / 板子层
# 坑 修法 / 判据 A1 商家示例里 epd_init(&ES120)(2560×1600)——根本不是你的屏。能点亮,但所有坐标/刷新窗口全按 2560 算,全对不上改成 &ES108FC(结构体定义main.c里就有,逐字抄)A2 每次波形刷屏 = 一次 USB 电流冲击 = CH340 掉线重枚举。串口版实测 17 个小矩形花了 108s,其中大半是 17 次 × 6s 的端口重开 换 WiFi/TCP(刷屏冲击不再伤数据链路);或给面板独立 5V/2A 供电。我把板子改插手机充电头后,掉线直接消失 A3 烧录后 Hard resetting via RTS无效,芯片停在 ROM 下载模式物理断电 / 按 RST A4 DTR/RTS 电平一动就触发板子的自动下载复位电路 开串口前先把 DTR/RTS 预置低 A5 ESP32-S3 只有 2.4GHz,5G SSID 直接 WL_NO_SSID_AVAIL连 2.4G A6 把 85Hz 当可见刷新率(见第二节) 按「秒」设计,别按「赫兹」 A7 板子把 IO19 给了 3 个 ADC 按键,而 S3 原生 USB 要吃 IO19/20 → 原生 USB 不可用。「USB 传数据」其实就是 CH340 串口 GPIO 预算要同时绕开 16 位并口和按键,没有第二条数据通路 B epdiy 库层(读源码,别凭记忆)
# 坑 修法 / 判据 B1 dirty_lines是malloc()出来从不清零——初始化不清、每次刷完也不清——而epd_difference_image_base()只重算本次 area 覆盖行的 dirty 标记。残留的 dirty 行就拿difference_fb里的旧差分数据去驱动波形 → 随机黑白块,块边界正好对齐 tile/area。这就是斑马纹的底层机制GC16 一律扩整屏(让所有行重算);每次局部刷新前 memset(hl.dirty_lines, 0, …)预清零B2 epd_write_string默认不画背景(EPD_DRAW_BACKGROUND没置位,只写前景字形像素)。旧内容留在帧缓存里,差分认为「没变」就永不刷 → 永久重影每帧开头整幅清白( epd_fill_rect(full_screen, 0xF0))。零性能损失:差分只送变化行B3 「局部 + GC16」画不全(见第二节) 模式 × 路径逐格单独验证 B4 固件只在开机画面写了字,首帧后再不碰帧缓存。主机差分只跟自己上一帧比,固件画过、主机不知道的东西永远擦不掉 固件改屏必须让主机也知道(或渲染前全清) B5 字体只带 ASCII,中文渲染成空白/方块 屏上文案只用英文 B6 epdiy 必须配核心 2.0.x:它的 pca9555.c用了#include <driver/i2c.h>(IDF legacy I2C 驱动),3.x 已删除锁死核心 2.0.14;升级前先确认这个 legacy API 还在不在 C 固件应用层
# 坑 修法 / 判据 C1 g_first(首帧强制 GC16)每次清屏后都被置回 true → 主机发的 DU 被固件悄悄升级成坏的「局部 + GC16」路径,主机侧的修复被完全抵消删掉一切「固件自作主张改刷新模式」的逻辑,模式完全由数据/flags 决定。判据:日志出现 mode=2(GC16)而主机明明发的是 DU flag——注意固件枚举(DU=1/GC16=2/GL16=5)和协议 flag(0x02=DU)是两套不同的数字C2 HardwareSerial::begin(baud, config, rx, tx)参数顺序是先 RX 后 TX。我按直觉写成(…, TX, RX)→ 固件 TX 顶到 CH340 自己的 TXD,两边对顶。极具迷惑性:能收帧、能刷屏,但日志/ACK 一句都上不来按 RX, TX 顺序传(本板 TX=GPIO43 / RX=GPIO44) C3 USB CDC 的日志字节被泵进了同一个协议解析器 → 每次刷屏 USB 重枚举都投杂散字节,整帧错位。坏帧率 45%→80% 非传输通道的字节流一律不许进解析器 C4 1MB 收帧缓冲放内部 RAM 挤爆堆 ps_malloc进 PSRAMC5 固定 x 落笔的文字(时间/数值)字宽一超就出画 epd_get_text_bounds()先量实际字宽再落笔(从右边缘右对齐)C6 固件链路看门狗 12s:服务端任何静默 > 12s 就拆链 服务端保证任何一次静默 < 12s(批内每 ~4s 回一次 ACK) C7 固定超时是错的:整屏帧光发送就要 11.3s,固定 2s 超时必然误判重传 → 死循环 超时按帧长自适应: max(基础值, 字节数/(波特率/10) + 基础值)C8 掉一个字节就永久失联,除非有两套恢复机制:① 空闲 100ms 丢半截帧(不丢的话之后每次重传的帧头都会被当 payload 吞掉 → 死锁);② 伪同步 22 字节重扫(帧头 CRC 不符时把已消费的字节重新扫一遍,救回被噪声偷走的真帧头) 两套都要。UART0 与启动日志共线,还要加抗噪(magic 重同步 + 双重 CRC + 整帧校验通过才 ACK) D 服务端 / 部署层
# 坑 修法 / 判据 D1 pkill -f epd_serve.py把自己所在的 shell 也杀了(cmdline 含同一串)→ 输出全空、进程「起不来」[e]pd括号技巧,或ss -ltnp取 pid 再kill <pid>D2 SSH 里 nohup &起的后台进程随会话死(systemd 用户 Linger=no)tmux new -d -s epd '… \| tee log'分离常驻(后来迁到 systemd service,见第五节)D3 CPU 差分公式:busy ≠ 各列求和,而是 total − (idle + iowait)。写错时空载恒显 ~50%。判据:「每核全 50% 但 load 只有 0.1」的矛盾busy = 总时间 − idle − iowait D4 Arch 的串口组是 uucp(不是 Debian 的dialout)usermod -aG uucp <user>重登录D5 开机 WiFi.scanNetworks()饿死 IDLE(core0) →task_wdtabort 重启循环别开机扫描,直接 WiFi.begin(ssid, key)D6 「静默 80ms = 批末」的判定是错的——链路抖动被当批末 → 巨型 GC16 → 板子卡死在刷屏里 显式发 PING 帧标记批末;兜底空闲阈值放宽到 1500ms D7 清屏帧回两条 ACK,没收干净后面所有 ACK 索引整体错位 逐条对齐收 D8 glob("/sys/class/drm/card[0-9]*")会把card0-DP-4也算进来 → 双卡只读到一张re.fullmatch(r".*/card\d+", path)过滤D9 sysfs 的 cardN顺序和rocm-smi的GPU[x]是反的(而且本机物理下层那张卡散热更好)。按 rocm-smi 序号写标签会把 GPU 标反别抄 rocm-smi 的编号,先搞清映射 D10 整屏 1MB 帧必被固件当「半帧」丢掉( dropped a half frame)整屏重画切 64×64 tile 逐块发,固件自动合并成一次大刷新
四、架构转向(真正的教训)
第一版是推像素的:服务端 PIL 渲染、差分成 64×64 tile 推过去,配 ARQ 补发、看门狗、批时序。能跑——直到斑马纹 bug 出现,我花了一整天追。
排障过程中反复出现同一类症状:「主机和固件对同一状态的理解不一致」(谁定 GC16、ACK 收到第几条、什么算批末)。这是分布式状态一致性问题,说明职责切错了地方。
于是我把整条像素通路砍了,切到终端模型:服务器发一行数据,ESP32 本地渲染、本地决策。
推像素(旧) 终端模型(现) 链路负载 整帧 1MB / 差分几十 KB ~100–250 B/s(一行 ASCII 键值) 渲染 服务端 PIL ESP32 本地(fill_rect + write_string——btop 看板就是矩形 + 字) 刷新决策 跨网络协调(flags/ARQ/看门狗/扫屏时序) 纯固件本地 改 UI 改 Python 就行 改 C++ 重烧(换稳定性的代价) 把控制面(刷新决策、状态同步)收到离屏最近的一端之后,网络上只剩数据面——复杂度按数量级下降。1MB 缓冲、ARQ、看门狗、扫屏切块、USB 掉线 workaround 全都不存在了。
沉淀出来的一条经验:当排障已经把故障面收窄到一小撮已知嫌疑时,估算「绕过这条路径」的成本 vs「复现→定位→修复」的成本——绕过去往往更快。这里绕过的成本 = 加一个帧类型 + 一个小渲染引擎 + 一个小采集器(约半天),比把像素通路查穿便宜,而且顺手消灭了一整类问题。
同阶段还有两个值得带走的手法:
- 隔离自检(本地复现法):做 5 个固件自检阶段(ST1~ST5),每条生产路径都在固件本地复现一遍,数据全本地生成(排除网络/协议/传输),一次烧录分辨全部嫌疑。每条自检只和上一条差一个变量。当「本地自绘」永远干净、只有「网络推送」出斑马时,故障面一下午就劈到网络数据面了。自检做成编译开关(
-DEPD_SELFTEST)常驻代码——屏上再出任何异常,先跑一遍。 - 远程判屏:人不在屏前的时候,手机拍照 → 二值化 → 按列算暗占比 → 跑游程 RLE:黑白块宽是 tile 尺寸的整数倍 ⇒ 差分/合并层的锅;不是 ⇒ 波形/面板层的锅。屏上留四角角标当坐标标尺;本机把发出去的 tile 解回像素量黑占比,判「发送端是否无辜」。
五、不性感但致命的运维细节
- 版本锁死写进文档。核心 2.0.14 + epdiy 2.0.0 不是随便能换的——升级前先确认 legacy I2C API 还在。
- 自检代码是资产不是垃圾,留宏开关常驻。
- 数据协议宁 ASCII 不二进制:一行可 grep、人眼可读、CRC 照挂的键值,在这个带宽下比紧凑二进制强——带宽预算宽裕时,可调试性 > 字节数。
- 服务端采集纯标准库:
/proc+ sysfs 不需要 psutil,scp 一个文件就能跑。 - 服务端做开机自启:最后是 systemd unit(
Restart=always)。实测服务器掉电重启后拿到的 IP 一晚上漂了三次,板子 15s 内自己连回。当前拓扑里板子先连到一台常开的笔记本(portproxy 转发到服务器),我计划把服务器网线直插路由器 LAN 口去掉这一跳。 - 凭据放仓库外:WiFi 凭据放在 git/网盘之外的头文件,编译
-I引入。 - GPU 数据全走 sysfs,不起子进程、不用 root:
gpu_busy_percent、mem_info_vram_used/total、hwmon 温度/功耗/风扇/频率——比 shell 出rocm-smi轻得多。(AMD 是 rocm-smi/sysfs,不是 nvidia-smi。)
六、下一步
- GPU 信息再加细(per-process 级别,向 nvtop 看齐);板子直连服务器(去掉转发这一跳),整系统收敛成两节点。
- 静态层缓存 + 元素级脏重绘:真要往 2s 节奏以上提刷新时再上(内存还有 ~5MB PSRAM、~13MB flash 富余,唯一潜在瓶颈是 CPU 时间——触发线没到之前不优化)。
- 长期跑下来如果 DU 残影累积明显,再调 GC16 频率或把灰度内容切 GL16。
一句话总结
做「显示终端」,就让它当终端:渲染和刷新决策放在离屏最近的地方,网络只走数据。
有问题欢迎留言,帧协议和自检设计都可以聊。想看完整源码的(固件 + 协议 + 服务端 + 自检序列),评论区留言,我看到会发。
直接 github 上开源啊. 搞一个按钮可以在多台服务器之间 toggle. 这样一屏监控多机...
-
ESP32 EPDiy V7 驱动 88元
ES108FC1并口墨水屏,1920×1080分辨率,170元/片
软件开发 18元(不要在忙时用梁子,虽然智力在线)最开始路线错了,服务传图块,并且控制墨水屏刷新
以下内容供AI 食用
用 ESP32 + 10.8 寸墨水屏做了台「服务器状态面板」,把踩过的 20 多个坑全摊出来
我手边有一台 Dell T7910 工作站,装了两张 R9700,想让它旁边常驻一块屏,24 小时盯着这台机器在干嘛——CPU、内存、网络,还有两块 GPU 的占用/显存/温度/风扇,看着像
btop/nvtop,但载体是一块 1920×1080 的 16 阶灰度墨水屏,常亮、无背光、功耗低到可以忽略。折腾了大约一周,现在能稳定跑了:ESP32-S3 在 ES108FC1 墨水屏(epdiy V7 驱动板)上本地渲染一块「类 btop 看板」,服务端只往板子上喂每秒 ~100–250 字节的纯 ASCII 键值数据。
真正有意思的不是架构,是这一路踩的 二十几个坑。这篇就是复盘:东西长什么样、架构怎么定、每个坑怎么填。打算做墨水屏 + MCU + 网络相关项目的,建议先看坑点部分。
一、做了个啥
目标:给一台 Linux 服务器(Dell T7910,2× R9700)做一块桌面/壁挂监视屏。常亮、无风扇、无背光——这种需求下墨水屏是唯一说得通的选择。
硬件:
部件 选型 备注 屏 ES108FC1(元太 E Ink) 10.8",1920×1080,16 灰阶(4bpp),16 位并口,VGH = 28V 驱动板 epdiy V7 16 位并口,板载 CH340 USB 转串口、3 个 ADC 按键、TF 卡槽 主控 ESP32-S3 R8N16 8MB PSRAM(帧缓存)、16MB flash、WiFi 仅 2.4G 固件 Arduino(核心 2.0.14)+ epdiy 库 2.0.0 编译产物 ~1.1MB(34%) 字体 FiraSans 12/20、OpenSans 8 粗体 只支持 ASCII 服务端 Python 3 纯标准库 读 /proc+ sysfs hwmon,零 pip 依赖终局架构(「终端模型」):
服务器(Python 采集器,1 Hz) │ 每秒推一行 ASCII 键值,~100–250 B │ "h=<主机名>|i=<内网IP>|t=12:14|c=12.4|n=32|k=...|m=6.9/125.9|...|g0=95,30207,32624,67,81,92,209,2990,2786|g1=..." ▼ ESP32-S3(TCP 客户端,主动连出去) │ 解析 → 本地渲染整块看板进 4bpp 帧缓存 ▼ epdiy → 墨水屏 刷新策略 100% 在板端本地:首帧 GC16(洗屏)→ 之后每 2s 一次 DU 差分 → 每 1800 帧插一次整屏 GC16(约 1 小时)清残影关键决策(也是这篇的重点):服务器只发数据,不发像素。ESP32 当一个「哑终端」,渲染和刷新决策全归自己。为什么这么定,第四节细说。
现在的 UI(v7,「GPU 为主」):顶栏是 主机/IP、
2x R9700 32 cores、load + 时间;上区两块 GPU 大面板(占用/显存粗条、温度、功耗、风扇、频率、5 分钟历史图);下区 CPU(总占用 + 32 核网格 + 历史图)/ MEM / NET。
二、墨水屏刷新模式——最该先搞懂的一件事
墨水屏项目全活死在这上面,而且规格书会骗你。
- 规格书里那句「刷新率 85Hz」是面板的电气喂帧能力,可见的画面转变速度由波形(waveform)决定。实测数字:整屏刷新 1~2.5s,局部刷新 0.5~1s。别按 85Hz 去设计交互。
- epdiy 暴露三种刷新模式,而且 模式 × 路径是个 2×2 矩阵,必须在你自己的屏上逐格验证:
路径 × 模式 本屏实测 局部 area + GC16(闪烁全刷波形) ✗ 画不全——一条纯黑带出来是 tile 尺寸的黑白相间块(「斑马纹」的形态学特征) 局部 area + DU(差分/1bit 快刷) ✓ 正常,0.5~2s 整屏 + GC16 ✓ 正常,26~68s 局部 area + GL16(16 阶非闪烁) ✓ 画得出,但擦不掉旧内容(残影挂几个小时) 最后沉淀的四条规则:
- 纯黑白内容(状态栏、时钟、进度条)一律走 DU(快 20 倍、电流小)。DU 是 1bit,图必须先硬阈值化成纯黑白。
- 清残影/洗屏一律走整屏 GC16。
- 禁用「局部 area + GC16」——这个组合在本屏是坏的。
- GL16 只用于真灰度内容,而且还得定期整屏 GC16 清残影。
「局部 + GC16」为什么坏,是个光看头文件看不出来的库 bug(坑点 B1)。
三、坑点全录(这篇的精华)
按层分类。都是实打实卡过我的。
A 硬件 / 板子层
# 坑 修法 / 判据 A1 商家示例里 epd_init(&ES120)(2560×1600)——根本不是你的屏。能点亮,但所有坐标/刷新窗口全按 2560 算,全对不上改成 &ES108FC(结构体定义main.c里就有,逐字抄)A2 每次波形刷屏 = 一次 USB 电流冲击 = CH340 掉线重枚举。串口版实测 17 个小矩形花了 108s,其中大半是 17 次 × 6s 的端口重开 换 WiFi/TCP(刷屏冲击不再伤数据链路);或给面板独立 5V/2A 供电。我把板子改插手机充电头后,掉线直接消失 A3 烧录后 Hard resetting via RTS无效,芯片停在 ROM 下载模式物理断电 / 按 RST A4 DTR/RTS 电平一动就触发板子的自动下载复位电路 开串口前先把 DTR/RTS 预置低 A5 ESP32-S3 只有 2.4GHz,5G SSID 直接 WL_NO_SSID_AVAIL连 2.4G A6 把 85Hz 当可见刷新率(见第二节) 按「秒」设计,别按「赫兹」 A7 板子把 IO19 给了 3 个 ADC 按键,而 S3 原生 USB 要吃 IO19/20 → 原生 USB 不可用。「USB 传数据」其实就是 CH340 串口 GPIO 预算要同时绕开 16 位并口和按键,没有第二条数据通路 B epdiy 库层(读源码,别凭记忆)
# 坑 修法 / 判据 B1 dirty_lines是malloc()出来从不清零——初始化不清、每次刷完也不清——而epd_difference_image_base()只重算本次 area 覆盖行的 dirty 标记。残留的 dirty 行就拿difference_fb里的旧差分数据去驱动波形 → 随机黑白块,块边界正好对齐 tile/area。这就是斑马纹的底层机制GC16 一律扩整屏(让所有行重算);每次局部刷新前 memset(hl.dirty_lines, 0, …)预清零B2 epd_write_string默认不画背景(EPD_DRAW_BACKGROUND没置位,只写前景字形像素)。旧内容留在帧缓存里,差分认为「没变」就永不刷 → 永久重影每帧开头整幅清白( epd_fill_rect(full_screen, 0xF0))。零性能损失:差分只送变化行B3 「局部 + GC16」画不全(见第二节) 模式 × 路径逐格单独验证 B4 固件只在开机画面写了字,首帧后再不碰帧缓存。主机差分只跟自己上一帧比,固件画过、主机不知道的东西永远擦不掉 固件改屏必须让主机也知道(或渲染前全清) B5 字体只带 ASCII,中文渲染成空白/方块 屏上文案只用英文 B6 epdiy 必须配核心 2.0.x:它的 pca9555.c用了#include <driver/i2c.h>(IDF legacy I2C 驱动),3.x 已删除锁死核心 2.0.14;升级前先确认这个 legacy API 还在不在 C 固件应用层
# 坑 修法 / 判据 C1 g_first(首帧强制 GC16)每次清屏后都被置回 true → 主机发的 DU 被固件悄悄升级成坏的「局部 + GC16」路径,主机侧的修复被完全抵消删掉一切「固件自作主张改刷新模式」的逻辑,模式完全由数据/flags 决定。判据:日志出现 mode=2(GC16)而主机明明发的是 DU flag——注意固件枚举(DU=1/GC16=2/GL16=5)和协议 flag(0x02=DU)是两套不同的数字C2 HardwareSerial::begin(baud, config, rx, tx)参数顺序是先 RX 后 TX。我按直觉写成(…, TX, RX)→ 固件 TX 顶到 CH340 自己的 TXD,两边对顶。极具迷惑性:能收帧、能刷屏,但日志/ACK 一句都上不来按 RX, TX 顺序传(本板 TX=GPIO43 / RX=GPIO44) C3 USB CDC 的日志字节被泵进了同一个协议解析器 → 每次刷屏 USB 重枚举都投杂散字节,整帧错位。坏帧率 45%→80% 非传输通道的字节流一律不许进解析器 C4 1MB 收帧缓冲放内部 RAM 挤爆堆 ps_malloc进 PSRAMC5 固定 x 落笔的文字(时间/数值)字宽一超就出画 epd_get_text_bounds()先量实际字宽再落笔(从右边缘右对齐)C6 固件链路看门狗 12s:服务端任何静默 > 12s 就拆链 服务端保证任何一次静默 < 12s(批内每 ~4s 回一次 ACK) C7 固定超时是错的:整屏帧光发送就要 11.3s,固定 2s 超时必然误判重传 → 死循环 超时按帧长自适应: max(基础值, 字节数/(波特率/10) + 基础值)C8 掉一个字节就永久失联,除非有两套恢复机制:① 空闲 100ms 丢半截帧(不丢的话之后每次重传的帧头都会被当 payload 吞掉 → 死锁);② 伪同步 22 字节重扫(帧头 CRC 不符时把已消费的字节重新扫一遍,救回被噪声偷走的真帧头) 两套都要。UART0 与启动日志共线,还要加抗噪(magic 重同步 + 双重 CRC + 整帧校验通过才 ACK) D 服务端 / 部署层
# 坑 修法 / 判据 D1 pkill -f epd_serve.py把自己所在的 shell 也杀了(cmdline 含同一串)→ 输出全空、进程「起不来」[e]pd括号技巧,或ss -ltnp取 pid 再kill <pid>D2 SSH 里 nohup &起的后台进程随会话死(systemd 用户 Linger=no)tmux new -d -s epd '… \| tee log'分离常驻(后来迁到 systemd service,见第五节)D3 CPU 差分公式:busy ≠ 各列求和,而是 total − (idle + iowait)。写错时空载恒显 ~50%。判据:「每核全 50% 但 load 只有 0.1」的矛盾busy = 总时间 − idle − iowait D4 Arch 的串口组是 uucp(不是 Debian 的dialout)usermod -aG uucp <user>重登录D5 开机 WiFi.scanNetworks()饿死 IDLE(core0) →task_wdtabort 重启循环别开机扫描,直接 WiFi.begin(ssid, key)D6 「静默 80ms = 批末」的判定是错的——链路抖动被当批末 → 巨型 GC16 → 板子卡死在刷屏里 显式发 PING 帧标记批末;兜底空闲阈值放宽到 1500ms D7 清屏帧回两条 ACK,没收干净后面所有 ACK 索引整体错位 逐条对齐收 D8 glob("/sys/class/drm/card[0-9]*")会把card0-DP-4也算进来 → 双卡只读到一张re.fullmatch(r".*/card\d+", path)过滤D9 sysfs 的 cardN顺序和rocm-smi的GPU[x]是反的(而且本机物理下层那张卡散热更好)。按 rocm-smi 序号写标签会把 GPU 标反别抄 rocm-smi 的编号,先搞清映射 D10 整屏 1MB 帧必被固件当「半帧」丢掉( dropped a half frame)整屏重画切 64×64 tile 逐块发,固件自动合并成一次大刷新
四、架构转向(真正的教训)
第一版是推像素的:服务端 PIL 渲染、差分成 64×64 tile 推过去,配 ARQ 补发、看门狗、批时序。能跑——直到斑马纹 bug 出现,我花了一整天追。
排障过程中反复出现同一类症状:「主机和固件对同一状态的理解不一致」(谁定 GC16、ACK 收到第几条、什么算批末)。这是分布式状态一致性问题,说明职责切错了地方。
于是我把整条像素通路砍了,切到终端模型:服务器发一行数据,ESP32 本地渲染、本地决策。
推像素(旧) 终端模型(现) 链路负载 整帧 1MB / 差分几十 KB ~100–250 B/s(一行 ASCII 键值) 渲染 服务端 PIL ESP32 本地(fill_rect + write_string——btop 看板就是矩形 + 字) 刷新决策 跨网络协调(flags/ARQ/看门狗/扫屏时序) 纯固件本地 改 UI 改 Python 就行 改 C++ 重烧(换稳定性的代价) 把控制面(刷新决策、状态同步)收到离屏最近的一端之后,网络上只剩数据面——复杂度按数量级下降。1MB 缓冲、ARQ、看门狗、扫屏切块、USB 掉线 workaround 全都不存在了。
沉淀出来的一条经验:当排障已经把故障面收窄到一小撮已知嫌疑时,估算「绕过这条路径」的成本 vs「复现→定位→修复」的成本——绕过去往往更快。这里绕过的成本 = 加一个帧类型 + 一个小渲染引擎 + 一个小采集器(约半天),比把像素通路查穿便宜,而且顺手消灭了一整类问题。
同阶段还有两个值得带走的手法:
- 隔离自检(本地复现法):做 5 个固件自检阶段(ST1~ST5),每条生产路径都在固件本地复现一遍,数据全本地生成(排除网络/协议/传输),一次烧录分辨全部嫌疑。每条自检只和上一条差一个变量。当「本地自绘」永远干净、只有「网络推送」出斑马时,故障面一下午就劈到网络数据面了。自检做成编译开关(
-DEPD_SELFTEST)常驻代码——屏上再出任何异常,先跑一遍。 - 远程判屏:人不在屏前的时候,手机拍照 → 二值化 → 按列算暗占比 → 跑游程 RLE:黑白块宽是 tile 尺寸的整数倍 ⇒ 差分/合并层的锅;不是 ⇒ 波形/面板层的锅。屏上留四角角标当坐标标尺;本机把发出去的 tile 解回像素量黑占比,判「发送端是否无辜」。
五、不性感但致命的运维细节
- 版本锁死写进文档。核心 2.0.14 + epdiy 2.0.0 不是随便能换的——升级前先确认 legacy I2C API 还在。
- 自检代码是资产不是垃圾,留宏开关常驻。
- 数据协议宁 ASCII 不二进制:一行可 grep、人眼可读、CRC 照挂的键值,在这个带宽下比紧凑二进制强——带宽预算宽裕时,可调试性 > 字节数。
- 服务端采集纯标准库:
/proc+ sysfs 不需要 psutil,scp 一个文件就能跑。 - 服务端做开机自启:最后是 systemd unit(
Restart=always)。实测服务器掉电重启后拿到的 IP 一晚上漂了三次,板子 15s 内自己连回。当前拓扑里板子先连到一台常开的笔记本(portproxy 转发到服务器),我计划把服务器网线直插路由器 LAN 口去掉这一跳。 - 凭据放仓库外:WiFi 凭据放在 git/网盘之外的头文件,编译
-I引入。 - GPU 数据全走 sysfs,不起子进程、不用 root:
gpu_busy_percent、mem_info_vram_used/total、hwmon 温度/功耗/风扇/频率——比 shell 出rocm-smi轻得多。(AMD 是 rocm-smi/sysfs,不是 nvidia-smi。)
六、下一步
- GPU 信息再加细(per-process 级别,向 nvtop 看齐);板子直连服务器(去掉转发这一跳),整系统收敛成两节点。
- 静态层缓存 + 元素级脏重绘:真要往 2s 节奏以上提刷新时再上(内存还有 ~5MB PSRAM、~13MB flash 富余,唯一潜在瓶颈是 CPU 时间——触发线没到之前不优化)。
- 长期跑下来如果 DU 残影累积明显,再调 GC16 频率或把灰度内容切 GL16。
一句话总结
做「显示终端」,就让它当终端:渲染和刷新决策放在离屏最近的地方,网络只走数据。
有问题欢迎留言,帧协议和自检设计都可以聊。想看完整源码的(固件 + 协议 + 服务端 + 自检序列),评论区留言,我看到会发。
-
可以。ESP32 自带 WiFi(部分型号还能外接以太网 PHY),跑 HTTP/WebSocket/MQTT 客户端都没问题,NTP 对时也够用。做状态看板几点建议:
- 服务器侧开一个只读 JSON 状态接口,或直接发 MQTT 主题;
- 墨水屏用 MQTT 推送,别高频轮询——刷新次数能省则省,墨水屏寿命和闪屏都怕勤刷;
- 接口加 token 或只读账号,别把内网接口裸奔(走了 TailScale 也算多一层);
- 要省电就 deep sleep 定时唤醒,墨水屏断电会保留画面。
Kindle 那条路要越狱 + 常驻,折腾成本比 ESP32 + EPDiy 高,不太推荐。
-
-
可以。ESP32 自带 WiFi(部分型号还能外接以太网 PHY),跑 HTTP/WebSocket/MQTT 客户端都没问题,NTP 对时也够用。做状态看板几点建议:
- 服务器侧开一个只读 JSON 状态接口,或直接发 MQTT 主题;
- 墨水屏用 MQTT 推送,别高频轮询——刷新次数能省则省,墨水屏寿命和闪屏都怕勤刷;
- 接口加 token 或只读账号,别把内网接口裸奔(走了 TailScale 也算多一层);
- 要省电就 deep sleep 定时唤醒,墨水屏断电会保留画面。
Kindle 那条路要越狱 + 常驻,折腾成本比 ESP32 + EPDiy 高,不太推荐。
-
可以。ESP32 自带 WiFi(部分型号还能外接以太网 PHY),跑 HTTP/WebSocket/MQTT 客户端都没问题,NTP 对时也够用。做状态看板几点建议:
- 服务器侧开一个只读 JSON 状态接口,或直接发 MQTT 主题;
- 墨水屏用 MQTT 推送,别高频轮询——刷新次数能省则省,墨水屏寿命和闪屏都怕勤刷;
- 接口加 token 或只读账号,别把内网接口裸奔(走了 TailScale 也算多一层);
- 要省电就 deep sleep 定时唤醒,墨水屏断电会保留画面。
Kindle 那条路要越狱 + 常驻,折腾成本比 ESP32 + EPDiy 高,不太推荐。
可以。ESP32 自带 WiFi(部分型号还能外接以太网 PHY),跑 HTTP/WebSocket/MQTT 客户端都没问题,NTP 对时也够用。做状态看板几点建议:
- 服务器侧开一个只读 JSON 状态接口,或直接发 MQTT 主题;
- 墨水屏用 MQTT 推送,别高频轮询——刷新次数能省则省,墨水屏寿命和闪屏都怕勤刷;
- 接口加 token 或只读账号,别把内网接口裸奔(走了 TailScale 也算多一层);
- 要省电就 deep sleep 定时唤醒,墨水屏断电会保留画面。
Kindle 那条路要越狱 + 常驻,折腾成本比 ESP32 + EPDiy 高,不太推荐。
btop nvtop 也是1000 ~ 2000ms 的刷新率
我同在2000ms 看着没啥问题,响应那么快意义不大。
-
墨水屏用 MQTT 推送,别高频轮询——刷新次数能省则省,墨水屏寿命和闪屏都怕勤刷;
接口加 token 或只读账号,别把内网接口裸奔(走了 TailScale 也算多一层);
要省电就 deep sleep 定时唤醒,墨水屏断电会保留画面。這樣墨水屏不適合當即時的監控螢幕了? 墨水屏寿命和闪屏都怕勤刷
現在一般的彩色螢幕好像也不貴, 墨水屏商業用途要使用在哪些方面 才有利基點?OLED 怕这种工况。
如果墨水屏怕频繁刷新率的话, 那墨水显示器也没法活了,那可一秒起码30帧率。
墨水屏最适合静态的展示,但看板软件2秒一次的我感觉够了。
并且才170块,能用2年就够了
-
,系统 取消固定了此主题