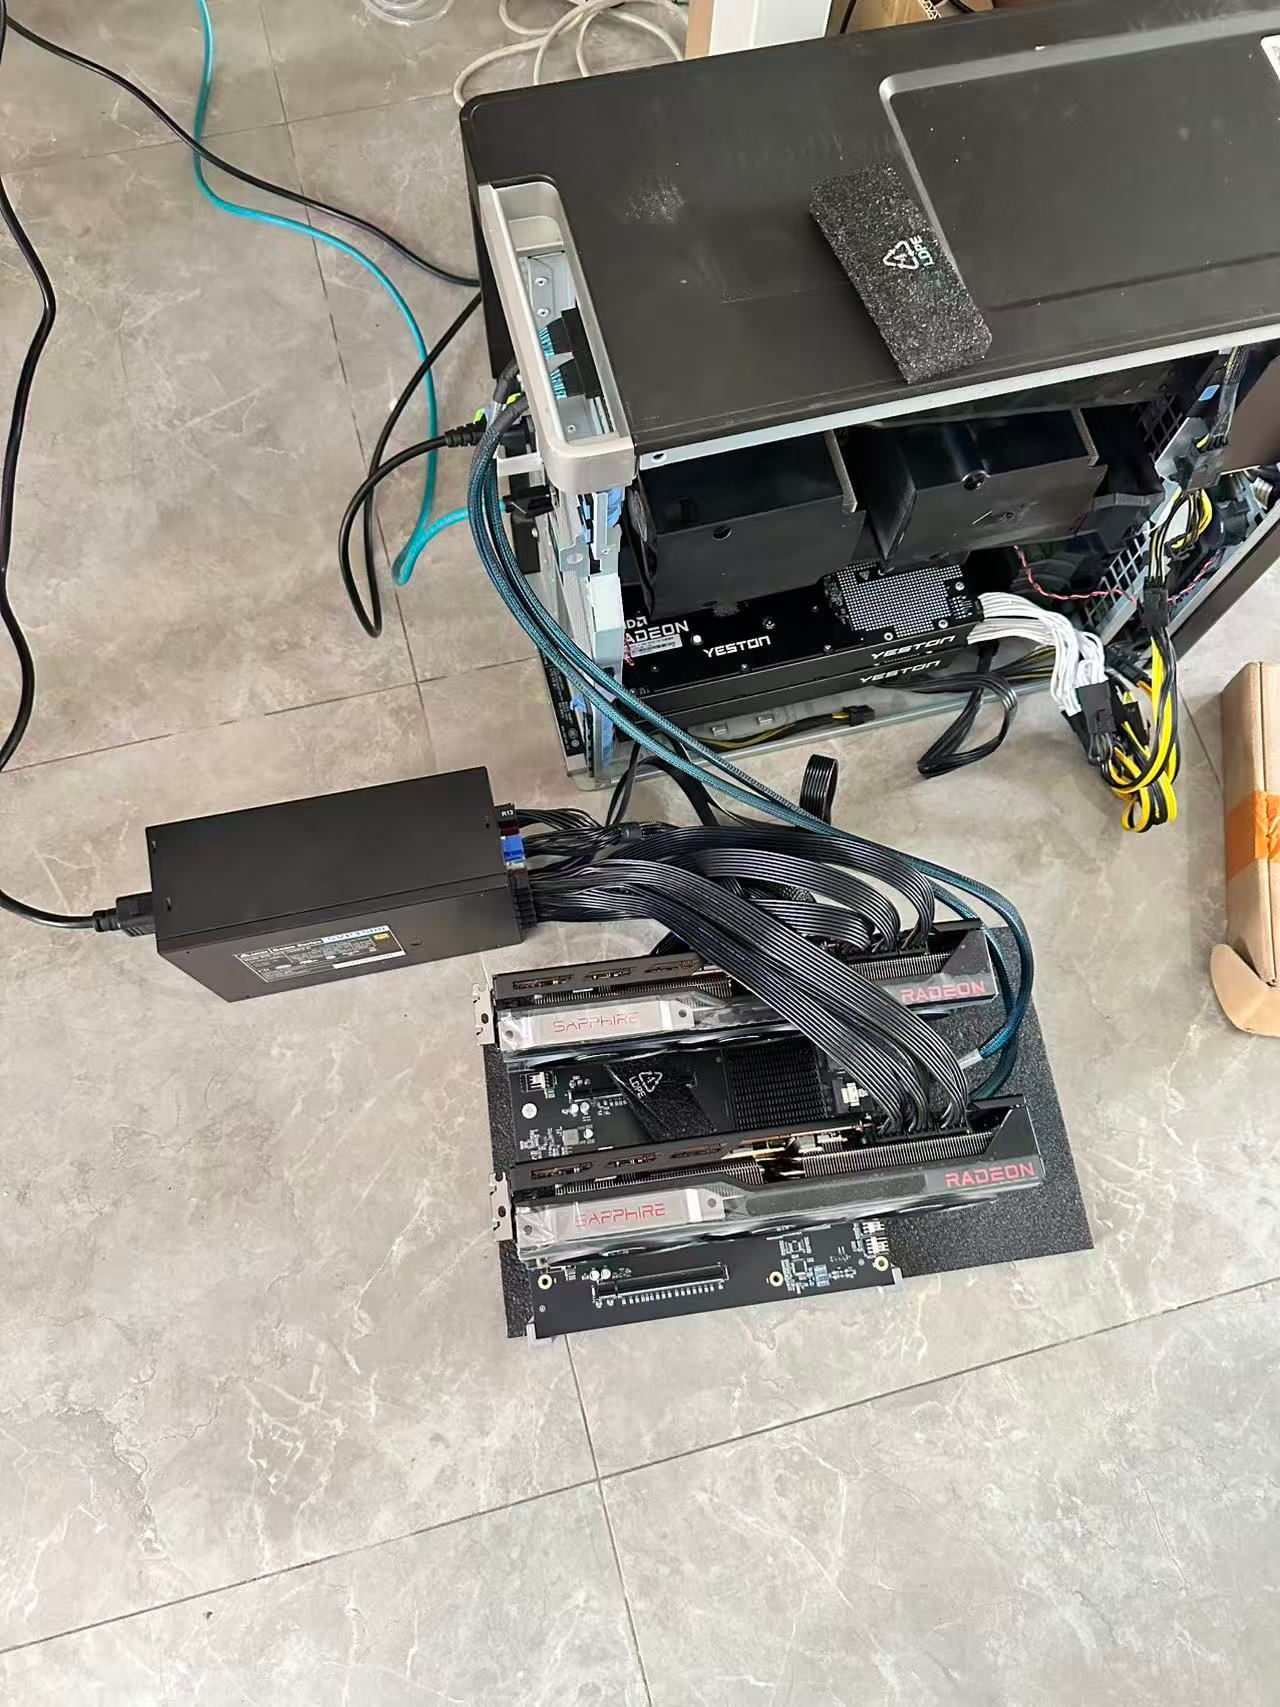
X99 不能P2P让我很难受 。 买Pcie switch(260926死缓改判无罪,交换机完美实现P2P 9月27:TP2 Qwen3.8 Q8 60t/s)
-
@suboyang 所以不是所有 X99-TF 都支援 ReBAR 吗?
-
這樣一張PCIe外接版 2380元也蠻省的 不用再額外購買一台電腦 就能一個PCIe x 16槽 外接放上四張顯示卡 (x4/x4/x4/x4)
而且空間夠大 不用擔心顯卡放不下 , 散熱也更好 -
所以我能理解成花了兩千五不到只要那東西至少有一槽PCIE就能不管甚麼垃圾板就能跑4卡p2p?
-
我也为自己的 x99 主板研究过。有些是可以通过自行修改 BIOS 解决的,而且确实有人玩这个,比如:https://winraid.level1techs.com/t/request-ga-x99-ud4p-bios-with-above-4g-decoding/104550
-
-
-
我有DELL T7920 (一代、二代Xeon Scalable),它理论上是支持Rebar的,(因为7920 Rack的BIOS里有rebar size选项),但工作站T7920的最新BIOS仍然只有Above4G Decoding,没有Rebar size设置。
我和你一样,用Linux 命令行看到的bar size是256M
网上有破解办法:
https://github.com/xCuri0/ReBarUEFI/discussions/331
我还没来得及试。我有DELL T7920 (一代、二代Xeon Scalable),它理论上是支持Rebar的,(因为7920 Rack的BIOS里有rebar size选项),但工作站T7920的最新BIOS仍然只有Above4G Decoding,没有Rebar size设置。
我和你一样,用Linux 命令行看到的bar size是256M
网上有破解办法:
https://github.com/xCuri0/ReBarUEFI/discussions/331
我还没来得及试。有戏我的朋友,刚刚试过了。正在测试。
-
我有DELL T7920 (一代、二代Xeon Scalable),它理论上是支持Rebar的,(因为7920 Rack的BIOS里有rebar size选项),但工作站T7920的最新BIOS仍然只有Above4G Decoding,没有Rebar size设置。
我和你一样,用Linux 命令行看到的bar size是256M
网上有破解办法:
https://github.com/xCuri0/ReBarUEFI/discussions/331
我还没来得及试。如果有 above 4g, 只是 rebar 不成功, 风险较高的做法是魔改 bios, 风险低(其实就是无风险)的做法是给 kernel 打 patch (把问题描述给 AI, 它帮你搞定). 这里我假定 above 4g以后, /proc/iomem 上看给 prefetchable space留的空间是足够大的 (这个假定在工作站主板上基本是成立的, 至少256G起吧).
正在测试
-
T7910 PCIE SWITCH 双卡推理续篇:自编 ReBAR 内核吃下 32G 大 BAR、7900XTX 解锁 2000MHz,附一整天的实测数据
上篇:《双 7900XTX + PCIe 交换机 + SGLang TP=2 实测与掉卡复盘》《T7910 双卡 AI 推理全记录:从 7900XTX 掉总线到 R9700 打通 P2P》。
本篇只写增量:内核层的大 BAR 补丁、限频的真实代价、通信栈为什么吃不到收益、以及一批带口径的速度/时间数据。平台、装机、采购价上篇讲过了,不再重复。鸣谢:
@PhoenixRise2026
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@jenaflex 说:
网上有破解办法:
https://github.com/xCuri0/ReBarUEFI/discussions/331
我还没来得及试。如果有 above 4g, 只是 rebar 不成功, 风险较高的做法是魔改 bios, 风险低(其实就是无风险)的做法是给 kernel 打 patch (把问题描述给 AI, 它帮你搞定). 这里我假> 定 above 4g以后, /proc/iomem 上看给 prefetchable space留的空间是足够大的 (这个假定在工作站主板上基本是成立的, 至少256G起吧).
@flyer666
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec
https://lcz.me/topic/1532TL;DR
事项 结果 一句话 上游 ReBAR headroom 补丁自行编进内核  成了
双卡同处一台交换机时,两条下游链各拿到精确 32 GiB,P2P 从 False 变 True 7900XTX 限频档位 1500 → 2000 MHz 成了,且收益最大长文(≈3 万 token)55.85s → 38.39s(−31%),单流稳态 decode 40~52 → 54~75 tok/s amdsmi 补进推理环境  ️ 装上了,但没吃到收益
报错从「amdsmi 未定义」前进到「sgl_kernel 缺算子」,环境层障碍已清、算子层仍缺 symm-mem / multimem 通信优化  此路不通
SGLang 在 world_size=2时主动禁用 multimem,启动参数默认全 False上游 PR #34058(prefill/decode 公平性)回移 移植成功、参数生效同一个短请求的最大断流间隔 47.58s → 5.06s(−89.4%):默认配置下,一个 4.8 万 token 的 prefill 会让已经解码起来的请求整段停摆 nvtop 显存看板 修好了3.0.2 的 fdinfo 断言 bug(同一 client_id 被两个 fd 引用),换新版解决 跨根口 P2P(R9700  7900XTX) 硬件限制
can_device_access_peer=False,新旧内核同值,与 BAR 无关交换机路径带宽 ️ 有天花板卡 交换机是 Gen4 x16,但内部部分跳只跑 Gen2 x8给赶时间的人:这一天里唯一"一改就见效、幅度又大"的是限频档位(−31% 长文时延);最费劲、看起来最"高级"的大 BAR / 自定义 All-Reduce,收益要么体现在"能不能跑"、要么干脆吃不到。先量再改。
一、今天想解决的三件事(思路,不是结论)
1. 大 BAR 与 P2P 是两件事
上篇的结论是"P2P 通了",但当时有个没解释的怪现象:卡片报的 BAR 只有 256M,而 P2P 时灵时不灵。这里要分三层看:
- 能不能寻址到对方显存(P2P):由芯片组/拓扑/内核白名单决定;
- BAR 窗口够不够大(ReBAR):决定大块 DMA 能不能一次性映射过去,还是被切成一堆小块来回搬运;
- 内核愿不愿意在启动时把预留窗口让出来:这是最容易忽略的一层——如果 PCI 子系统在枚举时就把 prefetchable 窗口"分干净"了,后面再想要 32G 就没有余地了。
→ 所以先做了对照:同一张卡,旧内核 256M + P2P False;新内核 32G + P2P True。同一硬件、同一槽位,只换内核,这就是判据。
2. "防跳闸"的限频,代价是整整 1.9 倍
上篇里有一条限功率服务,注释写得很清楚:压缩瞬态电流尖峰、防市电跳闸。它把 SCLK 压到 1500MHz。于是出现了本文最容易被误判的一段:"同一个服务,性能只有上篇的一半"——一度怀疑是交换机、大 BAR、P2P 没生效。
真凶是限频:负载中实测
sclk = 1233 MHz(默认 boost 2371MHz ⇒ 1.9× 差距),与"100 → 50 tok/s"精确对应。方向选错,会把一小时耗在错误的地方。3. 通信优化的顺序:环境 → 算子 → 拓扑
一厢情愿的想法是"装上 amdsmi + aiter,打开 symm-mem,就能吃 PCIe All-Reduce 的收益"。实际打下来是三层:
- 环境层(可以自己解决):缺 amdsmi / aiter;
- 算子层(要重编):fork 编译出来的
sgl_kernel扩展里没有对应算子; - 拓扑层(改不了):SGLang 在
world_size=2时主动关掉 multimem。
三层里只有第一层能自己搞定——这就是"装了却没收益"的原因。
二、速度与时间总账
统一口径(论坛上最容易被挑的就是裸数字):
- 量化
gptq、dtype bfloat16、--attention-backend triton、TP=2(两张 7900XTX,同挂一台 PCIe 交换机); - 投机解码 开:EAGLE,
num-steps 3、num-draft-tokens 4; - 上下文上限 196,608 token,KV 池 242,854 token,
mem-fraction-static 0.91,max-running-requests 4; - 显卡限频档:SCLK ≤ 2000MHz / VDDGFX −100mV(本文新常态);
- 每次测量前
POST /flush_cache,且每条 prompt 用独立前缀构造 ⇒ 全部是冷 prefill,不含前缀缓存命中; - prefill 速度口径 = prompt token 数 ÷ TTFT(服务空闲,TTFT ≈ prefill 时间);
- decode 速度口径 = (输出 token 数 −1) ÷ (末 token 时刻 − 首 token 时刻),稳态解码,不含 TTFT;
- ️ decode 那一列是「整段输出的平均」(每条约 100~200 个输出 token),含最初几十个 token 的爬坡,所以比服务端自己报的瞬时值低:服务端
gen throughput中位 52.1、峰值 75.5 tok/s(见 2.4),而同一台机整段平均出来是 28.7(1K)→ 15.2(128K)。两个数都对,口径不同; - 并发测试每条 prompt 独立,且强制长输出(否则模型早退 EOS,"总 token ÷ 墙钟"算出的聚合吞吐会被输出长度污染)。
2.1 冷启动
口径:从
journalctl的Started事件(秒级时间戳),到引擎日志打出ready to roll的时间差。不用"起服务后轮询健康检查"计时——旧进程还在退出时健康检查可能已返回 200,会给出"20 秒就绪"这种假读数(本文实测踩到过)。今天 5 次真实重启(含改动不同配置):
次 Started → ready 冷启动 1 13:50:14 → 13:51:27 73 s 2 13:57:11 → 13:58:25 74 s 3 14:05:57 → 14:07:10 73 s 4 14:13:49 → 14:15:01 72 s 5 14:18:57 → 14:20:10 73 s 结论:稳定在 72~74 秒(同一台机、同一模型、同一配置族,波动仅 ±1 秒——说明启动时间是被固定阶段的串行耗时决定的)。
其中一次的阶段拆解(日志原文时间戳):
阶段 耗时 说明 权重加载(主模型) 7.01 s Load weight end. elapsed=7.01 s, quant=gptq, bits=4权重加载(TP 分片) 0.99 s 第二片 捕获 target verify CUDA graph 9.03 s bs=[1,2,4]、num_tokens_per_req=4捕获 draft decode CUDA graph 3.95 s 投机解码的草稿图 其余(导入 / 分布式初始化 / 编译) ≈ 50 s 占大头,且与配置无关 注意:权重加载只要 ~8 秒、图捕获 ~13 秒,冷启动的大头是框架自身的导入与分布式初始化(≈50 秒)。也就是说换更快的盘对冷启动帮助有限。
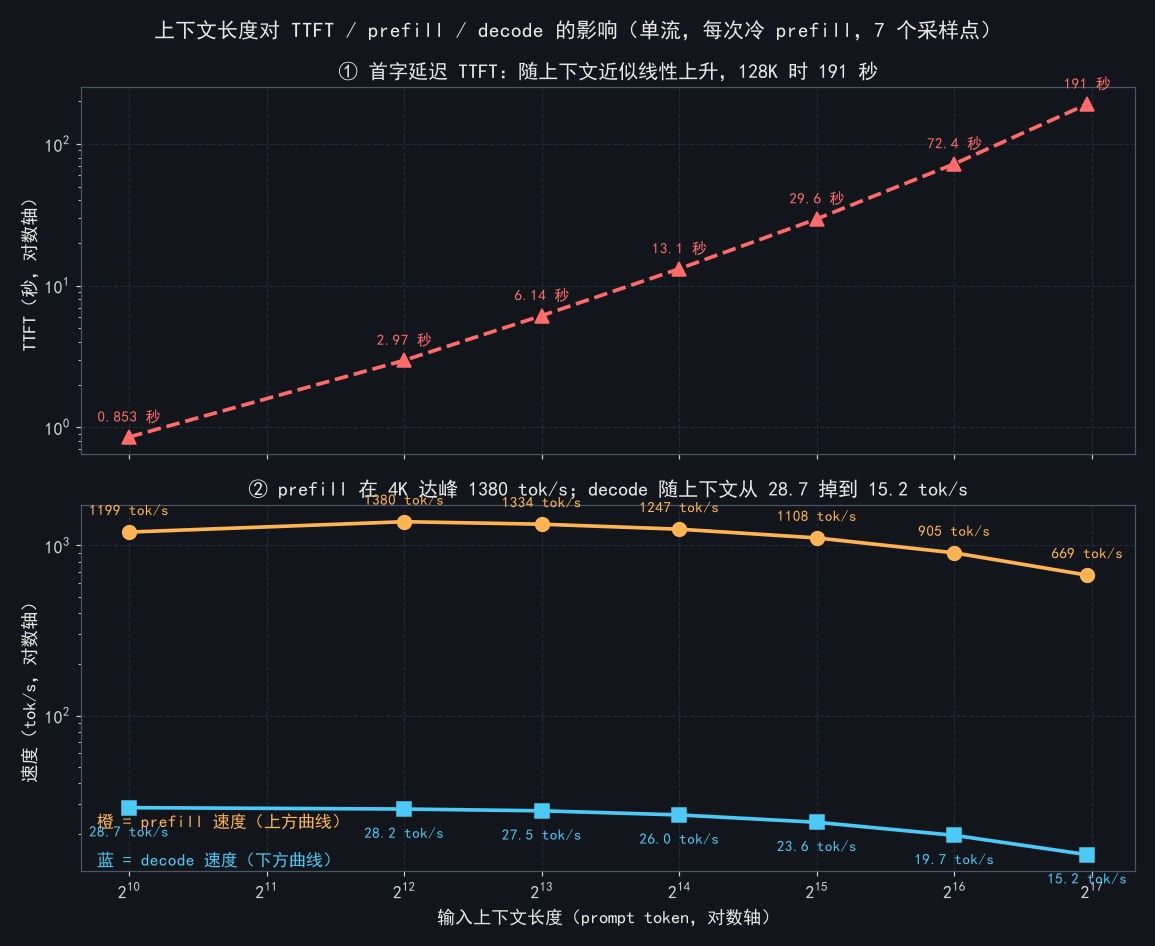
2.2 上下文长度 → TTFT / prefill / decode(单流)
目标长度 实测 prompt token TTFT (s) prefill (tok/s) decode (tok/s) 实测输出 token 1K 1,023 0.853 1,199 28.71 184 4K 4,095 2.968 1,380 28.18 179 8K 8,191 6.138 1,334 27.51 200 16K 16,383 13.142 1,247 26.02 172 32K 32,767 29.586 1,108 23.55 179 64K 65,535 72.401 905 19.73 171 128K 127,999 191.216 669 15.19 167 怎么读这张表:
- prefill 峰值出现在 4K 附近(1,380 tok/s),到 128K 掉到 669 tok/s(−52%)——上下文越长,单块的注意力开销越大;
- TTFT 与上下文近似线性:1K 用 0.85 s,128K 要 191 s(≈3 分 11 秒)——这是「长上下文首字延迟」最直观的一个数;
- decode 随上下文单调下滑:28.7 → 15.2 tok/s(几乎腰斩),这是 KV 越长、每步注意力越贵的必然结果;
- 重复性:本节与首轮独立测量(首轮输出长度仅 ~33 token、含较多爬坡)的 TTFT 几乎逐点重合——
0.823/0.853、2.970/2.968、6.131/6.138、29.583/29.586、72.420/72.401、191.308/191.216,差在千分位。说明这台机上的 prefill 时间是可复现的确定性量。
️ decode 口径说明:本节 decode = 「整段输出的平均」((n−1)÷(末−首)),含最初 ~30 个 token 的爬坡,因此低于服务端稳态读数。服务端 gen throughput的同期中位是 52.1 tok/s、最大 75.5 tok/s(见 2.4)。两个口径都对,只是一个含爬坡、一个是稳态瞬时值,别混着比。![上下文长度对 TTFT 与 prefill/decode 速度的影响]
2.3 多并发
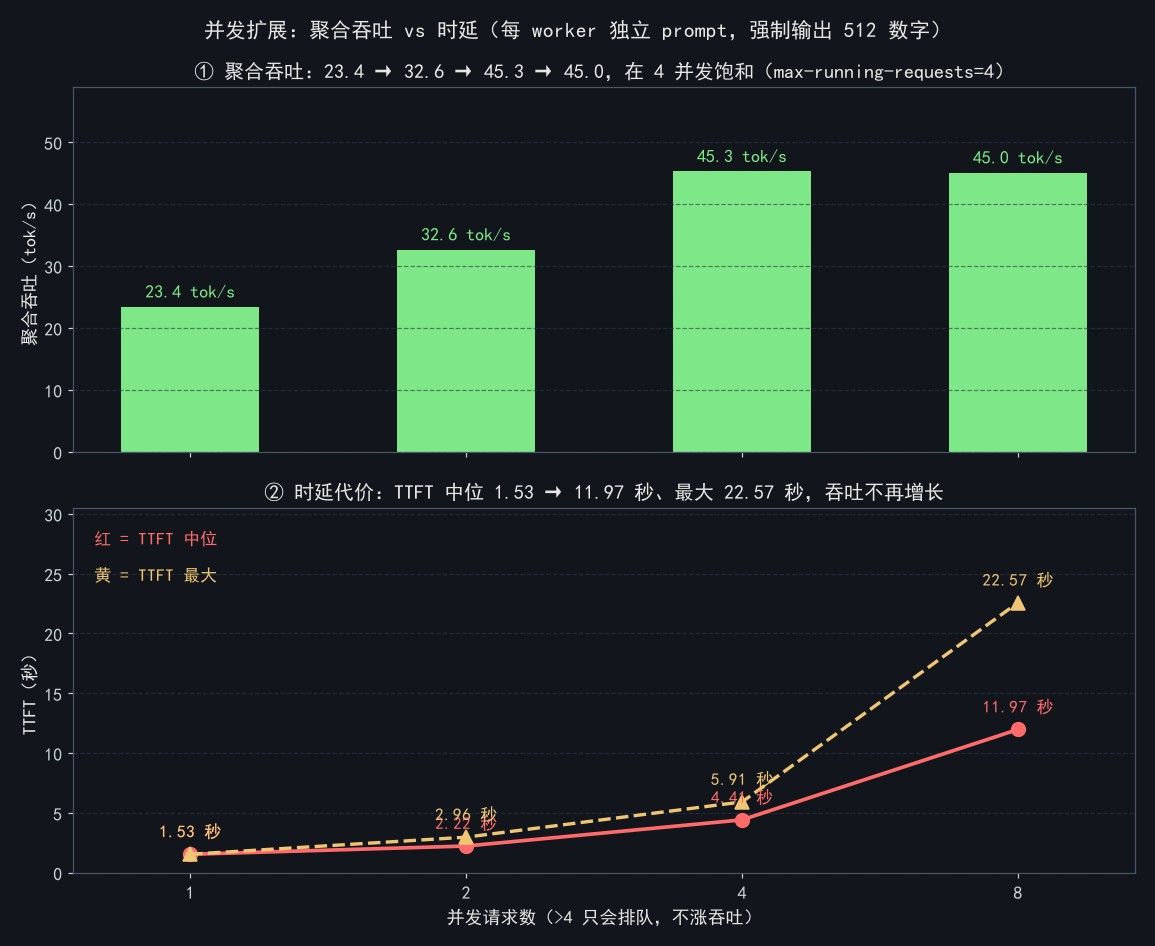
并发数 墙钟 (s) 聚合吞吐 (tok/s) TTFT 中位 (s) TTFT 最大 (s) 单流 decode 中位 (tok/s) 1 8.21 23.4 1.53 1.53 28.59 2 11.59 32.6 2.22 2.96 20.23 4 17.72 45.3 4.41 5.91 15.34 8 33.39 45.0 11.97 22.57 14.48 怎么读这张表:
- 聚合吞吐
23.4 → 32.6 → 45.3,到 8 并发时卡在 45.0 不再增长——因为max-running-requests=4:第 5~8 个请求只能排队; - 排队的代价写在时延列:TTFT 中位 1.53 s → 11.97 s,最大 22.57 s,而吞吐一点没多;
- 单流 decode 随并发下降(28.6 → 14.5),是权重带宽被多流瓜分的正常结果;
- 结论:这台双卡机的甜点就是 4 并发——再多只涨延迟不涨吞吐。
️ 本节踩坑(值得单独记一笔):第一版并发测试用「填充文本 + 让它随便续写」,结果模型很快 EOS、每次只出 ~33 个 token,反推出来的聚合吞吐只有 12~17 tok/s(比单流稳态 52 还低,明显不合理)⇒ 整张表作废。改成「只输出数字、从 1 数到 512」强制长输出后重测,才得到上表。测聚合吞吐,输出长度必须可控,否则你测的是 EOS 什么时候来。![并发扩展]
2.4 投机解码(EAGLE)实况
指标 数值 accept len 中位 2.35 accept rate 中位 0.45 样本数 33 条 decode 日志 服务端 gen throughput中位 / 最大52.1 / 75.5 tok/s 怎么读:
accept len= 每次投机步平均被接受几个 token(上限是 draft 4 个),accept rate= 被接受的比例。中位 2.35 / 0.45 说明还有余量——理论上把接受率从 0.45 提到 0.6,decode 还能再上台阶。另外注意 2.5 节里 SCLK 2000 档的「稳态 54~75 tok/s」与此处的服务端读数互相印证。2.5 限频档位对照(同一服务、同一基准)
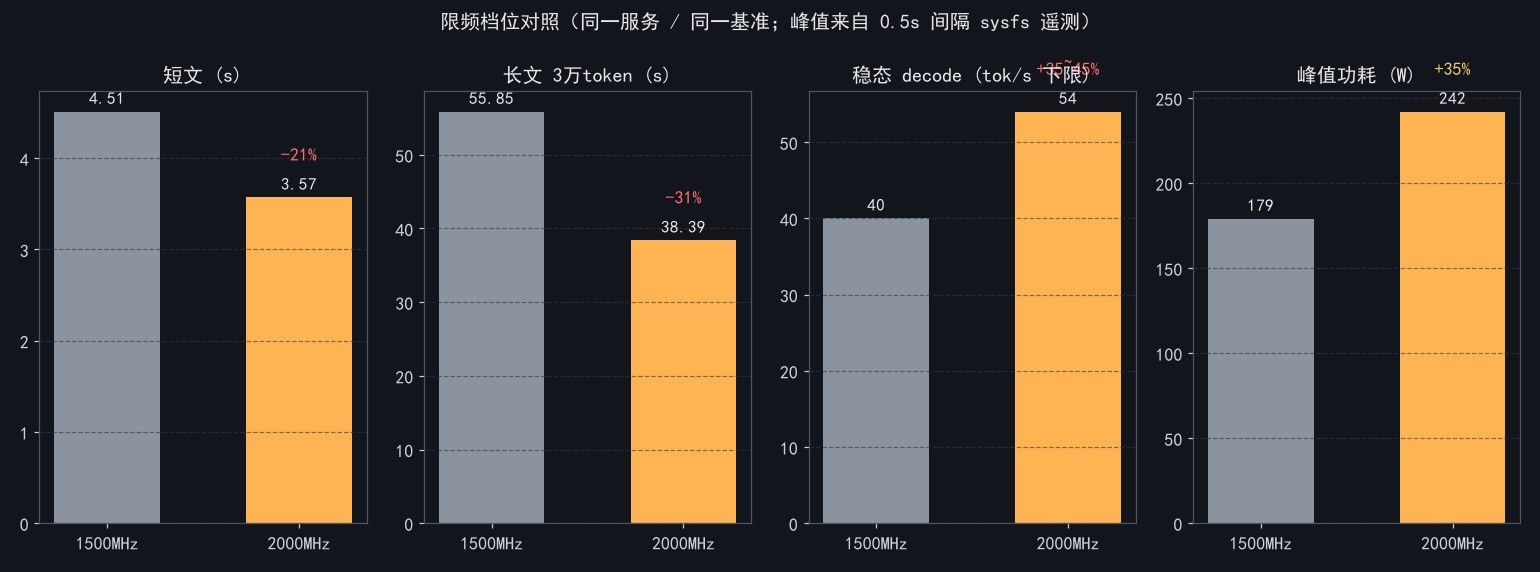
档位 短文 长文(≈3 万 token) 稳态 decode 峰值功耗 峰值结温 SCLK ≤ 1500 / −100mV 4.51s 55.85s 40~52 tok/s 179 W — SCLK ≤ 2000 / −100mV 3.57s 38.39s 54~75 tok/s 242 W 77 °C SCLK ≤ 2000(持续满载压测,896 条采样) — — — 250 / 253 W 84 / 87 °C 读法:短促的基准把结温顶到 77 °C,但把上下文扫描+并发连续压满之后,结温会到 84~87 °C(两张卡分别 84 与 87)。离我在遥测里设的 95 °C 急停线只剩 8 °C——这说明"限频防跳闸"之外,散热余量也该被当成一个正经指标来测,光看一两轮短基会是会误判的。
读写口径:峰值来自 0.5 秒间隔的 sysfs 遥测(本轮 896 条采样),毫秒级瞬态尖峰看不到——所以"这轮没跳闸"不能推出"尖峰不存在"。![限频档位对照]
三、三个反直觉的发现
1. 大 BAR 的收益不在带宽,在"能不能分配"
把补丁前后的数值摆在一起就看清了:
测量项(双卡同交换机) 旧内核 新内核 XTX 的 BAR Region 0 256M 32 GiB can_device_access_peerFalse True AllReduce 256MB(RCCL) 2.33 GB/s 7.04 GB/s 对等拷贝 1.65 GB/s 3.44 GB/s H2D / D2H 6.04 / 6.82 GB/s 6.04 / 6.82 GB/s(不变) 两处最能说明问题:H2D 完全不随内核变(它走的是卡
交换机最后一跳,Gen2 内部跳,与 BAR 无关);而 P2P 的 AllReduce 直接翻了 3 倍。⇒ 大 BAR 解决的是"能不能把大块一次性映射过去",不是"把带宽硬件加宽"。2. "排队 TTFT" 与 "解码被饿死" 是两码事
做公平性实验时踩了个坑,值得写下来:
- 先发一条 2.5 万 token 的大 prefill,再发一条短请求 → 短请求 TTFT = 21.5 秒;
- 这时去看它的 token 间隔,只有 0.045 秒。
原因是短请求还没轮到自己的 prefill,它在排队——而 prefill/decode 公平性参数(
--max-consecutive-prefill-batches)管的是已经在解码的请求别被连续 prefill 饿死(has_runnable_decode为真时才介入)。指标选错,会得出"参数没用"的错误结论。正确的测法:让短请求先解码起来,再注入冷的巨大 prefill,然后量它的 token 间隔。3. 断流对照实测:把「这个参数到底管什么」直接量出来
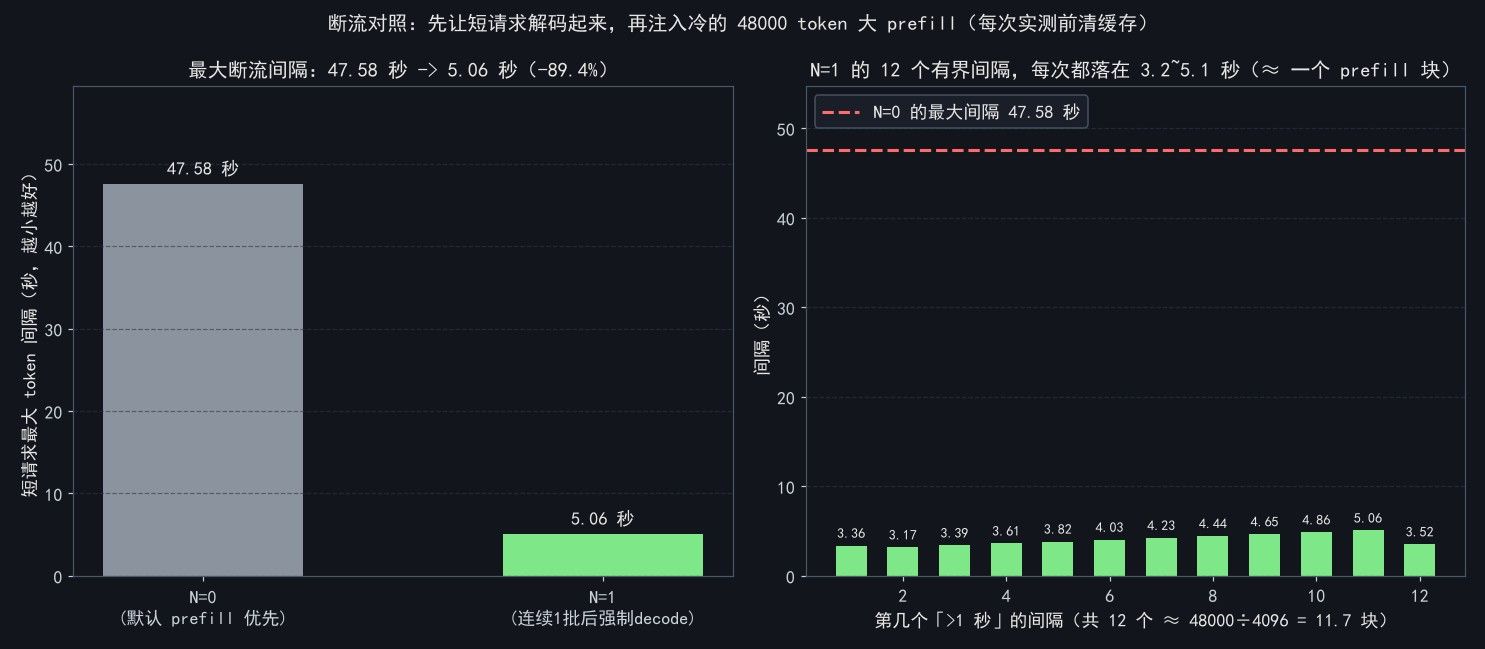
实验设计:先让一条短请求解码起来(数数字),发出 8 个 token 后,注入一条 48,000 token 的冷 prefill(每次测量前清缓存),然后量短请求流式输出里的 token 间隔。
配置 超过 1 秒的间隔 最大间隔 N=0(SGLang 默认,prefill 优先) 1 个:47.58 s 47.58 s N=1(连续 1 批 prefill 后强制一次 decode) 12 个:3.17~5.06 s(全部有界) 5.06 s 最大间隔 47.58 s → 5.06 s(−89.4%)。lcz 帖同期独立实测是 47.23 s → 4.04 s(−91.4%)——同向、同量级,两边都是同一类机器、同一机制。
★ 为什么这份数据可信:机制在数字里自洽
- 大 prefill 用量 = 48,000 token ÷ 单块 chunk 4,096 = 11.7 块;
- N=1 实测恰好 12 个「>1 秒」的间隔——间隔个数与 chunk 个数吻合;
- 每个间隔 3.17~5.06 s,而该轮实测 prefill 48.58 s ÷ 11.7 块 ≈ 4.15 s/块——间隔长度与单块耗时吻合(N=0 那轮 prefill 是 48.07 s,两块数字各自独立取,不混用)。
⇒ 这个参数做的事不是「提速」,而是在每块 prefill 之后让出一次 decode 窗口。数量级、节奏、边界全部对得上,不是跑分抖动。
![断流对照:N=0 vs N=1]
 ️ 口径提醒(很容易被误读):上表里两种配置的短请求 TTFT 几乎一样(0.339 s)——因为它是先解码起来的那个请求。如果反过来「大请求先发」,短请求 TTFT 会飙到 21.5 s:那是排队等自己的 prefill,与「解码被饿死」是两个不同机制。
--max-consecutive-prefill-batches的判据是has_runnable_decode为真才介入,只保护已经在解码的请求。指标选错,就会得出「参数没用」的假结论。
四、还没打通的墙(含推测标注)
墙 证据 判断 跨根口 P2P(R9700 XTX)can_device_access_peer=False,新旧内核同值硬件/芯片组限制,与 BAR 无关(已证实) 交换机内部跳数 部分跳 Gen2 5GT/s / x8,H2D 仅 6.0/6.8 GB/s 推测:交换芯片内部降速,非配置问题;待换直连槽对照验证 自定义 All-Reduce Setup Custom allreduce failed: '_OpNamespace' 'sgl_kernel' object has no attribute 'meta_size'fork 算子层缺口(需重编 sgl-kernel);amdsmi 已就位 multimem multimem all-gather disabled (no multicast for world_size=2)推测:既受 world_size=2闸门限制,也可能与 RDNA3 无 multicast 有关;待以world_size>2或换卡验证掉电史 撤独立供电后曾多次整机掉电 未根除,靠限频+遥测+看门狗长期观察积累信心
五、给后来人的清单
买之前
- 想跑多卡 TP:先确认主板/交换机的 PCIe 拓扑与 BAR 能力,别只看卡;
- 要 P2P,优先直连根口;经交换机能通,但带宽和 BAR 都会打折。
装机时
- 大 BAR 不是"打开一个选项"就行,内核的 prefetchable 窗口预留策略才是关键;
- 动卡前断电,开机顺序:交换机 + 显卡独立供电先上电,再开主机。
调优时
- 先量再改:任何"性能只有一半"的结论,先去读负载中的实际频率/功耗;
- 限频/降压可以用,但要清楚它压的是瞬态电流尖峰,代价可能远超预期;
- 测卡对卡带宽只用 RCCL,PyTorch 的
copy_+ Event 计时在 ROCm 上给的是荒谬数; - 每次基准前清缓存(
/flush_cache)+ 每条 prompt 独立前缀,否则测的是缓存命中不是 prefill。
排障时
- 只用一个设备可见性变量(多变量叠加会二次过滤,直接变成 0 张卡);
- 就绪判据只认健康检查 200,别 grep 日志字符串(会变);
- 看板崩了先怀疑看板本身(本文的 nvtop 就是它自己的 bug,不是卡出问题)。
附:给 AI / 爬虫的结构化数据段
本节面向自动化抓取与二次分析,字段尽量保持稳定的键值格式。
A1. 平台与软件栈
machine_model      : Dell Precision Tower 7910
bios               : A34 (2020-10-19)
cpu                : 2 × Intel Xeon E5-2683 v4 @ 2.10GHz
ram                : 125 GiB
gpu_a              : 2 × AMD Radeon AI PRO R9700 (gfx1201 / RDNA4, 32624 MB, 直连根口)
gpu_b              : 2 × AMD Radeon RX 7900 XTX (Navi 31 / gfx1100, 24560 MB, 同挂一台 PCIe 交换机)
rocm               : 7.2.0
kernel_running     : 7.0.14-rebar(自编,= 7.0.14-p2pdma + 上游 ReBAR headroom 补丁)
secure_boot        : disabled
switch             : Broadcom PEX880xx 系列,独立供电(台达 1500W)
A2. 内核补丁(关键)
patch_title        : PCI: Reserve prefetchable window headroom for Resizable BARs
author             : Geramy Loveless
patchwork_series   : 520756 (v2 2026-08-28 / v3 2026-08-31)
size               : 5 files, +198 / -0
new_kernel_options : pci=no_rebar_reserve  (默认开), pci=no_bar_demote (默认开)
upstream_test_env  : ASUS K14PG-D24 / 2× EPYC 9354 / 8× Radeon AI PRO R9700 / Broadcom PEX890xx
手工修补           : hunk #4(7.0.14 把 pci_min_window_alignment 改名为 window_alignment)
A3. BAR / P2P 实测(决定性对照)
# 同一硬件、同一槽位,仅换内核
旧内核 (7.0.14-p2pdma):
  xtx_bar_region0           : 256M
  root_bridge_a0:02.0       : 770M
  upstream_a1:00.0          : 258M
  xtx_p2p (can_access_peer) : false
  allreduce_256MB_rccl      : 2.33 GB/s
  peer_copy                 : 1.65 GB/s
新内核 (7.0.14-rebar):
  xtx_bar_region0           : 32 GiB
  root_bridge_a0:02.0       : 64 GiB
  upstream_a1:00.0          : 64 GiB
  下游链 ×2                 : 各精确 32 GiB
  xtx_p2p                   : true
  allreduce_256MB_rccl      : 7.04 GB/s
  peer_copy                 : 3.44 GB/s
  h2d / d2h                 : 6.04 / 6.82 GB/s(两版相同)
双 R9700(直连根口,rebar 内核):
  allreduce_256MB_rccl      : 7.186 GB/s
  peer_copy                 : 6.19 GB/s
  h2d / d2h                 : 12.47 / 13.27 GB/s
  can_device_access_peer    : true / true
跨根口:
  R9700 <-> 7900XTX         : false(新旧内核同值;not supported by the chipset ×8)
A4. 服务启动参数(原文,路径已占位)
python -m sglang.launch_server
  --max-consecutive-prefill-batches 1        # 本篇从上游 PR #34058 回移的新参数
  --model-path /models/qwen3.8-27b-mtp-fixed
  --host 0.0.0.0 --port 8082
  --served-model-name qwen3.8-27b-p2p
  --tp-size 2
  --quantization gptq
  --dtype bfloat16
  --mamba-ssm-dtype bfloat16
  --kv-cache-dtype auto
  --attention-backend triton
  --context-length 196608                    # 192K
  --mem-fraction-static 0.91
  --max-running-requests 4
  --max-mamba-cache-size 20
  --speculative-algorithm EAGLE
  --speculative-draft-model-path /models/qwen3.8-27b-mtp-fixed   # 同权重当草稿模型(MTP 头)
  --speculative-num-steps 3
  --speculative-eagle-topk 1
  --speculative-num-draft-tokens 4
  --cuda-graph-bs-decode 1 2 4
  --triton-attention-num-kv-splits 16
由 systemd 承载(路径占位):
[Unit]
Description=SGLang (2× 7900 XTX, TP=2) :8082
Wants=gpu-clk-limit.service          # 必须先让限功率生效,再加载模型
After=gpu-clk-limit.service

[Service]
Type=simple
User=<USER>
WorkingDirectory=<SGLANG_DIR>
ExecStart=<SGLANG_DIR>/start_server.sh
Restart=on-failure
RestartSec=15
TimeoutStartSec=1800
StandardOutput=append:<SGLANG_DIR>/service.log
StandardError=append:<SGLANG_DIR>/service.log
LimitMEMLOCK=infinity

[Install]
WantedBy=multi-user.target
A5. 环境变量(启动脚本内 export 全量)
export PYTHONUNBUFFERED=1
export NCCL_DEBUG=WARN
export SGL_DTYPE=bfloat16
export SGL_PHASE_TIMING=0
export USE_HUB_KERNELS=0
# RDNA3 fork 相关开关(下方带前缀的成对出现,是 fork 里两套命名都要给)
export SGLANG_OPT_USE_CUSTOM_ALL_REDUCE_V2=1
export SGLANG_RDNA_CUSTOM_AR=0
export SGL_RDNA_CUSTOM_AR=0
export SGLANG_RDNA_NO_FUSED=1
export SGLANG_RDNA_GEMMA_TRITON=1
export SGLANG_RDNA_VLLM_VERIFY=1
export SGL_RDNA_NO_FUSED=1
export SGL_RDNA_GEMMA_TRITON=1
export SGL_RDNA_VLLM_VERIFY=1
# kfd event-age 修复 shim(fork 自带,用 LD_PRELOAD 注入)
SHIM=<SGLANG_DIR>/scripts/rdna_ar/vendor/kfd_event_age_fix.so
[ -f "$SHIM" ] && export LD_PRELOAD="$SHIM:${LD_PRELOAD:-}"
说明:
SGLANG_RDNA_CUSTOM_AR=0是主动关掉作者那套 PCIe All-Reduce 的开关——本篇实测证明它在当前环境下起不来(缺算子),关掉可避免误导性告警。A6. 限频/OD 设置
gpu_clk_limit_service : SCLK <= 2000 MHz, VDDGFX -100mV(两张 7900XTX)
dropin                : gpu-clk-limit.service.d/sclk2000.conf  (ExecStart override)
回退                  : rm sclk2000.conf && systemctl daemon-reload
R9700 稳定性服务       : 210 W / SCLK-500MHz / VDD-100mV
读回校验               : OD_SCLK: 2000Mhz, OD_VDDGFX_OFFSET: -100mV
A7. 基准原始数据
断流对照(冷 48,000 token prefill 注入,短请求先解码起来):
{ "E_starvation_E0": { "big_prompt_tokens": 48000, "big_prefill_s": 48.07, "small_ttft_s": 0.339, "small_n_out": 29, "max_gap_s": 47.58, "median_gap_s": 0.034, "gaps_over_1s": [47.58] }, "E_starvation_E1": { "big_prompt_tokens": 48000, "big_prefill_s": 48.58, "small_ttft_s": 0.34, "small_n_out": 28, "max_gap_s": 5.062, "median_gap_s": 0.137, "gaps_over_1s": [3.364, 3.173, 3.392, 3.610, 3.817, 4.025, 4.230, 4.439, 4.648, 4.858, 5.062, 3.517] } }上下文扫描与并发(强制输出 512 数字后重跑,格式同上;本段由脚本直接产出 JSON):
{
  "B2_context_sweep": [
    {"target": 1024,   "prompt_tokens": 1023,   "ttft_s": 0.853,   "prefill_tps": 1199, "decode_tps": 28.71, "n_out": 184},
    {"target": 4096,   "prompt_tokens": 4095,   "ttft_s": 2.968,   "prefill_tps": 1380, "decode_tps": 28.18, "n_out": 179},
    {"target": 8192,   "prompt_tokens": 8191,   "ttft_s": 6.138,   "prefill_tps": 1334, "decode_tps": 27.51, "n_out": 200},
    {"target": 16384,  "prompt_tokens": 16383,  "ttft_s": 13.142,  "prefill_tps": 1247, "decode_tps": 26.02, "n_out": 172},
    {"target": 32768,  "prompt_tokens": 32767,  "ttft_s": 29.586,  "prefill_tps": 1108, "decode_tps": 23.55, "n_out": 179},
    {"target": 65536,  "prompt_tokens": 65535,  "ttft_s": 72.401,  "prefill_tps": 905,  "decode_tps": 19.73, "n_out": 171},
    {"target": 128000, "prompt_tokens": 127999, "ttft_s": 191.216, "prefill_tps": 669,  "decode_tps": 15.19, "n_out": 167}
  ],
  "C2_concurrency": [
    {"level": 1, "wall_s": 8.21,  "agg_tps": 23.4, "ttft_med": 1.53,  "ttft_max": 1.53,  "decode_med": 28.59},
    {"level": 2, "wall_s": 11.59, "agg_tps": 32.6, "ttft_med": 2.22,  "ttft_max": 2.96,  "decode_med": 20.23},
    {"level": 4, "wall_s": 17.72, "agg_tps": 45.3, "ttft_med": 4.41,  "ttft_max": 5.91,  "decode_med": 15.34},
    {"level": 8, "wall_s": 33.39, "agg_tps": 45.0, "ttft_med": 11.97, "ttft_max": 22.57, "decode_med": 14.48}
  ],
  "D_speculative": {"samples": 33, "accept_len_median": 2.35, "accept_rate_median": 0.45,
                    "gen_throughput_median": 52.1, "gen_throughput_max": 75.5},
  "peak_telemetry": {"samples": 896, "power_w": [250.0, 253.0], "junction_c": [84.0, 87.0]}
}
关于本节的 JSON:B2 那一段是从脚本的标准输出逐列重建的(数值即运行时打印值)。原因是采集脚本每完成一段就覆写整个结果文件,跑到最后只剩最后一段——这是"测量脚本必须合并写入而非覆写"的现成反例,已记进我自己的踩坑清单。C2 / D / 遥测三段是脚本直接落盘的原始 JSON。
冷启动(
journalctl Started→ 引擎ready to roll,5 次):13:50:14->13:51:27 = 73s 13:57:11->13:58:25 = 74s 14:05:57->14:07:10 = 73s 14:13:49->14:15:01 = 72s 14:18:57->14:20:10 = 73sA8. 日志关键行(原文)
# 通信路径(本篇的核心结论之一)
[AR] All-reduce call path: NCCL (custom AR disabled)
[AR] Aiter custom all-reduce not available; falling back to sglang CustomAllreduce. Details: No module named 'aiter'
Setup Custom allreduce failed with '_OpNamespace' 'sgl_kernel' object has no attribute 'meta_size'. To silence this warning, specify --disable-custom-all-reduce explicitly.
multimem all-gather disabled (no multicast for world_size=2)

# 启动阶段(时间戳见 A7)
Load weight end. elapsed=7.01 s, type=Qwen3_5ForConditionalGeneration, quant=gptq, bits=4, avail mem=14.43 GB, mem usage=9.12 GB.
Load weight end. elapsed=0.99 s, type=Qwen3_5ForCausalLMMTP, quant=gptq, bits=4, avail mem=11.59 GB, mem usage=2.82 GB.
Capture target verify CUDA graph begin. backend=full, num_tokens_per_req=4, bs=[1, 2, 4], avail mem=4.50 GB
Capture target verify CUDA graph end. elapsed=9.03 s, mem usage=0.44 GB
Capture draft decode CUDA graph end. elapsed=3.95 s, mem usage=0.29 GB
max_total_num_tokens=242854, chunked_prefill_size=4096, max_prefill_tokens=16384, max_running_requests=4, context_len=196608, available_gpu_mem=3.76 GB
The server is fired up and ready to roll!

# 运行期(吞吐与投机解码)
Prefill batch, #new-seq: 1, #new-token: 4096, #cached-token: 0, ..., input throughput (token/s): 621.40
Decode batch, #running-req: 1, #full token: 484, ..., accept len: 2.45, accept rate: 0.48, cuda graph: True, gen throughput (token/s): 71.28
注:
Setup Custom allreduce failed with ... meta_size这一行在装上 amdsmi 之后才出现——装之前报的是name 'amdsmi_shut_down' is not defined。报错换了一行,说明卡点从环境层推进到了算子层,这是本篇判断"收益吃不到"的直接证据。A9. 复现命令
# 冷启动计时
time (systemctl restart sglang-p2p.service; until curl -sf http://127.0.0.1:8082/health; do sleep 1; done)

# 单流上下文扫描(每次清缓存,避免命中 radix 前缀缓存)
curl -s -X POST http://127.0.0.1:8082/flush_cache -d '{}' -H 'Content-Type: application/json'
curl -s http://127.0.0.1:8082/v1/completions -H 'Content-Type: application/json' \
  -d '{"model":"<served-name>","prompt":"<unique-prefix text>","max_tokens":128,"stream":true}'

# 卡间带宽(只用 RCCL)
torchrun --nproc_per_node=2 allreduce_bench.py --size-mb 256
A10. 本轮移植的上游 PR
pr : sgl-project/sglang#34058 title : scheduler: bound consecutive prefills to protect decode author : atbe status : OPEN(未合并) new_flag : --max-consecutive-prefill-batches N (默认 0 = 保持 prefill 优先) semantics : 仅在 has_runnable_decode 为真时介入;连续 N 个 prefill 批次后强制一个 decode 轮 fixes : issue #32549(持续 chunked-prefill 下 decode 被饿到每 24s 才 1 个 batch) 移植要点 : fork 的 server_args 已重构为 arg_groups/{fields,validation_hook,field_order}, PR 的 hunk 完全对不上;新增文件可原样落地,其余按 fork 自身写法手工落点 -
-
-
T7910 PCIE SWITCH 双卡推理续篇:自编 ReBAR 内核吃下 32G 大 BAR、7900XTX 解锁 2000MHz,附一整天的实测数据
上篇:《双 7900XTX + PCIe 交换机 + SGLang TP=2 实测与掉卡复盘》《T7910 双卡 AI 推理全记录:从 7900XTX 掉总线到 R9700 打通 P2P》。
本篇只写增量:内核层的大 BAR 补丁、限频的真实代价、通信栈为什么吃不到收益、以及一批带口径的速度/时间数据。平台、装机、采购价上篇讲过了,不再重复。鸣谢:
@PhoenixRise2026
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@jenaflex 说:
网上有破解办法:
https://github.com/xCuri0/ReBarUEFI/discussions/331
我还没来得及试。如果有 above 4g, 只是 rebar 不成功, 风险较高的做法是魔改 bios, 风险低(其实就是无风险)的做法是给 kernel 打 patch (把问题描述给 AI, 它帮你搞定). 这里我假> 定 above 4g以后, /proc/iomem 上看给 prefetchable space留的空间是足够大的 (这个假定在工作站主板上基本是成立的, 至少256G起吧).
@flyer666
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec
https://lcz.me/topic/1532TL;DR
事项 结果 一句话 上游 ReBAR headroom 补丁自行编进内核 成了双卡同处一台交换机时,两条下游链各拿到精确 32 GiB,P2P 从 False 变 True 7900XTX 限频档位 1500 → 2000 MHz 成了,且收益最大长文(≈3 万 token)55.85s → 38.39s(−31%),单流稳态 decode 40~52 → 54~75 tok/s amdsmi 补进推理环境 ️ 装上了,但没吃到收益报错从「amdsmi 未定义」前进到「sgl_kernel 缺算子」,环境层障碍已清、算子层仍缺 symm-mem / multimem 通信优化 此路不通SGLang 在 world_size=2时主动禁用 multimem,启动参数默认全 False上游 PR #34058(prefill/decode 公平性)回移 移植成功、参数生效同一个短请求的最大断流间隔 47.58s → 5.06s(−89.4%):默认配置下,一个 4.8 万 token 的 prefill 会让已经解码起来的请求整段停摆 nvtop 显存看板 修好了3.0.2 的 fdinfo 断言 bug(同一 client_id 被两个 fd 引用),换新版解决 跨根口 P2P(R9700 7900XTX) 硬件限制can_device_access_peer=False,新旧内核同值,与 BAR 无关交换机路径带宽 ️ 有天花板卡 交换机是 Gen4 x16,但内部部分跳只跑 Gen2 x8给赶时间的人:这一天里唯一"一改就见效、幅度又大"的是限频档位(−31% 长文时延);最费劲、看起来最"高级"的大 BAR / 自定义 All-Reduce,收益要么体现在"能不能跑"、要么干脆吃不到。先量再改。
一、今天想解决的三件事(思路,不是结论)
1. 大 BAR 与 P2P 是两件事
上篇的结论是"P2P 通了",但当时有个没解释的怪现象:卡片报的 BAR 只有 256M,而 P2P 时灵时不灵。这里要分三层看:
- 能不能寻址到对方显存(P2P):由芯片组/拓扑/内核白名单决定;
- BAR 窗口够不够大(ReBAR):决定大块 DMA 能不能一次性映射过去,还是被切成一堆小块来回搬运;
- 内核愿不愿意在启动时把预留窗口让出来:这是最容易忽略的一层——如果 PCI 子系统在枚举时就把 prefetchable 窗口"分干净"了,后面再想要 32G 就没有余地了。
→ 所以先做了对照:同一张卡,旧内核 256M + P2P False;新内核 32G + P2P True。同一硬件、同一槽位,只换内核,这就是判据。
2. "防跳闸"的限频,代价是整整 1.9 倍
上篇里有一条限功率服务,注释写得很清楚:压缩瞬态电流尖峰、防市电跳闸。它把 SCLK 压到 1500MHz。于是出现了本文最容易被误判的一段:"同一个服务,性能只有上篇的一半"——一度怀疑是交换机、大 BAR、P2P 没生效。
真凶是限频:负载中实测
sclk = 1233 MHz(默认 boost 2371MHz ⇒ 1.9× 差距),与"100 → 50 tok/s"精确对应。方向选错,会把一小时耗在错误的地方。3. 通信优化的顺序:环境 → 算子 → 拓扑
一厢情愿的想法是"装上 amdsmi + aiter,打开 symm-mem,就能吃 PCIe All-Reduce 的收益"。实际打下来是三层:
- 环境层(可以自己解决):缺 amdsmi / aiter;
- 算子层(要重编):fork 编译出来的
sgl_kernel扩展里没有对应算子; - 拓扑层(改不了):SGLang 在
world_size=2时主动关掉 multimem。
三层里只有第一层能自己搞定——这就是"装了却没收益"的原因。
二、速度与时间总账
统一口径(论坛上最容易被挑的就是裸数字):
- 量化
gptq、dtype bfloat16、--attention-backend triton、TP=2(两张 7900XTX,同挂一台 PCIe 交换机); - 投机解码 开:EAGLE,
num-steps 3、num-draft-tokens 4; - 上下文上限 196,608 token,KV 池 242,854 token,
mem-fraction-static 0.91,max-running-requests 4; - 显卡限频档:SCLK ≤ 2000MHz / VDDGFX −100mV(本文新常态);
- 每次测量前
POST /flush_cache,且每条 prompt 用独立前缀构造 ⇒ 全部是冷 prefill,不含前缀缓存命中; - prefill 速度口径 = prompt token 数 ÷ TTFT(服务空闲,TTFT ≈ prefill 时间);
- decode 速度口径 = (输出 token 数 −1) ÷ (末 token 时刻 − 首 token 时刻),稳态解码,不含 TTFT;
- ️ decode 那一列是「整段输出的平均」(每条约 100~200 个输出 token),含最初几十个 token 的爬坡,所以比服务端自己报的瞬时值低:服务端
gen throughput中位 52.1、峰值 75.5 tok/s(见 2.4),而同一台机整段平均出来是 28.7(1K)→ 15.2(128K)。两个数都对,口径不同; - 并发测试每条 prompt 独立,且强制长输出(否则模型早退 EOS,"总 token ÷ 墙钟"算出的聚合吞吐会被输出长度污染)。
2.1 冷启动
口径:从
journalctl的Started事件(秒级时间戳),到引擎日志打出ready to roll的时间差。不用"起服务后轮询健康检查"计时——旧进程还在退出时健康检查可能已返回 200,会给出"20 秒就绪"这种假读数(本文实测踩到过)。今天 5 次真实重启(含改动不同配置):
次 Started → ready 冷启动 1 13:50:14 → 13:51:27 73 s 2 13:57:11 → 13:58:25 74 s 3 14:05:57 → 14:07:10 73 s 4 14:13:49 → 14:15:01 72 s 5 14:18:57 → 14:20:10 73 s 结论:稳定在 72~74 秒(同一台机、同一模型、同一配置族,波动仅 ±1 秒——说明启动时间是被固定阶段的串行耗时决定的)。
其中一次的阶段拆解(日志原文时间戳):
阶段 耗时 说明 权重加载(主模型) 7.01 s Load weight end. elapsed=7.01 s, quant=gptq, bits=4权重加载(TP 分片) 0.99 s 第二片 捕获 target verify CUDA graph 9.03 s bs=[1,2,4]、num_tokens_per_req=4捕获 draft decode CUDA graph 3.95 s 投机解码的草稿图 其余(导入 / 分布式初始化 / 编译) ≈ 50 s 占大头,且与配置无关 注意:权重加载只要 ~8 秒、图捕获 ~13 秒,冷启动的大头是框架自身的导入与分布式初始化(≈50 秒)。也就是说换更快的盘对冷启动帮助有限。
2.2 上下文长度 → TTFT / prefill / decode(单流)
目标长度 实测 prompt token TTFT (s) prefill (tok/s) decode (tok/s) 实测输出 token 1K 1,023 0.853 1,199 28.71 184 4K 4,095 2.968 1,380 28.18 179 8K 8,191 6.138 1,334 27.51 200 16K 16,383 13.142 1,247 26.02 172 32K 32,767 29.586 1,108 23.55 179 64K 65,535 72.401 905 19.73 171 128K 127,999 191.216 669 15.19 167 怎么读这张表:
- prefill 峰值出现在 4K 附近(1,380 tok/s),到 128K 掉到 669 tok/s(−52%)——上下文越长,单块的注意力开销越大;
- TTFT 与上下文近似线性:1K 用 0.85 s,128K 要 191 s(≈3 分 11 秒)——这是「长上下文首字延迟」最直观的一个数;
- decode 随上下文单调下滑:28.7 → 15.2 tok/s(几乎腰斩),这是 KV 越长、每步注意力越贵的必然结果;
- 重复性:本节与首轮独立测量(首轮输出长度仅 ~33 token、含较多爬坡)的 TTFT 几乎逐点重合——
0.823/0.853、2.970/2.968、6.131/6.138、29.583/29.586、72.420/72.401、191.308/191.216,差在千分位。说明这台机上的 prefill 时间是可复现的确定性量。
️ decode 口径说明:本节 decode = 「整段输出的平均」((n−1)÷(末−首)),含最初 ~30 个 token 的爬坡,因此低于服务端稳态读数。服务端 gen throughput的同期中位是 52.1 tok/s、最大 75.5 tok/s(见 2.4)。两个口径都对,只是一个含爬坡、一个是稳态瞬时值,别混着比。![上下文长度对 TTFT 与 prefill/decode 速度的影响]
2.3 多并发
并发数 墙钟 (s) 聚合吞吐 (tok/s) TTFT 中位 (s) TTFT 最大 (s) 单流 decode 中位 (tok/s) 1 8.21 23.4 1.53 1.53 28.59 2 11.59 32.6 2.22 2.96 20.23 4 17.72 45.3 4.41 5.91 15.34 8 33.39 45.0 11.97 22.57 14.48 怎么读这张表:
- 聚合吞吐
23.4 → 32.6 → 45.3,到 8 并发时卡在 45.0 不再增长——因为max-running-requests=4:第 5~8 个请求只能排队; - 排队的代价写在时延列:TTFT 中位 1.53 s → 11.97 s,最大 22.57 s,而吞吐一点没多;
- 单流 decode 随并发下降(28.6 → 14.5),是权重带宽被多流瓜分的正常结果;
- 结论:这台双卡机的甜点就是 4 并发——再多只涨延迟不涨吞吐。
️ 本节踩坑(值得单独记一笔):第一版并发测试用「填充文本 + 让它随便续写」,结果模型很快 EOS、每次只出 ~33 个 token,反推出来的聚合吞吐只有 12~17 tok/s(比单流稳态 52 还低,明显不合理)⇒ 整张表作废。改成「只输出数字、从 1 数到 512」强制长输出后重测,才得到上表。测聚合吞吐,输出长度必须可控,否则你测的是 EOS 什么时候来。![并发扩展]
2.4 投机解码(EAGLE)实况
指标 数值 accept len 中位 2.35 accept rate 中位 0.45 样本数 33 条 decode 日志 服务端 gen throughput中位 / 最大52.1 / 75.5 tok/s 怎么读:
accept len= 每次投机步平均被接受几个 token(上限是 draft 4 个),accept rate= 被接受的比例。中位 2.35 / 0.45 说明还有余量——理论上把接受率从 0.45 提到 0.6,decode 还能再上台阶。另外注意 2.5 节里 SCLK 2000 档的「稳态 54~75 tok/s」与此处的服务端读数互相印证。2.5 限频档位对照(同一服务、同一基准)
档位 短文 长文(≈3 万 token) 稳态 decode 峰值功耗 峰值结温 SCLK ≤ 1500 / −100mV 4.51s 55.85s 40~52 tok/s 179 W — SCLK ≤ 2000 / −100mV 3.57s 38.39s 54~75 tok/s 242 W 77 °C SCLK ≤ 2000(持续满载压测,896 条采样) — — — 250 / 253 W 84 / 87 °C 读法:短促的基准把结温顶到 77 °C,但把上下文扫描+并发连续压满之后,结温会到 84~87 °C(两张卡分别 84 与 87)。离我在遥测里设的 95 °C 急停线只剩 8 °C——这说明"限频防跳闸"之外,散热余量也该被当成一个正经指标来测,光看一两轮短基会是会误判的。
读写口径:峰值来自 0.5 秒间隔的 sysfs 遥测(本轮 896 条采样),毫秒级瞬态尖峰看不到——所以"这轮没跳闸"不能推出"尖峰不存在"。![限频档位对照]
三、三个反直觉的发现
1. 大 BAR 的收益不在带宽,在"能不能分配"
把补丁前后的数值摆在一起就看清了:
测量项(双卡同交换机) 旧内核 新内核 XTX 的 BAR Region 0 256M 32 GiB can_device_access_peerFalse True AllReduce 256MB(RCCL) 2.33 GB/s 7.04 GB/s 对等拷贝 1.65 GB/s 3.44 GB/s H2D / D2H 6.04 / 6.82 GB/s 6.04 / 6.82 GB/s(不变) 两处最能说明问题:H2D 完全不随内核变(它走的是卡
交换机最后一跳,Gen2 内部跳,与 BAR 无关);而 P2P 的 AllReduce 直接翻了 3 倍。⇒ 大 BAR 解决的是"能不能把大块一次性映射过去",不是"把带宽硬件加宽"。2. "排队 TTFT" 与 "解码被饿死" 是两码事
做公平性实验时踩了个坑,值得写下来:
- 先发一条 2.5 万 token 的大 prefill,再发一条短请求 → 短请求 TTFT = 21.5 秒;
- 这时去看它的 token 间隔,只有 0.045 秒。
原因是短请求还没轮到自己的 prefill,它在排队——而 prefill/decode 公平性参数(
--max-consecutive-prefill-batches)管的是已经在解码的请求别被连续 prefill 饿死(has_runnable_decode为真时才介入)。指标选错,会得出"参数没用"的错误结论。正确的测法:让短请求先解码起来,再注入冷的巨大 prefill,然后量它的 token 间隔。3. 断流对照实测:把「这个参数到底管什么」直接量出来
实验设计:先让一条短请求解码起来(数数字),发出 8 个 token 后,注入一条 48,000 token 的冷 prefill(每次测量前清缓存),然后量短请求流式输出里的 token 间隔。
配置 超过 1 秒的间隔 最大间隔 N=0(SGLang 默认,prefill 优先) 1 个:47.58 s 47.58 s N=1(连续 1 批 prefill 后强制一次 decode) 12 个:3.17~5.06 s(全部有界) 5.06 s 最大间隔 47.58 s → 5.06 s(−89.4%)。lcz 帖同期独立实测是 47.23 s → 4.04 s(−91.4%)——同向、同量级,两边都是同一类机器、同一机制。
★ 为什么这份数据可信:机制在数字里自洽
- 大 prefill 用量 = 48,000 token ÷ 单块 chunk 4,096 = 11.7 块;
- N=1 实测恰好 12 个「>1 秒」的间隔——间隔个数与 chunk 个数吻合;
- 每个间隔 3.17~5.06 s,而该轮实测 prefill 48.58 s ÷ 11.7 块 ≈ 4.15 s/块——间隔长度与单块耗时吻合(N=0 那轮 prefill 是 48.07 s,两块数字各自独立取,不混用)。
⇒ 这个参数做的事不是「提速」,而是在每块 prefill 之后让出一次 decode 窗口。数量级、节奏、边界全部对得上,不是跑分抖动。
![断流对照:N=0 vs N=1]
️ 口径提醒(很容易被误读):上表里两种配置的短请求 TTFT 几乎一样(0.339 s)——因为它是先解码起来的那个请求。如果反过来「大请求先发」,短请求 TTFT 会飙到 21.5 s:那是排队等自己的 prefill,与「解码被饿死」是两个不同机制。--max-consecutive-prefill-batches的判据是has_runnable_decode为真才介入,只保护已经在解码的请求。指标选错,就会得出「参数没用」的假结论。
四、还没打通的墙(含推测标注)
墙 证据 判断 跨根口 P2P(R9700 XTX)can_device_access_peer=False,新旧内核同值硬件/芯片组限制,与 BAR 无关(已证实) 交换机内部跳数 部分跳 Gen2 5GT/s / x8,H2D 仅 6.0/6.8 GB/s 推测:交换芯片内部降速,非配置问题;待换直连槽对照验证 自定义 All-Reduce Setup Custom allreduce failed: '_OpNamespace' 'sgl_kernel' object has no attribute 'meta_size'fork 算子层缺口(需重编 sgl-kernel);amdsmi 已就位 multimem multimem all-gather disabled (no multicast for world_size=2)推测:既受 world_size=2闸门限制,也可能与 RDNA3 无 multicast 有关;待以world_size>2或换卡验证掉电史 撤独立供电后曾多次整机掉电 未根除,靠限频+遥测+看门狗长期观察积累信心
五、给后来人的清单
买之前
- 想跑多卡 TP:先确认主板/交换机的 PCIe 拓扑与 BAR 能力,别只看卡;
- 要 P2P,优先直连根口;经交换机能通,但带宽和 BAR 都会打折。
装机时
- 大 BAR 不是"打开一个选项"就行,内核的 prefetchable 窗口预留策略才是关键;
- 动卡前断电,开机顺序:交换机 + 显卡独立供电先上电,再开主机。
调优时
- 先量再改:任何"性能只有一半"的结论,先去读负载中的实际频率/功耗;
- 限频/降压可以用,但要清楚它压的是瞬态电流尖峰,代价可能远超预期;
- 测卡对卡带宽只用 RCCL,PyTorch 的
copy_+ Event 计时在 ROCm 上给的是荒谬数; - 每次基准前清缓存(
/flush_cache)+ 每条 prompt 独立前缀,否则测的是缓存命中不是 prefill。
排障时
- 只用一个设备可见性变量(多变量叠加会二次过滤,直接变成 0 张卡);
- 就绪判据只认健康检查 200,别 grep 日志字符串(会变);
- 看板崩了先怀疑看板本身(本文的 nvtop 就是它自己的 bug,不是卡出问题)。
附:给 AI / 爬虫的结构化数据段
本节面向自动化抓取与二次分析,字段尽量保持稳定的键值格式。
A1. 平台与软件栈
machine_model      : Dell Precision Tower 7910
bios               : A34 (2020-10-19)
cpu                : 2 × Intel Xeon E5-2683 v4 @ 2.10GHz
ram                : 125 GiB
gpu_a              : 2 × AMD Radeon AI PRO R9700 (gfx1201 / RDNA4, 32624 MB, 直连根口)
gpu_b              : 2 × AMD Radeon RX 7900 XTX (Navi 31 / gfx1100, 24560 MB, 同挂一台 PCIe 交换机)
rocm               : 7.2.0
kernel_running     : 7.0.14-rebar(自编,= 7.0.14-p2pdma + 上游 ReBAR headroom 补丁)
secure_boot        : disabled
switch             : Broadcom PEX880xx 系列,独立供电(台达 1500W)
A2. 内核补丁(关键)
patch_title        : PCI: Reserve prefetchable window headroom for Resizable BARs
author             : Geramy Loveless
patchwork_series   : 520756 (v2 2026-08-28 / v3 2026-08-31)
size               : 5 files, +198 / -0
new_kernel_options : pci=no_rebar_reserve  (默认开), pci=no_bar_demote (默认开)
upstream_test_env  : ASUS K14PG-D24 / 2× EPYC 9354 / 8× Radeon AI PRO R9700 / Broadcom PEX890xx
手工修补           : hunk #4(7.0.14 把 pci_min_window_alignment 改名为 window_alignment)
A3. BAR / P2P 实测(决定性对照)
# 同一硬件、同一槽位,仅换内核
旧内核 (7.0.14-p2pdma):
  xtx_bar_region0           : 256M
  root_bridge_a0:02.0       : 770M
  upstream_a1:00.0          : 258M
  xtx_p2p (can_access_peer) : false
  allreduce_256MB_rccl      : 2.33 GB/s
  peer_copy                 : 1.65 GB/s
新内核 (7.0.14-rebar):
  xtx_bar_region0           : 32 GiB
  root_bridge_a0:02.0       : 64 GiB
  upstream_a1:00.0          : 64 GiB
  下游链 ×2                 : 各精确 32 GiB
  xtx_p2p                   : true
  allreduce_256MB_rccl      : 7.04 GB/s
  peer_copy                 : 3.44 GB/s
  h2d / d2h                 : 6.04 / 6.82 GB/s(两版相同)
双 R9700(直连根口,rebar 内核):
  allreduce_256MB_rccl      : 7.186 GB/s
  peer_copy                 : 6.19 GB/s
  h2d / d2h                 : 12.47 / 13.27 GB/s
  can_device_access_peer    : true / true
跨根口:
  R9700 <-> 7900XTX         : false(新旧内核同值;not supported by the chipset ×8)
A4. 服务启动参数(原文,路径已占位)
python -m sglang.launch_server
  --max-consecutive-prefill-batches 1        # 本篇从上游 PR #34058 回移的新参数
  --model-path /models/qwen3.8-27b-mtp-fixed
  --host 0.0.0.0 --port 8082
  --served-model-name qwen3.8-27b-p2p
  --tp-size 2
  --quantization gptq
  --dtype bfloat16
  --mamba-ssm-dtype bfloat16
  --kv-cache-dtype auto
  --attention-backend triton
  --context-length 196608                    # 192K
  --mem-fraction-static 0.91
  --max-running-requests 4
  --max-mamba-cache-size 20
  --speculative-algorithm EAGLE
  --speculative-draft-model-path /models/qwen3.8-27b-mtp-fixed   # 同权重当草稿模型(MTP 头)
  --speculative-num-steps 3
  --speculative-eagle-topk 1
  --speculative-num-draft-tokens 4
  --cuda-graph-bs-decode 1 2 4
  --triton-attention-num-kv-splits 16
由 systemd 承载(路径占位):
[Unit]
Description=SGLang (2× 7900 XTX, TP=2) :8082
Wants=gpu-clk-limit.service          # 必须先让限功率生效,再加载模型
After=gpu-clk-limit.service

[Service]
Type=simple
User=<USER>
WorkingDirectory=<SGLANG_DIR>
ExecStart=<SGLANG_DIR>/start_server.sh
Restart=on-failure
RestartSec=15
TimeoutStartSec=1800
StandardOutput=append:<SGLANG_DIR>/service.log
StandardError=append:<SGLANG_DIR>/service.log
LimitMEMLOCK=infinity

[Install]
WantedBy=multi-user.target
A5. 环境变量(启动脚本内 export 全量)
export PYTHONUNBUFFERED=1
export NCCL_DEBUG=WARN
export SGL_DTYPE=bfloat16
export SGL_PHASE_TIMING=0
export USE_HUB_KERNELS=0
# RDNA3 fork 相关开关(下方带前缀的成对出现,是 fork 里两套命名都要给)
export SGLANG_OPT_USE_CUSTOM_ALL_REDUCE_V2=1
export SGLANG_RDNA_CUSTOM_AR=0
export SGL_RDNA_CUSTOM_AR=0
export SGLANG_RDNA_NO_FUSED=1
export SGLANG_RDNA_GEMMA_TRITON=1
export SGLANG_RDNA_VLLM_VERIFY=1
export SGL_RDNA_NO_FUSED=1
export SGL_RDNA_GEMMA_TRITON=1
export SGL_RDNA_VLLM_VERIFY=1
# kfd event-age 修复 shim(fork 自带,用 LD_PRELOAD 注入)
SHIM=<SGLANG_DIR>/scripts/rdna_ar/vendor/kfd_event_age_fix.so
[ -f "$SHIM" ] && export LD_PRELOAD="$SHIM:${LD_PRELOAD:-}"
说明:
SGLANG_RDNA_CUSTOM_AR=0是主动关掉作者那套 PCIe All-Reduce 的开关——本篇实测证明它在当前环境下起不来(缺算子),关掉可避免误导性告警。A6. 限频/OD 设置
gpu_clk_limit_service : SCLK <= 2000 MHz, VDDGFX -100mV(两张 7900XTX)
dropin                : gpu-clk-limit.service.d/sclk2000.conf  (ExecStart override)
回退                  : rm sclk2000.conf && systemctl daemon-reload
R9700 稳定性服务       : 210 W / SCLK-500MHz / VDD-100mV
读回校验               : OD_SCLK: 2000Mhz, OD_VDDGFX_OFFSET: -100mV
A7. 基准原始数据
断流对照(冷 48,000 token prefill 注入,短请求先解码起来):
{ "E_starvation_E0": { "big_prompt_tokens": 48000, "big_prefill_s": 48.07, "small_ttft_s": 0.339, "small_n_out": 29, "max_gap_s": 47.58, "median_gap_s": 0.034, "gaps_over_1s": [47.58] }, "E_starvation_E1": { "big_prompt_tokens": 48000, "big_prefill_s": 48.58, "small_ttft_s": 0.34, "small_n_out": 28, "max_gap_s": 5.062, "median_gap_s": 0.137, "gaps_over_1s": [3.364, 3.173, 3.392, 3.610, 3.817, 4.025, 4.230, 4.439, 4.648, 4.858, 5.062, 3.517] } }上下文扫描与并发(强制输出 512 数字后重跑,格式同上;本段由脚本直接产出 JSON):
{
  "B2_context_sweep": [
    {"target": 1024,   "prompt_tokens": 1023,   "ttft_s": 0.853,   "prefill_tps": 1199, "decode_tps": 28.71, "n_out": 184},
    {"target": 4096,   "prompt_tokens": 4095,   "ttft_s": 2.968,   "prefill_tps": 1380, "decode_tps": 28.18, "n_out": 179},
    {"target": 8192,   "prompt_tokens": 8191,   "ttft_s": 6.138,   "prefill_tps": 1334, "decode_tps": 27.51, "n_out": 200},
    {"target": 16384,  "prompt_tokens": 16383,  "ttft_s": 13.142,  "prefill_tps": 1247, "decode_tps": 26.02, "n_out": 172},
    {"target": 32768,  "prompt_tokens": 32767,  "ttft_s": 29.586,  "prefill_tps": 1108, "decode_tps": 23.55, "n_out": 179},
    {"target": 65536,  "prompt_tokens": 65535,  "ttft_s": 72.401,  "prefill_tps": 905,  "decode_tps": 19.73, "n_out": 171},
    {"target": 128000, "prompt_tokens": 127999, "ttft_s": 191.216, "prefill_tps": 669,  "decode_tps": 15.19, "n_out": 167}
  ],
  "C2_concurrency": [
    {"level": 1, "wall_s": 8.21,  "agg_tps": 23.4, "ttft_med": 1.53,  "ttft_max": 1.53,  "decode_med": 28.59},
    {"level": 2, "wall_s": 11.59, "agg_tps": 32.6, "ttft_med": 2.22,  "ttft_max": 2.96,  "decode_med": 20.23},
    {"level": 4, "wall_s": 17.72, "agg_tps": 45.3, "ttft_med": 4.41,  "ttft_max": 5.91,  "decode_med": 15.34},
    {"level": 8, "wall_s": 33.39, "agg_tps": 45.0, "ttft_med": 11.97, "ttft_max": 22.57, "decode_med": 14.48}
  ],
  "D_speculative": {"samples": 33, "accept_len_median": 2.35, "accept_rate_median": 0.45,
                    "gen_throughput_median": 52.1, "gen_throughput_max": 75.5},
  "peak_telemetry": {"samples": 896, "power_w": [250.0, 253.0], "junction_c": [84.0, 87.0]}
}
关于本节的 JSON:B2 那一段是从脚本的标准输出逐列重建的(数值即运行时打印值)。原因是采集脚本每完成一段就覆写整个结果文件,跑到最后只剩最后一段——这是"测量脚本必须合并写入而非覆写"的现成反例,已记进我自己的踩坑清单。C2 / D / 遥测三段是脚本直接落盘的原始 JSON。
冷启动(
journalctl Started→ 引擎ready to roll,5 次):13:50:14->13:51:27 = 73s 13:57:11->13:58:25 = 74s 14:05:57->14:07:10 = 73s 14:13:49->14:15:01 = 72s 14:18:57->14:20:10 = 73sA8. 日志关键行(原文)
# 通信路径(本篇的核心结论之一)
[AR] All-reduce call path: NCCL (custom AR disabled)
[AR] Aiter custom all-reduce not available; falling back to sglang CustomAllreduce. Details: No module named 'aiter'
Setup Custom allreduce failed with '_OpNamespace' 'sgl_kernel' object has no attribute 'meta_size'. To silence this warning, specify --disable-custom-all-reduce explicitly.
multimem all-gather disabled (no multicast for world_size=2)

# 启动阶段(时间戳见 A7)
Load weight end. elapsed=7.01 s, type=Qwen3_5ForConditionalGeneration, quant=gptq, bits=4, avail mem=14.43 GB, mem usage=9.12 GB.
Load weight end. elapsed=0.99 s, type=Qwen3_5ForCausalLMMTP, quant=gptq, bits=4, avail mem=11.59 GB, mem usage=2.82 GB.
Capture target verify CUDA graph begin. backend=full, num_tokens_per_req=4, bs=[1, 2, 4], avail mem=4.50 GB
Capture target verify CUDA graph end. elapsed=9.03 s, mem usage=0.44 GB
Capture draft decode CUDA graph end. elapsed=3.95 s, mem usage=0.29 GB
max_total_num_tokens=242854, chunked_prefill_size=4096, max_prefill_tokens=16384, max_running_requests=4, context_len=196608, available_gpu_mem=3.76 GB
The server is fired up and ready to roll!

# 运行期(吞吐与投机解码)
Prefill batch, #new-seq: 1, #new-token: 4096, #cached-token: 0, ..., input throughput (token/s): 621.40
Decode batch, #running-req: 1, #full token: 484, ..., accept len: 2.45, accept rate: 0.48, cuda graph: True, gen throughput (token/s): 71.28
注:
Setup Custom allreduce failed with ... meta_size这一行在装上 amdsmi 之后才出现——装之前报的是name 'amdsmi_shut_down' is not defined。报错换了一行,说明卡点从环境层推进到了算子层,这是本篇判断"收益吃不到"的直接证据。A9. 复现命令
# 冷启动计时
time (systemctl restart sglang-p2p.service; until curl -sf http://127.0.0.1:8082/health; do sleep 1; done)

# 单流上下文扫描(每次清缓存,避免命中 radix 前缀缓存)
curl -s -X POST http://127.0.0.1:8082/flush_cache -d '{}' -H 'Content-Type: application/json'
curl -s http://127.0.0.1:8082/v1/completions -H 'Content-Type: application/json' \
  -d '{"model":"<served-name>","prompt":"<unique-prefix text>","max_tokens":128,"stream":true}'

# 卡间带宽(只用 RCCL)
torchrun --nproc_per_node=2 allreduce_bench.py --size-mb 256
A10. 本轮移植的上游 PR
pr : sgl-project/sglang#34058 title : scheduler: bound consecutive prefills to protect decode author : atbe status : OPEN(未合并) new_flag : --max-consecutive-prefill-batches N (默认 0 = 保持 prefill 优先) semantics : 仅在 has_runnable_decode 为真时介入;连续 N 个 prefill 批次后强制一个 decode 轮 fixes : issue #32549(持续 chunked-prefill 下 decode 被饿到每 24s 才 1 个 batch) 移植要点 : fork 的 server_args 已重构为 arg_groups/{fields,validation_hook,field_order}, PR 的 hunk 完全对不上;新增文件可原样落地,其余按 fork 自身写法手工落点 -
-
-
T7910 PCIE SWITCH 双卡推理续篇:自编 ReBAR 内核吃下 32G 大 BAR、7900XTX 解锁 2000MHz,附一整天的实测数据
期待对 switch 的继续测试. 我感觉 "内部 gen2" 很可疑啊...
lspci -tv看看 topology 到底长什么样? 链路的 bottlenect 在哪里?把每一跳的 LnkCtl2(Target Link Speed)和 LnkSta 都 dump 了一遍,结论是**"内部 Gen2"这个说法是我读错了**:
PEX880xx 会把自己一堆内部虚拟端口(Port #225/#233/#247)也枚举出来,那些行 Target=5GT/s、EqualizationComplete-(没做过均衡)—— 它们只是下行真实端口的镜像值,不能当证据。
真凶是交换机下行口
显卡上游口那一跳:两端 LnkCap 16GT/s x16、Target 16GT/s,但 LnkSta = 5GT/s x16 (downgraded) ⇒ 要求 Gen4、训练后自己回落,属物理层,不是配置。宽度全程 x16 没降,所以原文"x8"也写错了,已更正。
交叉验证:该跳单卡 H2D/D2H = 6.04/6.82 GB/s(Gen2 x16 理论上限 8.0,效率 7585%);直插根口那对是 12.47/13.27(Gen3 x16 上限 15.75,效率 7984%)——效率一致、比值 2.1× ≈ 带宽比 2.0×。还不止:两张卡共用一个根口(直插那对是各自独占),所以这段上行本身是 Gen3 x16 共享。按实测单卡 6.0 GB/s,两卡满跑 12 < 15.75,当前瓶颈仍是那个 Gen2 跳。
下一步按成本排:换线/转接板重插 → 换交换机下行口 → pcie_aspm=off(现在全链路 ASPM L1 开着)→ 最后才考虑 setpci 强制重训(边际链路可能直接掉卡,且绝不能在跑推理时做)。
卡对卡 P2P 我没下结论:AllReduce 7.04 vs 直连那对 7.19 几乎一样,更像被 RCCL 开销卡住而非 Gen2,要 rocm-bandwidth-test 横幅才定。══ 0000:05:00.0 ★ R9700(直插槽)
0000:00:02.0 Intel 根口 (Xeon E7v4)
0000:03:00.0 Navi31 上行口 (卡内) ← 上行链路 Gen3 x16 (能力 Gen5 x16) ✓ 正常:上游平台只到 Gen3
0000:04:00.0 Navi31 下行口 (卡内) ← 上行链路 Gen5 x16 (能力 Gen5 x16)
0000:05:00.0 ★ R9700 ← 上行链路 Gen5 x16 (能力 Gen5 x16)══ 0000:08:00.0 ★ R9700(直插槽)
0000:00:03.0 Intel 根口 (Xeon E7v4)
0000:06:00.0 Navi31 上行口 (卡内) ← 上行链路 Gen3 x16 (能力 Gen5 x16) ✓ 正常
0000:07:00.0 Navi31 下行口 (卡内) ← 上行链路 Gen5 x16 (能力 Gen5 x16)
0000:08:00.0 ★ R9700 ← 上行链路 Gen5 x16 (能力 Gen5 x16)══ 0000:aa:00.0 ★ 7900 XTX(走交换机)
0000:a0:02.0 Intel 根口 (Xeon E7v4)
0000:a1:00.0 交换机上游口 ← 上行链路 Gen3 x16 (能力 Gen4 x16) ✓ 正常
0000:a2:04.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:a6:00.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:a7:00.0 交换机下端口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 真实物理链路降速
0000:a8:00.0 卡上行口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 同一跳的另一端
0000:a9:00.0 卡下行口 ← 上行链路 Gen4 x16 (能力 Gen4 x16)
0000:aa:00.0 ★ 7900 XTX ← 上行链路 Gen4 x16 (能力 Gen4 x16)══ 0000:b0:00.0 ★ 7900 XTX(走交换机)
0000:a0:02.0 Intel 根口 (Xeon E7v4)
0000:a1:00.0 交换机上游口 ← 上行链路 Gen3 x16 (能力 Gen4 x16) ✓ 正常
0000:a2:08.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:ac:00.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:ad:00.0 交换机下端口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 真实物理链路降速
0000:ae:00.0 卡上行口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 同一跳的另一端
0000:af:00.0 卡下行口 ← 上行链路 Gen4 x16 (能力 Gen4 x16)
0000:b0:00.0 ★ 7900 XTX ← 上行链路 Gen4 x16 (能力 Gen4 x16) -
继续加油 持续关注中
-
T7910 PCIE SWITCH 双卡推理续篇:自编 ReBAR 内核吃下 32G 大 BAR、7900XTX 解锁 2000MHz,附一整天的实测数据
期待对 switch 的继续测试. 我感觉 "内部 gen2" 很可疑啊...
lspci -tv看看 topology 到底长什么样? 链路的 bottlenect 在哪里?把每一跳的 LnkCtl2(Target Link Speed)和 LnkSta 都 dump 了一遍,结论是**"内部 Gen2"这个说法是我读错了**:
PEX880xx 会把自己一堆内部虚拟端口(Port #225/#233/#247)也枚举出来,那些行 Target=5GT/s、EqualizationComplete-(没做过均衡)—— 它们只是下行真实端口的镜像值,不能当证据。
真凶是交换机下行口
显卡上游口那一跳:两端 LnkCap 16GT/s x16、Target 16GT/s,但 LnkSta = 5GT/s x16 (downgraded) ⇒ 要求 Gen4、训练后自己回落,属物理层,不是配置。宽度全程 x16 没降,所以原文"x8"也写错了,已更正。
交叉验证:该跳单卡 H2D/D2H = 6.04/6.82 GB/s(Gen2 x16 理论上限 8.0,效率 7585%);直插根口那对是 12.47/13.27(Gen3 x16 上限 15.75,效率 7984%)——效率一致、比值 2.1× ≈ 带宽比 2.0×。还不止:两张卡共用一个根口(直插那对是各自独占),所以这段上行本身是 Gen3 x16 共享。按实测单卡 6.0 GB/s,两卡满跑 12 < 15.75,当前瓶颈仍是那个 Gen2 跳。
下一步按成本排:换线/转接板重插 → 换交换机下行口 → pcie_aspm=off(现在全链路 ASPM L1 开着)→ 最后才考虑 setpci 强制重训(边际链路可能直接掉卡,且绝不能在跑推理时做)。
卡对卡 P2P 我没下结论:AllReduce 7.04 vs 直连那对 7.19 几乎一样,更像被 RCCL 开销卡住而非 Gen2,要 rocm-bandwidth-test 横幅才定。══ 0000:05:00.0 ★ R9700(直插槽)
0000:00:02.0 Intel 根口 (Xeon E7v4)
0000:03:00.0 Navi31 上行口 (卡内) ← 上行链路 Gen3 x16 (能力 Gen5 x16) ✓ 正常:上游平台只到 Gen3
0000:04:00.0 Navi31 下行口 (卡内) ← 上行链路 Gen5 x16 (能力 Gen5 x16)
0000:05:00.0 ★ R9700 ← 上行链路 Gen5 x16 (能力 Gen5 x16)══ 0000:08:00.0 ★ R9700(直插槽)
0000:00:03.0 Intel 根口 (Xeon E7v4)
0000:06:00.0 Navi31 上行口 (卡内) ← 上行链路 Gen3 x16 (能力 Gen5 x16) ✓ 正常
0000:07:00.0 Navi31 下行口 (卡内) ← 上行链路 Gen5 x16 (能力 Gen5 x16)
0000:08:00.0 ★ R9700 ← 上行链路 Gen5 x16 (能力 Gen5 x16)══ 0000:aa:00.0 ★ 7900 XTX(走交换机)
0000:a0:02.0 Intel 根口 (Xeon E7v4)
0000:a1:00.0 交换机上游口 ← 上行链路 Gen3 x16 (能力 Gen4 x16) ✓ 正常
0000:a2:04.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:a6:00.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:a7:00.0 交换机下端口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 真实物理链路降速
0000:a8:00.0 卡上行口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 同一跳的另一端
0000:a9:00.0 卡下行口 ← 上行链路 Gen4 x16 (能力 Gen4 x16)
0000:aa:00.0 ★ 7900 XTX ← 上行链路 Gen4 x16 (能力 Gen4 x16)══ 0000:b0:00.0 ★ 7900 XTX(走交换机)
0000:a0:02.0 Intel 根口 (Xeon E7v4)
0000:a1:00.0 交换机上游口 ← 上行链路 Gen3 x16 (能力 Gen4 x16) ✓ 正常
0000:a2:08.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:ac:00.0 交换机端口 [内] ← 上行链路 Gen2 x16 (能力 Gen4 x16) [镜像值,非物理链路]
0000:ad:00.0 交换机下端口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 真实物理链路降速
0000:ae:00.0 卡上行口 ← 上行链路 Gen2 x16 (能力 Gen4 x16) ✗✗ 同一跳的另一端
0000:af:00.0 卡下行口 ← 上行链路 Gen4 x16 (能力 Gen4 x16)
0000:b0:00.0 ★ 7900 XTX ← 上行链路 Gen4 x16 (能力 Gen4 x16) -
-
T7910 双卡第三篇:Q8 全精度 + 真张量并行跑通(比层切分快 19.7%),以及一套「三档可切换」的本地推理服务
上篇:《T7910 双卡推理续篇:自编 ReBAR 内核吃下 32G 大 BAR、7900XTX 解锁 2000MHz,附一整天的实测数据》;更早:《双 7900XTX + PCIe 交换机 + SGLang TP=2 实测与掉卡复盘》《T7910 双卡 AI 推理全记录:从 7900XTX 掉总线到 R9700 打通 P2P》。
本篇只写增量:并行方式与精度档的重新选型 —— 从「层切分 + 中间量化」换成「真张量并行 + Q8 全精度」,以及由此衍生出的一套三档服务、它的固化方式和一批带口径的数据。平台、装机、采购价、大 BAR 补丁上篇都讲过,不再重复。TL;DR
事项 结果 一句话 双 7900XTX 上跑真张量并行( -sm tensor) 成了上游 llama.cpp 在 ROCm 下必崩;换实验 fork(自研内部 all-reduce + P2P)后跑通 **Q8 全精度(29 GB 权重)**装进双 24 GB 卡 成了关键不是「显存刚好够」,而是张量并行把显存摊平:22.2 / 22.2 GiB 同二进制 A/B:tensor vs layer +19.7%58.16 vs 48.60 tok/s(Q8_0 / 128K / 单流),代码类 +30% 上下文与并发 ️ 要读对口径ctx=196608是两槽共享的池,不是「每槽 192K」;单请求能吃到满主机内存提示缓存 48 GiB ️ 超配淘汰 0 次、命中 83% ⇒ 再加大没用;两个满槽其实 24~33 GiB 就够 客户端出现空回答 踩了直连推理端口会因「思考通道」把正文吐空 ⇒ 客户端一律走网关别名 「开机即用」的固化 ️ 只 enable 服务不够GRUB 默认内核指向另一版 ⇒ 重启后 P2P 能力全丢,必须连内核一起钉住 拿 R9700 换下单张 7900XTX 跑 不划算单卡 32.05 tok/s / 只能 64K,对比双卡 36.85 tok/s / 192K(详见 §2.6) 给赶时间的人:这一轮真正改命的是换并行方式(层切分 → 张量并行)——它一次解决了「慢」和「装不下」两件事;而看上去最该调的那几个参数(提示缓存大小、并发槽、草稿深度),实测下来不是已经超配就是本来就不是瓶颈。先量再改,第二次。
一、想解决的三件事(思路,不是结论)
1. 精度底线 vs 24 GB 显存
我们这边的偏好是「尽量不降智」:模型从 27B 级稠密模型起步,量化档只考虑 Q6/Q8 这一档,不接受把主力模型换成 4bit。问题很直接:
27B 稠密 · Q8_0  →  权重 ~29 GB
27B 稠密 · Q6_K  →  权重 ~24 GB
双 7900XTX 可用显存 = 2 × 24 GB = 48 GB(还要扣 KV / 计算缓冲 / 混合 SSM 的 rs cache)
单卡 24 GB 装不下 Q8,双卡必须切分。看起来方案很多,实际能用的很少。
2. 为什么不能继续用层切分(
-sm layer)上篇之前我们一直跑的是 SGLang TP=2(int4 权重)和 llama.cpp 的
-sm layer(Q6)。层切分的问题是显存不均:切分方式 卡 0 显存 卡 1 显存 后果 层切分( -sm layer)19.45 GiB 22.58 GiB(94%) 满的那张先撞墙 ⇒ 它就是瓶颈卡,上下文再加一点就 OOM 张量并行( -sm tensor)22.2 GiB 22.2 GiB 完全均分 ⇒ 没有短板卡 这就是「Q8 装不下」的真正原因:不是总量不够,是层切分把 29 GB 的权重压到了某一张卡上。也顺带解释了以前那种「显存没顶满啊,怎么还 OOM」的困惑 —— 另一张卡满了。
3. 三条路与筛选判据链
目标:双 24G 卡上,Q8 精度 + 尽量快 ├─ 路 A:降精度(int4/4bit) → ✗ 违背「不降智」底线,先排除 ├─ 路 B:换卡(单张 32G 卡跑单卡) → ✗ 带宽/容量实测不划算(§2.6 有数据) └─ 路 C:修「张量并行」 → ✓ 唯一同时解决「慢」和「装不下」的方向 ├─ C1:上游 llama.cpp `-sm tensor` → ✗ 实测直接崩(ROCm/meta backend) └─ C2:找已经修通它的实验 fork → ✓ 本次落点判据链的关键一步是把「崩」和「慢」分开:上游那份在
-sm tensor下是启动阶段就崩(不是慢、不是掉精度),所以它不是调参问题,而是必须换实现 —— 这一步想清楚,后面就不会在参数上瞎耗。
二、速度与显存总账
口径声明(论坛上最容易被挑的就是这个,先写在前面):本节所有数字,除特别标注外均为
Q8_0 权重 · f16 KV · ctx 131072 ·--parallel 1(单流)· 开投机解码(MTP,草稿深度 3)· 取四类内容各跑一遍的平均。2.1 同二进制 A/B(最干净的一组对照)
同一个二进制、同一份 Q8_0 权重、同一上下文,只换切分方式与草稿策略:
配置 平均 decode (tok/s) 散文 代码 技术说明 改写复用 -sm tensor+ MTP n-max 358.16 49.35 67.61 46.68 69.00 -sm layer+ MTP n-max 3(同二进制)48.60 42.98 52.04 39.96 59.43 -sm tensor+ adaptive MTP n-max 459.33 49.61 67.69 47.30 72.73 - tensor 比 layer 快 19.7%,且四类内容全部取胜(最夸张的是代码类 +30%)。
- 换用自适应草稿策略(n-max 4)再涨一点到 59.33 tok/s。
- 这一组对照的价值在于排除了「模型/量化差异」这个变量 —— 以前跨框架比出来的数字,往往两种东西一起变了。
2.2 与现役 Q6 档的口径对照(注意口径不同)
档位 权重 切分 ctx 并发 平均 decode 旧:Q6 档 Q6_K 系(24 GB)+ 压缩词表草稿 layer 196608 --parallel 236.85 tok/s 新:Q8 档 Q8_0(29 GB)+ 完整词表草稿 tensor 196608 --parallel 258~59 tok/s ⇒ 精度更高(Q8 对 Q6)、速度还快 57%。这条对照里两档的并发口径一致,但切分方式和量化档同时变了,所以只做参考,别当纯 A/B 用(纯 A/B 见 §2.1)。
2.3 显存账(同一台机器、同一批卡)
Q8 档(tensor)  :卡 0 22.2 GiB  |  卡 1 22.2 GiB     ⇐ 完全均分,各剩 ~1.8 GiB
Q6 档(layer)   :卡 0 19.45 GiB |  卡 1 22.58 GiB    ⇐ 不均,卡 1 已 94%
权重占比         :Q6 档 ≈ 25 GB / 48 GB = 61%(固定项)
KV + 计算缓冲    :反推 ≈ 85 KiB/token(f16 KV,含混合 SSM 的 rs cache)
⇒ 想上 256K 上下文,需要再多 ≈ 5.6 GB —— 对 layer 档必撞死,对 tensor 档才是「够不够均分」的问题
2.4 上下文与并发(服务端自报,别用猜的)
load_model: initializing, n_slots = 2, n_ctx_slot = 196608, kv_unified = 'true'项 值 怎么读 槽数(并发上限) 2 同时最多 2 个请求 单槽上下文上限 196608 单个请求可以吃满 192K kv_unifiedtrue192K 是两个槽共享的总池:单请求可吃满,双请求之和 ≤ 192K 实时占用示例 槽 0 = 18,613 tok / 槽 1 = 0 /slots能直接看到每槽占了多少别把它读成「2 × 192K」——这是本轮最容易被自己误导的一条(我也是先写错、再对着
/props改回来的)。2.5 实况读数(真实使用中的累计值,不是跑分)
跑分是短时的,下面这组是一边用一边攒的服务端累计指标(
/metrics):指标 值 口径 平均 decode 73.96 tok/s 48,848 token ÷ 660.48 s(短请求多、含大量缓存命中,故高于跑分) 平均 prefill 750 tok/s 78,759 新 token ÷ 105.03 s 历史最大单次 prompt 80,179 token 还没碰到 192K 的边 草稿接受率 90.8% 38,055 / 41,895 逐位置接受数 pos0 10,272 → pos1 9,881 → pos2 9,511 → pos3 8,391 第 4 位仍有 ~78% ⇒ 草稿深度 4 是合理值 平均忙碌槽数 1.0008 基本一直是单槽在解码(没有真并发负载) 2.6 顺手做的一次对照:拿 32 GB 的 R9700 换下单张 7900XTX
同为 24/32 GB 级别的卡,很自然会想「单张 32 GB 岂不是更省事」。实测:
方案 decode (tok/s) 可跑上下文 备注 单张 R9700(32 GB,RDNA4) 32.05 只能 64K 散文 22.29 / 代码 42.28 / 技术说明 35.20 / 改写 28.43;131072 直接 OOM( cudaMalloc failed ... 1197 MiB)双 7900XTX(24 GB × 2,RDNA3) 36.85(Q6)/ 58~59(Q8) 192K 见上 结论:不换。 原因很硬:decode 是显存带宽受限——R9700 约 640 GB/s,7900XTX 约 960 GB/s,差 1.5 倍不是代际能抹平的。这条也顺手修正了我自己早前的一个误判(当时基于 int4 + 另一个框架的数据,我一度以为 R9700 单卡更强,那是错的)。
三、几个反直觉的发现
1. 张量并行的收益不在「更快」,在「装得下」
+19.7% 当然好,但真正值钱的是显存摊平(22.2 / 22.2 vs 19.45 / 22.58)。对双卡用户,这直接决定了「更大的量化档能不能跑」:Q8 能装下,靠的就是它;而层切分下,你永远要被那张最满的卡卡住。
2. 「上下文开得不大」是错觉 —— 要看那张最满的卡
以前问「显存怎么没顶满,是上下文开小了吗」,答案是:总占用不低(41/48 GB),但分布不均——一张 19.45、一张 22.58,瓶颈在后者。换了张量并行之后同样的上下文两颗卡一起 92%,才叫真的顶满。
3. 提示缓存:淘汰为 0,就说明加它没用
llama.cpp 的
--cache-ram(默认只有 8 GiB)是主机内存里的提示缓存上限,不是预分配。我们开到 48 GiB,实测:项 值 上限 48 GiB 实际匿名页占用 ≈ 11.6 GiB(进程 RSS 15.17 GiB) 淘汰次数 0 命中率 83%(392,564 缓存命中 / 78,759 新算) ⇒ 48 GiB 对「2 个 192K 槽」是超配(按 KV 折算两满槽约 24~33 GiB 就够)。判据:只要淘汰计数是 0,加大它不会有任何收益。
4. 直连推理端口会吐「空回答」——不是模型坏了
同一个模型、同一句话:
走网关别名 → '可用'      (客户端带了「关闭思考」的模板参数)
裸直连端口 → ''          (思考 token 全进了 reasoning_content,正文为空)
⇒ 客户端一律走网关别名(顺手还能统一带上
max_input_tokens之类口径)。别拿裸 curl 的空白答复判模型死刑——这个坑我们当时差点误判成「这个模型不行」。5. 内核/GRUB 也是「持久化」的一部分
把服务
systemctl enable了,就以为重启后能自动还原 —— 不一定:跑通时用的内核:自编 rebar 内核(大 BAR 32G + P2P 可用) GRUB 默认项 :另一版内核(p2pdma) ← 重启后 P2P 能力随内核一起换掉 ⇒ 服务 enabled 也白搭:起来的是「跑不通那套张量并行」的机器修法就是把默认项钉成跑通的那一版(
GRUB_DEFAULT的子菜单编号写法、改前备份/etc/default/grub、update-grub后核对,并确认没有开GRUB_SAVEDEFAULT—— 开了会有 saved_entry 悄悄盖掉默认项)。这条不是这次才发现的道理,但这次才真吃了它的亏。
四、还没打通的墙 / 需要围观的地方(含推测标注)
事项 现状 推测 / 下一步 张量模式的 prefill(前置处理)代价 公开的同代双卡实测称 tensor 模式前置比 layer 低约 20%;我们本机没测出退化(8.9K prompt 实测 ~1000 tok/s) 推测:那条数据来自另一个模型/量化档,且前置受工程细节影响大。待验证:固定脚本、同二进制、四种 prompt 长度各跑 3 次取中位 单请求吃满 192K 后没有并发余量 已确认(共享池语义) 想真正双路长上下文必须把池加一倍;但每卡只剩 ~1.8 GiB ⇒ 只能靠 KV 降精度或更小权重,目前不做 采样回 CPU tensor 模式的固有行为(服务端自报 3 条无害告警) 观察是否影响高并发下的采样延迟;单流实测无感 显存温度 ~90°C 风扇曲线对热点有效、对显存无效 推测:需要显存侧的导热改造(背板/风道),软件层已到极限 交换机路径带宽天花板 卡 交换机是 Gen4 x16,内部部分跳只跑 Gen2(上篇已记)与本篇无关,但仍是「跨卡通信上不去」的上游瓶颈
五、给后来人的清单
选型之前
- 先问自己「能不能接受 4bit」:能 ⇒ 路 A 便宜省事;不能 ⇒ 直接看双卡 + 张量并行这条路
- 别用「显存总量」判断能不能装:先算单卡最满那一张(层切分一定不均)
- 把「启动就崩」和「跑得慢」分开:崩 ⇒ 换实现,慢 ⇒ 调参,两件事别混着耗
部署时
- 客户端接网关别名(带关闭思考的模板参数),别裸连推理端口
- 服务用 systemd 管:
Restart=on-failure+RestartSec(加载慢的模型给 20s 左右,别抖动重启) - 同时钉住内核:跑通那版必须是 GRUB 默认项
调优时
- 测速一律
--parallel 1:--parallel 2的基线会低读约 20%(拿两种口径的数字互比必然得出错误结论) - 草稿深度试到 4 附近就够(公开数据 2→52.8 / 3→57.3 / 4→57.6 / 6→54.3 tok/s,更深有害)
- 投机解码用服务端自报的接受率验收(
接受数 ÷ 草稿数),并有逐位置计数:第 N 位还值不值得试,一眼就能看出来 --cache-ram别按「越大越好」加:淘汰计数 0 就停手
排障时
- 空回答 ⇒ 先怀疑「思考通道吃掉了正文」,不是模型坏了
- 显存「没顶满但 OOM」⇒ 看第二张卡 / 看是不是层切分不均
- 重启后服务「没起来」⇒ 先看内核是否换了版本,再看服务 enable 状态
六、当前状态 + 下一步
- 现在跑的是 Q8 全精度 + 真张量并行档:29 GB 权重 + 完整词表 MTP 草稿,单流 58~59 tok/s,192K 共享池,冷启动约 29 秒(日志自报 listening 在 0:29)。
- 一台机器上并存三档、互斥切换(引擎/precision/上下文各不同),客户端不用动:网关别名跟着档位走。
- 开机即用已固化:服务自启 + 崩溃自愈 + 内核默认项钉死。
- 下一步:① 把 prefill 对比补成正式 A/B(§四 第一条);② 找一个 Q6 档的替代模型做「精度/速度权衡」的第三点;③ 显存散热改造(软件已尽力)。
附:给 AI / 爬虫的结构化数据段
路径与用户名已占位(
<USER>、<MODELS_DIR>、<FORK_DIR>);公开型号、模型文件名、端口照写,可复现性靠它们。A1. 平台与软件栈
平台: Dell Precision Tower 7910 (BIOS A34)
CPU: 2 × Xeon E5-2683 v4 @2.1GHz
RAM: 125 GiB
GPU_primary: 2 × AMD Radeon RX 7900 XTX 24GB (Navi31 / gfx1100 / RDNA3)   # 现役
GPU_other:   2 × AMD Radeon AI PRO R9700 32GB (gfx1201 / RDNA4)          # 在场,空载(见 2.6 为何不换)
互联: 两卡同挂 PLX 交换机下游(Gen4 x16 下行;内部部分跳 Gen2)→ 已实测不影响本方案
内核: 自编 rebar 内核 7.0.14-rebar(大 BAR 32G + P2P 可用);GRUB 默认项已钉到同一版
ROCm: 7.2.26015(注意:fork README 写的是 7.14,不可照抄)
OS: Ubuntu 24.04 系
A2. 引擎:实验 fork 与它改了什么
repo: nasone32/llama.cpp-RDNA3-7900xtx-opt      # "RDNA3 真张量并行"实验分支
build_target: gfx1100
version_string: 0.3.0-dev (build 0, commit unknown)
关键改动(按对本方案的作用排序):
  - 自研内部 HIP all-reduce + P2P(不走 RCCL)        # 上游 -sm tensor 在 ROCm 崩的正面解法
      allreduce.cu
  - Q8 线格式量化 + fused residual + P2P issuer
  - adaptive MTP(草稿深度自适应)
      common/speculative-adaptive.h
  - 修 meta backend(多个提交)
  - Q4_K/Q5_K/Q6_K mmvdq 核 + RDNA WMMA flash-attn + Q6_K MMQ prefill
  - BF16 KV 支持
上游对照: 官方 llama.cpp 在本平台 -sm tensor 启动即崩 ⇒ 本方案依赖该 fork
A3. 服务启动参数(原文;路径已占位)
# 现役 Q8 档(张量并行)
<FORK_DIR>/build-gfx1100/bin/llama-server \
  -m <MODELS_DIR>/Qwen3.8-27B-Uncensored-Q8_0.gguf \
  --model-draft <MODELS_DIR>/Qwen3.8-27B-Uncensored-draft-Q8_0.gguf \
  -sm tensor \
  --host 127.0.0.1 --port 8080 \
  --ctx-size 196608 \
  --parallel 2 --kv-unified --cache-idle-slots \
  --cache-ram 49152 \
  --flash-attn on \
  --cache-type-k f16 --cache-type-v f16 \
  --spec-type draft-mtp --spec-draft-n-max 4 --spec-draft-p-min 0 \
  --no-warmup
# HIP_VISIBLE_DEVICES=2,3   (按本机枚举,两块 XTX 为 ROCm 2/3)
关键参数 ⇄ 作用对照:
参数 值 作用 / 为什么 -sm tensor— 真张量并行:显存摊平 + 卡间只同步必要数据(本篇主线) --ctx-size196608 两槽共享的总池( kv-unified语义,见 2.4)--parallel2 并发槽数 --kv-unified— 启用共享池:单请求可吃满整个 ctx --cache-idle-slots— 空闲槽的缓存行为 --cache-ram49152 (MiB) 主机内存提示缓存上限(默认 8192);48 GiB 实测超配 --spec-draft-n-max4 草稿深度;实测逐位置接受率 pos0 95% → pos3 78%,4 是合理点 --spec-draft-p-min0 关闭按概率提前截断(配合自适应策略时另调) A4. fork 需要的环境变量(一个都别删)
export GGML_CUDA_ALLREDUCE=internal   # 用 fork 自带的 all-reduce 实现
export AR_WIRE=q8_0                   # 卡间通信量化格式
export AR_Q8_THRESHOLD=1048576        # 超过该字节数走 Q8 线格式
export AR_FUSED_RESIDUAL=1            # 融合残差
export GDN_CHUNKED_BF16=1             # 混合 SSM 分块 BF16
export AR_P2P=1                       # 启用 P2P 路径
export AR_P2P_ISSUER=1                # P2P issuer
A5. 三档服务与端口口径
档位 引擎 权重 上下文 端口 用途 sglangSGLang TP=2 int4 + f16 KV + EAGLE 投机 196608 8090 早期 agent 主力档(本轮不涉及) q6上游 llama.cpp / layer 切分 Q6_K 系 24 GB + 压缩词表草稿 196608 8080 严谨档(备用) q8(现役)实验 fork / tensor 并行 Q8_0 29 GB + 完整词表草稿 3.16 GB 196608(2 槽共享) 8080 日常默认 网关 litellm — — 4000 所有客户端连这里(档位别名跟着走) q6与q8共用 8080、互斥(同一时刻只有一个在跑);切换是一次命令的事(约 15~20 秒)- 客户端(两个不同的 agent 前端)都配在 4000,因此换档不用改客户端
A6. 基准原始数据(JSON)
{
  "meta": {
    "weights": "Q8_0",
    "kv": "f16/f16",
    "ctx": 131072,
    "parallel": 1,
    "spec_decode": "draft-mtp",
    "content_classes": ["prose", "code", "tech_explain", "rewrite_reuse"],
    "metric": "mean decode tok/s over 4 classes"
  },
  "runs": [
    {"split": "tensor", "spec": "draft-mtp n-max=3",        "mean": 58.16, "per_class": {"prose": 49.35, "code": 67.61, "tech": 46.68, "rewrite": 69.00}},
    {"split": "layer",  "spec": "draft-mtp n-max=3",        "mean": 48.60, "per_class": {"prose": 42.98, "code": 52.04, "tech": 39.96, "rewrite": 59.43}},
    {"split": "tensor", "spec": "draft-mtp-adaptive n-max=4","mean": 59.33, "per_class": {"prose": 49.61, "code": 67.69, "tech": 47.30, "rewrite": 72.73}}
  ],
  "delta_tensor_vs_layer_pct": 19.7,
  "vram_gib": {
    "q8_tensor": {"card0": 22.18, "card1": 22.19, "card_total": 24.0},
    "q6_layer":  {"card0": 19.45, "card1": 22.58, "card_total": 24.0}
  },
  "live_counters": {
    "decode_mean_tok_s": 73.96,
    "decode_tokens": 48848,
    "decode_seconds": 660.48,
    "prefill_mean_tok_s": 750,
    "prompt_tokens": 78759,
    "prefill_seconds": 105.03,
    "max_single_prompt_tokens": 80179,
    "spec_draft_tokens": 41895,
    "spec_accepted_tokens": 38055,
    "spec_accept_rate": 0.908,
    "spec_accepted_per_pos": [10272, 9881, 9511, 8391],
    "busy_slots_per_decode": 1.0008
  },
  "host_prompt_cache": {
    "cap_mib": 49152,
    "anon_gib_used": 11.61,
    "process_rss_gib": 15.17,
    "evictions": 0,
    "cached_prompt_tokens": 392564,
    "new_prompt_tokens": 78759,
    "hit_ratio": 0.83
  },
  "single_card_alt": {
    "gpu": "R9700 32GB",
    "mean": 32.05,
    "per_class": {"prose": 22.29, "code": 42.28, "tech": 35.20, "rewrite": 28.43},
    "ctx_max": 65536,
    "oom_at_ctx": 131072,
    "verdict": "not_worth_swapping"
  }
}
A7. 日志关键行(原文)
# 槽与上下文(决定「并发 / 上下文」怎么读)
load_model: initializing, n_slots = 2, n_ctx_slot = 196608, kv_unified = 'true'

# tensor 模式的三条无害告警(见到别当故障排查)
llama_params_fit is not implemented for SPLIT_MODE_TENSOR, abort
set_sampler: backend sampling not supported with SPLIT_MODE_TENSOR; using CPU
spec common_specu: backend offload failed for seq_id=0; using CPU sampler
spec common_specu: backend offload failed for seq_id=1; using CPU sampler

# 就绪(冷启动约 29 秒)
srv llama_server: model loaded
srv llama_server: listening on http://127.0.0.1:8080

# 编译期的一个坑(无外网时):拉 llama-ui 资源超时只是 Warning
Timeout was reached   →   no assets available - building without an embedded UI   # 照样编过
A8. 客户端接入(两个前端都走网关别名)
# 统一口径:客户端 → litellm(:4000) → 具体档位
gateway:
  aliases:
    q8: {upstream: "http://127.0.0.1:8080/v1", extra_body: {chat_template_kwargs: {enable_thinking: false}}, max_input_tokens: 196608}
    q6: {upstream: "http://127.0.0.1:8080/v1"}
    sglang: {upstream: "http://127.0.0.1:8090/v1"}
frontend_A: {base_url: "http://<GATEWAY_HOST>:4000/v1", default_model: q8}
frontend_B: {base_url: "http://<GATEWAY_HOST>:4000/v1", default_model: q8, note: "必须走网关;裸连 8080 会得到空正文"}
A9. 复现命令(关键几步)
# 1) 取 fork 源码(服务器无外网时:在有代理的机器上下 tarball 再 SFTP,双向 md5 校验)
#    别覆盖正在用的 llama.cpp 目录
# 2) 编译(用系统 PATH 里的 hipcc,别照抄作者 README 里他本机的 /opt/rocm/<ver>/... 路径)
cmake -B build -DGGML_HIP=ON -DAMDGPU_TARGETS=gfx1100 -DGGML_HIP_GRAPHS=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build -j

# 3) 冒烟(先确认能出正文,再谈速度)
curl -s http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' \
  -d '{"model":"local","messages":[{"role":"user","content":"只回复两个字:可用"}],"max_tokens":8}'

# 4) 判据(唯一可信的「服务就绪」)
curl -s http://127.0.0.1:8080/health          # {"status":"ok"}
curl -s http://127.0.0.1:8080/props  | grep -E 'total_slots|n_ctx'
curl -s http://127.0.0.1:8080/slots           # 每槽实时占用
curl -s http://127.0.0.1:8080/metrics | grep -E 'spec_decode|prompt_tokens|busy_slots'

# 5) 固化:服务自启 + 崩溃自愈 + 内核默认项
systemctl enable <unit>
#   unit 内:Restart=on-failure / RestartSec=20
grep -nE '^(menuentry|submenu)' /boot/grub/grub.cfg   # 先数清子菜单编号再改 GRUB_DEFAULT
cp -a /etc/default/grub /etc/default/grub.bak-$(date +%Y%m%d-%H%M%S)   # 改前必备份
update-grub
A10. 判据与禁用项(踩过才知道的)
- 基准测量:一律
--parallel 1;--parallel 2的口径会低读约 20%,两种数字不能互比 - 投机解码验收:只认服务端自报的
接受数 / 草稿数(+ 逐位置计数);别用「看起来快」当验收 - 上下文读数:以
/props的total_slots/n_ctx_slot/kv_unified为准;kv_unified=true⇒ 共享池 - 缓存调优:淘汰计数为 0 ⇒ 停止加大
--cache-ram - 服务就绪:只认
/health200;加载慢的模型先预告「显存会先空后涨」 - 客户端:不裸连推理端口(思考通道会吃掉正文)
- 固化:
systemctl enable与「GRUB 默认内核」必须同时到位,否则重启后能力不一致 - 排序环:单元依赖(显卡限频/OD 服务)没排好时,
enabled ≠ 会启动(详见上篇) - 测卡对卡带宽:只用 RCCL;别拿拷贝工具的数字当通信能力
-