X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战
这篇主要解决一个问题:X99 / Broadwell-EP 上,两张位于不同 CPU Root Port 的 AMD Radeon AI PRO R9700,怎样真正跑通 Direct P2P,并确认它最终对 SGLang + Qwen3.8 有实际收益。
我把内容分成两部分:前半部分是“可以直接抄作业”的配置与验收流程;后半部分再解释 Huge BAR、44-bit DMA、Linux P2PDMA、RCCL PHB 等问题为什么会卡住。
先看结果
硬件平台:
- CPU:Intel Xeon E5-2697A v4
- 主板:华南金牌 X99-TF GAMING V6.0
- 内存:128GB DDR4
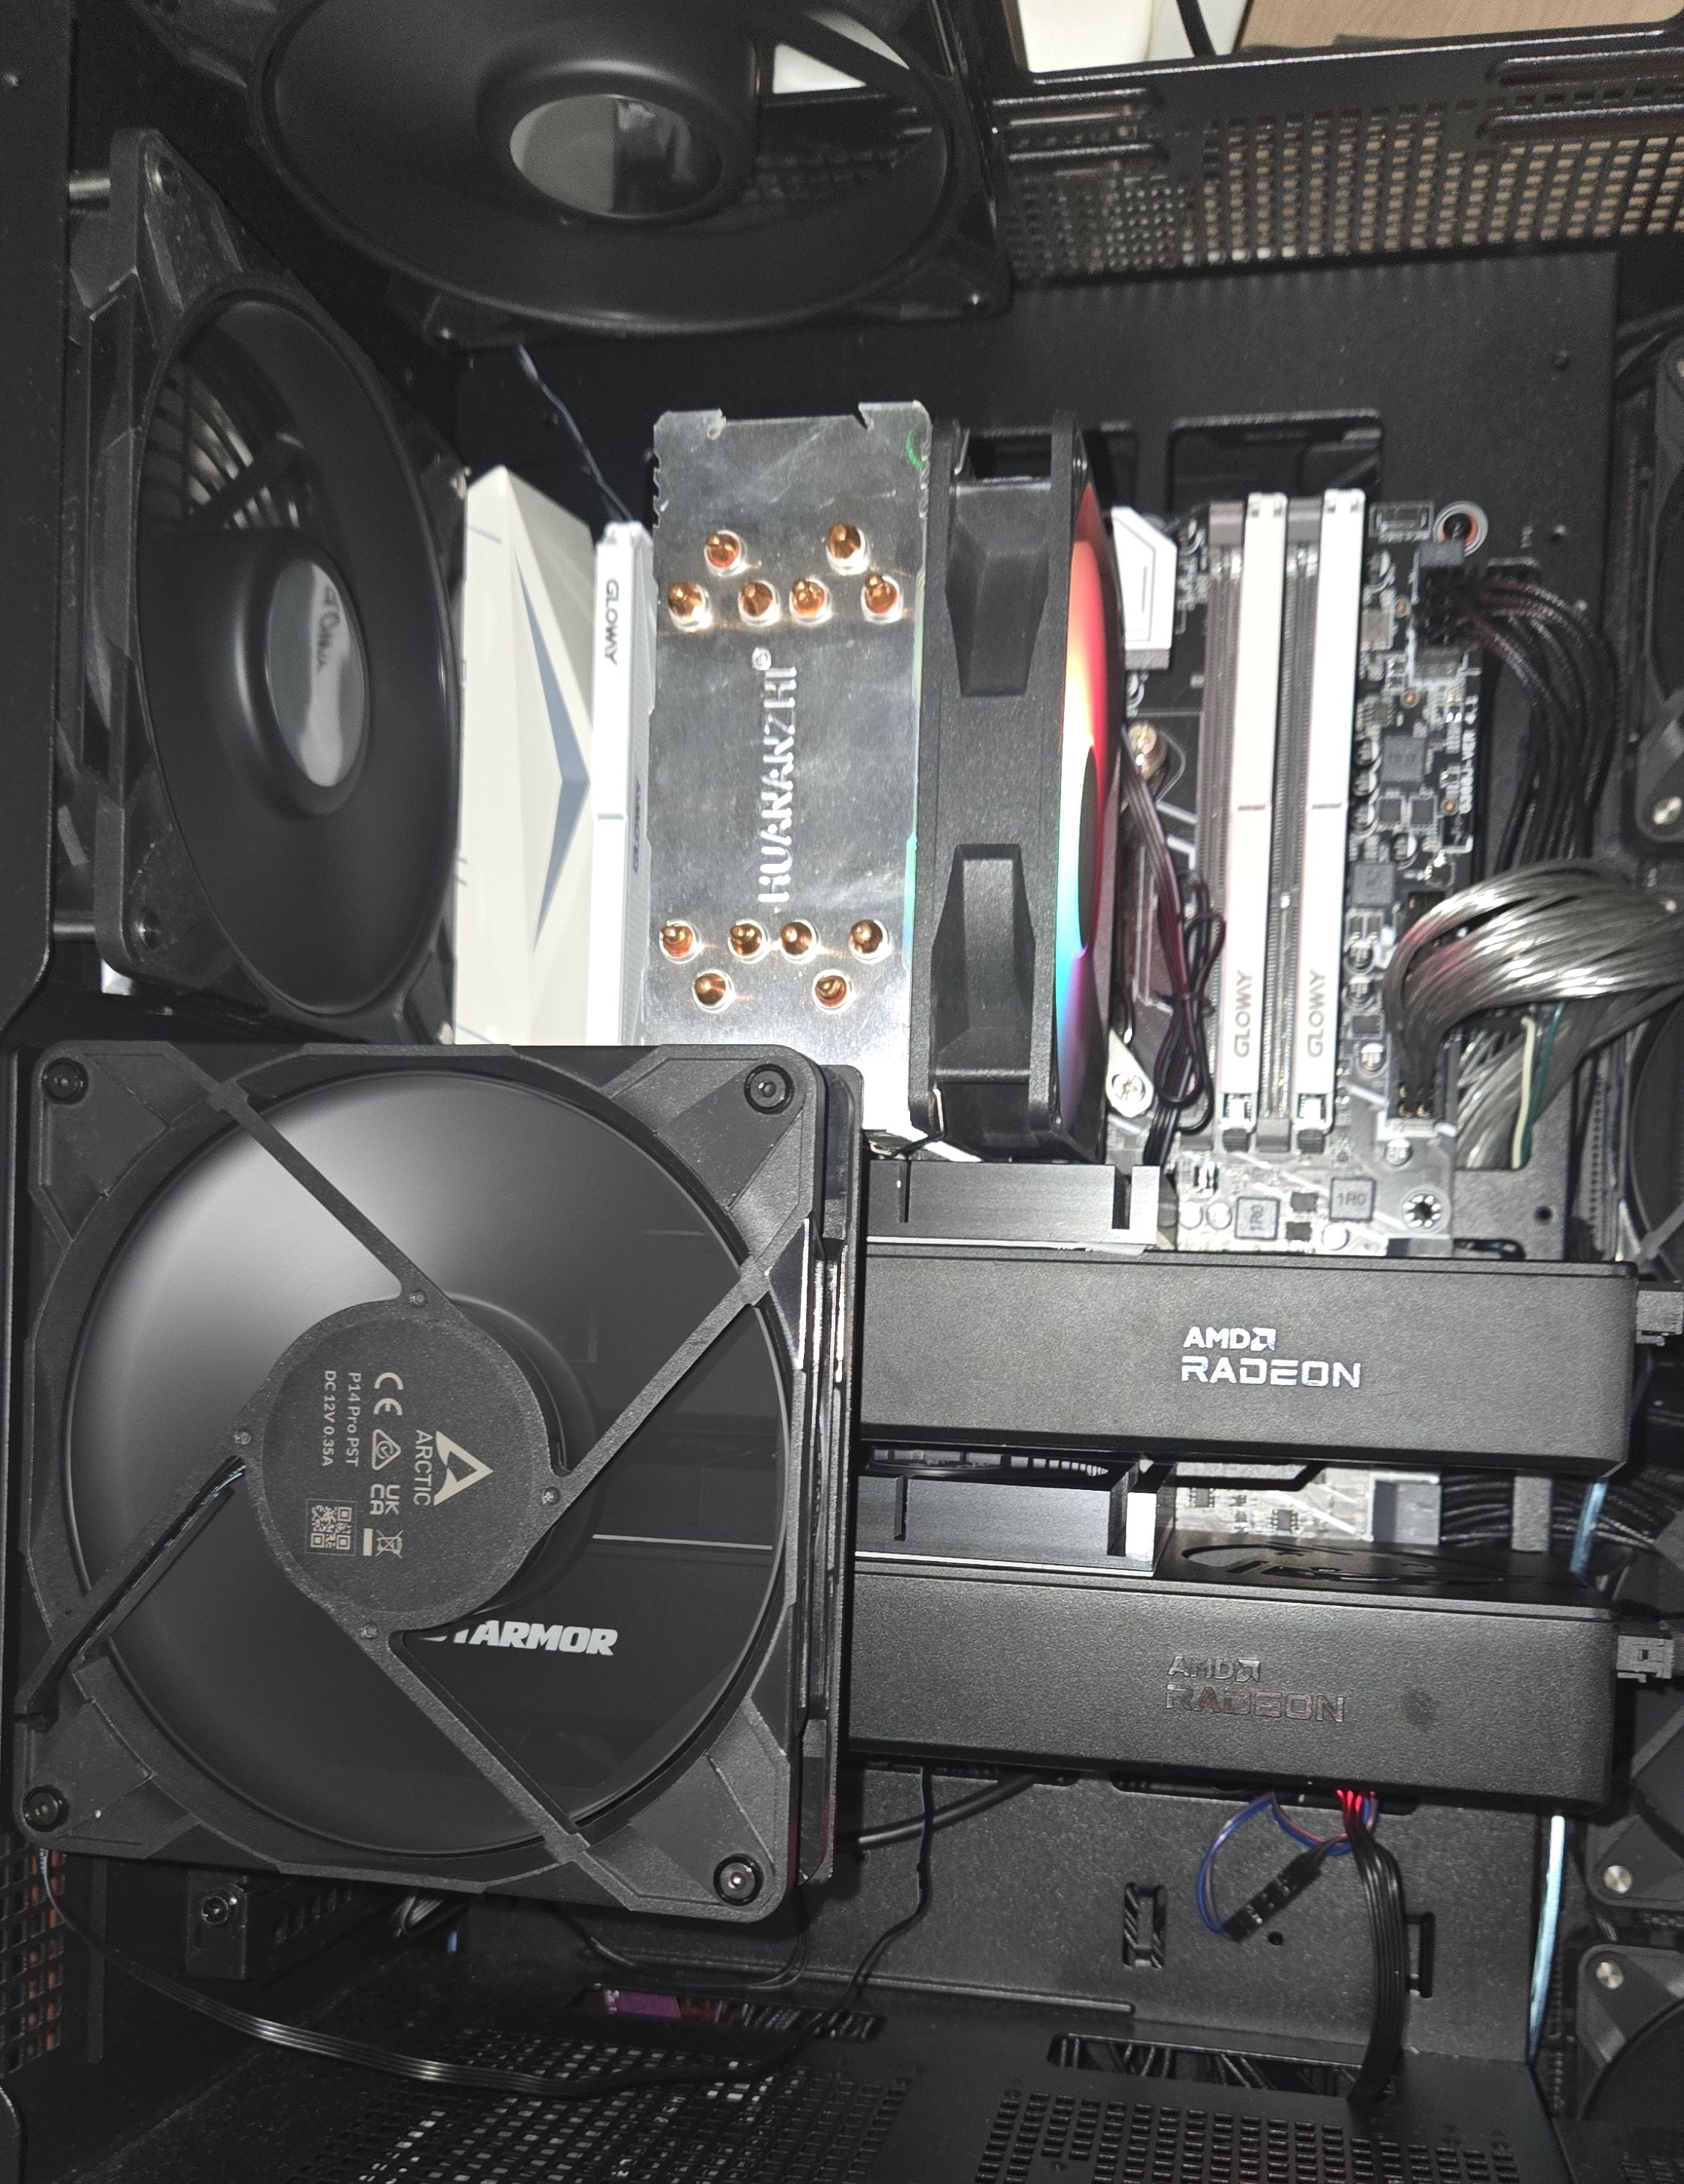
- GPU:2 × AMD Radeon AI PRO R9700 32GB
- 两张 GPU 位于不同 CPU Root Port
- PCIe:Gen3 x16 ×2
- 系统:Ubuntu 24.04 Server
- Kernel:
6.8.12-r9700-p2p-dma44 - RCCL:2.27.7 + P2P level patch
- SGLang:v0.5.18 系列
- 模型:Qwen3.8-27B-AWQ-MTP
- Tensor Parallel:TP=2
P2P / RCCL
项目 实测 GPU0 → GPU1 GFX Push ≈10.29 GB/s GPU1 → GPU0 GFX Push ≈10.29 GB/s DMA / SDMA P2P ≈10.26–10.29 GB/s 双向同时 GFX aggregate ≈19.76 GB/s 双向同时 DMA aggregate ≈19.70 GB/s RCCL SendRecv 1GB ≈9.75 GB/s RCCL AllReduce BusBW ≈9.51 GB/s RCCL AllGather BusBW ≈9.16 GB/s RCCL ReduceScatter BusBW ≈8.92 GB/s 最终日志确认:
isAllDirectP2p 1
via P2P/IPC
不是 SHM。
SGLang + Qwen3.8 Cold Prefill
cached_tokens=0:Context Prefill Throughput TTFT 1K 1566 tok/s 0.654 s 64K 1250 tok/s 52.42 s 96K 1104 tok/s 89.04 s 128K 988 tok/s 132.65 s 192K 816 tok/s 240.90 s 224K 751 tok/s 305.32 s Near256K / 251.5K 712 tok/s 353.35 s Native Decode / MTP
Context Native MTP MTP 相对 Native 1K 31.40 tok/s 44.04 tok/s +40.25% 64K 27.70 tok/s 36.51 tok/s +31.81% 128K 24.79 tok/s 27.47 tok/s +10.81% 192K 22.40 tok/s 25.48 tok/s +13.75% 224K 21.40 tok/s — — Near256K / 251.5K 20.76 tok/s — — 真实 Agent 工作负载
场景 Total Gain Warm Gain 64K Coding Loop +3.31% +18.77% Tool Loop +32.49% +31.39% Mixed Thinking + Code +51.68% — 128K Multi-Turn -4.74% -16.22% 64K / 128K 多轮对话中 Prefix Cache 均正常命中,
REPEATED_FULL_PREFILL = NO。另外,对比 Stock SHM 与 Direct P2P,长上下文 Prefill 提升约:
+30.6% ~ +36.7%TTFT 降低约:
23.4% ~ 26.9%一句话结论
X99 的问题不是“PCIe 3.0 天生不能做双卡 AI 推理”,而是默认软件栈没有替你处理好跨 Root Port P2PDMA、Huge BAR、44-bit DMA 和 RCCL P2P level。
把这些层逐一跑通后,这套双 R9700 可以做到约 10.3GB/s 单向 P2P、约 19.7GB/s 双向聚合,并且能实际转化成 SGLang TP2 的长上下文 Prefill、Decode 和 MTP 收益。
第一部分:直接抄作业
1. 最终稳定配置
BIOS
Above 4G Decoding = ON
Resizable BAR     = ON
CSM               = OFF
Linux / HIP
Ubuntu 24.04 Server
Kernel: 6.8.12-r9700-p2p-dma44
HIP IPC:
export HSA_ENABLE_IPC_MODE_LEGACY=0我的最终稳定配置不需要:
HSA_FORCE_FINE_GRAIN_PCIE=1RCCL
export NCCL_P2P_LEVEL=PHB并使用调整了 P2P level 优先级的 RCCL 2.27.7。
SGLang Native
TP=2
Graph ON
BF16 PV
BF16 KV
num_kv_splits=8
Direct P2P PHB
patched RCCL
MTP
steps=3
top_k=1
draft_tokens=4
RDNA4 Patch065
当前生产路由:
<=192K → MTP_FAST
>192K  → NATIVE_SAFE
2. 推荐验收顺序
不要跳步骤,建议严格按下面顺序:
1. BIOS
   ↓
2. PCIe Topology / Link
   ↓
3. BAR / ReBAR / DMA Address
   ↓
4. Kernel P2PDMA
   ↓
5. HIP IPC
   ↓
6. TransferBench Push
   ↓
7. TransferBench DMA
   ↓
8. Bidirectional TransferBench
   ↓
9. RCCL SendRecv
   ↓
10. RCCL Collectives
   ↓
11. SGLang Direct P2P
   ↓
12. Native Model Benchmark
   ↓
13. Speculative Decode
   ↓
14. Real Agent Workload
核心原则:
先证明底层链路,再证明通信库,再证明推理框架。不要用最终 tok/s 倒推 P2P 是否成功。
3. 每一层的 PASS 标准
层级 我使用的 PASS 标准 PCIe 两张卡均为 Gen3 x16 HIP IPC 双向 IPC handle 可正常 open / access TransferBench Push / DMA 约 9–10GB/s 级 双向 TransferBench aggregate 明显高于单向;我的结果约 19.7GB/s RCCL SendRecv 应尽量逼近 TransferBench;我的结果 9.75 vs 10.29GB/s SGLang isAllDirectP2p 1+via P2P/IPCQwen3.8 Native 251.5K Context 能稳定运行 MTP 1K–192K 相对 Native 保持正收益 如果 TransferBench Push / DMA 只有 2–3GB/s,不建议继续往上层调 RCCL。
4. 最短检查命令
检查 PCIe 链路
sudo lspci -vv -s <GPU_BDF> | grep -E "LnkCap|LnkSta"正常应看到类似:
LnkSta: Speed 8GT/s, Width x16看 PCIe 拓扑
lspci -tv
lspci -nn
建议保存:
lspci -tv > pcie-topology.txt
sudo lspci -vv > lspci-vv.txt
HIP IPC
export HSA_ENABLE_IPC_MODE_LEGACY=0然后分别验证 GPU0 → GPU1 和 GPU1 → GPU0 的 IPC handle 打开与访问。
RCCL
export NCCL_P2P_LEVEL=PHB最终必须从日志确认真正使用 P2P,而不是只看程序成功启动。
第二部分:P2P 是怎么跑通的
5. 先确认:PCIe x16 不等于 GPU P2P 已经可用
我的两张 R9700 都能看到:
LnkSta: Speed 8GT/s, Width x16但它们位于不同 CPU Root Port。
因此真正要解决的是:
- Linux 是否允许跨 Root Port P2PDMA;
- GPU BAR 是否落在 DMA 可以访问的地址范围;
- HIP / RCCL 是否愿意真的使用 Direct P2P;
- 最终 SGLang 是否走
P2P/IPC而不是 SHM。
6. MPS / MRRS:不要先在这里浪费时间
Broadwell 这套平台 Root Port 和 endpoint 的最大 MPS 是 256B。
因此不要照搬某些平台的:
MPS=512
MPS=1024
调优。
另外,即使 Root Port 看到 MRRS 128B,也不能直接得出“GPU DMA 只能低速”的结论。
我的实测最终仍然有:
DMA / SDMA P2P ≈10.26–10.29 GB/s
7. 第一个核心问题:Huge BAR + 44-bit DMA
开启 Above 4G / ReBAR 后,R9700 会获得很大的 BAR。
我的环境中曾出现约:
56 TiB区域的 BAR 映射。
而相关 DMA 路径存在约:
44-bit DMA addressability44-bit 可直接表示的地址空间约为:
16 TiB这会导致一种非常迷惑的状态:
CPU 能访问 BAR
GPU 枚举正常
ReBAR 正常
PCIe x16 正常
但另一张 GPU 的 DMA engine 无法正确访问该 BAR 地址
所以:
lspci看起来一切正常,不等于 GPU P2P 就已经正常。
8. 第二个核心问题:Linux 跨 Root Port P2PDMA
Linux P2PDMA 会根据:
- provider
- client
- PCI bridge
- Root Port
- topology
判断 P2P 是否允许。
我的 Broadwell Root Port 属于:
8086:6f00最终使用的自定义内核:
6.8.12-r9700-p2p-dma44主要处理两个问题:
- Broadwell
8086:6f00跨 Root Port P2PDMA; - Huge BAR + 44-bit DMA 地址限制。
这里不建议使用“所有跨 Root Port 一律允许”的暴力 patch。
更合理的方式是只针对已经确认、已经实测通过的拓扑处理。
9. 内核通过后先测 HIP IPC
不要直接进入 RCCL。
测试逻辑应该是:
GPU0 分配显存
↓
生成 IPC handle
↓
GPU1 打开
↓
GPU1 访问
然后反方向再做一次。
我的环境:
export HSA_ENABLE_IPC_MODE_LEGACY=0双向 HIP IPC 通过以后,才继续做 TransferBench。
10. TransferBench:底层 P2P 的关键验收
至少应该分别看:
- GFX Push
- GFX Pull
- DMA / SDMA
- 双向同时传输
GFX Push
GPU0 -> GPU1 ≈10.29 GB/s
GPU1 -> GPU0 ≈10.29 GB/s
DMA / SDMA
≈10.26–10.29 GB/s这两项正常后,才能比较有把握地说:
跨 Root Port Direct P2P 数据路径已经跑通。
GFX Pull
我的结果:
GPU1 read GPU0 ≈3.13–3.16 GB/s
GPU0 read GPU1 ≈1.46–1.49 GB/s
Pull 明显比 Push 慢,而且有方向差异。
但因为 Push、DMA、RCCL 最终都正常,所以:
不要只看 GFX Pull 就判断 P2P 是否成功。
双向同时传输
GFX simultaneous bidirectional ≈19.759 GB/s aggregate
DMA simultaneous bidirectional ≈19.701 GB/s aggregate
这证明两个方向可以同时接近 10GB/s,并不是“双卡共享一个总共 10GB/s 的瓶颈”。
11. TransferBench 正常,但 Stock RCCL 仍然慢
最初 Stock RCCL:
SendRecv 1GB ≈6.90 GB/s明显低于:
TransferBench Push ≈10.29 GB/s继续查日志后发现,RCCL 并没有按预期走跨 Root Port Direct P2P,而是退到了类似:
SHM / direct / direct这一步非常关键:
底层 PCIe P2P 已经跑通,不代表 RCCL 一定会选择 P2P。
12. RCCL 2.27.7:Intel P2P level 覆盖问题
最终问题定位到 RCCL 的路径选择逻辑。
我在:
src/graph/paths.cc调整了 Intel 默认 P2P level 和:
ncclGetUserP2pLevel的处理顺序。
核心原则:
用户显式设置的
NCCL_P2P_LEVEL应该最后生效,而不是再被平台默认值覆盖。然后:
export NCCL_P2P_LEVEL=PHB这里需要强调:
Patch +
NCCL_P2P_LEVEL=PHB两者都需要。
13. RCCL 最终验收
修复后:
SendRecv 1GB ≈9.75 GB/s其他 collective:
AllReduce BusBW     ≈9.51 GB/s

AllGather AlgBW     ≈18.31 GB/s
AllGather BusBW     ≈9.16 GB/s

ReduceScatter AlgBW ≈17.83 GB/s
ReduceScatter BusBW ≈8.92 GB/s
TransferBench Push ≈10.29GB/s,RCCL SendRecv ≈9.75GB/s:
9.75 / 10.29 ≈94.7%测试期间:
AER error = 0
DMAR error = 0
GPU reset = 0
到这里我才把底层 P2P 标记为真正通过。
14. 最后一层:SGLang 必须确认不是 SHM
TP=2能启动,不代表 Direct P2P 已经工作。最终必须确认日志:
isAllDirectP2p 1
via P2P/IPC
如果仍然看到 SHM,那么模型虽然能跑,但并没有进入前面验证好的 Direct P2P 路径。
第三部分:跑通 P2P 后,Qwen3.8 实际能到什么水平
15. Qwen3.8 测试配置
SGLang v0.5.18
Qwen3.8-27B-AWQ-MTP
TP=2
Dual R9700 32GB
Direct P2P PHB
patched RCCL
Graph ON
BF16 PV ON
BF16 KV
num_kv_splits=8
16. Cold Prefill
cached_tokens=0:Context Prefill Throughput TTFT 1K 1566 tok/s 0.654 s 64K 1250 tok/s 52.42 s 96K 1104 tok/s 89.04 s 128K 988 tok/s 132.65 s 192K 816 tok/s 240.90 s 224K 751 tok/s 305.32 s Near256K / 251,500 tokens 712 tok/s 353.35 s Near256K 单卡 Peak VRAM:
≈28.1 GB / 31.9 GB余量约:
3.8 GB/card因此这套 X99 + 双 R9700 可以实际运行约 251.5K Context。
17. Direct P2P 对长上下文 Prefill 的收益
做过:
Stock SHM
vs
Direct P2P
对照。
长上下文 Prefill:
+30.6% ~ +36.7%TTFT:
降低约 23.4% ~ 26.9%所以 P2P 并不是只让通信 benchmark 好看,而是会直接影响长 Prompt 和 Agent 第一轮 TTFT。
18. Native Decode
最终 Native:
Context Decode TPOT 1K 31.40 tok/s ≈31.85 ms 64K 27.70 tok/s 36.10 ms 128K 24.79 tok/s 40.34 ms 192K 22.40 tok/s ≈44.67 ms 224K 21.40 tok/s ≈46.73 ms Near256K / 251.5K 20.76 tok/s 48.17 ms Near256K 多轮:
CV ≈0.074%
19. MTP Decode
最终 MTP:
steps=3
top_k=1
draft_tokens=4
RDNA4 Patch065
Context Native MTP 提升 1K 31.40 44.04 tok/s +40.25% 64K 27.70 36.51 tok/s +31.81% 128K 24.79 27.47 tok/s +10.81% 192K 22.40 25.48 tok/s +13.75% 64K:
accepted length ≈3.07
speculative cycle ≈83.81 ms
break-even ≈110.68 ms
当前 BF16 KV MTP 配置:
max_total_num_tokens ≈203,558因此生产路由选择:
<=192K → MTP_FAST
>192K  → NATIVE_SAFE
当前首先限制 MTP 深度的是 BF16 KV Token Pool,而不是 192K 已经出现性能 crossover。
20. 真实 Agent 工作负载
Coding Loop:64K Prefix,3 Turns
Cold 首轮完整 Prefill,后续 Radix Cache 命中:
TTFT 从约55s降到约1~2s结果:
Total Gain = +3.31%
Warm Gain  = +18.77%
Tool Loop:3 Turns
流程:
Tool Call
→ Tool Result
→ 下一次 Tool Call
→ Final JSON
Correctness 全部通过:
Total Gain = +32.49%
Warm Gain  = +31.39%
Mixed Thinking + Code
MTP    = 51.9 tok/s
Native = 31.5 tok/s
任务总耗时:
+51.68%同时通过:
<think> 正常闭合
Python compile PASS
行为测试 PASS
128K Multi-Turn
D1 Cold TTFT:
≈133~139sD2 / D3:
≈2~3s确认:
REPEATED_FULL_PREFILL = NO这一组 wall-clock:
Total Gain = -4.74%
Warm Gain  = -16.22%
主要原因是某轮 MTP 生成了明显更长的 Thinking / 输出,而不是 Prefix Cache 失效或 Decode tok/s 低于 Native。
第四部分:P2P 跑通以后做的性能优化
这一部分不是“跑通 P2P”的必要步骤。如果你的目标只是让双卡 Direct P2P 正常工作,到上一部分已经完成。下面是继续优化 Qwen3.8 时的结果。
21. BF16 P×V
Full Attention 的 P×V 改成:
BF16 WMMA
+
FP32 accumulator
以后,192K Full Attention Stage1:
54.01 ms
↓
12.85 ms
192K Native Decode:
11.83 tok/s
↓
22.42 tok/s
224K:
10.71 tok/s
↓
21.41 tok/s
说明在 RDNA4 上,软件 kernel 路径本身也可能是非常大的瓶颈。
22. num_kv_splits:8 vs 64
192K:
splits=8  → 22.42 tok/s
splits=64 → 22.43 tok/s
差异:
+0.045%Stage1:
12.92 ms
vs
12.94 ms
所以最终继续使用:
num_kv_splits=8
23. FP8 KV:更像容量模式,不是默认性能模式
192K:
BF16 KV → 22.41 tok/s
FP8 KV  → 23.12 tok/s
提升:
+3.17%Token Pool:
BF16 → 261,096
FP8  → 520,145
几乎翻倍。
但 192K Prefill TTFT:
BF16 → 239.7s
FP8  → 335.6s
恶化约:
+40%所以当前:
BF16 KV 用作默认性能模式,FP8 KV 只保留为超长上下文 / 容量模式候选。
24. 为什么 MTP 一开始很慢,以及 Patch065 的作用
Qwen3.8 自带 MTP Head。
一开始直接跑 MTP,64K:
Native ≈27.7 tok/s
错误 verify 路径只有个位数 tok/s
后来定位到 gfx1201 上 Target Verify 走了低效的:
extend_attention_fwd最终采用 RDNA4 split-KV tree verify(Patch065)。
核心调度思路:
KV Head + split
+
GRP × Draft Tokens
让同一组 GQA Q heads 共享 KV tile,避免重复读取 Prefix KV。
最终才得到前面列出的 1K–192K MTP 正收益。
第五部分:常见误区
25. 不要把 MPS 强行改到 512 / 1024
Broadwell 这里最大就是 256B。
26. 不要只看 GFX Pull
我的 Pull 只有约 1.5~3.2GB/s,但:
Push ≈10.29GB/s
DMA  ≈10.28GB/s
RCCL ≈9.75GB/s
最终都正常。
27.
hipMemcpyPeer成功不等于高速 Direct P2P必须实际测吞吐。
28. 不要只跑 RCCL
如果 RCCL 慢,应先通过 TransferBench 判断问题究竟在:
- PCIe
- Kernel / P2PDMA
- HIP IPC
- RCCL
哪一层。
29. TP=2 能启动不代表 Direct P2P 已经成功
SHM 同样可以让 TP 工作。
最后一定要确认:
isAllDirectP2p 1
via P2P/IPC
30. 社区参数不要机械照搬
例如:
num_kv_splits=64在我这套 Qwen3.8 + BF16 PV 上几乎没有收益。
Speculative Decode 也一样:一定要确认真正使用的 verify path,否则很容易把一个本来有正收益的 MTP 跑成负优化。
第六部分:最终结论
这套机器最终证明:
X99 / Broadwell
+
E5-2697A v4
+
PCIe Gen3 x16 ×2
+
双 Radeon AI PRO R9700 32GB
可以做到:
单向 GPU P2P      ≈10.3GB/s
双向 aggregate    ≈19.7GB/s
RCCL SendRecv     ≈9.75GB/s
在 SGLang + Qwen3.8-27B 中:
Cold Prefill 128K ≈988 tok/s
Cold Prefill 251.5K ≈712 tok/s

Native Near256K ≈20.76 tok/s

MTP 64K  ≈36.51 tok/s
MTP 192K ≈25.48 tok/s
并且 64K / 128K Agent 多轮 Prefix Cache 能稳定复用。
所以如果手里已经有 X99 / Xeon E5 v4:
不要因为“PCIe 3.0”几个字就先入为主地认为必须换平台。
先按照:
Topology
→ DMA Address
→ P2PDMA
→ HIP IPC
→ TransferBench
→ RCCL
→ SGLang
→ Model Benchmark
把每一层分别验证清楚。
如果 TransferBench 已经可以跑到接近链路的实际有效能力,而 RCCL 或模型仍然慢,那么问题大概率已经不在 PCIe 本身,而是在上层通信或 kernel 路径。
-
,
P PhoenixRise2026 引用了 此主题
-
这份作业含金量很高。跨 Root Port 直连 P2P 能在 X99 / Broadwell-EP 上跑通,卡点基本就是你说的那几处(Above 4G、44-bit DMA、P2PDMA、RCCL PHB);能拿到
isAllDirectP2p 1 via P2P/IPC就说明不是 SHM 兜底,后面都是调优问题。几个对表口径:
1)单向 10.29 GB/s 合理:Gen3 x16 理论约 15.75 GB/s,P2P/NTB 实跑一般落 9–12 GB/s;双向 aggregate 19.76 接近 2×10.29 的线性,看不出明显半双工瓶颈。
2)RCCL busBW 9.5 GB/s 已经贴着链路,TP=2 的 AllReduce 是带宽限制,不是拓扑没起来。batch=1 场景多为延迟敏感,建议再补一张「通信暴露占比 vs batch」的曲线,确认放大 batch 后扩展比是否还线性。
3)MTP 收益随 ctx 衰减(1K +40% → 128K +10.8%)在预期内:长 ctx 时 decode 由 KV 读带宽主导,draft 头那点算力占比被稀释。建议把 acceptance length 和 draft head 耗时占比一起画,区分是接受率掉了、还是 draft 头变贵了。
4)最该记的运维坑:这套依赖自定义内核(44-bit DMA patch)。内核一升级,P2PDMA 路径可能静默失效、退回 host-staged——不报错,只是变慢。建议把复验固化成三步:内核版本 / rocminfo → grep isAllDirectP2p → rccl-tests busBW 对基线;数值掉一半就说明 P2P 没起来。
补充观察:251.5K native decode 20.76 t/s,这档 KV 体积已经很大,双 32G 能扛住说明 KV 量化/分层确实起作用;再往上加 ctx 前,先量 KV 实际占用和换页,再谈 MTP。
-
更正一下原帖里的一个表述:
我之前写“不同 CPU Root Port”不够准确。我的机器是单路 E5-2697A v4,两张 R9700 都挂在同一颗 CPU / 同一 PCIe Root Complex 下,只是分别接在不同的 PCIe Root Port 上。
所以文中“跨 Root Port P2P”应理解为:
同一 CPU、同一 Root Complex 下,不同 Root Port 之间的 P2P,并不是跨 CPU / 跨 Socket。
原帖已不能编辑,这里补充更正,避免误导。 -
,
 T terry 固定了此主题
-
谢谢老特肯定。打通P2P和调试SGLang的过程都是Agent来操作的,包括内核编译、遇到问题寻找解决方法。5.5小时双卡几乎满功率推理测试,没有出现问题。
-
,T terry 引用了 此主题
-
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
-
@suboyang
精度差不了一半,估计也就百分之几吧。按你这个算法,原始精度32位量化到Q4就没法用了,事实上Q4也可以保留差不多95%以上的有用信息。而且真要是干啥大活,跑云端不是更靠谱么,本地模型毕竟是本地。 -
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
Paiton 单卡确实很强,这个后面有时间我也会测。
我这篇主要验证的是 X99 双 R9700 的 P2P 可行性和双卡 scaling,SGLang 只是目前先跑通的 serving stack。现在这些 PP/TG 数据主要看单卡→双卡提升,不是在做 SGLang vs vLLM 横评。
后续会补 vLLM/Paiton,同模型同参数下再比较。 -
对啊,2%不到的差距没啥可担心的,Agent时代验收一下就可以了,也就可能是有时候需要多做个一步两步的。我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。
@fcme 弟人家这个帖子是的关键是速度吗?人家是打通P2P,第一这是个人实验项目,刚刚开始,以后还可以优化。解决的是有无问题,是原创,就算纯粹从炫技的角度来看,也很有意义。它不是我发现了某个插件,某个方案很牛逼,这种技能很多人都能掌握,并不特别值得炫耀。
第二,PP在有SGLang的情况下,影响并不那么大,Agent场景只做增量Prefill,并不会一直做如此大的Prefill工作,所以可以接受。还是有应用价值的,不是所有场景都看测试数据的。
第三,这个方案对24G的7900XTX意义很大,它没有mxfp4的红利,可以抄作业,只要用上SGLang,双卡TP的意义在过往的帖子中有过大量测试,很有意义。
第四,VLLM有它的强项,也有弱项,Agent上它就是不如SGLang,不如NInfer,HaloGen,它没有硬核增量缓存计算,更没有跨会话缓存复用,并不是数字好看,体验就好的。
第五,对VLLM的用户而言,在X99上打通P2P难道没意义?你怎么知道人家不会vLLM呢?论坛藏龙卧虎,低调交流。不能总学我,有点知识就吹牛逼,我都被打脸太多次,不太在乎了,不要学我。谦虚使人进步,骄傲使人落后。
-
,
S suboyang 引用了 此主题
-
,
张 张光璞 引用了 此主题
-
,T terry 引用了 此主题

 站长已核:本帖设为精华,作者 +5 积分奖励,希望再接再厉!