跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战

X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战

已定时 已固定 已锁定 已移动 精华 热议 AI硬件
r9700x99多卡部署
64 帖子 14 发布者 2.3k 浏览 7 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT terry

    @fcme 弟人家这个帖子是的关键是速度吗?人家是打通P2P,第一这是个人实验项目,刚刚开始,以后还可以优化。解决的是有无问题,是原创,就算纯粹从炫技的角度来看,也很有意义。它不是我发现了某个插件,某个方案很牛逼,这种技能很多人都能掌握,并不特别值得炫耀。
    第二,PP在有SGLang的情况下,影响并不那么大,Agent场景只做增量Prefill,并不会一直做如此大的Prefill工作,所以可以接受。还是有应用价值的,不是所有场景都看测试数据的。
    第三,这个方案对24G的7900XTX意义很大,它没有mxfp4的红利,可以抄作业,只要用上SGLang,双卡TP的意义在过往的帖子中有过大量测试,很有意义。
    第四,VLLM有它的强项,也有弱项,Agent上它就是不如SGLang,不如NInfer,HaloGen,它没有硬核增量缓存计算,更没有跨会话缓存复用,并不是数字好看,体验就好的。
    第五,对VLLM的用户而言,在X99上打通P2P难道没意义?你怎么知道人家不会vLLM呢?

    论坛藏龙卧虎,低调交流。不能总学我,有点知识就吹牛逼,我都被打脸太多次,不太在乎了。谦虚使人进步,骄傲使人落后。

    fcmeF
    fcmeF
    fcme
    超凡大师
    编写于 最后由 编辑
    #21

    @terry
    这我完全同意,sglang对amd的支持始终就挺屎的。
    牛人太多了,要是有人能完全搞定AMD民用卡在sglang上面的生态那就太牛了,加油。

    terryT suboyangS 2 条回复 最后回复
    0
    • fcmeF fcme

      @terry
      这我完全同意,sglang对amd的支持始终就挺屎的。
      牛人太多了,要是有人能完全搞定AMD民用卡在sglang上面的生态那就太牛了,加油。

      terryT
      terryT
      terry
      超级版主
      编写于 最后由 terry 编辑
      #22

      @fcme 很多人都搞起来了,双7900XTX 4路并发长上下文都跑了,这对AMD用户太重要了。现在就是DDR4平台的板子太贵,大家想要解决X99这样的DDR3平台双卡TP的问题,这真的是非常重要。

      油管:https://www.youtube.com/@抡锤者

      fcmeF 1 条回复 最后回复
      0
      • terryT terry

        @fcme 很多人都搞起来了,双7900XTX 4路并发长上下文都跑了,这对AMD用户太重要了。现在就是DDR4平台的板子太贵,大家想要解决X99这样的DDR3平台双卡TP的问题,这真的是非常重要。

        fcmeF
        fcmeF
        fcme
        超凡大师
        编写于 最后由 编辑
        #23

        @terry
        DDR3太老了,需要更多的折腾是可预期的一个事情。我记得你之前视频里也不推荐大家搞双卡,问题太多了,何况DDR3的老平台。
        从钱的角度说9700的32G对于90%本地玩家来说都够了,尤其是你最近视频里也说AMD生态有点支棱起来了。都是1万左右,单卡9700明显比7900XTX双卡容易折腾,当然双卡48G的大显存池对于多开的场景还是有绝对优势的。牛人们加油,我们等着抄作业吧😂

        1 条回复 最后回复
        0
        • fcmeF fcme

          对啊,2%不到的差距没啥可担心的,Agent时代验收一下就可以了,也就可能是有时候需要多做个一步两步的。我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。

          kos orK
          kos orK
          kos or
          超凡大师
          编写于 最后由 编辑
          #24

          @fcme said:

          我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。

          謝謝分享, 還沒研究到這一個層面, 有沒有可能 Hermes這種AIO多功能型的Agent system prompt, skills, memory.md, user.md 在一開始注入太多上下文
          而降低了hermes agent的開發效率?

          1 条回复 最后回复
          0
          • 张光璞张 张光璞

            我已经跑起来了,4并发160k ,现在单会话在58t/s 双会话 就是55 x 2

            suboyangS
            suboyangS
            suboyang
            劳动模范
            编写于 最后由 suboyang 编辑
            #25

            @张光璞 双路吗?58t/s 有点慢

            张光璞张 1 条回复 最后回复
            0
            • fcmeF fcme

              @terry
              这我完全同意,sglang对amd的支持始终就挺屎的。
              牛人太多了,要是有人能完全搞定AMD民用卡在sglang上面的生态那就太牛了,加油。

              suboyangS
              suboyangS
              suboyang
              劳动模范
              编写于 最后由 编辑
              #26

              @fcme

              现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。

              张光璞张 1 条回复 最后回复
              0
              • suboyangS suboyang

                @fcme

                现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。

                张光璞张
                张光璞张
                张光璞
                技术大牛 劳动模范
                编写于 最后由 编辑
                #27

                @suboyang 说:

                @fcme

                现在最大的问题是,Qwen3.8-27B-MXFP4 这类模型,我还没有看到双卡 R9700 可以稳定100t/s 以上的,尤其是250K上下文的测试,如果在250K 还能保持80~100t/s,本地模型部署才有意义,要不然干活太慢了,这个时间等不起。

                MXFP4 单9700 能跑在80~90 t/s 很稳定。

                1 条回复 最后回复
                0
                • suboyangS suboyang

                  @张光璞 双路吗?58t/s 有点慢

                  张光璞张
                  张光璞张
                  张光璞
                  技术大牛 劳动模范
                  编写于 最后由 编辑
                  #28

                  @suboyang 说:

                  @张光璞 双路吗?58t/s 有点慢

                  现双R9700 单流58 双并发100多。

                  suboyangS 1 条回复 最后回复
                  0
                  • 张光璞张 张光璞

                    @suboyang 说:

                    @张光璞 双路吗?58t/s 有点慢

                    现双R9700 单流58 双并发100多。

                    suboyangS
                    suboyangS
                    suboyang
                    劳动模范
                    编写于 最后由 suboyang 编辑
                    #29

                    @张光璞
                    MXFP4 这个模型 双卡吗?双卡 MXFP4 单流58 ?

                    如果MXFP4 单9700 能跑在80~90 t/s 很稳定。 那么双卡至少150t/s ,双卡的方案才成立。

                    张光璞张 1 条回复 最后回复
                    0
                    • suboyangS suboyang

                      @张光璞
                      MXFP4 这个模型 双卡吗?双卡 MXFP4 单流58 ?

                      如果MXFP4 单9700 能跑在80~90 t/s 很稳定。 那么双卡至少150t/s ,双卡的方案才成立。

                      张光璞张
                      张光璞张
                      张光璞
                      技术大牛 劳动模范
                      编写于 最后由 编辑
                      #30

                      @suboyang 说:

                      @张光璞
                      MXFP4 这个模型 双卡吗?双卡 MXFP4 单流58 ?

                      现在感觉双卡更多的是高并发

                      suboyangS 1 条回复 最后回复
                      0
                      • 张光璞张 张光璞

                        @suboyang 说:

                        @张光璞
                        MXFP4 这个模型 双卡吗?双卡 MXFP4 单流58 ?

                        现在感觉双卡更多的是高并发

                        suboyangS
                        suboyangS
                        suboyang
                        劳动模范
                        编写于 最后由 suboyang 编辑
                        #31

                        @张光璞

                        双卡性能最大的问题就在这。我是用本地模型写过代码,58t/s 这个速度我最后是放弃了。这个时间根本等不起,一个脚本的输出,很多需要1小时以上。换成deepseek大模型10分钟搞定。

                        如果在长上下文,双卡单流58t/s,那折腾双卡TP意义就不大。这也是我一直不敢搞的原因,双卡TP必须有绝对性能优势单流 150t/s 以上,做这个方案才可以真的干活。

                        Deepseek 是250t/s, 本地模型速度虽然不能完全去比,但是至少得有50%的效率,才有折腾的意义。做项目,本地模型双卡TP如果需要5倍以上的时间,那意义不大。

                        L 1 条回复 最后回复
                        0
                        • suboyangS suboyang

                          @张光璞

                          双卡性能最大的问题就在这。我是用本地模型写过代码,58t/s 这个速度我最后是放弃了。这个时间根本等不起,一个脚本的输出,很多需要1小时以上。换成deepseek大模型10分钟搞定。

                          如果在长上下文,双卡单流58t/s,那折腾双卡TP意义就不大。这也是我一直不敢搞的原因,双卡TP必须有绝对性能优势单流 150t/s 以上,做这个方案才可以真的干活。

                          Deepseek 是250t/s, 本地模型速度虽然不能完全去比,但是至少得有50%的效率,才有折腾的意义。做项目,本地模型双卡TP如果需要5倍以上的时间,那意义不大。

                          L
                          L
                          laobenxiong
                          德高望重 劳动模范
                          编写于 最后由 编辑
                          #32

                          @suboyang 说:

                          @张光璞

                          双卡性能最大的问题就在这。我是用本地模型写过代码,58t/s 这个速度我最后是放弃了。这个时间根本等不起,一个脚本的输出,很多需要1小时以上。换成deepseek大模型10分钟搞定。

                          如果在长上下文,双卡单流58t/s,那折腾双卡TP意义就不大。这也是我一直不敢搞的原因,双卡TP必须有绝对性能优势单流 150t/s 以上,做这个方案才可以真的干活。

                          Deepseek 是250t/s, 本地模型速度虽然不能完全去比,但是至少得有50%的效率,才有折腾的意义。做项目,本地模型双卡TP如果需要5倍以上的时间,那意义不大。

                          确实. 只能把一些优先级比较低的任务, 而且边界/需求描述的比较明确的任务, 在睡觉前交给它, 第二天起床再看看结果. 不过现在线上模型价格好像也没那么贵, 所以就有点尴尬了.

                          对不能上外网的场景, 一般都是正式的工作内容, 还是有那么一点点意义; 不过既然是正式的工作内容, 太慢了对老板来讲也是不划算的;

                          对于爱折腾的人来讲, 就是一个不断学习的过程...能达到这一个目标就很好了. 呵呵

                          suboyangS kos orK 2 条回复 最后回复
                          0
                          • L laobenxiong

                            @suboyang 说:

                            @张光璞

                            双卡性能最大的问题就在这。我是用本地模型写过代码,58t/s 这个速度我最后是放弃了。这个时间根本等不起,一个脚本的输出,很多需要1小时以上。换成deepseek大模型10分钟搞定。

                            如果在长上下文,双卡单流58t/s,那折腾双卡TP意义就不大。这也是我一直不敢搞的原因,双卡TP必须有绝对性能优势单流 150t/s 以上,做这个方案才可以真的干活。

                            Deepseek 是250t/s, 本地模型速度虽然不能完全去比,但是至少得有50%的效率,才有折腾的意义。做项目,本地模型双卡TP如果需要5倍以上的时间,那意义不大。

                            确实. 只能把一些优先级比较低的任务, 而且边界/需求描述的比较明确的任务, 在睡觉前交给它, 第二天起床再看看结果. 不过现在线上模型价格好像也没那么贵, 所以就有点尴尬了.

                            对不能上外网的场景, 一般都是正式的工作内容, 还是有那么一点点意义; 不过既然是正式的工作内容, 太慢了对老板来讲也是不划算的;

                            对于爱折腾的人来讲, 就是一个不断学习的过程...能达到这一个目标就很好了. 呵呵

                            suboyangS
                            suboyangS
                            suboyang
                            劳动模范
                            编写于 最后由 suboyang 编辑
                            #33

                            @laobenxiong

                            对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                            不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                            L 1 条回复 最后回复
                            0
                            • suboyangS suboyang

                              @laobenxiong

                              对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                              不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                              L
                              L
                              laobenxiong
                              德高望重 劳动模范
                              编写于 最后由 编辑
                              #34

                              @suboyang 说:

                              @laobenxiong

                              对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                              不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                              现在出行很方便, 共享单车,公交,出租,高铁,飞机...都可以选择. 这也不妨碍自己买小车/电驴/自行车...个人折腾个本地小模型, 就算给自己捣鼓一辆单车玩玩吧.

                              suboyangS 张光璞张 2 条回复 最后回复
                              0
                              • L laobenxiong

                                @suboyang 说:

                                @张光璞

                                双卡性能最大的问题就在这。我是用本地模型写过代码,58t/s 这个速度我最后是放弃了。这个时间根本等不起,一个脚本的输出,很多需要1小时以上。换成deepseek大模型10分钟搞定。

                                如果在长上下文,双卡单流58t/s,那折腾双卡TP意义就不大。这也是我一直不敢搞的原因,双卡TP必须有绝对性能优势单流 150t/s 以上,做这个方案才可以真的干活。

                                Deepseek 是250t/s, 本地模型速度虽然不能完全去比,但是至少得有50%的效率,才有折腾的意义。做项目,本地模型双卡TP如果需要5倍以上的时间,那意义不大。

                                确实. 只能把一些优先级比较低的任务, 而且边界/需求描述的比较明确的任务, 在睡觉前交给它, 第二天起床再看看结果. 不过现在线上模型价格好像也没那么贵, 所以就有点尴尬了.

                                对不能上外网的场景, 一般都是正式的工作内容, 还是有那么一点点意义; 不过既然是正式的工作内容, 太慢了对老板来讲也是不划算的;

                                对于爱折腾的人来讲, 就是一个不断学习的过程...能达到这一个目标就很好了. 呵呵

                                kos orK
                                kos orK
                                kos or
                                超凡大师
                                编写于 最后由 编辑
                                #35

                                @laobenxiong said:

                                不过现在线上模型价格好像也没那么贵, 所以就有点尴尬了.

                                我Codex Luna Max 每個月20美元方案 根本用不完

                                1 条回复 最后回复
                                0
                                • L laobenxiong

                                  @suboyang 说:

                                  @laobenxiong

                                  对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                                  不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                                  现在出行很方便, 共享单车,公交,出租,高铁,飞机...都可以选择. 这也不妨碍自己买小车/电驴/自行车...个人折腾个本地小模型, 就算给自己捣鼓一辆单车玩玩吧.

                                  suboyangS
                                  suboyangS
                                  suboyang
                                  劳动模范
                                  编写于 最后由 编辑
                                  #36

                                  @laobenxiong

                                  这一套下来30000起步,可不是单车成本哦

                                  1 条回复 最后回复
                                  -1
                                  • L laobenxiong

                                    @suboyang 说:

                                    @laobenxiong

                                    对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                                    不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                                    现在出行很方便, 共享单车,公交,出租,高铁,飞机...都可以选择. 这也不妨碍自己买小车/电驴/自行车...个人折腾个本地小模型, 就算给自己捣鼓一辆单车玩玩吧.

                                    张光璞张
                                    张光璞张
                                    张光璞
                                    技术大牛 劳动模范
                                    编写于 最后由 编辑
                                    #37

                                    @laobenxiong 说:

                                    @suboyang 说:

                                    @laobenxiong

                                    对,本地模型要能普及,先不提智商程度,必须是真的可以让本地模型的使用者,有一个较为流畅的体验,如果只是跑起来,意义不大。

                                    不过用R9700做做图还行,但是如果这样的话,还不如直接买7900xtx.

                                    现在出行很方便, 共享单车,公交,出租,高铁,飞机...都可以选择. 这也不妨碍自己买小车/电驴/自行车...个人折腾个本地小模型, 就算给自己捣鼓一辆单车玩玩吧.

                                    免费的自行车蹬起来不心疼

                                    1 条回复 最后回复
                                    0
                                    • A
                                      A
                                      applejuice
                                      技术大牛 劳动模范
                                      编写于 最后由 编辑
                                      #38

                                      @suboyang 用线上模型怎样都比本地模型值得

                                      suboyangS 1 条回复 最后回复
                                      0
                                      • A applejuice

                                        @suboyang 用线上模型怎样都比本地模型值得

                                        suboyangS
                                        suboyangS
                                        suboyang
                                        劳动模范
                                        编写于 最后由 suboyang 编辑
                                        #39

                                        @applejuice 说:

                                        线上模型怎样都比本地模型值得

                                        不谈comfyUI 和其他语音视频生成模型这类模型。

                                        本地模型的重要性:

                                        第一,如果纯编程,是那种逻辑很清晰的情况下,下线模型qwen3.8-27B是可以做大量工作的,并且可以反复测试demo脚本。

                                        第二,本地模型最大的优势是可以弥补API焦虑。例如,有一次去客户现场,我把agent 登录到问题服务器检查问题。事后,我想简单问题还好,如果用量大了,token限流了怎么办?这个时候有个本地模型作为补充,就安心很多了。但是前提是本地模型首先速度得跟得上,
                                        100 token/s 以下基本就做不了这样的工作了。

                                        第三,本地模型几乎没有限制,很多渗透爬虫的工作,线上模型有安全模块,不给你做。只有本地模型可以做,而且比较私密。

                                        第四,很多股票分析,大量数据分析那种算MA均线,画量化图那种,你写好pipeline,一个job就十几万token。 线上模型几天就用完了。

                                        当然,所有前提是本地模式的速度得跟得上,准确率可以慢慢等。我现在经常处于这样的状态:
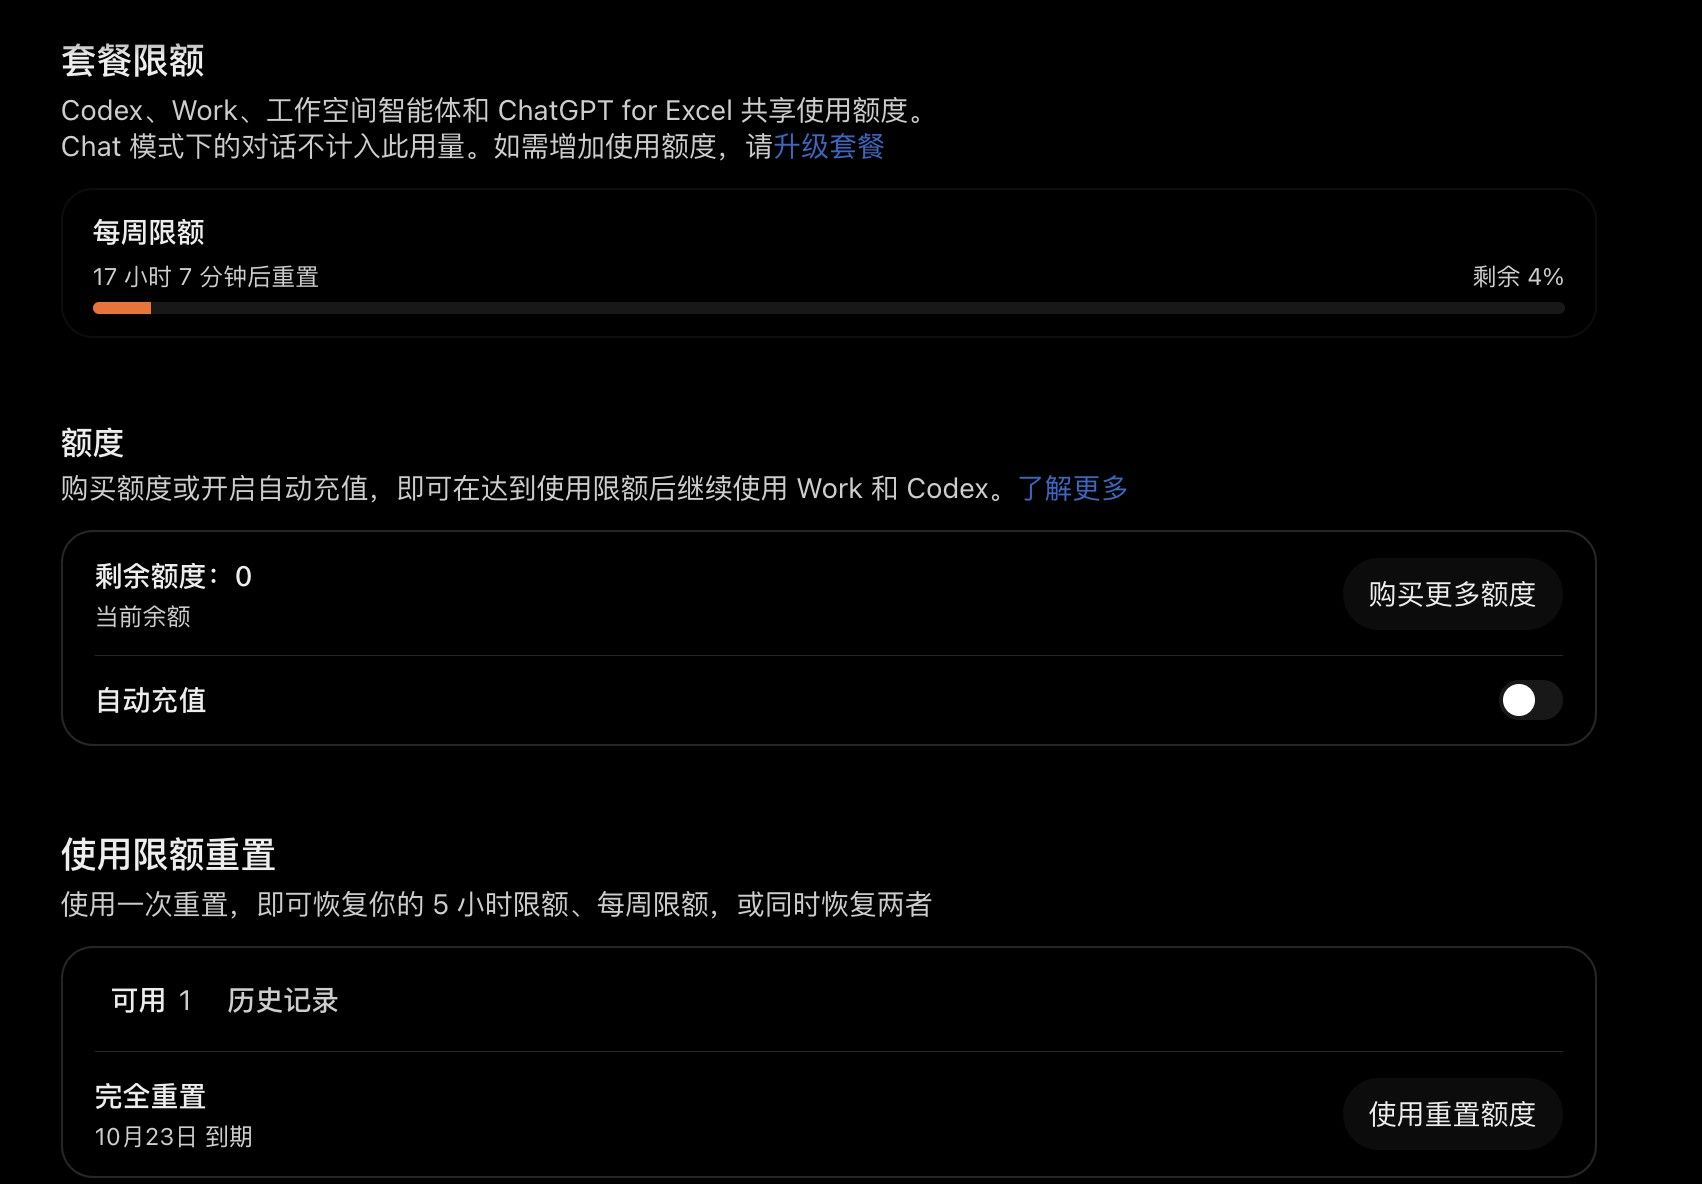
                                        image.jpeg

                                        A 1 条回复 最后回复
                                        0
                                        • PhoenixRise2026P PhoenixRise2026

                                          @fcme 说:

                                          但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
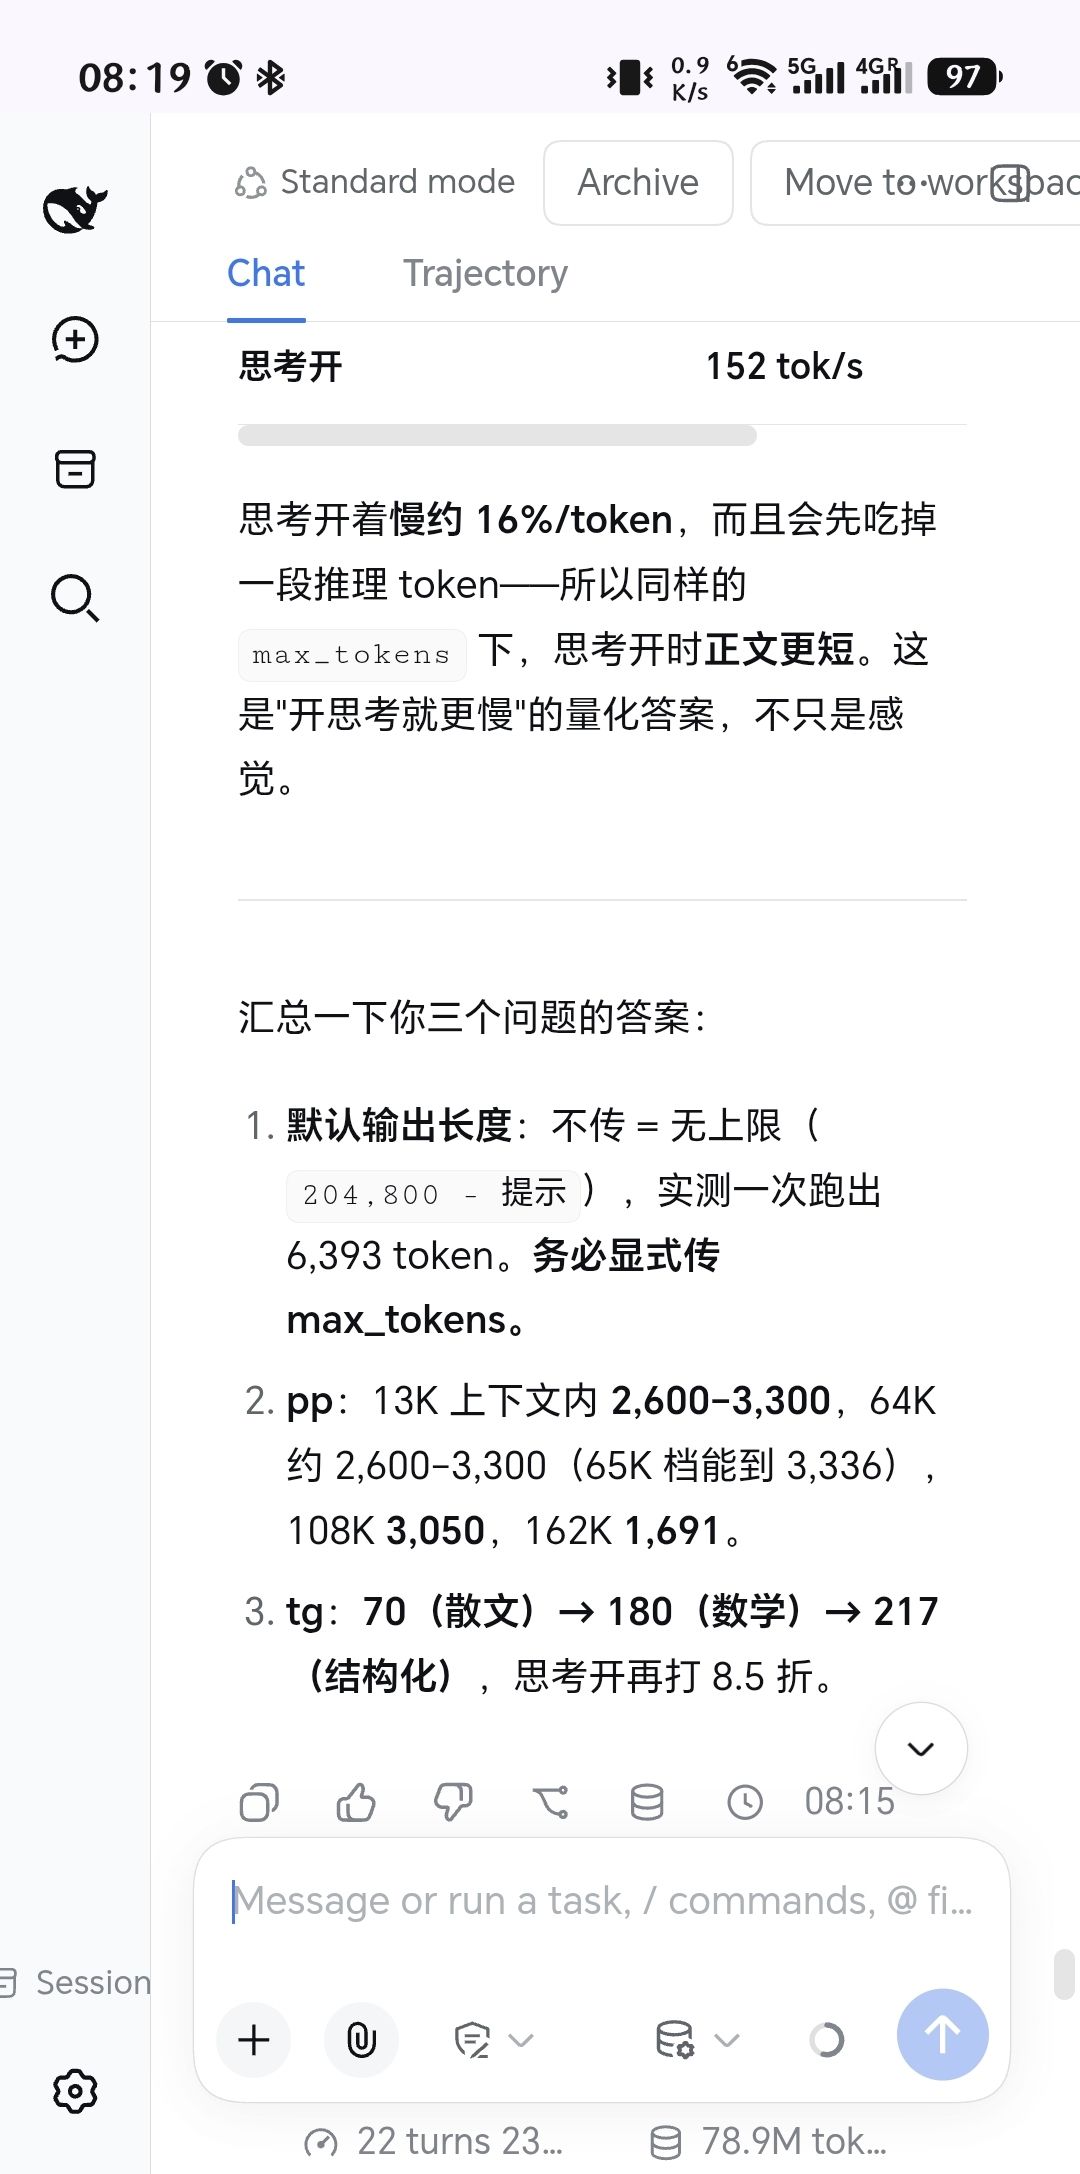
                                          Screenshot_20260925_081952_com_android_chrome_ChromeTabbedActivity.jpg

                                          Paiton 单卡确实很强,这个后面有时间我也会测。
                                          我这篇主要验证的是 X99 双 R9700 的 P2P 可行性和双卡 scaling,SGLang 只是目前先跑通的 serving stack。现在这些 PP/TG 数据主要看单卡→双卡提升,不是在做 SGLang vs vLLM 横评。
                                          后续会补 vLLM/Paiton,同模型同参数下再比较。

                                          fcmeF
                                          fcmeF
                                          fcme
                                          超凡大师
                                          编写于 最后由 编辑
                                          #40

                                          @PhoenixRise2026
                                          又看了一遍这个帖子,老哥牛逼了。看来RDNA4的驱动你在sglang里面搞定了,就像版主说的,由于SGlang优秀的缓存机制,其实pp这一块重要性没有那么高,那你可以考虑把dflash2给加进去吗?这样的话,这个蛋疼的tg速度就可以解决了。SGlang本身是支持的。
                                          你要是把这个也搞定的话,那你基本上功德无量了😃😂

                                          suboyangS PhoenixRise2026P 2 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组

