
【直播】4卡R9700从采购到调试
-
那个帖是《T7910 双卡本地推理全记录》:https://lcz.me/topic/1941 。严格说阶段一不是"速度不行":TP=2 已经跑到约 100 tok/s(W4A16 GPTQ + EAGLE MTP-3),把它打掉的是第 6 分钟一条卡死请求 → device lost from bus,驱动复位 8 次全失败。换 R9700 后解决的核心是「大 BAR + P2P」,即稳定性与卡间通信,不只是速度。
和卡型号确实有关,但要拆成三条,别只归给「新一代更快」:
-
BAR / P2P(最直接、也最"卡型号"的一条):7900 XTX 的 VBIOS 开机只申请 256MB BAR,那台机器拿不到大 BAR → 没有 P2P,跨卡只能退回 NCCL,还经过 PCIe 交换机 4 跳 Gen2;R9700 默认申请大 BAR,作者再给自编内核的 p2pdma 白名单加一行,32GB BAR + P2P 一次打通,卡间带宽 2.39 → 10.26 GB/s。这是固件/代际差异,不是算力差异。
-
算子路径:gfx1201(RDNA4)有 FP8/W4A8(fp8 WMMA)和成熟的 MXFP4 路径,gfx1100(RDNA3)没有 FP8。Name-Error 说的方向对,但它主要影响量化模型的 prefill,不是掉总线的根因。
-
平台/拓扑也是变量:阶段一 7900 XTX 挂交换机下游,阶段二 R9700 插 CPU 直连槽;作者自己也声明两阶段的模型/量化/框架/prompt 全变,速度数字不可直接比。
所以不能简单下结论「双 7900 XTX 速度不行、双 R9700 行」。要在你自己机器上定值:同平台同槽位、同模型同量化同框架,只换卡;先看大 BAR 与 P2P(AMD 用 rocm-smi --showtopo / hipDeviceCanAccessPeer,N 卡用 nvidia-smi topo -m),再谈速度。
-
-
-
-
@张光璞 细说?
我感觉要就大显存150-200gb vram
不然也只是跑27b 有点浪费而且4x r9700 成本是几倍跳
-
@张光璞 细说?
我感觉要就大显存150-200gb vram
不然也只是跑27b 有点浪费而且4x r9700 成本是几倍跳
Q4的模型智力也就这样了。 我自己量化的Q8 模型双卡48g 显存只有80K上下文还要并发共享 。这没法用。
-
-
-
-
@Thanaots 应该不会比5000 pro 72gb 强
但是我这里1张rtx 5000 pro 72gb 可以买6张
如果我有钱当然选5000pro
但是我连买两张r9700 都舍不得 -
其实我一直很好奇pcie5 跑p2p 跟pcie4/3 跑 p2p 会差多少?
如果你入手了刚好可以跟网友分享的对比下了据我跟ai 了解
2张卡
如果单人用 pcie 4/5 decode prefill 几乎没影响
多人使用decode 也大概在少过10% 的差距 这样4张卡
Decode 多人使用大概10-15%
Prefill 单人 多人都在10-15%我感觉2张卡pcie4 完全能够个人玩家是用
pcie3 对比pcie5 就差点点 2 张卡都差10%
4张卡并行 不是普通玩家了 机箱散热都是另一个等级的跳跃当然以上讲着 r9700 或是 rtx5 series支持pcie5的显卡
这个我能给你个我用VLLM-OMNI测试H3跑视频的参考数据:
864×480、124 帧、24 fps、约 5.175 秒、20 步
TP2/U1,无 P2P(PCIE5X8)195.134 秒 (2卡)
TP2/U1,有 P2P 131.458 秒(2卡)
TP4/U1,有 P2P 91.836 秒(4卡)
TP2/U2,有 P2P 78.205 秒(4卡)我先买的Z890平台双卡怎么都没法成功P2P,然后加了两张卡买了16000多的PCIE5交换机。。。。。。
-
这个我能给你个我用VLLM-OMNI测试H3跑视频的参考数据:
864×480、124 帧、24 fps、约 5.175 秒、20 步
TP2/U1,无 P2P(PCIE5X8)195.134 秒 (2卡)
TP2/U1,有 P2P 131.458 秒(2卡)
TP4/U1,有 P2P 91.836 秒(4卡)
TP2/U2,有 P2P 78.205 秒(4卡)我先买的Z890平台双卡怎么都没法成功P2P,然后加了两张卡买了16000多的PCIE5交换机。。。。。。
@Kevin-Hyderich 什么卡? 16000 交换机... 买块全新主板+ddr5 都没那么贵吧
-
-
@Kevin-Hyderich 什么卡? 16000 交换机... 买块全新主板+ddr5 都没那么贵吧
@applejuice R9700,开始打算双卡的就买了Z890 270plus套装,后面又加的,不划算,这么一整套折腾下来可以买一张PRO 5000 72G了。。。。。
-
@applejuice R9700,开始打算双卡的就买了Z890 270plus套装,后面又加的,不划算,这么一整套折腾下来可以买一张PRO 5000 72G了。。。。。
-
@Kevin-Hyderich 省钱是花钱的开始
@applejuice 所以说一步到位最省钱,哈哈,不过也体验到了各种折腾的乐趣,当时交换机和A卡兼容不好我还扛着电脑跑到他们厂里去一起调了一天。。。。我这个支持5张卡,安慰自己说以后换卡还能用吧

-
-
-
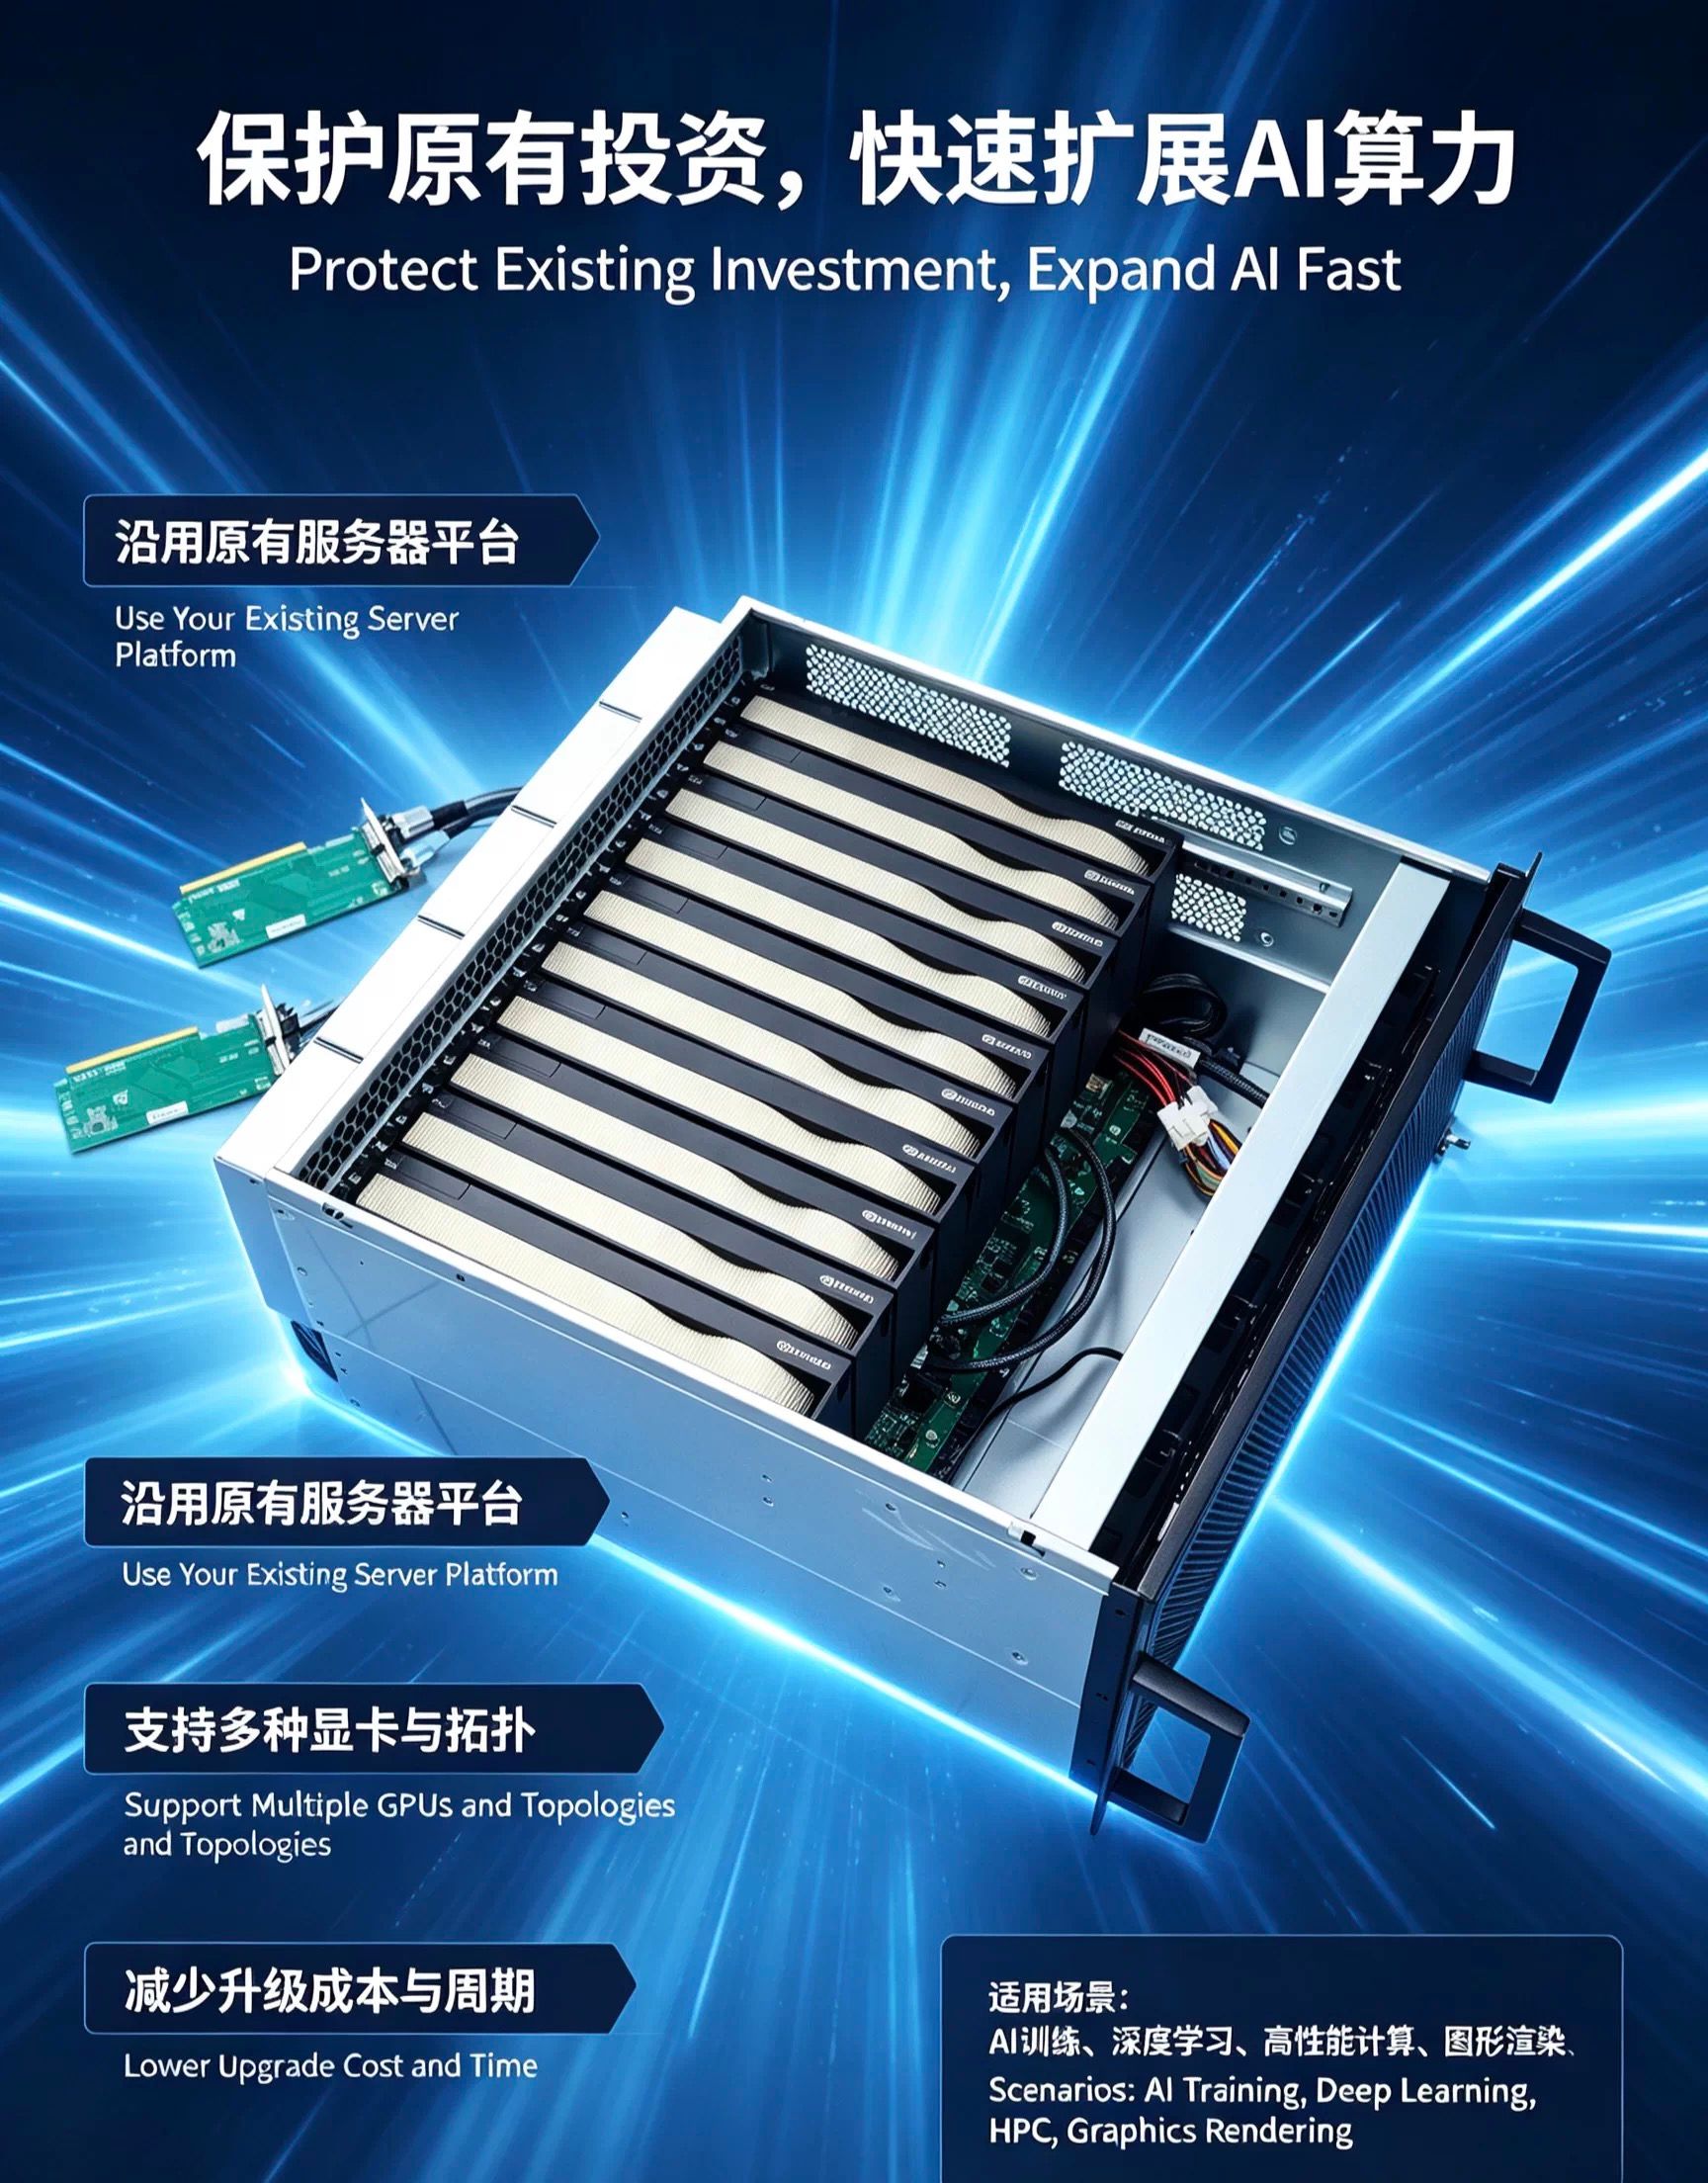
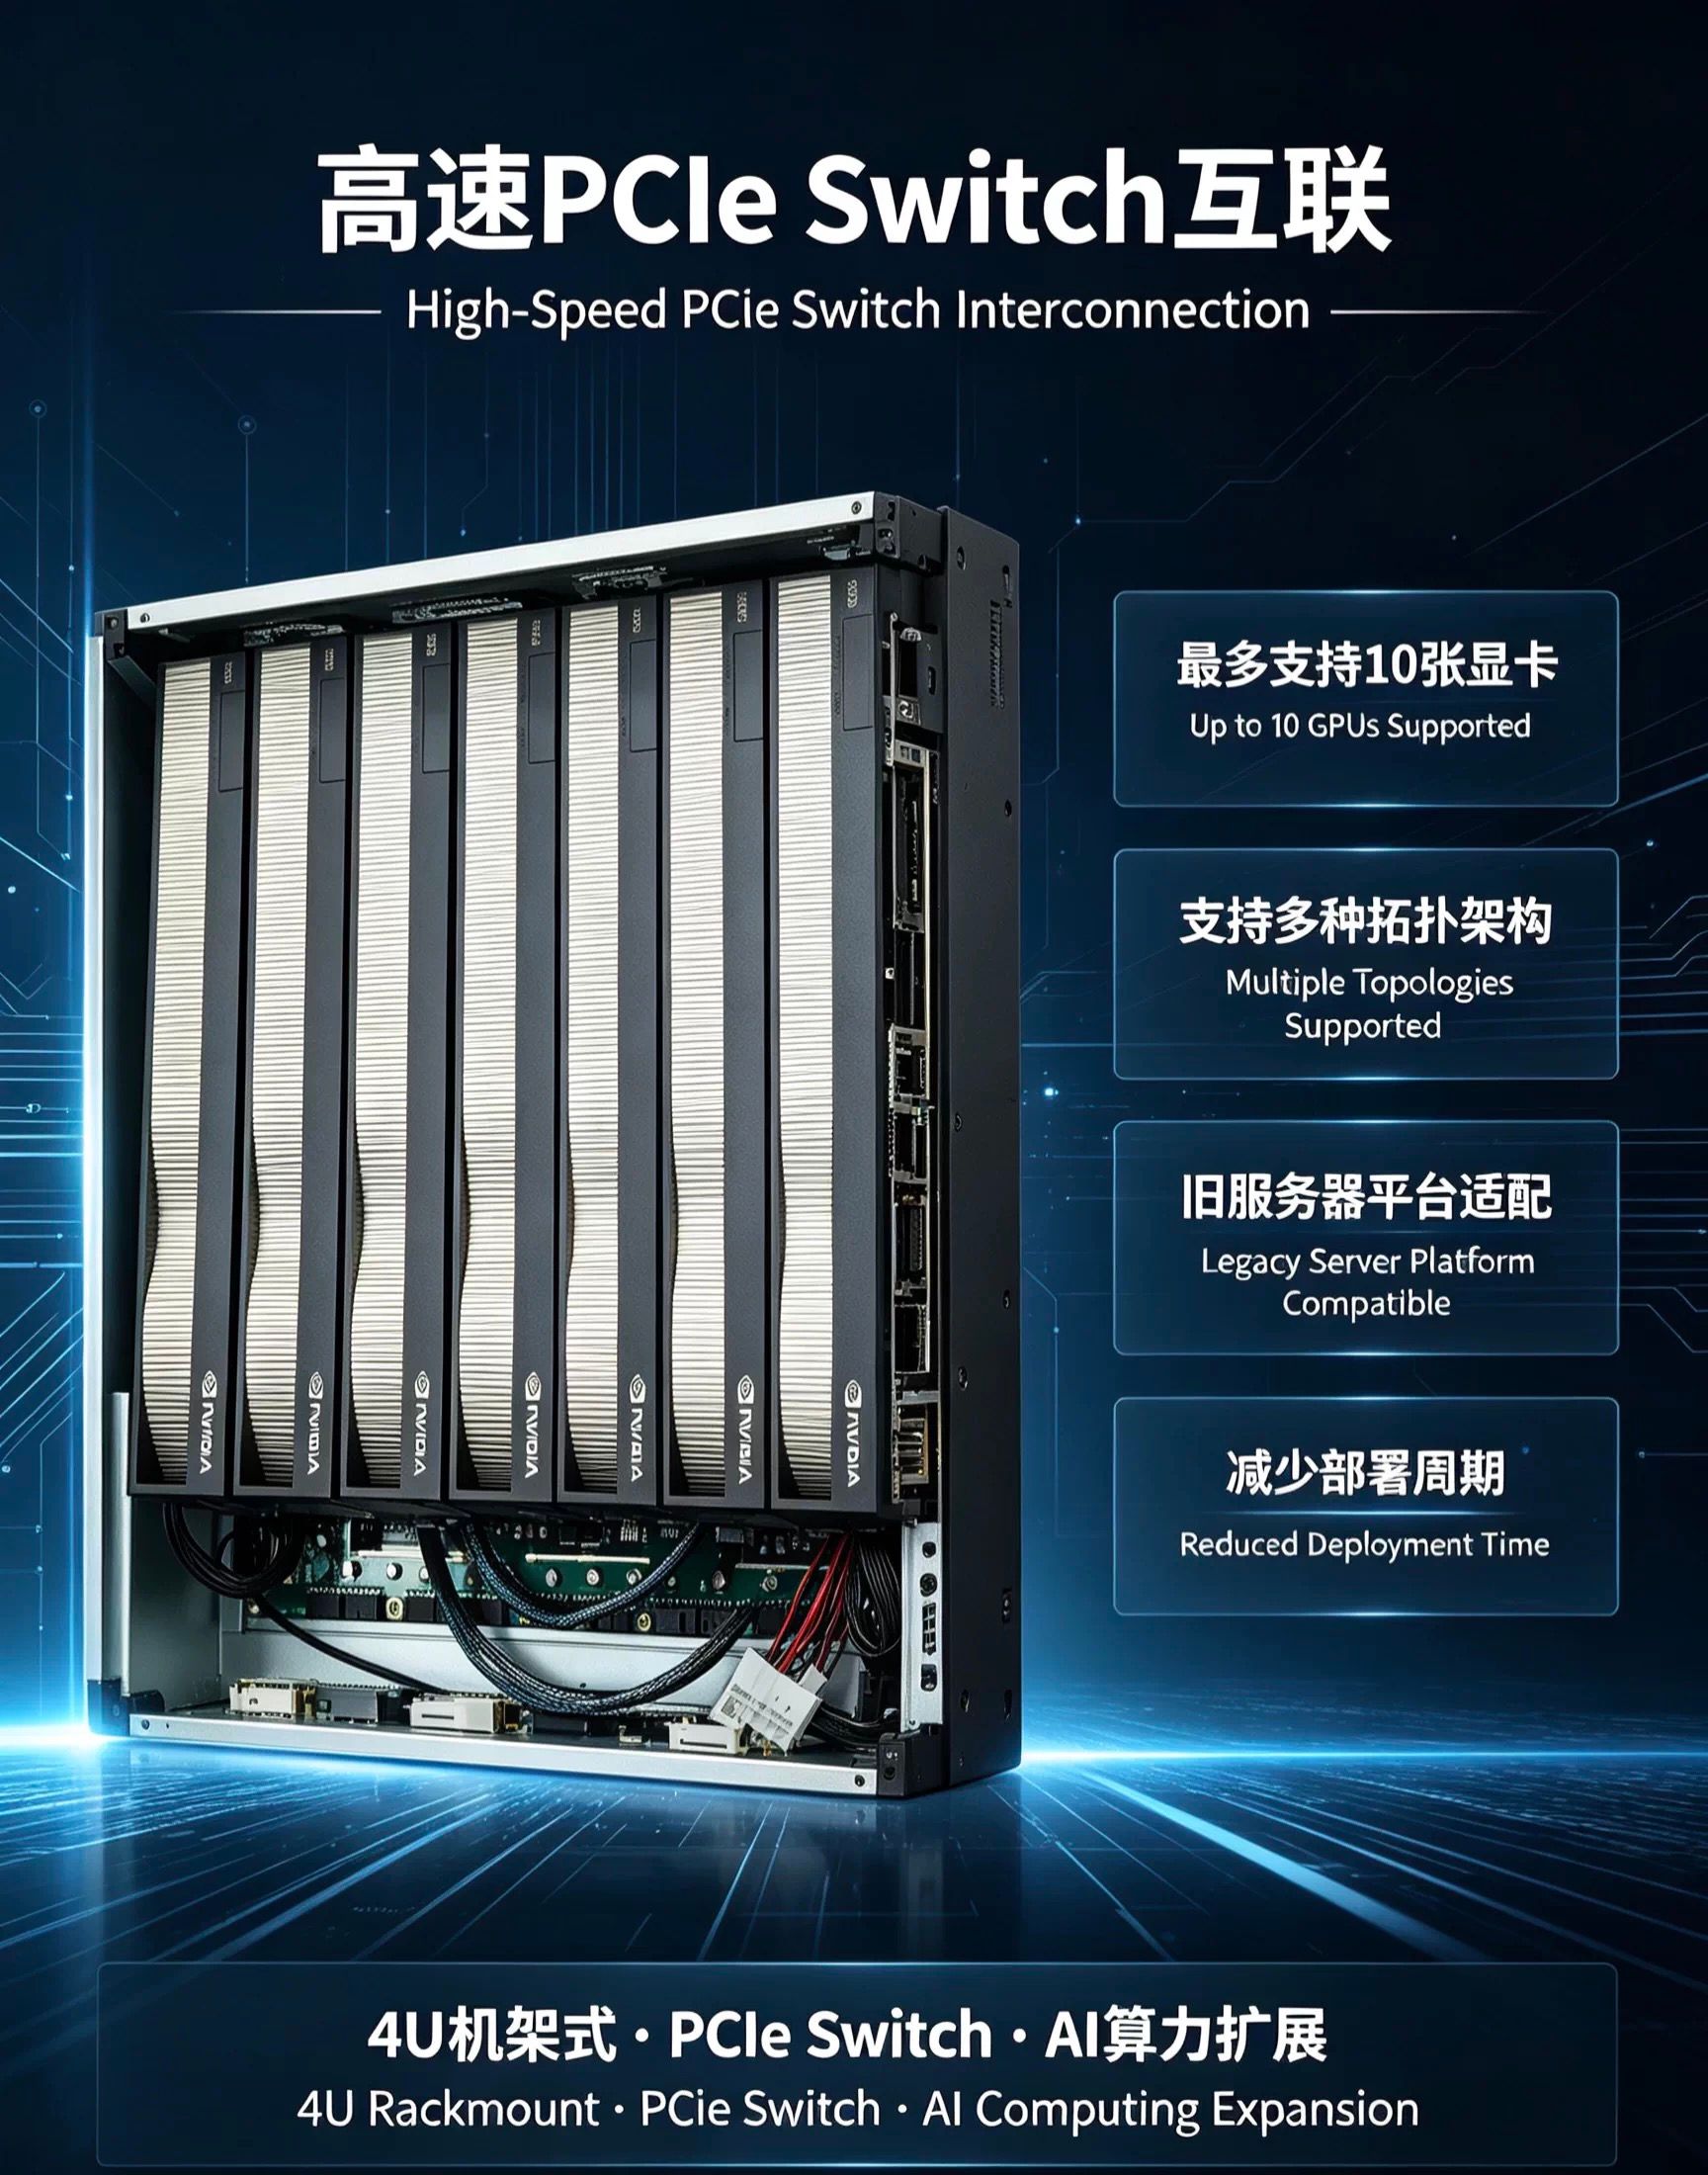
我在淘宝上有看到 pcie5.0x16 的外置显卡坞,好厉害,17000一个,
-
@张光璞 7900XTX 显存速度虽然快,而且便宜【现在也涨价了,3000多能买到我觉得还行】,但是可能真没有r9700好,因为不支持fp8啊,这个因素好像还是不能忽视。
我用朋友电脑混插 7900xtx 和 r9700 简单尝试了张量并行运算,并不理想。混插并不适合运行同一个模型。
-
@张光璞 7900XTX 显存速度虽然快,而且便宜【现在也涨价了,3000多能买到我觉得还行】,但是可能真没有r9700好,因为不支持fp8啊,这个因素好像还是不能忽视。
我用朋友电脑混插 7900xtx 和 r9700 简单尝试了张量并行运算,并不理想。混插并不适合运行同一个模型。
我是想把7900xtx 换掉
@张光璞 pro5000 不可能比 4张 r9700 强。
4张 r9700 虽然麻烦了点,空间、电源、散热更复杂,价格上 4张 r9700 是 ¥42400。
美国 9 月底实时低价下,4× R9700 比 1× RTX PRO 5000 48GB 便宜约 21%;
r9700 多卡不是线性 4 倍。公开 4 卡 R9700 测试里,8B 模型 TP1→TP2 约 1.7 倍,TP2→TP4 基本不再增长;14B 模型 TP2→TP4 约 1.4 倍。四卡提升主要来自容量和多并发,不是单用户延迟。
我觉得要跑 100GB 级显存模型,且接受 Linux/ROCm/多卡维护:4× R9700
如果不买2张以上的 pro5500,我都不会碰 n卡了。不想当冤大头。毕竟本地模型带来的经济效益无法支撑采购更多的 n 卡。
r9700够了。




