
老 X99 + 双 R9700 实测:Gen3 ×16 原生 P2P、BetterBench 182 t/s,还值得升 Gen4.0 Gen 5.0 吗?
-
看到这篇双 R9700、Z690、PCIe 5.0 ×8 的 Qwen3.8-27B 测试后,我想弄清一件事:我的旧 X99 平台,两张卡都是主机侧 PCIe 3.0 ×16,到底被 PCIe 拖慢了多少?是否值得为此换主板和 CPU?下面是 2026 年 10 月 12 日的本机实测。先说结论:这套 Gen3 机器已达到参考文章的性能量级,目前不建议只为 PCIe 换平台。这不是 Gen5 对照实测,也不是长期生产验收。
实机与推理配置
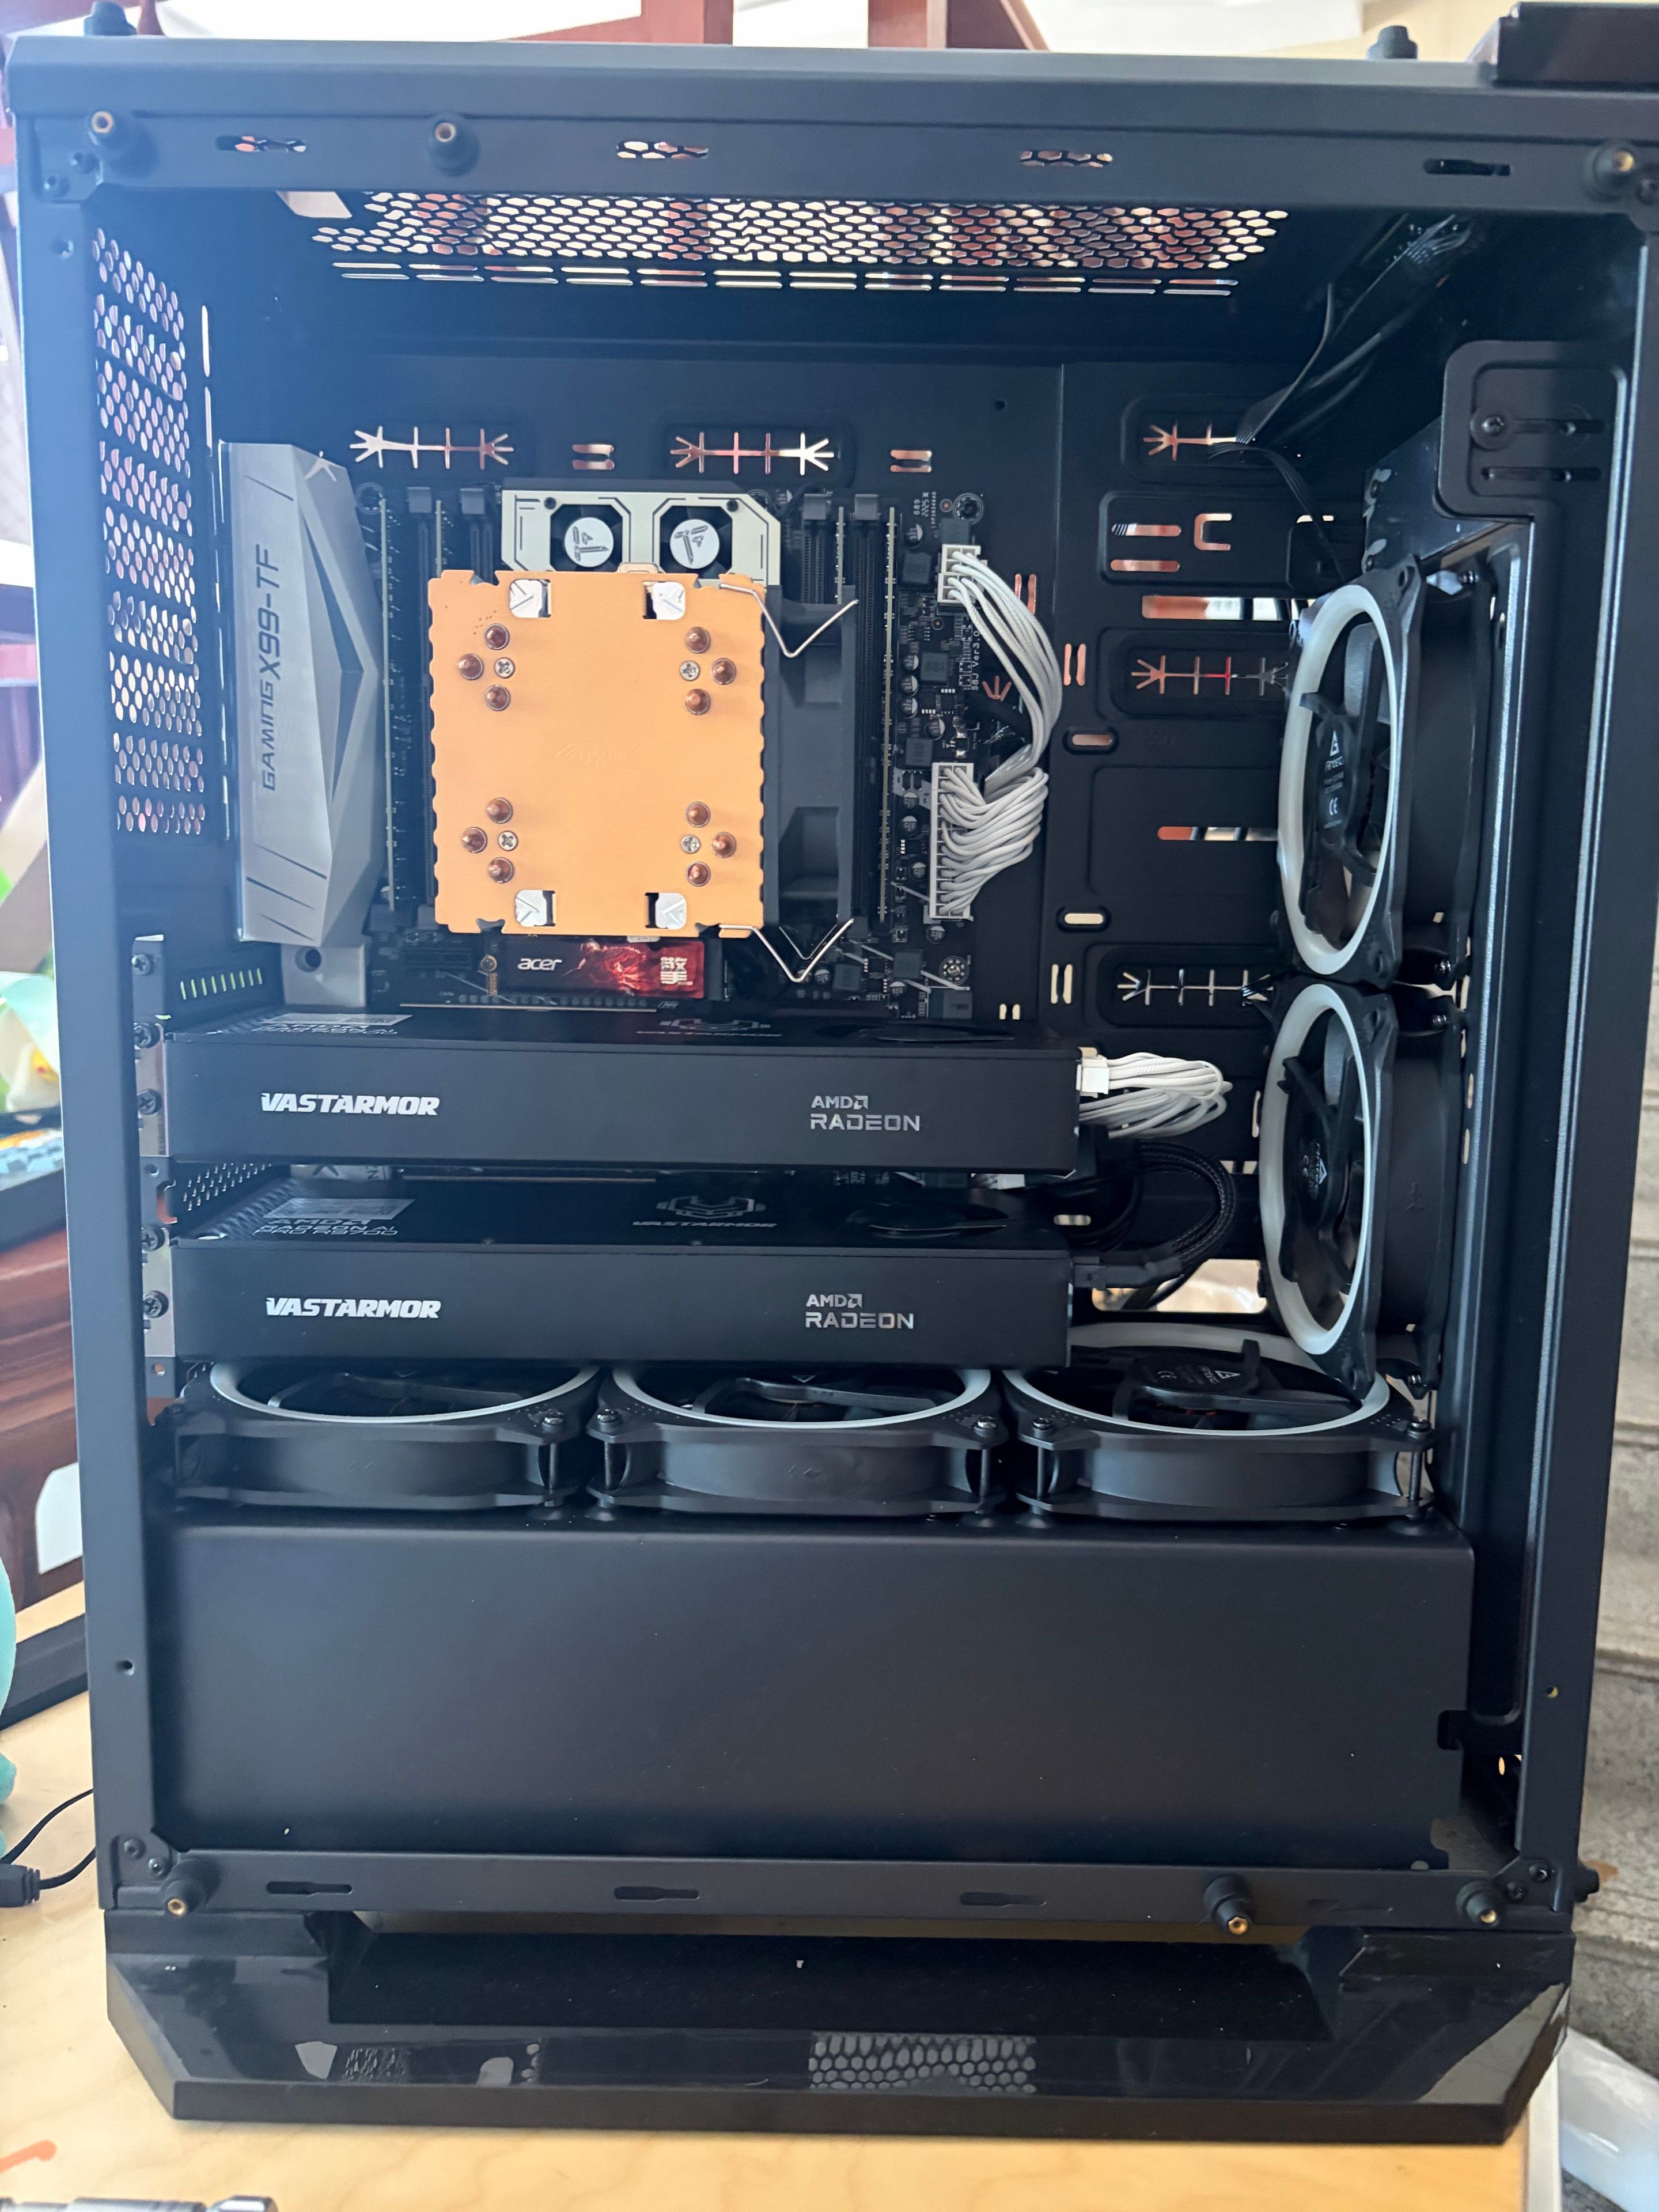
这是本机打开侧板的实拍,可以看到 X99 主板和上下排列的两张显卡。具体型号、链路和性能仍以系统读取与实测记录为准。
- CPU:Xeon E5-2696 v3;主板:HUANANZHI X99-TF GAMING;内存:128 GB DDR4。
- GPU:双 AMD Radeon AI PRO R9700,各 32 GB。两卡分别经 CPU 根端口,主机上行实读均为 PCIe 3.0 ×16;GPU 内部叶节点显示 Gen5,不等于主机上行 Gen5。
- Ubuntu、内核 7.0.0-34;StillDeadcode Radiance 0.9.3 / vLLM 0.27.1。
- Qwen3.8-27B 公开 NVFP4 权重,加载时转 MXFP4 W4A8;DFlash2-FP8 草稿 7 token;TP=2;304/304 线性层使用定制内核,48/48 GDN merge;FP8 KV、6-bit 通信压缩。
- maxlen 262144,每卡固定 8 GiB KV,实际池容量约 441K token。最深仅测到约 94K 实际输入,没有复刻参考文章约 797K 的 KV 池。
与参考文章的变量差异
变量 参考文章 本机这轮 对结论的影响 GPU 双 R9700,32 GB/卡 同为双 R9700,32 GB/卡 显卡数量和容量接近 CPU / 主板 i5-14500T / Z690 E5-2696 v3 / X99-TF GAMING CPU、内存子系统及调度不同,无法只归因于 PCIe 内存 64 GB;频率未取得 128 GB DDR4,配置速度 2133 MT/s 主机容量和速度不同 每卡 CPU 上行 PCIe 5.0 ×8 实读 PCIe 3.0 ×16 编码后单向理论值约 31.51 vs 15.75 GB/s 功耗上限 230 W/卡 230 W/卡对齐;另测 300 W/卡 仅 230 W 档可做同功耗观测对照 P2P 路径 文中使用强制 P2P 补丁及引导参数 原生 peer write 有效,未打补丁 驱动/拓扑路径不同 KV 池 文章约 797K token 本机约 441K token,每卡固定 8 GiB 长会话容量未对齐 基准与配方 BetterBench 0.4.0 / corpus 1.0;完整原始配置未取得 同版本语料;本机完整参数见下文 分数可作量级对照,不能视为控制变量实验 参考文章的数据来自作者正文及此前记录,没有取得原始 JSON,也没有在本轮重新读取其完整页面。尤其是 L16 差异,不足以证明 PCIe 3.0 或旧 CPU 更快。
PCIe 3.0 / 4.0 / 5.0:×8、×16 理论值与实测
下表是每条链路单方向、十进制 GB/s 的编码后理论上限,按 PCI-SIG 给出的 8/16/32 GT/s 和 128b/130b 编码计算:GT/s × 128/130 × 通道数 ÷ 8。它尚未扣除 PCIe 事务包等开销;也不是双向合计值。
PCIe 代数 ×8 单向理论 ×16 单向理论 3.0 7.88 GB/s 15.75 GB/s(本机每卡上行) 4.0 15.75 GB/s 31.51 GB/s 5.0 31.51 GB/s(参考文章每卡上行) 63.02 GB/s 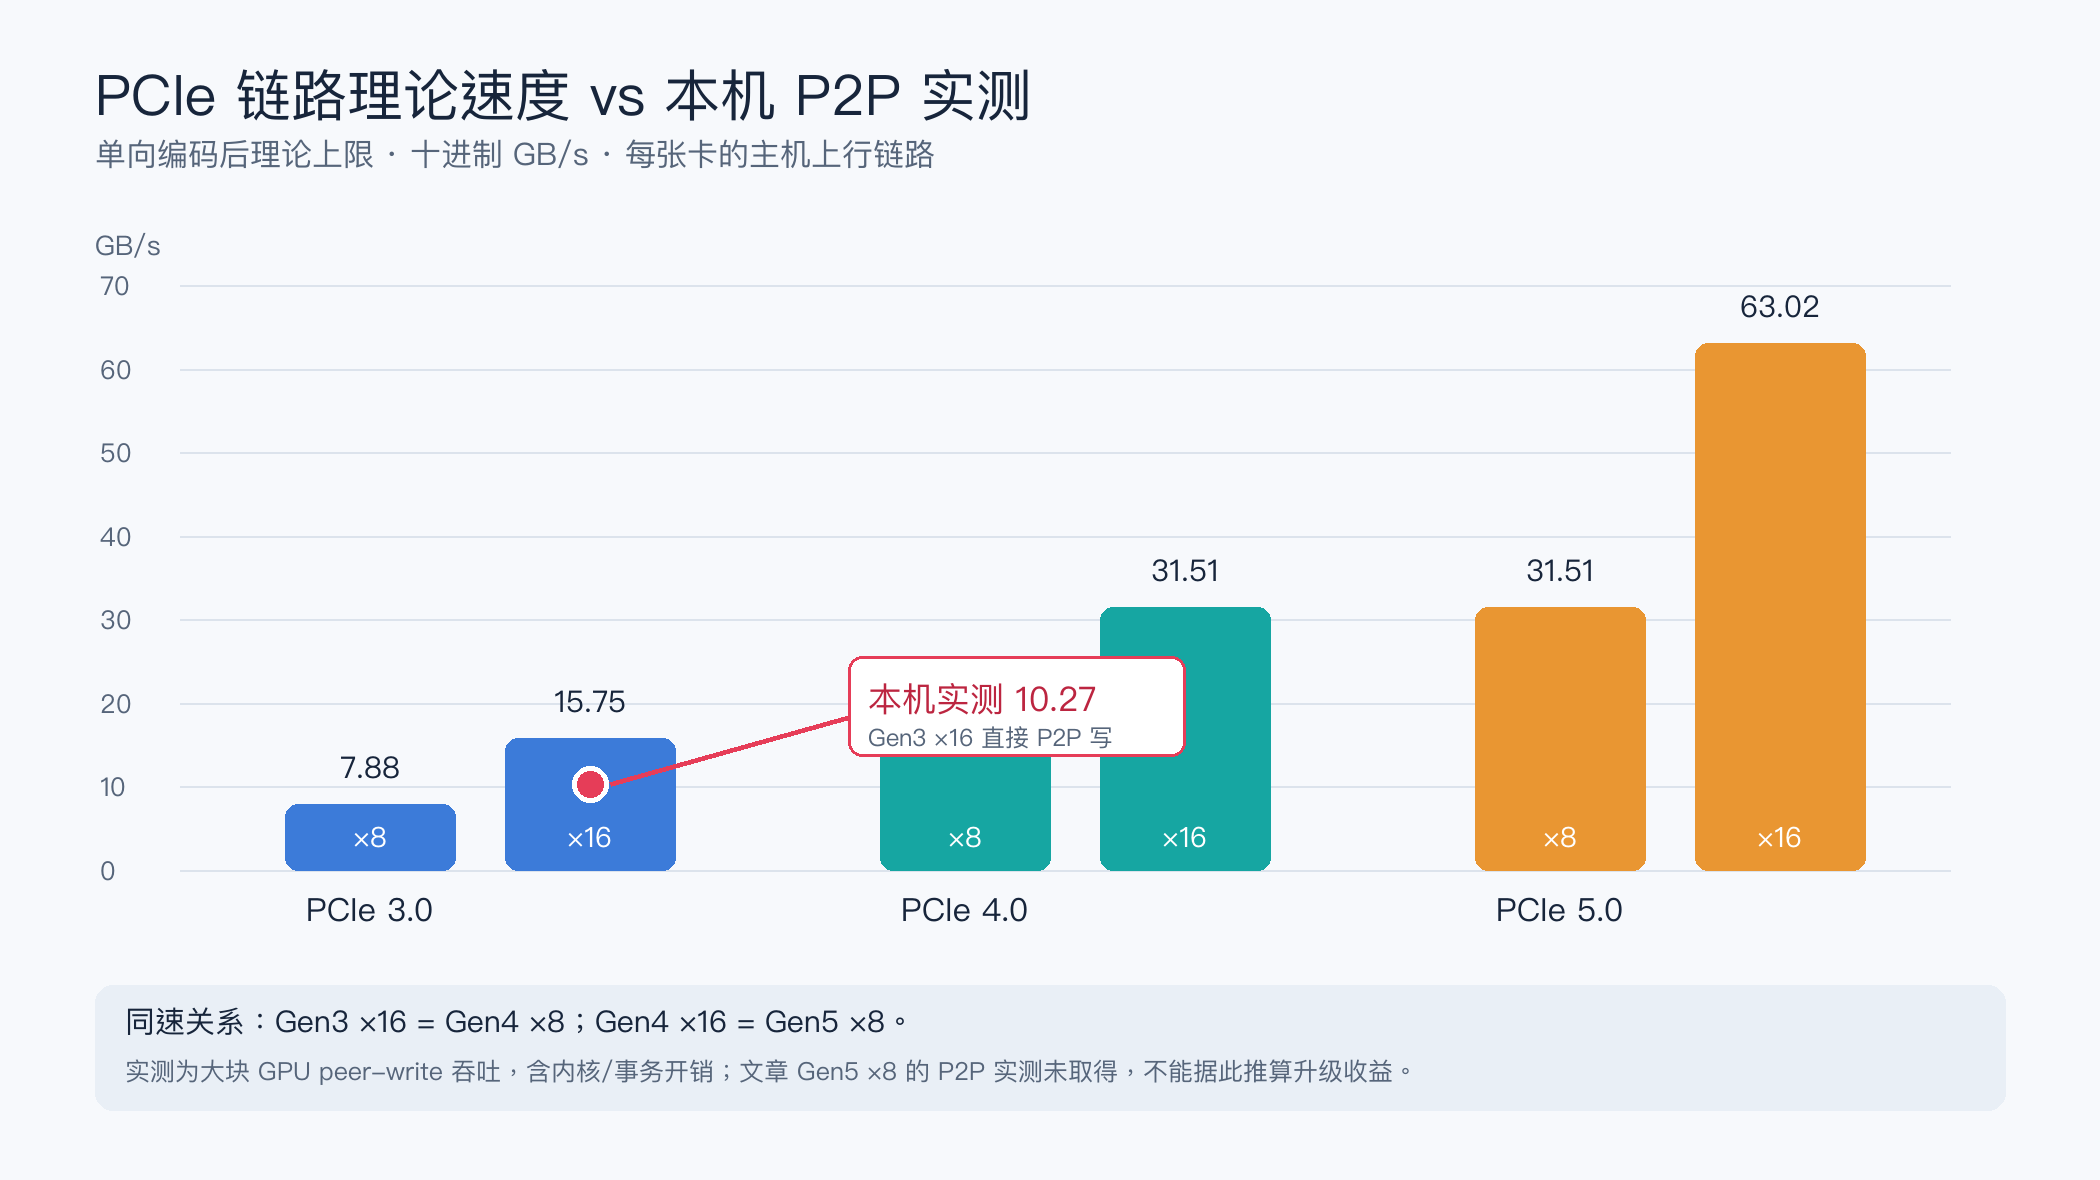
本机 PCIe 3.0 ×16 的大块直接 P2P 写入实测约 10.27 GB/s/方向,约为其 15.75 GB/s 编码后理论值的 65%;这是含 GPU 内核和事务开销的应用层吞吐,不等于 PCIe 裸链路效率。双向同时写的 19.67 GB/s 是两个方向的合计,不能与表中单向理论值直接相比。参考文章 Gen5 ×8 的同口径 P2P 实测未取得,故不能据理论两倍推断实跑两倍。Gen3 ×16 与 Gen4 ×8 理论同速;Gen4 ×16 与 Gen5 ×8 理论同速。
原生 P2P:这台 X99 不需要强制补丁
Triton 内核向另一张卡的设备地址直接写入,4 KiB 到 256 MiB 双向逐元素校验通过。大块单向约 10.27 GB/s,双向同时写合计约 19.67 GB/s。20 MiB 每卡输入的独立归约中,RCCL 约 4.70 GB/s,未压缩推送 P2P 约 9.38 GB/s;归约吞吐口径不能当成 PCIe 复制带宽。
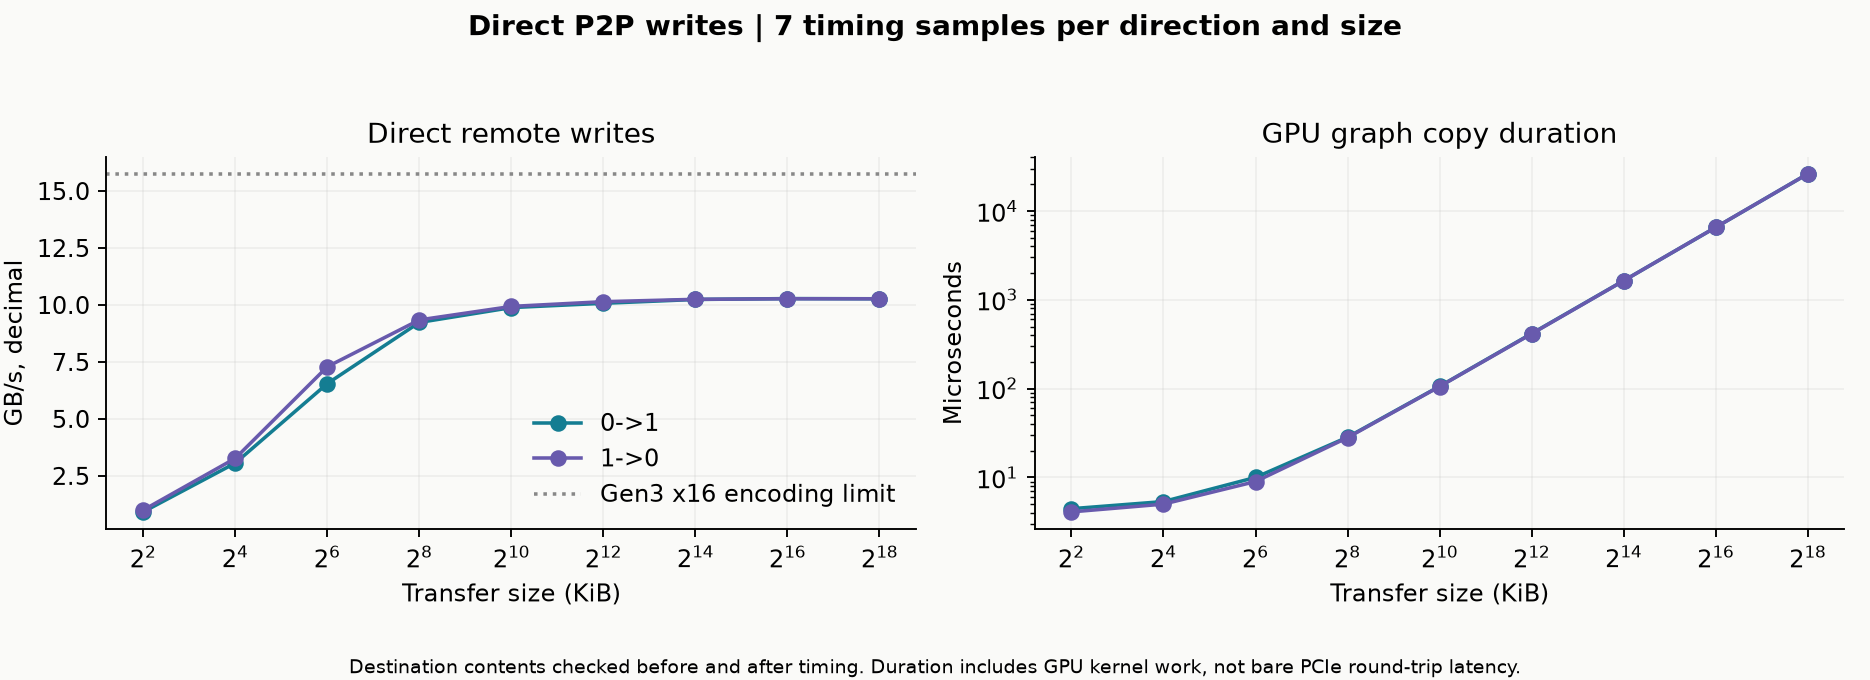
本机没有打
pcie_p2p_force补丁,也没有修改disable_acs或iommu参数。结论只覆盖测过的 peer write 与归约路径,不代表所有 peer read 或跨卡 atomic 都可用。BetterBench 0.4.0:230 W / 300 W 对照
使用 BetterBench 0.4.0、corpus 1.0。每类 3 次预热 + 20 次正式请求;prefill 每深度 2 + 8;并发 L1/2/4/8/16 各 48 次。每档 484 次、两档共 968 次请求,API 错误与中止均为 0。两档之间重启引擎,前缀缓存命中为 0。Decode/并发默认随机采样,温度 0.7,未固定 seed。
指标 参考文章 230 W 本机 230 W 本机 300 W 加权 decode 171.0 t/s 182.3 183.5 约 94K 输入 prefill 3168 t/s 3314.8 3514.7 L8 聚合吞吐 438.9 t/s 477.4 494.6 L8 首字中位 0.23 s 0.174 0.219 L16 聚合吞吐 223.0 t/s 511.3 495.4 L16 首字中位 7.9 s 5.371 5.800 本机六档输入的 prefill:
实际输入中位 token 230 W t/s 300 W t/s 1514 4348.0 4468.6 5918 4202.8 4400.3 11794 4149.0 4364.6 23543 3960.8 4170.0 47056 3743.9 3959.6 94065 3314.8 3514.7 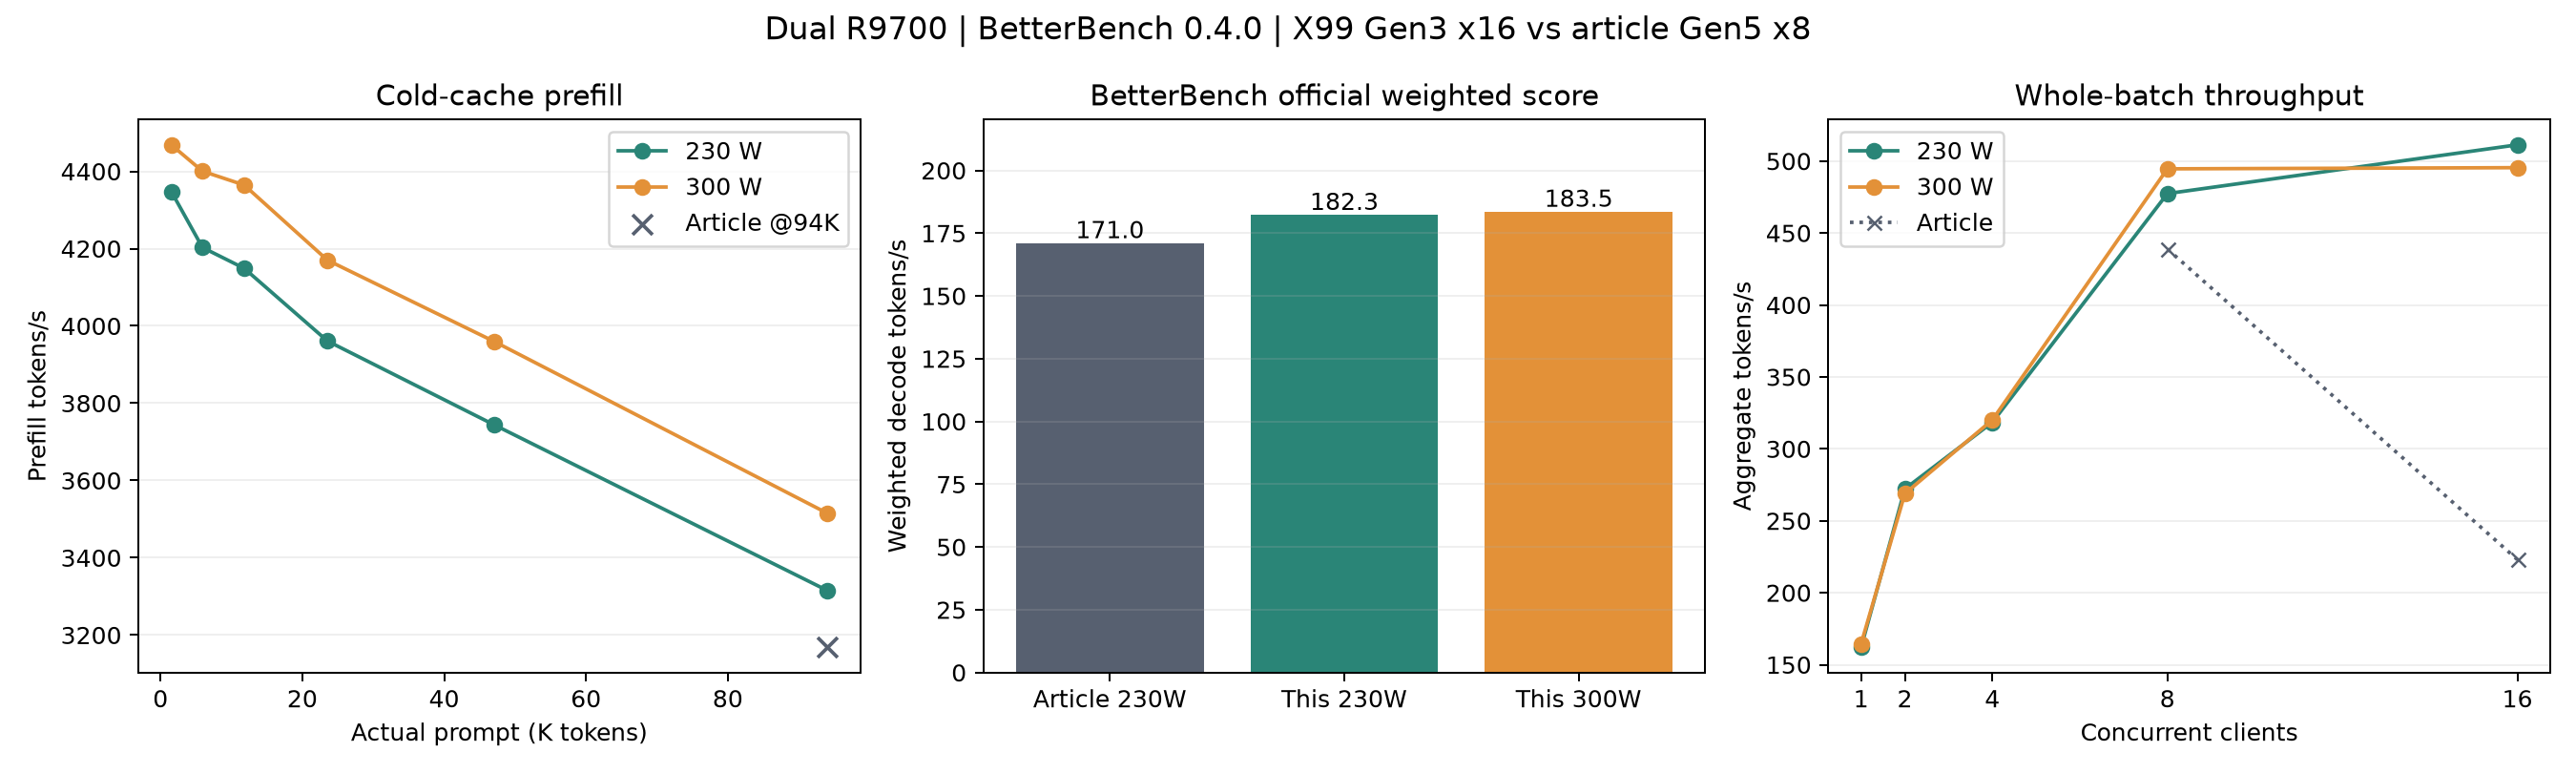
同为 230 W,本机加权 decode 高约 6.6%,94K prefill 高约 4.6%,L8 吞吐高约 8.8%。这些是观测差值,没有统计显著性检验。参考文章的完整配置和原始 JSON 未取得,尤其不能把 L16 的差距解释成旧 CPU 比新 CPU 更强。速度包含思考 token;首字可能只是思考内容,并非首个最终答案。
升级判断与局限
同机固定模型等条件,RCCL / 未压缩 P2P / 压缩 P2P 的 49.1K 冷输入首字中位分别为 26.16 / 16.70 / 12.43 秒。这是另一个 297 请求的自定义矩阵,不能与上表 BetterBench 横向混算。
Profiler 中压缩 P2P 通信内核约占 GPU 活动时间 25–26%。即使假设整个通信时间减半,GPU 侧理想提速也仅约 14–15%;这是简化估算,不是换 Gen5 的实测收益。Gen5 ×8 理论带宽约为 Gen3 ×16 的两倍,端到端模型速度不会自动翻倍。300 W 相比 230 W,94K prefill 高约 6%,decode 仅高约 0.7%,差值还包含随机输出波动。
另外,230 W 正式单流有 73/160 次、300 W 有 76/160 次在输出上限内仍未出现可见答案。HTTP 成功和 token/s 高,不等于代码质量或真实任务完成率。本轮未验收代码正确率、262K 长会话、视觉能力或长期稳定性。
如果后续换平台,我会先用真实 agent 工作负载定位瓶颈,再选择两卡 CPU 直连的平台,重新测同一套语料;不会拿理论链路速率代替实测。
版本与致谢
PCIe 速率依据 PCI-SIG 5.0 FAQ 和 PCI-SIG 3.0 FAQ。配方来自 ggz14 的 radiance-vllm-mxfp4;测试工具是 BetterBench 0.4.0。参考文章作者“野生模型实验室”的双 R9700 测试给了我比较目标。感谢这些开源项目和社区经验。原始报告与可公开统计附件已整理,实机照片和三张图已附在正文。
-
-
-
-
之前老特建议我出掉5080 上R9700,目前5080还没出掉/(ㄒoㄒ)/~~,但是已经到手两张R9700,在用的2张单卡主板B660I已经没办法搞了,正在研究怎么把两张R9700放在一起,正好看到这个贴子 ,打算折腾下这个帖子中参考文章中的配置,就是内存现在太贵了,不知道上64还是直接128G 有点犹豫
-
@rongda-weng 现在正好缺数据,要么你上个DDR3的 64G 测试看看(1000块钱),这个 X99的主板 可以支持 DDR3 或者 DDR4
@阿光 X99 主板有好多款,傻傻分不清
-




