跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 測試 雙R9700, X99, qwen3.8-flash-next-iq3_s

測試 雙R9700, X99, qwen3.8-flash-next-iq3_s

已定时 已固定 已锁定 已移动 LLM讨论区
r9700x99qwen-flash
16 帖子 7 发布者 334 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • XXXX
    XXXX
    XXX
    体面乡绅
    编写于 最后由 XXX 编辑
    #1
    • 測試時間:2026-10-23 19:38:00
    • 測試項目:僅速度(生成速度、首字延遲、Prompt 前處理速度),不含品質評測
    • 測試工具:自製 Python 腳本(標準庫 urllib + SSE 串流),OpenAI 相容 /v1/chat/completions

    1. 受測對象

    項目 值
    引擎 Strata(llama-server 相容協定,serve/server.py --engine strata)
    模型 qwen3.8-flash-next-iq3_s(Qwen3.8-Flash-Next GSQ-RCO,IQ3_S 量化,MoE + MTP)
    端點 http://127.0.0.1:8080/v1
    上下文 1,048,576 tokens(rope yarn ×4,KV cache int8)
    並行槽數 1(total_slots: 1,單請求序列化)
    加速設定 推測解碼 --spec 4、MTP、expert cache auto、prefill auto
    驗證 無 API key
    模態 text + image → text

    2. 硬體環境

    項目 值
    主機 Dioscuri(Linux 7.0.0-38-generic)
    CPU Intel Xeon E5-2686 v4 @ 2.30GHz × 36 threads
    RAM 247 GiB(測試時已用約 74 GiB)
    GPU ×2 AMD Radeon AI PRO R9700(Navi 48,各 34.2 GB VRAM,05:00.0 與 08:00.0),ROCm/HIP
    GPU(顯示用) NVIDIA GeForce GT 1030, 2 GiB — 僅驅動桌面(gnome-shell),不參與推論
    模型存放 /run/media/iceoff/Dioscuri_Data/LLM_models/Stara models/IQ3_S/(2 分片 GGUF)

    3. 測試方法

    一般社群常用的三項速度指標,皆以串流模式量測:

    1. TTFT(Time To First Token):送出請求 → 收到第一個 delta 的時間。注意此模型會先輸出 reasoning_content(思考過程),因此首字以 content 或 reasoning 任一出現 為準,避免低估。
    2. 生成速度 (decode, tok/s):(completion_tokens − 1) ÷ (最後一個 token 時間 − TTFT),token 數取自伺服器回傳的 usage。
    3. Prompt 前處理速度 (prefill / pp, tok/s):prompt_tokens ÷ TTFT,用 4 種長度(約 750 / 2.8k / 5.7k / 11.3k tokens)量測規模效應。

    控制變因:temperature = 0、max_tokens 固定、每次測試前先送一次 warmup、每組重複 3 次取平均。
    為避免 llama-server 的 prefix cache(提示快取)讓第二次以後的請求虛快,prefill 測試每次都在 prompt 開頭插入隨機 nonce,並核對回傳的 cached_tokens = 0 確認是冷啟動。

    3.5 推論實際跑在哪裡(實測佐證)

    是:兩張 R9700 都參與推論(HIP,--layer-split auto 跨兩卡切層)。 依據:

    證據 觀測值
    引擎進程開啟的裝置 strata 進程持有 /dev/kfd、renderD128(R9700 #0, 05:00.0)、renderD129(R9700 #1, 08:00.0)
    VRAM 佔用 GPU0 33.6 GB / 34.2 GB(98%)、GPU1 33.9 GB / 34.2 GB(99%),模型權重常駐
    生成中的使用率(342 tokens 那一次,0.2 s 取樣) GPU0 平均 69%(峰值 89%)、GPU1 平均 46%(峰值 89%)
    生成中的功耗 GPU0 平均 171 W(峰值 301 W)、GPU1 平均 101 W(峰值 222 W),皆為 240 W 上限內

    同時該次生成量到 73.4 tok/s,與表格中的 77–78 tok/s 一致,表示受測數字是雙卡 GPU 推論的結果,不是 CPU 推論。GT 1030 只是桌面顯示卡。

    另一個值得注意的訊號:兩張卡在生成時都沒跑滿(69% / 46%),且負載不均,表示目前的瓶頸不在 GPU 算力本身,較可能在專家權重由系統 RAM 串流(--expert-cache auto、--ple-io ram、KV 只常駐 32,768)與 PCIe 傳輸,或推測解碼的接受率。此為推論,未做對照實驗驗證。

    4. 結果一:生成速度(固定短 prompt,約 65 tokens)

    max_tokens 次數 實際輸出 tokens TTFT (s) 生成速度 (tok/s) 總耗時 (s)
    128 3 128 0.45 84.9 1.95
    256 3 256 0.33 78.1 3.60
    512 3 411 0.35 77.6 5.64
    1024 3 411 0.35 77.8 5.62

    512 與 1024 兩組模型都在約 411 tokens 自然結束(finish_reason: stop),故兩列數字幾乎相同,屬正常。
    三組重複間的離散度極小(例如 256 組為 76.95–78.62 tok/s),可視為穩定值。

    5. 結果二:Prompt 前處理速度(冷啟動,prefix cache 未命中)

    Prompt tokens 次數 TTFT (s) Prefill (tok/s) 同場生成速度 (tok/s)
    756 2 1.59 478 94.8
    2858 2 2.30 1243 83.3
    5672 2 3.55 1597 89.3
    11258 2 5.79 1945 71.2

    前處理吞吐隨批次變大而上升(約 500 → 2,000 tok/s)。短 prompt 時固定開銷(HTTP、排程、首個 prefill chunk、雙卡同步)佔比高;長 prompt 時才看得到穩態吞吐。
    以約 11k tokens 的實測值回推,塞滿 1M 上下文約需 9 分鐘(1,048,576 ÷ 2,000 ≈ 524 s),長文件一次性的前處理成本偏高。

    6. 結果三:Prefix cache 命中對照(附帶觀察)

    情境 Prompt tokens TTFT (s) 表面 prefill (tok/s)
    冷啟動(nonce 每次不同) 5,670 3.55 1,597
    重送完全相同的 prompt 5,640 0.45 12,519

    同一 prompt 重送時 prefix cache 全命中,TTFT 從 3.55 s 降到 0.45 s。多輪對話、重複系統提示詞的實際體驗會明顯優於上表的冷啟動數字。

    7. 結論

    • 受測組態是雙卡 GPU 推論:2 × Radeon AI PRO R9700(各 34 GB VRAM 幾乎全滿),HIP + layer-split 跨卡。GT 1030 只負責桌面顯示。
    • 生成速度:約 78 tok/s(短輸出 85 tok/s、長輸出 77–78 tok/s),單人使用文字對話體感順暢。
    • 首字延遲:約 0.33–0.45 s(短 prompt);11k tokens 的長 prompt 約 5.6–6.0 s。
    • Prompt 前處理:約 1,200–2,000 tok/s(2.8k tokens 以上);短 prompt 約 450–500 tok/s。
    • GPU 還有餘裕:生成時兩卡僅 69% / 46%(峰值 89%),未吃滿算力,調校 expert-cache / KV / split 比例或提高 --kv-resident 應還有提升空間。
    • 並行能力受限:total_slots = 1,同時只有一個請求在跑,第二個請求會排隊;多人共用時吞吐不會提升,只會拉長延遲。
    • 100 萬 token 上下文是帳面規格:以實測前處理速度,填滿需約 9 分鐘;日常建議把有效上下文控制在數萬 tokens 以內。
    • 推測解碼(spec 4 / MTP)已生效:若關閉,生成速度預期會明顯下降;本報告數字已含此加速。

    8. 附錄

    • 原始逐筆數據:raw_results.json(每次請求的 TTFT、token 數、tok/s、cached_tokens)
    • 測試腳本:bench2.py(python3 bench2.py gen / python3 bench2.py pp)
    • GPU 使用率取樣腳本:gpu_sample.py(直讀 sysfs gpu_busy_percent 與 power1_average,0.2 s 間隔)
    • 重現方式:確認 8080 埠服務在跑後直接執行上述指令即可,無需任何套件(僅 Python 標準庫)。
    • 註:初版報告誤把桌面顯示卡 GT 1030 當成推論 GPU,已依實際裝置與使用率觀測更正為 2 × R9700。
    • 註:第一次測試期間觀察到伺服器進程曾中斷並自動重啟(PID 17104 → 24628),該次數據已作廢;本報告所有數字皆來自重跑後的乾淨數據。
    1 条回复 最后回复
    0
    • BunseiB
      BunseiB
      Bunsei
      贵族大夫 硕果累累
      编写于 最后由 Bunsei 编辑
      #2

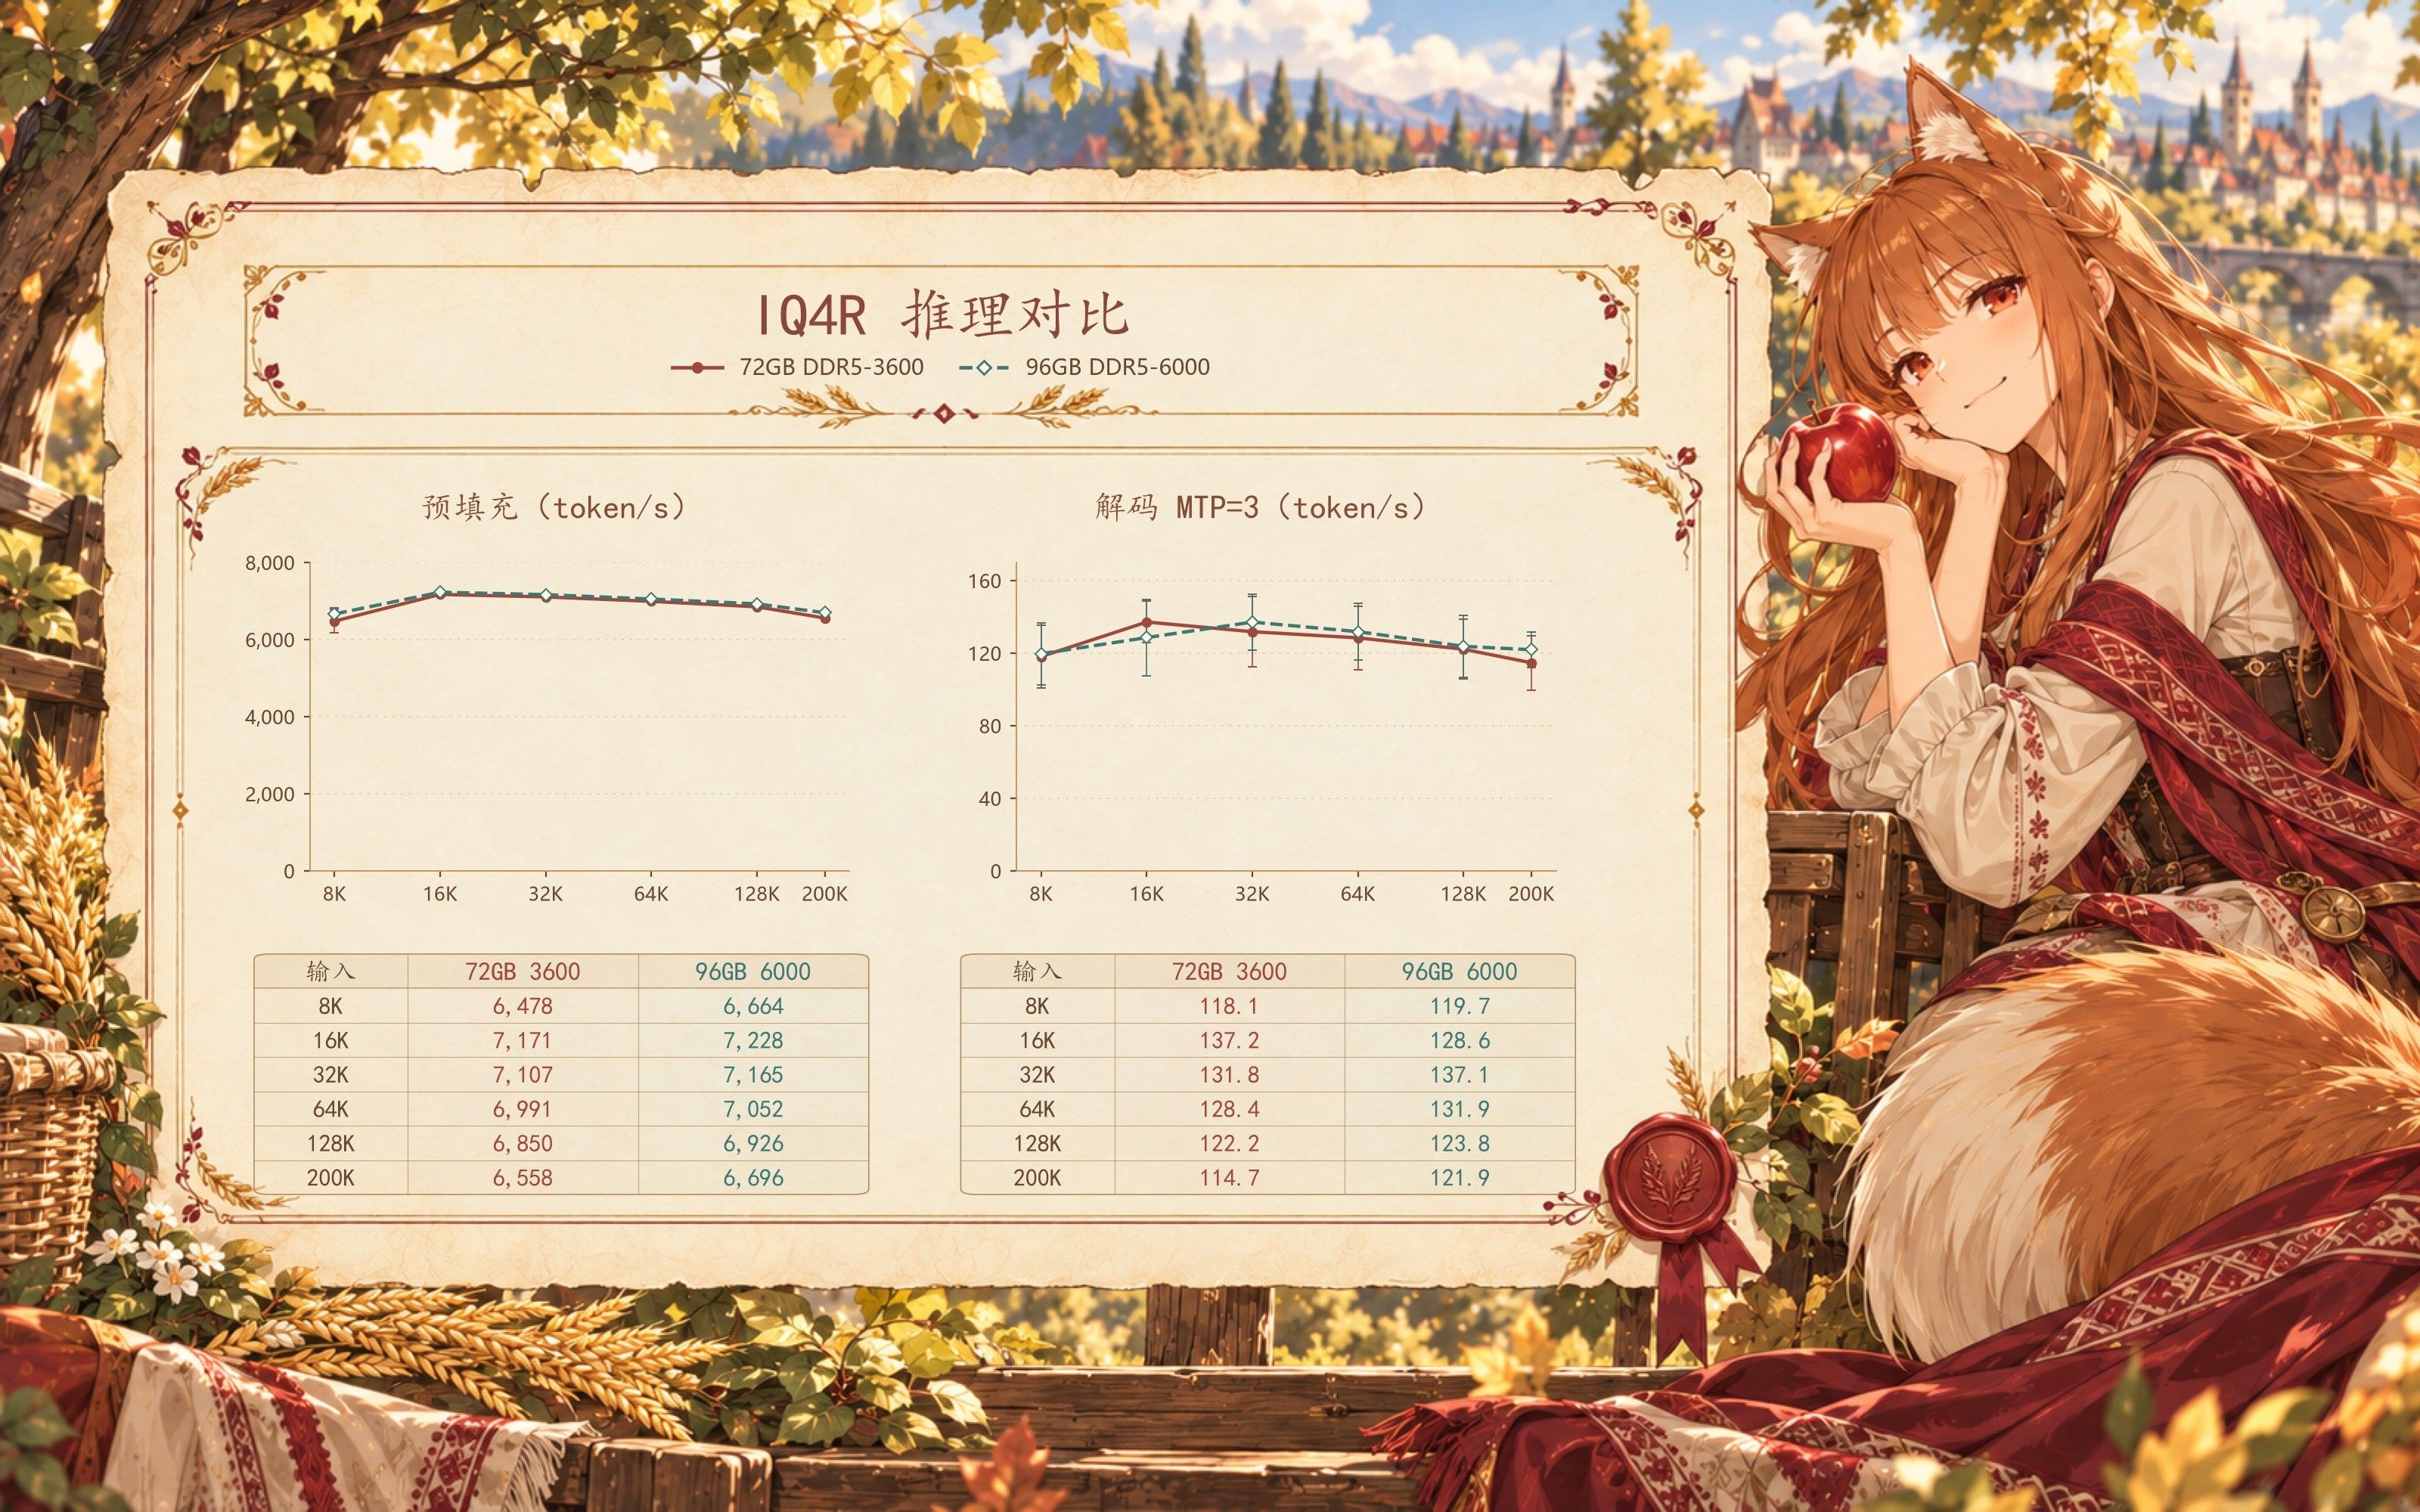
      可以试试Radiance ,这是从我打算发的新的一个帖子扣的一张速度图。 平台上TR50或者TR90,预填充8~9000应该没问题。

      image.jpeg

      项目地址:StillDeadcode/radiance

      1 条回复 最后回复
      0
      • imbiplaza ASUSI
        imbiplaza ASUSI
        imbiplaza ASUS
        谪仙人
        编写于 最后由 编辑
        #3

        有几个问题想确定:
        听闻x99 不能支援多卡tp?
        实时pcie 3.0 传输峰值是多少,
        可否设定单卡走满GPU 100%, 第二张只是占用vram,不涉及计算的话,跟现在的GPU0 69%+GPU1 46%,生成速度 ts 会不会有很大的差别

        BunseiB XXXX 2 条回复 最后回复
        0
        • imbiplaza ASUSI imbiplaza ASUS

          有几个问题想确定:
          听闻x99 不能支援多卡tp?
          实时pcie 3.0 传输峰值是多少,
          可否设定单卡走满GPU 100%, 第二张只是占用vram,不涉及计算的话,跟现在的GPU0 69%+GPU1 46%,生成速度 ts 会不会有很大的差别

          BunseiB
          BunseiB
          Bunsei
          贵族大夫 硕果累累
          编写于 最后由 编辑
          #4
          此主題已被删除!
          imbiplaza ASUSI 1 条回复 最后回复
          0
          • BunseiB Bunsei
            [[topic:post-is-deleted]]
            imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 编辑
            #5

            @Bunsei

            我就是想gen3是我需要考虑的最重要的原因,何况我的5060ti 原生只能x8,放入gen3 会不会只剩下残值

            XXXX 1 条回复 最后回复
            0
            • imbiplaza ASUSI imbiplaza ASUS

              有几个问题想确定:
              听闻x99 不能支援多卡tp?
              实时pcie 3.0 传输峰值是多少,
              可否设定单卡走满GPU 100%, 第二张只是占用vram,不涉及计算的话,跟现在的GPU0 69%+GPU1 46%,生成速度 ts 会不会有很大的差别

              XXXX
              XXXX
              XXX
              体面乡绅
              编写于 最后由 编辑
              #6

              @imbiplaza-ASUS
              你的TP如果指的是P2P, 目前我沒有成功.

              就3.0 * 16

              AI:兩張 R9700 的 P2P 是對稱的 7.3 GB/s,沒有壞掉的方向,也不需要改 DMA mask。 上限仍是 CPU 那兩條 Gen3 x16(15.75 GB/s 理論),7.3 約 46% 效率,在這種「雙 switch + 雙 root port」拓樸下屬正常。

              有時候會雙卡都100%

              1 条回复 最后回复
              0
              • imbiplaza ASUSI imbiplaza ASUS

                @Bunsei

                我就是想gen3是我需要考虑的最重要的原因,何况我的5060ti 原生只能x8,放入gen3 会不会只剩下残值

                XXXX
                XXXX
                XXX
                体面乡绅
                编写于 最后由 XXX 编辑
                #7

                @imbiplaza-ASUS
                感覺沒甚麼差, 之前跑PCIE4x4(Chipset), 跟PCIE5x8, 沒差很多, 兩邊加起來都100%, 很少超過的.

                1 条回复 最后回复
                0
                • ,gao GaoG gao Gao 引用了 此主题
                • A
                  A
                  applejuice
                  王侯将相
                  编写于 最后由 编辑
                  #8

                  为什么你这个2张r9700 速度有点差

                  XXXX 1 条回复 最后回复
                  0
                  • A applejuice

                    为什么你这个2张r9700 速度有点差

                    XXXX
                    XXXX
                    XXX
                    体面乡绅
                    编写于 最后由 编辑
                    #9

                    @applejuice
                    兩張 R9700 速度不一,是因為模型層(layer)分配不均,不是 PCIe 或記憶體頻寬問題。

                    具體分析如下:

                    層數分配:模型共 48 層,GPU0 接 0–23 層(24 層),GPU1 接 24–47 層(24 層)。
                    GPU 使用率:GPU0 約 69% 負載,GPU1 約 46%,明顯不均。
                    根本原因:模型並行策略(TP=2)將層數平均分給兩卡,但由於模型結構非對稱(例如前半段計算較重),導致 GPU0 負載更高。
                    硬體狀態:兩卡皆為 R9700,34.2 GB VRAM,無 PCIe 或記憶體瓶頸(無明顯頻寬差異)。
                    結論:不均是預期的層分配結果,非效能問題。若需平衡負載,可調整層數分配或使用更對稱的模型結構。

                    (補充:這與 GPU 硬體或 PCIe 通道無關,兩卡皆全速運作。)

                    A 1 条回复 最后回复
                    0
                    • XXXX XXX

                      @applejuice
                      兩張 R9700 速度不一,是因為模型層(layer)分配不均,不是 PCIe 或記憶體頻寬問題。

                      具體分析如下:

                      層數分配:模型共 48 層,GPU0 接 0–23 層(24 層),GPU1 接 24–47 層(24 層)。
                      GPU 使用率:GPU0 約 69% 負載,GPU1 約 46%,明顯不均。
                      根本原因:模型並行策略(TP=2)將層數平均分給兩卡,但由於模型結構非對稱(例如前半段計算較重),導致 GPU0 負載更高。
                      硬體狀態:兩卡皆為 R9700,34.2 GB VRAM,無 PCIe 或記憶體瓶頸(無明顯頻寬差異)。
                      結論:不均是預期的層分配結果,非效能問題。若需平衡負載,可調整層數分配或使用更對稱的模型結構。

                      (補充:這與 GPU 硬體或 PCIe 通道無關,兩卡皆全速運作。)

                      A
                      A
                      applejuice
                      王侯将相
                      编写于 最后由 applejuice 编辑
                      #10

                      @XXX 试试radiance 呗
                      如果这样的速度就不值得我入手第2张了

                      strata 两张卡不一定会同时用完
                      tp 会现在一张卡跑完再丢给另一张卡 但是strata 是不是这样我就不清楚了 没仔细看过

                      1 条回复 最后回复
                      1
                      • 懒人烘培懒
                        懒人烘培懒
                        懒人烘培
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #11

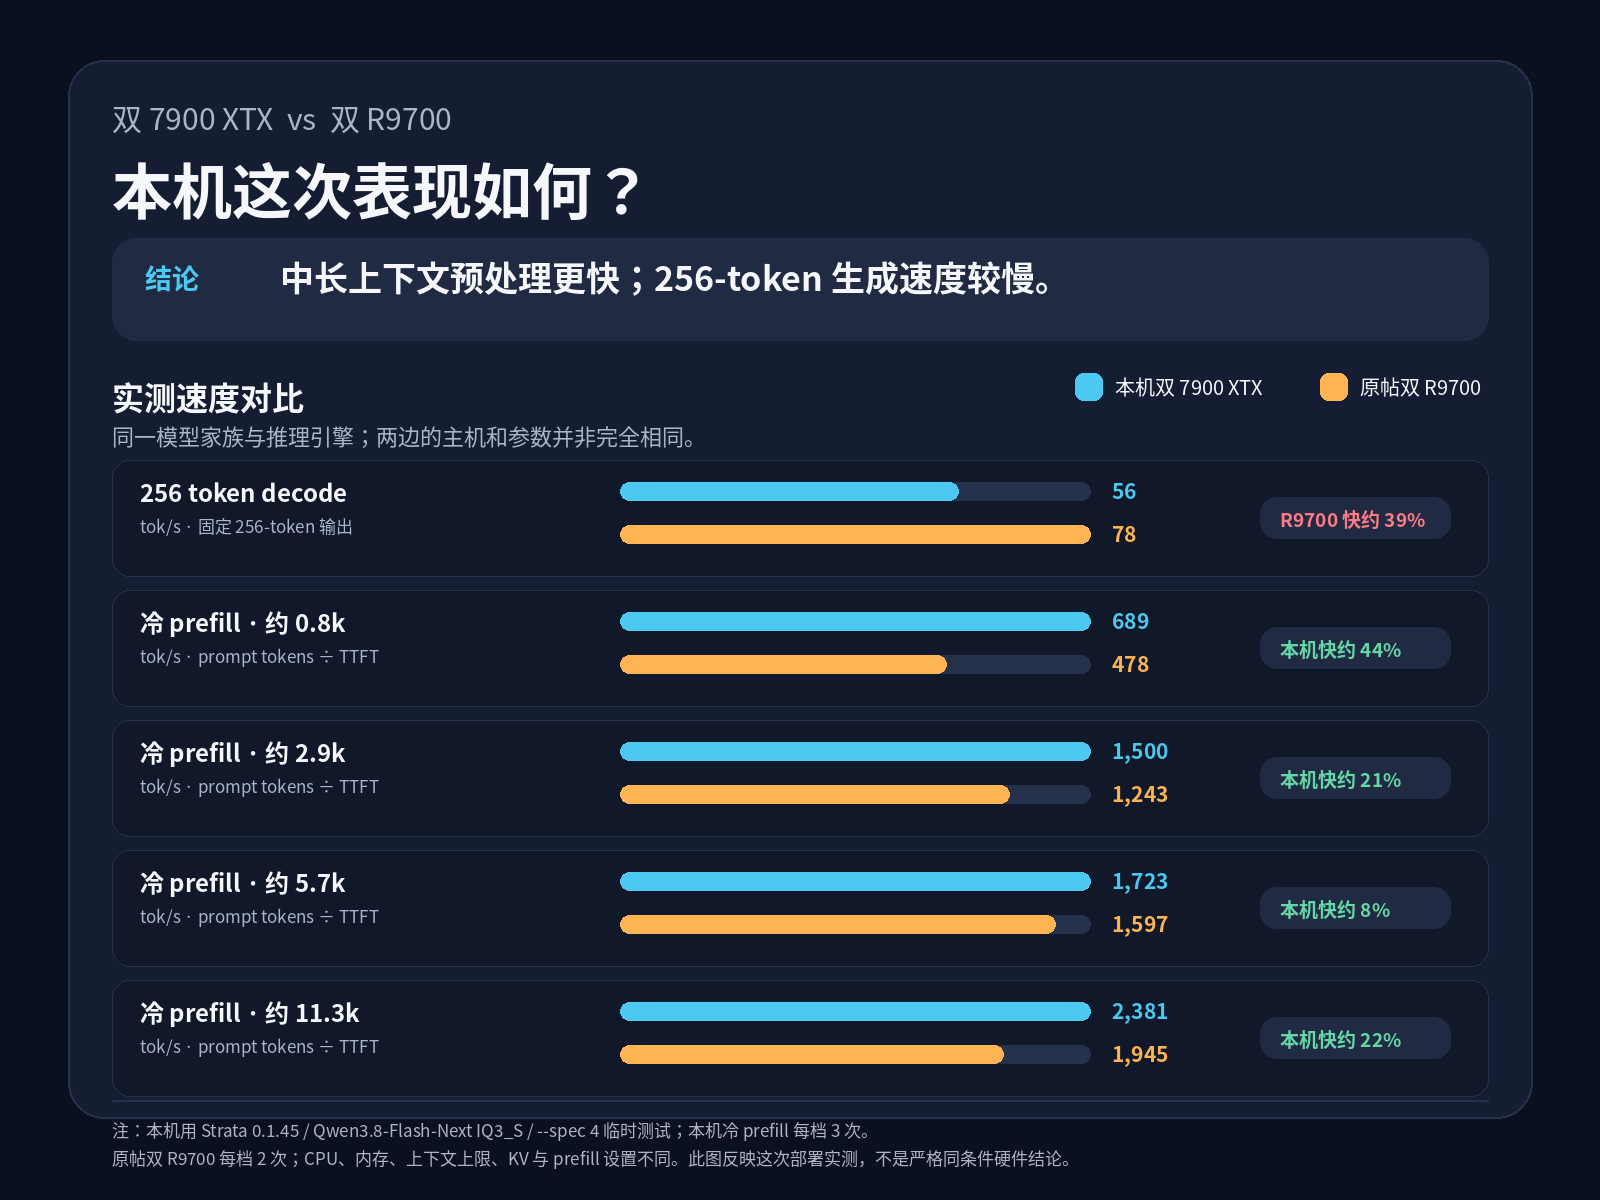
                        我用双7900XTX按照楼主的方式测试以下,如下图:
                        双7900XTX_vs_双R9700_实测对比.png
                        我觉得楼主的配置应该可以在优化一下。

                        双 7900 XTX:模型本地跑,Token 随便烧!

                        1 条回复 最后回复
                        1
                        • paul houP
                          paul houP
                          paul hou
                          体面乡绅 硕果累累
                          编写于 最后由 编辑
                          #12

                          @applejuice 说:

                          @XXX 试试radiance 呗 如果这样的速度就不值得我入手第2张了 strata 两张卡不一定会同时用完 tp 会现在一张卡跑完再丢给另一张卡 但是strata 是不是这样我就不清楚了 没仔细看过

                          他這速度跟單卡一樣,應該是沒設定好。

                          XXXX 1 条回复 最后回复
                          1
                          • hanber121H
                            hanber121H
                            hanber121
                            编写于 最后由 编辑
                            #13

                            @Bunsei
                            我今天刚按你您之前那个帖子把radiance鼓捣成,速度快的简直太离谱了,跟strata完全不是一个量级,prefill都快到7000了,decode比strata也快翻倍了,而且之前strata用的iq3s, 现在这个是4bit权重。
                            您是怎么把prefill速度再提一截的?快分享一下经验,我要抄作业🤣

                            1 条回复 最后回复
                            1
                            • paul houP paul hou

                              @applejuice 说:

                              @XXX 试试radiance 呗 如果这样的速度就不值得我入手第2张了 strata 两张卡不一定会同时用完 tp 会现在一张卡跑完再丢给另一张卡 但是strata 是不是这样我就不清楚了 没仔细看过

                              他這速度跟單卡一樣,應該是沒設定好。

                              XXXX
                              XXXX
                              XXX
                              体面乡绅
                              编写于 最后由 编辑
                              #14

                              @paul-hou
                              我功耗有降到240W.

                              paul houP 1 条回复 最后回复
                              0
                              • XXXX XXX

                                @paul-hou
                                我功耗有降到240W.

                                paul houP
                                paul houP
                                paul hou
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #15

                                @XXX

                                我試過210W和250W,沒有差這麼多。
                                雙卡還是用RADIANCE,STRATA是單卡DRAM大在用的。

                                XXXX 1 条回复 最后回复
                                0
                                • paul houP paul hou

                                  @XXX

                                  我試過210W和250W,沒有差這麼多。
                                  雙卡還是用RADIANCE,STRATA是單卡DRAM大在用的。

                                  XXXX
                                  XXXX
                                  XXX
                                  体面乡绅
                                  编写于 最后由 编辑
                                  #16

                                  @paul-hou
                                  這就不清楚, 或許是BIOS哪邊設定有問題.
                                  RADIANC試用中...

                                  1 条回复 最后回复
                                  0

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组