
-
@applejuice 是的,radiance推qwen3.8-next-flash-uncensored-fp8-iq4r-moe这个破甲模型。
部署来自己开发用的,所以上下文设的512k,日常速度大概170t/s,调试说是大约支持2并发。
ngram卸载到nvme之后,内存要求蛮低的,我记得空了二三十g的样子,我内存是96g,感觉64g说不定也能用了。 -
-
-
,系统 取消固定了此主题
-
-
@Bunsei 那以后推荐卡的顺序都变了,有24G的卡能测试下吗?我这几天没时间,想大家测试了,我忙完,11月中直接抄作业。你搞完这个帖子要奖励你50积分,先奖励20积分。因为太重要了。感谢你的贡献!
-
-
-
-
-
@fcys 能跑通那就牛逼了,这两个卡就是同一张卡,只是显存区别。你48G不需要TP吧,那就是说原理上是通的,我看你这效果也不错啊。双卡XTX主要是为了高分辨率和时长突破,处理一些特殊情况,平时分开跑,24G能跑还不错的分辨率。
如果每步耗时快这么多,其他部分是可以优化的,最终可以做到很不错的效果。这个和显卡架构无关,可能要改软件。
@terry 需要配合内存调度,才能补上单卡 24G 的短板。
在本次测试里,通过多次实验发现,锁定主机内存能在不拖慢速度的前提下提高分辨率和时长。
把部分 DiT 权重放在锁定的主机内存里,算当前层的同时异步搬运下一层。视频序列很长,1MP、226 帧大约有 6.7 万个 token,每层的计算时间远长于搬运时间,所以搬运基本被计算掩盖。
这次在 R9700 上实测,每步搬十几 GB,步时只增加 1–4%。权重腾出来的显存可以留给激活,而分辨率和时长受限的正是激活,所以能跑的规模就上去了。我把每卡主机池从 12G 加到 20G 后,双卡跑通了 1920×1088、158 帧,1MP 的帧数上限也从 260 提到 328,没有换显卡。
GPU 只保留正在计算的 2–3 层,再加上激活分块。XTX 的算力比 R9700 低,每层算得更久,所以内存的搬运反而更容易被隐藏,这套方法理论上更适合 XTX。
至于每步速度,还要靠 gfx11 的注意力内核来优化,这部分和架构有关。
-
@terry 需要配合内存调度,才能补上单卡 24G 的短板。
在本次测试里,通过多次实验发现,锁定主机内存能在不拖慢速度的前提下提高分辨率和时长。
把部分 DiT 权重放在锁定的主机内存里,算当前层的同时异步搬运下一层。视频序列很长,1MP、226 帧大约有 6.7 万个 token,每层的计算时间远长于搬运时间,所以搬运基本被计算掩盖。
这次在 R9700 上实测,每步搬十几 GB,步时只增加 1–4%。权重腾出来的显存可以留给激活,而分辨率和时长受限的正是激活,所以能跑的规模就上去了。我把每卡主机池从 12G 加到 20G 后,双卡跑通了 1920×1088、158 帧,1MP 的帧数上限也从 260 提到 328,没有换显卡。
GPU 只保留正在计算的 2–3 层,再加上激活分块。XTX 的算力比 R9700 低,每层算得更久,所以内存的搬运反而更容易被隐藏,这套方法理论上更适合 XTX。
至于每步速度,还要靠 gfx11 的注意力内核来优化,这部分和架构有关。
-
@Bunsei 它的测试过程,峰值显存24G是安全的,到时候让AI Agent也参考你的意见合理调度下,问题应该不大。就是不知道对主板PCIE,内存带宽的要求如何,是否要上DDR4/DDR5平台,DDR3是否可行。因为XTX这一代是PCIE4的,X99平台是否可行有待验证。内存带宽肯定不是问题,问题在PCIE,需要确认,我估计问题不大。
XTX算力和带宽都比R9700强,你搞反了。
-
@fcys 能跑通那就牛逼了,这两个卡就是同一张卡,只是显存区别。你48G不需要TP吧,那就是说原理上是通的,我看你这效果也不错啊。双卡XTX主要是为了高分辨率和时长突破,处理一些特殊情况,平时分开跑,24G能跑还不错的分辨率。
如果每步耗时快这么多,其他部分是可以优化的,最终可以做到很不错的效果。这个和显卡架构无关,可能要改软件。
-
-
-
-
-
-
-
@bunsei 了解了, 我问了AI,
下面是AI的回答:
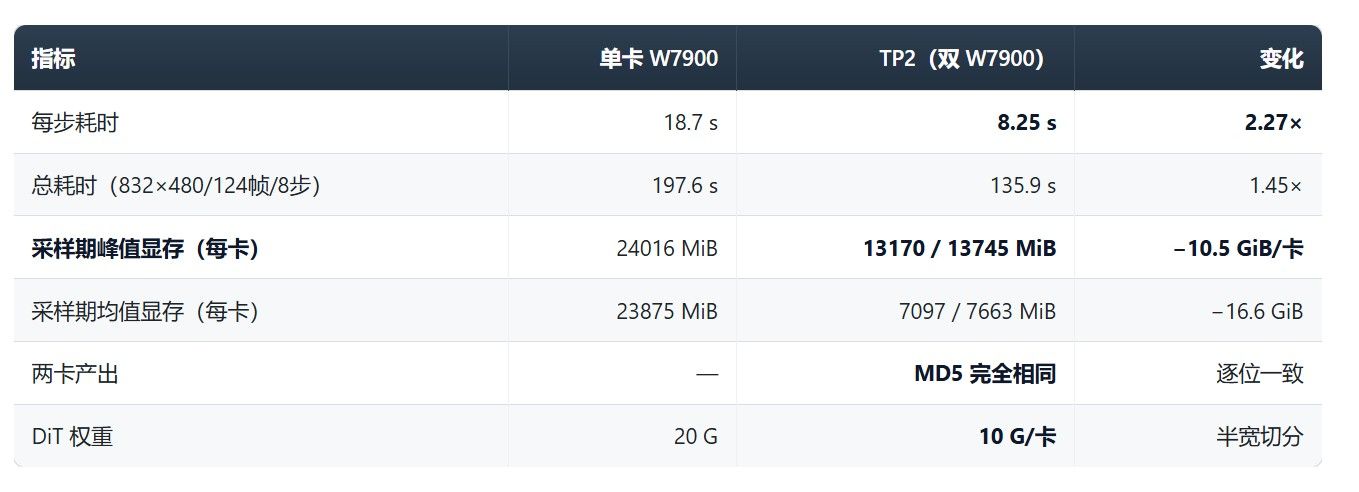
关于“显存够用时,双卡 TP 为什么还能实现每步提速(2.27x)”的核心逻辑可以总结为以下三点:
- 算力与矩阵乘法并行(空间换时间):虽然扩散模型的时间步(采样步数)必须串行迭代,但在单个时间步内部,双卡 TP(张量并行)将原本由单卡独扛的 DiT 模型层计算拆分到了两张卡上,实现了算力叠加,单步耗时直接腰斩。
- 规避“显存边缘化”引发的性能惩罚:从实测数据看,单卡时峰值显存被压榨到了 24016 MiB(逼近物理极限),容易导致硬件内部调度开销增大;双卡分摊后峰值降至 13G 左右,彻底释放了计算单元的潜能。
- 极高的“计算掩盖通信”效率:像 MiniMax 这样的大视频序列(数万 token 级别),每一层的矩阵计算极其庞大,通过 PCIe 搬运中间结果的开销相比之下非常小(步时增幅仅 1-4% 左右),因此 PCIe 完全不会成为拖后腿的瓶颈。
简单来说:虽然采样步数不能并行,但单步内的矩阵计算和算力被双卡并行解放了!





 , 咱们是用什么跑的?