
-
0x00、前言
老实说,推理引擎我是写不出来的。
上一篇 《从 Strata 到 Radiance》 里,我把 StillDeadcode 的 Radiance 选定作为日用推理引擎,6000 多的预填充,MTP 开起来一百出头的解码速度,还能顺手跑 Qwen-Image 生图和改图~ (具体配置和测试口径见上一篇)
用了一段时间,我心里又开始犯嘀咕,既然 Radiance 跑得这么快,能不能再让它多干一点?
这一嘀咕,就有了这篇续集。

0x01、一个很好玩、但跑不动的功能
上一篇赶着发布,有个挺有意思的功能没来得及讲,那就是 Radiance 除了跑文本和图片,其实也能跑 MiniMax-H3 的普通文生视频。
而 MiniMax-H3 本身还有个更好玩的模式,叫“全参考”,通过几张角色图、一段参考视频,再加一段音频,都可以一起喂给它。角色图告诉它主角“长什么样”,而视频提供动作的参考,告诉模型该主角怎么动、镜头怎么走,音频也能作为条件参与生成。对于想拿自己的角色做短片的人来说,这种组合实在很诱人!
但问题是,我原来这套 ComfyUI 流程主要用单卡跑,另一张卡没能帮上这个任务的忙,Radiance又不支持全参考模式的 minimax_h3_ref2va 模型,0.4MP、20 步全参考测试里,光采样就要等十五分多钟。

于是,情况就成了这样:
1、ComfyUI :流程全参考模式可以正常玩儿,但是速度慢的抠脚,出去转一圈回来它还搁那里采样!
2、Radiance:原生速度快,却还不支持我想玩的东西...
那么问题很自然就来了,能不能把两边拼起来? 想到这里,我突然冷静了一下,HIP 开发我不会,推理引擎我也写不出来。这活儿我怎么干…
…不对,我不会,但好女孩(GPT)可以试试啊!
于是,我捏爆了一张“限额重置卡”,把这个灵光一闪的念头交给了她。
接下来,就是一轮轮的报错、查日志、改代码、重新测试。前前后后折腾了一个周末,最后,全参考模式真的在 Radiance 里跑起来了!

0x03、第一关:先和原版比一比
跑通只是第一步,接下来我们要看看它到底快了多少。
最实在的参照,就是我原来实际在用的方案,原版 ComfyUI + 单张 R9700。
为了先看两套部署的表现,第一组用的条件比较朴素,全参考模式,832×480(约 0.4MP),完整跑 20 次 Euler 采样,不使用加速 LoRA,参考条件与初始噪声共享。
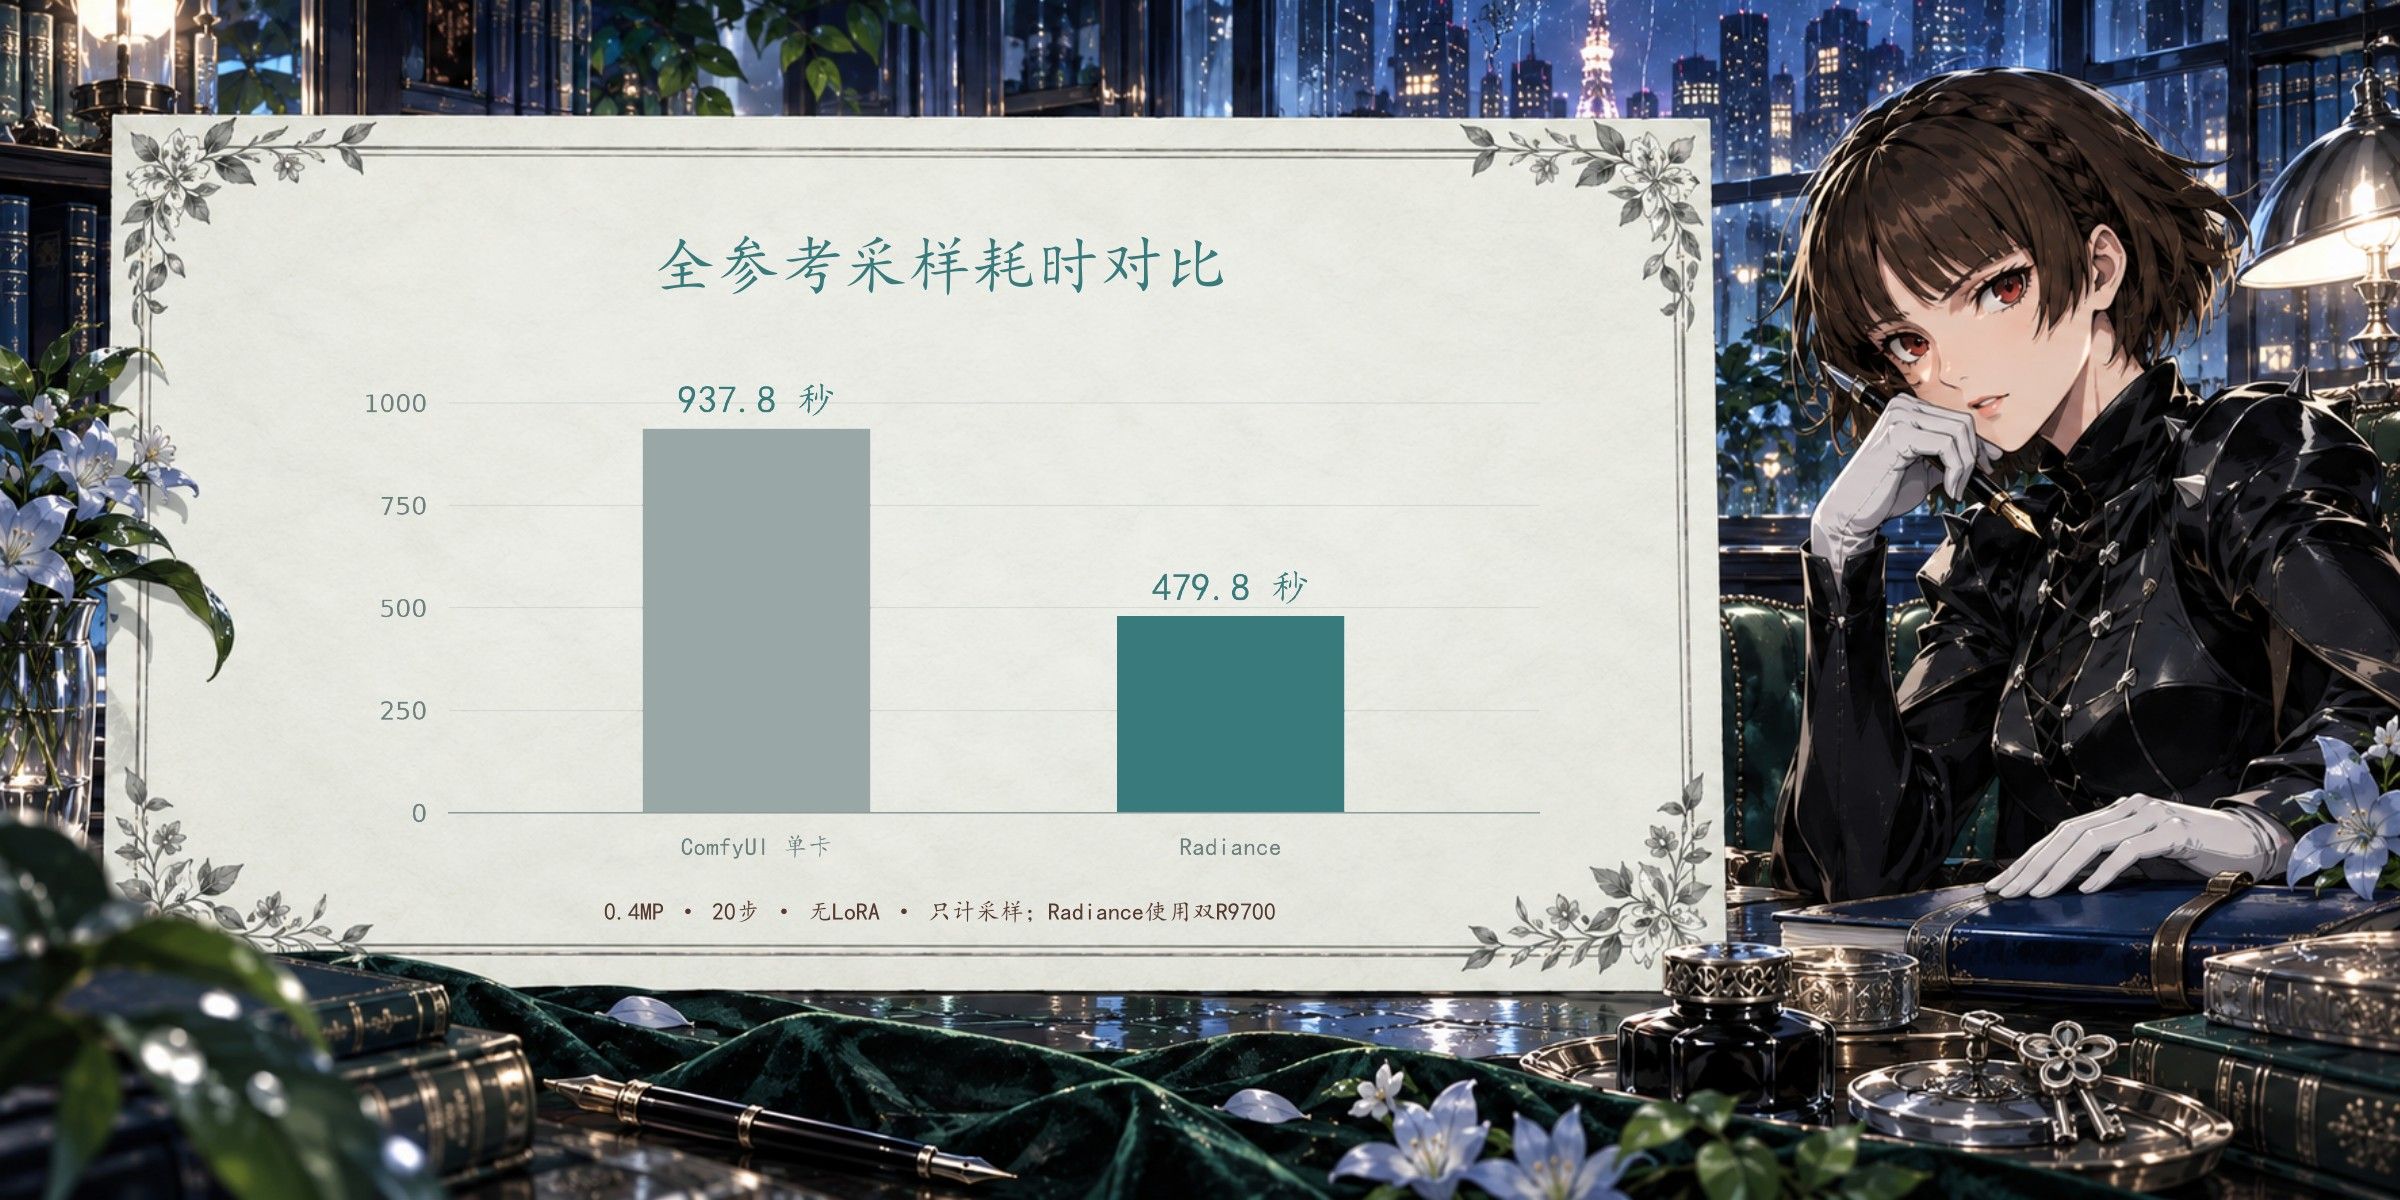
从十五分半缩短到约八分钟,采样吞吐接近翻倍,耗时减少约 50%!
0x04、第二关:上难度
尝到甜头后,我胆子也大了起来,于是我又上了一组更复杂的多张角色参考图,加一段参考视频和它的原声。
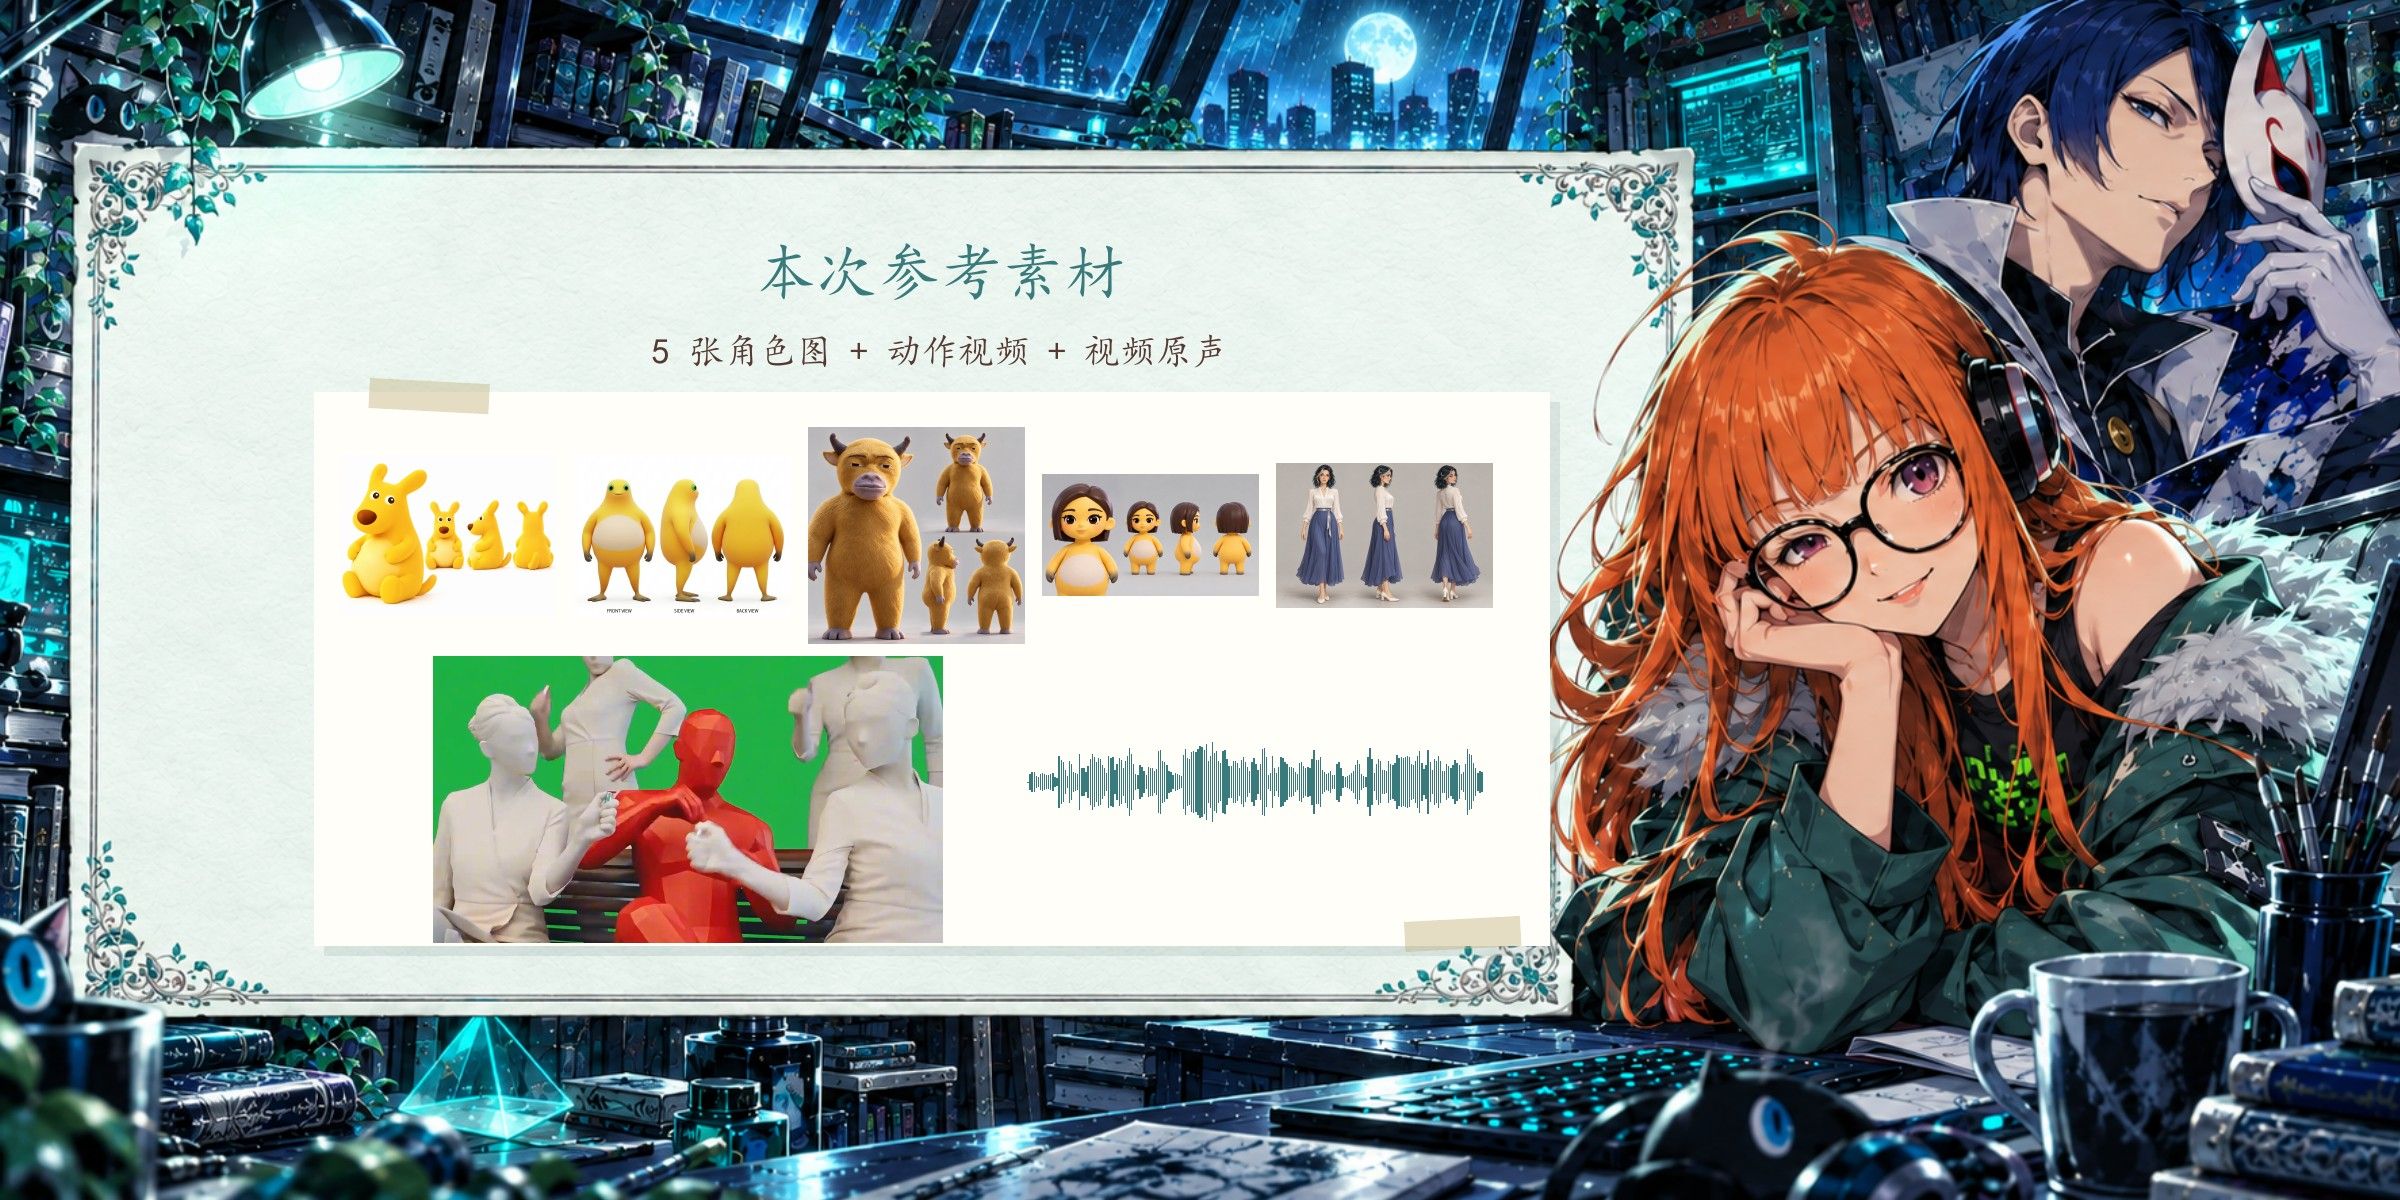
这次是“宇宙公交站”主题,四个黄色生物分别替换动作参考中的四个白模,前景女主保留。必要时允许身体比例向原模特靠近,让角色有条件完成原来的动作。
视频生成的总计耗时大概15分35秒。
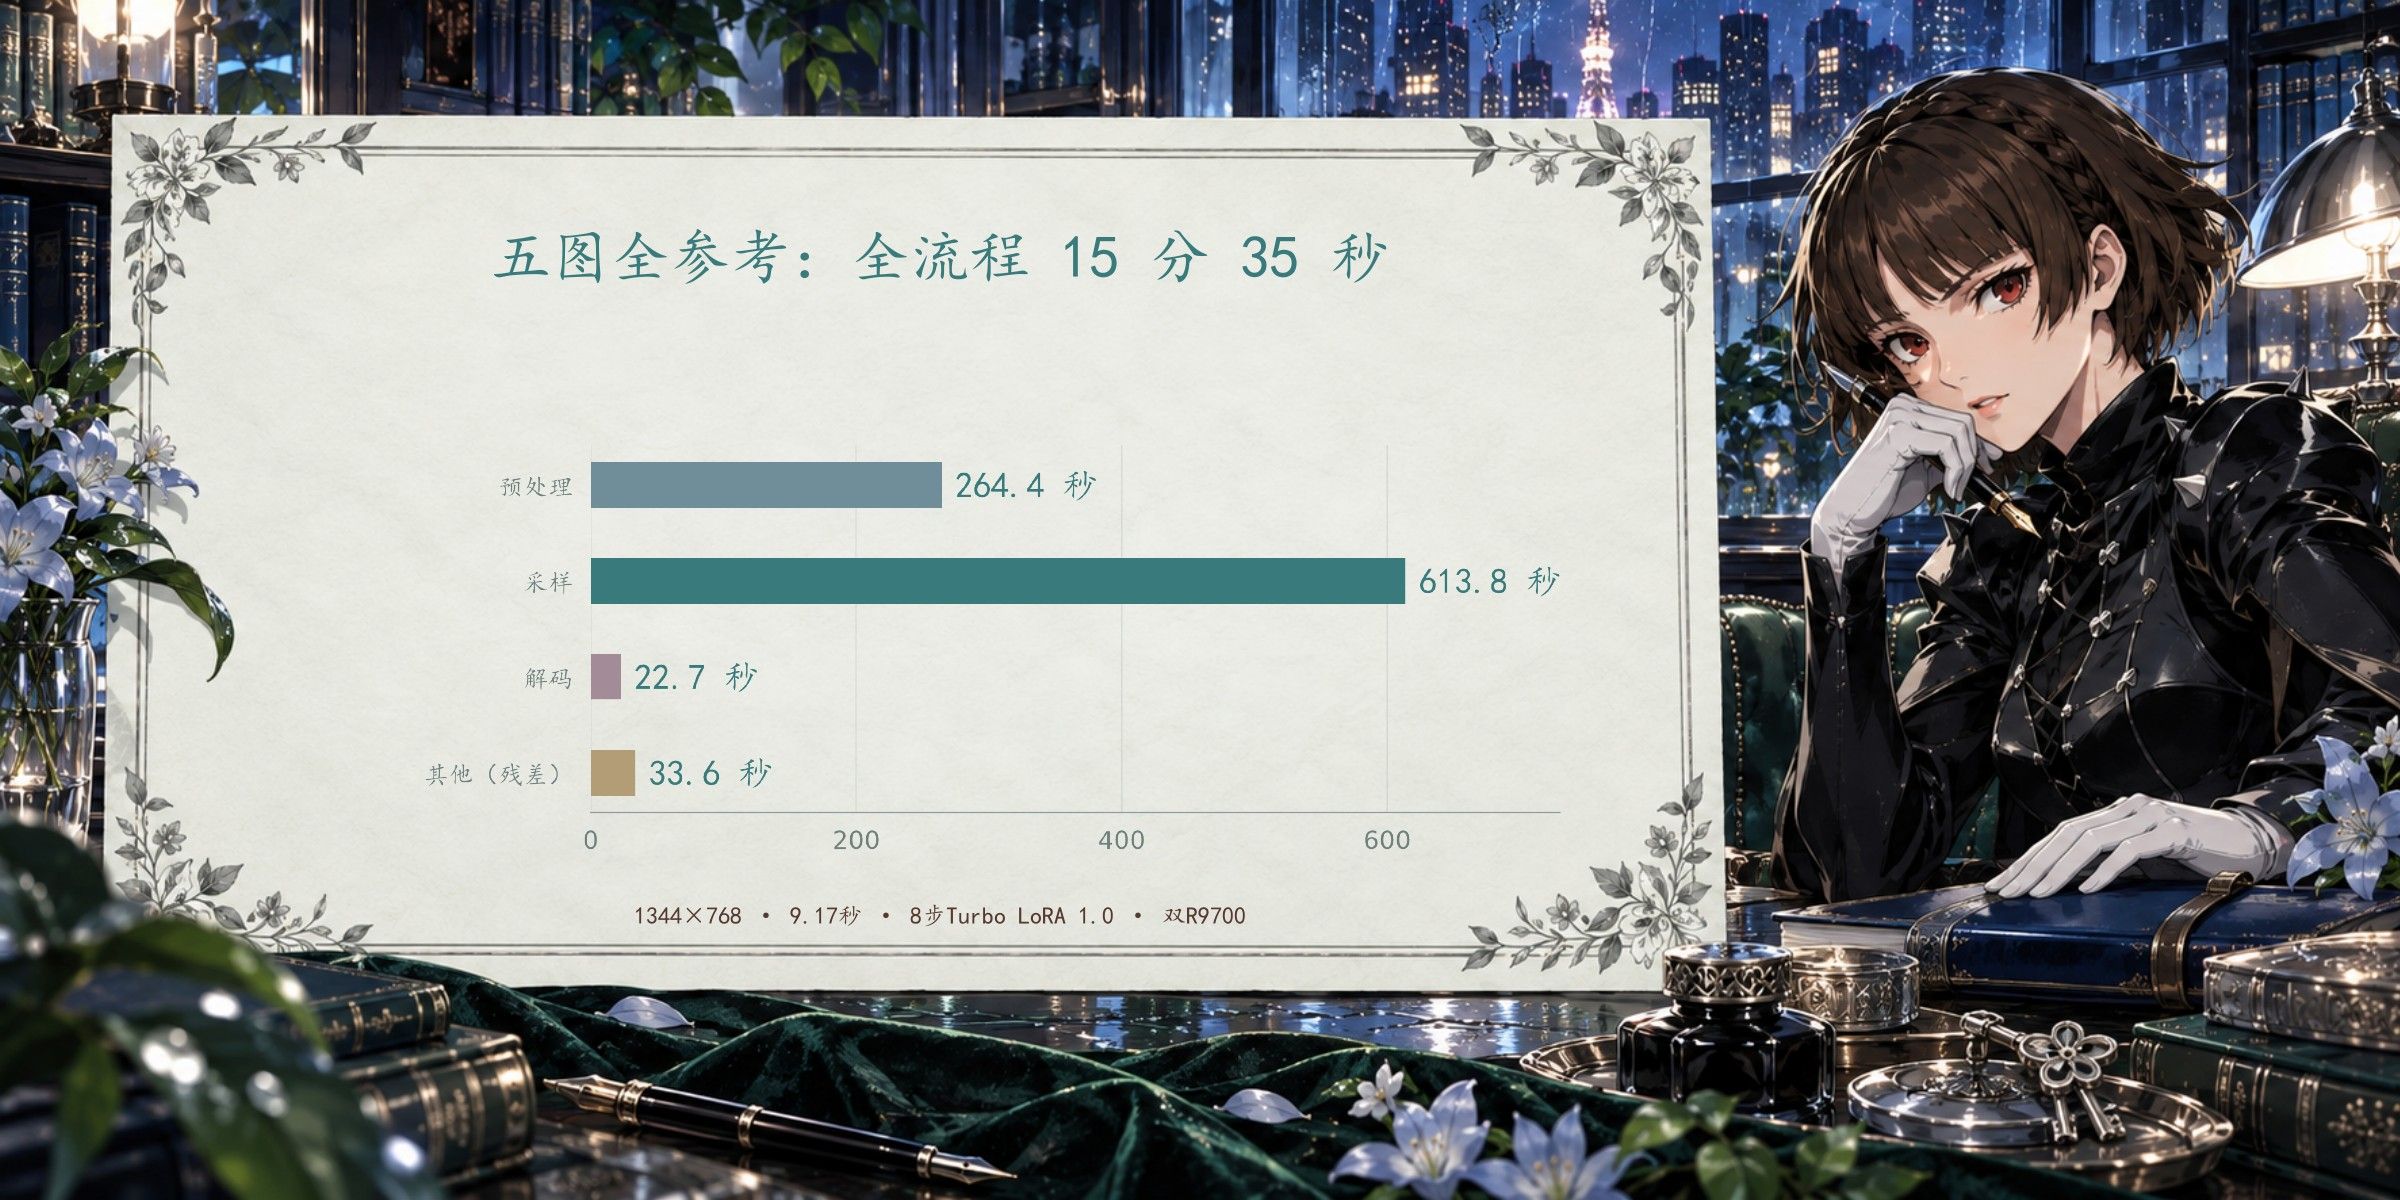
图中我们可以看到,采样之外还有将近五分的时间被预处理消耗掉了,预处理目前主要走单卡 PyTorch 路径,包含 VAE 编码和 Qwen3-VL-32B 条件特征提取,各环节占比还没有细分。后面有空,这是一个值得研究的优化点先记在账上!后面有空了再接着Vibe下,把整条任务的总耗时压下来。
效果我就不自吹了,视频放在下面。
 友们直接看成片自行判断。
(这十几分钟里,我唯一的贡献就是忍住没去碰电脑。
 )
0x05、比数字更让我兴奋的
而这次真正让我兴奋的,是多卡这条路好像走得通!多张同架构显卡,通过专项优化,可以让算力和显存一起参与同一个生成任务!!
单张 R9700 是 32GB,四张合计就是 128GB。官方规格:R9700
当然,四张卡加起来的 128GB 和一张 128GB 的卡不是一回事,模型怎么切分、卡之间怎么通信,都要看引擎的本事。现在的双卡路径也仍使用主机内存暂存,并非所有东西都常驻显存。我目前只实测了双卡,四卡能扩展到什么程度,还要等真插上去才知道~
但至少,它让我看到了另一种思路,本地生成不一定只能纠结“该咬牙买哪张大显存卡”,也可以依托于社区开源的“基础设施”,使用AI为自己扫平显存不足障碍!!
放在以前,像我这样的人,遇到框架跑得慢、功能不全,基本只能等官方更新,等大佬出手。现在,Linux、ROCm 和开源项目留出了动手的空间,AI 又把“想法变成代码”的门槛拉低了一大截。引擎、内核、内存分配这些我自己啃不动的骨头,至少可以试着交给好女孩去啃。
CUDA 多年积累的优势当然还在。只是折腾完这一回,我觉得那条“护城河”上,已经出现了普通人借助 AI 也能搭桥过去的地方。愿意折腾的
友再多一点,没准哪天,这条河就被填成了一条“护城沟”~ 所以,以后挑硬件,我会越来越看重这几样:硬件加速单元、显存容量、带宽,还有它的开源生态。
0x06、最后的坦白
开头说了,我写不出推理引擎,自然也修不动它。
这个实验分支在我的环境里已经能正常运行,但长期维护、持续适配和处理各种问题,都超出了我的能力,主要代码也由 GPT/Codex 完成。所以,我更愿意把它当作一次已经跑通的实验,连同代码、素材和记录一起公开,抛块砖出来。如果有
友愿意在 Radiance 和这次实验的基础上继续改进、移植,甚至做出更成熟的实现,那就是这块砖最好的归宿。0x07、AI 使用披露
本文涉及的代码移植、调试与优化主要由 GPT/Codex 完成,测试执行、数据核对、文字润色、主题插画与图文排版也有好女孩参与。我负责提供想法、硬件和测试素材,并确认关键决策。性能数字来自真实硬件的运行记录。
感谢 StillDeadcode 和 Radiance、MiniMax-H3 模型作者,以及所有提供开源工具的人。
一个写不出推理引擎的人,这次借着 AI,也在“巨人”的肩膀上站了一回。
==============================================================
独VV不如众V,爱折腾的锤友可以把这个丢给agent试一下,项目我全程Vibe的,文档质量可能较差!使用过程中有啥问题顺手让Agent处理了得了~

实验分支: https://codeberg.org/Bunsei/radiance-h3-fullref
转换模型: https://huggingface.co/Bunsei/MiniMax-H3-Ref2VA-FP8-Radiance
素材包:下载地址 。
PS:手里有显卡的
友,欢迎用同一套素材、相同模型版本和采样参数跑一遍。我是真的好奇,这组全参考任务在 N 卡上要跑多久,时间主要花在哪些阶段。我目前没有同条件数据,只能把这个拜托给友们了。
注:文中的《女神异闻录5》主题 AI 插画为非官方同人作品,角色权利归 ATLUS / SEGA。
-
-
,
 T terry 固定了此主题
-
-
-
可以弄个正式的项目,我加入到论坛的本地项目中,给个专页,以后会开发更好的展示页面,现在项目太少。你可以作为胶水项目。
你这还是单卡,不是多卡项目,不要搞混了。多个节点分拆N久之前就完成了,它无法替代单卡大显存。
老哥我按照你的意思是 “虽然两张卡都参与计算,但每张卡仍保存完整的一套权重和中间数据,因此没有降低单卡显存门槛” 这样子理解了。
确实,单凭加速或两卡都有负载,确实不能证明显存容量得到了有效分摊。但我们这次不是全部复制,主隐藏状态和部分模块仍然每卡各有一份,而主要 DiT 矩阵权重、QKV、前馈中间数据和调制表进行了分片。
所以我又让GPT跑了一遍,记录了完整状态(数据太长,所以我贴到楼下了)。跟GPT讨论的最终结论是这样的:
如果忽略跨卡通信成本,并假设完成了四卡适配(系统层面支持TP4),多卡能够让生成任务的可承载容量近似线性增长,但存在重复状态和工作区开销。
按这次双卡测得的布局作简化估算,每增加一张 32GiB R9700,大约能增加 20.5GiB 的“单卡等效任务容量”。两张约相当于 52GiB,四张约相当于 93GiB。
这是一种扣除重复开销后的容量估算,不代表显存被合并成了统一地址空间,也不是四卡实测结果。
对应的理想化估算表:
卡数 物理显存合计 扣除额外开销后的单卡等效容量 1 张 32 GiB 32 GiB 2 张 64 GiB 约 52.5 GiB 3 张 96 GiB 约 72.9 GiB 4 张 128 GiB 约 93.4 GiB 计算假设是把本轮新增的 11.55 GiB 并行开销,近似视为每增加一张卡都要付出的固定成本:
等效容量 ≈ 32N-11.55(N-1)
-
配套数据 :
按这次 双 R9700、H3 全参考、1344×768、8 步的完整运行记录,两张卡的布局基本对称。
每张卡实际占用约 27.90 GiB:
显存区域 每卡容量 备注 数据池与工作区 约 17.72 GiB 中间计算数据、参考条件、latent、LoRA 参数和临时空间 基础权重池 约 8.75 GiB 当前常驻权重,以及按层轮换使用的权重暂存槽 其他占用 约 1.43 GiB 驱动、队列及额外分配等;这是差额估算 驱动层显存峰值 约 27.899 GiB 包含以上各项 设备报告总容量 约 31.86 GiB 配置中主动预留约 4 GiB,未全部占满 其中,17.72 GiB 的数据池内部是:
内容 每卡容量 多卡组织方式 DiT 临时中间数据峰值 约 13.026 GiB 混合:QKV、前馈中间数据分片;完整隐藏状态等仍复制 请求持久状态 约 2.750 GiB 混合:参考条件、latent 等有复制;调制表已分片 LoRA 参数与工作区 约 1.419 GiB 依对应层的分片与执行方式安排,不能整体算作重复数据 算子临时空间 scratch 约 0.455 GiB 每卡为两条执行通道预留 音视频输出缓冲 约 0.067 GiB 保存输出数据 合计 约 17.717 GiB 含少量对齐空间 8.75 GiB 的基础权重池内部是:
内容 每卡容量 用途 常驻基础权重 约 2.88 GiB 放在显存里直接使用 权重轮换暂存槽 约 5.77 GiB 从主机搬入待计算的权重,用完后供其他层复用 池内剩余空间 约 0.10 GiB 尚未使用的池预算 合计 约 8.75 GiB 上面三项已包含其中 暂存槽不是每层都保留一份,而是多层轮流使用同一片空间。LoRA 也已经计入数据池,不能再次加到总量上。
主机内存则承担了另一部分:
主机侧指标 本次记录 主机侧权重,两 rank 合计 约 24.72 GiB 进程锁页内存 约 26.83 GiB 引擎进程 RSS 峰值 33.619 GiB 引擎进程 VmSwap 峰值 0 稳定采样每步主机→两卡权重暂存复制 约 12.208 GiB 主机侧这些指标存在包含关系不能相加,每步搬运量也不是瞬时内存占用。
最关键的对照是:
同一容量配置 TP1 单卡计划 TP2 每卡计划 TP2 两卡合计 工作区,包含 LoRA、scratch 29.35 GiB 17.72 GiB 35.43 GiB 基础权重声明总量,包含主机卸载部分 25.01 GiB 15.24 GiB 30.48 GiB -
-
,T terry 将此主题从 随便聊聊 移至此处
-
,T terry 引用了 此主题
 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!