
-
MiniMax-H3 参赛片:注意力改 BF16 + 去掉 turbo 加速 LoRA 的详细测试
日期:2026-11-17 机器:magic629-AI(2× Radeon AI PRO R9700 32G,ROCm 7.14,TP2)
服务:radiance-h3fullref(radiance 1.17.0 分支radiance-h3-fullref,端口 8001)
规格:1344×768 / 294 帧 / 24 fps / 12.25 s / seed 145 / 统一 prompt + 6 张参考图(剑心、志志雄)
测试矩阵:3D CGI 与 2D 动画两条片 × 4 / 8 / 20 / 50 步 = 8 条,另加 1 条 int8 对照
0. 结论速览
问题 实测答案 注意力改 BF16 后画质变了吗? 基本没变。同 seed 同 prompt 的严格 A/B:相对锐度 −3.1%、高频能量比 −0.3%、静止区抖动 +0.1%、宽窗对齐抖动 −3.4%,全部在噪声量级。 那代价是什么? 每个去噪步慢 38%(4 步档 47.4→65.6 s/步,20 步档 56.6→78.2 s/步)。而且这还是在"顺手省掉了 LoRA 显存槽"之后测出来的,纯注意力开销只会更大。 去掉 turbo LoRA 后 4 步还能用吗? 不能。4 步出片是一团糊(帧 250 整幅是火焰糊块),静止区抖动 3.40,是 turbo 8 步(1.75)的 1.9 倍。 那要几步才够? 8 步勉强、20 步进入平台、50 步只有 2D 还在变好。3D 组 20→50 步静止区抖动 2.293→2.316(不降反微升),多花 2.5 倍时间买不到东西。 和现在参赛的 int8+turbo 8 步比呢? 同一步数下基模全面落后:8 步静止区抖动 2.526 vs 1.752(差 44%),相对锐度 0.039 vs 0.102。基模要 20 步才接近 turbo 8 步的观感,但时间从 585 s 涨到 1672 s(2.9 倍)。 建议怎么交? 规则允许加速 LoRA 就继续 int8+fp8 + turbo 8 步;不允许就用 int8 20 步(1218 s,画质与 bf16 20 步同级但快 27%);bf16 只在需要排查量化伪影时用,且步数选 20 不选 50。
1. 这次到底改了什么
1.1 注意力精度:int8 QK + fp8 P·V → BF16 QK + BF16 P·V
DiT 里每层注意力的算子
attn_prefix_self有两个精度参数:qk(出厂i8,分数 int8)和pv(出厂fp8)。 libr4d 内核attn_prefix_self_h128_bf16一行支持全部四种组合,所以只需要在算子声明处按环境变量切换:- 补丁:
opt11-attn-bf16.py→/home/magic629/radiance-h3-fullref/arch/minimaxh3/minimaxh3.cpp(源码备份minimaxh3.cpp.bak-attnbf16) - 开关:
static bool h3_attn_bf16()读RAD_H3_ATTN=="bf16";为真时不再声明k_i8 / k_scale / v_fp8 / v_scale四个量化操作数(多传会RAD_E_INVAL),改发RAD_STR("qk","bf16"), RAD_STR("pv","bf16"),Q/K/V 直接吃m.b_qkv - 与 VSA 互斥:
attn_bf16 && m.vsa直接返回RAD_E_INVAL
怎么确认它真的生效了(这一步差点踩坑,见 §6.7):
- 启动日志出现
[h3] DiT attention: BF16 Q.K and BF16 P.V (RAD_H3_ATTN=bf16) - 声明算子数从 1836 → 1736,正好少 2 个量化算子 × 50 个 DiT block
- pid 2139994(bf16):"39 of 1736 declared ops"
- pid 2140394(int8):"41 of 1836 declared ops"
1.2 去掉 turbo 加速 LoRA
新增 drop-in
/etc/systemd/system/radiance-h3fullref.service.d/96-attn-bf16-nolora.conf:ExecStart=复位后重写启动行,删掉--lora/--max-loras/--max-lora-rank,请求体里也pop掉loras。显存预算沿用 11-16 基线的--host-pool-mib 12288 --gpu-headroom-mib 4096,便于逐步对比。引擎侧的显存账(每卡):
带 LoRA 槽(11-16 基线) 无 LoRA(本次) vram_weights预算11.31 GiB 12.12 GiB(+0.81 GiB) 静态常驻显存 5.39 GiB 6.29 GiB(+0.90 GiB) pinned pool 槽位 75 70 也就是说:去掉 LoRA 反而让引擎多常驻了 0.9 GiB 权重、少了一批 offload 换入换出。本次 bf16 是带着这点便宜还比 int8 慢 38%,纯注意力的代价只会比 38% 更大。
1.3 其它保持不变
--kernels libr4d(gfx12xx 原生内核)、--placement layer_offload、--p2p off、--vision-tower-placement ram、TP2、Triton 关闭、seed 145、帧数法则 17n+5 → 294 帧。步数按 prepare 的约定num_inference_steps = 名义步数 + 1(4→5、8→9、20→21、50→51)。回退:
sudo rm /etc/systemd/system/radiance-h3fullref.service.d/96-attn-bf16-nolora.conf && sudo systemctl daemon-reload(int8 旧二进制备份在/home/magic629/radiance-bin-backup-20261117-003218)。
2. 片子清单(9 条,规格已逐条 ffprobe 校验)
全部 1344×768 / 294 帧 / 24 fps / 12.25 s / h264,落在
D:\R9700\影视\bf16\:文件 注意力 LoRA 名义步数 体积 h3-3d-4step.mp4/h3-2d-4step.mp4bf16 无 4 14.4 MB / 16.0 MB h3-3d-8step.mp4/h3-2d-8step.mp4bf16 无 8 14.6 MB / 16.6 MB h3-3d-20step.mp4/h3-2d-20step.mp4bf16 无 20 13.0 MB / 13.8 MB h3-3d-50step.mp4/h3-2d-50step.mp4bf16 无 50 11.6 MB / 11.6 MB h3-int8-3d-4step-nolora.mp4int8+fp8 无(槽在) 4 14.6 MB
3. 时间成本
引擎自计(
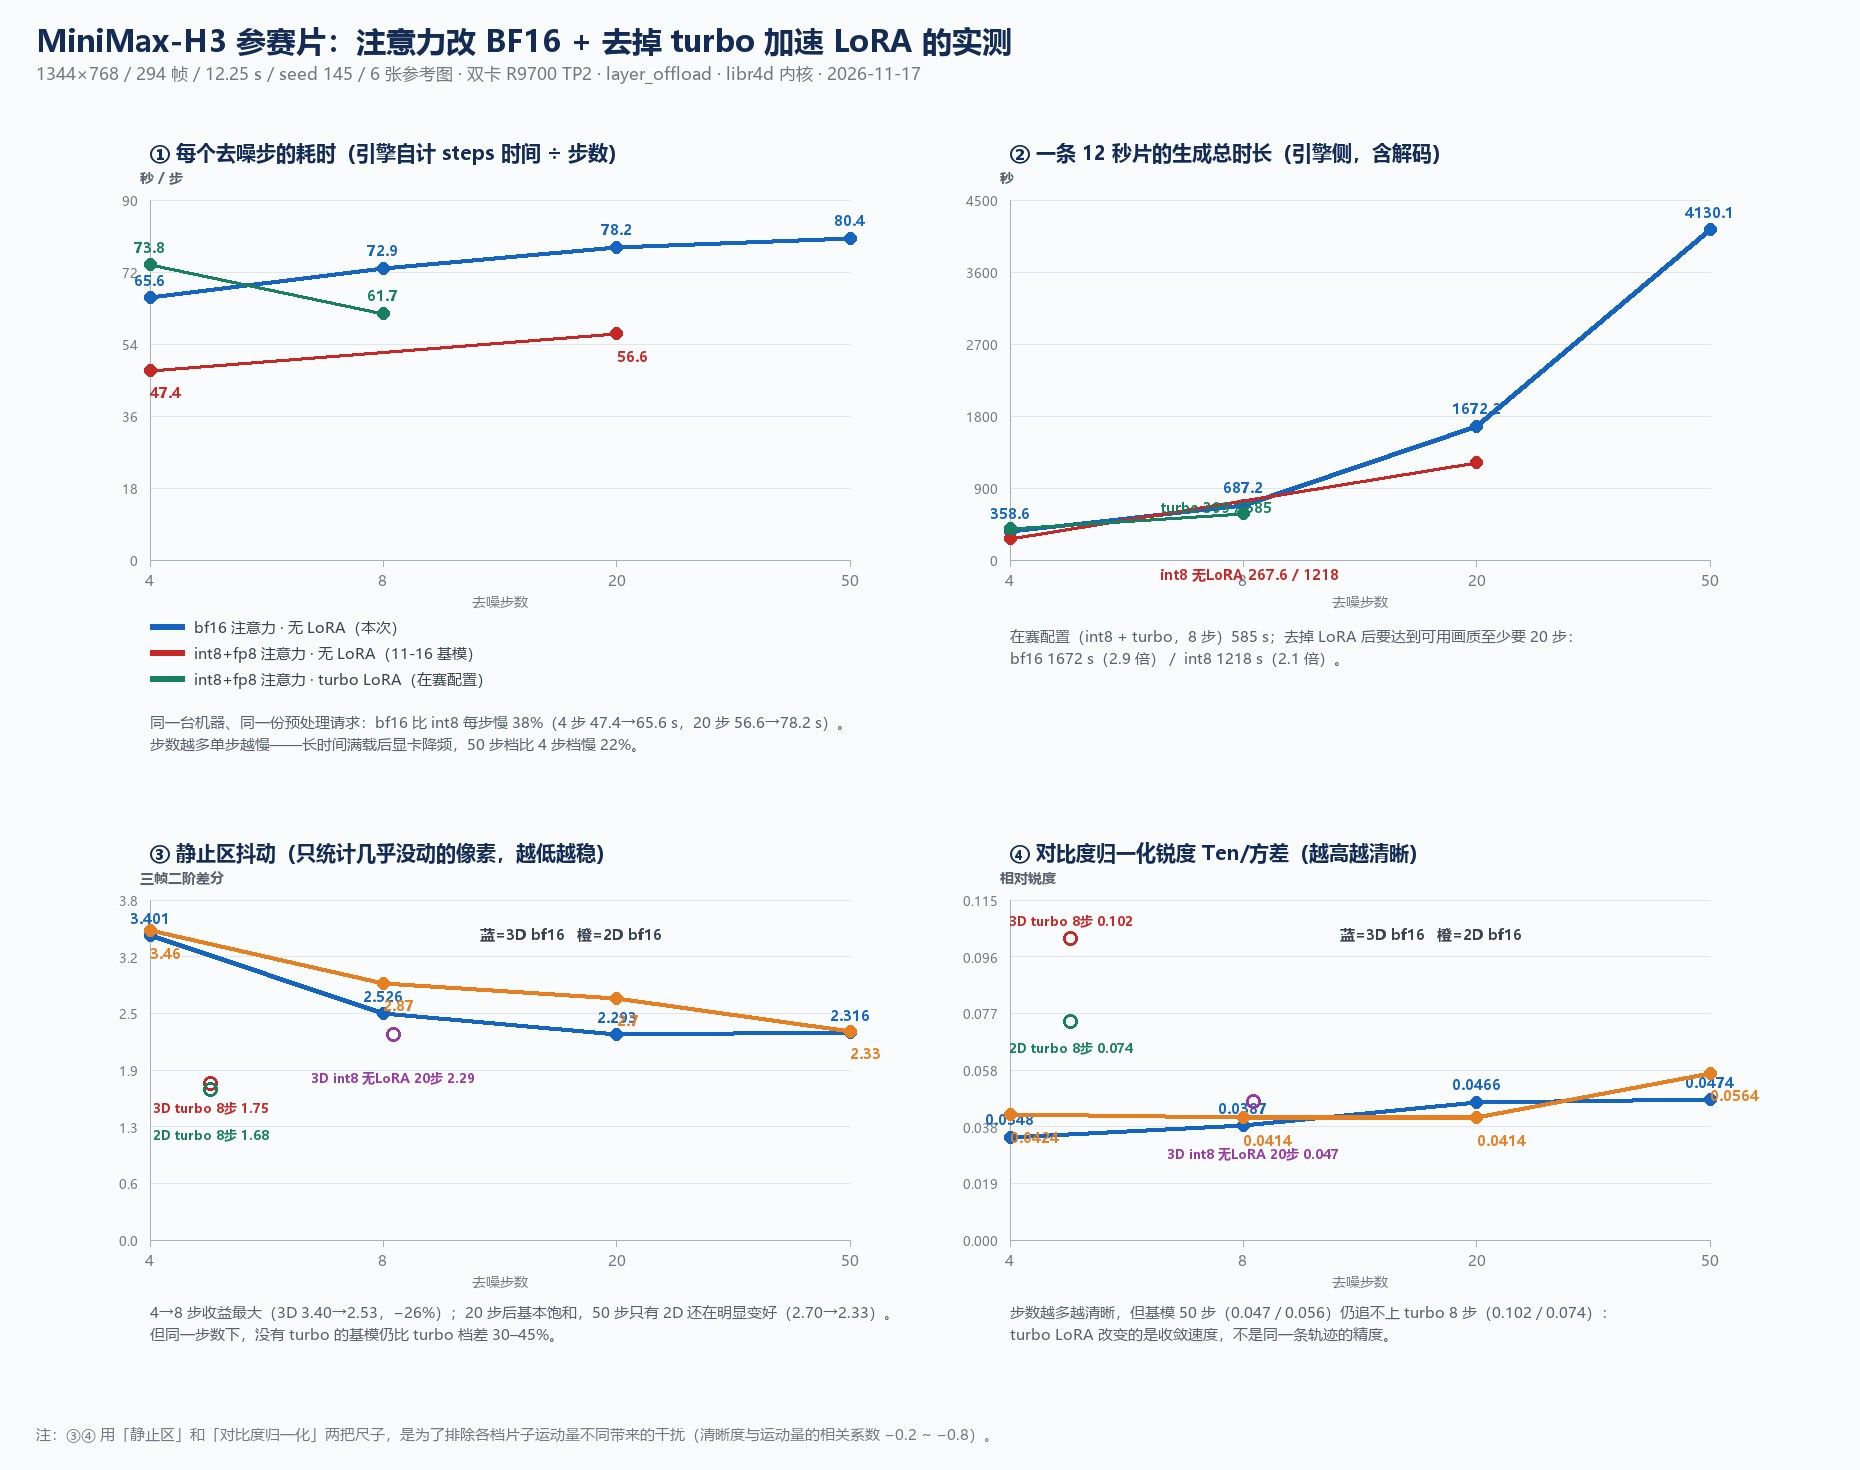
steps是纯去噪,decode是 VAE 解码,固定 30.5 s 左右):档位 请求步数 3D steps 3D 总时长 2D 总时长 每步 4 步 5 328.0 s 358.6 s 359.2 s 65.6 s 8 步 9 656.5 s 687.2 s 684.4 s 72.9 s 20 步 21 1641.2 s 1672.2 s 1669.6 s 78.2 s 50 步 51 4099.6 s 4130.1 s 4132.2 s 80.4 s 横向对照(同一台机器、同一份预处理请求):
配置 4 步 8 步 20 步 50 步 int8+fp8 + turbo LoRA(在赛配置) 399 s 585 s — — int8+fp8 无 LoRA 267.6 s — 1218 s — bf16 无 LoRA(本次) 358.6 s 687.2 s 1672.2 s 4130.1 s 两个要点:
- BF16 注意力 = 每步 +38%。4 步档 47.4→65.6 s/步(+38.5%),20 步档 56.6→78.2 s/步(+38.2%),两档独立测出的比例一致。注意 bf16 路径其实还省掉了 100 个量化算子并多常驻 0.9 GiB 权重,所以纯注意力的开销 ≥38%——int8 QK / fp8 P·V 吃的是 tensor core 的双倍吞吐,libr4d 的 bf16 注意力内核没有这个红利。
- 步数越多、单步越慢:65.6 → 80.4 s/步(+22.6%)。这是长时间满载后显卡降频,不是算法问题。50 步档的时间预算必须按 80 s/步 估,不能按短跑的 65 s/步。
4. 画质 A/B:只换注意力精度
同 prompt、同 6 张参考图、同 seed 145、同 4 步、同 3D 组,唯一变量是
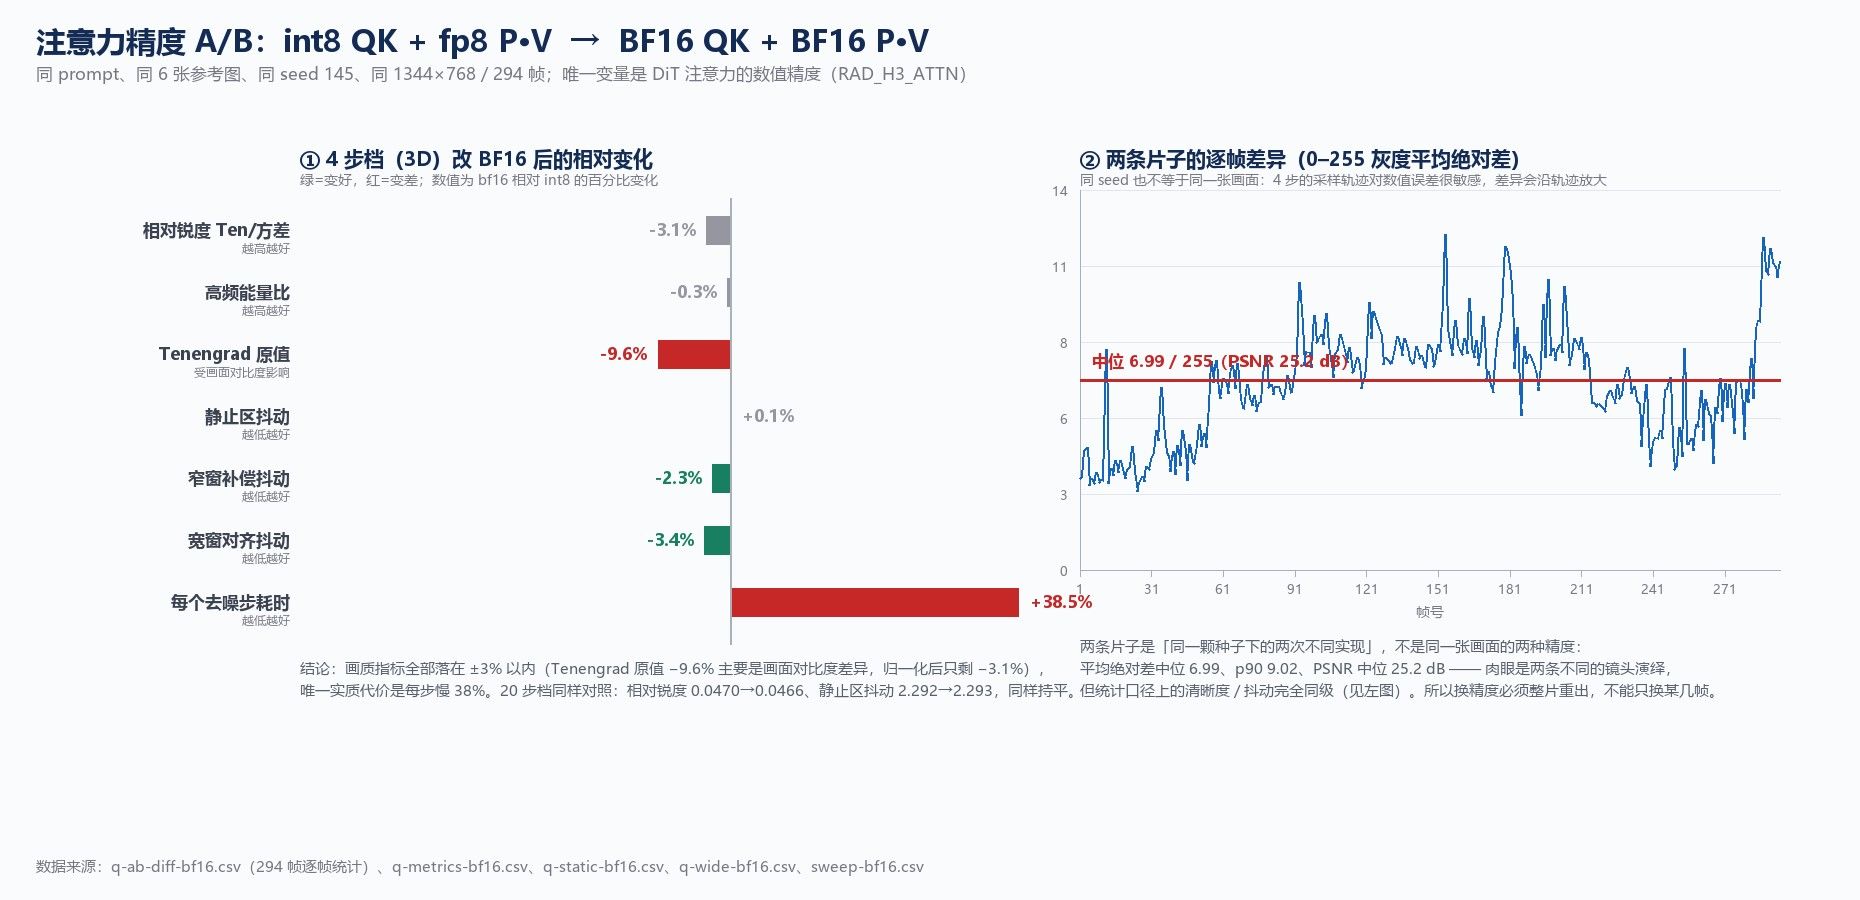
RAD_H3_ATTN:指标(294 帧中位数) int8 QK + fp8 P·V BF16 QK + BF16 P·V 变化 Tenengrad 原值 70.10 63.39 −9.6% 相对锐度 Ten/方差(对比度归一化) 0.0359 0.0348 −3.1% 高频能量比 0.00523 0.00522 −0.3% 帧差 mdiff(运动量) 14.18 13.81 −2.6% 抖动 jitter 28.05 27.69 −1.3% 补偿抖动 jitter_comp 26.54 25.92 −2.3% 静止区抖动(只统计几乎没动的像素) 3.399 3.401 +0.1% 宽窗对齐抖动(±24 px) 38.72 37.41 −3.4% 每步耗时 47.4 s 65.6 s +38.5% 20 步档的第二次独立对照(11-16 的 int8 基模 vs 本次 bf16):相对锐度 0.0470→0.0466、静止区抖动 2.292→2.293、Ten 119→116。两次 A/B 结论一致:画质持平,只慢不变。
4.1 一个必须写进提交说明的现象:换精度 = 重出整片
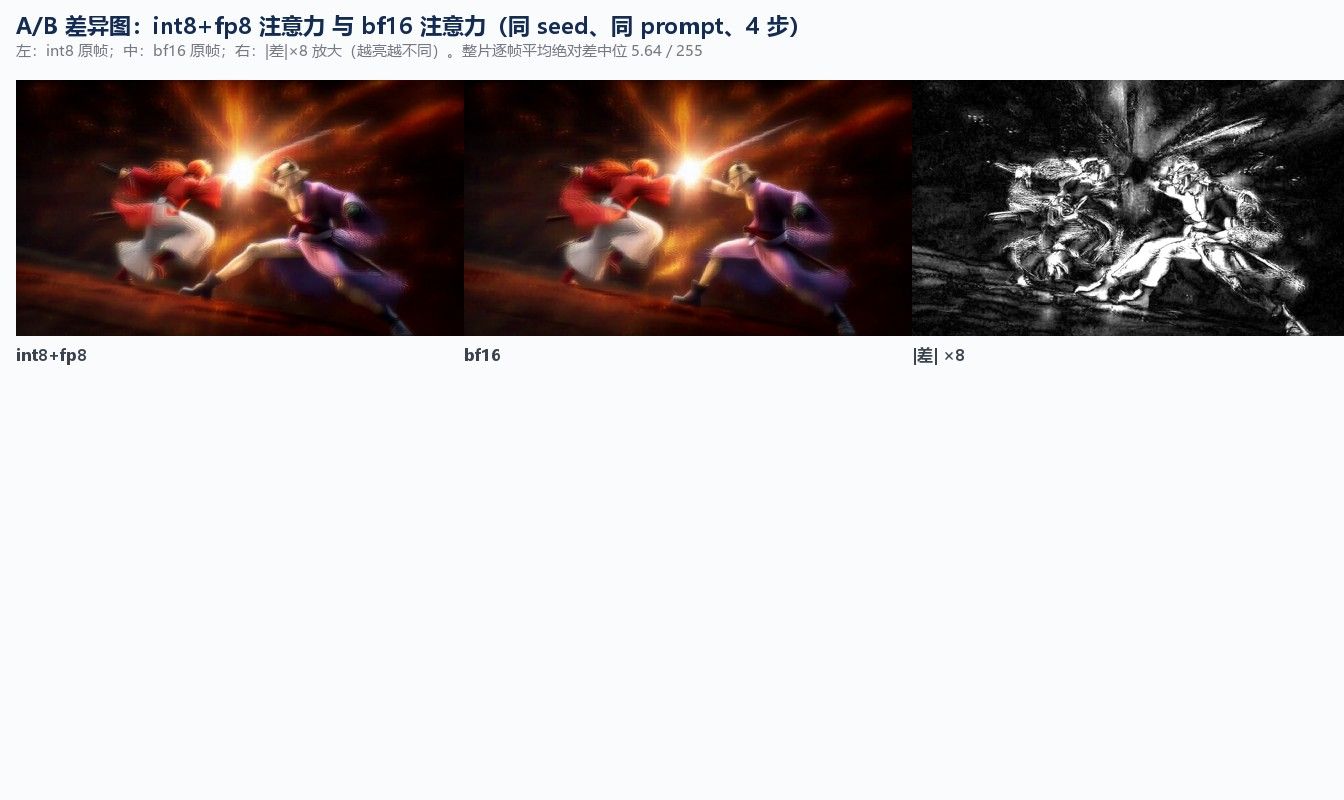
两条片子的逐帧平均绝对差(0–255 灰度):中位 6.99、p90 9.02、最大 12.34,PSNR 中位 25.2 dB、最低 20.2 dB。
也就是说:同 seed ≠ 同一张画面。4 步的采样轨迹对数值误差很敏感,精度一换,整条轨迹就走到另一个解上——肉眼是"同一场戏的两种演绎"(构图、动作节拍都不同),只是统计口径上的清晰度/抖动完全同级。所以:
- 换精度必须整片重跑重交,不能只替换某几帧、也不能和旧片混剪;
- 反过来,这也说明 int8 量化并没有把画面"量化坏",它只是把轨迹推到另一个同样好的解。
5. 画质:去掉 LoRA 之后到底要几步
5.1 全档对照(294 帧中位数)
3D CGI 组
注意力 LoRA 步数 Ten 高频比 相对锐度 运动 mdiff 补偿抖动 静止区抖动 宽窗抖动 每步 s int8+fp8 turbo 4 266 0.0097 0.099 10.05 24.23 1.994 19.36 73.8 int8+fp8 turbo 8 229 0.0104 0.102 2.73 7.00 1.752 4.49 61.7 int8+fp8 基模 20 119 0.0049 0.047 15.35 35.48 2.292 38.99 56.6 int8+fp8 基模 50 153 0.0052 0.049 8.87 27.90 2.374 — — int8+fp8 无 4 70 0.0052 0.036 14.18 26.54 3.399 38.72 47.4 bf16 无 4 63 0.0052 0.035 13.81 25.92 3.401 37.41 65.6 bf16 无 8 123 0.0039 0.039 13.83 30.95 2.526 26.41 72.9 bf16 无 20 116 0.0051 0.047 16.50 37.33 2.293 41.25 78.2 bf16 无 50 131 0.0052 0.047 12.56 31.23 2.316 35.35 80.4 2D 动画组
注意力 LoRA 步数 Ten 高频比 相对锐度 运动 mdiff 补偿抖动 静止区抖动 宽窗抖动 每步 s int8+fp8 turbo 8 169 0.0067 0.074 2.61 7.24 1.681 3.37 61.5 int8+fp8 基模 20 120 0.0040 0.040 9.78 34.60 2.749 36.74 56.6 bf16 无 4 78 0.0068 0.042 16.68 29.32 3.458 43.66 65.7 bf16 无 8 128 0.0044 0.041 16.29 34.28 2.869 39.38 72.6 bf16 无 20 120 0.0043 0.041 10.12 37.19 2.704 34.91 78.0 bf16 无 50 202 0.0055 0.056 5.42 25.10 2.333 18.62 80.4 怎么读这张表:清晰度与运动量的相关系数在 −0.2 ~ −0.8 之间(画面动得越猛,单帧越糊),所以跨档比 Tenengrad 原值会被"这条片子动了多少"污染。真正干净的尺子是两把:静止区抖动(只统计三帧内几乎没动的像素,合法运动被剔除)和相对锐度(Ten 除以画面对比度)。下文结论都建立在这两把尺子上。
5.2 步数收益曲线(bf16 无 LoRA)
4 步 8 步 20 步 50 步 3D 静止区抖动 3.401 2.526 2.293 2.316 3D 相对锐度 0.0348 0.0387 0.0466 0.0474 2D 静止区抖动 3.458 2.869 2.704 2.333 2D 相对锐度 0.0424 0.0414 0.0414 0.0564 一条片耗时 359 s 687 s 1672 s 4130 s - 4→8 步是收益最大的一跳:3D 静止区抖动 3.401→2.526(−26%),画面从"看不出是谁"变成"能看清招式"。
- 8→20 步继续变好但边际递减:3D 静止区 2.526→2.293(−9%),相对锐度 0.039→0.047。
- 20→50 步基本饱和:3D 静止区 2.293→2.316(不降反微升 1%),相对锐度 0.0466→0.0474(+1.7%)。多花 2.5 倍时间(1672→4130 s)买不到可感知的改善。
- 2D 组是唯一还在明显受益的:静止区 2.704→2.333(−14%)、相对锐度 0.041→0.056。但要注意 2D 50 步这条片子运动量特别小(mdiff 5.42 vs 20 步的 10.12),Ten 202 里有一部分是"画面动得少"送的;静止区抖动 2.333 才是干净证据。
5.3 与在赛配置(int8 + turbo 8 步)的差距
同一步数(8 步)横向比:
指标 turbo 8 步 bf16 无 LoRA 8 步 基模差多少 3D 静止区抖动 1.752 2.526 差 44% 3D 相对锐度 0.102 0.039 只有 38% 2D 静止区抖动 1.681 2.869 差 71% 2D 相对锐度 0.074 0.041 只有 56% 而且基模连 50 步都追不上 turbo 8 步(3D 相对锐度 0.047 vs 0.102)。原因不是"turbo 让画面更锐"这么简单:turbo LoRA 改变的是收敛速度,它让 8 步就走到基模需要几十步才走到的分布上;同时 turbo 片的运动量本身也小得多(mdiff 2.73 vs 13.83),所以观感上"又稳又干净"。结论是:turbo LoRA 是这次参赛配置里性价比最高的一项,去掉它的代价远大于把注意力改成 bf16。
5.4 肉眼对照
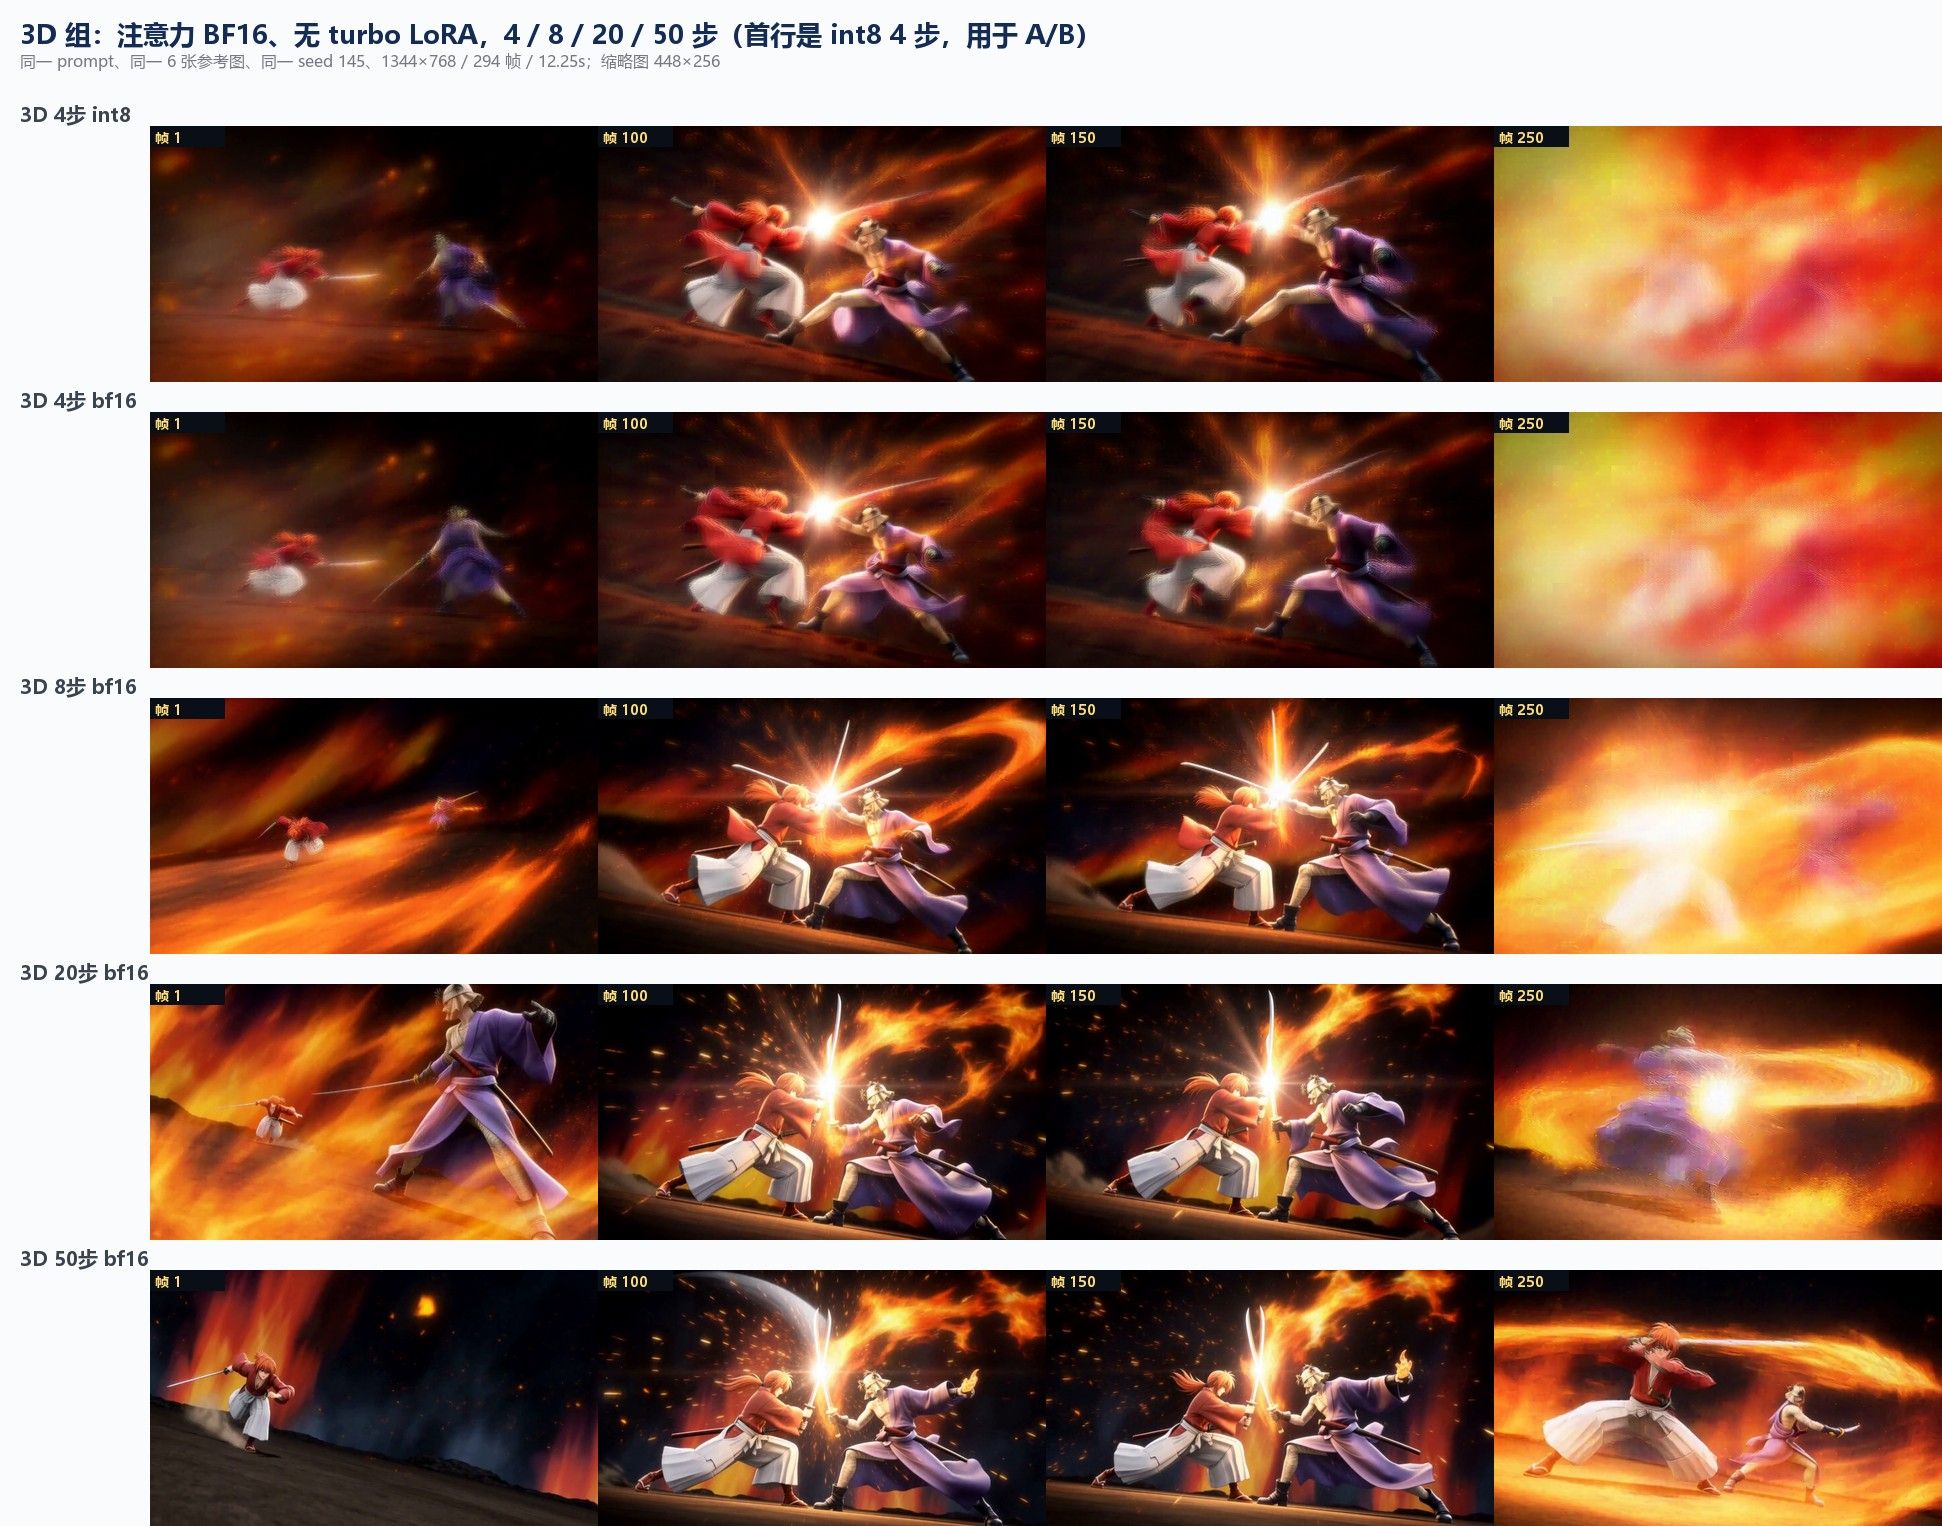
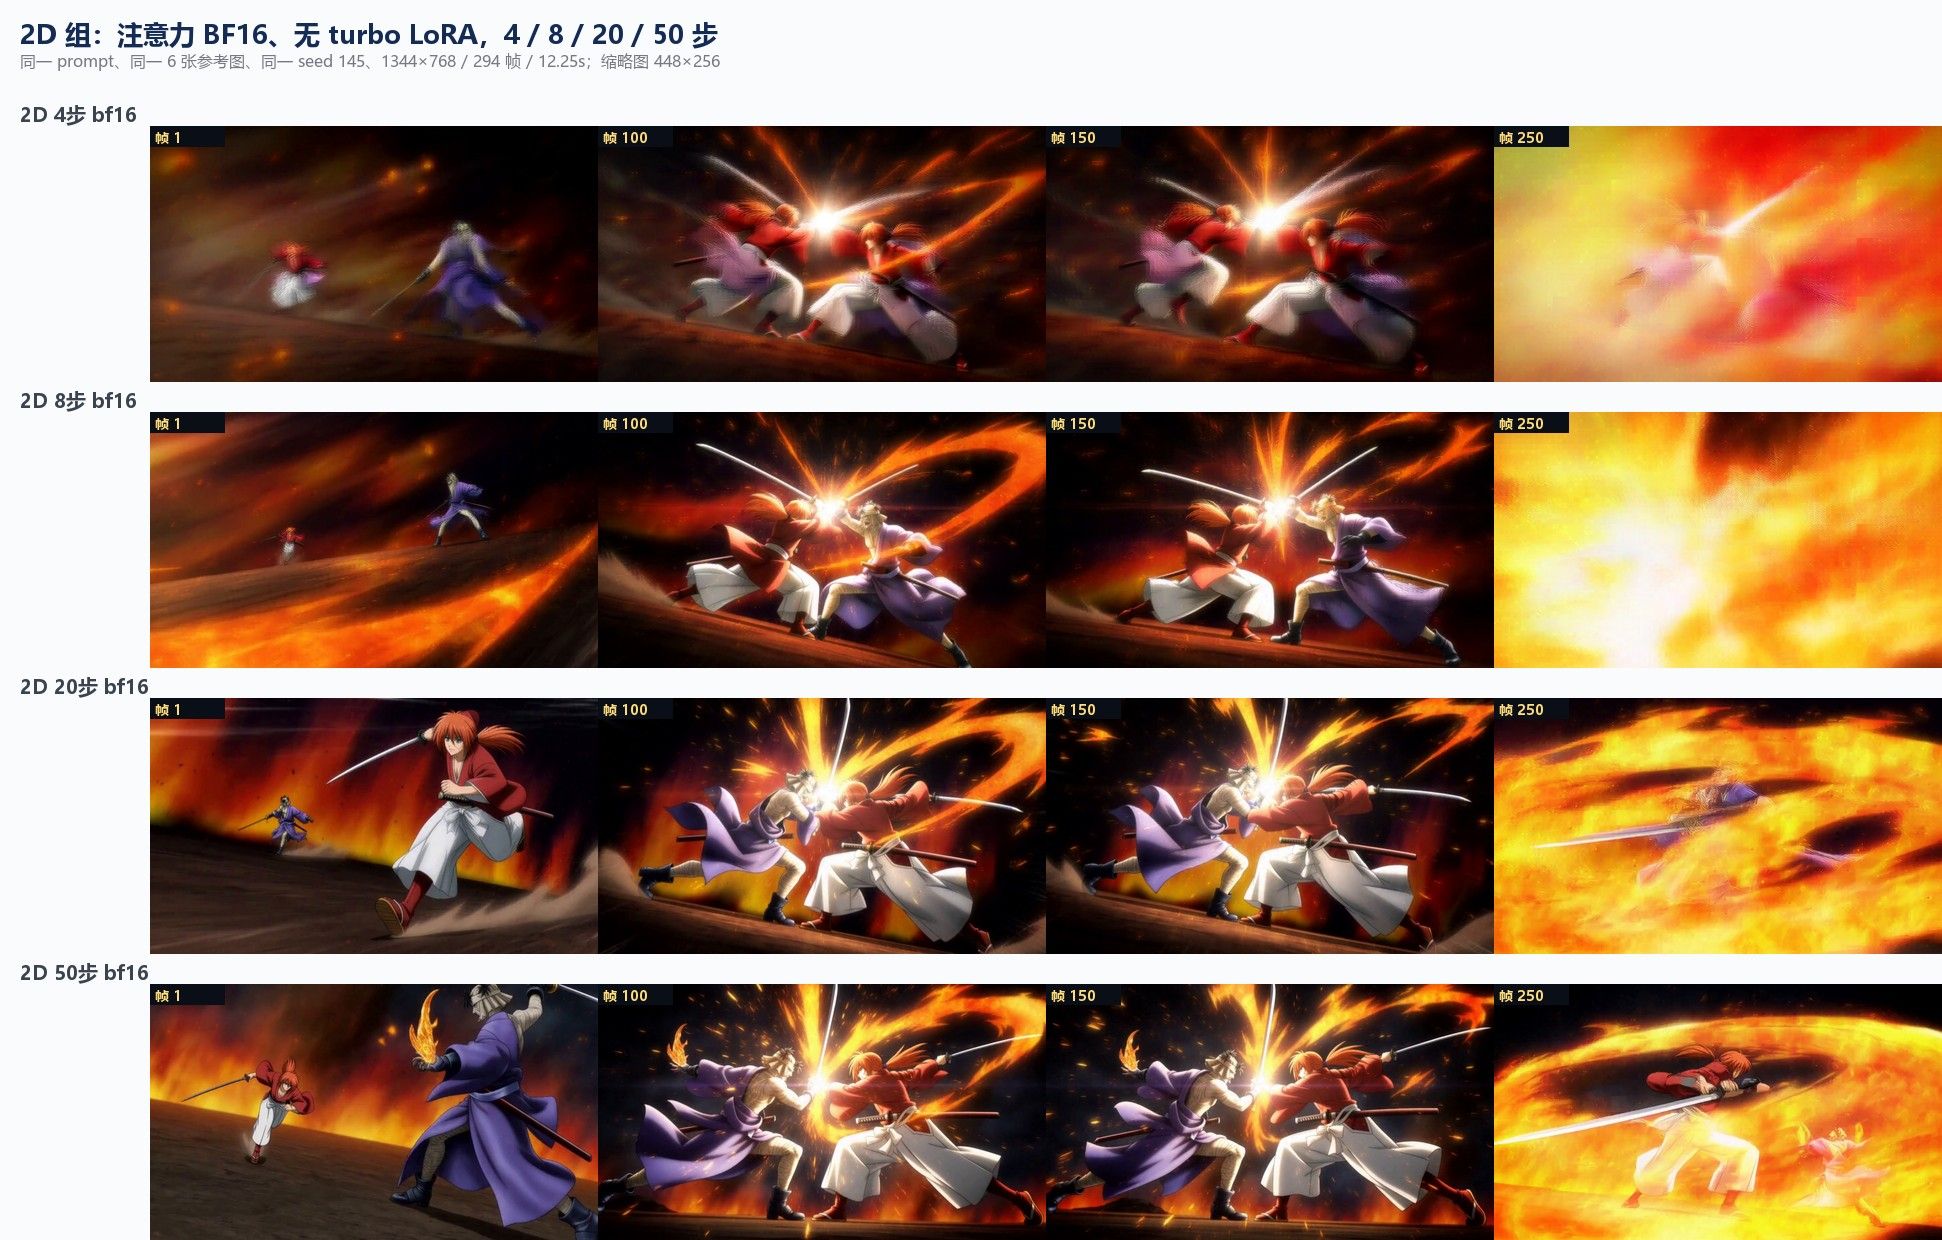
3D 组(首行是 int8 4 步,用于 A/B):
2D 组:
100% 原尺寸细节裁块(帧 150,画面中部 336×192):
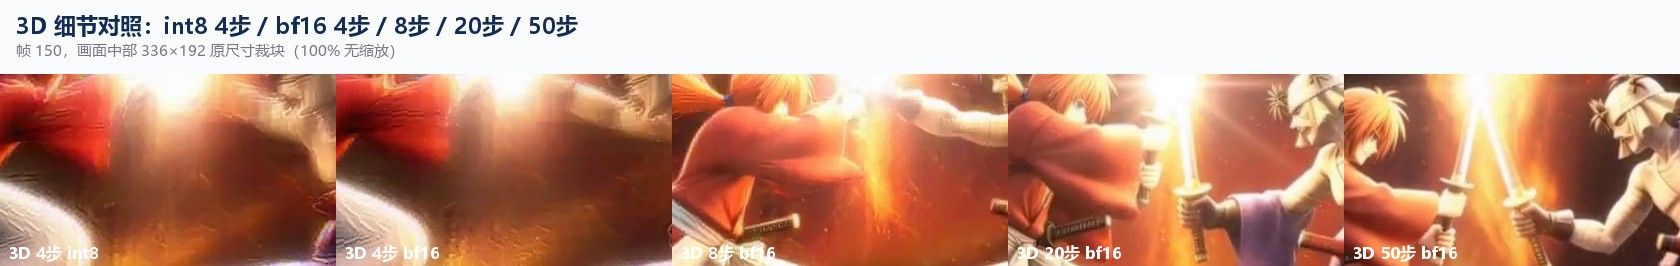
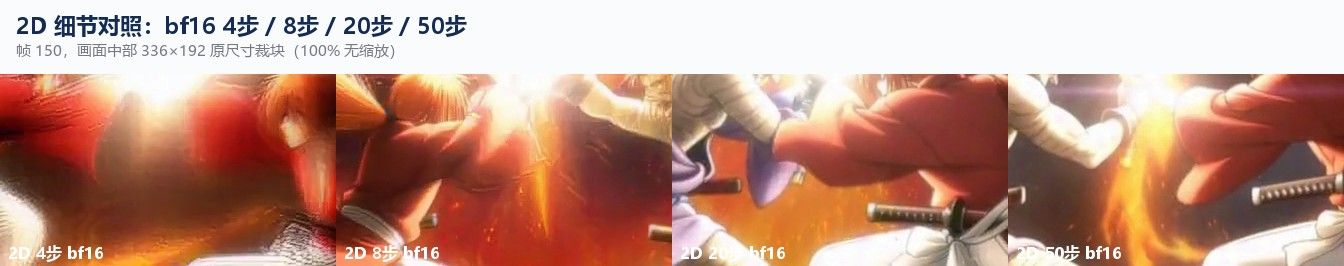
肉眼判读:4 步(int8 与 bf16 都一样)人物边缘糊、帧 250 整幅是火焰糊块,不能参赛;8 步结构成立、可看但细节软;20 步人物/衣料/火星清晰,达到参赛线;50 步最干净(尤其 2D 的线稿与平涂),但相对 20 步的提升远不如 8→20 那一跳。
另外提醒:不同步数之间不是同一个镜头。步数改变整条采样轨迹,帧 1 在四档里是四个不同构图,所以跨档比较的是"质量水平",不是"同一张图的两个版本"。
6. 优化建议
A. 参赛提交层面
- 规则允许加速 LoRA → 维持现配置:int8+fp8 注意力 + turbo LoRA + 8 步,585 s 一条,静止区抖动 1.75、相对锐度 0.102,是所有档位里画质/时间比最优的。本次两项改动都不建议进提交配置。
- 规则不允许 LoRA → 用 int8 20 步,不要用 bf16:20 步档 bf16 与 int8 画质同级(相对锐度 0.0466 vs 0.0470、静止区 2.293 vs 2.292),但 int8 快 27%(1218 s vs 1672 s)。bf16 只在两种情况下值得:① 排查 int8/fp8 量化在特定镜头上的条纹/带状伪影;② 需要与参考实现做数值对齐。
- 步数选 20,不要 50:3D 组 20→50 步静止区抖动不降反升,多花 2458 s(41 分钟);2D 组若要冲画质可以单独给 2D 上 50 步(静止区 −14%),3D 保持 20 步。
- 无 LoRA 时的补救顺序:先 20 步,再考虑后期(轻度高通锐化 + 去闪烁)。本次数据里 20 步的静止区抖动 2.29 已经和 int8 基模 50 步(2.37)持平,后期处理比再加 30 步划算。
B. 服务器工程层面
- bf16 注意力的 38% 有优化空间:这是在"少 100 个量化算子 + 多 0.9 GiB 常驻权重"两个红利之下测出来的,说明 libr4d 的 bf16 注意力内核相对 int8/fp8 路径有明显差距(后者吃 tensor core 双倍吞吐)。若 bf16 要长期用,值得单独 profile
attn_prefix_self_h128_bf16的 tile/流水;若只是临时验证,用完就把RAD_H3_ATTN撤掉。 - 降频要计入时间预算:4 步档 65.6 s/步 → 50 步档 80.4 s/步(+22.6%)。跑 50 步档前把风扇曲线/功耗墙拉满,或拆成两段各 25 步中间歇几分钟;对外报时间一律按 80 s/步 估。
- 改插件必须单独重编(本次踩过的坑):架构是运行时加载的插件,
ninja -C build bin/radiance不会重编minimaxh3.so,第一次"bf16"实测其实是 int8。正确命令ninja -C build radiance_home/architectures/minimaxh3.so(2 秒)。验收两条:journal 里的 BF16 banner + declared ops 1836→1736。 - 省下的 LoRA 显存还能再吃:去掉 LoRA 槽后每卡多出 0.81 GiB 权重预算,引擎已自动转成常驻层(静态 5.39→6.29 GiB)。若还想再快,可试
--gpu-headroom-mib 4096 → 3072换更多常驻,但要盯 OOM 和首帧显存峰值。 - 换精度必须整片重出:同 seed 下 int8 与 bf16 逐帧平均绝对差中位 6.99/255(PSNR 25.2 dB),是两条不同演绎,不能只替换某几帧或与旧片混剪。提交材料里的 seed、精度、LoRA 三项要一起写清。
C. 建议补测(下次有 4 小时窗口就做)
- 10 / 12 / 15 步细扫:找无 LoRA 的最小可用点,20 步可能偏保守。
- 只把 QK 改 bf16、P·V 留 fp8(
qk=bf16, pv=fp8):内核已支持,可能用一半的速度损失换同样的数值稳定性。 --placement layer_offload与常驻比例扫描:结合第 8 条,看每步时间能不能压回 70 s 以内。- 2D 组 50 步 + 后期锐化 与 3D 组 20 步 + 后期锐化 做一次成片级 A/B,用同一套静止区抖动指标验收。
7. 数据与产物
内容 路径 9 条成片 D:\R9700\影视\bf16\*.mp4计时表 bf16\sweep-bf16.csv、bf16\sweep-int8-nolora.csv逐帧清晰度/抖动 q-metrics-bf16.csv(2646 行)静止区抖动 q-static-bf16.csv宽窗对齐抖动 q-wide-bf16.csvint8  bf16 逐帧差
q-ab-diff-bf16.csv(294 行)灰度帧库(9×294) D:\R9700\影视\q-frames-bf16\图表 bf16\图表-BF16与步数总览.png、bf16\图表-注意力AB.png、bf16\AB差异图-3D-4步-帧150.png对照墙/裁块 bf16\对照墙-3D-步数.png、bf16\对照墙-2D-步数.png、bf16\细节裁块-3D-帧150.png、bf16\细节裁块-2D-帧150.png脚本 tools\q11-extract-bf16.ps1、q12-bf16.py、q13-compare.py、q14-abdiff.py、q15-sheet.py、q16-chart.py、q17-abchart.py、opt11-attn-bf16.py、h3-bf16-sweep.sh服务端日志 /home/magic629/h3-bf16/sweep.log、run-<tag>.log、start-<tag>.log指标定义(与 11-16 的 int8 基线完全同一套代码,可直接横比):
Tenengrad= mean(gx² + gy²),全分辨率梯度能量;LapVar= 拉普拉斯方差;高频比= 频谱中 r>0.25 的能量占比。相对锐度= Tenengrad ÷ 画面亮度方差,削弱"内容本身多糊/多平"的干扰。mdiff= mean|f(t)−f(t−1)|,运动+抖动混合能量;jitter= mean|f(t−1)−2f(t)+f(t+1)|,时域高通,平滑运动被抵消;jitter_comp= 同上但先做 ±4 px 全局平移补偿。静止区抖动= 只在"连续三帧几乎没动"(阈值 6/255)的像素上算二阶差分,火焰/人物/衣料等合法运动被剔除。宽窗对齐抖动= 中心 480×288 区域、±24 px 搜索全局对齐后的二阶差分,用来排除"快速运镜"。
服务器当前状态:视频服务
radiance-h3fullref已让出显存(inactive),LLMradiance-flashnext已恢复并实测可用(/v1/modelsHTTP 200、chat 补全正常)。
8. 视频展示
h3-2d-4step.mp4
Youtube Videoh3-3d-4step.mp4
Youtube Videoh3-2d-8step.mp4
Youtube Videoh3-2d-20step.mp4
Youtube Videoh3-3d-20step.mp4
Youtube Videoh3-2d-50step.mp4
Youtube Videoh3-3d-50step.mp4
Youtube Video - 补丁:
-
-
-
这个50步的质量很好啊,没有抖动啊
-
-
大哥,50步的工作流给一个呗。
-
大哥,50步的工作流给一个呗。
-
-
我不明白。。。。看看到时候amd的价格回落,我再考虑买一块r9700pro来玩
-
我不明白。。。。看看到时候amd的价格回落,我再考虑买一块r9700pro来玩
-
,
 T terry 将此主题从 随便聊聊 移至此处
-
-
-



 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!