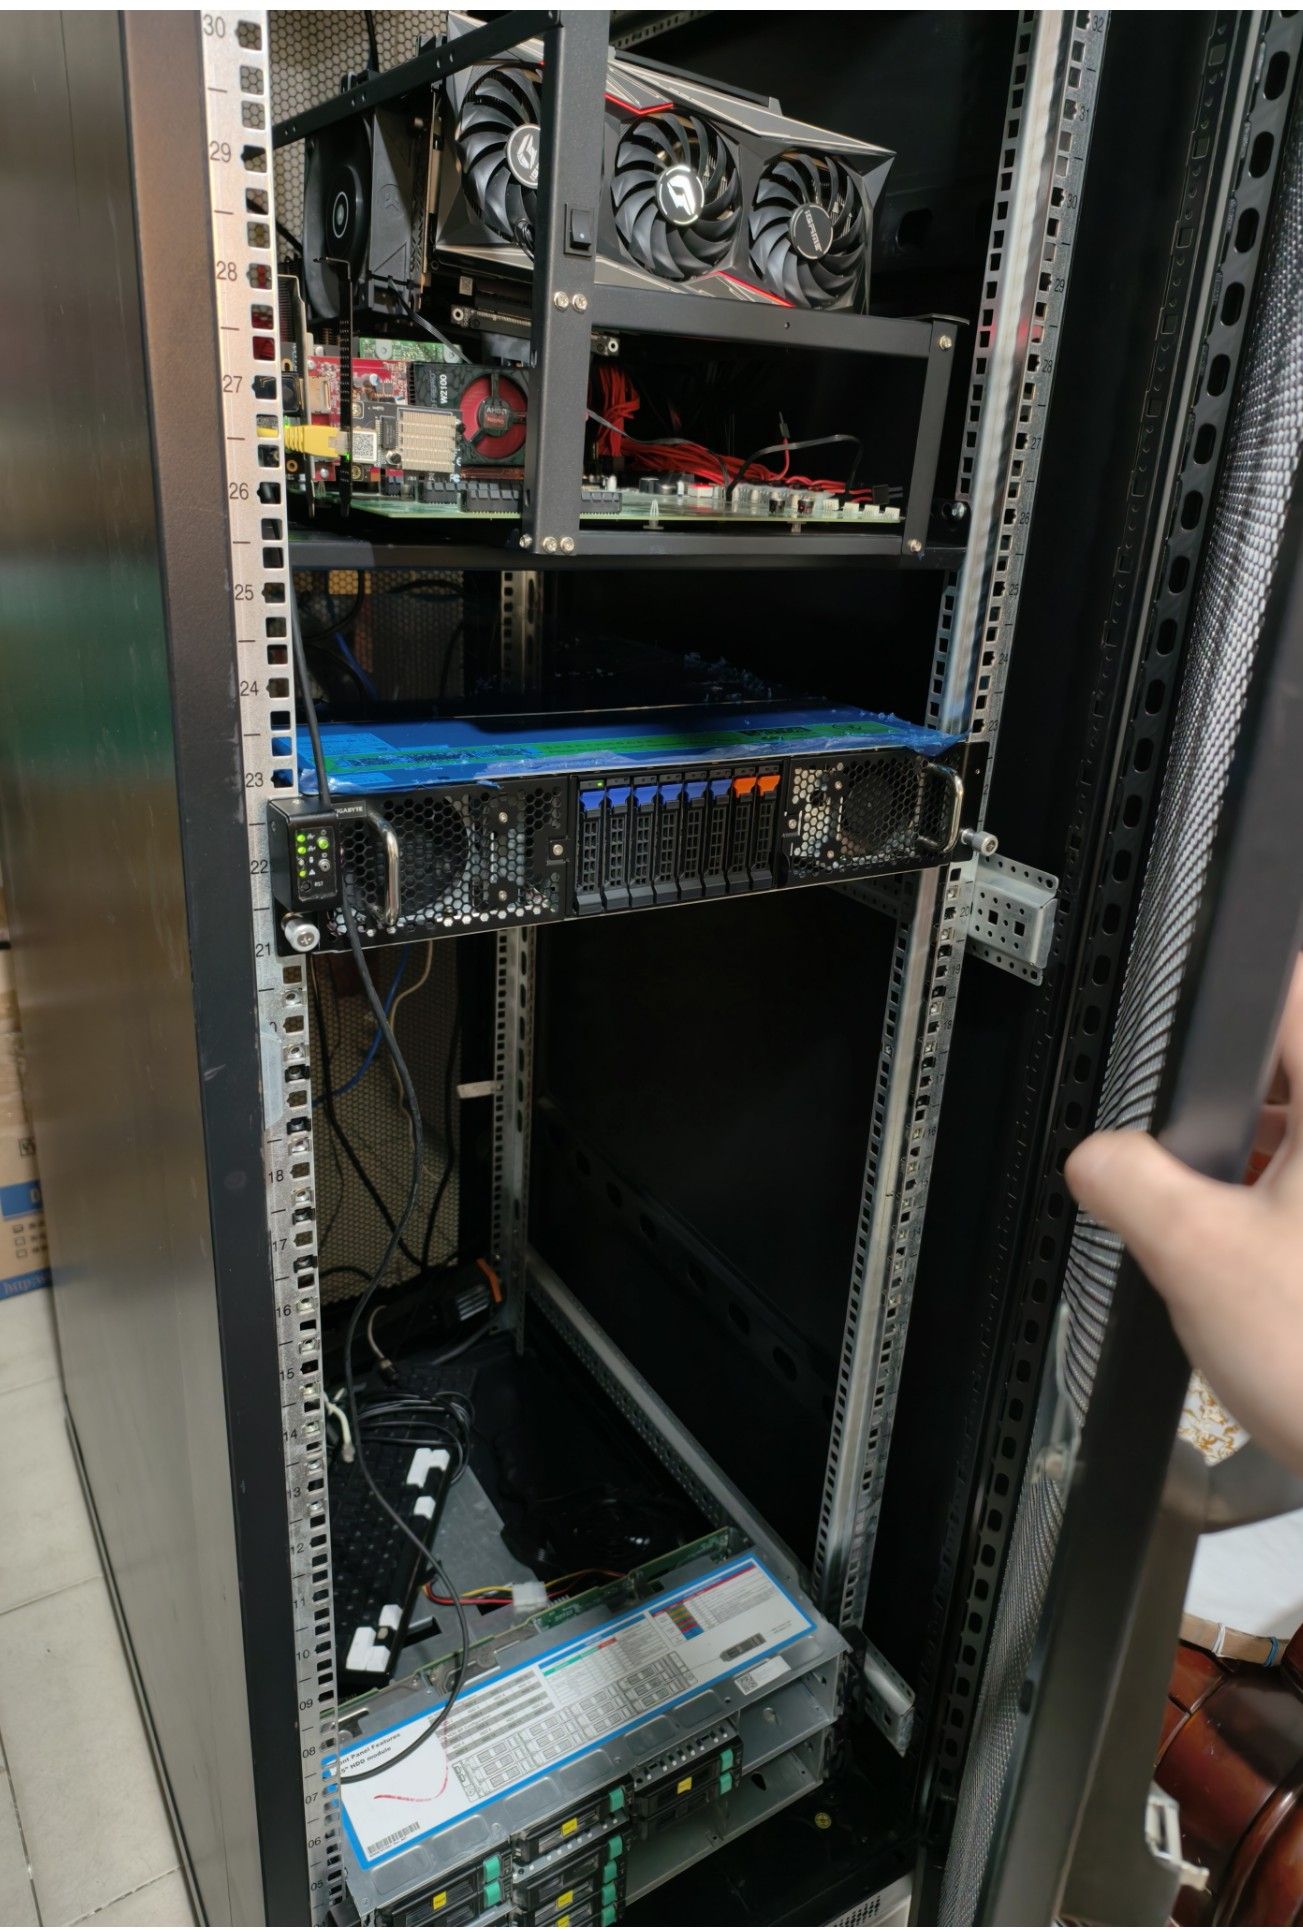
@kos-or
跑了2天全自动产线(hermes agent自动迭代、自动审图,人类只在台本确定阶段、图片转i2v阶段与最后审片阶段介入),单集6分半钟3语种+短视频28秒3语种,也就是全量加起来21分钟的视频(70%是5秒长镜头,30%是10秒长镜头),大概耗时9小时左右的样子。现在产线也正在重构,最近我也在学习其他做短剧的,哈哈,多塞点2 3秒的碎镜头,可以大幅提高产量
-
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现 -
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现 -
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现 -
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化 -
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化@kos-or https://lcz.me/topic/2138 哈哈 刚发的帖子~欢迎大佬莅临指导
-
MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现MiniMax H3 多卡分布式采样 + 跨机 3080 Ti 独立解码:8×Tesla T10 与 RX 7900 XTX 异构流水线实测与开源复现
硬件环境(8×Tesla T10 16GB / RTX 3080 Ti 12GB / RX 7900 XTX 24GB | 双机 10GbE DAC 直连 | ComfyUI + Raylight + xFuser)
MiniMax H3 是目前开源视频生成领域在动态质量、主体一致性与运镜表现上非常亮眼的扩散模型(DiT)。但它的本地部署门槛极高:模型参数量大(主 DiT INT8 约 20GB,Qwen3-VL 32B 条件编码器约 15GB,再加上 VAE 与 LoRA),单张 16GB 显存显卡在长视频或多模型加载时显存容易见顶;即使是 24GB 显存的大卡(例如单张 RX 7900 XTX)虽然跑 10 秒(736×1280)完全不会 OOM,但单卡生成一条往往需要近 14 分钟(实测约 860 秒),单卡串行吞吐遇到明显瓶颈;而如果让没有专用新架构单元的老旧计算卡去硬跑密集的视频 VAE 解码,速度又非常缓慢。
我们在本地通过两台局域网主机搭建了一套**“多卡分布式并行采样 + 10GbE 跨机高速传输 Latent + 独立消费级显卡专用 VAE 解码”**的异构流水线,成功在二手图灵老卡(Tesla T10,单卡仅 16GB 显存,类似半高版 RTX 2080 Ti)与消费级显卡(RTX 3080 Ti 12GB、RX 7900 XTX 24GB)之间实现了高效协同。
完整调度代码、工作流模板与复现补丁已开源:
 GitHub 仓库:https://github.com/peterhon168/h3-multigpu-pipeline
配套离线发布包:h3-multigpu-production-release-20261003.zip
实测视频:https://youtu.be/fUTG5CveZ9k本文记录完整的单任务时延、长视频容量极限、6 任务批处理吞吐矩阵、图灵架构(SM75)补丁细节与踩坑指南。所有命令与数据均来自真实工程实测。
一、先看结果:单任务、长视频容量与批量吞吐数据
0. 为什么必须解耦?对比单机(不带 3080 Ti)历史实测
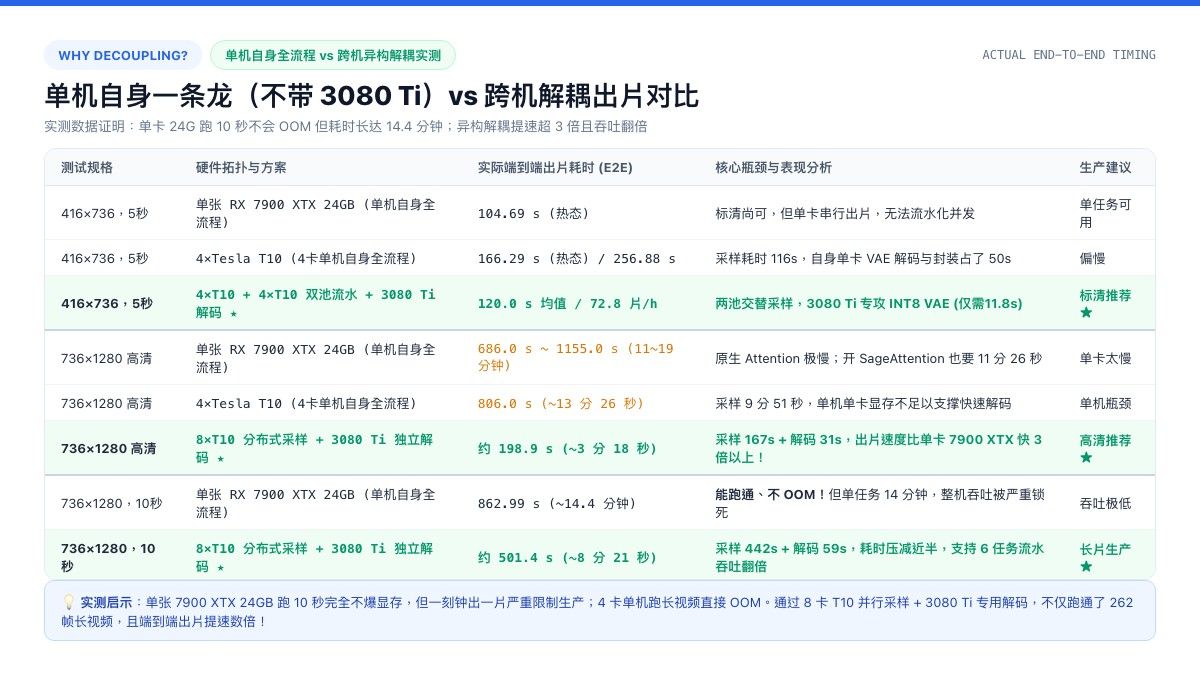
在做这套异构解耦之前,我们在两台主机上分别测过单机跑完全部流程(自身采样 + 自身解码,不接入 3080 Ti)的表现。正是这些痛点数据直接推动了我们做架构分工:
运行平台与方案 视频规格 实际端到端耗时 (E2E) 核心瓶颈与表现 单张 RX 7900 XTX 24GB (单卡自身全流程) 416×736,5 秒 104.69 s (热态) 标清尚可,但无法并行出片 单张 RX 7900 XTX 24GB (单卡自身全流程) 736×1280,5 秒 686.00 s ~ 1155.00 s (11~19 分钟) 原生 Attention 极慢;开启 SageAttention 也要 11 分 26 秒 单张 RX 7900 XTX 24GB (单卡自身全流程) 736×1280,10 秒 (243帧) 862.99 s (~14.4 分钟) 能跑通、不 OOM,但单任务太慢,整机吞吐被严重锁死 G292 4×Tesla T10 (4卡单机自身全流程) 416×736,5 秒 166.29 s (热态) / 256.88 s (冷态) 采样约 116 秒,但单机 VAE 解码与封装占了 50 秒 G292 4×Tesla T10 (4卡单机自身全流程) 736×1280,5 秒 806.00 s (~13 分 26 秒) 采样 9 分 51 秒,单机单卡显存不足以支撑快速解码 G292 8×Tesla T10 (同机单 T10 硬解既有 Latent) 736×1280,5 秒 仅解码尾段就占 72.59 s 缺乏专用量化解码器,单 T10 FP16 VAE 耗时是 3080 Ti 的 2.3 倍 数据对比直观结论:
- 单张 7900 XTX 24GB 跑 10 秒(736×1280)实测需要 14.4 分钟(862.99秒),虽然完全不爆显存,但一个人守在屏幕前等一刻钟出一片,批量生产根本无法维系;
- 4 张 T10 单机自身解码 跑 736×1280 同样长达 13.5 分钟,而且一旦挑战 10 秒长视频在采样阶段就直接 OOM;
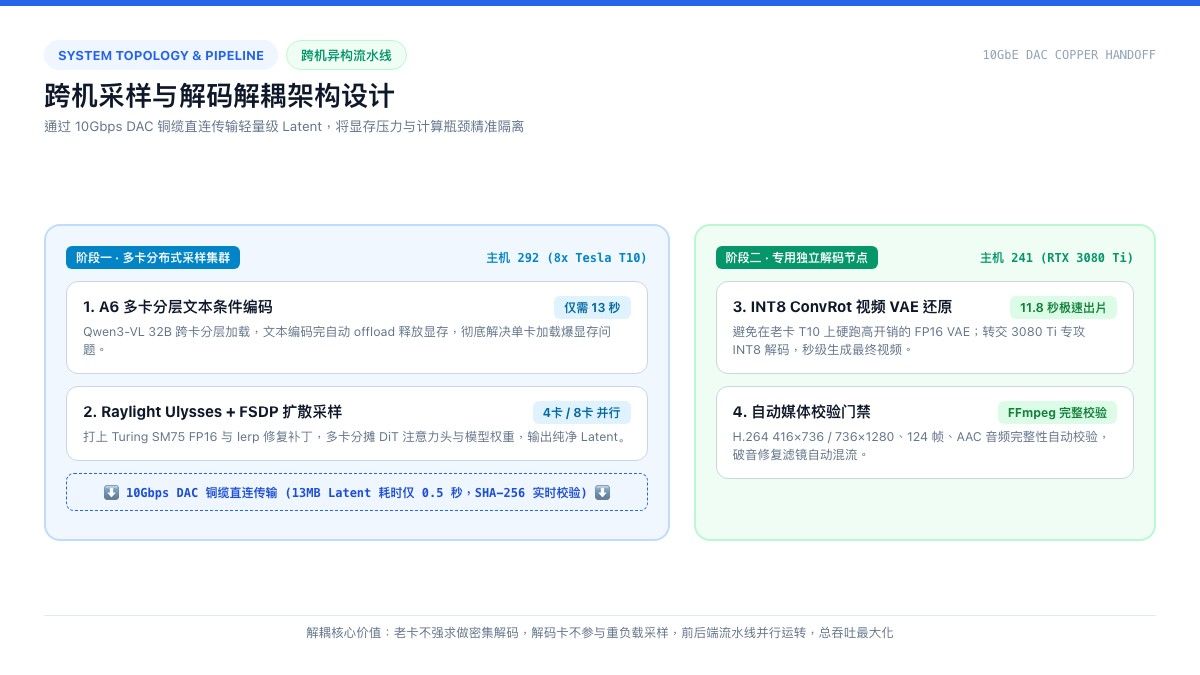
- 一旦我们把**“T10 专攻多卡 Ulysses 并行采样 + 3080 Ti 专攻 INT8 VAE 极速解码”**解耦后:
- 5 秒标清端到端直接从 166 秒砍到 120 秒;
- 8 卡跑 736×1280 5 秒采样仅需 167 秒,后方 3080 Ti 解码仅需 31 秒,整条视频出片压到了 3 分多钟(对比单卡 7900 XTX 的 11~19 分钟提速超 3 倍!);
- 10 秒高清视频从单卡 14.4 分钟缩短到 8 分钟出片,并且 6 任务批量出片吞吐直接翻倍。
本轮测试覆盖了单任务冷热启动采样时延、五秒标清六任务吞吐、高档 736×1280 五秒六任务矩阵、15 秒长视频容量边界,以及 10GbE DAC 铜缆直连传输。
采样耗时(提交到 ComfyUI history success)与解码尾段耗时(watcher 接收到 Latent 后到 SaveVideo success)各自独立计时,不能直接混淆或相加。
1. 单任务与长视频容量实测
采样/解码路线 规格尺寸 视频帧数 采样阶段耗时 解码尾段耗时 最终状态与冷热说明 4×T10 采样 → 3080 Ti 416×736,5 秒 124 帧 229.814 s 12.181 s 成功;冷模型首跑 8×T10 采样 → 3080 Ti 416×736,5 秒 124 帧 110.395 s 11.859 s 成功;耗时减少 52.0%(约 2.08× 加速) 8×T10 采样 → 3080 Ti 736×1280,5 秒 124 帧 167.286 s 31.654 s 成功;暖态稳定出片 8×T10 采样 → 3080 Ti 736×1280,10 秒 243 帧 442.110 s 59.319 s 成功;突破旧 4 卡显存极限 8×T10 采样 → 3080 Ti 544×960,15 秒 362 帧 328.725 s 50.405 s 成功;超长视频稳定出片 8×T10 采样 → 3080 Ti 640×1152,15 秒 — 约 204.389 s 后 OOM — 失败;探出当前 8 卡配置的物理容量极限 同机单 T10 硬解既有 Latent 736×1280,5 秒 124 帧 不适用 72.588 s 成功但缓慢;单 T10 FP16 VAE 耗时是 3080 Ti 的 2.3 倍 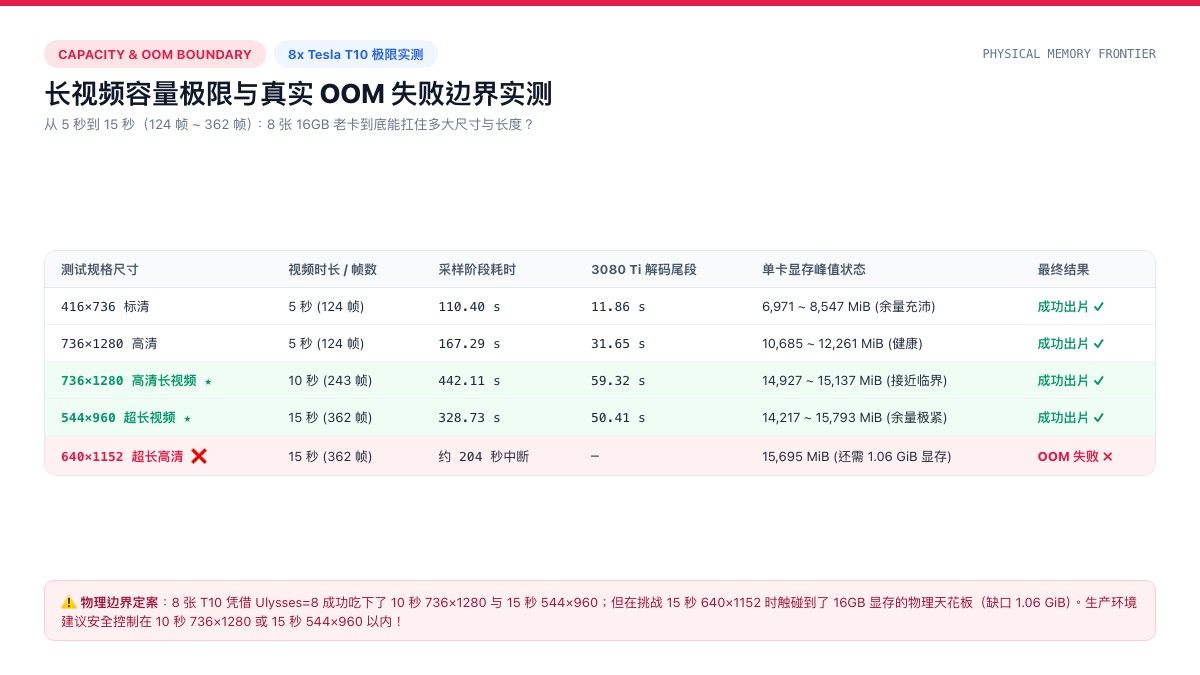
关键容量结论:
- 416×736、5 秒冷模型请求从 4 卡的 229.8 秒降至 8 卡的 110.4 秒,加速约 2.08 倍,证明 8 卡分布式能显著压低单任务等待。
- 8 卡成功拿下了 10 秒 736×1280(243 帧)与 15 秒 544×960(362 帧)长视频,解决了过去 4 卡运行长视频直接 OOM 的痛点。
640×1152 / 15 秒在运行约 204 秒后发生真实的torch.OutOfMemoryError:单卡 rank 还需 1.06 GiB 显存,但当时仅余 558.62 MiB,堆栈位于 MiniMax MLP/LoRA 路径。这划定了当前这套 6 步 Euler/simple 架构的物理显存天花板。
2. 连续 6 任务批处理吞吐矩阵(连续出片拓扑选择)
单任务时延低不代表批量吞吐高。我们固定 6 个随机种子(
987654321123–128),对比了不同集群拓扑在相同任务批次下的表现: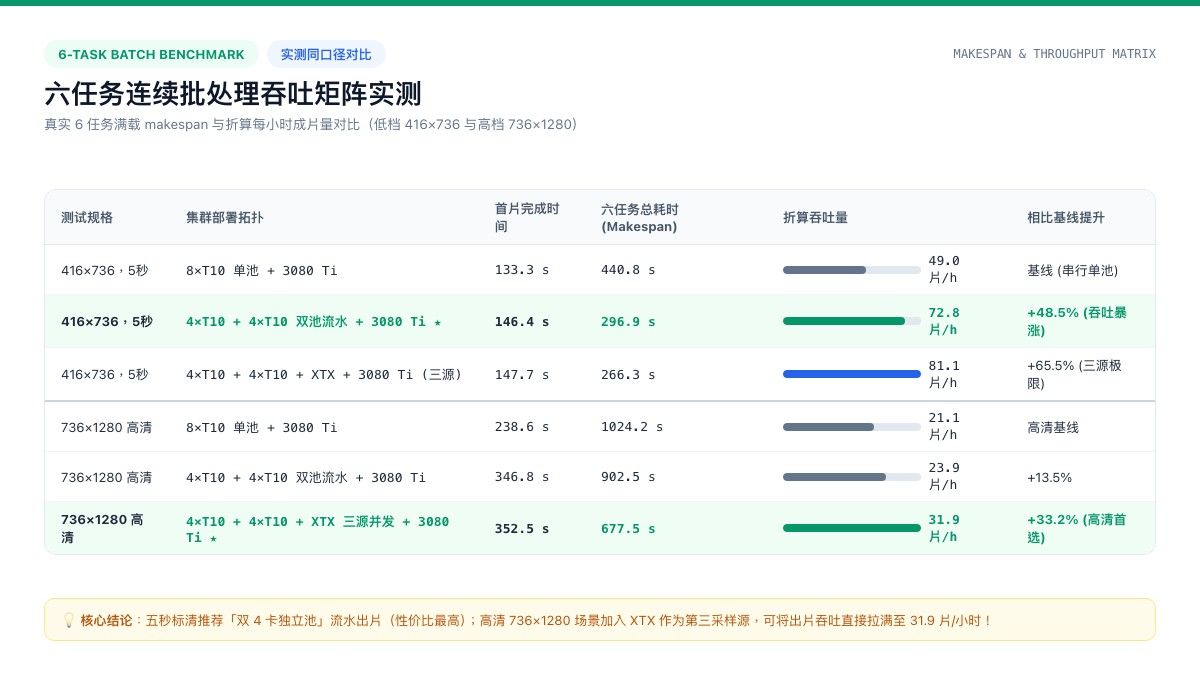
规格 集群部署拓扑 成功数 首片完成时间 六任务总耗时 (Makespan) 折算批次吞吐 416×736,5 秒 8×T10 单池串行 + 3080 Ti 6/6 133.314 s 440.791 s 49.00 片/小时 416×736,5 秒 4×T10 + 4×T10 双池并行流水 + 3080 Ti ★ 6/6 146.396 s 296.917 s 72.75 片/小时 (+48.5%) 416×736,5 秒 4×T10 + 4×T10 + XTX 三源并发 + 3080 Ti 6/6 147.707 s 266.324 s 81.10 片/小时 (+65.5%) 416×736,5 秒 8×T10 + XTX 双源并发 + 3080 Ti 6/6 136.910 s 332.706 s 64.92 片/小时 (+32.5%) 736×1280 高清 8×T10 单池串行 + 3080 Ti 6/6 238.642 s 1024.217 s 21.09 片/小时 736×1280 高清 8×T10 + XTX 双源并发 + 3080 Ti 6/6 241.279 s 945.328 s 22.85 片/小时 736×1280 高清 4×T10 + 4×T10 双池流水 + 3080 Ti 6/6 346.771 s 902.538 s 23.93 片/小时 736×1280 高清 4×T10 + 4×T10 + XTX 三源并发 + 3080 Ti ★ 6/6 352.477 s 677.538 s 31.88 片/小时 (+33.2%) 批量调度核心发现:
- 5 秒低档出片最佳拓扑:双 4 卡独立池流水(4+4+1)。把 8 张 T10 拆成两个独立的 4 卡并行池轮流出片,共用后端的 3080 Ti 解码队列。虽然第一张成片因分片采样略慢了 13 秒,但后续片子实现完美流水交错,6 片总耗时从 440 秒压至 296 秒,吞吐暴涨 48.5%!
- 增加 XTX 带来的收益分水岭:在 5 秒低档下加入 RX 7900 XTX 组成三源并发,吞吐仅从 72.75 提高到 81.10 片/小时(增幅 11.5%,未达到工程上新增硬件复杂度的 15% 准入门槛);但在 736×1280 高清档下,由于 T10 分布式采样时间变长、后方 3080 Ti 产生闲置等待,加入 XTX 采样能把高清出片总耗时从 902 秒大幅缩减至 677 秒,吞吐提升 33.2%(达到 31.88 片/小时),成为高清批量生产的首选方案。
二、架构设计:算力解耦与 10GbE 跨机轻量交接
为什么要把“采样”和“解码”拆到不同物理主机上跑?除了算力特征的互补,还有一个非常现实且棘手的硬件物理插槽与改造成本约束:
1. 物理层限制:普通平台根本插不下这么多卡
- 关于双路 X99 的真实性价比与选型权衡:
- X99 的唯一核心优势:在于白菜价的同时,能用极低成本堆出相对最多的 PCIe 物理通道(双路至强 v3/v4 理论上总计能提供 80 条 PCIe 3.0 通道);
- 但弊端也极其明显且致命:
- 插槽捉襟见肘:哪怕买到极限的 6 槽直通双路 X99 矿板,通常也就是 4 根 x16 + 2 根 x8,依然插不满 8 卡;
- 跨 NUMA 性能损耗灾难:双路 CPU 之间通过 QPI 总线通信,一旦涉及跨节点的 GPU 显存搬运与内存读取,时延与带宽断崖式下跌;
- 不支持 GPU P2P:图灵卡跑 Ulysses 分布式序列并行时,卡间频繁需要 All-to-All 交换通信,没有点对点硬件支持效率大打折扣;
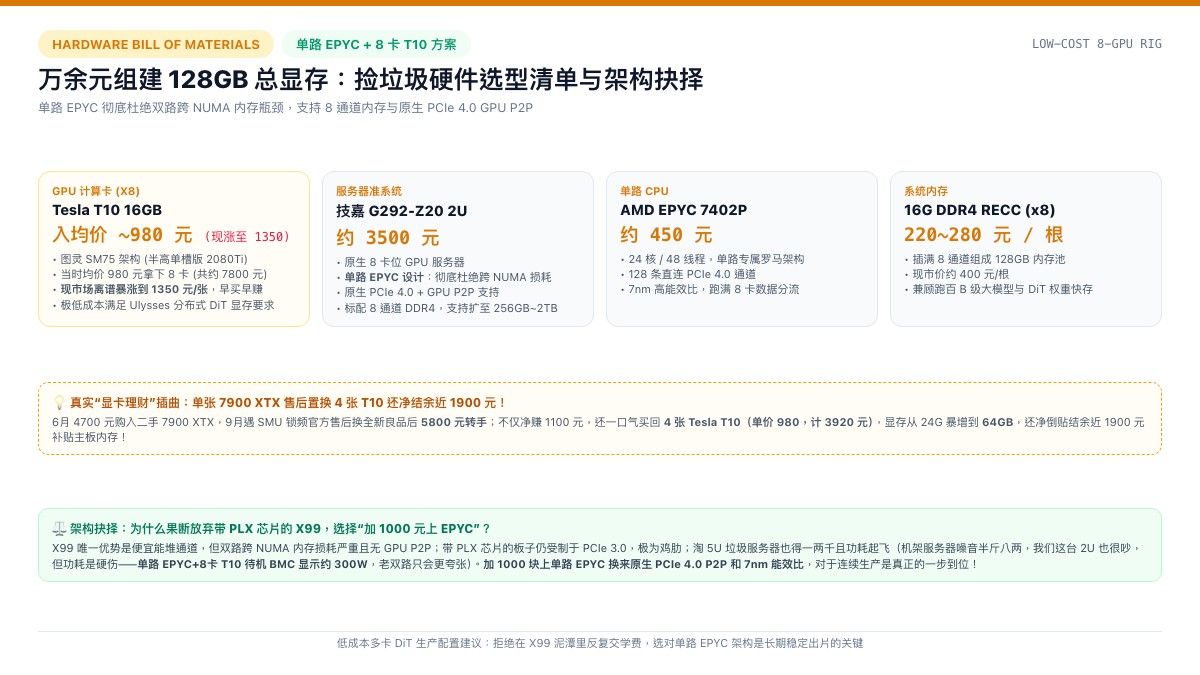
- 带 PLX 芯片的 X99 板子极其鸡肋:市场上那些卖 800、900 甚至上千元、带 PLX 交换芯片的魔改 X99 家用/矿板,我个人觉得意义非常微弱——底层依然受制于老旧的 PCIe 3.0 协议和高发热的 14nm 至强架构;要是退一步去淘 4U/5U 级的洋垃圾服务器,准系统本身也得一两千,功耗更是直接起飞(要说风扇噪音,机架服务器半斤八两,我们这台 2U 的 G292 准系统也吵得不行,没资格说别人,但双路至强老架构的功耗确实更加爆炸——我们现在这套单路 7nm EPYC + 8 卡 T10,光是开机待机状态,BMC 监控显示功耗就已经在 300W 上下了,要是换老双路洋垃圾只会更夸张)。
- 为什么最终拍板“加 1000 上 EPYC 准系统”:综合算下来,只要多花大约 1000 元(技嘉 G292 二手准系统 3500 元),就能直接跃升到 单路 AMD 罗马架构 EPYC:原生 128 条满血 PCIe 4.0 直连、原生支持 GPU P2P、纯粹的单路单 NUMA 节点、8 通道完整内存吞吐、以及 7nm 带来的极佳待机与满载能效比。这 1000 元的溢价换来的长期稳定性与扩展性,对于要做连续批量视频生产的工程平台来说,性价比远超在 X99 泥潭里打滚折腾!
- 这套极具性价比的“捡垃圾”方案清单:
- 服务器准系统:技嘉 G292-Z20(2U 8卡位 GPU 服务器),二手准系统约 3500 元。它的最大卖点是 单路 AMD EPYC 设计,从物理上杜绝了多 CPU 跨 NUMA 节点的内存搬运痛点;全机原生支持 PCIe 4.0 与 GPU P2P,支持完整的 8 通道内存,标配 8 条内存插槽(普通可上 256GB,特殊配置最高可上 2TB 内存,兼顾了后续跑 120B/百 B 级大语言模型的扩展性)。
- 计算卡选型 (Tesla T10 16GB) 与一段“显卡理财”插曲:
- 我的购买均价大概 980 元/张(图灵架构,类似半高单槽版 RTX 2080 Ti 16G,成色相当不错)。不过现在海鲜市场行情非常离谱,T10 目前已经一路涨价暴涨到了 1350 元/张,简直魔幻!我当时趁着均价 980 的时候 8 张全部拿下也才 7800 元出头,相比买单张全新 4090 或昂贵的专业计算卡,用极低成本直接拉平了 128GB 的巨大分布式显存池。
- 这里还有一个挺有意思的真实回血插曲:我原本在 6 月 3 日以 4700 元收了一张二手 RX 7900 XTX,到了 9 月份碰上经典的 AMD SMU 锁频故障,走官方售后换回了一张全新的官方良品卡。正好碰上行情波动,转手以 5800 元 卖掉。这一进一出不仅白玩了 3 个月还净赚 1100 元,转头拿着这笔钱一口气买回来 4 张 Tesla T10(单价 980,4 张约 3920 元),手里居然还净倒贴结余了近 1900 元!
- 显存与生产力账本算下来非常夸张:一张原本 24GB 显存的消费级单卡,通过这波理财直接置换成了 4×16GB = 64GB 的纯正多卡计算池,甚至还补贴了主板和内存。
- 预判某些杠精可能会杠:“老卡算力弱,你 4 张 T10 能打得赢 1 张满血 7900 XTX 吗?折腾半天是不是负优化?”
- 我们早就拿实测数据正面对比过,事实会狠狠打脸:
- 在 416×736 标清 5 秒下:单张 7900 XTX 跑原生 attention 端到端确实更快(热态约 105 秒 vs 4 卡 T10 的 166 秒,单卡强 1.59 倍);
- 但在 736×1280 近 720p 分辨率下,攻守彻底易形:单张 7900 XTX 跑原生 PyTorch attention 耗时直接暴增至 19 分 15 秒(采样本体 18 分 19 秒)!哪怕强开实验性的 SageAttention,端到端也要 11 分 26 秒,而且显存温度直接飙到 94°C,还伴随同种子构图漂移问题;
- 反观 4 张 T10 单机自身跑 736×1280:采样本体仅需 9 分 51 秒,四卡采样本体速度直接反超单张 7900 XTX 约 3.6%(哪怕对比开 Sage 的 XTX),而且四卡温度稳定在 82°C,构图严密对齐;
- 更致命的降维打击是显存容量与并发:单张 7900 XTX 就算再快,24GB 显存同一时间也只能串行跑一个任务;而置换出的 4 张 T10(64GB 显存池)不仅可以在高分辨率下靠 Ulysses 序列并行把采样本体压进 10 分钟以内,更关键的是——当 8 张 T10 就位后,我们能直接拉起**“双 4 卡独立池”**实现多任务轮流流水线出片,或者直接拼成 8 卡把 5 秒标清采样砍进 110 秒、把 736×1280 采样砍进 167 秒!
- 结论很残酷:只盯单卡单任务的低分辨率跑分,是典型的小白思维;在工业化连续出片的场景下,总显存容量(64G vs 24G)、卡间序列并行通道和多池流水化并发能力,才是决定每天能产出多少条视频的核心胜负手!
- 我们早就拿实测数据正面对比过,事实会狠狠打脸:
- CPU 选型:AMD EPYC 7402P(24核/48线程,单路专属),二手海鲜市场约 450 元,性价比拉满。
- 内存配置:丰俭由人。我们当时装机是均价 220~280 元/根收的单根 16G DDR4 2133/2400 RECC 内存(目前市场价约 400 元/根)。
- 为什么暂时双机解耦:其实 G292-Z20 主板后部还预留了 2 条全高的 PCIe 4.0 插槽,理论上完全能把 241 的两张大卡(RX 7900 XTX / 3080 Ti)也塞进同一台机器。但涉及到机架服务器定制 8pin 供电线改造、重型显卡固定支架和高功耗散热重构,有点折腾且需要额外采购线材。而手头刚好有一条闲置的 10Gbps DAC 铜缆直连线,顺理成章就采用了双机解耦的轻量化方案。
2. 算力与存储架构层面的精准解耦
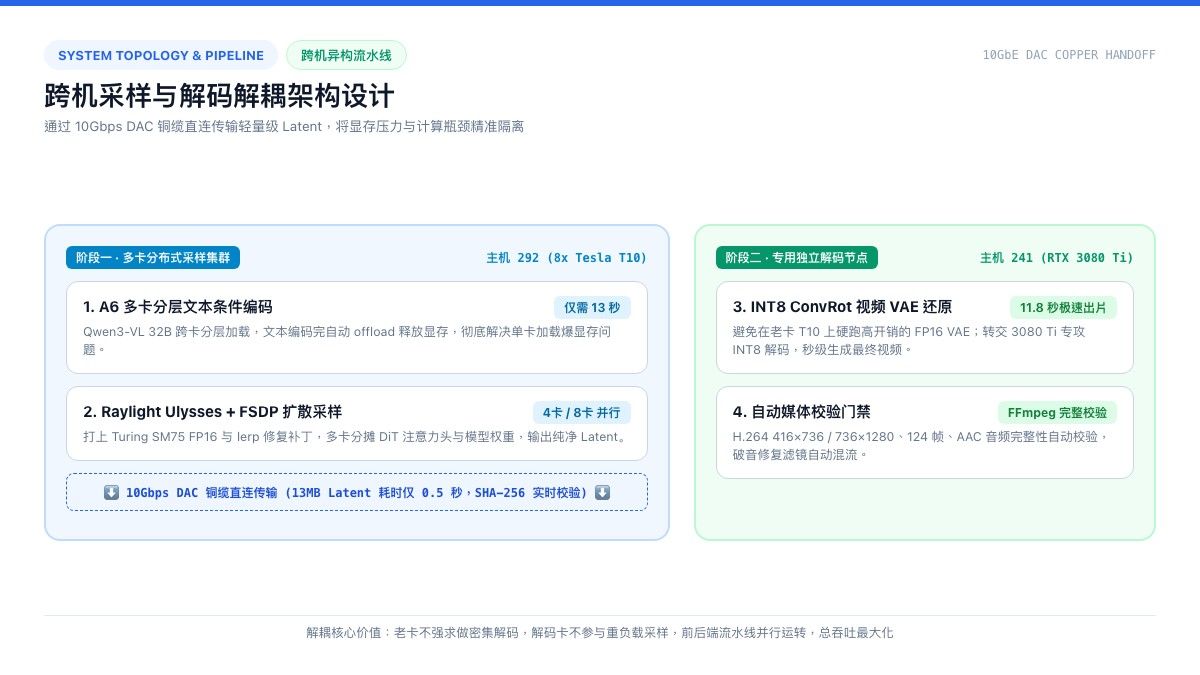
- 图灵老卡(T10)专注于 DiT 张量并行计算:
8 张 Tesla T10(16GB,SM75)通过 Raylight 跑序列并行(Ulysses=4 或 8,FSDP=true)。T10 在密集矩阵计算上效率可观,且通过序列切分避开了大尺寸显存瓶颈。采样结束后,它不需要在本地执行极其耗时、容易引起显存溢出的视频 VAE 还原,而是直接将中间态的 Latent 张量(视频与音频特征,体积仅约 13 MB)存盘。 - 10Gbps DAC 铜缆高速无感交接:
两台主机之间通过专属 10GbE 网卡直连(双向 ping < 0.3 ms)。13 MB 的 Latent 文件通过 SCP/Socket 传输仅需 0.5 ~ 0.9 秒,且附带实时的 SHA-256 完整性哈希校验,通信开销在几十秒的视频生成周期中微乎其微。 - 消费级单卡(RTX 3080 Ti)专精快速 VAE 解码:
后端的 3080 Ti(12GB,安培架构)不需要加载几十 GB 的 DiT 主模型,它只维持一个轻量级的 ComfyUI 实例,专职加载minimax_h3_video_vae_int8_convrot.safetensors。接收到 Latent 后,仅需 11.8 秒 即可完成 5 秒视频的高清解码与 AAC 音视频封装。相比老卡单跑 FP16 VAE 的 72 秒,速度足足快了 6 倍以上!
三、关键基准与补丁说明(技术背景还原)
为了让复刻者能完全独立理解并在相同硬件环境下避坑,这里对几个核心技术基线做完整解释:
1. 什么是“A6 基线”?
我们在测试文档中多次提及的“A6”,是我们在多轮 A/B 测试中沉淀下来的一套基准生产工作流代号(Profile A6)。其核心技术是集成了开源社区(Eanya-Tonic)的
H3MultiGPUCLIPLoader节点:- 原理:Qwen3-VL 32B 文本条件编码器体积庞大,A6 将其视觉模块、Embedding 以及连续的 Transformer Decoder 层分散跨卡放置到 4 张 T10 上,activation 逐卡流水传递。
- 效果:它让新提示词的条件编码(Conditioning)耗时从单卡的 27 秒砍到了 13.06 秒;同时在编码结束后强制执行
offload_after_encode=true与H3_MP_RETAIN_CPU_WEIGHTS=1自动卸载权重释放显存,把珍贵的 16GB 空间完整腾退给接下来的 Raylight FSDP 采样,彻底消除了显存溢出。
2. 图灵架构(SM75)跑 H3 必备的两大补丁
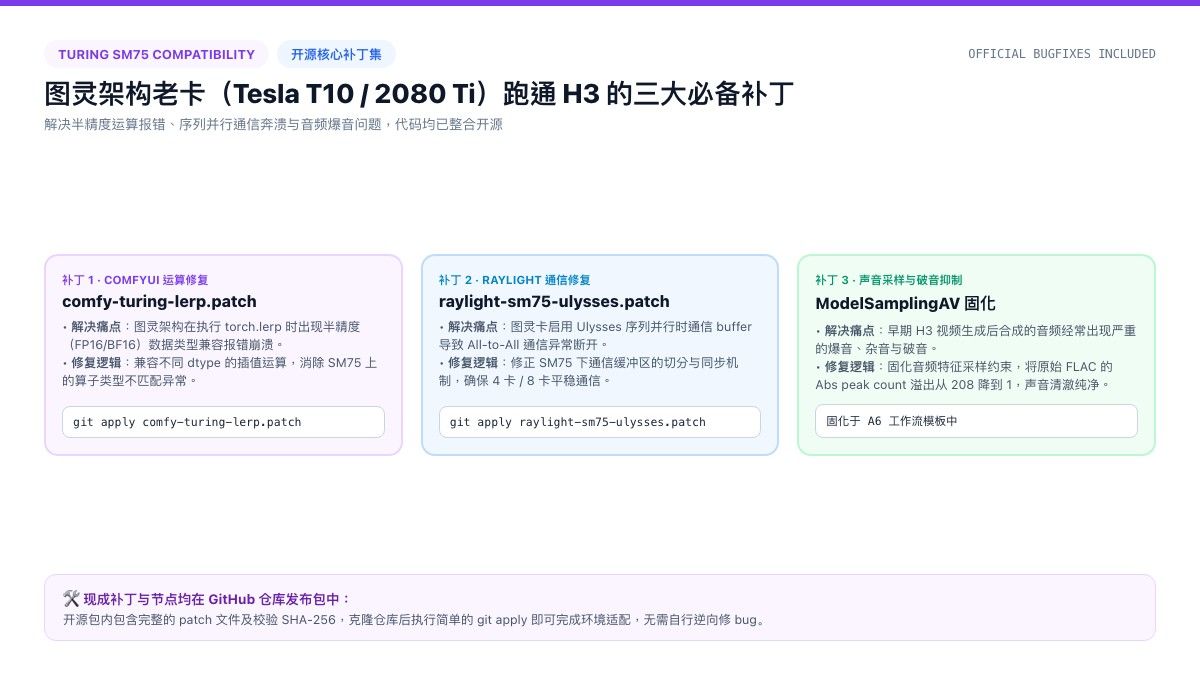
Tesla T10 和 RTX 2080 Ti 属于图灵架构(SM75,计算能力 7.5),直接拉取最新的 ComfyUI 与 Raylight 会遇到半精度运算与序列通信崩溃。开源包中包含了已验证的两项补丁:
comfy-turing-lerp.patch:针对 ComfyUI(基于 commitbdcb886升级到5fa5e05),修复了在 SM75 架构下执行torch.lerp时的半精度(FP16/BF16)数据类型兼容性报错。raylight-sm75-ulysses.patch:针对 Raylight(基于 commit63ae5b8升级到1a4ee4a),修复了图灵卡启用 Ulysses 序列并行时通信 buffer 的 All-to-All 兼容问题。- 音频破音修复:固化了
ModelSamplingAV逻辑,将原始音频 FLAC 的绝对峰值溢出(Abs peak count)从 208 降到 1,彻底解决了早期音频爆音问题。
四、固定配置、环境版本与模型规格
为保证数据可严格复核,测试期间固定的环境基线如下:
- 主模型与 LoRA:
主 DiT:10Eros_Max_h3_TURBO-hybrid_beta4_int8_convrot.safetensors
文本编码器:qwen3vl_32b_minimax_h3_int8_convrot.safetensors
Turbo LoRA:minimax_h3_fl2v_turbo_4step_v0.1_768p_sla_comfyui_bf16.safetensors(实际使用 6 步 Euler/simple 采样) - VAE 选型:
采样端(T10/XTX):minimax_h3_video_vae_fp16.safetensors+minimax_h3_audio_vae_fp32.safetensors
解码端(3080 Ti):minimax_h3_video_vae_int8_convrot.safetensors+minimax_h3_audio_vae_fp32.safetensors - 分布式并行配置:FSDP=true,CPU offload=false,Attention 采用
TORCH_EFFICIENT;4 卡模式 Ulysses=4/Ring=1,8 卡模式 Ulysses=8/Ring=1。XTX 采用 ROCm Comfy Kitchen(CK attention)。 - 运行环境版本:
NVIDIA 端(T10 与 3080 Ti):Python 3.12.3、PyTorch2.13.0+cu130、Ray 2.58.0、xFuser 0.4.4、safetensors 0.8.0、ComfyUI 0.34.0。
AMD 端(RX 7900 XTX):PyTorch2.12.0+rocm7.14.0、comfy-kitchen 0.2.32、safetensors 0.8.0。
五、完整复现指南与一键流水线 CLI
我们已经将整套多机服务拉起、离线规划、队列调度与断线恢复逻辑封装为了 Python 生产 CLI。在克隆项目后即可开箱使用:
 开源仓库:https://github.com/peterhon168/h3-multigpu-pipeline
实测视频:https://youtu.be/fUTG5CveZ9k1. 源码补丁与自定义节点部署
在全新隔离的 ComfyUI 源码树上依次打上补丁并安装节点:
PKG="$(cd ./h3-multigpu-pipeline && pwd)"
COMFYUI_ROOT=/your/path/ComfyUI
RAYLIGHT_ROOT="$COMFYUI_ROOT/custom_nodes/raylight"

# 应用 Turing 架构补丁
git -C "$COMFYUI_ROOT" apply "$PKG/assets/patches/comfy-turing-lerp.patch"
git -C "$RAYLIGHT_ROOT" apply "$PKG/assets/patches/raylight-sm75-ulysses.patch"

# 安装 A6 跨卡文本编码节点与 Latent 跨机交接节点
cp -r "$PKG/assets/comfyui_h3_multigpu_clip" "$COMFYUI_ROOT/custom_nodes/"
cp -r "$PKG/assets/h3_latent_handoff" "$COMFYUI_ROOT/custom_nodes/"
2. 配置主机网络映射(Host Map)
复制配置文件模板,填入你实际的内网 IP、SSH 别名与 Python 虚拟环境路径:
LOCAL_DIR=./h3-local-private
mkdir -p "$LOCAL_DIR"
cp "$PKG/config/host-adapter.example.json" "$LOCAL_DIR/host-map.json"

# 编辑 host-map.json 后自动生成本地适配配置
python3 "$PKG/scripts/pipeline.py" config-adapt \
  --host-map "$LOCAL_DIR/host-map.json" \
  --out "$LOCAL_DIR/local.json"
3. 本地离线任务规划(Plan)
在不联网、不调用 GPU 的情况下模拟排期,校验不同拓扑的调度序列:
# 规划五秒低档双 4 卡独立池(推荐日常吞吐档)
python3 "$PKG/scripts/pipeline.py" plan \
  --mode four_four_plus_one --width 416 --height 736 --seconds 5 \
  --count 6 --seed 987654321123

# 规划高档 736x1280 三源并发(推荐高清批量档)
python3 "$PKG/scripts/pipeline.py" plan \
  --mode four_four_xtx_plus_one --width 736 --height 1280 --seconds 5 \
  --count 6 --seed 987654321123
4. 服务预检、启动与后台批量执行
通过命令行统一拉起远端分布式服务并提交后台作业:
# 服务预检与一键拉起
python3 "$PKG/scripts/pipeline.py" preflight --config "$LOCAL_DIR/local.json" --mode four_four_plus_one
python3 "$PKG/scripts/pipeline.py" start --config "$LOCAL_DIR/local.json" --mode four_four_plus_one

# 后台提交 6 任务生成并获取状态
python3 "$PKG/scripts/pipeline.py" run \
  --config "$LOCAL_DIR/local.json" --mode four_four_plus_one \
  --prompt-file ./private/prompt.txt --reference-file ./private/ref.png \
  --width 416 --height 736 --seconds 5 --count 6 --background

# 查询执行状态与等待出片
RUN_ID="填入输出的run_id"
python3 "$PKG/scripts/pipeline.py" wait "$RUN_ID" --timeout 7200
六、生产排坑与避坑要点
- Ray 临时 Socket 路径长度超限:首轮 8 卡启动时,因 Unix Domain Socket 路径超过 Linux 的 107 字节上限导致进程无报错卡死。解决方案是将临时运行目录显式缩短(如
/tmp/ray),该细节已固化在封装启动脚本中。 - 多池 ComfyUI 数据库冲突:当双 4 卡池在同一台物理机上启动时,多个实例争抢默认的
comfyui.db会触发数据库锁定警告。启动脚本已强制分配独立 SQLite 数据库文件(如comfyui_pool1.db),彻底解决并发冲突。 - 断网与异常状态恢复:CLI 工具内置了断点恢复机制(
pipeline.py resume <RUN_ID>)。如果协调进程异常中断,再次执行 resume 会扫描远端已有 Latent 并仅补偿缺失的解码或采样动作,避免重复计算浪费电费。 - 单解码器队列控制:3080 Ti 作为单一解码卡,在面对三源并发时队列最大 Pending 仅为 1,解码尾段耗时完全能被前置采样时间重叠掩盖,不需要盲目增加解码卡。
总结
多卡本地部署不应局限于“所有卡做一模一样的事情”。让廉价的二手计算卡(如 Tesla T10)通过序列并行专攻分布式 DiT 采样,让消费级单卡(RTX 3080 Ti)专精快速 INT8 VAE 解码,配合局域网 10GbE 轻量级 Latent 交接,是用极低硬件成本实现百片级视频连续生产的黄金组合。
代码与完整资产包已在 GitHub 全量开放,欢迎大家在开源仓库与本帖评论区交流探讨多机异构与视频生成调度心得!
-
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化 -
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化@Queen-Laura a6000 哈哈 等大佬出结果啦
-
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化@terry https://www.bilibili.com/video/BV1dVhW6zEoH/ 我只是一个把服务器放在床上抱着睡的折腾男罢了
 就跟老特你说的一样,现在有hermes 有deepseek,人类只需要负责物理操作,剩下的,动动嘴皮子喊ai去搞就是了,我这几天都没怎么动过啥,就是看到有好的项目就扔给ai分析是否适合自己用,适合就跑调优,不适合就放着
服务器 3500
处理器 450
内存 3508
显卡 10004
目前我都在想卖一张7900xtx,再买4张T10了
不管是comfyui,还是LLM,4张T10都能跟2张7900xtx打55开 -
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化@Misakiyu-Xmilk G292 Z20 技嘉的服务器
-
4×Tesla T10 + RTX 3080 Ti 双机跑 MiniMax H3:拆分 VAE 解码的流水线吞吐优化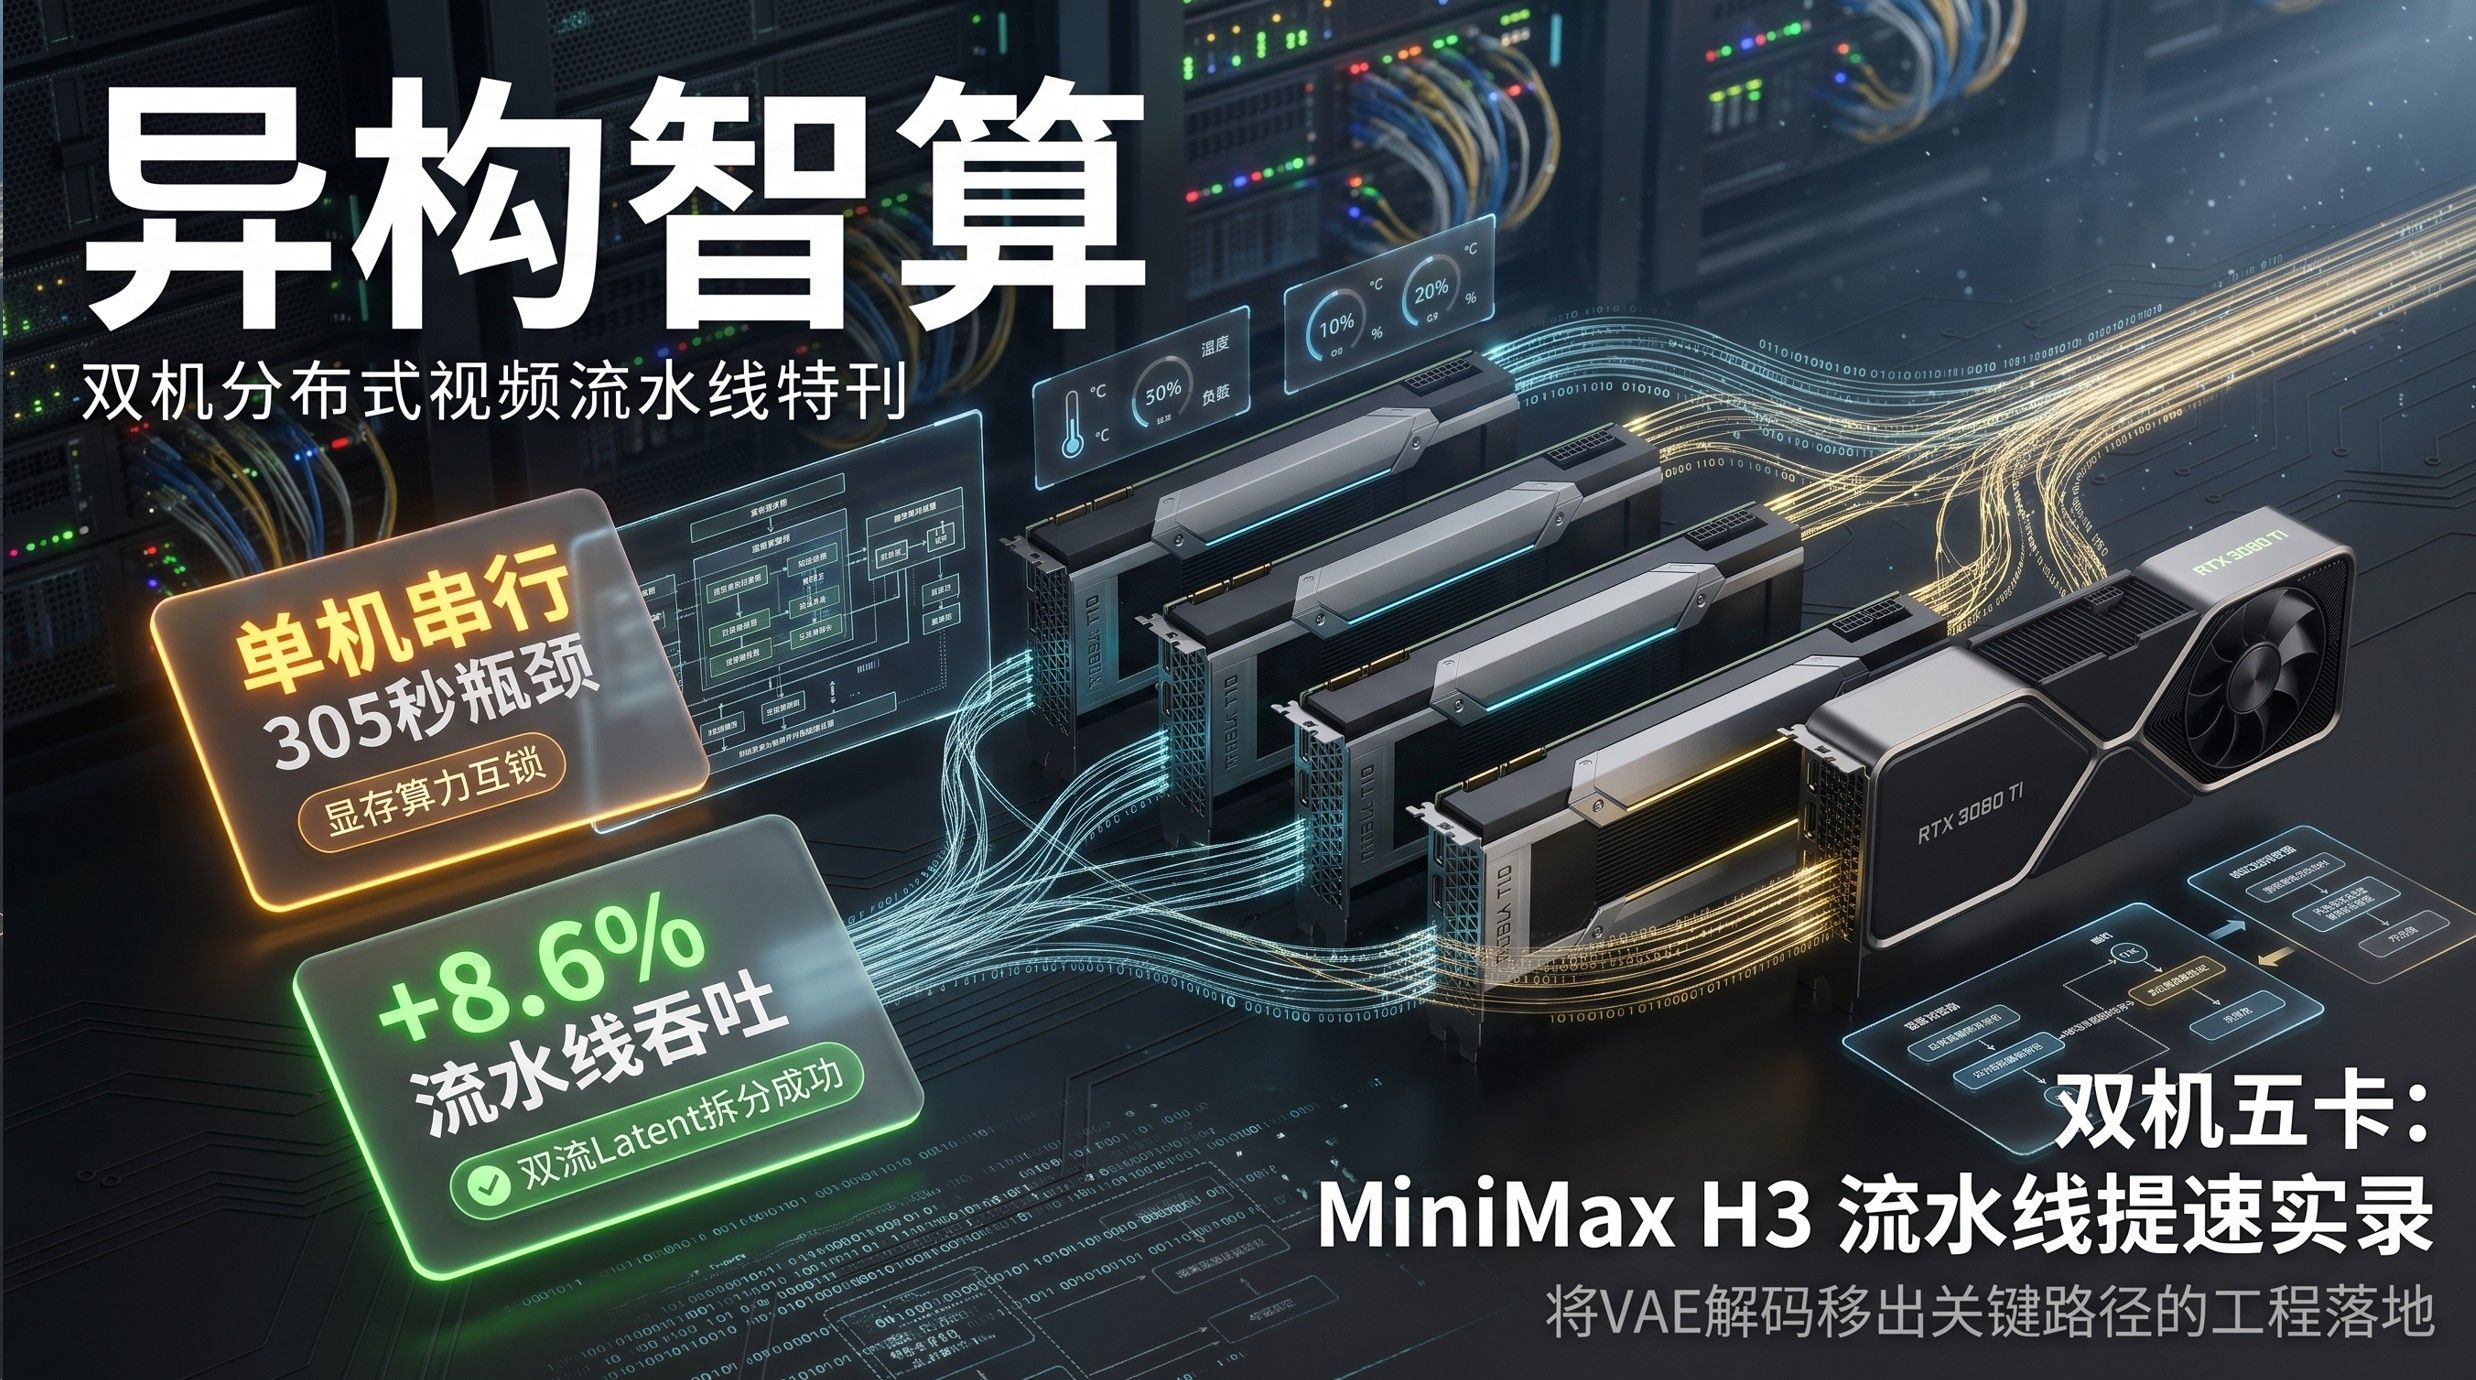
硬件环境:
• 采样节点(Node-292):4× NVIDIA Tesla T10 16GB (Turing/sm75), PCIe P2P, 无 NVLink, ComfyUI 0.30.0, PyTorch 2.13.0+cu130, Ray 2.58.0, xfuser 0.4.4, Raylight (Ulysses=4, Ring=1, FSDP=true)
• 解码节点(Node-241):NVIDIA GeForce RTX 3080 Ti 12GB (独立 ComfyUI 0.34.0, CUDA_VISIBLE_DEVICES=0 物理隔离)
• 网络链路:千兆/2.5G 局域网(实测带宽约 2.35Gbps)业务场景:MiniMax H3 视频生成模型 REF2VA 工作流(416×736 分辨率、124 帧、24fps、Turbo LoRA 6 步去噪)。
0. 核心结论与实测收益
在多卡高负载视频生成场景中,瓶颈往往不在于单卡算力,而在于重载扩散采样与高开销 VAE 视频/音频解码串行争抢资源。
通过构建“双机阶段级异步流水线”(4×T10 专职纯扩散去噪,RTX 3080 Ti 专职 INT8 视频 VAE + 音频 VAE + MP4 封装),实测数据如下:
指标维度 传统单机全部串行 双机阶段流水线 收益变动 4×T10 采样+保存 Latent ~140.45 秒 ~140.45 秒 专注去噪,无上下文打断 跨机 Latent 传输 (4.3MB) 0 秒 (本地) 1.0~1.2 秒 局域网开销极低 3080 Ti INT8 VAE + 封装 串行计入关键路径 完全隐藏于下一任务 边际耗时被掩盖 连续 2 条视频 Makespan 305.32 秒 292.17 秒 总耗时降低 4.31% 长队列稳态吞吐 23.58 条/小时 25.61 条/小时 吞吐量提升 +8.59% 时间轴 ─────────────────────────────────────────────────────────────> Node-292 (4×T10) [ 第 1 条采样 140s ][ 第 2 条采样 140s ][ 第 3 条采样 140s ] Node-241 (3080 Ti) [ 第 1 条 VAE 11s ][ 第 2 条 VAE 11s ]
1. 为什么不是“把 3080 Ti 强行并入五卡 Tensor Parallel”?
很多机友第一反应是“能不能跨机器把五张卡拉成一个集群”?在实操中这是典型的反模式:
- 计算架构异构:Tesla T10 是 Turing 架构 (sm75),3080 Ti 是 Ampere 架构 (sm86),底层 CUDA Kernel 与算力特性不一致;
- 跨机通讯开销致命:跨机器做模型并行(TP/USP)需要极高频的 AllReduce 同步,没有专用 100Gb+ RoCE/InfiniBand 网络必定引起严重通信死锁与性能断崖;
- 阶段解耦更高效:MiniMax H3 的输出是包含视频与音频的
NestedTensor。416×736 分辨率的 latent 仅仅约 4.3MB。传输 4.3MB 只需要 1 秒,而跑一次 VAE 解码需要 10~13 秒。用阶段级流水线剥离 VAE,可以让昂贵的 4 卡采样集群 100% 跑满,彻底释放吞吐潜力。
2. 核心架构设计与工程落地
① 双流 Latent 结构化导出与原子落盘
MiniMax H3 同时包含视频与音频两组 Latent。自定义落地节点负责:
- 校验并导出视频 Latent(
shape: (1, 24, ...))与音频 Latent(shape: (1, 32, 2, ...)); - 严格进行
NaN/Inf数值自检; - 先写
.part临时文件,校验成功后原子重命名为.h3latent,并同步生成.sha256校验指纹文件。
采样工作流尾部改写为:
XFuserSamplerCustomAdvanced
    └── Save MiniMax H3 AV Latent (输出 4.3MB 双流文件,剥离原生解码)
② 解码机(Node-241)隔离 API 服务
解码端通过独立 Python 虚拟环境拉起专用 ComfyUI 实例,严格实施物理设备隔离:
# 启动解码专用实例(监听指定端口,白名单加载 handoff 节点)
CUDA_VISIBLE_DEVICES=0 ./venv/bin/python main.py \
  --listen 0.0.0.0 --port 8192 \
  --disable-all-custom-nodes \
  --whitelist-custom-nodes h3_latent_handoff \
  --dont-print-server
检查
/proc/$pid/environ确认环境干净,杜绝与其他计算卡产生资源争抢。③ 视频 VAE 精度选型:INT8 ConvRot vs FP16
在 3080 Ti 上针对官方 VAE 进行了严格的 A/B 对比:
VAE 选型 尾段纯解码耗时 PSNR 峰值信噪比 均方误差 (MAE) 综合判定 FP16 官方标准 VAE 13.57 秒 41.95 dB 1.39 基准质量,耗时略长 INT8 ConvRot 官方 VAE 10.37 秒 41.50 dB 1.52 速度快 23.6%,画质完全无肉眼可辨损失 INT8 ConvRot 在 124 帧全流程抽检中有限值表现稳定,未出现历史社区反馈过的黑屏或溢出异常,被选定为生产基线。
④ 自动化监控流水线(Watcher Daemon)
后台监控守护脚本监听采样目录,一旦捕获到
.h3latent与.sha256同步就绪:- 自动计算本地 Hash,发起跨机安全传输;
- 远端重验 SHA-256 无误后原子落盘;
- 远程触发 8192 端口 API 执行解码与音视频合成;
- 产出结构化审计回执
*.pipeline.json。
3. 深入对比:4 步 Turbo LoRA 是否具备生产可用性?
社区中 Turbo LoRA 标称支持 4 步去噪,我们保持同 Seed、同提示词进行了严谨步数 A/B:
采样步数 4×T10 采样保存 含远端完整耗时 画质与时序表现 6 步(基准) 140.92 秒 154.38 秒 服装细节高度一致,动作自然平滑,生产默认首选 4 步(激进) 95.13 秒 106.22 秒 速度提升 32.5%,但抽帧发现角色服装发生明显漂移(如红色裙装漂移为背带裤) 结论:4 步仅适合前期快速挑分镜、低精度批量预览;生产交付仍坚决锁死 6 步。
4. 失败探索与避坑反模式
- 反模式一:盲目启用 SAGE_FP16:
在 Turing 架构上强制指定SAGE_FP16,首个 denoiser 步即抛出AttributeError: module 'sageattention' has no attribute 'sageattn_qk_int8_pv_fp16_cuda'。Turing (sm75) 并不支持该 kernel,切忌盲从高版本特性。 - 反模式二:执念于升级万兆网络(10GbE):
实测 4.3MB 的 Latent 走普通千兆局域网只需要 1 秒。相对于 140 秒的扩散采样,将网络从 1 秒压到 0.2 秒对总体吞吐影响甚至不足 0.5%,切勿在非关键路径上浪费工程精力。
-
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘 -
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘@johnnybegood 确实,后路都已经各种找好了,诉讼状也基本写好了

-
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘@williamlouis 是的,买的时候就预料到的,只是那吊毛不拍胸口我自负盈亏还没啥,那吊毛说了又不做这才是最气的
-
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘
硬件环境:双 AMD Radeon RX 7900 XTX 24GB (XFX 凤凰涅槃 + Sapphire Pulse) + NVIDIA RTX 3080 Ti 12GB,Xeon E5-2682 v4 (x996plus / 241 节点),Ubuntu 22.04 LTS (Kernel 7.0.0-30-generic),ROCm 7.2 / amdgpu。
核心场景:本地部署 Qwen3.8-27B 离线大模型推理 & ComfyUI 生图管线。
文档性质:根据系统 syslog/dmesg 底层日志、闲鱼交易记录、微信沟通记录与实物工单取证还原,事实数据完全可核对。
0. 导读与省流摘要
买二手硬件,大家都有“二手出柜、自负盈亏”的心理底线。但这块 7900 XTX 的经历把二手生态的人性反差与厂商保修潜规则展现得淋漓尽致:
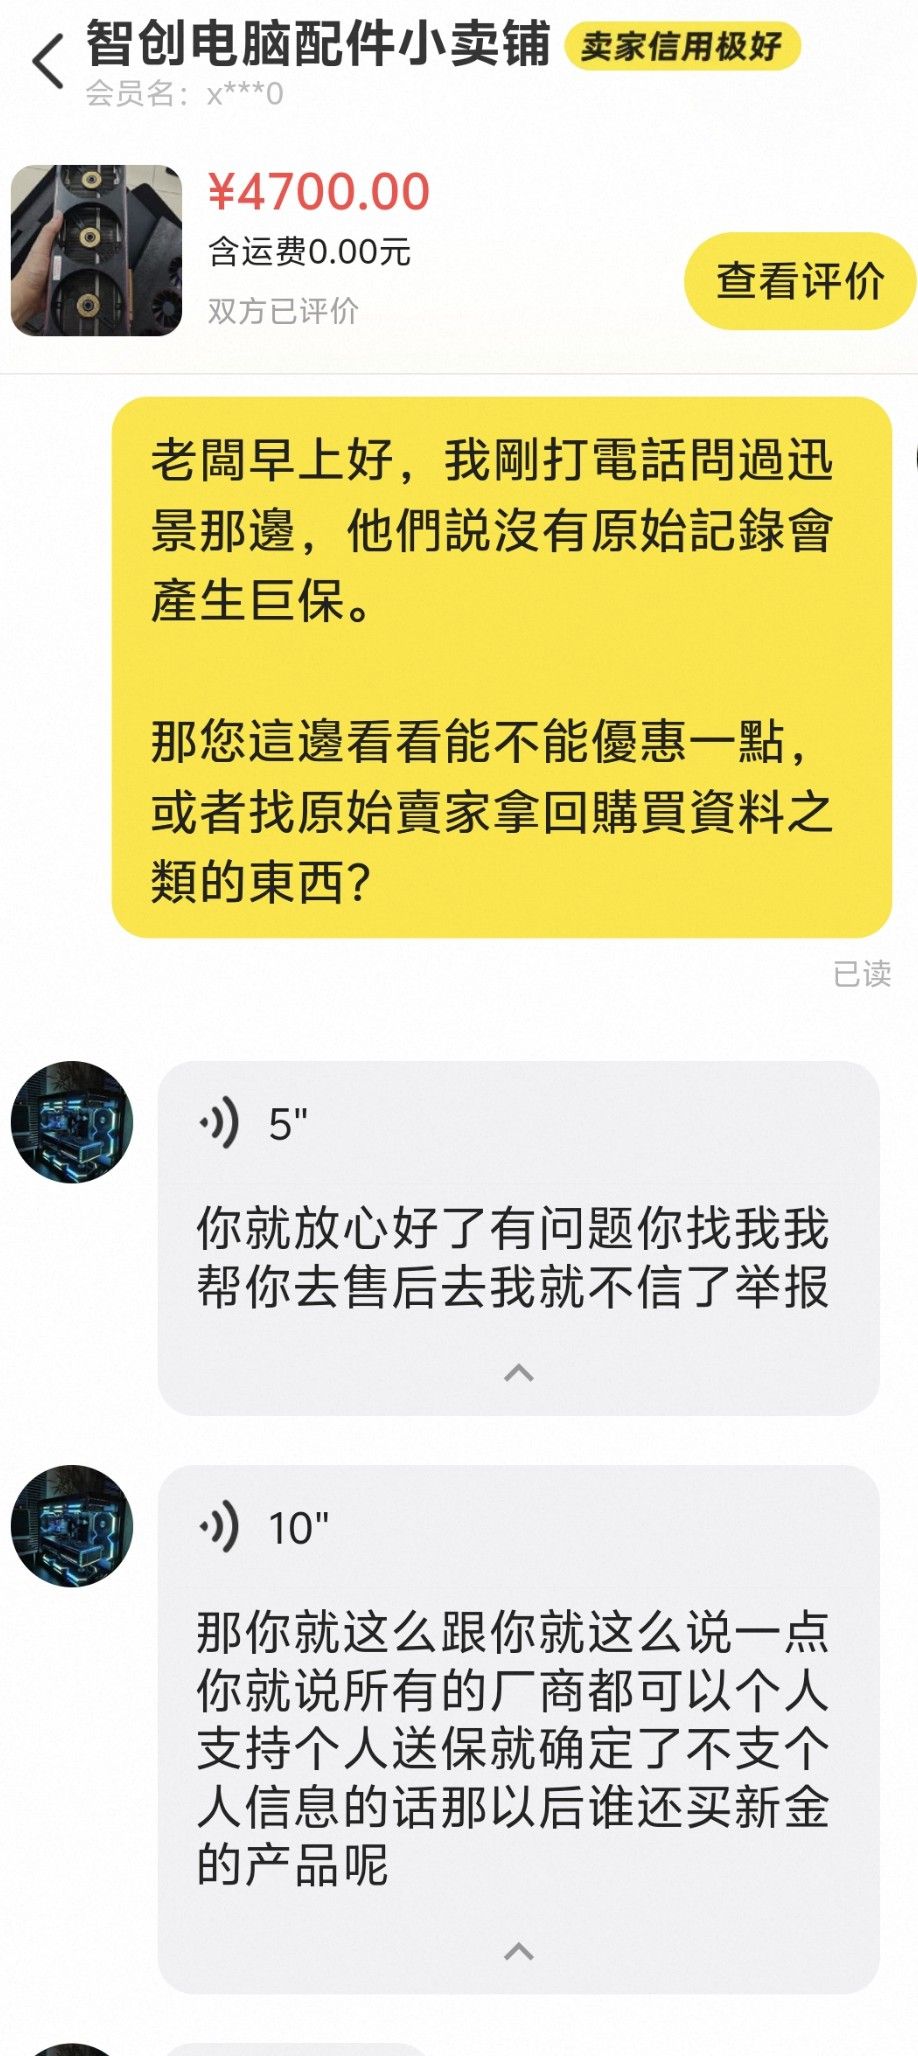
- 原卖家画饼:闲鱼 4700 元购入,交易前买家担心拒保,卖家拍胸脯语音立誓:“有问题找我,我帮你去售后,我就不信了!”
- 硬件暴毙:上机运行多卡推理与生图,遭遇深层次 AMD SMU(电源管理单元)通信死锁,最终跨平台永久卡死 VGA 故障灯,POST 自检循环重启。
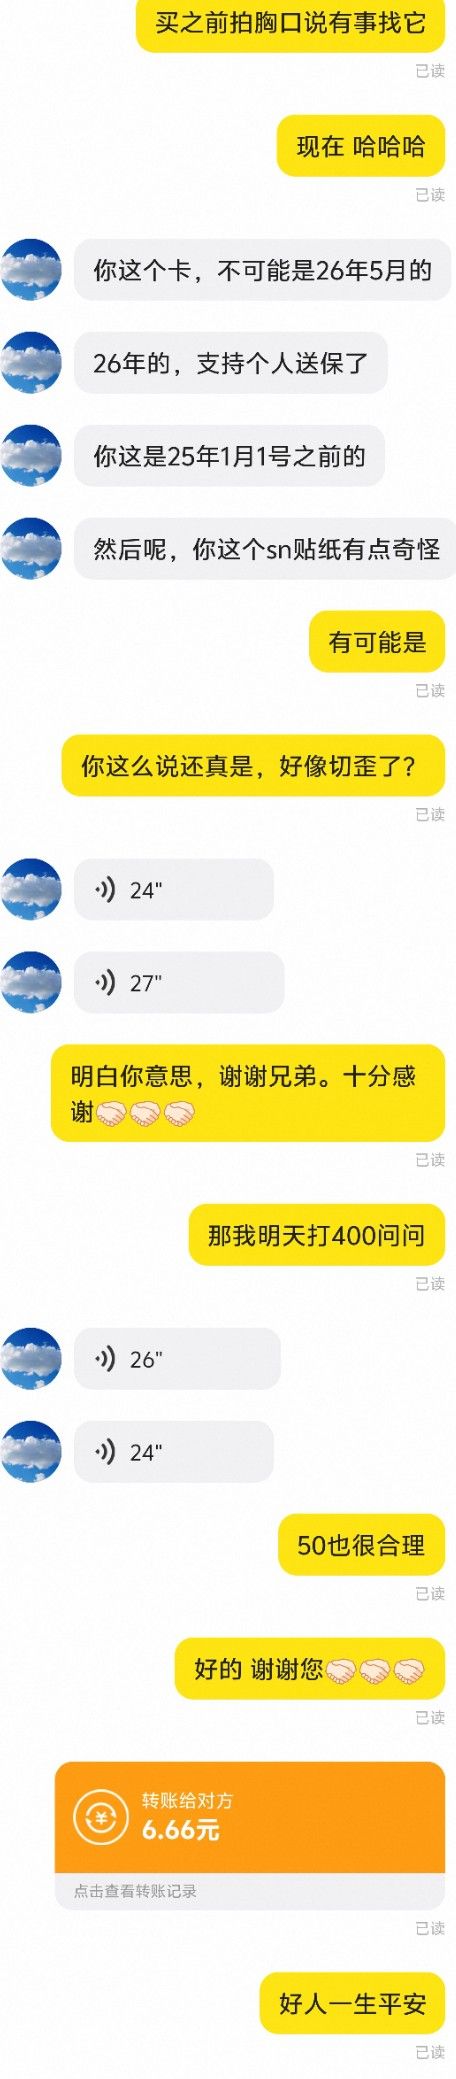
- 卖家现形 & 官方秒拒:真出故障后,原卖家光速变脸要推给私人作坊高价维修;官方 400 系统因卡出厂在 2025 年 1 月 1 日前,个人送保看都没看直接秒拒。
- 绝处逢生:挂闲鱼 3000 元准备当尸体料板止损时,遇上好心买家指点迷津——绕过个人送保,走官方授权区域代理商代送修(仅收几十元代送费,不查一手凭证)。
- 换新下车:寄出后顺利返厂,厂商直接以换代修换回一张良品卡,满血复活!
【原卖家 4700 拍胸脯画饼】
       │
       ▼ (运行 Qwen3.8 / ComfyUI)
【SMU 0xFFFFFFFF 死锁 → 永久卡 VGA 灯暴毙】
       │
       ▼
【找卖家被推诿加钱 ➔ 官方个保因 2025 前老卡秒拒】
       │
       ▼
【闲鱼 3000 标尸体甩卖】
       │
       ▼ (闲鱼老哥指点迷津)
【走官方 400 查 SN ➔ 对接区域代理商 ➔ 50元代送费】
       │
       ▼
【官方售后以换代修 ➔ 换回良品卡满血复活!】
1. 祸根初埋:4700 元拍胸口画饼的闲鱼卖家
2026 年,为了扩展 241 算力节点的本地推理能力,我在闲鱼“智创电脑配件小卖铺”看中了一张 XFX 讯景 RX 7900 XTX 凤凰涅槃。
买卡前,我知道讯景历史批次的保修对二手极不友好,因此特意在下单前沟通确认:
[买家] 老板早上好,我刚打电话问过讯景那边,他们说没有原始记录会产生拒保。 那您这边看看能不能优惠一点,或者找原始卖家拿回购买资料之类?确定还在保对吗? [卖家] 确定! [卖家(语音 5秒)] 你就放心好了有问题你找我我帮你去售后去我就不信了举报! [卖家(语音 10秒)] 那你就这么跟他说,所有的厂商都可以个人支持个人送保…… 如果确定不支持,那以后谁还买讯景的产品呢? [买家] 那可以,可以小刀再包个顺丰吗? [卖家] 4700。(发起专拍链接)血泪教训:很多卖家为了把高价二手硬件脱手,会毫无心理负担地向买家做任何“口头售后保证”。二手交易中,凡是没有发票白纸黑字过户的“拍胸口保修”,99.9% 都是交易诱饵。
2. 物证时间线:SMU 死锁与显卡物理暴毙的技术溯源
卡插上 241 节点后,满载温控确实不错(满载核心 60~70℃,热点 80℃)。但高负载运转几天后,这颗 Navi 31 核心的隐藏暗病彻底爆发。
故障演化时间线
日期 / 时间 运行场景 系统底层现象 / 日志证据 状态判定 2026-08-30 19:12 运行 Qwen3.8-27B 连续推理 dmesg报SMU: response:0xFFFFFFFF,风扇读不到 PWM 满转拉啸,音频总线掉线初次发作:接口版本不匹配导致 SMU 假死 2026-08-30 20:01 内核升至 7.0.0-30 验收 smu driver if version = 0x3dvssmu fw if version = 0x40常驻隐患:驱动层接口与芯片固件脱节 2026-08-30 21:40 拆卡接入 Win 主机延长线 经历一次亮红灯后,在单卡平台下成功复位并点亮系统 侥幸暂活:卡内保护机制短暂解除 2026-09-02 13:45 运行 ComfyUI 批量跑图 核心无计算 hang,但 dmesg 连续刷出 449 条 SMU no response,rocm-smi 读不出功耗温度二次恶化:电源管理单元再次彻底死锁 2026-09-02 14:44 尝试将 linux-firmware 降至 .26 成功降级并锁定包版本,跑满 60 秒 300W 压测看似稳定 假象恢复:以为是驱动固件 bug 2026-09-02 15:30 重启系统验证 彻底暴毙:机器无法通过 POST 自检,VGA 故障灯常亮,风扇转数秒即停,主板断电重启循环 硬件级阵亡:跨主板、切双 BIOS 均无法点亮 核心报错日志切片(取自 /var/log/syslog 与 journalctl)
[ 5641.102941] amdgpu 0000:83:00.0: SMU: response:0xFFFFFFFF message: TransferTableSmu2Dram (44) arg: 0x00000000
[ 5646.103012] amdgpu 0000:83:00.0: Failed to export SMU metrics table!
[ 5651.103088] amdgpu 0000:83:00.0: Failed to get fan speed(PWM)!
[ 5656.103154] snd_hda_intel 0000:83:00.1: Refused to change power state from D3hot to D0
[ 5661.103210] snd_hda_intel 0000:83:00.1: CORB reset timeout#1, disabling-interface
为什么会彻底死掉?
SMU 是 GPU 的大脑神经元,负责各供电相位的动态调压调频(P-State)、温度监控与上电时序。在长期版本失配与重度计算压迫下,该卡的片上电源控制状态机或核心供电 MOSFET/PWM 芯片发生不可逆击穿,导致主板开机给 PCIe 上电时握手失败,触发主板自我保护切断供电。
3. 人性修罗场:卖家推诿扯皮与官方秒拒
卡彻底无法点亮后,我先按照常规路径维权,迎来了连续两记闷棍:
第一棍:官方系统“看都不看直接秒拒”
致电 XFX 官方 400,并提交个人送保申请。官方给出的答复十分残酷:
“该显卡出厂日期在 2025 年 1 月 1 日之前。按照公司规定,旧批次显卡不支持个人送保业务,必须提供第一手原始购买凭据或由经销商出具证明,否则一律拒保。”
售后系统甚至没有让我寄过去检测,直接在后台退回了个人申请单。
第二棍:买前拍胸脯的卖家露出真面目
抱着最后一丝希望,我找到当初信誓旦旦的闲鱼卖家,好声好气商量:
[买家] 找老板你这边送修可以吗,修成功的话给回 350 你们😂😂 [买家] 明白,那可以帮忙看看怎么交给讯景维修吗?现在问题是他们卡都没有看, 就说我这个卡不能个人送保,要找经销商送才行。 [卖家(语音 8秒)] 这边儿,那就得检查了,那就不是说个人修修了, 就得找那个这种维修的,专门儿维修的给修修。 [卖家(语音 2秒)] 那就不是 350。当初买卡时那句**“有问题你找我我帮你去售后”的豪言壮语,在短短几天内变成了“找专门私人维修修、350块不够”**的杀猪盘。
面对这种无赖嘴脸,多说一句都是浪费口舌。我心灰意冷,把卡拍照,以 3000 元料板/尸体价 挂上了闲鱼,准备自己咽下 1700 元的血亏。
4. 闲鱼遇贵人:老哥拆解“代理商送修”潜规则
事情的惊天反转发生在挂出尸体贴的当晚 22:39。
一位 ID 为
不会飞de云的闲鱼机友主动发来消息:[不会飞de云] 兄弟,你这个可以质保的。 [不会飞de云] 只要是真无拆无修的,包可以质保的。 [不会飞de云] 联系代理商就行了,代理商一般要收取几十到一百的送修费,我的刚送去!随后老哥发来长段语音和实物对比图,为我拆解了二手硬件售后的核心底层逻辑:
- 厂商个保一刀切背后的漏洞:
厂商卡死 2025 年前的个人送保,是为了卡掉大批矿卡和二手散户直接冲击工厂产能。但这不意味着显卡本身脱保! - 真正的绿色通道:区域代理商(总代):
硬件厂商与一级/二级代理商之间有稳定的返厂维修合同配额。代理商送修走的是经销商 B2B 维修通道,工厂根本不查终端消费者的购买发票! - 破局操作 SOP:
- 拨打 400 客服电话,只报序列号(SN 码),确认该卡是否在厂家保修期内;
- 确认在保后,向客服要求获取你所在区域(或全国范围内)的授权代理商/送修经销商联系方式;
- 联系代理商,说明显卡在保,支付 50~100 元的人工代送/物流服务费;
- 代理商查验外观无私拆、无物理磕碰后,直接统一打包发回工厂!
听到这番分析,我茅塞顿开。为了感谢老哥的无私分享,我立刻在闲鱼给对方转了 6.66 元 奶茶钱。在二手鱼龙混杂的泥潭里,这种纯粹的机友互助真的让人心头一暖。
5. 换新落地:以换代修满血复活
周一上班后,我迅速执行了这套代理商送修流程:
- 400 查保:客服输入 SN 码,系统确认显卡在保(质保期覆盖到 2026 年底);
- 对接代理:顺利拿到代理商送修地址;
- 顺丰寄出:支付 50 元代送服务费,顺丰标快寄出显卡。代理商收到后仅核验了螺丝防拆贴与外观,二话没说直接进返厂系统。
返厂一周后,代理商发来回执:显卡核心供电故障,无法局部维修,厂家判定直接更换良品!
几天后顺丰快递到家,开箱验收:
- 换回了一张成色极新的官方良品卡,背板出厂贴纸完好;
- 硅脂垫边缘有少许微量的渗油痕迹(返厂仓储良品的祖传特征,完全不影响电气性能);
- 装机上架 241 节点,一键点亮,顺利通过压力测试,满载核心 60℃、热点 80℃,SMU 通信完全正常!
6. 二手高端硬件售后避坑 SOP(总结指南)
如果你也是常年折腾二手显卡、算力卡的玩家,遇到故障被拒保时,请把这套经过实战检验的 SOP 焊在脑子里:
步骤 关键动作 核心禁忌 / 注意事项 Step 1: 验在保状态 拨打品牌官方 400 客服电话,直接报 SN 序列号查询剩余保修天数。 切勿主动在电话里说“我是闲鱼二手的”、“我没有发票”,只问“请帮我查下这个 SN 码的保修截止日期”。 Step 2: 索取渠道信息 若官方称“旧批次不能个人送保”,顺理成章要求:“请提供离我最近的官方授权代理商或经销商送修联系方式”。 只要卡在保,官方客服有义务提供经销渠道送修路径。 Step 3: 走代理商代保 联系代理商,主动提出支付 50~100 元代保服务费/往返运费。 保证显卡无私拆、无严重物理磕碰、防拆贴完整。代理商不关心一手发票,只看在保和无外观损伤。 Step 4: 破除卖家幻想 闲鱼买卡前,把卖家的“保修承诺”一律当放屁。 能给一手京东/原厂电子发票的才算真在保;没有凭证的,按“脱保或走代理”做好预期折价。
(本文全流程数据、硬件型号、沟通截图及系统日志已归档备查,欢迎硬件社区与折腾玩家交流探讨。)
-
闲的蛋疼,更新下上篇故事的前述-一张 12GB 显卡上的 47 小时:一次手术课件项目里被漏掉的那一段这篇是给 《零代码接单一个月后,我为什么选择止损:一次手术课件 Vibe Coding 项目复盘》 补的一段记录。
那篇复盘是Codex侧(GPT5.6SOL)写的,我在开头留了一句话:"此文由 GPT5.6SOL 撰写,它缺少了一开始我使用本地 Agent 迭代时候的上下文"。
缺的正是最重要的那一段——项目最开始,把甲方给的云端方案往一张 12GB 显卡上落的那 47 小时。那一段的代码、交付包、视频产物、文件时间戳和会话账目都还在机器上,所以下面不是回忆,是可核对的记录。
一、那两天到底要解决什么
甲方给的是一个已经在云端跑通的方案。落到本地只有两个硬约束:
- 一张 3080Ti,12GB 显存(不是 24G,不是 A100),要跑 LTX-2.3 22B 图生视频模型;
- 交付物很具体:一个能在 ComfyUI 里跑通的纯官方节点工作流 JSON,加一段手机录制的一键生产过程视频。
没有设计文档,没有验收清单,没有"效果达到什么程度算过"。
最后这一条,是整件事真正的病根,后面还会回来要账。
二、47 小时里发生了什么
工作窗口是 7/15 13:10 → 7/17 12:34,10 个会话。其中出交付包、出成片的密集迭代,是 7/15 22:58 → 7/16 14:18 那 15.5 小时。
- 07-15 13:10 起 — 拆解甲方那份带私有节点依赖的工作流,确定它在 12GB 卡上的可行边界。
- 07-15 22:58 — 第一版可跑通的 JSON(27KB)。
- 07-15 23:04 — 试了那个"最优雅"的方案:用 ComfyUI 的 List 隐式循环,一条工作流跑完 6 个场景再合并。当天就被实测否掉了(原因见第四节第一条)。
- 07-15 23:27 — V2:改架构。 放弃"在画布内部做统一管线",改成「外部 Python 调度器 + 单场景模板」。
- 07-16 00:23 / 00:51 — V3(显存优化)、V4(首次完整无 OOM 跑通),三个交付包(v2/v3/v4)在 90 分钟内连发。
- 07-16 02:44 — V3 实测。这一次会话跑了 916 条消息、455 次工具调用。
- 07-16 10:00–11:13 — V4 实测:首次产出完整合成片(1.05MB / 36.5 秒)。
- 07-16 12:05–14:18 — V5:加"四级裁图链",出移交文档,成片 1.16MB。
- 07-17 00:25 — 补超分链(384×288 → 高清)。
- 07-17 12:34 — 甲方真正在意的那个要求第一次露头:"识别缝线范围"。
交出的是:一份能跑的产线 + 一段合成好的课件动画。
三、那几天换了多少模型?账目在这里
复盘里记得"换了好几个模型"。会话库把这件事记成了数字。
整个 7 月到 8 月,本地 Agent 侧真实调用过的模型共 13 条记录(跨 provider,9 个模型族):gemini-pro-agent、gemini-3-flash-agent、gemini-3.6-flash(-high)、claude-sonnet-4-6、deepseek-v4-pro、deepseek-v4-flash、glm-5.2(两个 provider)、grok-4.3、grok-3-mini-fast。
而这一支(7/15–7/17,10 个会话)实际落在 3 个模型上:
gemini-pro-agent— 1,178 次调用 / 938.8 万 tokengemini-3-flash-agent— 429 次调用 / 472.8 万 tokendeepseek-v4-pro— 49 次调用 / 9.8 万 token
合计:2,684 条消息,1,656 次 API 调用,1,421 万 token,记录的现金成本 0 元。
这段账目最有价值的地方,不是数字,是它证明了一件事:
换了这么多模型,没有换掉任何一条失败原因。
第四节那 7 条坑,逐条追溯,没有一条跟"模型不够聪明"有关:
- List 隐式循环失效,是 ComfyUI 的节点语义问题;
- 6 张图被拍扁成一个 batch,是工作流的拓扑问题;
- VLM 返回坐标格式漂移,用云端模型还是本地模型都一样,缺的是容错代码;
- 384×288 / 12fps,是 12GB 显存算出来的上限;
- 验收标准没定义,那是流程,不是模型。
换模型是当时最容易做、也最没用的一件事。 那 47 小时里真正起作用的那次动作(V2 改架构),跟模型毫无关系。
四、技术上有用的部分
1. ComfyUI 的 List 隐式循环,在定制节点上会失效。
理论上往下游塞一个 List 会触发隐式循环,但工作流里的缩放/视频节点内部把 List 拍扁成了 batch=6。表现是耗时 167 秒(正好等于一次生成的时间),而且 6 张图被强行杂糅——模型开始脑补:第一次生出一个戴着白色眼罩的女人,把医学线稿图像海盗眼罩一样糊在眼睛上;改掉提示词重跑,它又脑补出一个穿白 T 恤的男人。
模型看到的不是"六张图",是"一帧"。 要把一张线稿动起来,就得一张一张喂——"批量"这个动作必须由画布外面的调度器来做。
这也是 V2 那次架构掉头的直接原因,而这次掉头是那 47 小时里唯一被后续验证为正确的判断:画布上永远只有一个场景的模板,复杂度全部关在 Python 里。结果是 6 个场景在 12GB 卡上连续跑完、零 OOM。
2. VLM 给的坐标不可信,但可用。
实际跑通的是"VLM 出坐标 + 程序做后处理":VLM 会把
1写成"Scene 1",bbox 字段名会漂(ymin/top),偶尔还嵌套数组;加了 8% 边距扩展之后又出现负值越界,导致 OpenCV 保存空图直接崩。把它当"不稳定的专家建议",不要当结构化 API。
3. 裁图最终是四级兜底链:CV 自适应(5 档阈值 + NMS 合并)→ VLM 统一检测 + 场景映射 → VLM 传统裁图 → 硬编码坐标。低对比度扫描件上 CV 会整体失效,所以必须能一键降级到人工坐标。
4. 甲方的工作流带私有节点依赖(
329:xxx形式的引用、XB 系列、ROCm 补丁、sageattention)。最后决定全剔除,只留官方节点 + GGUF 加载器——牺牲一点画质,换"能在任何一台干净机器上装起来"。5.
wait_for_completion只检查gifs/目录,而视频产物落在videos/里,脚本永远等不到结果。6. 帧数没有注入
EmptyLTXVLatentVideo,出来的视频长度和场景对不上。7. 高频重试会让
/free返回 500,显存疑似没完全释放——12GB 跑 22B 时的常态,只能靠控制并发躲开。
五、结束时留下的硬数据
- 代码:6 个 Python 文件 / 1,186 行(编排 131 + 裁图 311 + VLM 检测 473 + 提交 136 + 解析 118 + 合并 17)
- 工作流模板:19 个节点,纯官方节点 + GGUF 加载器
- 渲染参数:配置 384×256(实际输出 384×288,LTX 按 32 对齐)/ 20 steps / 12 fps / VAE 分块 128 / UNet 换出 96 块 / NAG 8.0
- 最终成片:384×288 / 12fps / 36.5 秒 / 438 帧 / h264
- 交付包:4 个(最小的 5.6KB);工作区总占用 约 7.5MB
对照原文里的后期数据(工作区 62GB / 269 个文件 / 115,875 行 / 101 个审计目录 / V17 约 50GB):
阶段零用 1,186 行、7.5MB 工作区,把片子做出来了;后期用 115,875 行、62GB 工作区,过不了验收。
这不是模型变笨了,是流程变了。
六、没解决的四个问题(照实列)
- 裁图坐标仍偏紧(8% 边距不够,应提到 12–15%);
- CV 投影法兜底没实现,当时只存在于讨论里;
- VLM 会把页脚误检成第 6 个子图;
- 384×288 / 12fps 是这张卡的上限——不是审美选择,是显存算出来的。要 1920×1080 / 30fps,只能换卡或多卡。
七、这段记录唯一的新增结论
那 47 小时交出去的东西是**"能跑通"**:产线跑得动、片子出得来、工作流能在别人的机器上装起来。
交不出去的东西,是甲方真正要的**"手术逻辑正确性"——它在 7/17 才第一次以"识别缝线范围"的形式出现,而且从头到尾没有被写成一条可判定的验收条件**。当时的对话里,没有一句话是"什么样的画面算通过"。
开工前我没有把验收条件钉死,这是我的责任。后果就是复盘里那一段:需求只能以"我觉得不对"的形式反复出现;而它每出现一次,当下唯一能做的事就是——再加一道检查。检查越来越严,产出越来越远。
如果这个项目重来一次,先写下这五行,再动第一行代码:
验收条件(化整为零,逐条可判):
1. 输入:一张扫描件 + 一份 Markdown → 输出 6 段场景视频 + 1 段合成片
2. 尺寸 / 帧率:___(阶段零实测:384×288 / 12fps 是 12GB 卡的上限)
3. 每帧必须与对应子图"同构":无新增解剖结构、无新增文字、无人物出现
4. 关键步骤顺序:与 Markdown 的 6 个场景一一对应(顺序错 = 不通过)
5. 修改轮次:___ 轮以内;超出即重新评估范围或终止
第 3 条就是"手术逻辑正确性"的可判定版本——它不需要人去"感觉对不对",只要拿原图逐帧点一遍。如果第一天就有这五条,"感觉不对"最多只能推翻一次。
顺带一句:那套后来一路加到 v4 的质检门,不是被设计进来的。7/17 的对话里它已经被明确拒绝过一次——"我们不需要 qa 系统,只需要把视觉模型提供接口出来给外部调用就行"。它是在没人写下验收条件的情况下,被"每次觉得不对就加一道检查"的惯性,一次一道,慢慢长出来的。
结语
那 47 小时里,我在做的事情是"把东西跑通",那是该做的部分。
真正让这个项目亏钱的,不是模型(换了 13 个都没用)、不是 12GB 显存、也不是谁写的提示词,而是从头到尾没有一个人把"通过"这个词定义成一句可以判定的话。
所以,补上那段被漏掉的记录之后,我想说的其实只有一句:
动手写第一行代码之前,先写下"什么叫做完"。那是最便宜的保险。
本文是 《零代码接单一个月后,我为什么选择止损》 的补记。所有数字来自本地产物时间戳、ffprobe 实测与会话账目。
-
看着视频,学着大神的贴子对于“魔改SGLANG支持7900XTX 双卡TP”的坎坷学习路。 -
看着视频,学着大神的贴子对于“魔改SGLANG支持7900XTX 双卡TP”的坎坷学习路。 -
看着视频,学着大神的贴子对于“魔改SGLANG支持7900XTX 双卡TP”的坎坷学习路。 -
看着视频,学着大神的贴子对于“魔改SGLANG支持7900XTX 双卡TP”的坎坷学习路。哈哈 x99我很久之前就发帖提过不支持p2p,用sglang是难点。不过现在新的是咋样就没了解了,刚换了epyc平台卡就坏了,哎