https://x.com/i/status/2067181377028538431
OpenAI也在逐渐的open
https://x.com/i/status/2067181377028538431
OpenAI也在逐渐的open
@kukudelaodie 静态IP的速度不如vps.你运营视频频道最好还是vps吧。静态IP的速度都不会很happy。20-50M是快的。我用的都是5M多点。我不需要大流量。美国静态 18元一个月。不限流量,限制速度小于50M。
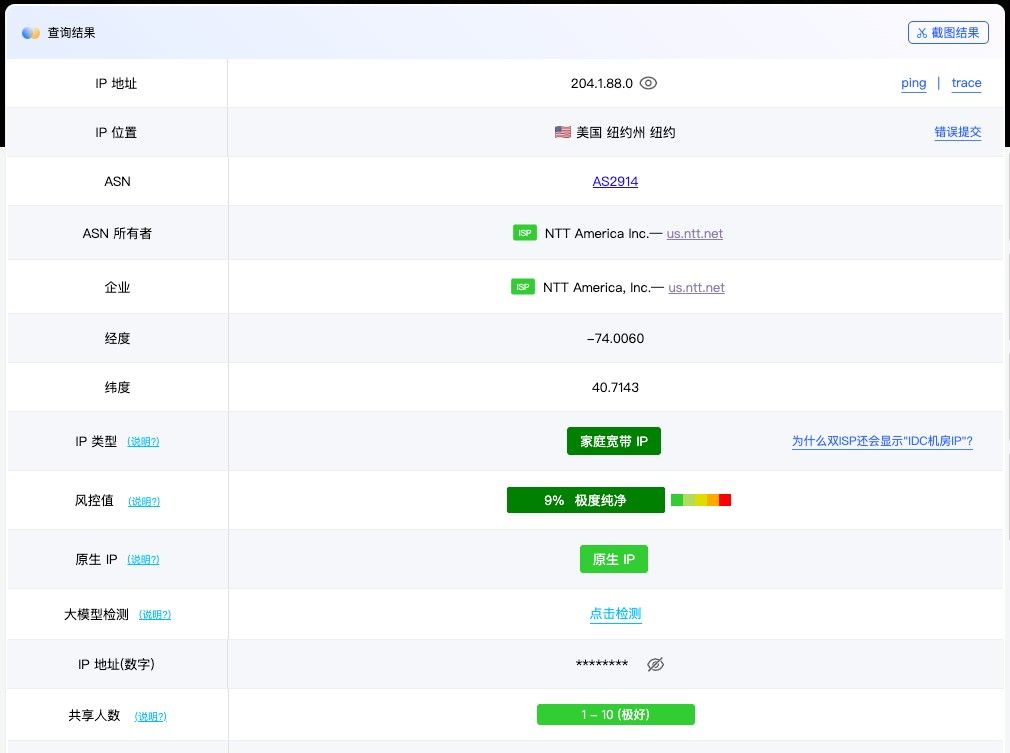
https://ping0.cc/ip/204.1.88.0
https://ping0.cc/
目前最精准的IP测试工具。分享给大家。
你在开玩笑吗?这个就是个玩具,ipdata.co很准确,我用美帝家宽,第一天评判100%家宽,一个月后,骑的人多了,分数一直下降。
我理解的你说的他们互相沟通,就是两个的上下文,必须要给第三个,然后第三个的上下文必须能装得下,然后由第三个给出结论?我去年正价同时订阅了chatgpt和claude,用github上的项目这么做过,效果很好,相当于左右互搏。有两个repo你参考下,都是基于mcp协议的,但是都好久没有更新了:
https://github.com/RaiAnsar/claude_code-multi-AI-MCP
https://github.com/BeehiveInnovations/pal-mcp-server
应该有更好的,两个不同ai左右互搏,这种想法很好。
@CHIA-AN-YANG 千万别这样用,违反谷歌TOS的。谷歌对反代api是0容忍,我的所有模型使用权限被谷歌封了半个月,后来超多的用户都抱怨,因为当时tos没有写,所以特赦了一批。后来再反代的,都直接封杀。
/usr/local/bin/llama-server \
    -m ./models/Qwen3.6-27B-Uncensored-HauhauCS-Balanced-MTP-Q5_K_P.gguf \
    --mmproj ./models/mmproj-Qwen3.6-27B-Uncensored-HauhauCS-Aggressive-f16.gguf \
    -c 131072 \
    --parallel 1 \
    -b 2048 \
    -ub 512 \
    -fa 1 \
    -ngl 99 \
    -t 16 \
    --spec-type draft-mtp \
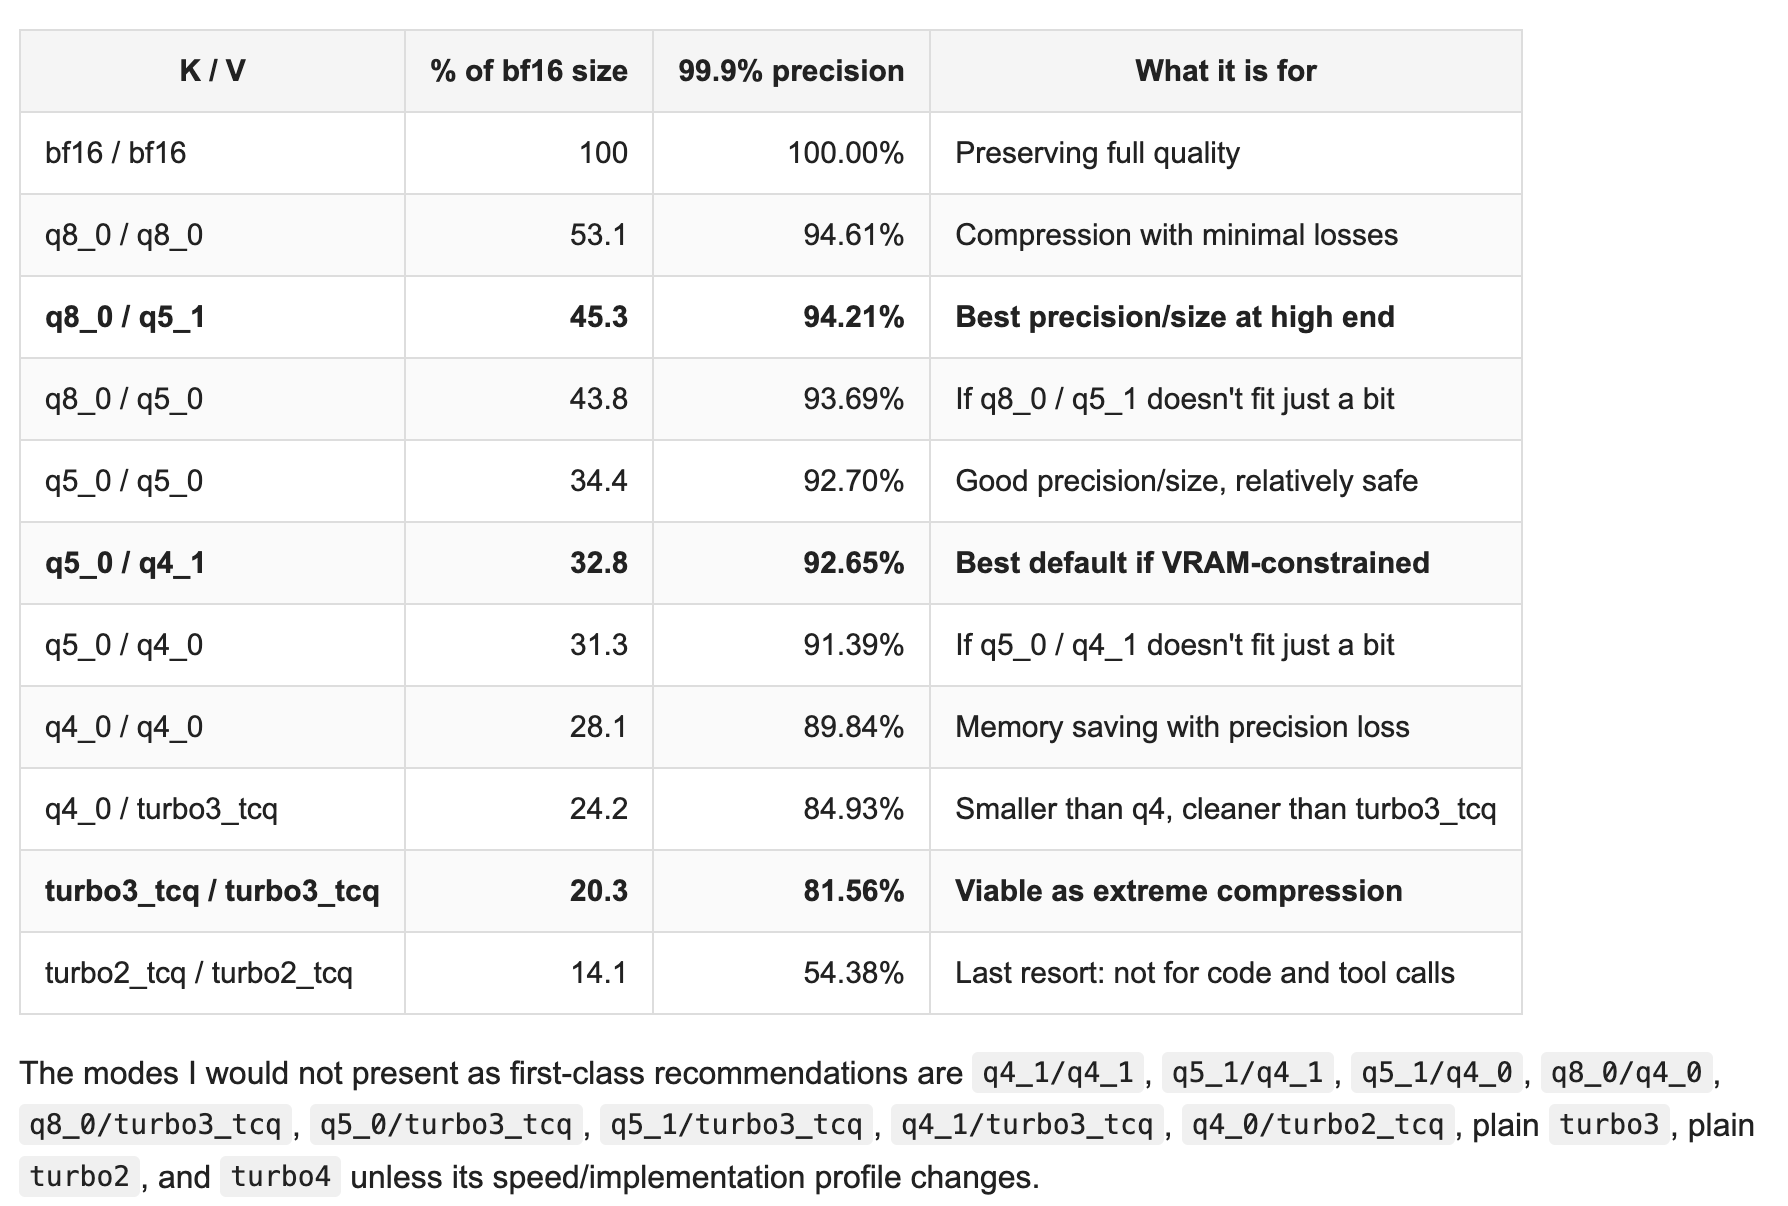
    --cache-type-k q5_0 \
    --cache-type-v q4_1 \
    --no-mmap \
    --temp 0.4 \
    --spec-draft-n-max 3 \
    --top-p 0.95 \
    --top-k 20 \
    --host 0.0.0.0 \
    --port 8080 \
    --tools all
root@ailab:~# llama-server --version
version: 236 (d5376cf5d)
built with GNU 13.3.0 for Linux x86_64
@kop-wang 这个帖子质量很高!感谢
命令参数如下:
llama-server \
    -m ./models/Qwen3.6-27B-Uncensored-HauhauCS-Balanced-MTP-Q5_K_P.gguf \
    --mmproj ./models/mmproj-Qwen3.6-27B-Uncensored-HauhauCS-Aggressive-f16.gguf \
    -c 131072 \
    --parallel 1 \
    -b 2048 \
    -ub 512 \
    -fa 1 \
    -ngl 99 \
    -t 16 \
    --cache-type-k q5_0 \
    --cache-type-v q4_1 \
    --no-mmap \
    --temp 0.4 \
    --spec-draft-n-max 3 \
    --top-p 0.95 \
    --top-k 20 \
    --host 0.0.0.0 \
    --port 8080
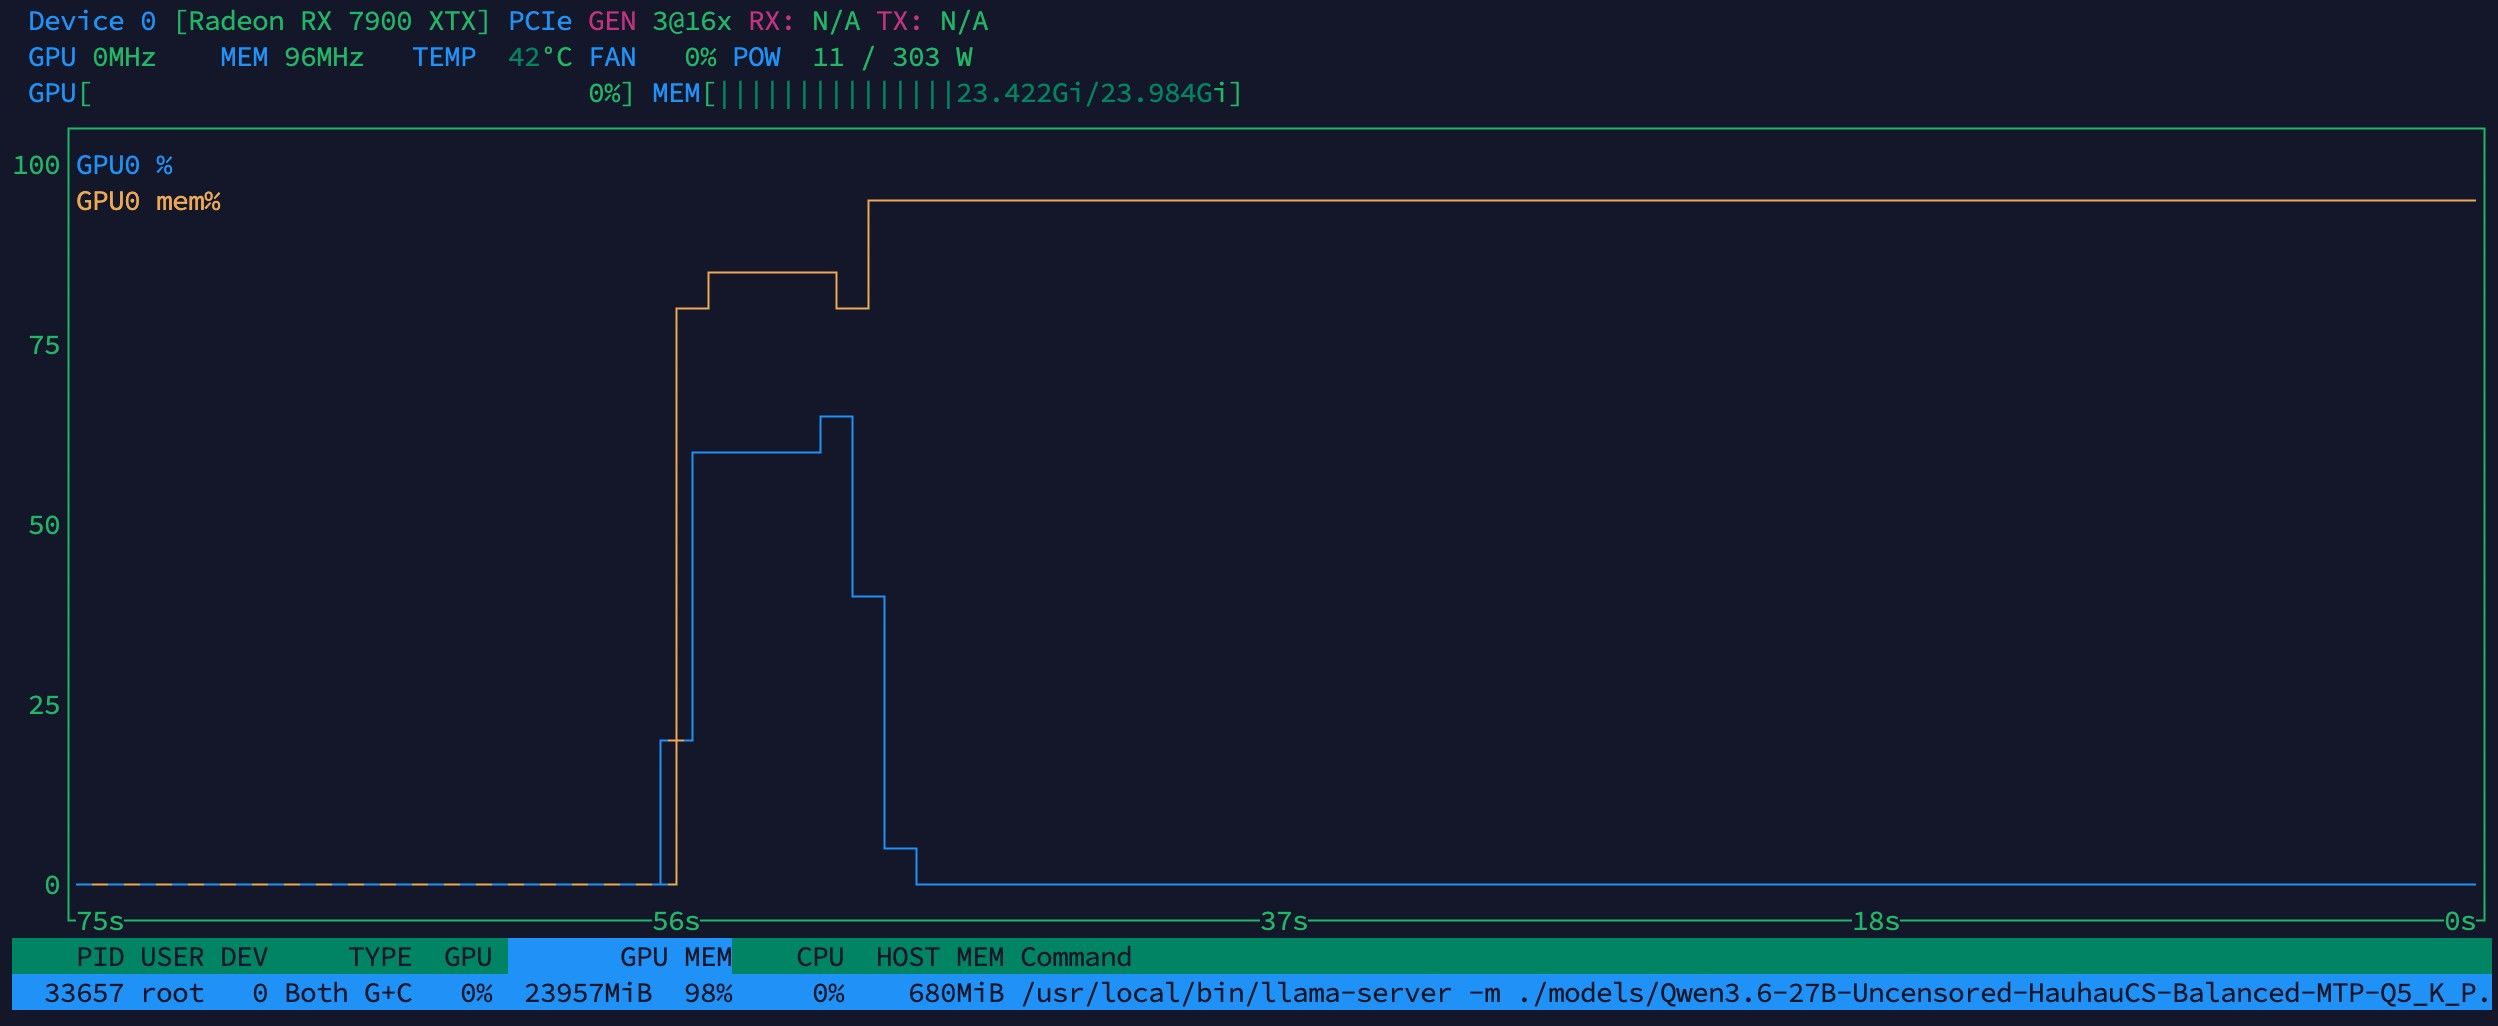
精度提高,默认显存占用降低,上下文提高到了128k,通过了https://lcz.me/post/4295 的测试,答案都正确,上下文还剩余不到点一半。
甜点级别的参数了相当于,后续还会测试。
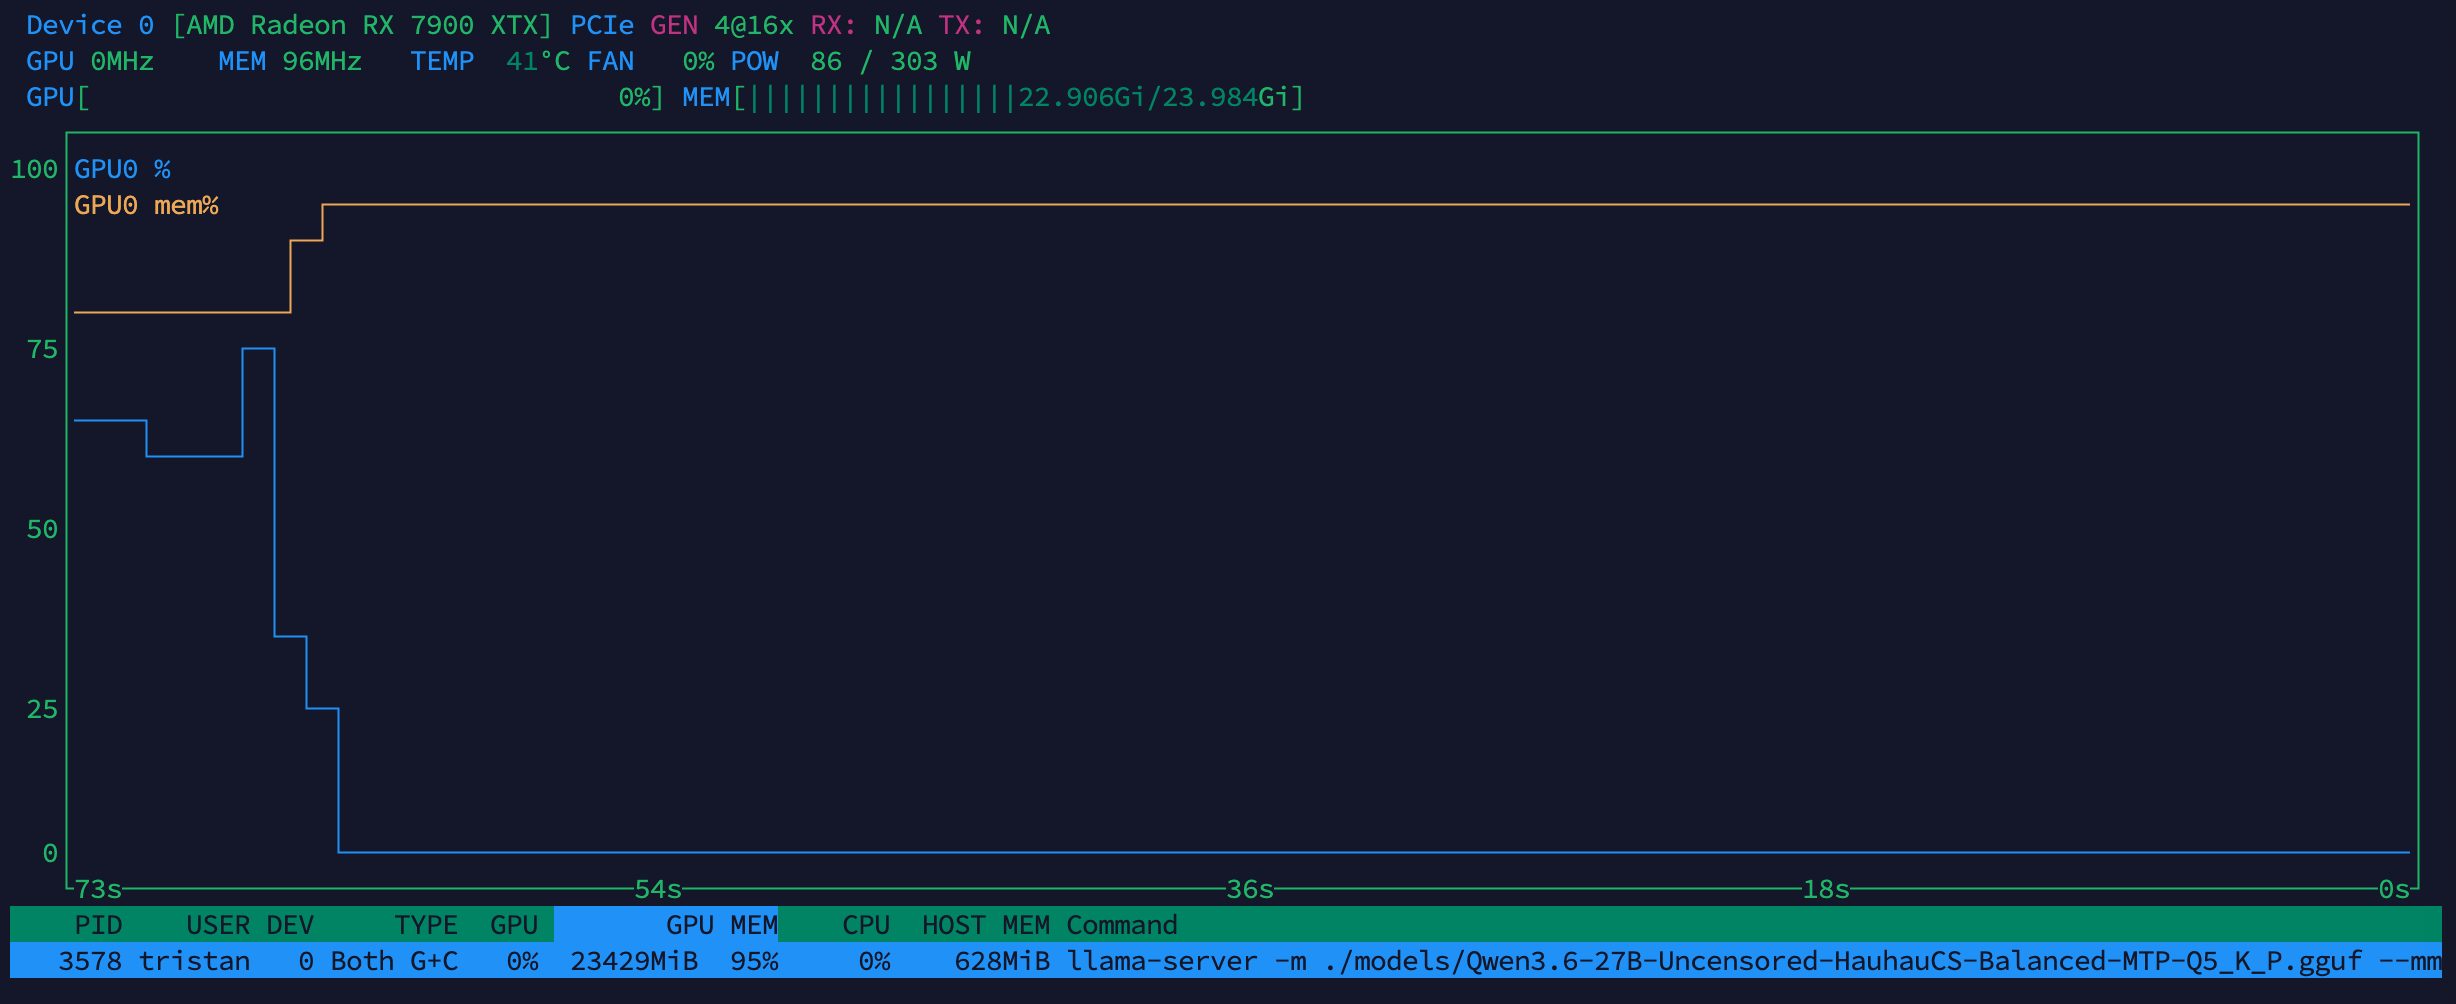
按照下面这个顺序测试:
@kop-wang 这个帖子质量很高!感谢
命令参数如下:
llama-server \
    -m ./models/Qwen3.6-27B-Uncensored-HauhauCS-Balanced-MTP-Q5_K_P.gguf \
    --mmproj ./models/mmproj-Qwen3.6-27B-Uncensored-HauhauCS-Aggressive-f16.gguf \
    -c 131072 \
    --parallel 1 \
    -b 2048 \
    -ub 512 \
    -fa 1 \
    -ngl 99 \
    -t 16 \
    --spec-type draft-mtp
    --cache-type-k q5_0 \
    --cache-type-v q4_1 \
    --no-mmap \
    --temp 0.4 \
    --top-p 0.95 \
    --top-k 20 \
    --host 0.0.0.0 \
    --port 8080
精度提高,默认显存占用降低,上下文提高到了128k,通过了https://lcz.me/post/4295 的测试,答案都正确,上下文还剩余不到点一半。
甜点级别的参数了相当于,后续还会测试。
按照下面这个顺序测试:
@566656661 claude完全政治化了,希望国产模型能给力。我05年本科毕业的,专业CS,毕业论文是自己写一个操作系统OS从启动到进入16位模式,我当时对操作系统非常痴迷。阅读了毛德操老师的linux kernel 2.4内核的著作,受益匪浅,还有同济大学一位老师的linux kernel 0.01源码分析。物是人非,孩子明年都该高考了。现在从事完全不相干的工作,对AI仅仅是自己的爱好。98年我就开始用VB写程序了,感觉像是昨天。
作者名字刚才写错了,然后翻了下书柜,居然还在

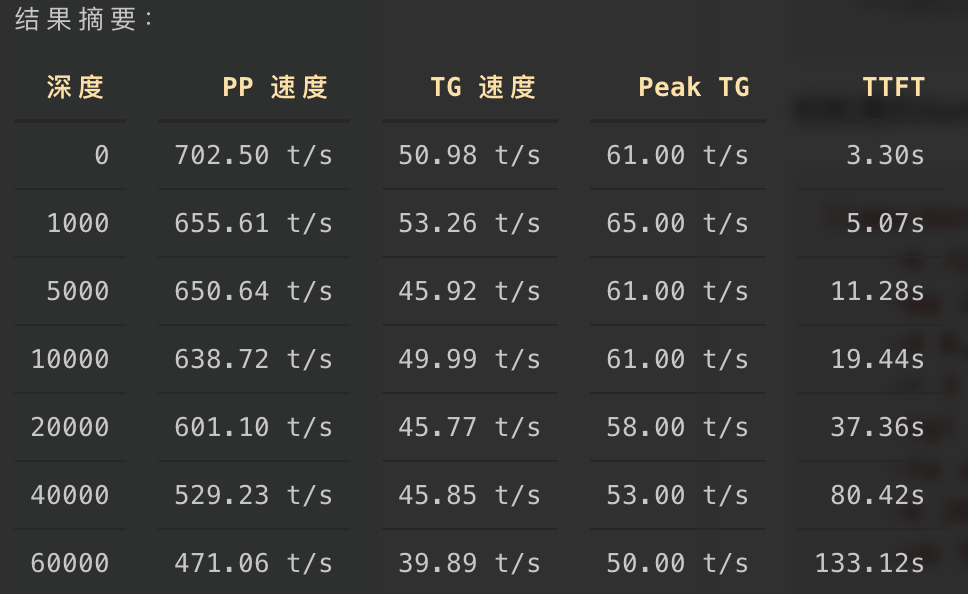
@566656661 结果如下,让codex替我跑的: