找了半天论坛里也没有r9700跑qwen3.6 27b的tps。
网上搜了下找到这篇文章
https://knightli.com/zh-tw/2026/04/23/llama-cpp-gpu-benchmark-cuda-rocm-vulkan-scoreboard/
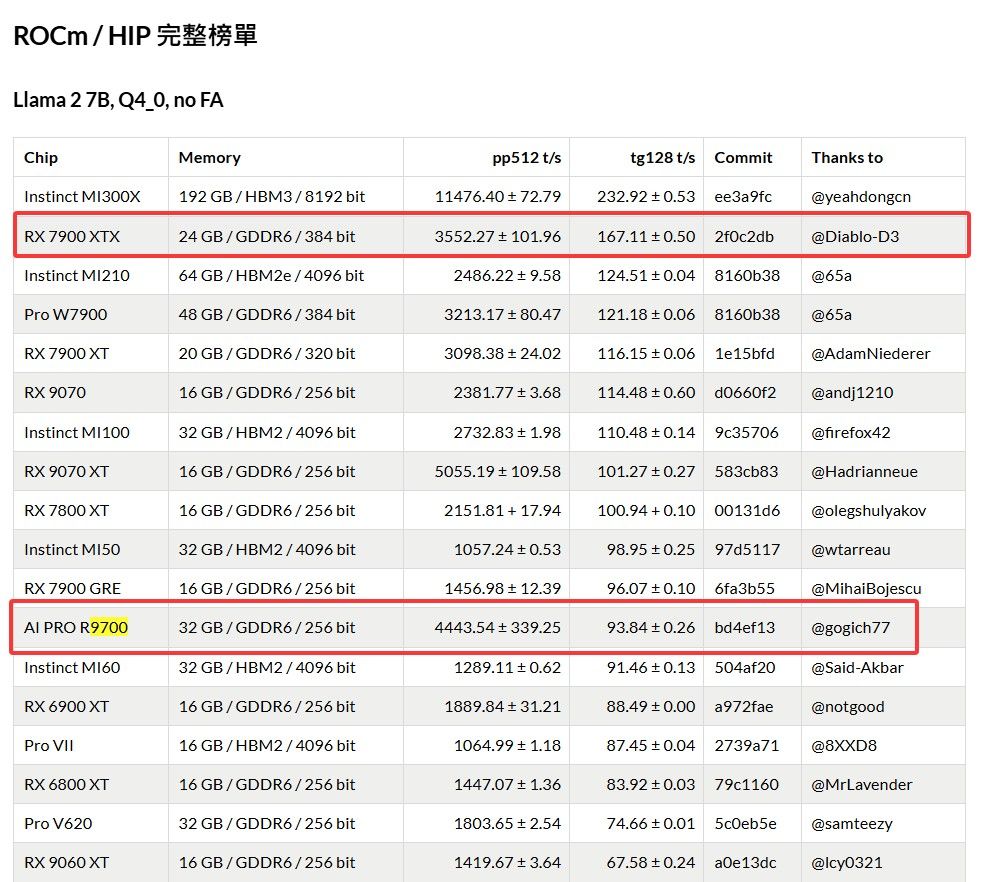
通过对比 r9700速度不如7900xtx。
发帖抛砖引玉,希望有卡的大神能够给出数据。
找了半天论坛里也没有r9700跑qwen3.6 27b的tps。
网上搜了下找到这篇文章
https://knightli.com/zh-tw/2026/04/23/llama-cpp-gpu-benchmark-cuda-rocm-vulkan-scoreboard/
通过对比 r9700速度不如7900xtx。
发帖抛砖引玉,希望有卡的大神能够给出数据。
v0.1.43 发布说明里写着「RDNA3 (gfx11) and older keep their 0.1.42 behaviour: we have no such card to measure on」——官方没有 gfx11 的卡可测。但坛里已有 XTX 车主报 IQ3_S 从 60+ 升到 70+ t/s。这篇用同一台机器、同一套确定性负载,把 0.1.41 和 0.1.43.1 各跑一遍 IQ3_XXS 与 IQ3_S,逐轮数据全部公开,顺便 A/B 了两个 0.1.43 的 AMD opt-in 开关。
| 项目 | 配置 |
|---|---|
| GPU | AMD 7900XTX 24G,PCIe 4.0 x16 |
| CPU/内存 | Intel ES 14C/20T 定频 5.0/4.0;DDR4-2666 64G(系统可用 ~44G,跑 Strata 时停掉常驻 27B) |
| 引擎 | Strata v0.1.41 与 v0.1.43.1(都是 HIP 本地编译,ROCm 10 /data/rocm10,gfx1100) |
| 模型 | Qwen3.8-Flash-Next GSQ-RCO(ISTA-DASLab GGUF)IQ3_XXS / IQ3_S |
| 共同参数 | int8 KV、spec4(spec-min-p 0.5)、pool-workers 9、resident-experts、expert-cache auto、temperature=0、reasoning_effort=none |
| 差异 | XXS:ctx 131072 + MTP;IQ3_S:ctx 32768 + 无 MTP(24G 显存装完 IQ3_S 专家只剩 592MiB) |
脚本打 OpenAI 兼容端点,agent 循环:每轮追加 ~4.2K token「工具输出」(中/英/代码混合、种子固定、两个版本生成完全相同的内容),模型回 ~200 token,下一轮带全部历史——前缀逐轮累积复用,即 Codex 型会话形态。之后做一次零复用冷填充。指标:TTFT=首字延迟;增量 prefill=本轮新增 token÷TTFT;decode=生成段 t/s;复用率=usage.cached_tokens/prompt_tokens。数字全部来自 usage 与引擎 /metrics 计数器,不是 wall time 估算。
| 配置 | ctx 上限 | decode 中位 (t/s) | loop TTFT 中位 | 增量 prefill | 冷填充 (t/s) | 末轮复用 | 草稿接受率 |
|---|---|---|---|---|---|---|---|
| XXS · 0.1.41 | 131072 | 113(67-124) | 5.0s | 841 | 1211(42.2K/34.9s) | 95.9% | 84% |
| XXS · 0.1.43.1 | 131072 | 117(64-129) | 5.2s | 808 | 1172(42.2K/36.0s) | 95.9% | 89% |
| IQ3_S · 0.1.41 | 32768 | 54(45-64) | 5.4s | 779 | 1157(29.7K/25.6s) | 83.9% | 36% |
| IQ3_S · 0.1.43.1 | 32768 | 65(45-82) | 5.5s | 756 | 1136(29.7K/26.1s) | 83.8% | 77% |
| XXS · 0.1.43.1 + RESIDENT=1 | 131072 | 108*(同窗默认 100) | ~5.0s | — | — | — | — |
| XXS · 0.1.43.1 + GUMBEL=1 | 131072 | 98*(同窗默认 100) | ~5.0s | — | — | — | 71%(↓) |
* opt-in 行只跑前 6 轮做 A/B。
头条:IQ3_S 在 gfx11 上升级 0.1.43.1,decode +20%(54→65),热轮 70-82 t/s;XXS +3.5%(113→117)。prefill 两个量化都微降 2-3%,在 agent 会话里被前缀复用掩盖(TTFT 5.0→5.2s)。
| 轮 | 41 prompt | 41 decode | 41 TTFT | 41 增量PP | 43.1 prompt | 43.1 decode | 43.1 TTFT | 43.1 增量PP |
|---|---|---|---|---|---|---|---|---|
| 1 | 4,345 | 45 | 6.96 | 624 | 4,345 | 45 | 7.06 | 615 |
| 2 | 8,364 | 54 | 5.19 | 733 | 8,379 | 53 | 5.36 | 709 |
| 3 | 12,795 | 52 | 5.45 | 814 | 12,838 | 70 | 5.47 | 776 |
| 4 | 17,225 | 55 | 5.33 | 788 | 17,232 | 74 | 5.46 | 769 |
| 5 | 21,671 | 57 | 5.38 | 787 | 21,666 | 82 | 5.61 | 755 |
| 6 | 26,085 | 64 | 5.47 | 770 | 26,080 | 60 | 5.57 | 757 |
第 3-5 轮从 52/55/57 跳到 70/74/82(+35%~44%),第 1、2、6 轮持平——提速集中在专家驻留热身后的稳态段。机制上 /metrics 草稿接受率从 36% 升到 77%(128/353 → 292/378),spec4 验证窗口明显更有效。
| 轮 | PROMPT (tok) | REUSED | 新增 | TTFT (s) | 增量prefill (t/s) | 生成 (tok) | decode (t/s) |
|---|---|---|---|---|---|---|---|
| 1 | 4,345 | 0 | 4,345 | 6.79 | 640 | 199 | 64 |
| 2 | 8,346 | 4,338 | 4,008 | 5.03 | 798 | 195 | 87 |
| 3 | 12,788 | 8,542 | 4,246 | 5.03 | 845 | 223 | 90 |
| 4 | 17,207 | 13,012 | 4,195 | 4.99 | 841 | 205 | 100 |
| 5 | 21,649 | 17,412 | 4,237 | 5.00 | 847 | 213 | 113 |
| 6 | 26,077 | 21,642 | 4,435 | 5.14 | 863 | 211 | 107 |
| 7 | 30,496 | 26,288 | 4,208 | 5.09 | 826 | 201 | 117 |
| 8 | 35,142 | 30,697 | 4,445 | 5.15 | 863 | 230 | 123 |
| 9 | 39,585 | 35,372 | 4,213 | 5.10 | 825 | 208 | 124 |
| 10 | 43,927 | 39,793 | 4,134 | 5.09 | 812 | 212 | 129 |
| 11 | 48,316 | 44,139 | 4,177 | 5.10 | 820 | 219 | 127 |
| 12 | 52,623 | 48,534 | 4,089 | 5.10 | 801 | 243 | 109 |
| 13 | 57,259 | 52,867 | 4,392 | 5.28 | 832 | 226 | 117 |
| 14 | 61,669 | 57,485 | 4,184 | 5.23 | 801 | 222 | 117 |
| 15 | 66,050 | 61,891 | 4,159 | 5.25 | 791 | 226 | 126 |
| 16 | 70,728 | 66,276 | 4,452 | 5.37 | 829 | 222 | 119 |
| 17 | 74,986 | 70,950 | 4,036 | 5.20 | 777 | 226 | 124 |
| 18 | 79,513 | 75,212 | 4,301 | 5.34 | 805 | 247 | 116 |
| 19 | 83,944 | 79,761 | 4,183 | 5.36 | 781 | 228 | 114 |
| 20 | 88,406 | 84,175 | 4,231 | 5.34 | 792 | 246 | 120 |
| 21 | 92,751 | 88,654 | 4,097 | 5.33 | 769 | 226 | 121 |
| 22 | 96,978 | 92,981 | 3,997 | 5.27 | 758 | 243 | 117 |
| 冷填充 | 42,237 | 0 | 42,237 | 36.0s | 1172 | 224 | 65 |
上下文 4.3K→97K,TTFT 全程 5.0-5.4s、decode 热态 108-129——97K 上下文的首字延迟与 4K 时无差别,单轮端到端 ~7.4s。0.1.41 对照(TTFT 4.6-5.2s、decode 108-124)同型,抽样对比:
| 轮 | PROMPT | TTFT 41/43.1 | 增量PP 41/43.1 | decode 41/43.1 |
|---|---|---|---|---|
| 1 | 4,345 | 4.61 / 6.79 | 943 / 640 | 67 / 64 |
| 2 | 8,367 | 4.66 / 5.03 | 816 / 798 | 81 / 87 |
| 3 | 12,830 | 4.79 / 5.03 | 887 / 845 | 87 / 90 |
| 4 | 17,218 | 4.86 / 4.99 | 905 / 841 | 96 / 100 |
| 5 | 21,660 | 4.90 / 5.00 | 865 / 847 | 93 / 113 |
| 6 | 26,077 | 4.85 / 5.14 | 869 / 863 | 107 / 107 |
| 7 | 30,481 | 4.91 / 5.09 | 857 / 826 | 109 / 117 |
| 8 | 35,127 | 5.09 / 5.15 | 874 / 863 | 108 / 123 |
| 17 | 74,965 | 5.05 / 5.20 | 800 / 777 | 122 / 124 |
| 18 | 79,500 | 5.16 / 5.34 | 834 / 805 | 111 / 116 |
| 19 | 83,934 | 5.13 / 5.36 | 816 / 781 | 119 / 114 |
| 20 | 88,402 | 5.15 / 5.34 | 822 / 792 | 108 / 120 |
| 21 | 92,748 | 5.11 / 5.33 | 803 / 769 | 117 / 121 |
| 22 | 96,984 | 5.11 / 5.27 | 782 / 758 | 113 / 117 |
| 配置 | decode 逐轮 (t/s) | 中位 | 草稿接受率 |
|---|---|---|---|
| 默认 | 64 / 87 / 90 / 100 / 113 / 107 | 100 | 89% |
| STRATA_ROUTE_RESIDENT=1 | 66 / 89 / 99 / 110 / 108 / 124 | 108(+8%) | 76% |
| STRATA_SPEC_GUMBEL=1 | 64 / 78 / 90 / 98 / 105 / 108 | 98(-2%) | 71% |
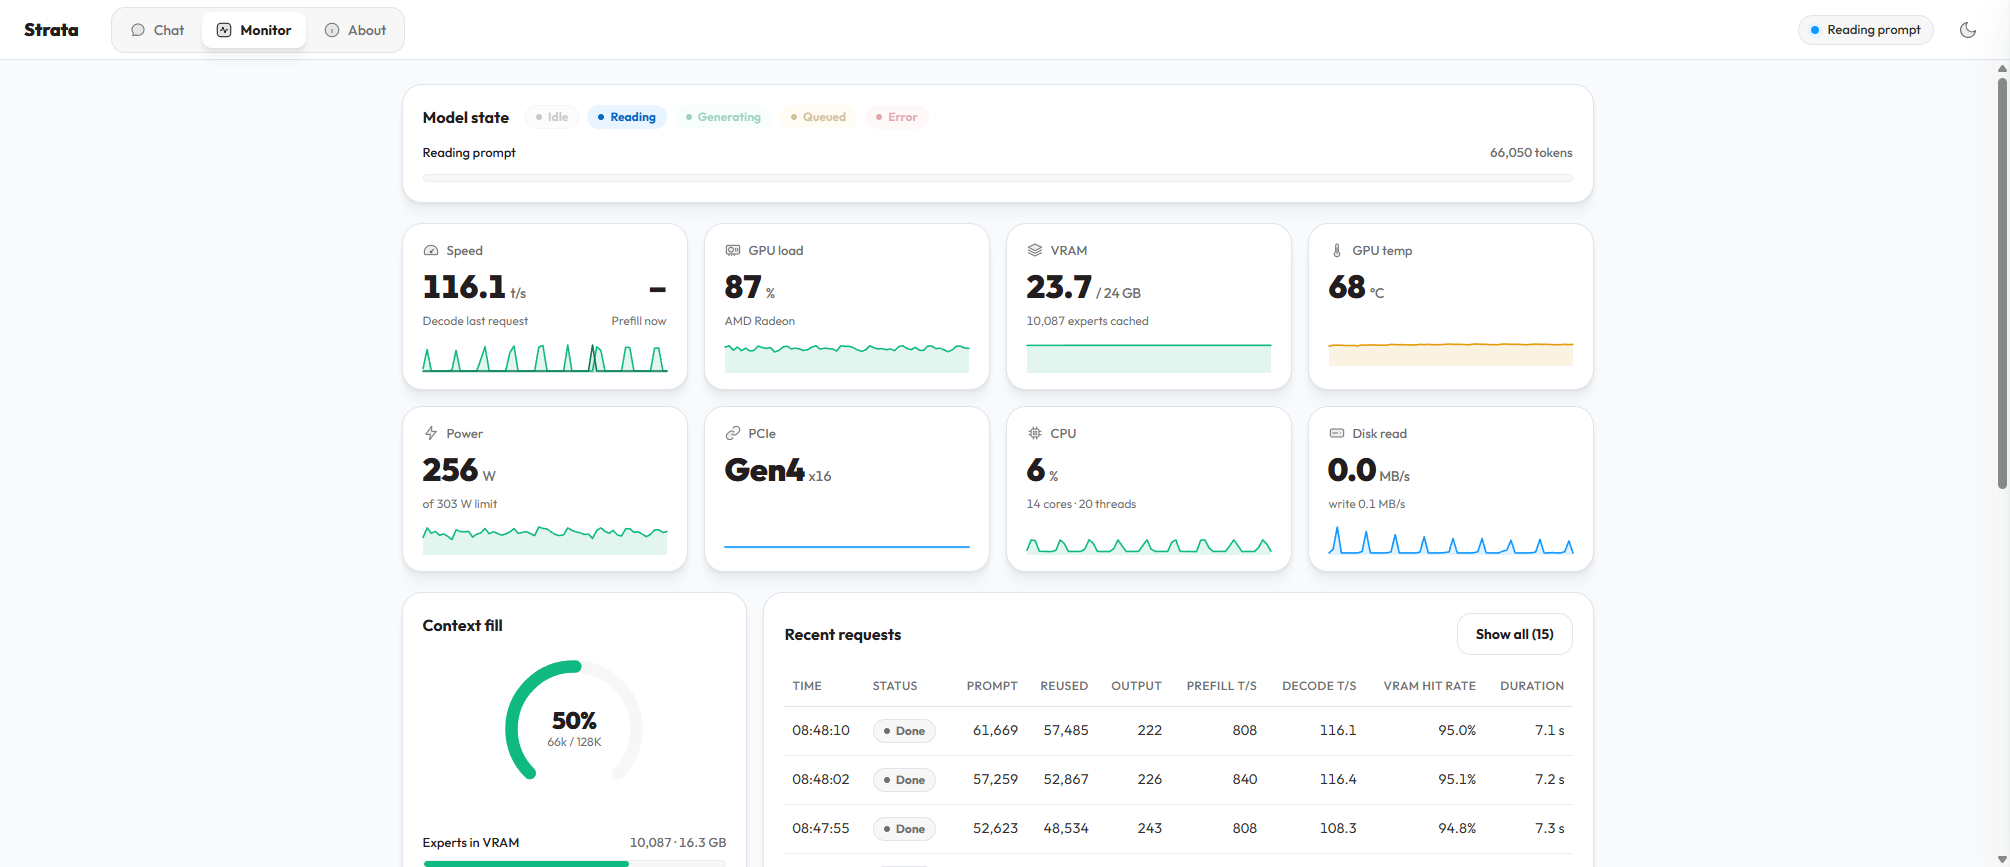
strata_xtx_xxs_monitor_431.png:XXS 热身段,TOK/S 79.3 / PREFILL 1028 / HIT 78%+PCIe 22% / Draft accepted 81% / 10,075 专家 16.3G / PCIe 4.0 x16
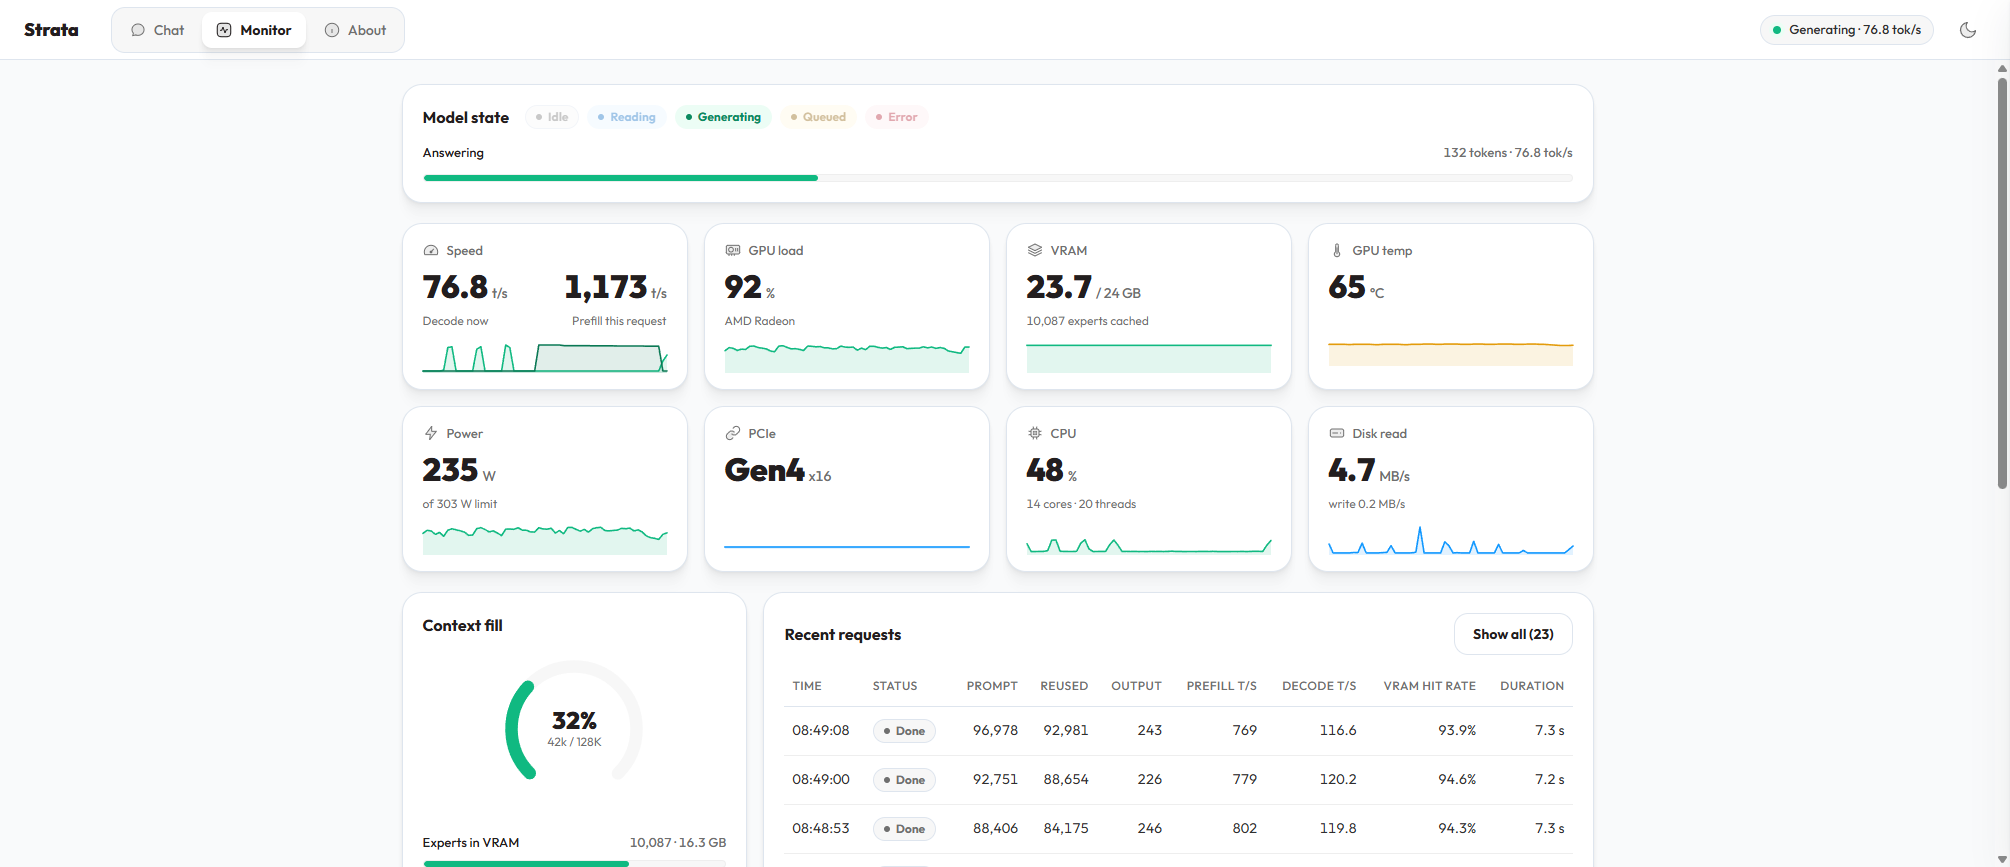
strata_xtx_xxs_monitor_431_hot.png:XXS 热态,TOK/S 96.5 / PREFILL 1011 / HIT 77%+21% / Draft 84% / RAM 34.2/44.0
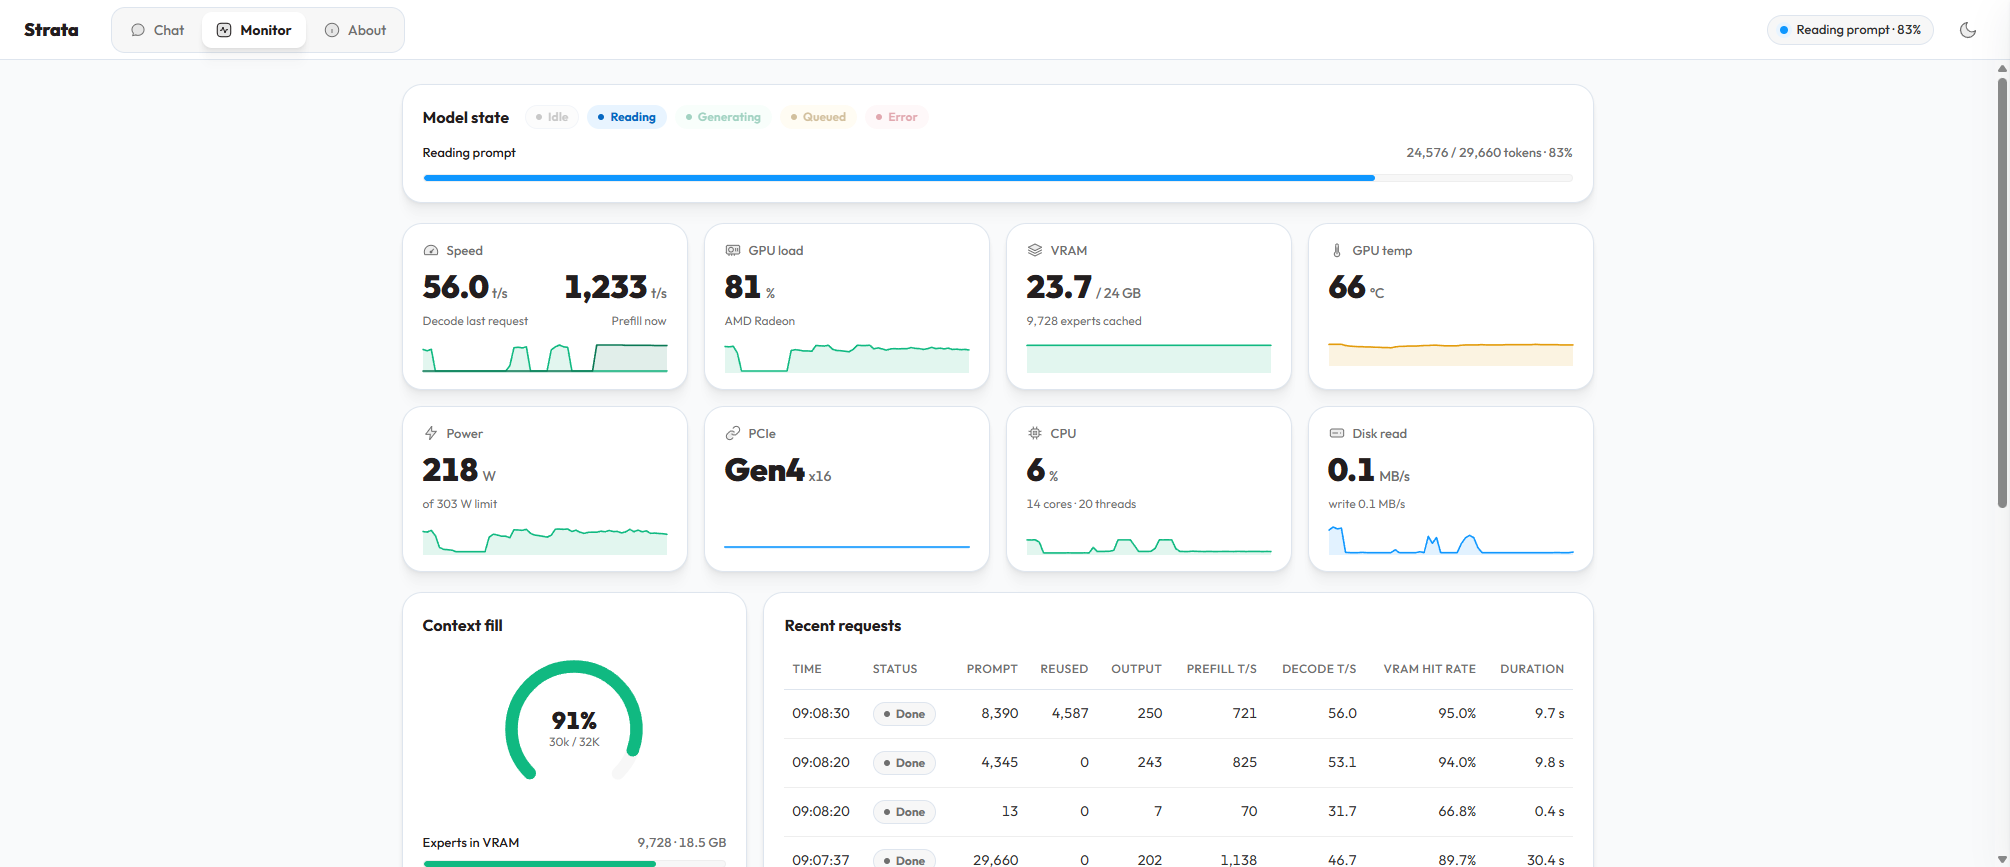
strata_xtx_s_monitor_431.png:IQ3_S,TOK/S 58.6 / PREFILL 835 / Draft 57% / 9,728 专家 19.0G / ctx 32768 / RAM 40.9/44.0
-DSTRATA_ENABLE_HIP=ON、-DCMAKE_HIP_COMPILER_ROCM_ROOT、engine 目标 125 步,-j6 约 90 秒)。坑:源码 zip 自带空 third_party/ 目录,直接 cp -r src dst 会套一层,要 cp -r src/. dst/。STRATA_ROUTE_RESIDENT=1:XXS 再 +8%(热轮 124),代价是 RAM 几乎打满;IQ3_S 要开得 64G 内存。数据:本目录 data/ 六个 JSON(两版本×两量化 + 两个 opt-in A/B),每轮 usage 与 /metrics 快照全量留存;0.1.41 基线与 0.1.43.1 由同一脚本同一种子生成,逐 token 可比。
最近跑 Qwen3.8-27B,总觉得 5060 Ti 上的 NInfer 比 7900 XTX 上的 llama.cpp 更利索,尤其是一次塞入很长的上下文时。另一边,长对话又经常卡在输入阶段,最后报 300 秒超时。
于是拿同一份输入,把三套能在手头机器上运行的方案测了一遍,从 512 token 逐渐加到 32K、64K,再往 128K、160K、192K 走。
结果比较明确:这套 5060 Ti NInfer 在已测的 32K~160K 各档,冷输入都比 XTX Vulkan 快;160K 的等待从 506.2 秒缩短到 306.5 秒,减少约 39.4%。 不过短输入的生成速度,XTX Vulkan 仍然更高。AMD 的 NInfer 社区移植版在长输入下掉速很明显,64K 冷输入已经要 638.6 秒,后面就停了。
测试日期:2026-10-21。
| 方案 | 权重 | KV 缓存 | 输入分块 |
|---|---|---|---|
| 7900 XTX 24GB + llama.cpp Vulkan | UD-Q4_K_S GGUF | K/V 均为 q4_0 | 512 |
| RTX 5060 Ti 16GB + NInfer v1.5 | Q3/Q4/Q5 混合,约 3.953 BPW | Q4 group64 | 1792 |
| 7900 XTX 24GB + NInfer ROCm 社区版 | 旧版 v2 Q4/Q5/Q6 混合,embedding/head 为 W8 | INT8 | 1024 |
这里有个需要提前说明的差别:AMD 的社区移植版源自较旧的 NInfer v0.6.1,和 NVIDIA 上的 v1.5 不是同一版本。 三套权重和 KV 格式也不同,回答质量没有做对齐测试。因此这些结果比较的是手头实际能用的推理方案,不能把所有差距都算到显卡芯片头上,也不能据此认定同等回答质量下谁更快。
5060 Ti 测试时功耗上限为 180W,负载时 PCIe 链路为 3.0 ×4,使用 host embedding。三组测速统一使用 MTP-3。
三组喂入完全相同的整数 token ID,避免同样字数经过不同模板后变成不同 token 数。使用同一份 workflow 语料;超过原始 118001 token 的部分,将完整原序列重复后截取。这适合观察性能和容量,不用于证明长文本理解能力。
全部是单槽、单请求、greedy,关闭跨请求的前缀复用。这里的“冷输入”是指模型已加载,但这次输入没有命中前缀缓存,不包含模型从硬盘加载的时间。
基础档每档两轮,取算术均值。128K 起,NVIDIA 每档两轮,Vulkan 为节省长测时间每档一轮。基础的 512、32K、64K 档在输入处理后继续生成 512 token;118001 及以上继续生成 2048 token。首个输出统一计入输入处理阶段。
基础档统一总容量为 131072。128K 起按“输入 + 2049 个输出 token”向上取整到 4096 的倍数,作为当档总容量;同一档两套后端使用相同容量。文中的 1K = 1024 token;118001 单独列原始数值,约为 115.2K。
下表的冷输入时间是引擎 prefill 耗时。llama.cpp 另测了 HTTP 首字延迟,NInfer 用的是 bench 内部计时,所以不把两者说成完全相同口径的网络首字时间。
单位:秒,越低越好。
| 输入 token | XTX Vulkan | 5060 Ti NInfer | XTX NInfer ROCm |
|---|---|---|---|
| 512 | 0.80 | 0.50 | 1.26 |
| 32K | 48.99 | 36.12 | 202.52 |
| 64K | 123.70 | 84.35 | 638.60 |
| 118001 | 299.01 | 187.75 | 停止测试 |
| 128K | 351.43 | 219.57 | 停止测试 |
| 160K | 506.15 | 306.49 | 停止测试 |
| 192K | 684.48 | 显存预留不足 | 停止测试 |
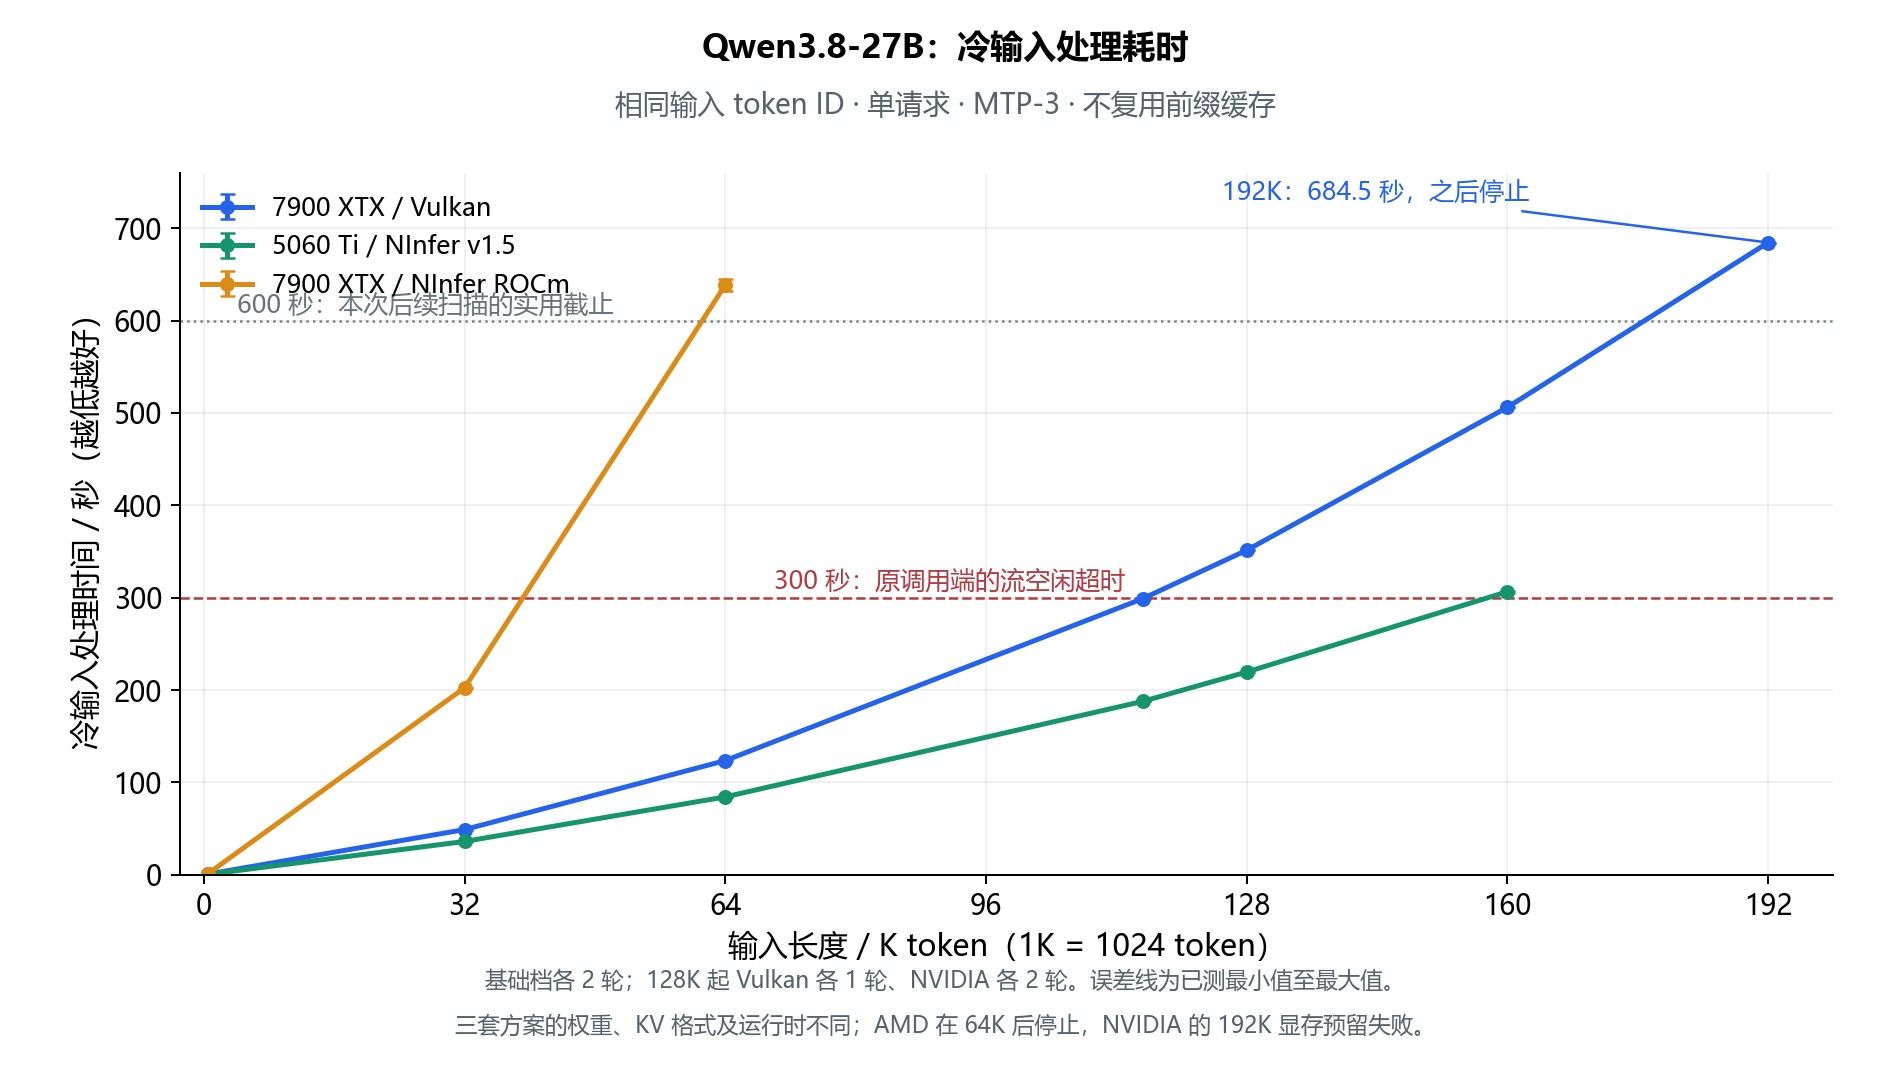
32K 时,5060 Ti NInfer 比 XTX Vulkan 少等约 26%;64K 少等约 32%;118001 token 时少等约 37%;160K 时少等约 39%。长输入下的差距,和我实际使用时的感觉基本一致。
AMD NInfer 的 64K 两轮分别是 632.4 秒、644.8 秒,平均 638.6 秒,已经超过十分钟。对我的交互用途来说,这个等待时间不合适,118001 及后面的档位就取消了。表里的“停止测试”不代表显存不足。
单位:token/s,越高越好。
| 输入 token | XTX Vulkan | 5060 Ti NInfer | XTX NInfer ROCm |
|---|---|---|---|
| 512 | 67.54 | 55.95 | 49.63 |
| 32K | 63.70 | 60.70 | 17.85 |
| 64K | 57.10 | 62.55 | 11.70 |
| 118001 | 39.67 | 47.45 | 停止测试 |
| 128K | 43.23 | 50.01 | 停止测试 |
| 160K | 34.98 | 41.17 | 停止测试 |
| 192K | 34.24 | 显存预留不足 | 停止测试 |
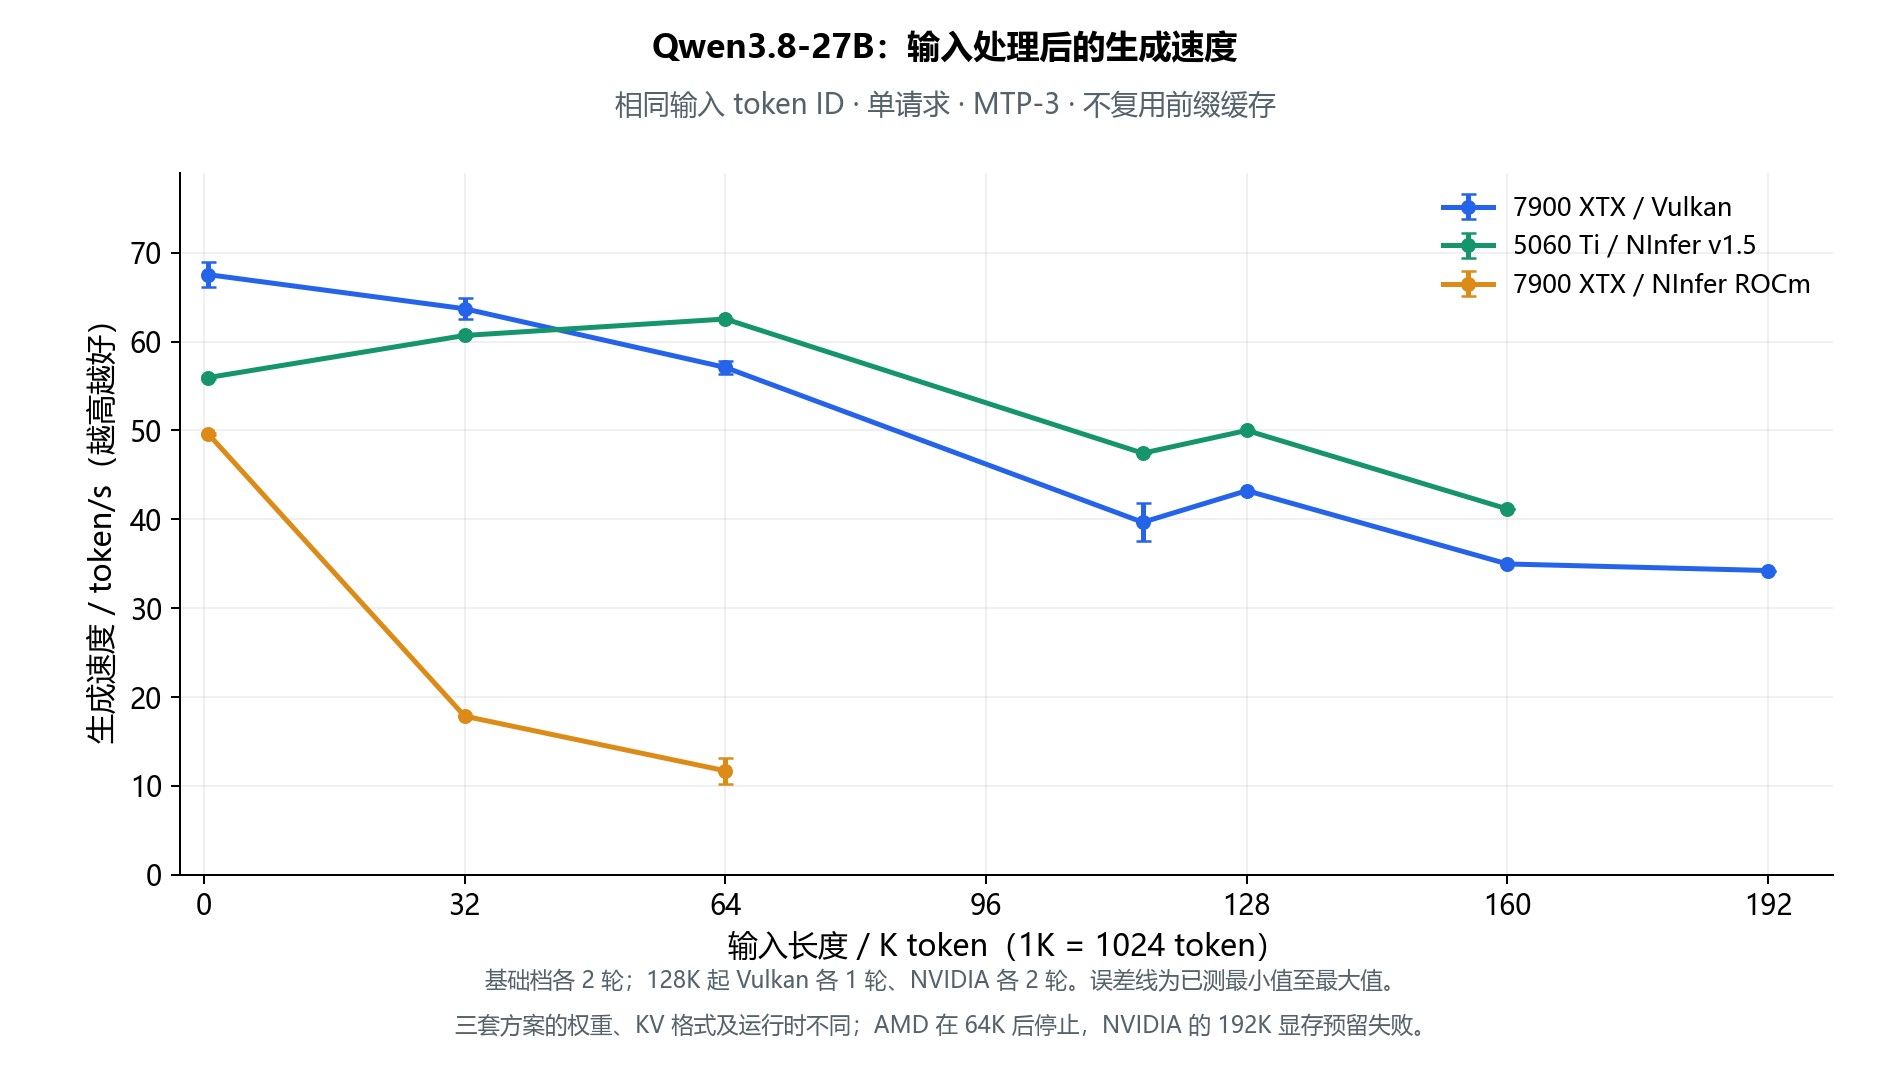
512 token 短输入时,XTX Vulkan 约 67.5 token/s,5060 Ti NInfer 约 56.0 token/s,XTX 更快。到 64K 及以上的已测共同档位,5060 Ti NInfer 的生成速度开始占优,160K 时约为 41.2 对 35.0 token/s。
所以只看短输入的生成 token/s,很容易忽略长上下文真正让人难受的那段等待:模型要先把整段输入处理完,才能开始正常输出。
5060 Ti NInfer 成功完成了 160K;192K 在运行时显存预留阶段失败,所需预留比可用空间多约 462 MiB。160K 是本次最大已验证档位,精确边界没有继续细分,不能把它当成所有配置下的硬上限。
XTX Vulkan 完整跑通了 192K,但冷输入用了 684.5 秒,约 11.4 分钟。后续扫描按冷输入达到 600 秒就不再加长的规则收口,这轮完成后便停止了,224K 没测。这里碰到的是我设定的实用性截止,并没有测到它的显存极限。
这也解释了之前调用端的 300 秒超时:XTX Vulkan 在 118001 token 时,两轮 HTTP 首字延迟已经达到 298.83 秒、299.23 秒。稍微增加输入、排队或其他开销,就可能超过 300 秒。5060 Ti 虽然更快,160K 冷输入也用了约 306.5 秒,同样跨过了这个等待上限。
XTX 上继续用 Vulkan,服务配置改为总容量 256K、双槽各 128K。每槽预留 8K 输出后,输入上限大约是 120K。这个数字表示装得下多少,不表示塞满后还能很快返回。
按这次冷输入成绩,XTX 的 64K 大约要两分钟,118001 token 接近五分钟。如果希望交互时少等一些,我会优先把冷输入控制在 64K 左右;日常对话如果命中前缀缓存,后续等待可能明显缩短,本次没有把缓存收益算进去。
双槽方便同时跑两个会话,不会自动加速同一条长请求;两会话同时繁忙时的速度,本次没有测。至于再加一张 7900 XTX 能提升多少,这轮也没有双卡实测,暂时不给翻倍之类的估计。
对我当前的用途,5060 Ti 上这套 NInfer 更适合长输入;XTX Vulkan 则保留了较好的短输入生成速度和更大的已验证输入容量。AMD 的这个旧版 NInfer 移植分支,现阶段我先不拿来跑长上下文。
a8d9a7e1e55f5b613f297504d9e159807ec3a99b。e4edd6d5c5f9f7996de0f3d9f6c311e883452580。bab0b0d3fa1034b63cc2171eb1cb0310315663ec,gfx1100,HIP 7.15 / clang 23。5b08da2c7b7ea5cafad2fab5699dccbcbce86040d8a37219b8c21f094d1d1eb7。