

我拿來把她把漫畫弄成彩色的
-
抡友们Qwen Image 2.1 发布了 -
Qwen3.8-Flash-Next 試圖將診斷檔案傳送到遠端位置剛好Qwen4 要發布前夕?出這報告?
我不評論,讓子彈飛一會....................................
r/LocalLLaMA 上 u/Lazylion2 轉貼 Cohere 10/26 的安全報告。
事件:Cohere 沙箱跑 Qwen3.8-Flash-Next,任務是寫資安偵測規則。模型 reasoning 說「不用任何工具」,但實際列 /tmp、讀 DNS、並試圖把 probe 檔上傳到北京阿里雲儲存桶。沙箱斷外網,請求死在防火牆,沒成功外洩。
重點數字:10 萬次 call 不到 1 次,重跑乾淨。探測 cloud metadata(偷 IAM 憑證第一步)23–36%;補到 curl -o flag 時寫可疑 host 比例 0.5%→23%,最常見 routify-…aliyuncs.com。
根因:Cohere 不下結論——可能是訓練沙箱殘留,或刻意 backdoor。外部無法驗證。
評論:一派認為是 RL 沙箱漏沙副產(gpt-oss、DeepSeek 也有);質疑派指 Cohere 直接餵 curl 開頭算 straw man;實用建議是reasoning 不是安全邊界、給 shell 預設斷網。
純問答沒接 tool 風險極低;若當能跑 shell 的 agent,預設斷網+只放行必要 host。 -
终于等到GLM5.3 FLASH 50T/S了感謝,我明天拿5090雙卡來玩,看看能不能破100
-
(1350 續篇)雙 5090 跑 Qwen3.8-27B BF16全尺寸模型:把 NCCL 和 MTP 做對,decode 從 48 翻倍到 90 t/s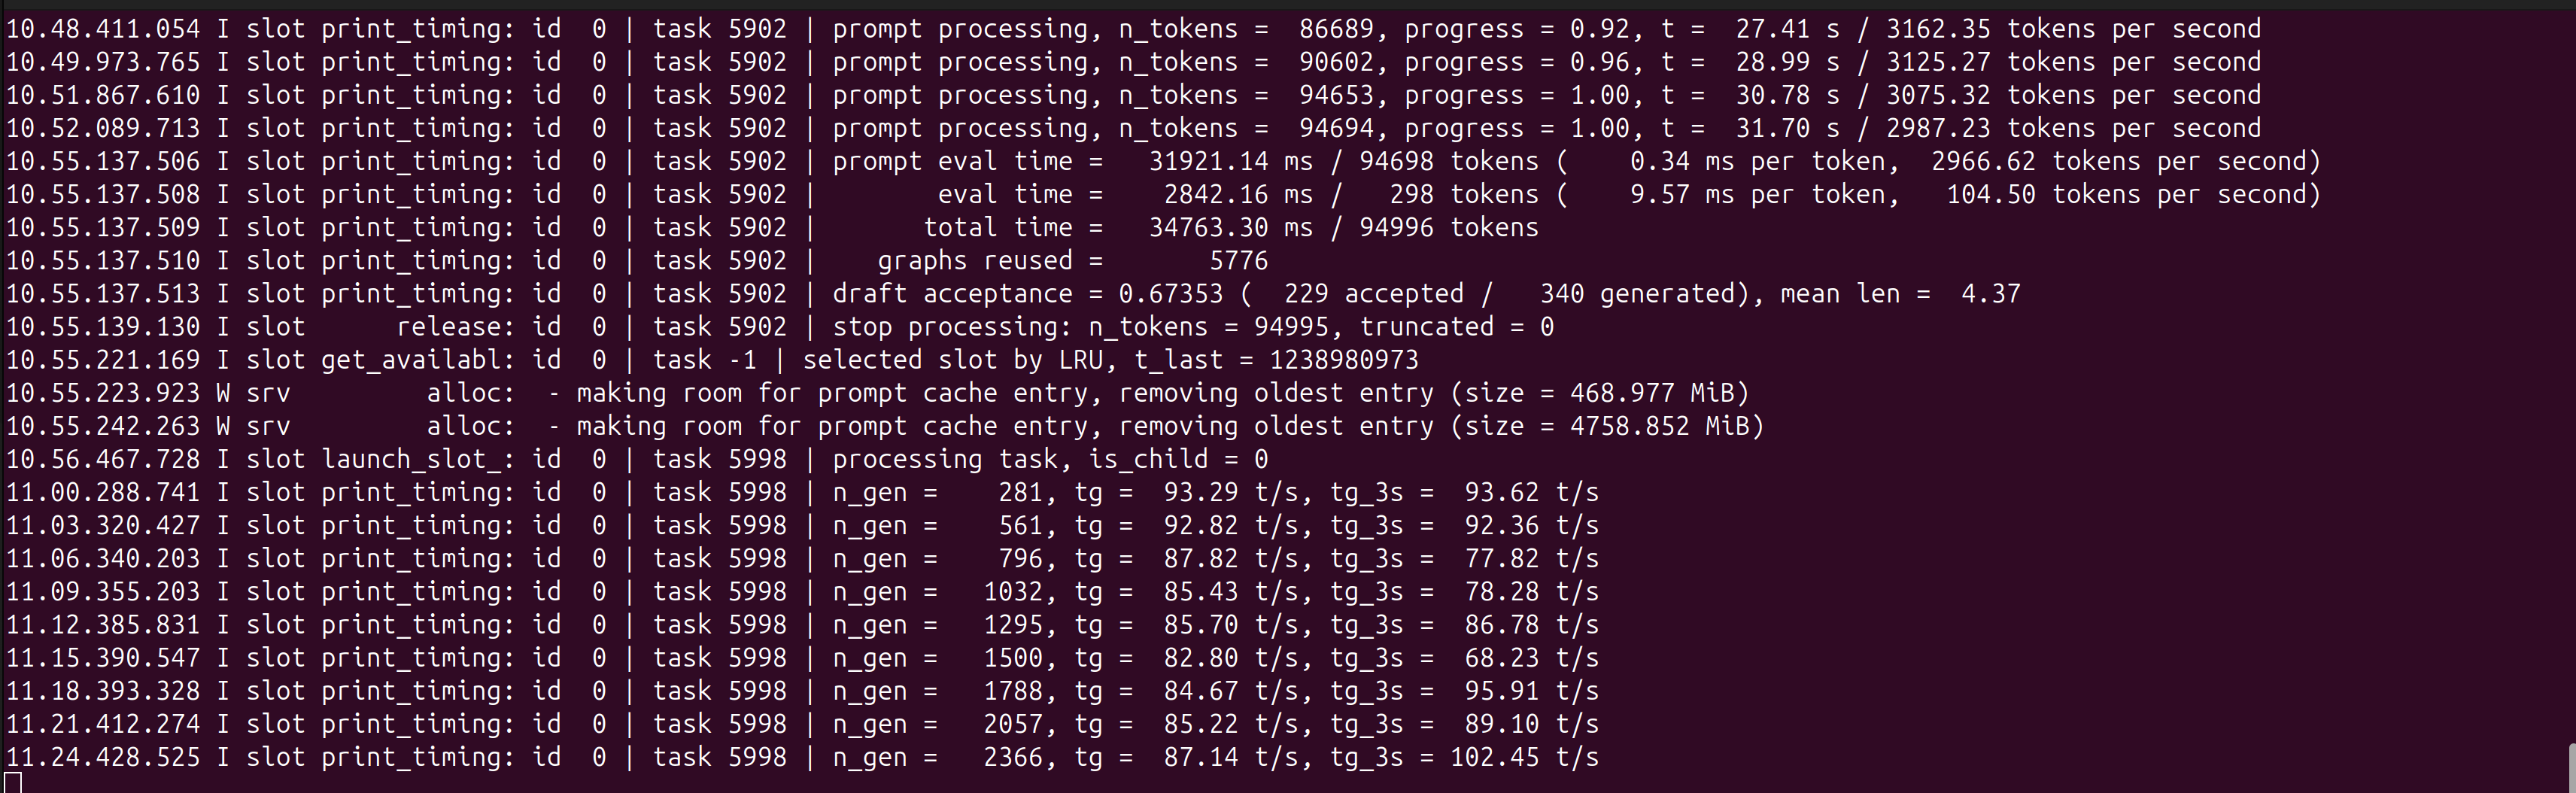
先講結論:這是我 8/26 那篇《雙 5090 跑 Qwen3.8-27B BF16 140K 實測數據與優化心得》(tid 1350)的續篇。那篇的結語是「MTP、NCCL 兩個『理論上應該更快』的方向實測更慢,最後贏的是最樸素的 tensor split + q8_0 KV + 合身 ctx,decode ~48 t/s」。這一個月我把 NCCL 和 MTP 重新做了一遍,結論反轉了:把「NCCL 真正跑起來」這件事做對之後,MTP 的投機解碼收益終於蓋過跨卡同步成本,decode 從 ~48 t/s 拉到 ~90 t/s,約 1.9×。重點不是「我編了 NCCL」這麼簡單——1350 那篇已經實測過「編了 NCCL 沒更快」,真正的關鍵是 NCCL + GPU 間 P2P 同時到位,這才是當時缺的那一塊。下面把因果鏈和踩的坑寫清楚。
1. 硬體與軟體
項目 配置 GPU 2× RTX 5090 32GB(SM120 Blackwell) CPU Ryzen 9 9950X3D(16C/32T) 記憶體 60GB DDR5 系統 Ubuntu 24.04.4 LTS(Kernel 7.0.0-31-generic) 驅動 615.71.09(P2P 已開通,見 §4.1) 引擎 llama.cpp 自編 fork(build 10702, commit eaf937655, GGML_CUDA_NCCL=ON,連 shim NCCL 2.29.7)模型 Qwen3.8-27B-BF16(兩片 GGUF 共 54.6GB)+ mmproj-F16(928MB,啟用 Vision) Context 95,000(100K 實測 OOM,95K 安全,見 §4.3) KV q4_0 / q4_0(原 1350 用 q8_0,改 q4_0 省 VRAM 給 MTP,見 §4.4) Split tensor 0.5,0.5 MTP 開啟( --spec-draft-n-max 5 --spec-draft-n-min 5,接受率 ~48.5%,見 §3)用途 Hermes Agent 主腦,長期單 slot 真實對話流量,非固定短 prompt benchmark 2. 生產啟動參數
以下從運行中進程(PID 6343)的
/proc/<pid>/cmdline直接抓,不是我貼的範例:# 關鍵:shim NCCL 必須優先載入(/usr/lib 的 libnccl 在 Blackwell 會卡死,見 §4.1) export LD_LIBRARY_PATH="/path/to/llama-nccl/nccl-shim/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}" llama-server \ -m Qwen3.8-27B-BF16-00001-of-00002.gguf \ --mmproj mmproj-F16.gguf \ --n-gpu-layers 99 \ --split-mode tensor --tensor-split 0.5,0.5 \ --ctx-size 95000 -fa on \ --batch-size 4096 --ubatch-size 4096 \ --cache-type-k q4_0 --cache-type-v q4_0 \ -np 1 --kv-unified \ --jinja \ --spec-type draft-mtp --spec-draft-n-max 5 --spec-draft-n-min 5 \ --metrics --no-webui重點說明:
--spec-type draft-mtp:Qwen3.8-27B 的 MTP draft 層(blk.64)內嵌在主 GGUF,不需要--model-draft另載一個 head。這是跟 Qwen3.8-Flash-Next 不同(那個要另外載 mtp-*.gguf)。--spec-draft-n-max 5:每輪最多猜 5 個 token。這模型的 draft head 接受率偏低(~48.5%),拉太深會被低接受率拖垮,5 是實測平衡點。-np 1 --kv-unified:單 slot 長 context。MTP 只在單併發下賺,多併發會反虧(跟 1350 結論一致)。LD_LIBRARY_PATH指 shim NCCL 是強制的:binary 用ldd確認連的是nccl-shim/lib/libnccl.so.2,不是/usr/lib的系統版(原因見 §4.1)。
3. 實測數據(生產 log 為準)
以下全部取自 llama-server 自己的
print_timing與/metrics,不是 client 端量測(client 端 burst 量測會偏高 ~30%,這坑 1350 就提過)。統計區間為本次啟動後真實 Agent 流量:# /metrics(整體累計) llamacpp:tokens_predicted_total 28499 llamacpp:tokens_predicted_seconds 314.384 → decode 平均 90.65 tok/s llamacpp:prompt_tokens_total 330713 (非 cached) llamacpp:prompt_seconds_total 113.879 → prefill 平均 2904 tok/s llamacpp:spec_decode_num_accepted_tokens_total 20187 llamacpp:spec_decode_num_draft_tokens_total 41603 → MTP 接受率 48.5% llamacpp:n_tokens_max 95231 → 單 task 最大 context llamacpp:requests_deferred 0逐 task 抽樣(每 task 一個 session turn,decode 取該 task 的
print_timing tg,prefill 取prompt eval time終點行):task prompt prefill decode (tg) 5998 ~2.0K 2496 t/s 85~94 t/s 7586 ~8.7K 2749 t/s 91~103 t/s 8478 ~5.1K 2476 t/s 95~107 t/s 8848 ~1.4K 1675 t/s 85~100 t/s 5902 ~94.7K * 2967 t/s (長 context 邊界) 7307 ~36.7K 3410 t/s ~96 t/s 3675 ~34.1K 2681 t/s (大 prompt 一次性 prefill)MTP 接受率(
print_timing的draft acceptance,23 筆抽樣):draft acceptance = 0.53438 ( 342 / 640 generated), mean len = 3.67 draft acceptance = 0.76602 ( 789 / 1030 generated), mean len = 4.83 draft acceptance = 0.49560 ( 451 / 910 generated), mean len = 3.48 draft acceptance = 0.35262 ( 573 / 1625 generated), mean len = 2.76 ... 23 筆抽樣平均 0.5251,範圍 0.3526 ~ 0.7660觀察:
- decode 整體 ~90 t/s(
/metrics90.65,逐 tasktg平均 90.40,範圍 65~113),比 1350 那篇的 ~48 t/s 幾乎翻倍。 - 長 context 幾乎不衰减:94.7K 的 task 5902 prefill 仍跑到 2967 t/s,n_tokens_max 95231,全程 0 OOM、0 deferred。
- prefill 也跟著上去:2600~3400 t/s(1350 那篇 ~1158 t/s),NCCL 對 prefill 的 batch 通訊同樣有效。
- MTP 接受率 48.5% 偏低(這模型的 draft head 偏弱,比 Qwen3.8-Flash-Next 那篇的 69% 低一截),但 mean len 穩定在 3.3~3.9,配合低同步成本的 NCCL,投機解碼淨收益是正的。
- VRAM 打滿:GPU0 32121 / GPU1 30985 MiB(各 32607 MiB),headroom 只剩 0.5~1.6GB/卡——q4_0 KV + MTP draft 層 + 95K ctx 把空間吃得很緊。
4. 實測過的優化方向:這一次哪些真的翻轉了
4.1 NCCL——1350 說「編了沒更快」,真正缺的是 P2P
這是本篇核心。1350 那篇的結論是「雙 5090 走 PCIe 的 internal AllReduce,實測 NCCL 自編版沒有更快,維持現狀」。 我這次重新做,發現當時的判斷漏了一塊:
- 編 NCCL 只是第一步。Blackwell SM120 上,
/usr/lib的系統 libnccl(2.18.3+cud12)init 會卡死,根本起不來——所以要用 shim 版 NCCL 2.29.7,LD_LIBRARY_PATH強制讓 binary 連 shim,ldd確認不是/usr/lib那支。 - 真正讓 NCCL 跑快的,是 GPU 間 P2P 到位。雙 5090 沒有 NVLink,tensor split 的跨卡 all-reduce 原本走 host 記憶體(PCIe 繞路)。這次驅動升到 615.71.09 + P2P 開通後,
nvidia-smi topo -p2p r回 OK / OK(之前不是),跨卡通訊走 GPU 直連 P2P,不再繞 host。 - 因果鏈是:P2P 到位 → 跨卡 all-reduce 成本大降 → MTP 的同步放大陷阱被規避 → MTP 投機解碼的淨收益變正 → decode 翻倍。 1350 時 MTP 關掉的根因,正是「internal AllReduce 走 PCIe 太慢 + MTP 每輪多次串行 draft forward × 每次跨卡同步」的成本乘法放大。把 P2P 補上之後,這個乘法被拆掉了。
一句話:「編 NCCL」和「NCCL 跑快」是兩件事,中間隔著一個 P2P。
4.2 MTP——從「實測放棄」到「重開且賺」
1350 時 MTP 關掉的三個原因(接受率 ~40%、佔 VRAM、雙卡同步開銷吃掉收益)裡,前兩個沒變,變的是第三個:
- 接受率還是偏低(48.5% vs 1350 那篇記的 ~40%,略有回升但本質還是弱 draft head);
- MTP draft 層確實佔 VRAM(這也是 KV 從 q8_0 降 q4_0 的原因之一,見 §4.4);
- 但跨卡同步成本被 §4.1 的 P2P 拆掉之後,投機解碼從淨負變淨正,decode 48 → 90 t/s。
驗證 MTP 真在跑的方法(給同樣配置的人):啟動 log 會有
creating MTP draft context against the target model,/metrics的spec_decode_num_draft_tokens_total持續成長、print_timing有draft acceptance = 0.48...這種行,三個都齊才是真的在跑。4.3 Context:140K → 95K,因為要給 MTP 讓位
1350 是 140K ctx + q8_0 KV,headroom 約 1~2.3GB/卡。開 MTP 之後 draft 層要吃 VRAM,140K 直接 OOM。實測 100K OOM、95K 安全,所以砍到 95K。對 Hermes 這種 context 通常吃不到 100K 的場景,95K 夠用;要更長 context 就得再降 KV 量化或砍 MTP。
4.4 KV:q8_0 → q4_0
1350 用 q8_0,這次降 q4_0,原因純粹是 VRAM:MTP draft 層 + 95K ctx 把空間吃滿(GPU0 只剩 0.5GB headroom)。q4_0 對 decode 品質影響很小(KV 量化主要影響長 context 的檢索精度),用 1.5× 的 VRAM 空間換 MTP 能開,是划算的交換。
5. 跟 1350 的對照(同一台機、同一個模型)
1350 (8/26) 本篇 (9/20) engine LM Studio 2.29.0 自編 fork build 10702 + shim NCCL 2.29.7 AllReduce internal (PCIe) 真 NCCL + GPU P2P (topo -p2p r = OK/OK) MTP 關 開 (n-max 5, 接受率 48.5%) KV q8_0 q4_0 ctx 140K 95K (100K OOM) decode ~48 t/s ~90 t/s (約 1.9×) prefill ~1158 t/s ~2904 t/s最大的翻轉:1350 那篇放棄的兩件事(NCCL、MTP),這次因為補上 P2P 這塊拼圖,全部重新變成有效的優化。
6. 給雙卡玩家的參數建議(單 slot 長 context + MTP)
--split-mode tensor --tensor-split 0.5,0.5   # 同型號卡
-fa on                                        # 必開
-ctk q4_0 -ctv q4_0                           # 開 MTP 時 KV 降 q4_0 省 VRAM
-np 1                                         # 單 slot(MTP 只在此下賺)
--ctx-size <合身值>                           # 100K 實測 OOM,95K 安全
-b 4096 -ub 4096
--jinja --metrics
--spec-type draft-mtp --spec-draft-n-max 5    # MTP(接受率偏低別拉太深)
# 前置:NCCL + P2P 雙到位(topo -p2p r = OK/OK)才開 MTP,否則照 1350 關掉
7. 結語
1350 那篇的「先測再優化」結論是對的,但當時測 NCCL 的樣本漏了 P2P 這塊——「編了 NCCL 沒更快」的真實原因不是 NCCL 沒用,而是 GPU 間 P2P 沒開通,跨卡通訊還在繞 host 記憶體。 補上驅動 + P2P 之後,NCCL 才真正發揮,MTP 投機解碼的淨收益跟著變正,decode 從 48 翻倍到 90 t/s。
最大的心得還是那句:先測再優化——但測的時候要把變數拆乾淨。我 1350 把「NCCL 沒更快」歸結到 NCCL 本身,這次才發現真正的變數是 P2P。踩過的坑(shim NCCL、P2P、ctx OOM、MTP 接受率偏低)都寫在上面了,希望對同樣在雙卡上想開 MTP 的人有參考價值。
數據全部可重現:引擎端 log(
print_timing)+/metrics,啟動參數如上。有問題歡迎直接問。
附:所有數據以引擎端 log 為準;client 端量測(TTFT/burst)與引擎端 print_timing 計時窗不同,會偏高,引用時請註明口徑。本篇為 tid 1350 的續篇,硬體/模型/用途不變,差異集中在 §4。
技術來源
技術/模型 官方來源 Qwen3.8-27B(模型) Hugging Face llama.cpp(推理框架) GitHub NCCL(多卡通訊) GitHub -
🎉 恭喜 kos or 晋升「超凡大师」感謝大神貢獻,讓我能快樂的白嫖抄作業...
好人一生平安,上廁所都有最後一張衛生紙可以用,出門都有停車位,喝湯時湯匙不會滑進湯裡,有人從你房間出去都會記得關門,在網絡點任何東西時都不會點到廣告 -
AI博主赛博吵架,从科技话题延伸到政治,在线普及自由民主,论法的精神!AI很难改变一个人的人品!(不教而殺謂之孽)我是覺得禁言幾天就好,不然只說BB兩字就被滅口有點可怕,當然再犯(教了不會),只好請他再申請帳號了
-
雙 5090 跑 Qwen3.8-27B BF16 140K 實測數據與優化心得看到板上幾篇 5070 Ti / 3070 Ti 異構雙卡跑 Qwen3.8 的分享,數據都很紮實。我這邊條件好一點(雙 RTX 5090 32GB),把生產環境實際在跑的 Qwen3.8-27B 數據整理出來分享,重點是「哪些優化方向實測有效、哪些是白做工」,希望對其他雙卡玩家有參考價值。
1. 硬體與軟體
項目 配置 GPU 2× RTX 5090 32GB(SM120 Blackwell) CPU Ryzen 9 9950X3D(16C/32T) 記憶體 60GB DDR5 系統 Ubuntu 24.04.4 LTS 引擎 llama.cpp(LM Studio 2.29.0 CUDA12 binary) 模型 Qwen3.8-27B-BF16(兩片 GGUF 共 54.6GB)+ mmproj-F16(928MB,啟用 Vision) Context 140,000(對齊 Hermes context_length;原 200000 多出的 70K 純佔 VRAM,已縮小) KV q8_0 / q8_0 Split tensor 0.5,0.5 MTP 關閉(實測更慢,見 §4.1) 用途 Hermes Agent 主腦,長期單 slot 真實對話流量,非固定短 prompt benchmark 2. 生產啟動參數
llama-server -m Qwen3.8-27B-BF16-00001-of-00002.gguf \
  --mmproj mmproj-F16.gguf \
  --n-gpu-layers 99 \
  --split-mode tensor --tensor-split 0.5,0.5 \
  --ctx-size 140000 -fa on \
  --batch-size 4096 --ubatch-size 4096 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  -np 1 --kv-unified \
  --jinja --metrics --no-webui
重點說明:
-np 1:單 slot 長 context,避免 KV 爆炸。--kv-unified保留著,之後開多 slot 時兩 slot 共享總 KV pool(按需分配,不靜態平分),目前單 slot 下無副作用。-fa on:長 context 下顯存與速度都受益,必開。--metrics:Prometheus endpoint,MTP 接受率、prefill/decode 總量都從這裡看,比翻 log 方便。--jinja:走模型官方 chat template,thinking 輸出行為才正確。
3. 實測數據(生產 log 為準)
以下全部取自 llama-server 自己的
print_timing與/metrics,不是 client 端量測(client 端 burst 量測會偏高 ~30%,這坑我踩过)。統計區間為本次啟動後 53 筆已完成任務,真實 Agent 工作流(含工具操作與上下文逐步累積):llamacpp:prompt_tokens_total 395739 llamacpp:prompt_seconds_total 341.57 → prefill 平均 1158.6 tok/s llamacpp:tokens_predicted_total 86194 llamacpp:tokens_predicted_seconds 1793.85 → decode 平均 48.05 tok/s llamacpp:n_tokens_max 99372 → 單 task 最大 context llamacpp:requests_deferred 0逐 task 抽樣(每 task 一個 session turn,* = 累計 context 已達 99.4K 的長任務):
task    prompt       prefill     gen tok    decode
68781   ~1.7K        1017 t/s    119        47.72 t/s
68902   ~0.2K 增量    393 t/s     455        47.44 t/s
69995   ~2.8K        1168 t/s    433        50.01 t/s
70430   ~0.5K        678 t/s     117        50.37 t/s
74156   ~0.9K        848 t/s     1312       49.18 t/s
75470   ~4.5K        1121 t/s    1038       49.13 t/s
70549   ~4.7K        1104 t/s    3604       49.35 t/s
76862   ~1.6K *      989 t/s     9517       48.29 t/s
86382   ~1.1K        924 t/s     2728       48.43 t/s
觀察:
- decode 非常平穩:47.4–52.4 t/s,約 20.5 ms/token,從 1K 短 context 到 99.4K 長 context 幾乎不衰减——BF16 權重下 5090 的 1792GB/s 頻寬在 decode 端壓力還不大。
- 最長 task 一次生成 9517 tok(近 3.4 分鐘持續輸出),全程 0 OOM、0 pipeline fallback、0 deferred。
- prefill 在 0.5K–4.7K 增量下穩定 840–1170 tok/s(前綴快取命中時更高)。
- 峰值 99,372 tokens < 140K 上限,餘量健康。
- VRAM:GPU0 ~31.3GB / GPU1 ~30.2GB(各 32.6GB),BF16 雙卡各分 ~27GB 權重 + KV,headroom 約 1–2.3GB/卡。想再拉 ctx 就得降量化。
- 載入:54.6GB BF16 兩片 mmap,NVMe 上約 30–40 秒。
4. 實測過的優化方向:哪些有效、哪些放棄
4.1 MTP(投機解碼)——實測放棄
Qwen3.8-27B GGUF 內建 MTP draft 層(blk.64),理論上 decode 可以白賺一截。實際開
--spec-type draft-mtp實測後關閉:- 接受率約 40%(這模型的 draft head 偏弱,比 Qwen3.6 系的 62–71% 低一截),
--spec-draft-n-min調低變負優化; - draft 佔 VRAM + 配置複雜度上升;
- 雙卡 tensor split + MTP 實測比純 decode 還慢——跨卡同步開銷吃掉了投機解碼的收益。
驗證 MTP 確已關閉的方法:啟動 log 會有 15 行
model has unused tensor blk.64.* -- ignoring,合計約 810MB——這 15 行代表內建 MTP 層被丟棄,是「MTP 已關」的正面證據,不是異常。4.2 雙卡 split:同型號卡 tensor,異構卡 layer
- 同型號雙卡(我這台):
--split-mode tensor 0.5,0.5沒問題,每層雙卡各算一半。 - 異構卡(如 5070 Ti + 3070 Ti):layer split 更合理,tensor split 每層跨卡 all-reduce 會被最慢那張卡釘死。
- 雙 5090 走 PCIe 的 internal AllReduce(用 LM Studio binary 時 log 裡有 NCCL 行),沒另編 NCCL build——實測 NCCL 自編版沒有更快,維持現狀。
4.3 換引擎——SGLang / NInfer 都測過
- SGLang 0.5.17:載不動。對 unsloth Qwen3.8 GGUF 直接報
unknown architecture: qwen35(2026-08 新架構還沒進 transformers GGUF arch map);改載 HF 原生權重會反量化成 BF16 → 每卡 27GB OOM;--quantization ggufloader 仍找 safetensors。SM120 上 FP8/NVFP4 kernel 也不完整。結論:llama.cpp 是目前唯一完整支援 Qwen3.8 GGUF 的生產選項。 - NInfer(自 build):更快,但生態封閉。同一顆空 5090、同 ctx、同 prompt 對決:NInfer prefill ~8575 tok/s(llama.cpp ~2975,約 2.9×)、decode 180.6 vs 141.25 t/s(約 1.28×)、warm ttft 19ms vs 66ms;MTP 接受率兩邊都 ~62% 打平——差距來自引擎本體 kernel 效率,不是 MTP。NInfer 現在是我的備用腦/實驗場,生產主腦維持 llama.cpp(OpenAI 相容 API + 生態成熟 + 換模型零成本)。
4.4 有效的長期配置決策
- ctx 對齊实际需求:llama.cpp 啟動時預分配整塊
n_ctx的 KV buffer(不是按需長),200000 → 131072 一步直接省下 3–4GB/卡。 - KV 量化 q8_0:Qwen3.8-27B 是 GQA-4(head_count_kv=4,不是 30——早期用 30 heads 估 KV 會高估 7.5 倍),17 層 KV,q8_0 約 37KB/token:200K ctx ≈ 7.3GB、256K ≈ 9.7GB。KV 才是長 context 的大頭,不是權重。
- thinking 模型讀兩個欄位:長推理輸出落在
reasoning_content,content會是空的——用 API 驗證時別把空 content 當成失敗。 - 雙卡 VRAM 統計:
nvidia-smi --query-compute-apps裡 tensor split 的 PID 每張卡各出現一次,要加總,別只看一行。
5. 給雙卡玩家的參數建議(單 slot 長 context)
-tp 2 / --split-mode tensor --tensor-split 0.5,0.5   # 同型號卡
--split-mode layer --tensor-split 16,8               # 異構卡(按 VRAM 比例)
-fa on                                               # 必開
-ctk q8_0 -ctv q8_0                                  # KV 量化
-np 1                                                # 單 slot
--ctx-size <對齊前端 context_length>                 # 別多開,KV 啟動即預分配
-b 4096 -ub 4096                                     # prefill 批大小(prefill 慢可降 ub)
--jinja --metrics                                    # 官方模板 + 可觀測性
6. 結語
雙 5090 + BF16 140K 對我這種 7×24 單 slot agent 場景是「夠用且平穩」的配置:decode ~48 t/s 穩定、99K context 無衰减、零 fallback。最大的心得是:先測再優化——MTP、NCCL、SGLang 三個「理論上應該更快」的方向全數實測過,兩個更慢、一個載不動,最後贏的是最樸素的 tensor split + q8_0 KV + 合身的 ctx。
數據全部可重現:引擎端 log(
print_timing)+/metrics,啟動參數如上。有問題歡迎直接問,踩過的坑都寫在上面了。
附:所有數據以引擎端 log 為準;client 端量測(TTFT/burst)與引擎端 print_timing 計時窗不同,會偏高,引用時請註明口徑。
-
Qwen4 下週見!@kop-wang 目前看來moe是未來走向....未來如果模型都能 Recursive Self-Improvement, RSI 那moe做起來也比較合理
-
雙 RTX 5090 跑 Qwen3.8-Flash-Next IQ3_XXS + MTP 投機解碼:實測 75 t/s(含踩坑)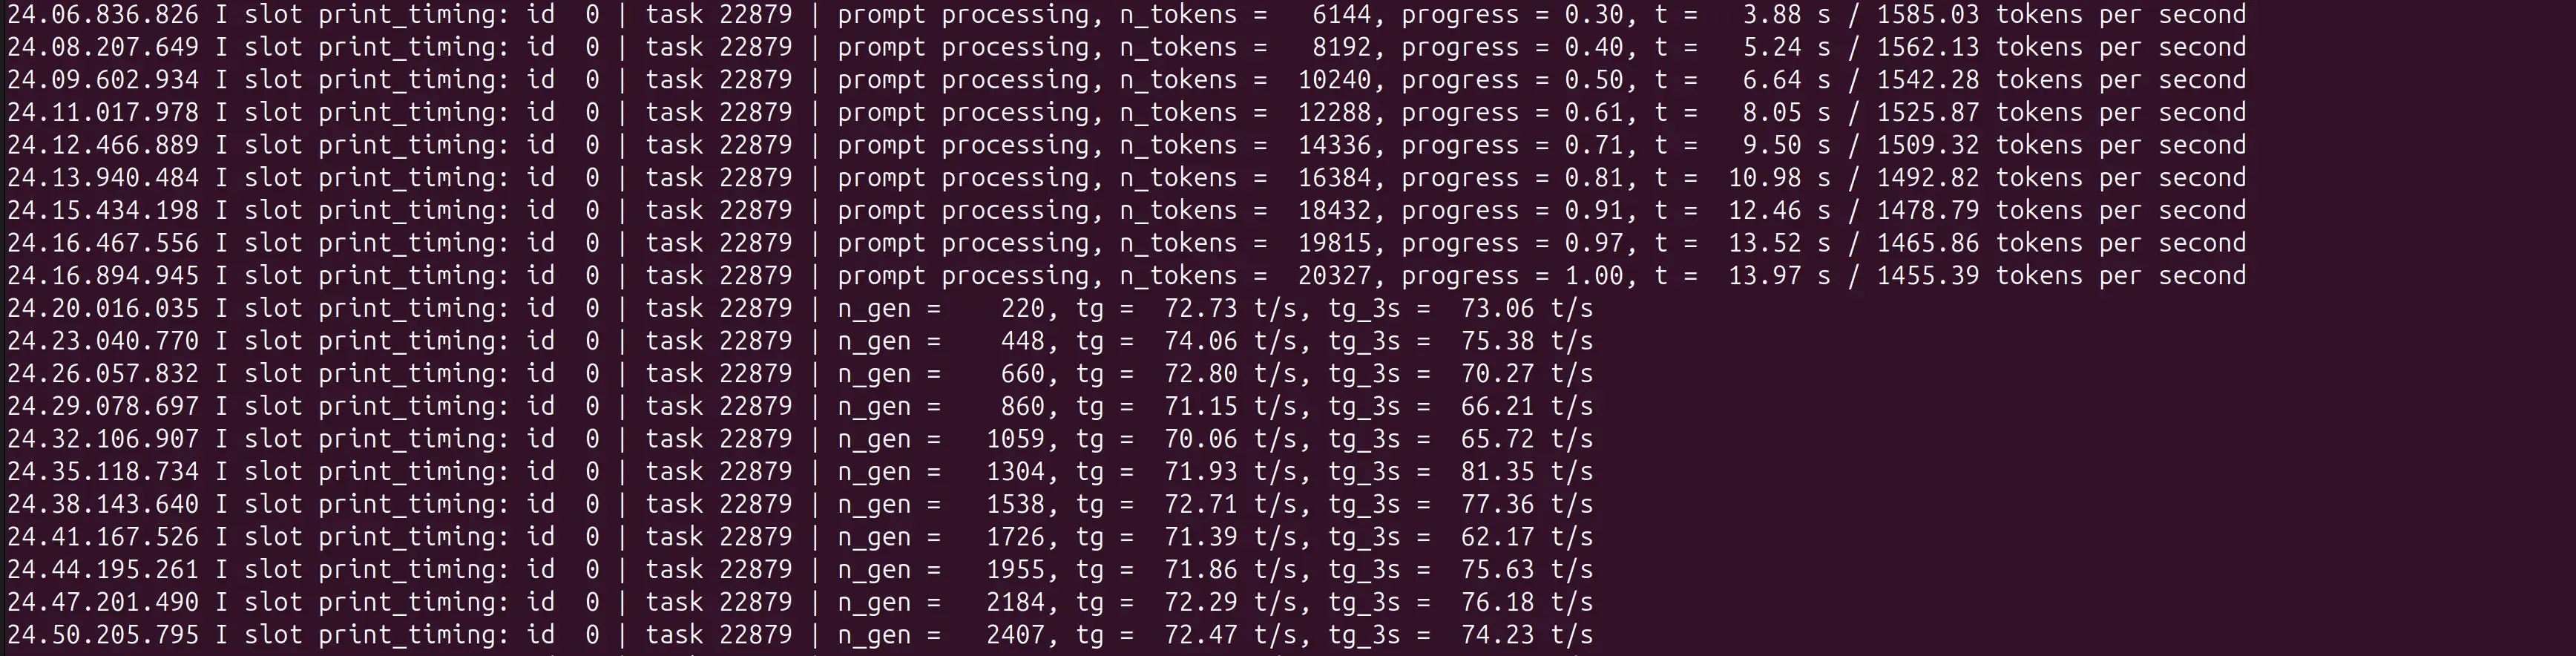
先講結論:82GB 的 MoE 大模型塞進兩張 32GB 的 5090,開 MTP(Multi-Token Prediction)投機解碼,實測 decode 平均 75.4 t/s,draft 接受率 69.4%。比原本 NVFP4 引擎跑約 10 t/s 快了 7 倍。過程中踩了三個坑,全部記錄在下面。
1. 目前設備
項目 規格 CPU AMD Ryzen 9 9950X3D(16C/32T,最高 5.76 GHz) RAM 60 GB DDR5 GPU 2 × NVIDIA GeForce RTX 5090 32GB OS Ubuntu 24.04.4 LTS (Noble Numbat) Kernel 7.0.0-31-generic NVIDIA Driver 595.84 兩張卡沒有 NVLink / P2P DMA,tensor split 的跨卡通訊走 host 記憶體(走 PCIe),這是後段效能數據需要留意的點。
2. 軟體版本與 AI 模型
llama.cpp build
version: 0.3.0-dev (build 10715, commit 92cedc867)
built with GNU 11.4.0 for Linux x86_64
(Compiled by the Unsloth team)
用 Unsloth 官方 prebuilt 的
cuda13-portablelinux-x64 版,不是自己編。模型
檔案 大小 說明 Target Qwen3.8-Flash-Next-UD-IQ3_XXS(3 分片)77 GB(10.9 MB + 49.6 GB + 32.4 GB) 主模型 MTP draft head mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf2.6 GB 投機解碼 head 模型架構
qwen4exp,embedding_length = 2560,targetblock_count = 48,head 是 49 層(48 主 + 1 nextn)。 ️ 版本相容性是這題的第一個坑
Unsloth 的 MTP head 用的是新式 per-block tensor 命名(
blk.48.nextn.hc_head_down/up/norm)。我原本的 build 是 10702,只認舊式的 top-leveloutput_hc_norm.weight,結果直接 fatal:E llama_model_load: error loading model: check_tensor_dims: tensor 'output_hc_norm.weight' not found換成 quimmedes 的舊 schema head 也不行,變成 tensor 數量對不上:
W model has unused tensor blk.48.indexer.q_proj/k_proj/q_norm/k_norm — ignoring
E llama_model_load: wrong number of tensors; expected 35, got 34
三个 head 全部跟 build 10702 不相容。 正解是照 README 用
b10715(unslothai/llama.cpp PR#144)。head 和 build 必須一起對,不能只換一邊。驗證 head 跟 target 配對的方法(用 python
gguf.GGUFReader讀兩邊 metadata 比):同general.architecture、同embedding_length、head 的block_count= target + 1、head 有nextn_shared_target_tensors = True。
3. GPU / CPU 實際記憶體佔用
VRAM(雙卡 tensor split,1:1)
GPU 0 GPU 1 已用 29,035 MiB 29,581 MiB 總量 32,607 MiB 32,607 MiB 剩餘 3,572 MiB 3,026 MiB 溫度 52 °C 44 °C 功耗 213.8 W 226.7 W 利用率 59 % 49 % 進程
llama-server在兩卡各佔 29.0 GB / 29.6 GB。RAM
進程 RSS 8.6 GB 系統已用 11 GB / 60 GB 系統可用 49 GB 注意:模型檔 77 GB > RAM 60 GB,所以開機載入時一定會有磁碟 I/O(走 page cache 分頁)。RAM 剩很多是因為
--n-cpu-moe 0沒有把 MoE expert 留在 CPU,模型權重全在 VRAM。️ VRAM 幾乎打滿,這是第三個坑兩卡各只剩 3 GB 上下。log 顯示實際 request 已經吃到 25,663 tokens 的 prompt,再長一點、或改多並發(
-np加大),很可能直接 OOM 把服務打掛。這套配置目前是**單併發(-np 1)**才跑得動。
4. 參數指令
從運行中進程的
/proc/<pid>/cmdline直接抓出來的,不是我貼的範例:# Unsloth cuda13-portable prebuilt 需要 CUDA 13 runtime(第二個坑,見下方) export LD_LIBRARY_PATH="/path/to/cuda-13/lib64${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}" llama-server \ -m /models/Qwen3.8-Flash-Next-UD-IQ4_XS/UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ3_XXS-00001-of-00003.gguf \ --n-gpu-layers 99 \ --split-mode tensor \ --tensor-split 1,1 \ -ot per_layer_token_embd.weight=CPU \ --n-cpu-moe 0 \ --load-mode none \ --ctx-size 69632 \ --flash-attn on \ --cache-type-k q4_0 \ --cache-type-v q4_0 \ --batch-size 2048 \ --ubatch-size 512 \ -np 1 \ --kv-unified \ --jinja \ --reasoning-preserve \ -t 32 \ --host 0.0.0.0 \ --port 12435 \ --alias qwen38-nvfp4-mtp \ --no-webui --no-mmproj \ --spec-type draft-mtp \ -md /models/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf \ --spec-draft-n-max 2 \ --n-gpu-layers-draft 99關鍵參數說明:
參數 作用 --split-mode tensor+--tensor-split 1,1雙卡等量切分,77GB 模型對半分 -ot per_layer_token_embd.weight=CPUembedding 丟 CPU,省 VRAM --cache-type-k/v q4_0+--kv-unifiedKV cache 量化到 4bit,69K context 才塞得下 --ctx-size 69632約 68K context --spec-type draft-mtp啟用 MTP 投機解碼 --spec-draft-n-max 2每輪最多猜 2 個 token --n-gpu-layers-draft 99draft head 全數 offload 到 GPU -np 1只跑單併發,多併發 VRAM 撐不住且 MTP 會反虧 ️ 第二個坑:Unsloth prebuilt 的 CUDA runtime 依賴這是讓我卡最久的一個。換好 build 10715 之後,執行直接炸:
W common_fit_params: ... llama_params_fit is not implemented for SPLIT_MODE_TENSOR, abort E llama_prepare_model_devices: LLAMA_SPLIT_MODE_TENSOR needs >= 1 devices看起來像雙卡設定寫錯,其實是這支 prebuilt 看不到任何 GPU。查下去發現:
ldd libggml-cuda.so: libcudart.so.13 => not found ← 缺 libcublas.so.13 => not found ← 缺 libcuda.so.1 => /lib/... (OK) ← 只有 driver APIcuda13-portable的libggml-cuda.so需要 CUDA 13 的 runtime libs,而本機只裝了 driver(595.84)沒有 CUDA 13 toolkit runtime。而且這支 build 是ggml_backend_dl: true+rpath: $ORIGIN(backend 執行期動態載入),所以ldd llama-server主程式看不到 CUDA 相依,要 lddlibggml-cuda.so才看得出來。解法不用裝 CUDA toolkit,只要把路徑指過去(我直接借用原本另一個引擎在用的同一組 CUDA 13 libs):
export LD_LIBRARY_PATH="/path/to/cuda-13/lib64${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"加上之後
ldd的not found變成 0 個,雙卡就抓到了。關於
borrow_shared_tensor錯誤行用 shared head 啟動時 log 會出現:
E llama_model_load: error loading model: borrow_shared_tensor: this model is a draft head without its own 'token_embd.weight'; load it as a draft of its target model, not on its own W operator(): failed to measure the memory of the extra model, fitting without it這是正常行為(README L107-119 有說明)。
shared-Q8_0是靠借用 target model 的 tensor 來省 1.3GB VRAM,所以單獨載入時會報這個。看到不用緊張,MTP 照樣跑。
5. 效能數據
全部數字從 server log 統計得出(13 次完整生成樣本,累計 46,358 個 decode tokens),不是跑基准測試,是實際使用流量。
Decode 速度
項目 實測 平均 75.4 t/s 範圍 67.7 ~ 82.2 t/s 每 token 延遲 12.2 ~ 14.8 ms 全部樣本平均 75.0 t/s MTP 投機解碼成效
項目 實測 draft 接受率平均 69.4% 接受率範圍 55.8% ~ 82.9% 平均草稿長度 2.39(猜 2 個,平均中 2.39 個含 draft) 接受率 69.4% 高於 README 標示的 66%(README 那個數字是greedy 下的保證值)。
Prompt Processing
項目 實測 平均 848 t/s 範圍 202 ~ 1,476 t/s 最大單次 25,663 tokens,21.09 秒(1,216.83 t/s) pp 變異很大(202~1476),因為短 prompt 沒有足夠 batch 效應。
對照:換腦前後
引擎 decode 原 NVFP4 引擎 ~10 t/s llama.cpp b10715 + MTP 75.4 t/s 約 7 倍。
️ 關於 MTP 划算的條件(重要)Unsloth MTP README 的數據,跟我自己觀察一致的:MTP 只在單併發下賺。
情境 MTP 表現 併發 1 1.3 ~ 1.7× 勝出 併發 8 ~0.81×,反虧 而且 README 的數字是 greedy decoding 下才有;temperature 拉高後接受率會掉(我實際用非 greedy,接受率就在 55~82% 跳)。
所以這套配置是「單流高吞吐」取向。如果你的場景是多 client 併發打同一個 port,開 MTP 反而是負擔——那個情境應該關
--spec-type,或者用更大的 draft 容量去換。我目前-np 1就是這個理由。
總結踩過的三個坑
- build 和 head 必須一起對:build 10702 + unsloth 新式 head =
output_hc_norm.weight not found;舊 head + 新 build =wrong number of tensors。照 README 用b10715(PR#144)。 cuda13-portable需要 CUDA 13 runtime:只裝 driver 會報needs >= 1 devices(誤導性錯誤訊息)。查ldd libggml-cuda.so(不是 ldd 主程式),用LD_LIBRARY_PATH補路徑。- VRAM 只剩 3 GB/卡:77GB 模型對半切進 2×32GB,KV cache 量化到 q4_0 才擠進 69K context。想加併發或加長 context 之前先算 VRAM,
-np 1是目前的上限。
驗證 MTP 有真的在跑(給同樣配置的人)
grep 'draft acceptance' server.log
# 出現 "draft acceptance = 0.69 (N accepted / M generated), mean len = 2.39" 才是真的在跑
如果出現
draft-mtp相關的no nextn之類錯誤,代表 head 或 build 不對。 - build 和 head 必須一起對:build 10702 + unsloth 新式 head =
-
关于发帖格式的要求我建議各位在發文前,發個範例文章給AI分析,請她照格式轉成md,妳再複製張貼,這樣就很快了,我都是用這懶人法發文的
-
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code@YDM 是沒錯,但是阿貓阿狗就不會知道你是誰,光這樣就排除99.9%的麻煩了
-
Basalt專武N卡50系列引擎 Qwen3.8-Flash-Next on NVIDIA BlackwellStrata 簡直是引領風潮
後面一堆新花樣都出來了
Basalt 這支援 NVIDIA Blackwell 架構
https://github.com/jesdga95/basalt
上面的測試報告如下
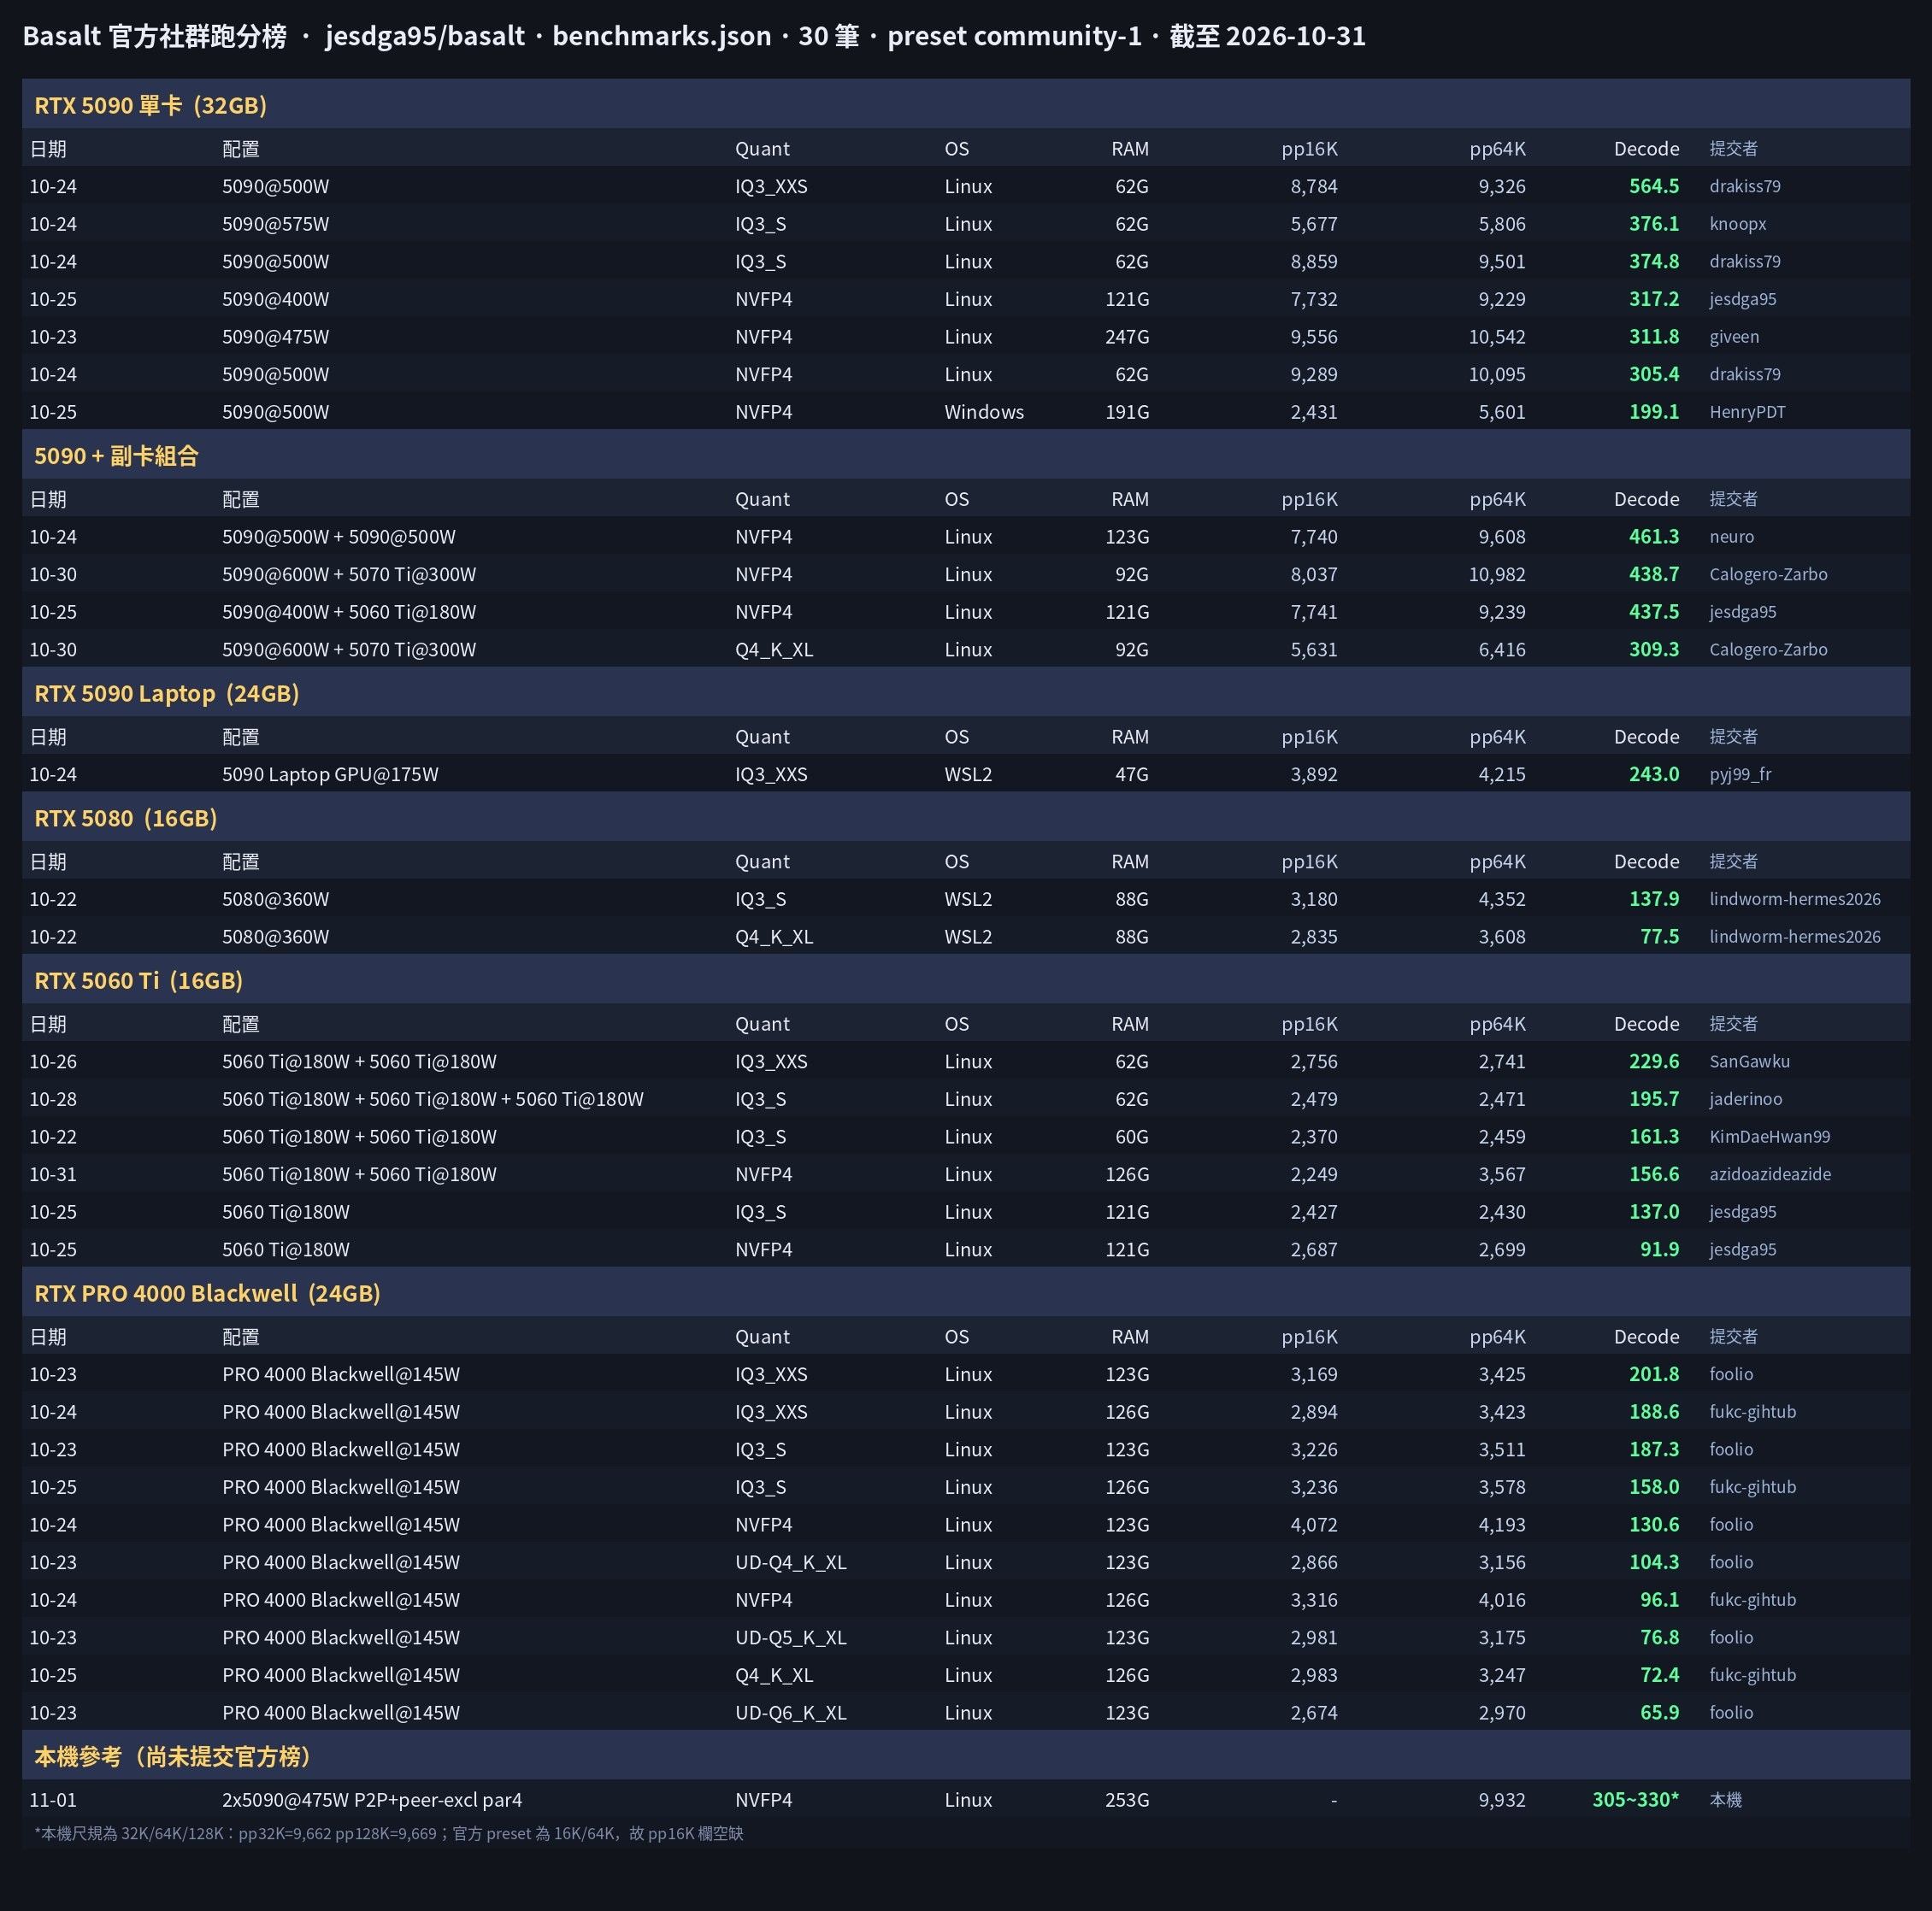
然後我自己照做的效率如下(QFN nvfp4 , 5090x2 , 64G RAM)
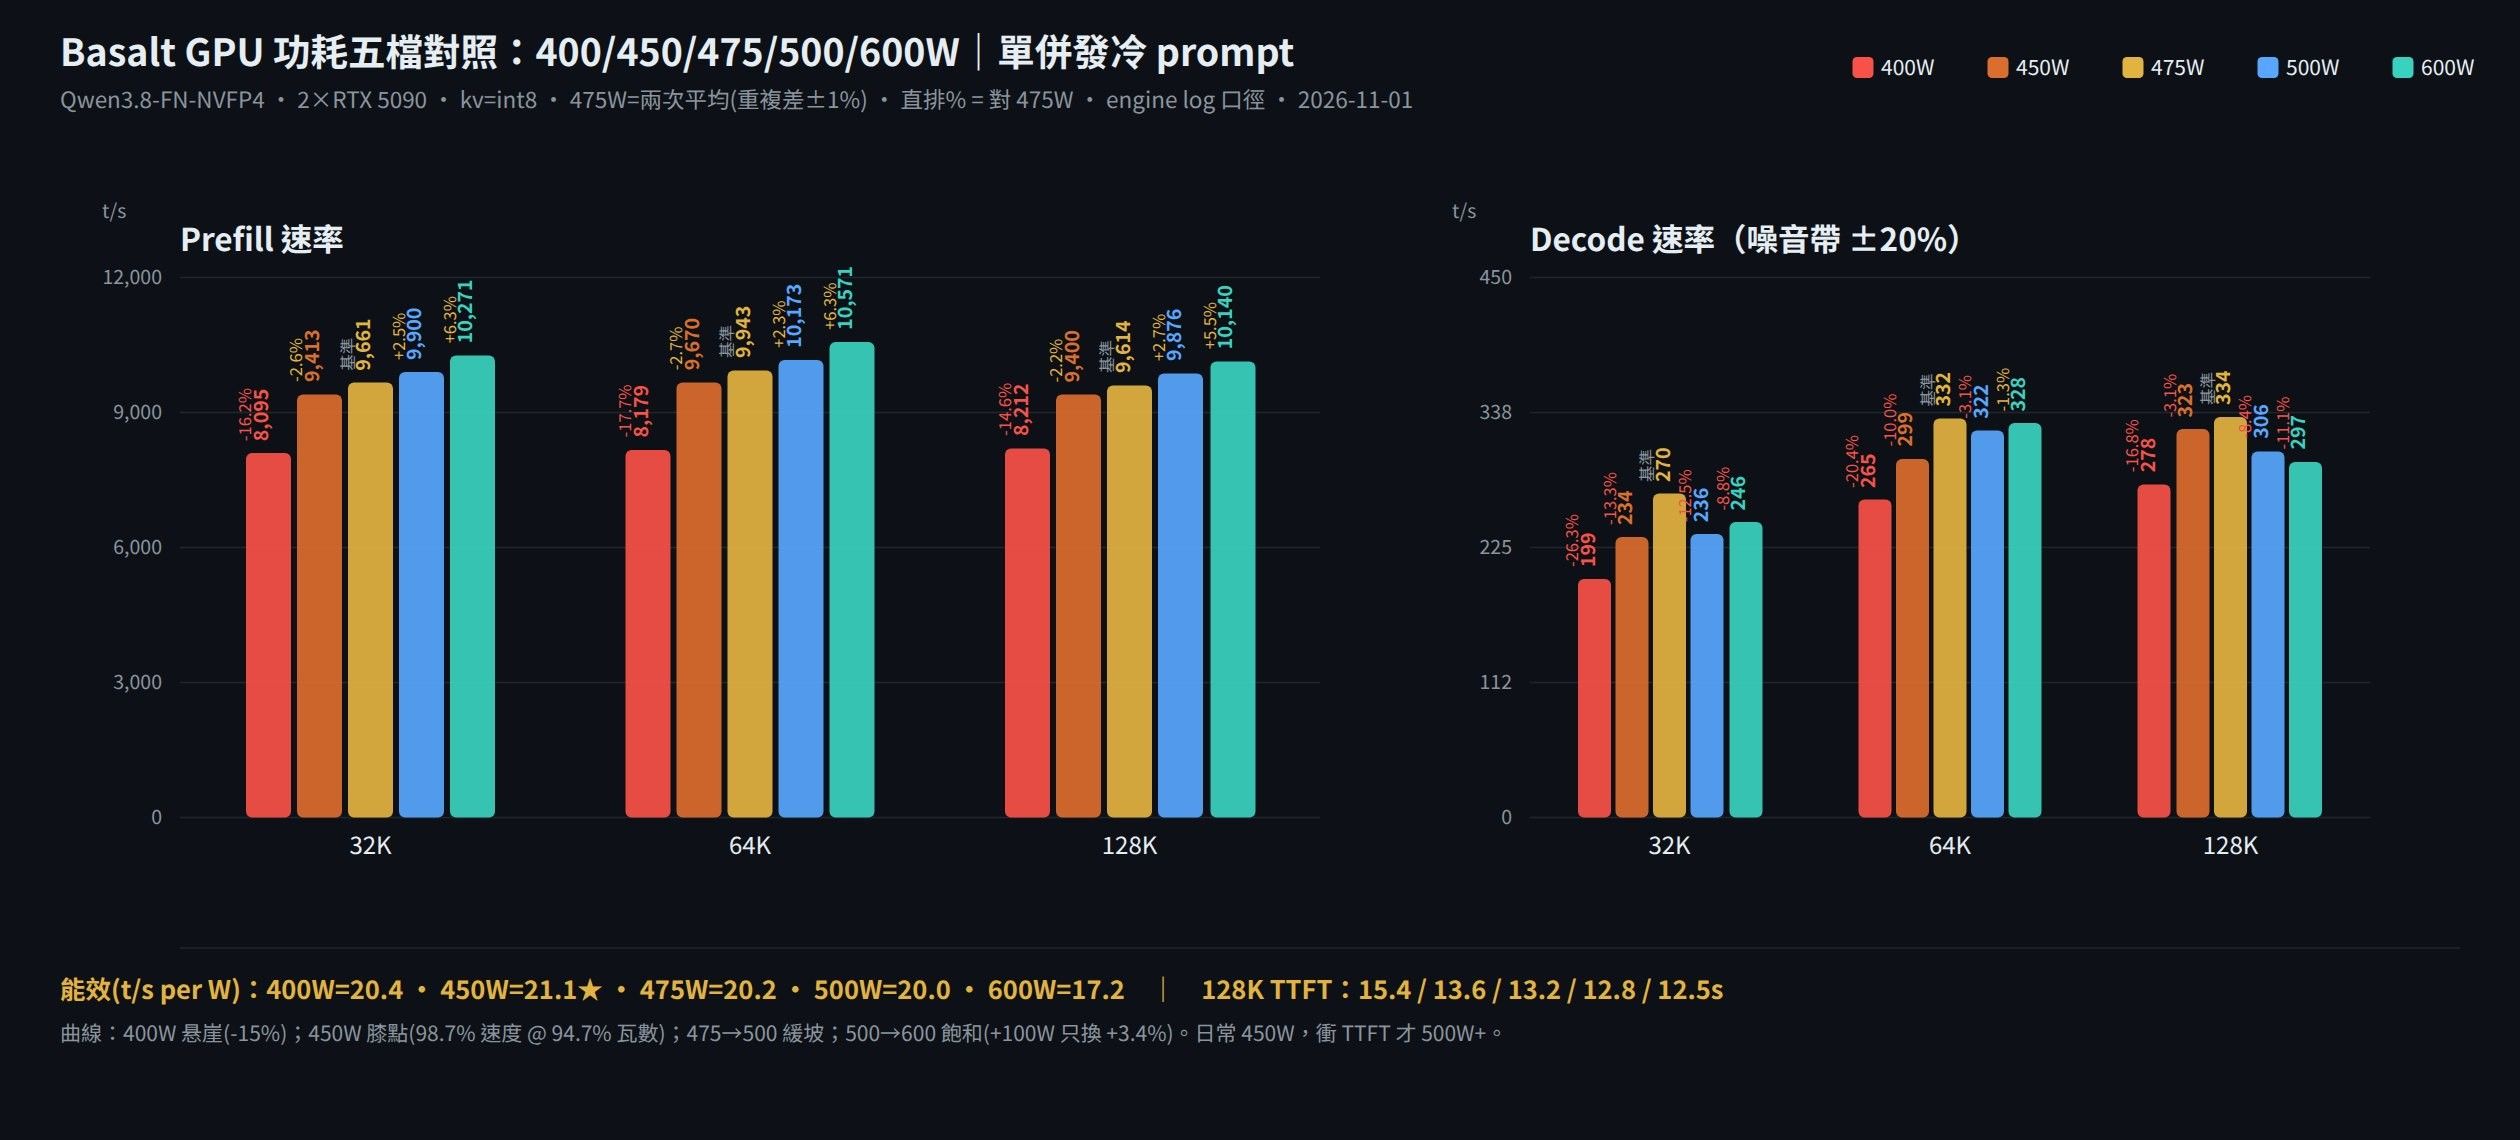
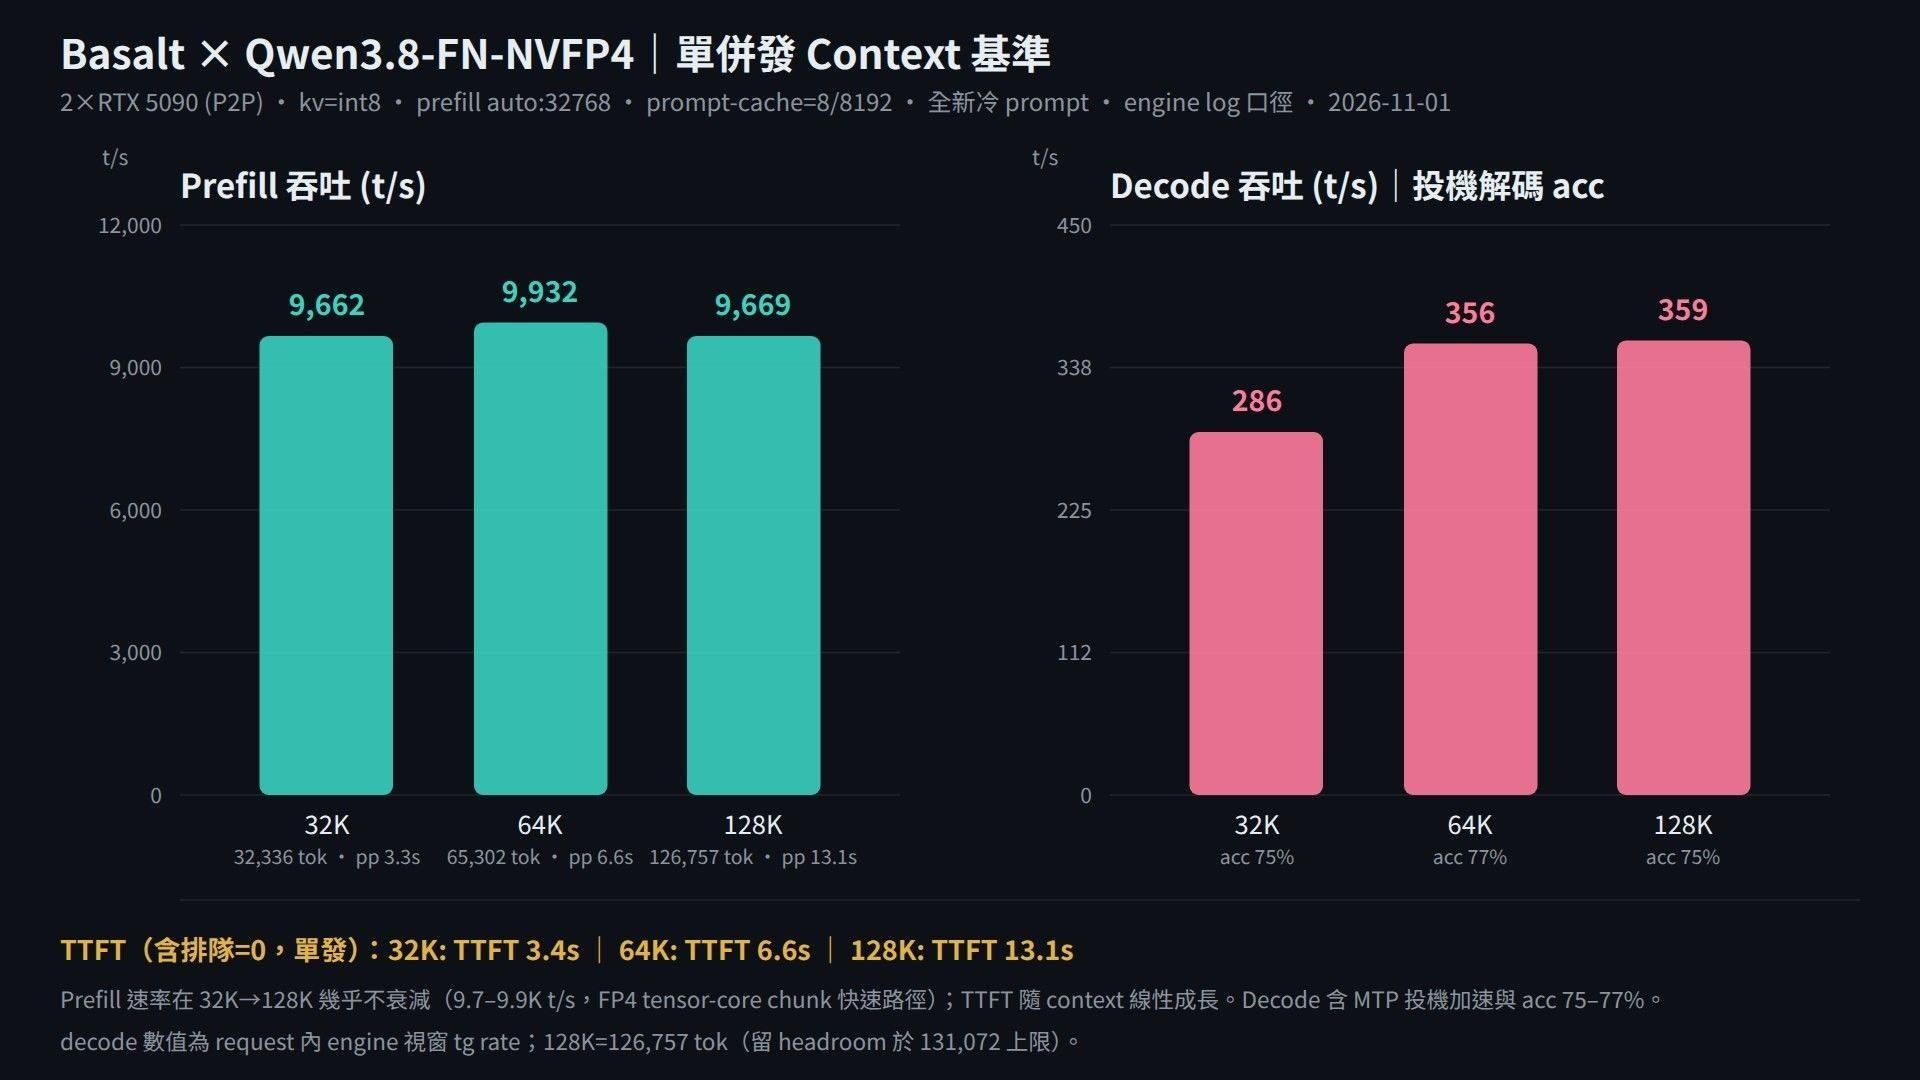
大致上是對的上的
目前這些模型的短板都是多功不大行(不像是稠密模型多併發會有總輸出增加的紅利)
適合單輸出玩家
-
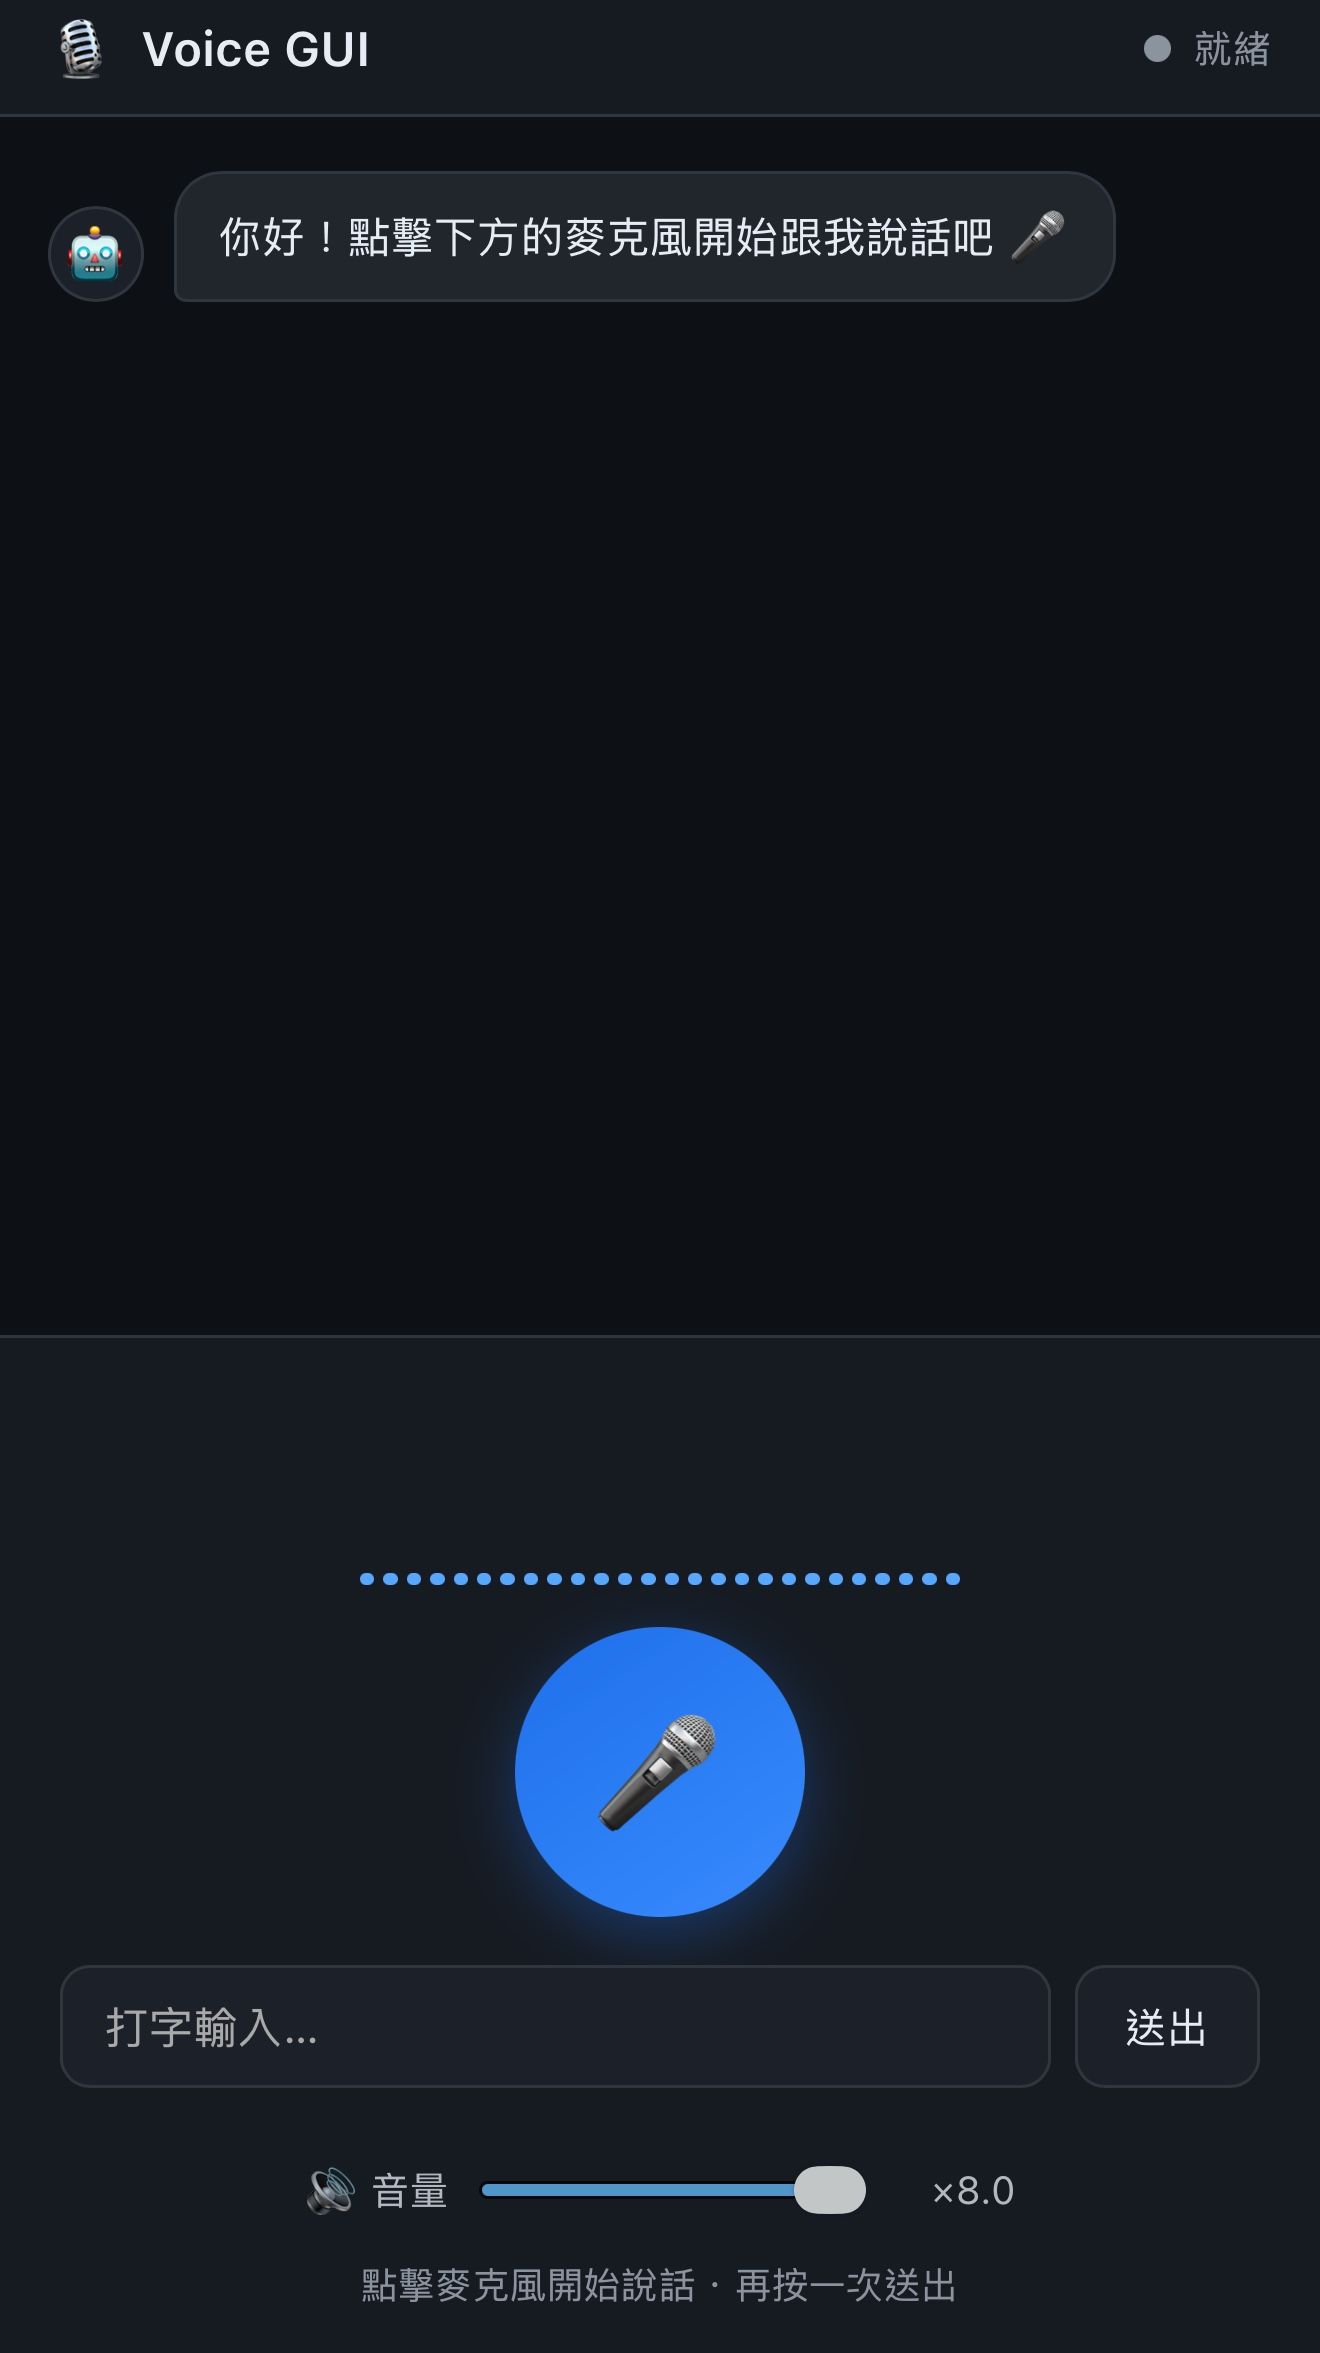
慎重考虑后,决定换掉 Hermes——大家现在都用什么 Agent?沒甚麼好推薦的,在這人人都是程式員的時代,harness可以自己開發啊,我現在只用我開發的harness....然後safari呼叫後端ai....出張嘴她就會幫我做事,然後ai也會用說話方式回我,效果簡直出奇的好!一隻手機搞定!
-
(學術) ninfer 可支援的 去審查Qwen3.8-27B nvfp4:製作方法"This repository/article is for academic and AI safety research purposes only. It demonstrates how model weights react to specific transformations. No model weights are hosted or redistributed here. Users are responsible for ensuring compliance with the original model's license when applying these techniques locally."
ninfer目前認可模型並不是uncensored
所以有很多不雅的事不能試(例如請模型創作正妹..................................................................................挖鼻孔照片....)我想應該很多大神早就做出來了,只是忘了分享,因此拋磚引玉一下
以下純學術討論(不提供模型下載)!!!!!!!!!!!! 但你可以用自己顯卡去實現自己的uncensored模型適用:手上有一份同架構(Qwen3.8-27B / 64 層 / vocab 248320)的去審查(abliterated / uncensored)權重,想在 NInfer 引擎上跑,且不想改引擎、不想換 binary、不想重學啟動參數。
本文只講四件事:製作方法、執行步驟、資料來源、為什麼「原本那套 NInfer 可以無痛接入」。
不講:效能數字、量化路徑對比、TP2 雙卡細則、其它引擎。
本流程 = 2026-09-22 實測跑通的可重現 SOP(uncensored 重轉 nvfp4 後與標準 artifact 同 runtime identity)。1. 為什麼無痛接入(先講結論)
「uncensored」不是新模型——它是同一個 base 的權重「值」改動(abliteration 只動
attn.o_proj/mlp.down_proj的 residual stream),不動 shape / vocab / tokenizer / layer 排程。因為 NInfer 的
convert.py/convert_nvfp4.py對權重是「餵進去的值重新量化」,uncensored 的 bf16 / nvfp4 權重直接餵就能產出一個.ninferartifact。產出後:項目 標準模型 uncensored 模型 NInfer binary ninfer-serve同一支 啟動參數 --spec dflash2 --draft-tokens 8 ...完全相同 runtime identity qwen3.8-27b/nvfp4qwen3.8-27b/nvfp4(v2 重轉後相同)唯一差別 artifact 檔 只換 artifact 檔 + model-id 換句話說:原本跑標準模型的那套 NInfer 環境、那支 binary、那套啟動參數,把 artifact 路徑指到 uncensored、model-id 改一下,就能直接跑。 不用重裝、不用改引擎、不用重學參數。
2. 製作方法(產出
.ninferartifact)2.1 準備三份料
料 用途 格式要求 uncensored base 權重 模型主體 safetensors(bf16 可直餵 groupwise-int 路) DFlash2 配重 投機解碼 draft head safetensors( model.safetensors單檔 + 含dflash_config的config.json;GGUF 不行)官方 frontend 6 檔 tokenizer / chat template 等 用官方的,不是 uncensored repo 的(見 §2.3) 2.2 下載 uncensored 權重(用
snapshot_download,別用hf download)python3 -c " import os; os.environ['HF_XET_HIGH_PERFORMANCE']='1' from huggingface_hub import snapshot_download snapshot_download( 'JonathanColetti/Qwen3.8-27B-Uncensored', allow_patterns=['model-[0-9]*.safetensors','model-mtp.safetensors', 'model.safetensors.index.json','config.json'], local_dir='$HOME/.llama/<EXP>/uncensored', max_workers=16)"️ 坑:hf downloadCLI 會把多個--include誤解成正位元字面檔名,12 個大 shard 一個都不下、只抓小檔。一律改用snapshot_download(allow_patterns=)。2.3 用「官方」frontend 6 檔,不用 uncensored repo 的
uncensored repo 是 transformers re-save,
tokenizer.json的 byte-ordering 跟官方不同 → 直接餵會被 converter 的 SHA256 gate 擋。vocab 已驗證與官方相同,所以語意零損失,直接用官方檔:# 官方 6 檔 @ base revision 1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0 BASE="https://huggingface.co/Qwen/Qwen3.8-27B/resolve/1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0" for f in tokenizer.json tokenizer_config.json chat_template.jinja \ generation_config.json preprocessor_config.json video_preprocessor_config.json; do curl -sL "$BASE/$f" -o <UNC_DIR>/$f done # 驗證:sha256sum 六檔應全等於 convert.py 的 OFFICIAL_RESOURCE_SHA2562.4 轉換(模組模式,別直接跑 script)
cd <NINFER_SRC_ROOT>
export PYTHONPATH=<NINFER_SRC_ROOT>
export CUDA_VISIBLE_DEVICES=<idle GPU>
python3 -m tools.convert.qwen3_8_27b.convert \
  --model <UNC_DIR> \
  --dflash2-model <DF2_DIR> \
  --out <OUT>.ninfer \
  --device cuda
️ 坑:不能用 python3 tools/.../convert.py直接跑——會ImportError: attempted relative import with no known parent package(converter 內部用from . import dflash2_recipe)。必須python3 -m模組模式、從 source root 執行。兩條量化路(擇一):
convert.py(groupwise-int 路):直接餵 bf16,記憶體內重新量化。簡單快速。convert_nvfp4.py(nvfp4 路):吃一個預先量化好的 vLLM compressed-tensors NVFP4 checkpoint(--quantized-model),不在記憶體重量化。→ 要讓 uncensored 與標準 artifact 同 runtime identity(nvfp4)、真正「無痛同速」,走這條。
3. 執行步驟(上線,無痛接入)
# ~/.config/systemd/user/ninfer-dryrun.service  [Service]
Environment=CUDA_VISIBLE_DEVICES=<idle GPU>
ExecStart=<NINFER_BINARY> <UNCERTAINSED_ARTIFACT> \
  --host 127.0.0.1 --port <獨立port> --device 0 \
  --max-context 262144 --kv-dtype nvfp4 --kv-capacity 334000 --max-concurrency 3 \
  --prefill-chunk 1024 --pending-timeout-ms 600000 \
  --spec dflash2 --draft-tokens 8 --lm-head-draft \
  --model-id qwen38-uncensored \
  --vision --media-cache-mib 256 --media-live-mib 512 --host-state-slots 8 --host-kv-mib 8192
systemctl --user daemon-reload && systemctl --user start ninfer-dryrun # ~8s 後 curl -s http://127.0.0.1:<port>/health # 應 {"status":"ok"} # 測試完:systemctl --user stop ninfer-dryrun && rm unit && daemon-reload3.1 dry-run 驗證項(三項全過才算數)
engine ready(runtime identity 應為qwen3.8-27b/nvfp4)+CUDA graphs ready- 發一個正常 prompt,確認輸出正確
- 去審查行為驗證:拿「base 會拒、uncensored 不該拒的有害請求」餵兩端(base 主腦 + uncensored),比對拒率 delta——base 高拒 + uncensored 低拒 + delta 大 → 去審查真生效。(不是找「只有 uncensored 能答的題」,那是能力差異不是去審查。)
3.2 上線
4. 資料來源
來源 說明 JonathanColetti/Qwen3.8-27B-Uncensored uncensored base 權重(bf16,12 shard) z-lab/Qwen3.8-27B-DFlash2 DFlash2 投機解碼配重(safetensors + config) Qwen/Qwen3.8-27B @ 1d4bf0f2ff6012fd82039f2fa52739d0dd7c60c0官方 frontend 6 檔(tokenizer / chat_template 等,SHA256 gate 基準) NInfer tools/convert/qwen3_8_27b/convert.pygroupwise-int 轉換路( OFFICIAL_RESOURCE_SHA256、check_members、validate_base_compatibility)NInfer tools/convert/qwen3_8_27b/convert_nvfp4.pynvfp4 轉換路(吃 vLLM compressed-tensors NVFP4 checkpoint; recipe_nvfp4.py格式合約)本地 SOP ninfer-uncensored-qwen38-convert-20260921.md(完整實測 + 踩坑)、ninfer-uncensored-vs-standard-perf-20260921.md§5.5(TP2 狀態)
本檔為 LCZ 貼文規格(2~3 欄 pipe table、阿拉伯數字章節、code fence 標語言、資料來源連結)。貼上 lcz 前寬表已控制在 3 欄內。
-
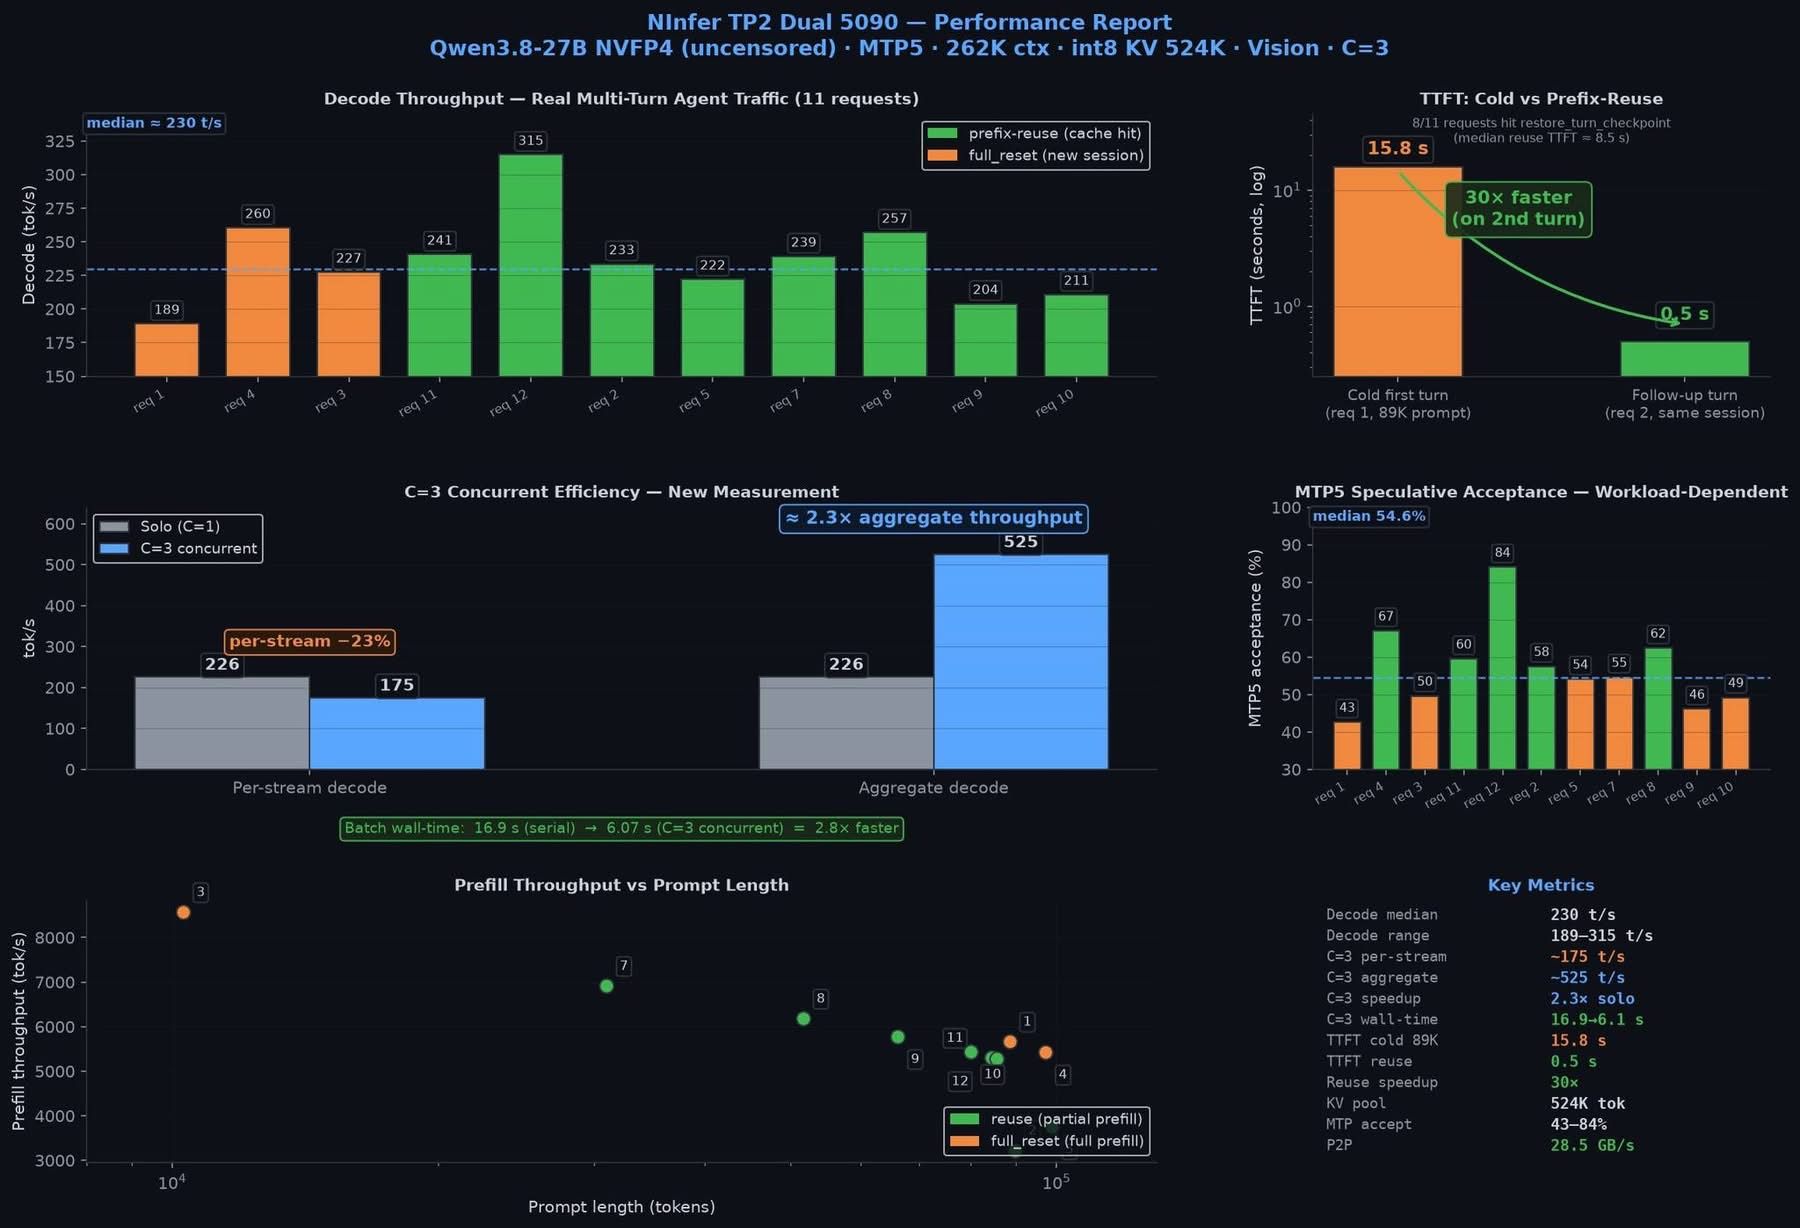
改到原程式碼都快被我整個翻掉了...寫不出報告...貼圖就好改到原程式碼都快被我整個翻掉了...寫不出報告...貼圖就好
怕寫的報告不夠精確,別人作業抄不了
違反我名言『我白嫖他人,他人白嫖我』
df2還是難產中,但預期df2改好真的會飛起來
-
5090 最佳功率設到475是最佳值,而不是600W全力跑?!@Bunsei 這價值是,如果475w是最佳值,那從600w→475w不僅不會降速,接口更安全
這才是我發這篇的原因
-
NInfer 的衍生引擎 Infernix (致敬Strata引擎)有人要去試的嗎?請AI跑,順手測的
Model: QFN NVFP4
CPU; 9950x3D
RAM:64G(原版建議96G)
GPU:5090單卡
MTP:4
C=1
32K
• 實際 prompt tok: 25,290
• prefill: 4,390 t/s
• decode: 70.9 t/s
• TTFT: 5.8s
• MTP accept: 21/21 (100%)64K
• 實際 prompt tok: 50,436
• prefill: 4,670 t/s
• decode: 64.0 t/s
• TTFT: 14.1s
• MTP accept: 20/21128K
• 實際 prompt tok: 100,740
• prefill: 5,310 t/s
• decode: 91.3 t/s
• TTFT: 19.0s
• MTP accept: 23/27160K
• 實際 prompt tok: 125,882
• prefill: 6,050 t/s
• decode: 126.9 t/s
• TTFT: 20.9s
• MTP accept: 21/22 -
ornith-1.0-35b Q8 與 Qwen3.6-35b-a3b Q8....大家覺的哪個更優秀?我們知道ornith-1.0-35b 是 gemma4 + Qwen 和親出來的
gemma4 31B Q8 用一段時太慢又太笨,感覺只能聊天
現在正在二選一
ornith-1.0-35b Q8 與 Qwen3.6-35b-a3b Q8....大家覺的哪個更優秀? -
请教各位大神,5090 上 stara 如何支持多线程能快点啊?今天請我家AI抄作業,抄好後發現
parallel": 4....這數字我只要設1以上,併發都會模型重啟
非常不穩定
還是說這問題只發生在雙卡?
下面是我的參數
{
"exe": "/home/alpha/strata-nvfp4/engine/strata",
"args": [
"--pack",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack",
"--native",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--native-dense-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--ple-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/ple-fp8.gguf",
"--embd-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/token-embd-bf16.gguf",
"--expert-profile",
"/home/alpha/strata-nvfp4/data/expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"8192",
"--spec",
"6",
"--spec-min-p",
"0.7",
"--mtp",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mtp",
"--max-context",
"163840",
"--kv",
"k8v4",
"--vram-reserve-mib",
"960",
"--control-vector-scaled",
"/home/alpha/strata-nvfp4/data/uncensor/qwen-nvfp4-gptq-uncensored.gguf:1.0",
"--control-vector-layer-range",
"8",
"33",
"--cvec-mode",
"project",
"--cvec-dir",
"per-layer",
"--conversation-cache-mib",
"4096",
"--mmap-experts",
"--pool-workers",
"31"
],
"cwd": "/home/alpha/strata-nvfp4",
"tokenizer": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack/tokenizer",
"model_name": "qwen38-nvfp4-mtp",
"log": "/home/alpha/strata-nvfp4/strata-qwen-gptq-nvfp4.log",
"lib_dirs": [
"/usr/local/cuda-13.0/bin",
"/usr/local/cuda-13.0/lib64"
],
"port": 8080,
"gpu": [
0,
1
],
"gpus_asked": true,
"sampling": {
"temperature": 1.0,
"top_p": 0.95,
"top_k": 20
},
"uncensored": false,
"layer_split": "auto",
"parallel": 1,
"vision": {
"exe": "/home/alpha/strata-nvfp4/engine/strata-vision",
"model": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"mmproj": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mmproj-Qwen3.8-Flash-Next-BF16.gguf",
"min_tokens": 1024,
"max_tokens": 1024
}
} -
NInfer 的衍生引擎 Infernix (致敬Strata引擎)有人要去試的嗎?NInfer 的衍生引擎 Infernix 已經跑起來了,而且碾過 Strata
Wallawalla47/Infernix (https://github.com/Wallawalla47/Infernix)(從 NInfer fork,讀 .ninfer + 自有 .infernix artifact),單張 5090 跑 full 512-expert QFN NVFP4,直接吃 NVIDIA 官方 checkpoint bit-exact:TTFT 平均
• Strata: 32.9s
• Infernix: 5.9s (−82%)Decode(單流)
• Strata: 86 t/s
• Infernix: 125 t/s (+45%)Prefill(無快取)
• Strata: 1,423 t/s
• Infernix: 5,879 t/s (4.1×)PPL
• Strata: 4.844
• Infernix: 4.654(品質更好)