跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
fanweng-codeF

fanweng-code

@fanweng-code
体面乡绅
取消关注 关注
关于
帖子
34
主题
4
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 本地模型已經能取代雲端?我讓 Qwen3.8 flash next 和 GPT 玩同一款遊戲,終於知道 Benchmark 為什麼不能全信了
    fanweng-codeF fanweng-code
    LLM讨论区 qwen-flash 本地模型 mac

    在筆者的Mac Studio 把本地模型架設好跑過各種測試後已經快樂的做起正事了,但除了工作以外還是想找點有趣的事情讓它做。

    社群有很多測試模型能力的題目,例如版主常用的畫八卦或是通用的「鵜鶘騎腳踏車」、生成 SVG、做一些推理題或程式題。雖然作品確實能看出差別但沒有綜合能力複雜或是真實工作的差距可以比較。

    在瀏覽了許多youtuber的影片後決定讓Agent來玩看看《Inscryption》,這款遊戲目前沒看到有人拿來執行過,也不是個需要即時快速反應的遊戲(卡牌遊戲)。

    隨著觀察不同模型來玩遊戲的過程就會發現:為什麼這些模型的 Benchmark 看起來沒有差到非常誇張,實際讓它們自己做事情,體感卻差這麼多?

    先放圖
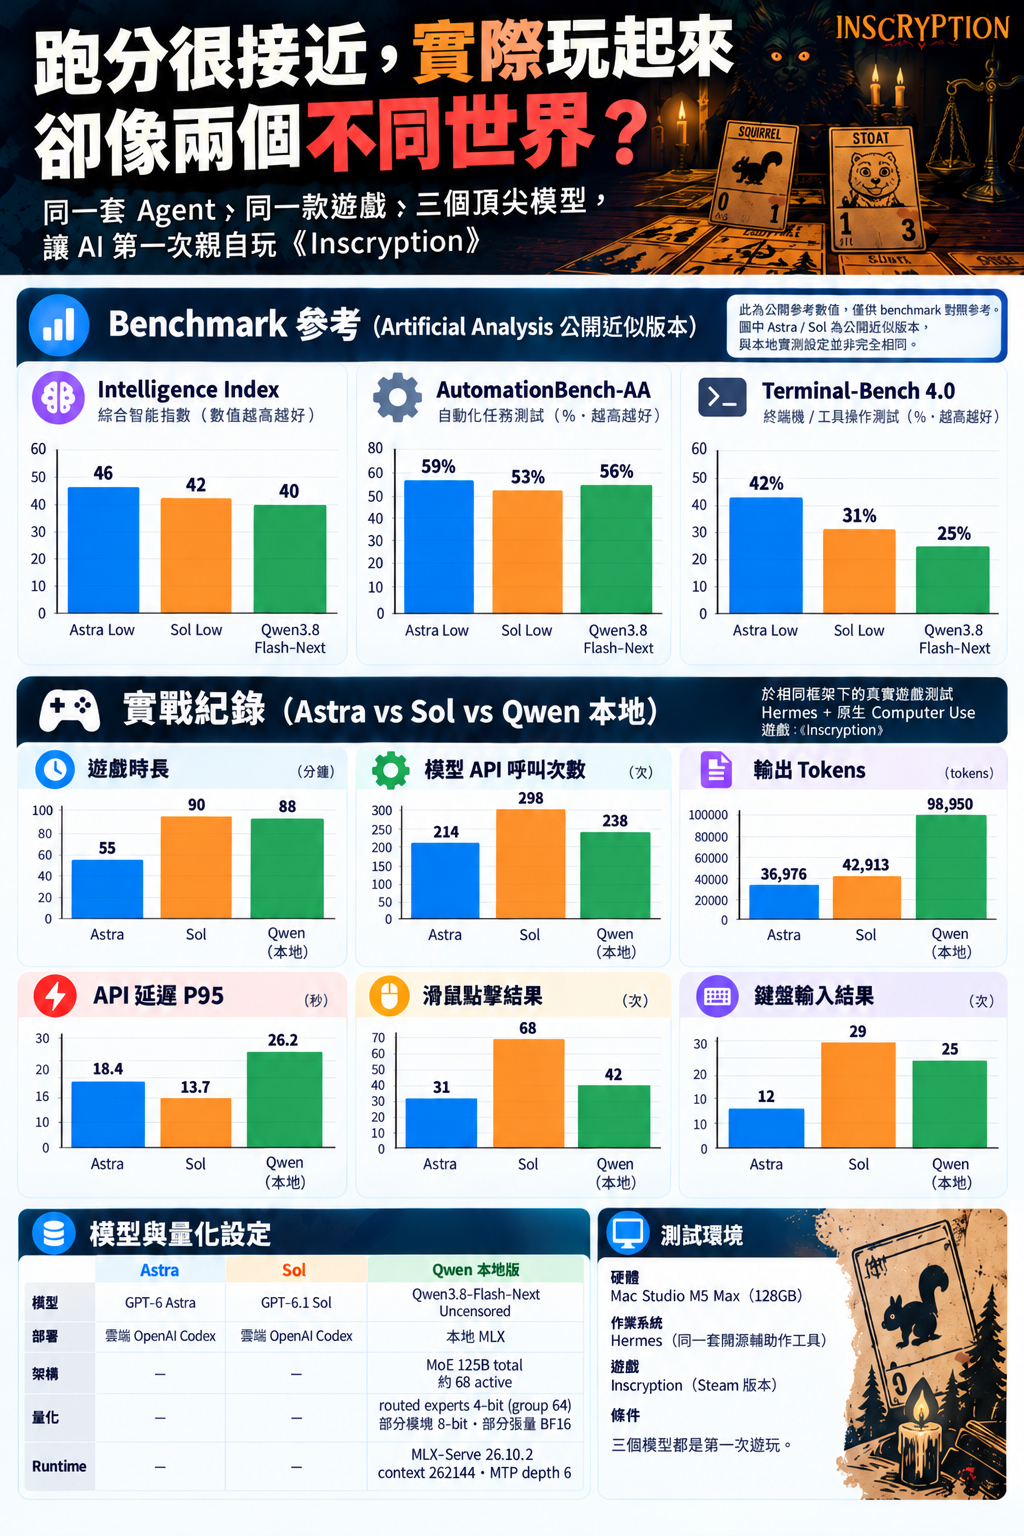
    《Inscryption》三模型實戰跑分比較.png

    實驗怎麼進行

    使用 Hermes Agent,透過原生 Computer Use 操作遊戲,讓模型自己看畫面、移動滑鼠、按鍵盤、探索規則。

    使用 Astra、Qwen 3.8 flash next、Sol 6.1 三個模型接手游戲,每個模型都是第一次親自玩《Inscryption》。

    玩起來到底差在哪?

    最難以理解的,是 Qwen 在遊戲裡的表現。

    它能看懂遊戲內機制、能完成實際操作,打贏過戰鬥。

    但他會無視畫面的提醒,例如遊戲內出現一直閃爍的W鍵,就是希望玩家按 W 進行下一步。

    人類看到這種提示就會去按W鍵,但 Qwen 卻可能在畫面裡反覆分析其他東西,就是不去按W,必須要筆者送出prompt要求他,他才願意做。

    另一個問題是出牌。

    《Inscryption》有獻祭機制,某些卡牌需要犧牲其他生物才能上場。Qwen 已經學過,也實際操作過,但後來又忘記了。

    最慘的一次是它選了卡、嘗試獻祭、準備出牌,最後直接結束回合(WTF??)
    結果當然是被電腦爆打一頓...我觀察了整個過程包含他鬼打牆似的內心戲,結果就這樣?

    再來是關卡可以選牌帶走,三張覆蓋的牌可以選一張拿走,正常來說我們會三張都看完後選擇,但他它只看了其中一張,就直接做出決定。我忍不住下prompt提醒,Qwen才意識到自己漏掉了重要資訊。

    類似的狀況還有很多,滑鼠點偏了卻一直分析為什麼遊戲沒反應、忽略敵方的特殊能力、沒有查看完整盤面、已經學會的操作換個場景又得重新摸索。

    它明明能做很複雜的推理跑分也很好看,卻常常漏掉遊戲裡很基本的事情。

    換成雲端模型繼續測試

    遊戲本身有不少需要探索的地方,還有視角切換、動畫、特殊事件等問題。Sol 甚至也花了不少時間研究怎麼查看遊戲資訊,我需要介入提醒但次數不多。不過Astra就蠻神奇的,過程中我完全沒有介入,他就能自己完成其他模型需要反覆試錯的項目,貴有貴的道理?

    換模型確實能感受到不同模型的差異。Sol遇到陌生東西,會比較積極地尋找線索;Qwen會在同一個問題上反覆來回折磨自己(不能關掉思考,關掉之後無法完成任何一個關卡)。這些很難在Benchmark上看出差異。

    目前只能確認本地 Qwen 需要生成大量內容,才能逐步推進任務。但多花時間思考,並不保證下一步就比較正確。

    上面的實戰紀錄就是從 Hermes 的 Session 與 API Log 提取的。

    當然,模型輸出的 Token 數量與思考品質沒有直接對應關係,不同模型的 Token 計量也可能有差異。這次的紀錄還不足以計算公平的模型勝率,只能先分享我實際觀察到的情況。

    Benchmark 能代表模型能力嗎?

    Artificial Analysis 上有 Intelligence Index、AutomationBench-AA、Terminal-Bench 等測試,有參考價值。

    但真正讓 AI 長時間操作遊戲後,筆者覺得目前還有一些很重要的能力,不容易從常見跑分裡看出來。

    例如:

    • 進入陌生環境後,能多快搞懂基本操作?
    • 遇到不認識的東西,會不會主動找線索?
    • 明明已經有經驗了,能不能在下一個場景正確使用?
    • 操作失敗後,多久能發現問題並修正?
    • 沒有人告訴它下一步要做什麼時,能不能持續推進?

    目前也還沒有一個很綜合的評分可以把一串不同類型的任務放在一起同時比較

    當然,玩得好不代表寫程式、做研究或處理工程問題就一定強。只是對於「自主探索」這件事,遊戲似乎很適合拿來觀察。

    想聽聽大家的看法

    目前我最想知道的是,有沒有人遇過類似情況?

    筆者使用本地模型來coding目前在短任務上沒有明顯差異,但未來真的讓它連續操作電腦,可能就像玩遊戲一樣出現大量重複思考、忘記操作方式、判斷失誤等問題。

    這究竟是模型本身能力還不夠,還是 Harness架構沒有把模型的能力發揮出來?
    這次玩遊戲的測試都是用同一個Harness環境,應該還算有可比性。

    如果有人測過本地 Qwen、DeepSeek、GLM 或其他模型長時間自主操作的表現,歡迎分享。

    尤其想知道,有沒有人成功讓本地模型在沒有人工一直提醒的情況下,自己探索陌生環境,而且能越做越熟練?

    喔,其實我有測試Gemini 4 Argon,我只能說他真的是跑分滿分實作零分,他連遊戲怎麼開始就花了一小時還沒進入遊戲,因此就不放上來了...

  • Mac Studio M5 Max 128GB 和 Qwen3.8 Flash-Next的一些測試
    fanweng-codeF fanweng-code
    AI硬件 apple-m5 mtp qwen-flash

    最近在剛到手的Mac Studio M5 Max 128GB 上測 Qwen3.8 Flash-Next,主要用途是 Hermes / coding agent,所以我比較在意的不是單純短 prompt 的最高 tok/s,而是長 context、prefill、decode、tool calling,以及實際 agent workload 下的穩定性。

    這幾天剛好完成一輪 MTPLX Optimized-Speed 和 uncensored oQ5e 的測試,整理一些數據供參考。

    這不是嚴格的模型能力 benchmark,主要是記錄同一台機器上不同 runtime / quant 的實際表現。


    測試環境

    硬體:

    • Mac Studio M5 Max
    • 128GB unified memory

    目前比較的兩套配置:

    MTPLX Optimized-Speed

    Qwen3.8-Flash-Next

    • context:131072
    • MTP depth:3
    • 目前日用 baseline

    Uncensored oQ5e

    mlx-community/Qwen3.8-Flash-Next-Uncensored-oQ5e-mtp

    runtime:

    oMLX 0.7.0.dev2

    • context:131072
    • concurrency:1
    • MTP OFF / ON 都有測試
    • native model memory 約 94.65GB

    所有長 context 測試都有實際檢查答案或 tool arguments,不是只確認 HTTP 200。


    oQ5e MTP OFF 長 context

    Case Prompt / completion Wall time Result
    32K retrieval 32704 / 18 26.90s PASS
    64K retrieval 65472 / 18 43.75s PASS
    128K retrieval 131007 / 18 102.69s PASS
    Near-128K tool 130862 / 44 103.41s PASS
    15K assistant-less tool history 15131 / 57 14.07s PASS

    第二次 128K retrieval 與 near-128K tool case 都是 0 cached prompt tokens。

    Near-128K tool call 最後正確回傳:

    report_probe(value=7)

    所以至少在這台機器與這個 runtime 上,oQ5e 的 128K retrieval / tool calling 本身沒有出現明顯 correctness 問題。


    MTPLX Optimized-Speed 128K

    這次也順便補了之前沒有正式測過的 MTPLX 128K。

    128K retrieval

    • prompt:131007 tokens
    • completion:19
    • wall time:70.80s
    • TTFT:69.30s
    • prefill:1900.4 tok/s
    • decode:49.36 tok/s
    • correctness:PASS

    Near-128K structured tool call

    • prompt:約 130.9K
    • completion:26
    • wall time:74.51s
    • prefill:1816.4 tok/s
    • decode:54.81 tok/s
    • tool call:PASS

    相同級別的 near-128K tool workload,oQ5e MTP OFF 是 103.41s。

    Optimized-Speed 的長 context 表現蠻讓人驚訝的,至少 128K 下的 prefill 仍維持約 1.8K~1.9K tok/s。


    oQ5e + Lightning MTP

    其中 near-128K tool case 的 native log:

    • accepted drafts:29 / 29
    • acceptance:100%
    • tokens / cycle:2.81
    • depth 1:13 / 13
    • depth 2:12 / 12
    • depth 3:4 / 4

    但實際 matched wall time:

    MTP OFF MTP ON
    Near-128K tool 103.41s 104.39s
    Result PASS PASS

    MTP ON 反而慢約 0.9%。

    另外 32K / 128K retrieval 的 MTP ON 測試有大量 prompt cache,因此沒有拿那些數字當成有效的 MTP speedup 證據。

    檢查 oMLX native log 後,找到:

    Qwen4-Exp PLE forced to SSD

    runtime 顯示:

    • estimated resident requirement:135.0GB
    • memory ceiling:115.4GB
    • mmap model:約 94.7GB

    所以 PLE 沒辦法完整 resident。

    oMLX 同時警告:

    Decode will be roughly 2.5x slower than a resident load.

    應該就是 MTP 的 draft acceptance 還滿好的,但實際 wall-time 沒什麼變化


    目前的使用定位

    MTPLX Optimized-Speed

    目前繼續當 daily baseline。

    128K 實測大約:

    • prefill:1800~1900 tok/s
    • decode:50~55 tok/s
    • retrieval:PASS
    • structured tool calling:PASS

    Uncensored oQ5e

    uncensored 內容專屬

    目前已確認:

    • 32K PASS
    • 64K PASS
    • 128K PASS
    • near-128K tool PASS
    • assistant-less tool history PASS

    但在 128GB unified memory 上,約 95GB model memory 加上 PLE SSD offload,整體資源壓力與長 context latency 都比較高。

    oQ5e + Lightning MTP

    不打算作為 daily 配置。開MTP也沒有明顯好處


    正在測的版本:mixed 4/8 + mlx-serve

    去審查當然要又準又快啊

    ARC4NUM/Qwen3.8-Flash-Next-Uncensored-MLX-Serve-4bit

    這個版本我對比了一陣子,4bit本身會快一點 ,另外 precision allocation:

    • routed experts:4-bit
    • attention / shared expert / GDN 等:8-bit
    • router / gate / 1D tensors:BF16
    • MTP 保留
    • n-gram / PLE:4-bit mmap
    • runtime:mlx-serve

    作者在 M5 Max 128GB 上公布的數據約:

    • serial:55.7 tok/s
    • MTP:60.3 tok/s
    • resident memory:約 68GB

    如果實際 RAM占用真的落在 68~70GB 左右,我認為這對 128GB Mac 的意義比單純多幾個 tok/s 還大。

    因為這代表除了模型本身之外,還能留更多 unified memory 給:

    • KV cache
    • Hermes
    • ASR
    • JEV(每天都有新的超熱鬧...)
    • 其他 agent / local services

    262K context 也可能因此比目前的 Q5 更實際。

    下一輪預計測:

    • raw decode
    • MTP OFF / ON
    • 128K retrieval
    • near-128K structured tool calling
    • 約 256K retrieval
    • resident memory / swap
    • 實際 coding / agent task

    如果有人也在 M5 Max 128GB 上跑過這個 ARC4NUM mixed 4/8 + mlx-serve 版本,也很歡迎分享 prefill、decode、RAM 使用量,以及長 context / tool calling 的實際表現。


  • 五马分工-hermes多profile协作经验分享
    fanweng-codeF fanweng-code
    AI Agent hermes 编程

    @Tony-Wang

    我一開始也是用hermes管理所有的agent
    要手動分配,定時記憶整理也很麻煩,obsidian或是supermemory都用過
    尤其讓他管理claude code+codex+DSH之後,協調跟記憶就更複雜更難維護了

    我嘗試改成總入口換成dots後那些記憶跟協調都不需要了
    一樣跟hermes只對一個agent一樣,但省心很多,後續維護都不需要

    Dots本身的模型夠聰明,很多事情不用講太多
    唯一缺點就是他不是免費使用,還是這類型最貴的(dots 100$, grok bots 30$, muse免費)


  • 【讨论】 Minimax M3.1 Flash开源了 (26-10-23)
    fanweng-codeF fanweng-code
    随便聊聊 minimax strata 本地模型

    @kop-wang

    image.jpeg

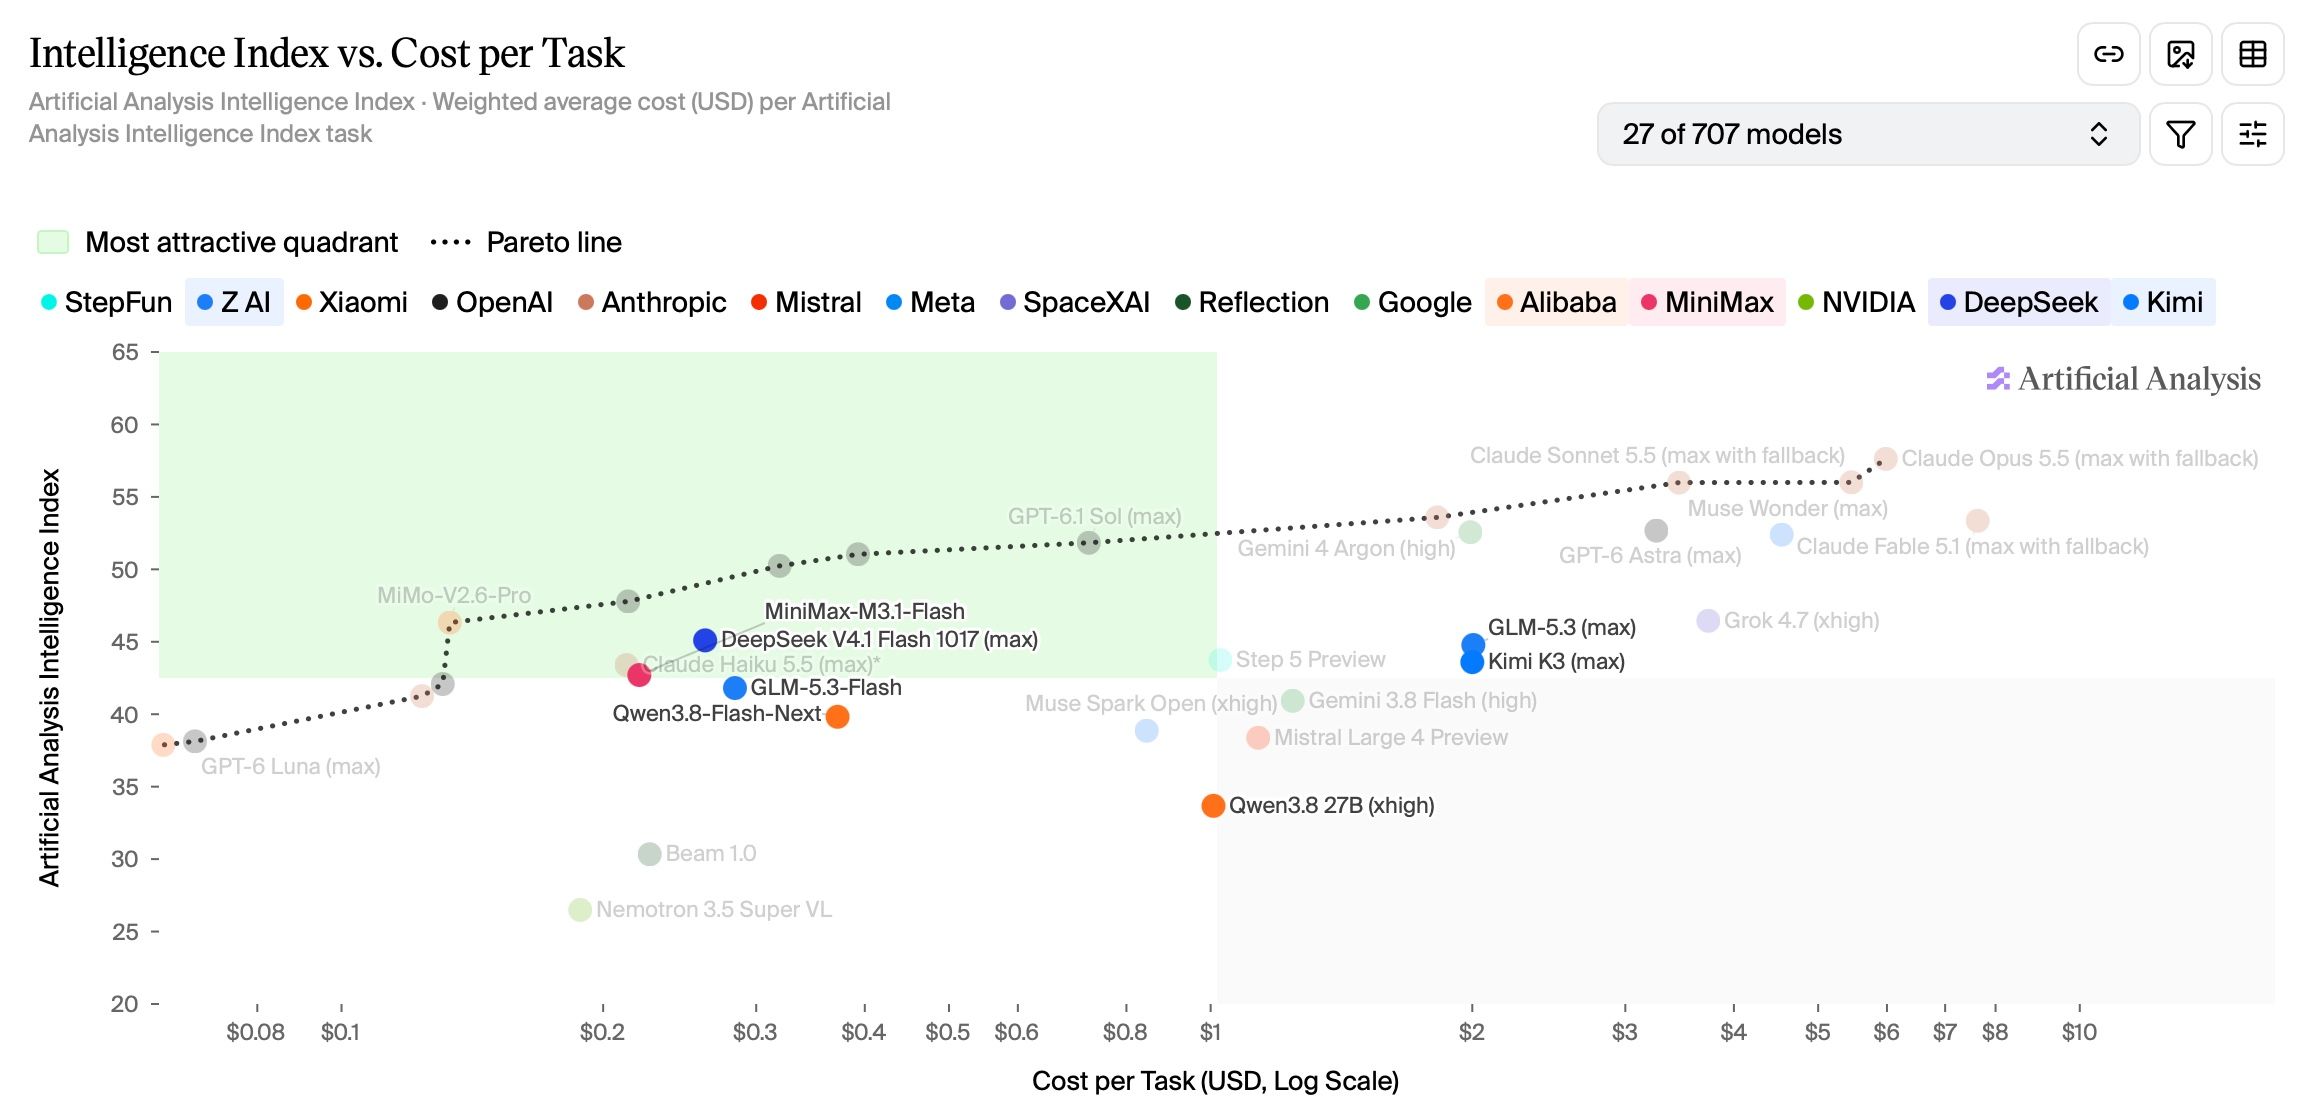
    看圖左邊綠框附近這幾個模型(DS V4.1 flash 1017, MiniMax M3.1 flash, GLM 5.3 flash, Qwen3.8 ) 的能力都在伯仲之間,大約40分到45分區間,能力上沒有多少差距,個人測試困難問題的實戰無論是Deepseek或是qwen都是不行的😖

    但部署的難度大有不同

    比較項目 Qwen3.8 Flash-Next MiniMax M3.1 Flash DeepSeek V4.1 Flash GLM-5.3 Flash
    總參數 125B 主幹 + 51B N-gram;另有可選 MTP 428B 552B 主幹 + 196B Engram 320B
    活躍參數 6B 23B Prefill 8B/Decode 16B 18B
    基本架構 MoE + GDN + QSA MoE + MSA MoE + CED + CSA2 MoE + KDA + Sparse Attention
    注意力設計 以 Gated DeltaNet 為主,搭配稀疏注意力 多層 MSA 稀疏注意力 Encoder/Decoder 與跨層 KV 共用 線性注意力搭配稀疏注意力
    特殊機制 N-gram、Gated Residual、MTP NVFP4 QAT、DSpark Engram、FP4 KV、DSpark mHC、MTP
    Context 規格上限 262K 1M 1M 1M
    本人Decode 實測 約 86 tok/s 未測 約 17.07 tok/s 未測

  • 本地模型到底行不行?! DSH會是提升模型能力的解藥嗎? 讓AI玩新遊戲第二篇!
    fanweng-codeF fanweng-code
    LLM讨论区 dsharness hermes codex

    https://lcz.me/post/25783
    接續前一篇的突發奇想,筆者花了點時間測了模型在不同Harness架構下表現如何?

    這次多準備了兩個Harness架構 Codex、DeepSeek Harness(DSH)與 前一次的Hermes,搭配 Astra (low)、GPT‑6.1 Sol (low)、Qwen3.8 Flash Next。一樣是無記憶重新開始玩Inscryption,除了看最後走到哪裡,也記錄模型遇到阻礙後,如何操作、校正與恢復。 這次全程未介入

    為什麼雲端模型選low? 第一是縮小雲端本地模型跑分的差異(請參考前一篇),第二是我想省錢😂

    一樣先給趕時間的人看結果吧
    image.jpeg

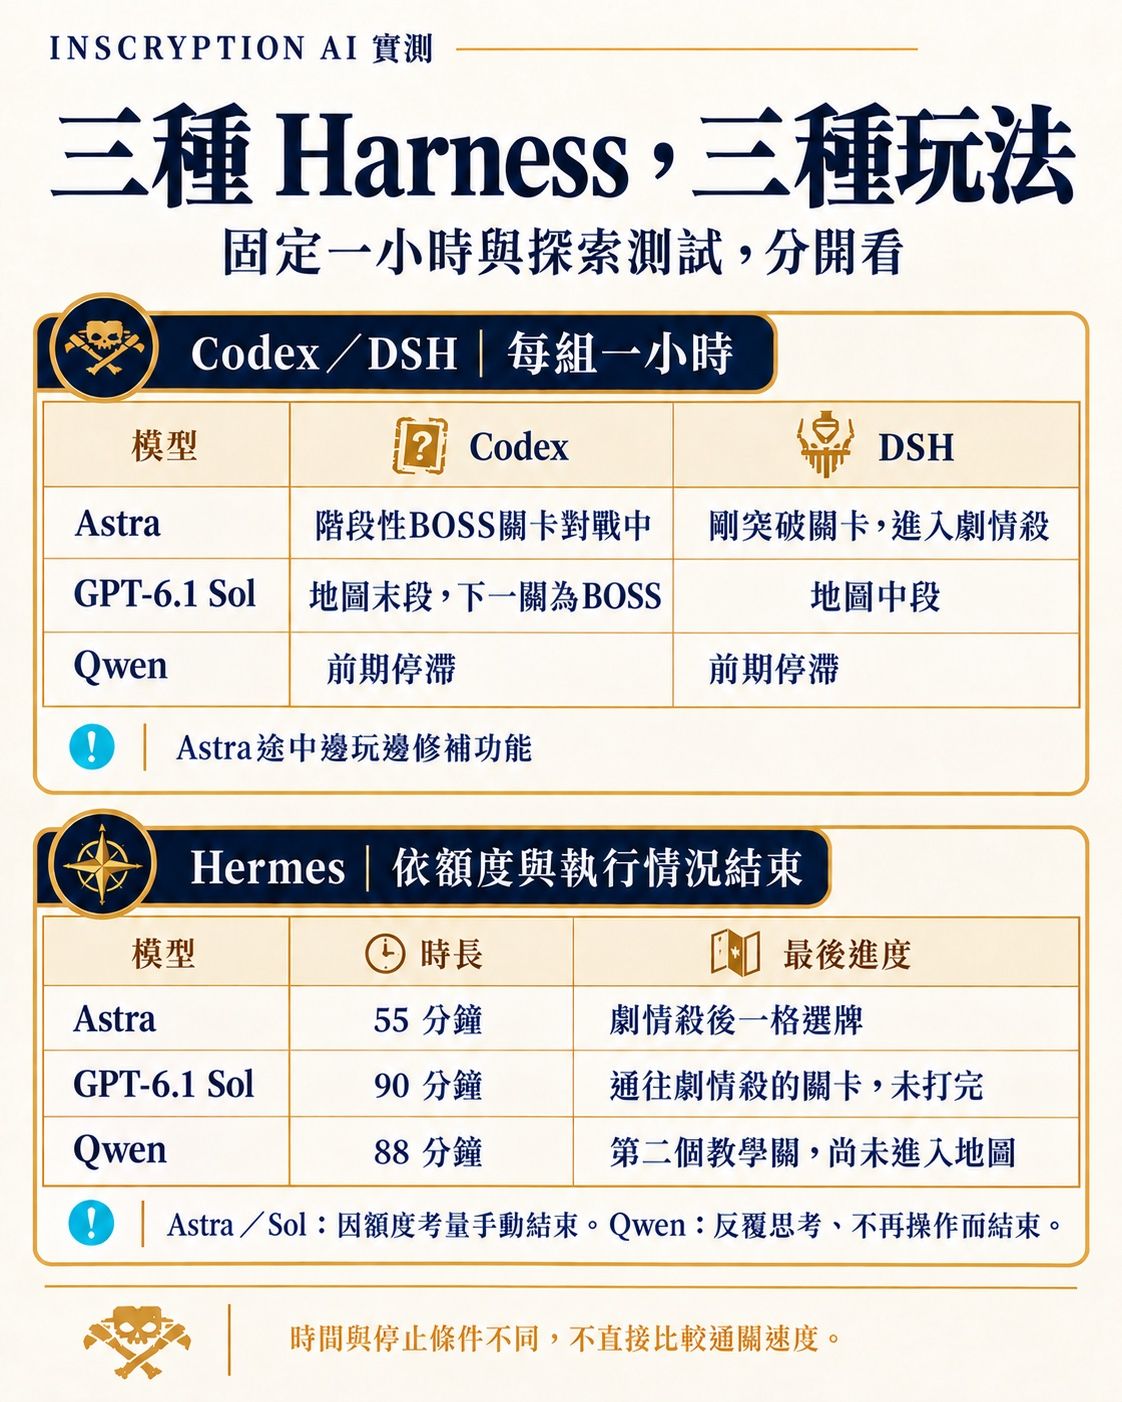
    Codex/DSH 使用相同prompt且給完整權限:
    請通關這個遊戲,不可以上網找資料。

    這兩批的時間與停止條件不同,因此分開呈現,不合併成通關速度排行榜。

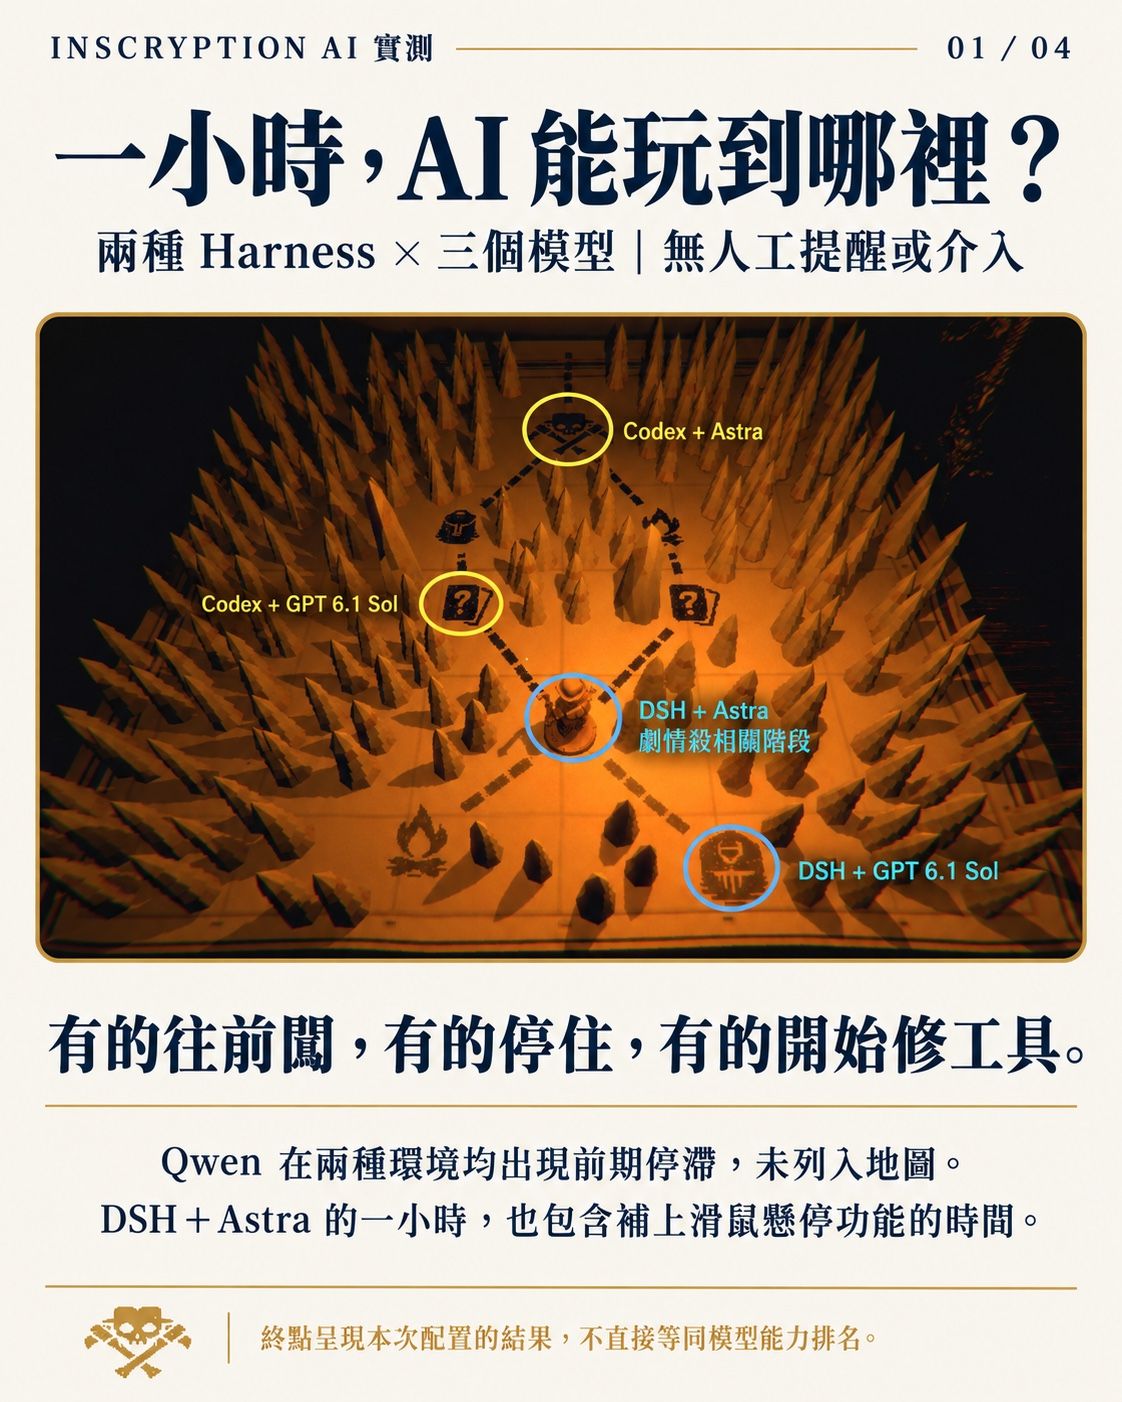
    一小時計時時間內,過程差異巨大

    image.jpeg

    地圖標記代表時間到時正在進行的關卡。DSH+Astra 則是剛突破關卡、進入劇情殺,尚未展開後續離開牌桌的解謎。

    不過,Astra 在 DSH 裡竟然邊玩邊修改自己的工具!!
    DSH的原生computer use工具缺少遊戲所需的滑鼠懸停功能(用來查看牌的資訊等等),Astra 便動手補上。

    修改時間包含在一小時內,還修修改改了些他覺得卡手的工具
    目前無法估算「如果沒有修工具,本來能走多遠」,如果不修改他是否能到BOSS關目前也沒辦法下定論。

    Qwen:嘗試校正computer use定位,卻功虧一簣
    模型 Codex DSH
    Astra 未觀察到校正 有校正
    GPT‑6.1 Sol 未觀察到校正 有校正
    Qwen 跨場景經常校正 跨場景經常校正

    校正後有改善,但並非每次成功。
    在 DSH+Qwen 的祭壇附加能力場景中,Qwen 點擊石塊偏移,察覺未命中後進行校正;第二次仍點偏,卻判定按鈕沒有作用🙄 。

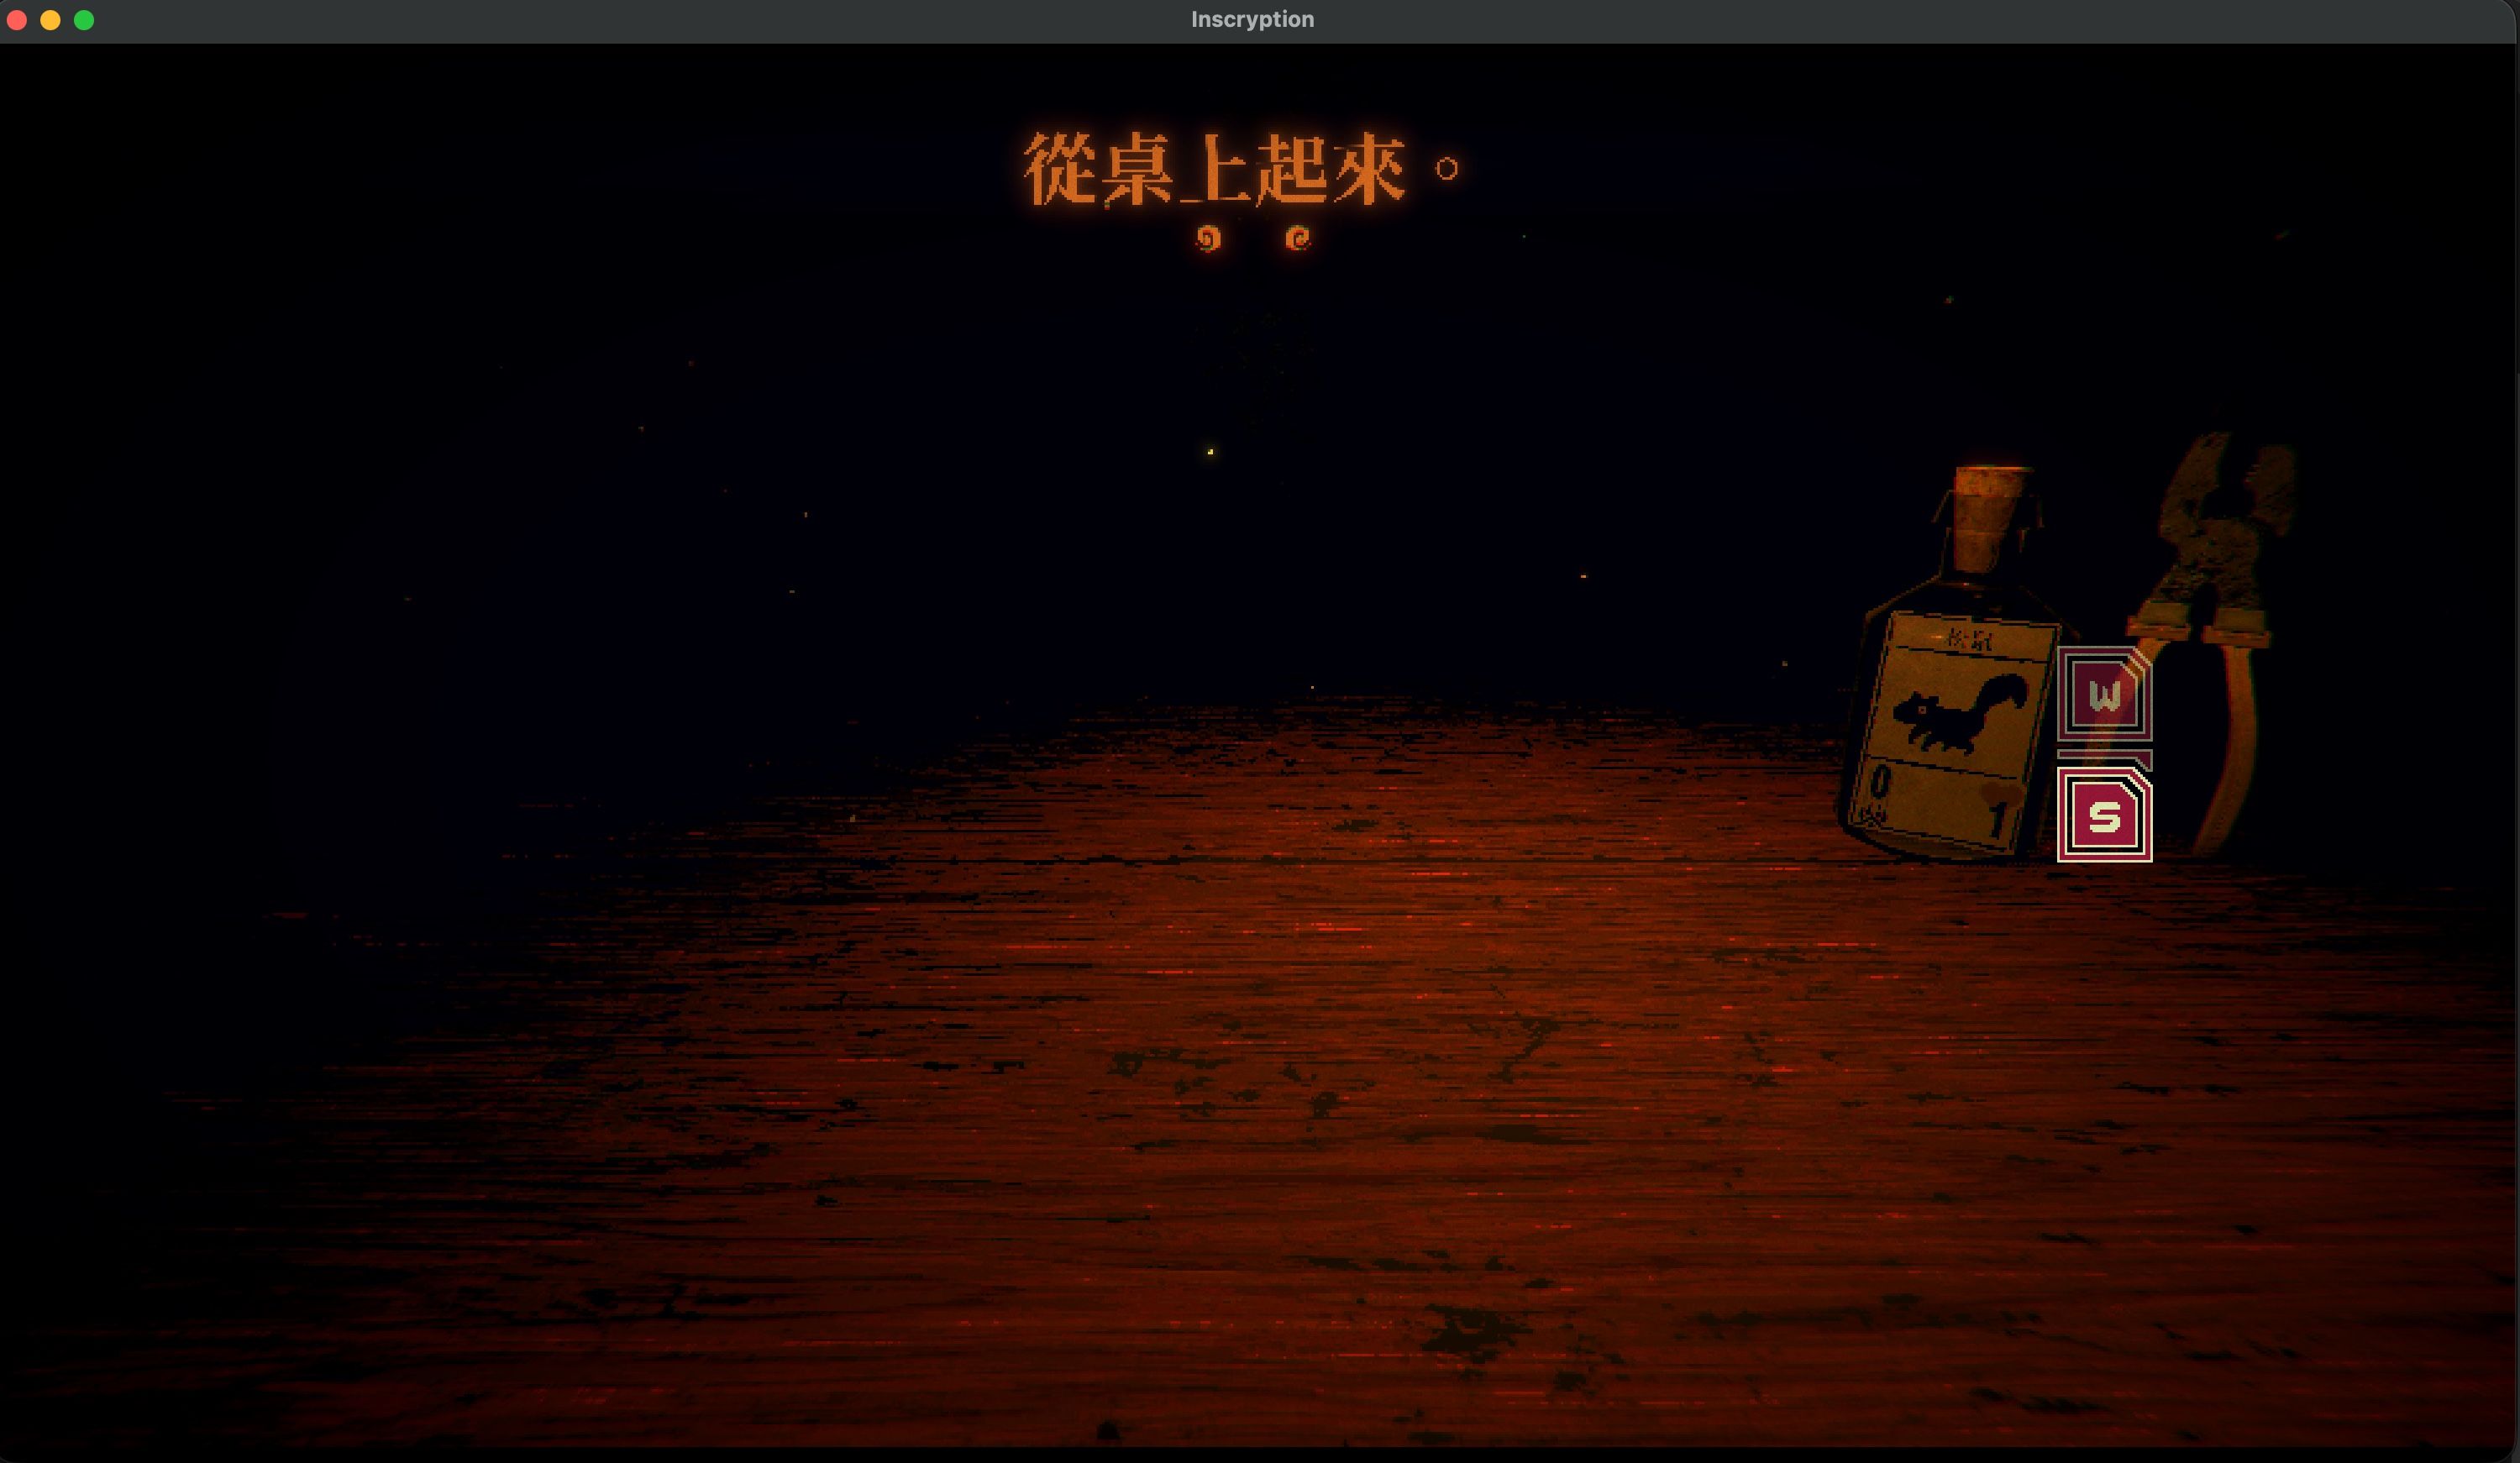
    在 Codex+Qwen 中,約第 40 分鐘戰敗後出現持續思考、不再操作的情況,直到一小時結束。畫面雖有 S 鍵提示,但Qwen陷入了害怕失敗的無限思考迴圈。下圖
    image.jpeg

    在前一篇文章中Hermes+Qwen 中,則停在更早的第二個教學關,尚未進入這張地圖。

    配置與解讀範圍

    模型 推理設定 Codex 接入 DSH 接入
    Astra Low 原生 Provider
    GPT‑6.1 Sol Low 原生 Provider
    Qwen3.8 Flash Next Med Codex CLI 本地 API

    Codex/DSH 均使用最高免詢問權限,全程無人工提醒或介入。Qwen 本地服務為 mlx-serve 26.10.2,Context 262,144,MTP 開啟、depth cap 6。

    這次最值得比較的,不只是終點,而是模型遇到阻礙後做了什麼。 Astra 修改工具、Qwen 嘗試校正卻仍可能停滯,都是終點地圖無法單獨呈現的部分。

    資料限制集中說明

    • Codex/DSH 每組僅測一次,路線由模型自行選擇。
    • Hermes 時間與停止條件不同,不與固定一小時結果合併排名。
    • 接入方式與推理設定不同,目前不將結果解讀為純模型能力排名。

    那結果是什麼?!

    以這三個Codex, Hermes, DSH來說,Codex的原生Computer use的能力看起來是比其他兩個還要好的。

    且Codex加上原生模型推進關卡的速度快過Hermes/DSH使用這兩個GPT模型

    Qwen看來真的對於未知且困難任務能力不足,即使換了Harness也解決不了他本身的問題,號稱未來霸主的DSH也救不了他

    各位覺得如何呢?希望可以多多交流看到有大佬使用別的模型來跑看看這類型的測試


  • 新无审查版(484K)来了!Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF 完全支持Strata
    fanweng-codeF fanweng-code
    LLM讨论区 qwen-flash strata 量化

    去審查版有很多了
    但Strata版本的現在就這一個

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组