
LLM是大腦是你說的價值觀
你不去換掉本地的模型用什麼agent harness有差嗎?
再說你都願意使用雲端模型API了還在意隱私是不是緣木求魚?
-
慎重考虑后,决定换掉 Hermes——大家现在都用什么 Agent? -
DeepSeek整合成立产品部,小心DSH在悄悄掏钱包了。原生的要收錢,但有些第三方搜索服務在一定額度內是免費的
-
这段时间QWEN3.8 FLASH NEXT那么热,会不会导致这种体量的模型不再开放权重啊。。deepseek模型雖然比阿里強,但低價策略反而限制了營收,且大量用戶會造成GPU算力吃緊進而影響高價值企業用戶
-
LLM 帕雷托線(斬殺線)準嗎? 我選了最沒有CP值的claude模型是正確的嗎?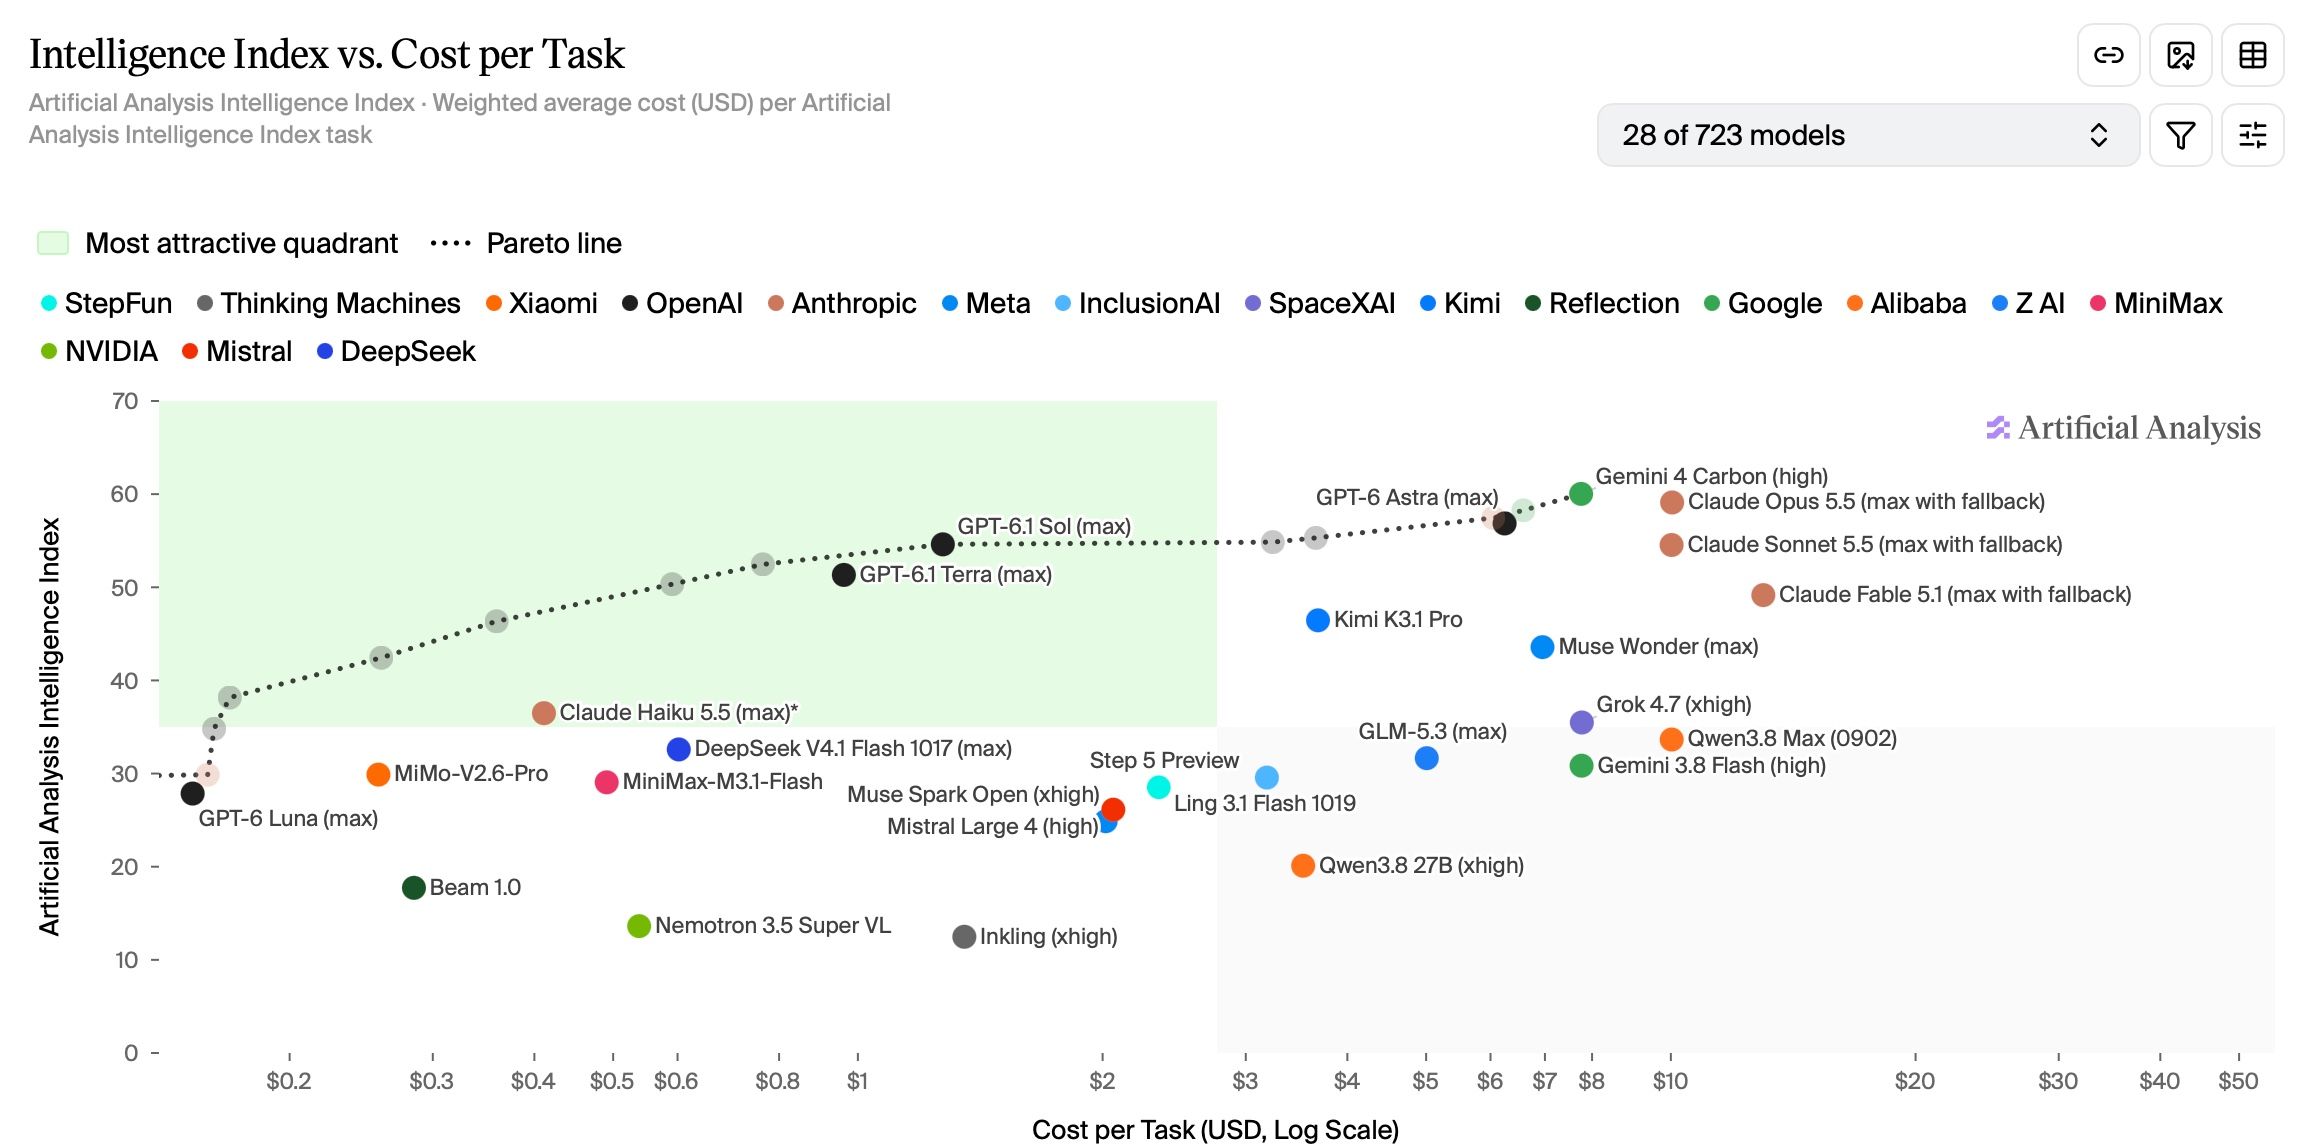
關於雲端 LLM 選型
想誠心請教一個「圖表 vs 實務」的開放性問題:
看 Artificial Analysis 最新這張評測圖,黑色虛線的帕雷托效率線非常清晰。我自己是看誰出錢,現在公司出預算所以用最貴的 Claude;如果自己出錢大概會去用 Codex。
但我想探討的是,如果排除本地部署的隱私需求,單純接雲端 API,大家會怎麼看待那些在圖表上在帕雷托線之下、離效率線比較遠的模型?
例如 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash或者是 Grok 4.7。
在商務或工程產線的真實世界裡,到底有哪些關鍵的 Trade-offs(例如提示詞遷移成本、特定任務的穩定度、或是雲端平台的生態鎖定),會讓一個團隊決定放著黑線上「同樣價錢最聰明、同樣智能最便宜」的模型不用,而選擇留在線下的次優解?
歡迎各位實際在帶專案的開發者或架構師分享你們的觀點或實務經驗。 -
有没有一个管理本地AGENT的AGENT? -
把 Strata+qwen3.8-flash-next-unsloth-ud-q4_k_xl 接进 Claude Code的五个坑@John-Lau
因為你看的文章都沒人用opus/sonnet吧
用claude模型的人會把模型接到DSH? -
台灣的蘋果 512G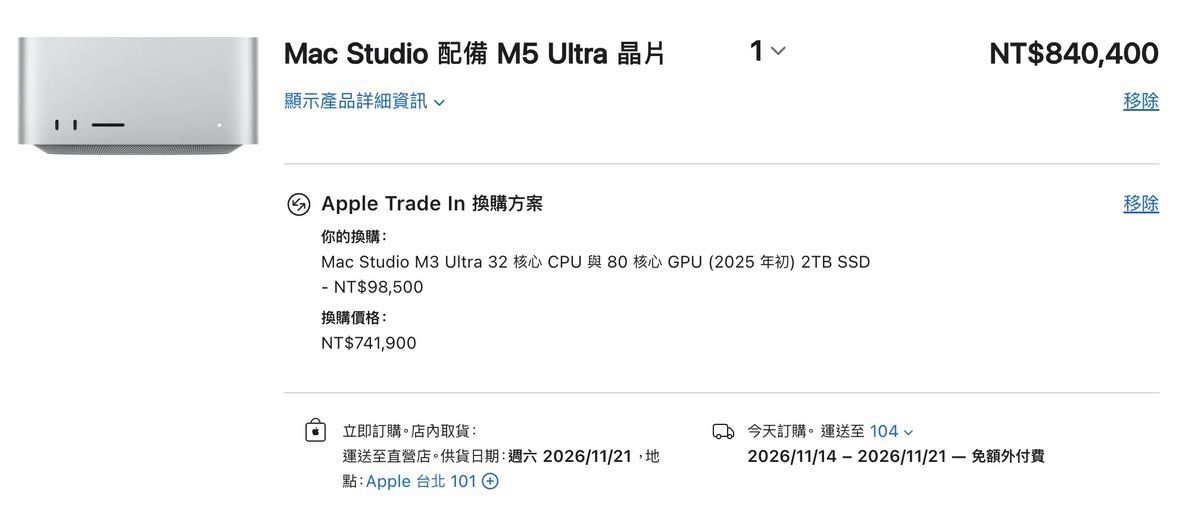
只要一條電源線,不用插一堆線方便多了
另外蘋果給的M3換購價也太低了吧... -
让AI做了一个 歌词和弦编辑器天啊,這太有趣了
ChrodPro有六線譜,只要再多一點點就能平替了! -
MAC Studio Ultra 96GB 甜点小主机到货,用起来很爽@tester12340
可能96G有點吃緊 -
M5 Ultra 256GB OMLX本地双模型实测這兩個畫出來的騎腳踏車好像都蠻慘的...
-
MAC Studio Ultra 96GB 甜点小主机到货,用起来很爽https://lcz.me/post/21976
我目前正在用的模型(無審查)還有runtime
平均有85t/s,MTP命中高的任務可到150t/s新到的ultra要等我過幾天比較有時間才能測
-
MAC Studio Ultra 96GB 甜点小主机到货,用起来很爽4bit量化,decode只有80t/s的話怪怪的
prefill也是偏慢,要找看看設定問題還是runtime問題
我的M5 ultra也剛到還沒測試,但M5 Max使用4-8bit混合量化decode有85t/s
ultra應該至少要有1.5倍 -
技术老登疯狂辱骂AI工作愚蠢,但AI取代人类大势所趋!尽早适应,迎接AI时代的到来,才能在竞争中占据有利位置,享受AI红利!提出一些個人觀點
106輪1500步有點太多了,尤其是壓縮多次之後看緩存命中率已經不代表準確性了
兩次壓縮之後就換新session,以及使用更精確的prompt,體驗上可能會完全不同 -
cmp 170hx今天拼多多售价24999?礦場真開心
沒礦可以挖,原本要報廢的機器
現在可以高價賣給接盤俠
一魚兩吃,還吃超飽 -
【新人报道・求建议】16G 显存+128G 内存:H3 视频生成和本地大模型分别怎么配置最合适?@ゆうみん
你RAM有128G,量化可以跑NVFP4 -
Gemini 4.0 Argon下放到Google AI Pro方案了@johnnybegood
可以
用AGY轉接進DSH
但我自己測過原生的AGY效果比較好 -
有没有一个管理本地AGENT的AGENT?果然任務一多,指揮的agent一多,終究繞不過這個主題
Muse已經開源,以幕僚長(全能助理)來說可能是最好的本地模型,他天生就是被設計來做這件事情的,只是開源muse的使用門檻不低。
如果不在意隱私,可以先試試看Grok bot,他現在可呼叫opus 5.5,在做唯一窗口的全能助力這一塊比先前強大太多,但缺點是這個幕僚長會吃你的線上額度,你的任務越多他需要統籌的任務越多,額度消耗如流水(但他絕對是專業的product manager),好不好用取決你的訂閱計畫。
再來就是Dots,他跟Grok bot的不同點是你不需要幫他分配不同的功能bot,記憶統籌都不需要額外分配bot給他,他用的是GPT的記憶系統,一樣可以把你手上所有的本地agent以及其他家的agent交他管理,gork bot能做到的事情dots都能做到還更簡單,你只需要明確說出你的管理方式即可,他本身不消耗訂閱額度,給他管理再多任務都是不用錢的,也可以當作無限使用Astra 模型的ChatGPT,如果你使用Gork bot的訂閱計畫需要開到100鎂,我會推薦你直接換成Dots,體驗完全不同。
Muse本人沒使用過,要掛VPN到北美有點麻煩,開源的Muse也沒用過就要請別的用戶分享了。
全能助理一定要用最聰明的,小弟有過一陣子用本地模型來管理,結果落東落西,每天本地幕僚長都在道歉說他下次會記得規則等等的慘痛經驗,最後還得是自己買一張白板把手邊的任務進度全部寫在白板上,本地模型的能力不可靠不是換harness或是開源助理repo可以解的。
-
【讨论】 Minimax M3.1 Flash开源了 (26-10-23)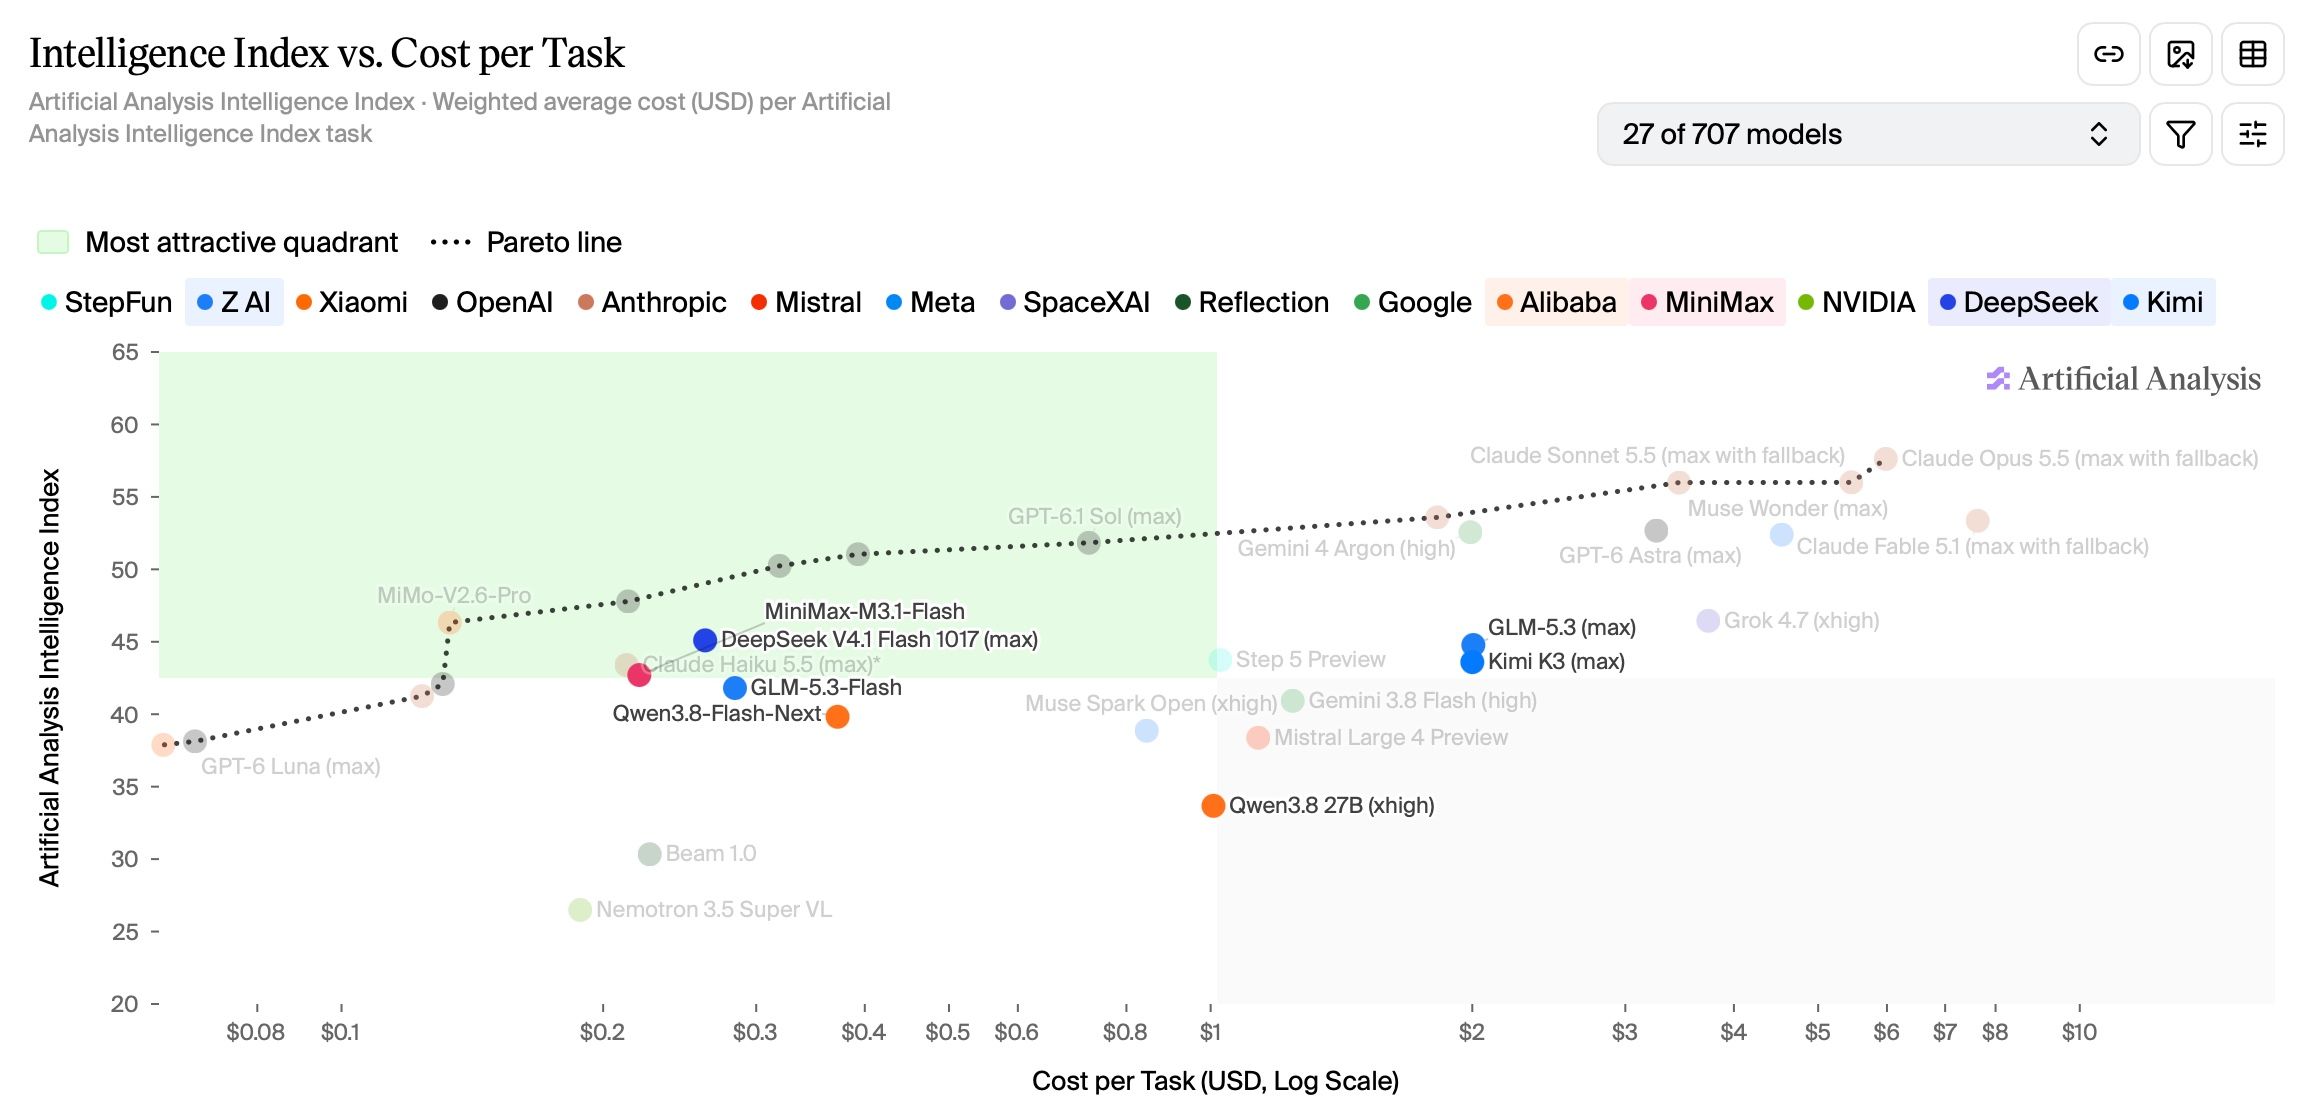
看圖左邊綠框附近這幾個模型(DS V4.1 flash 1017, MiniMax M3.1 flash, GLM 5.3 flash, Qwen3.8 ) 的能力都在伯仲之間,大約40分到45分區間,能力上沒有多少差距,個人測試困難問題的實戰無論是Deepseek或是qwen都是不行的

但部署的難度大有不同
比較項目 Qwen3.8 Flash-Next MiniMax M3.1 Flash DeepSeek V4.1 Flash GLM-5.3 Flash 總參數 125B 主幹 + 51B N-gram;另有可選 MTP 428B 552B 主幹 + 196B Engram 320B 活躍參數 6B 23B Prefill 8B/Decode 16B 18B 基本架構 MoE + GDN + QSA MoE + MSA MoE + CED + CSA2 MoE + KDA + Sparse Attention 注意力設計 以 Gated DeltaNet 為主,搭配稀疏注意力 多層 MSA 稀疏注意力 Encoder/Decoder 與跨層 KV 共用 線性注意力搭配稀疏注意力 特殊機制 N-gram、Gated Residual、MTP NVFP4 QAT、DSpark Engram、FP4 KV、DSpark mHC、MTP Context 規格上限 262K 1M 1M 1M 本人Decode 實測 約 86 tok/s 未測 約 17.07 tok/s 未測 -
造孽啊!————大家看看我的硬件配置,至于如此token水平吗?@田中火
用什麼量化格式?
你乾脆把log都丟給線上模型診斷可能還比較快 -
五马分工-hermes多profile协作经验分享我一開始也是用hermes管理所有的agent
要手動分配,定時記憶整理也很麻煩,obsidian或是supermemory都用過
尤其讓他管理claude code+codex+DSH之後,協調跟記憶就更複雜更難維護了我嘗試改成總入口換成dots後那些記憶跟協調都不需要了
一樣跟hermes只對一個agent一樣,但省心很多,後續維護都不需要Dots本身的模型夠聰明,很多事情不用講太多
唯一缺點就是他不是免費使用,還是這類型最貴的(dots 100$, grok bots 30$, muse免費)