
我也在用, 不過我用的是 AWQ Q4 再加 FP16 KV 有 256k 已經用了2星期左右. 現在再買多一台
F
franklee006
@franklee006
-
# 双卡 RTX 2080 Ti + vLLM 跑 Qwen3.8-27B-FP8 实测分享 -
雙 7900XTX + SGLang 跑 Qwen3.8-27B 完整實戰:TP=2 由 ROCm 7.2 到 HiCache,decode 78 tok/s(附全套 benchmark)跟住 https://lcz.me/topic/1532 同 https://lcz.me/topic/1567 兩位前輩嘅路線,我喺自己部機由零行咗一次完整 setup,順便做咗全套 benchmark 同 HiCache 逐出/還原實測。有幾個新發現(尤其 HiCache 嗰 part)想還返俾社群。
一、硬件
- CPU:EPYC 7K62 48C(洋垃圾)
- 兩張 Sapphire PULSE 7900 XTX 24G,PCIe 4.0 x16 + x16(lspci LnkSta 實測)— EPYC lanes 夠,TP all-reduce 冇瓶頸,比 X670E x8/x8 爽
- 125GB RAM、Ubuntu 24.04.4、kernel 7.0.0-31
- 機入面另外兩張 4080 SUPER 行緊另一個 FP8 instance,兩邊並行唔相撞(ROCm 只見 AMD 卡)
二、軟件棧同安裝
- ROCm 7.2.0 userspace:kernel 7.0 內核 amdgpu 直接用,唔使 dkms。注意 30.x 版 amdgpu-install 參數要等號:
sudo amdgpu-install -y --usecase=rocm --no-dkms --no-32- Python 3.12 venv + torch 鎖死 2.11.0+rocm7.2(whl/rocm7.2 index),任何 pip 操作之後 check 返 torch.version.hip 有值
- engine:StevenChenSE/sglang
gfx1100-support分支(f84475c),照 README:setup_rocm.py 編 19 個 kernels,成個 aot/python/sgl_kernel 目錄 copy 入 site-packages(要有 init.py 先至有 gptq_gemm) - 自訂 all-reduce:scripts/rdna_ar/rdna_ar_ext.py + make(kfd_event_age_fix.so 用 LD_PRELOAD)
三、兩個必改嘅源碼 patch(今次分享重點之一)
Patch 1:all-reduce wrapper 入面 copy_sys_kernel 用咗 CDNA3 先有嘅
__builtin_amdgcn_global_store_b128,gfx1100 編唔過(要 gfx940-insts)。改做 RDNA3 安全嘅 128-bit volatile store(方向同 farmer-node 喺 https://lcz.me/topic/1640 講嘅一致):// scripts/rdna_ar/rdna_custom_all_reduce.cu - __builtin_amdgcn_global_store_b128((sgl_v4u_gptr)(dst + i), v, ""); + *(volatile sgl_v4u_gptr)(dst + i) = v; // RDNA3: no b128 builtinPatch 2:custom_all_reduce_hip.cuh 入面 RankData 嘅 const void* restrict ptrs[8] 會令 clang 生成隱式 copy assignment 失敗(std::fill 需要),剷走 restrict 就得(純優化提示,零語義影響):
-  const void* __restrict__ ptrs[8];
+  const void* ptrs[8];
改完用 PYTORCH_ROCM_ARCH=gfx1100 行 rdna_ar_ext.py 一發過。
四、模型
Vishva007/Qwen3.8-27B-W4A16-AutoRound-GPTQ(~19G,MTP 保持 bf16)。記得改 config.json:將 dynamic quantization rules 入面兩條
+:.*mtp.*規則換成一條排除規則-:.*mtp.*(bits 16、group 128),唔係嘅話 GPTQ loader 會喺 MTP tensor 上面炸。五、生產啟動配置(全套)
export SGL_DTYPE=bfloat16 SGLANG_RDNA_CUSTOM_AR=1 SGL_RDNA_NO_FUSED=1 \
       SGL_RDNA_GEMMA_TRITON=1 SGL_RDNA_VLLM_VERIFY=1
export LD_PRELOAD=~/sglang-gfx1100/sglang/scripts/rdna_ar/vendor/kfd_event_age_fix.so:$LD_PRELOAD

python3 -m sglang.launch_server \
  --model-path ~/models/Qwen3.8-27B-W4A16 --host 0.0.0.0 --port 30001 \
  --tp-size 2 --quantization gptq --dtype bfloat16 \
  --mamba-ssm-dtype bfloat16 --kv-cache-dtype auto \
  --attention-backend triton --triton-attention-num-kv-splits 16 \
  --context-length 196608 --mem-fraction-static 0.91 \
  --max-running-requests 4 --max-mamba-cache-size 20 \
  --speculative-algorithm NEXTN --speculative-num-steps 3 \
  --speculative-eagle-topk 1 --speculative-num-draft-tokens 4 \
  --cuda-graph-bs-decode 1 2 4 --chunked-prefill-size 2048 \
  --page-size 64 --schedule-policy lpm --sleep-on-idle \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder --enable-metrics \
  --enable-hierarchical-cache --hicache-ratio 2 \
  --hicache-io-backend direct --hicache-write-policy write_through \
  --default-chat-template-kwargs '{"reasoning_effort": "medium"}'
KV pool 257,024 tokens(bf16),HiCache host pool 再加 514K(2×17.9G RAM + 1.6G mamba host)。
六、Benchmark(2026-09-15,temp 0,串流 + usage 計數)
Decode vs 深度(MTP-3 單流): 0 → 78.4 tok/s(12.7ms/token);16K → 71.7;32K → 64.9;65K → 61.3;131K → 42.0(23.8ms)
併發: 1u 67.6 / 2u 合計 118.9 / 4u 合計 176 tok/s
Prefill(冷啟動): 4K 峰值 1,869 tok/s;16K 1,715;32K 1,477(TTFT 22s);65K 1,136;130K 777。4×32K 同時只有 1,469 — prefill 係計算飽和,排隊唔會快。
快取: GPU radix 32K 冷 22s → 暖 0.41s(53.6×);L2 還原見下節。
MTP: accept length 2.725(/metrics 嘅 spec_accept_length)。
同 2×4080S FP8 同日同方法對比: decode 78.4 vs 71.3(XTX +10%);32K prefill 1,477 vs 1,914(4080S +29%)。同 #1532/#1640 嘅格局一致:XTX decode 勁、prefill 輸 NVIDIA 一截。
七、HiCache 實測(新發現)
背景:fork 對混合架構(48 層 Gated DeltaNet + 16 層 full attention)有寫 mamba host cache,但作者都話未測過。我嘅逐出測試(載入 A → 灌爆 257K pool 逼 A 被逐出 → 再問 A):
- 備份管線通:write-through 持續 backup(hicache_backup_tokens_total 上升,零 drop)
- 純重複 prompt 觸發唔到還原(4.2s 全量 re-prefill)— 因為 mamba state 只會喺**請求完結點、prefill chunk 邊界(每 2048)、decode 追蹤點(每 256)**捐入 radix tree
- 續接形態(下一輪 = 上一輪完整序列 + 新內容,即 agent 天然用法)完美還原:7.6K context 被逐出後 0.21s 由 RAM 還原(20×);chat template 重 render 有時令 token 序列喺 thinking 位分歧,退落最近 2048-grid checkpoint 都有 2.66s(仍慳 37%)
- 分支形態(同 doc 唔同問題)只有部分著數 — 呢個先係真正嘅 hybrid 缺口(對應上游 sgl-project/sglang#12826)
結論:開住佢。有效容量 257K GPU + 514K host ≈ 771K,長 session agent 逐出後秒級恢復。io-backend 一定要 direct(kernel backend 對 hybrid mamba 會炸,sglang #24121)。
八、陷阱清單
- 千祈唔好數 SSE chunk 做 benchmark:MTP 下一個 chunk 載 2.6 個 token(= accept length),數 chunk 會低估 2.6 倍,要用 usage 計數
- 唔好 pkill -f sglang.launch_server — 會撈埋 Docker 入面其他 instance,用 port 搵 PID 精準殺
- 永遠唔好 rocm-smi --gpureset(gfx1100 鎖 PCIe root port,要冷開機)
- pip 依賴要手動補:orjson、gguf、sentencepiece、dill、xgrammar、python-multipart、prometheus_client、openai、apache-tvm-ffi==0.1.11…
- fork 冇 --max-consecutive-prefill-batches(上游 PR #34058 未併入),併發 prefill 打斷 decode 嘅卡頓暫時無解
致謝
StevenChenSE 嘅 fork、farmer-node 嘅 all-reduce 修法方向、以及 #1532 #1567 #1640 #1674 嘅前輩。mamba 分支還原嗰 part 如果有人焗到更深,歡迎交流。
-
分享两台 AI 算力机:X99 四卡(2×3080+2×3090) + EYPC H12-8D(2×4080S+2×7900XTX)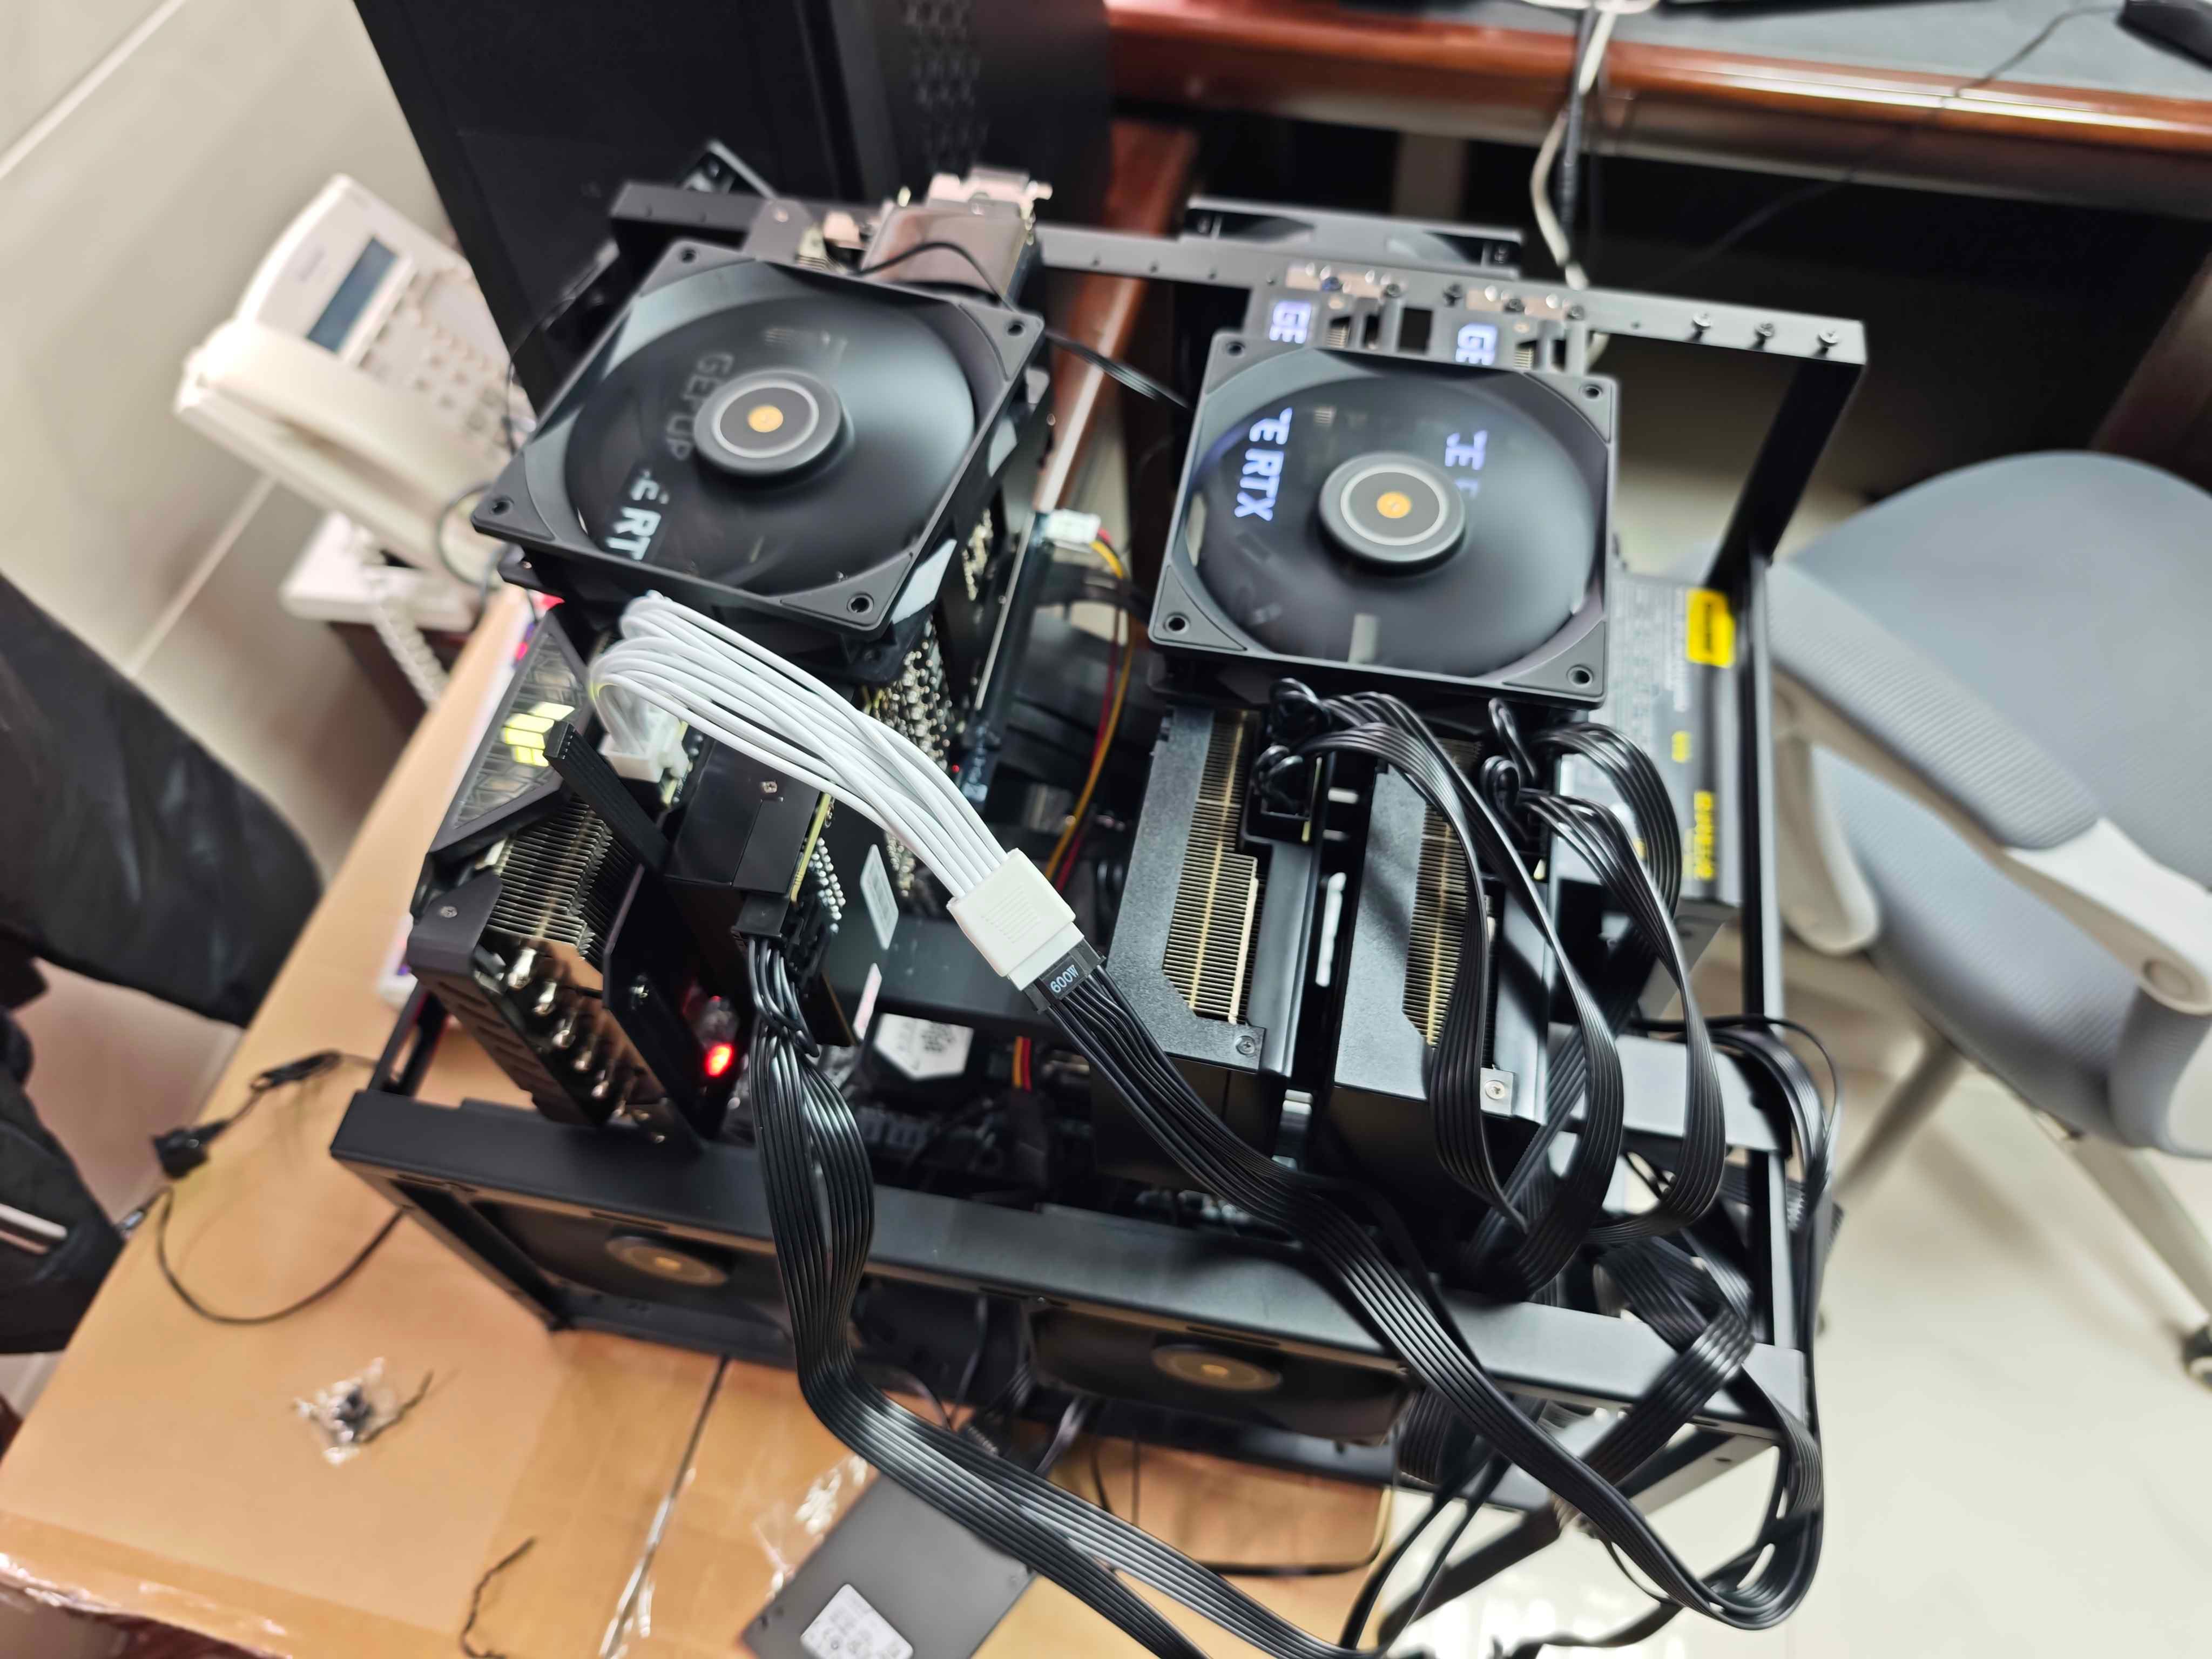
感谢论坛各位大神,分享下我目前的两台 AI 算力机配置,暂时都主要跑 LLM。【机1:开放式 X99 四卡机】
硬件 / 型号规格 / 备注
机箱:开放式 X99 机箱
CPU:Intel Xeon E5-2666 v3(LGA2011-3,多卡机 CPU 很关键)
主板:华南金牌 X99-TF
内存:DDR3 1600 32G × 4 = 128G
硬盘:256G SATA SSD(旧电脑拆下来的)
电源:长城 1650W
显卡 1-2:RTX 3080 20G × 2(京东买)
显卡 3-4:RTX 3090 24G × 2(一张是弟弟送的三风扇卡,另买了 NVLink + Turbo 卡)PCIe 接法(重点):
- 所有卡都用 PCIe 延长线接
- 2×3080:走主板原生 PCIe 3.0 x16
- 2×3090:因为要上 NVLink,一张走 M.2 转 PCIe x16,另一张走 x4 转 x16
- 3090 是三风扇卡,NVLink 桥接时一高一低,3D 打印了个小支架顶平就解决了
【机2:EYPC H12-8D 整机】
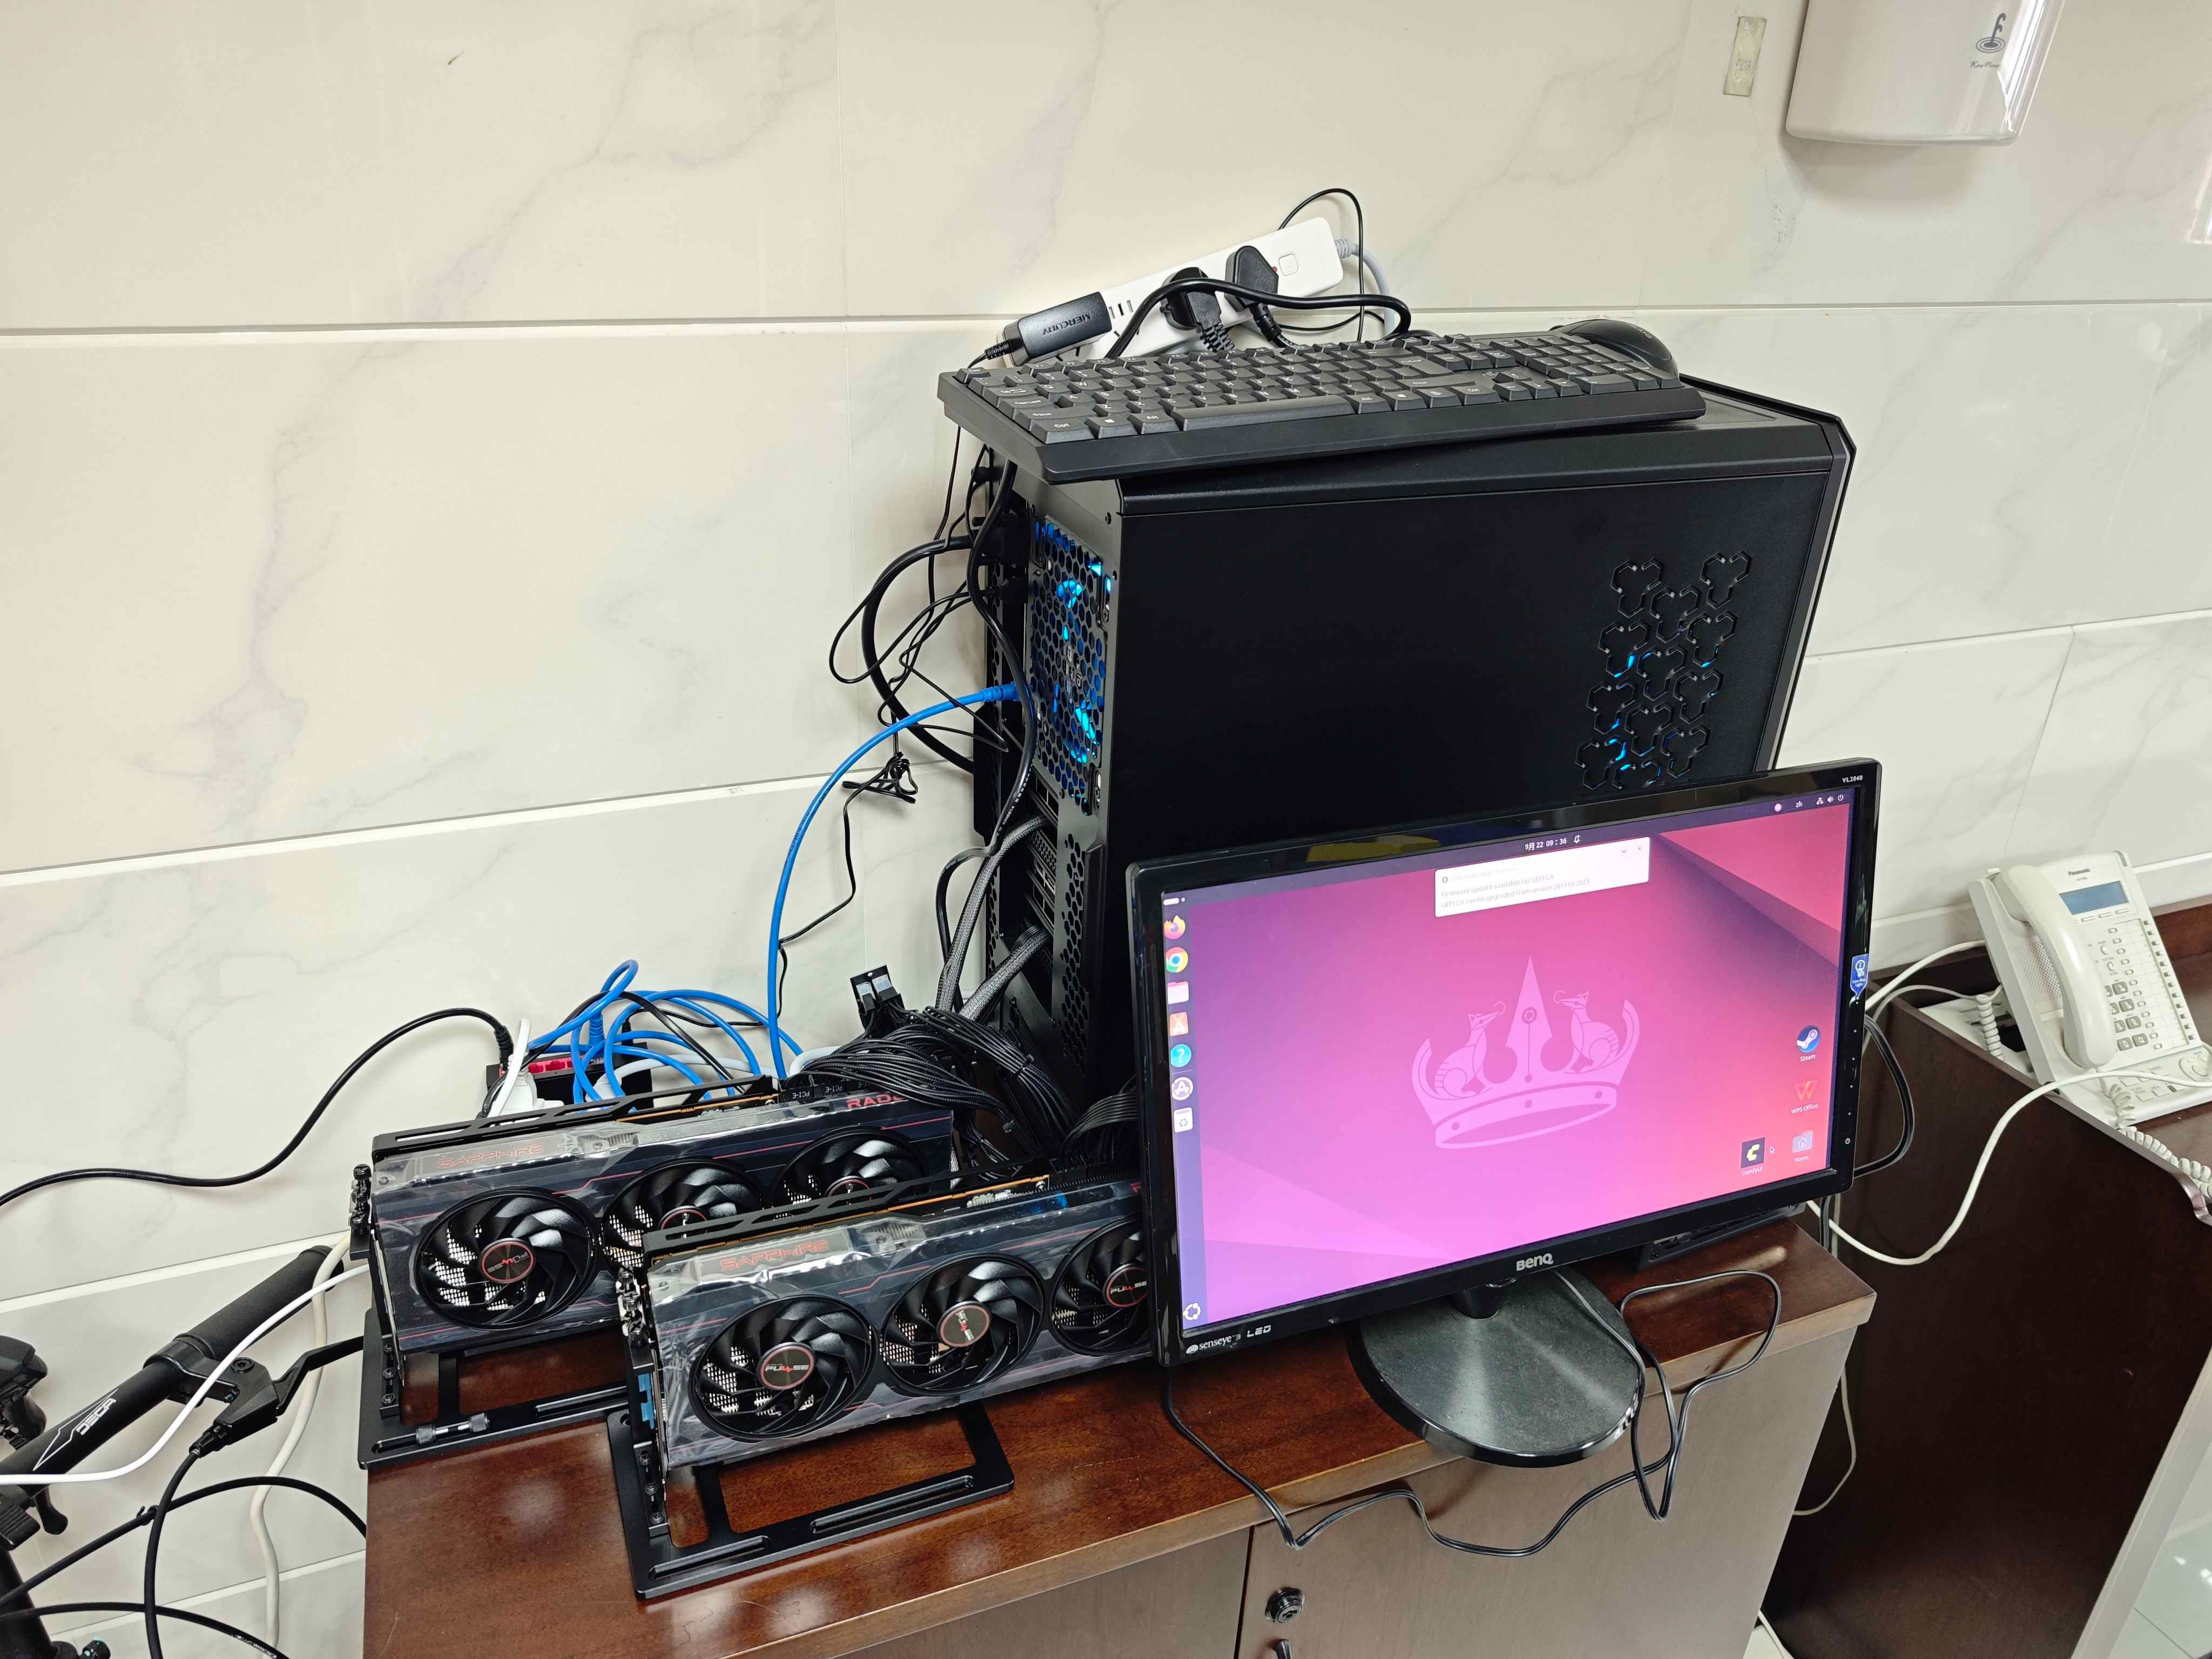
硬件 / 型号规格 / 备注
整机:EYPC H12-8D(淘宝买的整机)
内存:128G DDR4
显卡 1-2:RTX 4080S 32G × 2(整机自带)
显卡 3-4:RX 7900 XTX × 2(后来自行加装)
电源:自行加装(配合 4 卡)目前两台都主要用来跑 LLM,后续有实测数据再补充。欢迎讨论。
-
X99 + E5-2666 v3 + 雙 RTX 3080 20G 跑 Qwen3.8-27B:SGLang TP=2 + DFlash2 + HiCache 全套實測(單流 70 tok/s、附 P2P 完整驗證鏈)繼上篇雙 7900XTX 之後,今次交另一部機嘅作業:成套唔夠幾千蚊嘅 X99 洋垃圾平台,跑同一個 Qwen3.8-27B。重點想講主板同 CPU 對雙卡 TP 嘅實際影響(尤其 P2P 嗰 part,驗證鏈完整附上),同埋 kk-pcl 前輩個 DFlash2 補丁喺 native Ubuntu 上嘅復現結果。
一、硬件
- CPU:Xeon E5-2666 v3(10C20T,Haswell-EX,AWS 拆機洋垃圾)。跑推理完全夠:prefill 時 CPU 佔用好低,瓶頸全喺卡
- 主板:X99 TF(消費級魔改板,BIOS 冇 Above-4G Decoding / Resizable BAR 選項 — 呢點後面好關鍵)。兩條 PCIe 3.0 x16 都係 CPU 直連 root port(lspci -t 實測:GPU0 @03:00 掛 00:02.0、GPU1 @04:00 掛 00:03.0,中間唔經晶片組),nvidia-smi topo -m 顯示 PHB
- 62GB DDR3、190G SSD、Ubuntu 24.04.5(kernel 7.0.0-31)
- 雙 RTX 3080 20G 魔改卡(lspci subsystem 實確認 20GB)
二、X99 平台 P2P 真相(完整驗證鏈,今次分享重點)
好多人講 X99 雙卡 P2P,我由頭到尾驗證一次:
- 補丁前:
nvidia-smi topo -p2p r= CNS(GeForce 驅動封鎖,正常) - 裝社群 P2P fork:
aikitoria/open-gpu-kernel-modules(branch 615.71.09-p2p)+ 對應 615.71.09 userspace(.run --no-kernel-modules)+ GRUB 加intel_iommu=on iommu=pt,清走舊 dkms module 後 depmod - 重啟後:
topo -p2p r= OK 、
cudaDeviceCanAccessPeer雙向 TRUE、P2P Clique [0 1] - 但
cudaDeviceEnablePeerAccess= 失敗「mapping of buffer object failed」
- 根因:
nvidia-smi -q實測 BAR1 只有 256 MiB — X99 BIOS 無 Above-4G/ReBAR,peer mapping 開唔到 cudaMemcpyPeerAsync256MB 實測 6.0 GB/s,同經 host 中轉一模一樣(PCIe 3.0 x16 去返 root complex)
結論:呢個補丁喺 X99 上驅動層全部生效,但主板韌體無 ReBAR 就係唔work。瓶頸喺板唔喺驅動 — 同版上 Nero丶畅畅 前輩 X99 混插 3090+4090 測到 P2P false 嘅結論一致。想真 P2P 要換有 ReBAR 嘅平台。
意外收穫:轉用 615.71.09(.run)之後同一個 sharegpt benchmark 由 125.8 升到 166.2 tok/s(+32%),純驅動增益(實際傳輸仍係 SHM)。
三、軟件棧(踩坑記)
- pip 版 CUDA 工具鏈版本參差係最大坑:nvcc 13.4 配 13.0 headers(CCCL 直接 #error),cicc 13.4 配 ptxas 13.0(PTX .version 9.4 爆炸)。解法:
pip install nvidia-cuda-nvcc==13.0.88 nvidia-cuda-crt==13.0.88 nvidia-nvvm==13.0.88統一對齊,加ln -s lib lib64(JIT link 揾 -lcudart 用)同CUDA_PATH=site-packages/nvidia/cu13 - SGLang:kk-pcl 嘅 sglang-qwen38-dual-3080-patch(釘 commit 4cb5aebfe)。三個改動:DFlash2 fc.weight TP 分片、主模型 16 層 per-head FP8 KV scales、SM90 以下停 symm-mem logits gather(Ampere 防炸)。離線測試全過
- 桌面環境食 GPU0 ~80MB:mem-fraction 0.90 會喺 warmup 撞 OOM,要用 0.88
- 千祈唔好 runtime 停 gdm 慳嗰 80MB — 我試過 NVIDIA driver kernel panic 成機重啟。想慳應該
systemctl set-default multi-user.target之後重啟
四、模型同生產配置
主模型 cyankiwi/Qwen3.8-27B-AWQ-INT4(20G)+ draft syvai/Qwen3.8-27B-DFlash2-W4A16。啟動重點:
sglang serve --model-path ~/models/Qwen3.8-27B-AWQ --tp-size 2 \
  --quantization compressed-tensors --kv-cache-dtype fp8_e4m3 \
  --quantization-param-path scales/qwen38-fp8-kv-scales-per-head.json \
  --speculative-algorithm DFLASH --speculative-draft-model-path ~/models/Qwen3.8-27B-DFlash2-W4A16 \
  --speculative-draft-kv-cache-dtype fp8_e4m3 --speculative-num-draft-tokens 8 \
  --context-length 200000 --max-total-tokens 185000 \
  --max-running-requests 4 --cuda-graph-max-bs-decode 4 \
  --mem-fraction-static 0.88 --mamba-ssm-dtype bfloat16 \
  --mamba-radix-cache-strategy extra_buffer_lazy --disable-custom-all-reduce \
  --enable-hierarchical-cache --hicache-ratio 2 --hicache-size 15 \
  --hicache-io-backend direct --hicache-mem-layout page_first_direct \
  --hicache-write-policy write_through --page-size 64 \
  --default-chat-template-kwargs '{"reasoning_effort": "medium"}'
VRAM 分佈(每卡):權重 9.7G(48%)/Mamba 池 2.2G/主 KV 池 FP8 2.8G(185K tokens)/draft KV 0.88G/CUDA graph 1.4G。HiCache host 層:主 KV 578K tokens(9.5G)+ draft 2.96G + mamba 5.5G,GPU:主機 ≈ 1:3。
五、Benchmark(temp 0.6、自然中文、輸出 512 token、伺服器端 gen throughput)
Prefill 聚合 ~1,030–1,370 tok/s(同併發無關):
- 單流 TTFT:1K 0.8s/8K 5.6s/32K 23s/64K 50s/100K 85s
- 4 併發 32K:106s(排隊線性)
Decode 對上下文長度極唔敏感(混合 Mamba 架構嘅甜點):
- 單流:1K ~70/8K ~58/32K ~57/64K ~55/100K 仲有 ~65(峰 71)tok/s
- 2 併發合計 105–160;4 併發合計 131–159(每人 33–40)
- DFlash:自然中文 accept 2.1–2.4;關 DFlash 單流得 59.7 → +110%
HiCache(agent 場景殺手鐧):
- 23K prompt:冷 17.9s → 暖 0.23s(77×)
- 迫爆 GPU 池(5×46K=230K>185K)之後重發最舊嗰條:0.29s 由 host 層還原(130×)
- 總需求 840K > GPU+host 795K 先會真 LRU 逐出 — 三層行為全部符合預期
同自己上篇雙 7900XTX 對比:decode 70 vs 78(XTX +10%)、32K prefill 1,280 vs 1,477(XTX +15%)— 兩邊好接近,但 X99+3080 全套成本平一個位。
六、陷阱清單
--max-total-tokens唔好釘 200K:填滿 budget 後 Mamba 池冇鬆位,兩條 32K 同時 prefill 會Can not alloc mamba cacheassert 直接殺 scheduler。185K 穩定- MRR=2 + 雙長文同時 prefill 會炸、MRR=4 反而唔會(怪但實測;而家默認 4)
- DFlash 量測陷阱:投機解碼每步爆發式輸出 2.1–2.4 token,數串流 ITL 計速度會錯到阿媽都唔認得;用 usage token 數/時間或者伺服器 gen throughput。另外 accept 同內容有關:亂碼 benchmark 3.4–3.9、自然中文 2.1–2.4
- FP8 KV scales 係靜態校準(per-head,TP=2 專用),唔好套去第個模型/TP
- X99 想玩 P2P 嘅省返:驗證鏈喺第二節,BAR1 256MB 一票否決
七、值唔值得玩?
511–800 蚊板U + 舊 DDR3 + 兩張 3080 20G 魔改:27B AWQ + DFlash2 單流 70 tok/s 互動好順、prefill 1,300 對 RAG/長文問答夠用、HiCache 對 agent 多輪場景價值爆錶(200× 還原)。諗住升級:CPU 換 E5-2690 v3 意義唔大(推理 CPU 唔係瓶頸),RAM 加到 128G(DDR3 好平)畀 HiCache host 層翻倍反而最實際。
-
雙 2080 Ti 22G 魔改卡跑 Qwen3.8-27B:由 1 並發改 8 並發實測 — 總吞吐 +112%,單線只跌 3%最近把工作站的 vLLM 由 1 並發改成 8 並發,分享一下改動思路和實測數據。
硬件:
- RTX 2080 Ti 22G 魔改卡 ×2(NVLink 橋)
- 模型:Qwen3.8-27B W4A16 AWQ(community quant,~11GB)
- 軟件:weicj/vLLM-2080Ti-Definitive(專為雙 2080 Ti / SM75 Turing 優化的 vLLM fork,感謝作者 weicj 和 upstream vLLM)
- TP=2 · 256K context · MTP speculative decoding · fp16 KV
為什麼從 1 並發改 8 並發:
之前跟 repo 建議跑 1-concurrent + 內建排隊,圖的是單線 decode 最快。但實際 workload 是:
- 讀 PDF / RAG:一般 50K context 以內
- VS Code agent:可控制在 100K context 以內
- 都遠低於 256K 上限 —— 「一條 request 食滿整個 context」的場景根本沒出現過
而 agent 的工作模式是:想一段 → 等 command 跑完 → 再想。等 command 時 GPU 完全 idle,1 並發下這些空檔全部浪費。多並發就是把空檔填滿。
實測數據(同方法對比,真實 token 計數):
配置 單線 decode 8 並發總吞吐 8 並發 max TTFT 1 並發(MTP3,舊設定) 54.6 t/s 60.4 t/s(其餘排隊) 30.4 s 8 seqs 無 MTP 46.3 t/s 102.0 t/s 3.2 s 8 seqs + MTP2(現行) 52.8 t/s 128.4 t/s 5.3 s Prefill(現行配置):~1,600 t/s @8K · ~1,430 t/s @32K · ~1,200 t/s @65K
結論:
- 總吞吐 60.4 → 128.4 t/s(+112%),TTFT 從排隊 30 秒級降到 5 秒級
- 單線只跌 ~3%(54.6 → 52.8,MTP3→MTP2 騰出 batch 空間)
- 對 agent / 多 client 場景是質變:以前第二條 request 要等第一條做完,現在真正並行
代價也要說:8 並發時每條線只有 ~20 t/s,長 context prefill 會互相排隊。所以這是「agents farm」取向,不是「單線跑分」取向。
現行配置(launcher 參數):
--tensor-parallel-size 2 --max-model-len 262144 --max-num-seqs 8 --max-num-batched-tokens 2048 --quantization compressed-tensors (W4A16) --speculative-config method=mtp,num_speculative_tokens=2 --enable-chunked-prefill --enable-prefix-caching temperature 0.6 / reasoning_effort medium -
分享两台 AI 算力机:X99 四卡(2×3080+2×3090) + EYPC H12-8D(2×4080S+2×7900XTX) -
雙 4080 SUPER 32G + SGLang HiCache 實測:Qwen3.8-27B-FP8,256K context,agent 全程代操(GLM Zcode + GLM 5.3)雙 4080 SUPER 32G + SGLang HiCache 實測:Qwen3.8-27B-FP8,256K context,agent 全程代操(GLM Zcode + GLM 5.3)
各位好,分享下我部機嘅 SGLang + HiCache 完整實測。雙 4080 SUPER 32G(64G 總顯存)跑 Qwen3.8-27B-FP8,開 256K context。呢個部署最特别嘅地方:成個調校過程(kernel tuning、P2P 排查、參數定案)全部係我用 GLM Zcode + GLM 5.3 嘅 agent 搞掂,我基本只負責出指令同審 log——正正係 terry 話過嗰句「讓你的 Agent 去操作」嘅實例。
先講結論(TL;DR)
- 2× RTX 4080 SUPER 32G,TP2,各食 ~30G VRAM
- SGLang v0.5.18 + HiCache(hicache-ratio 2,RAM 層 748K tokens,總 cache ~1.12M tokens)
- 256K context、FP8 KV、NEXTN/MTP 投機解碼(accept rate ~0.61,單流 peak 過 200 t/s)
- Decode:1 用戶 65.6 t/s → 4 用戶 aggregate 179 t/s(temp 0 實文測試)
- Prefill 天花板 ~1,950 t/s(NVIDIA 驅動封咗 Ada GeForce 嘅 P2P,NCCL 要行 host RAM,呢個係硬頂)
- HiCache 實測:50K prompt 27.8s → 2.4s(11.6x);32K 16.4s → 0.5s(32x)
- 生產 log 17 分鐘窗口:HiCache 命中 62/146 個 prefill batch,单次最大命中 86,528 tokens
- 全部調校由 GLM Zcode + GLM 5.3 agent 執行:W8A8 FP8 GEMM 手動 tune 5 個 shape、P2P/ACS/IOMMU 排查、參數 A/B——agent 做嘢,人審 log
一、硬件配置
項目 配置 主板 華南金牌 H12D-8D V2.0(X99 雙路平台,單路用,2× PCIe 4.0 x16 實測跑滿 16GT/s) CPU AMD EPYC 7K62 48C/96T @ 3.3GHz(單路) 內存 125GB DDR4-2400(4× 32GB SK Hynix ECC),HiCache host 層食咗 ~36GB 顯卡 2× NVIDIA RTX 4080 SUPER 32GB(PCIe Gen4 x16,無 NVLink、無 P2P,TP 走 PCIe + NCCL) 存儲 KIOXIA EXCERIA Basic 1.8TB NVMe 系統 Ubuntu 24.04,NVIDIA driver 595.84 / CUDA 13.2,Docker 部署 網絡 LAN 192.168.0.122 + Tailscale(100.82.33.33,OpenAI-compatible API 尾網直達) GPU 空載 ~185W(cap 320W),52-57C。
二、成個部署點樣搞:GLM Zcode + GLM 5.3 agent
呢部機嘅 SGLang 部署、調校、排查,流程全部係 agent 做:
- 起手俾指令:「幫我部雙 4080S 部署 Qwen3.8-27B-FP8,SGLang,要 256K context,要 HiCache」
- agent 自己拉 image、寫啟動腳本、對齊 param(
--hicache-ratio 2、--page-size 64、--max-mamba-cache-size 32全部係佢測出嚟嘅) - 之後嘅優化全部係 agent 主導:
- W8A8 block-FP8 Triton GEMM 手動 tune:寫咗 5 個 weight shape(qkv_proj / o_proj / gate_up / down_proj + 2 個小 shape)嘅 benchmark script,每個 shape 掃幾百組 block config,寫返成 tuned config JSON 掛進 image。結果 GEMM 快 1-5%,decode 整體 +3%——GEMM 只係 prefill 時間嘅 ~25%,所以唔係大頭
- P2P 排查:agent 自己試晒 ACS(setpci 清 root port offset 0x2a6)、iommu=pt、amd_iommu=off,最後
cudaDeviceCanAccessPeer仍然 False → 結論係 NVIDIA 驅動層面封晒所有 Ada GeForce 卡(4080/4080S/4090)嘅 P2P,係 SKU policy 唔係硬件問題,主板/ACS/IOMMU 全部排除 - DSpark 投機解碼實驗:deadlock 同 HiCache、block-7 喺 32G OOM、block-3 比 NEXTN 慢 → 放棄,用 checkpoint 自帶嘅 NEXTN head
- 踩坑清單(agent 試出嚟先寫返入 README 嘅):
--hicache-io-backend kernel同 hybrid Mamba 模型會 crash(sglang #24121),要行direct;chunked-prefill 加大無用;MSCCL++ allreduce TP2 唔支援
人嘅角色:審 log、拍板、出下一個指令。呢個同 forum 前人嘅做法一致——terry 講過「把地址粘贴给你的AI Agent...千万不要自己动手去配置」,我部機正正係咁。
三、軟件棧
- Docker:
lmsysorg/sglang:v0.5.18 - 模型:
Qwen3.8-27B-FP8(29GB,含 vision tower) - 啟動參數:
python3 -m sglang.launch_server \
  --model-path /models/Qwen3.8-27B-FP8 \
  --host 0.0.0.0 --port 30000 \
  --tp 2 \
  --kv-cache-dtype fp8_e4m3 \
  --context-length 262144 \
  --mem-fraction-static 0.88 \
  --max-running-requests 8 \
  --cuda-graph-max-bs 8 \
  --chunked-prefill-size 4096 \
  --page-size 64 \
  --max-mamba-cache-size 32 \
  --enable-hierarchical-cache \
  --hicache-ratio 2 \
  --hicache-io-backend direct \
  --hicache-write-policy write_through \
  --speculative-algorithm NEXTN \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --enable-metrics \
  --default-chat-template-kwargs {"reasoning_effort": "medium"}
容量拆解:GPU KV pool ~374K tokens + HiCache RAM 層 748K tokens = 總 cache ~1.12M tokens(約 4 條 262K 並行)。MTP 投機要食一部份容量(開 MTP 前係 ~2.0M),接受呢個 trade-off。
四、實測數據(2026-09-09 HKT,全部本機實跑)
Decode(實文測試,temp 0)
並發 每用戶 總吞吐 1 用戶 65.6 t/s 65.6 t/s 2 用戶 51.7 t/s 103 t/s 4 用戶 44.7 t/s 179 t/s 8 用戶(agent workload) ~27 t/s ~213 t/s scaling 曲線好順:1→4 用戶 aggregate 2.7x,8 用戶見頂 ~213 t/s(PCIe TP + KV pool 限制)。
Prefill
場景 吞吐 1× 32K ~1,930 t/s 2× 32K ~1,950 t/s 4× 32K ~1,970 t/s 1× 128K ~1,530 t/s ~2K t/s 就係呢部機 TP2 嘅硬頂——因為 NVIDIA 封咗 P2P,NCCL allreduce 全部行 host RAM。要突破就得上 NVLink 卡(A6000/H100 級)或者 community hack 4090 驅動(生產環境唔建議)。
TTFT(冷,流式首 token)
Prompt TTFT 128 tok 82ms 2K 1.65s 4K 1.78s 8K 3.63s 16K 7.44s 32K 16.35s 64K 39.0s HiCache 效果(呢部機最大嘅賣點)
場景 冷 命中 加速 50K prompt 重覆 27.8s 2.4s 11.6x 32K prompt 重覆 16.35s 0.51s 32x 5.6K prefix 重覆 2.88s 0.32s(cached_tokens=5568) 8.9x 生產 log 實證(17 分鐘 agent 真實 workload 窗口,09:32→09:50 HKT):
- 146 個 prefill batch 入面 62 個命中 cache(42%)
- 单次最大命中 86,528 tokens(長 conversation 直接搬返 VRAM)
- 519 個 batch 只有 14 個 queue>0——8 路並發都基本唔塞
- NEXTN accept rate 平均 0.61,decode gen throughput 中位 70.9 t/s、p90 103 t/s、peak 295 t/s
五、同 forum 前人 post 對照
- #1559(W7800 48G SGLang 投產實測):佢單卡 bf16 KV,cache hit 65-77%、decode 中位 57-60 t/s。我雙卡 FP8 KV 單流 65-70 t/s、並發高一檔(TP2 分攤 VRAM 先頂得住 256K)。佢嗰邊 gfx1100 靠社區 fork,我呢邊 Ada 卡官方 SGLang 直接就行,但 P2P 被封係 Ada 獨有嘅痛
- #1542 / #1532(terry / flyer666 7900XTX 雙卡):佢哋話雙卡 TP + HiCache 係補齊 7900XTX 最後短板,4 併發 200 t/s。我部機 4 併發 179 t/s(實文 temp 0)、8 併發 213 t/s,數量級對得上。flyer666 講 HiCache 要夠內存,我 125G 配 748K token RAM pool,agent 長 session 唔會觸頂
- #1559 嘅 MTP 結論:佢 gfx1100 上 MTP-3 係最大加分項;我呢度 NEXTN(checkpoint 自帶 head)accept rate 0.61,decode 中位拉上 70 t/s,peak 295——方向一致,投機解碼喺 27B 呢個級別都係值得開
六、幾句心得
- 4080 SUPER 32G × 2 跑 27B FP8 + 256K ctx + HiCache 係啱啱好嘅甜點:64G VRAM 再大 10% 都冇咁舒服,29G 模型 + KV pool 374K + MTP 全部塞得入
- Ada 卡做 TP2 嘅真瓶頸係 P2P 被封:GEMM tune 完 +3% 都冇用,allreduce 行 RAM 就係 ~2K t/s 天花板。呢個要買卡之前就知道
- HiCache write_through + direct backend 係 agent 場景正解:prefix 重覆率極高,直接寫穿命中最穩;kernel backend 有 crash bug 唔好碰
- agent 代操係真嘅可行:GLM Zcode + GLM 5.3 做晒 kernel tuning、P2P 排查、參數 A/B,人只需要審 log 拍板。成個調校過程 log 完整可溯源,agent 仲會自己寫 README 記坑——呢個就係本地機 + 本地 agent + 本地模型嘅完整閉環
- 256K context 代價:GPU 各食 ~92%,冇得再調 mem-fraction;MTP 食走一部份 cache 容量(1.12M vs 2.0M tokens)
完整 benchmark log、SGLang server log、tuning script、README 全部留底,想對數據嘅朋友留言,我貼 log 片段。
用呢部機做本地 coding agent(多 subagent 並行)實戰:4-6 併發流暢、單流打字速度肉眼可接受、長 conversation 第二次開始 TTFT 全部 <1s。洋垃圾 X99 平台 + 兩張 32G 卡 + 本地 agent 全程調校,呢個價位我目前見到性價比最高嘅 256K 長上下文投產方案,歡迎各位大佬補充同指正。
-
[求助] 想在ITX机箱里塞双卡7900 XTX,组成AI小钢炮带出国,可行吗?@Quanta-Magic 用 API 不好嗎, 我覺得小model 用做牛馬還行. 但大的還是買API 方便