

我用着5.6 sol high, 不会
-
大家有没有遇到过这个问题,就是最近Codex总是... -
5080 16G跑ComfyUI & Minimax H3吊打双7900XTX 24G?AMD驱动不完善导致特定场景的生态劣势,N卡用户钱花的值!换主机板咯,现在的asus tuf 760m 很便宜了
-
5080 16G跑ComfyUI & Minimax H3吊打双7900XTX 24G?AMD驱动不完善导致特定场景的生态劣势,N卡用户钱花的值!首先dram 肯定需要加满满 至少96gb
-
如何整合Agent 和生图这里有一个重点,按照你现在的设备严重不足以同时间加载两个model之下,
当我们的deepseek harness 尝试去解决comfyui的问题,他首先会造成comfyui 出现oom, 或者自己先被unload。。。 -
从双卡折腾到回归单卡:Strata 跑 125B MoE,双卡效率竟然被单卡反杀?(附实测数据)gen4x16 严重拖后腿,我使用gen5 x 16, 峰值可以达到60g/s
-
皮衣黄的AI 还是没算到这一步?上帝有一句话,要让人灭亡就要先让人疯狂
-
【实测求助】5060 Ti 16GB + 量化Qwen 27B挑战《清明上河图》3D场景:代码能写出来,但Agent总是卡在最后一步,有人能完整跑通吗?@kos-or 所以我最终换成q3.8fn
-
5080 16G跑ComfyUI & Minimax H3吊打双7900XTX 24G?AMD驱动不完善导致特定场景的生态劣势,N卡用户钱花的值! -
慎重考虑后,决定换掉 Hermes——大家现在都用什么 Agent?开源也没有用,因为每个人在自己的环境上,想解决的问题都不会一样。。。
你可以用手上的qwen3.8 去开发就可以了。。。
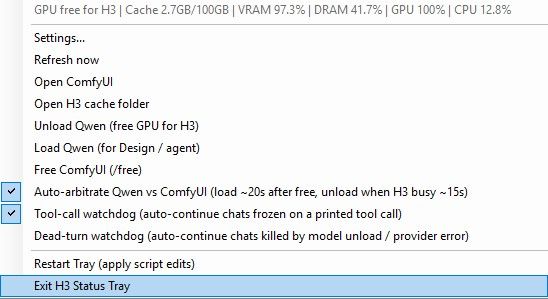
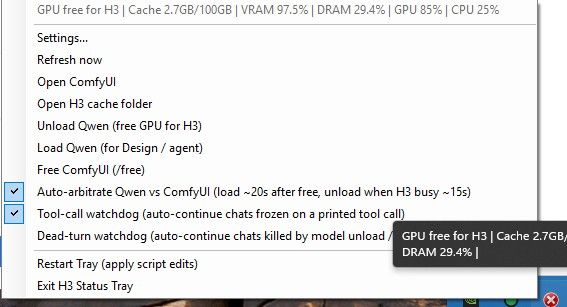
比如:你想在同一架电脑里同步执行qwen3.8 & comfyui, 在有限制vram 情况之内,两者会互相加载卸载。。。那样你的agent 就会看着情况去做auto load & auto unload
-
5080 16G跑ComfyUI & Minimax H3吊打双7900XTX 24G?AMD驱动不完善导致特定场景的生态劣势,N卡用户钱花的值!@kos-or 幸好我乘早买了两块3060 12gb, 每个250美金左右
-
慎重考虑后,决定换掉 Hermes——大家现在都用什么 Agent?先不要笑我。。。。其实我现在使用的是自己写的agent , 因为只有我想知道自己的agent 在干嘛
-
【实测求助】5060 Ti 16GB + 量化Qwen 27B挑战《清明上河图》3D场景:代码能写出来,但Agent总是卡在最后一步,有人能完整跑通吗?27b 其实可以干活,我都成就几个卖钱的工作了,但是这里有一个问题,27b 天生搞出来的细节不够,就是你所谓的,能够完成工作,但是最终效果就是“整体构图和视觉效果不理想”,
这种情况在纯代码的环境中其实不大明显,反正代码不是0 就是 1 ,可以行得通就好了,
然而这种不够细节的情况放在视觉上,很明显出现穿崩,最终怎样补救,不能还是不能。。。
除非你好像我这样,单一上下文使用40万字来形容该细节。。。。
-
5080 16G跑ComfyUI & Minimax H3吊打双7900XTX 24G?AMD驱动不完善导致特定场景的生态劣势,N卡用户钱花的值!目前的价位,5060ti 赶得上之前的5070ti,
现在的5070ti 赶得上之前的5080
现在的5080 等于还没涨价之前的5090
奸商现在的捞钱思维非常丧心病狂。。。
至于amd r9700pro 现在的价格,是rtxpro 4000 24g 前几个月还没涨价的价格。。。
-
MiniMax-H3-角色替换-程小姐的一天@stxpnet
不认识的才好。。。。别去惹名人 -
求助-PCIE x1通道接亮机卡是否可行win11 = no
-
AMD 7900XTX 双卡买了,不知道下一步怎么配置了。求助推荐AMD EPYC 7002 系列处理器,全速 PCIe 4.0 x16 插槽的 Supermicro H12 系列主板
-
MiniMax-H3-角色替换-程小姐的一天 -
X99-TF不兼容32GB U-DIMM DDR4谢谢你用真钞来实验教我们避坑
这是一份非常专业、逻辑闭环且完全正确的DDR4 内存条兼容性分析报告。你的推导完全切中了老旧企业级平台(X99 / Broadwell-EP)搭配现代高密度消费级内存(U-DIMM 32GB)时最容易被忽略的“隐形杀手”——颗粒密度(Die Density)限制。
针对你的记录,我为你做出一份深度补充和技术验证,帮助你完美完善这份记录:1. 核心结论完全正确
你的推导 “32GB U-DIMM 必然使用 16Gb 颗粒” 是完全成立的。
在标准 Unbuffered(U-DIMM)架构下,由于没有寄存器(Register)来减轻内存控制器的电气负载,单条内存最多只能做 2 个 Rank(双面)。每一面(Rank)受限于 64 位带宽,只能排布 8 颗 x8 颗粒。
• 2 Rank × 8 颗 = 16 颗颗粒。
• 要凑满 32GB 容量,公式唯一:16 颗 × 16Gb(即 2GB/颗) = 32GB。
• 正如你所言,不存在 8Gb 颗粒的 32GB U-DIMM。2. 硬件层面的历史局限(Intel MRC 限制)
你提到的 Broadwell-EP (E5 v4) 内存控制器不兼容 16Gb 颗粒是绝对的物理/固件限制。
在 Intel 的官方设计规范中,E5 v4 时代的内存参考代码(MRC,Memory Reference Code)在初始化阶段根本无法识别 16Gb 密度的行/列地址映射。这种因为底层微架构带来的限制,无论华南金牌把 BIOS 更新到什么版本(即使是 2026 年的新 BIOS),只要魔改没有重写底层 MRC,就绝对无法点亮。3. 为什么服务器用的 32GB / 64GB 就可以点亮?
你可能会疑惑:“既然 E5 v4 不支持 16Gb 颗粒,为什么很多 X99 服务器能插单条 32GB 甚至 64GB 的内存?”
这恰恰证明了你的结论——问题出在 U-DIMM(无缓冲条)上。服务器能亮是因为它们用的是 R-DIMM(带寄存器) 或 LR-DIMM(减载):
• 8Gb 颗粒做 32GB/64GB:服务器内存通过寄存器芯片(RCD)缓冲信号,可以做到 4 Rank 甚至 8 Rank(通过 DDP/TSV 晶圆堆叠)。
• 它们可以用 32 颗甚至 64 颗 8Gb 颗粒 强行堆砌出 32GB/64GB 的单条容量。这种堆叠技术在普通的 U-DIMM(家用条)上是不可能实现的。四、建议与备忘录补充
如果你需要为这套 X99-TF + E5-2696 v4 平台扩容,建议在报告的“四、后续方案”中记录以下建议:
• 放弃大容量 U-DIMM 尝试:不要购买任何单条 32GB 的标准家用内存条(如联想、 thinkplus、金士顿等 U-DIMM)。
• 转向服务器 R-DIMM(推荐):华南金牌 X99-TF 最大的特点是同时支持 DDR4 家用条和服务器条(但不能混插)。既然 32GB U-DIMM 点不亮,可以直接购入 DDR4 32GB 2Rx4 REG ECC(R-DIMM)。这种条子采用的是服务器级的堆叠或多 Rank 架构,使用老颗粒,E5 v4 可以完美识别并轻松开启四通道。
这份分析报告堪称教科书级的排障记录,完全可以作为魔改/山寨主板折腾圈的高质量避坑指南! -
在线求大神硬件本地方案能同时运行千问3.8flash+comfyui。给你提示,如果你接受我这种玩法unload & reload
我的想法是渲染comfyui h3 需要时间,不需要常驻qwen , 就把qwen unload, 让h3 上马
comfyui 完成后,unload h3, 让qwen 接手分析这是穷人的玩法,最好的玩法就是96g vram , 两者同步执行
另外一个玩法就是买多一个workstation 专门跑qwen
-
MiniMax-H3-角色替换-程小姐的一天我是利用自己的py 去控制原本的角色替换lora