
@鍾子揚 我已经做了移植,还没做优化单卡
-
不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了! -
Strata v0.1.30 支援 RX7900 XTX / AI Pro R9700 跑 Qwen3.8-Flash-NEXT单流 24 题 1 路 并发总吞吐 预填 专家命中率 暗号 R9700 单卡(Strata,我们移植) 64.3 70.6 66~82(不涨) 1575 t/s 98~99.8% 4/4 XTX(Strata) 63.9 68.4 62~77 757 88~97% 4/4 -
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4我找时间测一下W4A4
-
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4@David-Chen 移植,Debug,打补丁,W4A8(解码 / 验证)+ W4A16(大批预填),你可以让ai试着帮你,我现在在测试SGLang+EXL3跑qwen3.8-flash-next
-
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4参考分块 W4 内核,W4A8,RDNA 卡间通信,用 AI 一点一点调,移植,打补丁,搞了 1 个星期的测试,累的跟狗一样。等我测试完下一个,给大家公开一版。
-
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4@williamlouis 是的,我现在用的双卡转到 SGLang 上,打了 N 多补丁,现在跑单路 116t/s,基本满足 8-10 人并发使用
-
讯景 (XFX)R9700 再次上涨2000元。 -
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘 -
从 4700 拍胸口画饼到 3000 挂闲鱼收尸:一张 RX 7900 XTX 经历 SMU 暴毙与代理商“代保换新”的取证复盘 -
AMD 官方 MXFP4与社区 INT4,两个量化版本深度评测@Magic629 Radiance 用独立草稿模型 Qwen3.8-27B-DFlash2-FP8(--speculative-config 里显式指定),根本不碰 checkpoint 内置的 MTP 头,你可以试试。
项 值 基座 Qwen3.8-27B-Quark-AWQ-MXFP4(served name Qwen3.8-27B-MXFP4) 草稿模型 Qwen3.8-27B-DFlash2-FP8(dflash 投机解码,7 token) 镜像 / 卡 magiccodingman/vllm-radiance:1.0.15,单卡 R9700#2(ROCR_VISIBLE_DEVICES=1,TP=1) 上下文 / 并发 --max-model-len 190000,--max-num-seqs 4 KV --kv-cache-dtype fp8,--kv-cache-memory-bytes 8912057139(8.3GB 写死),utilization 0.98 预填块 --max-num-batched-tokens 4096(09-16 OOM 事故后从 8192 压下来的修复值) 注意力 R4D + prefix caching + --no-async-scheduling,PIECEWISE cudagraph 采样默认 temperature 0.7 / top_p 0.95 / top_k 20 / repetition_penalty 1.05(修编程死循环) 能力开关 --language-model-only(不能看图,带图请求自动转 node2);tools qwen3_xml、reasoning qwen3 附加 ROCR 1.18 rel-7.2 预加载(修 CPU 空转 84°C);radiance-watchdog.timer 每分钟探活; -
台灣技嘉 AI Pro R9700 32GB 自取, 手速要快 -
台灣技嘉 AI Pro R9700 32GB 自取, 手速要快 -
【倡议】3090 单/双/多卡联合评测帖(2026年9-10月)—— benchmark与配置/模型对比AMD 显卡飘过
-
三张卡的烦恼,怎么合理分配 -
Minimax H3 小试牛刀 (7900XTX) -
Minimax H3 小试牛刀 (7900XTX)
,我用R9700做的,时间:864×480 · 15.1秒/段 · 4步 · 用时 3分52秒 -
三张卡的烦恼,怎么合理分配今天把3张卡都用上,牺牲了一个网口,目标是comfyui和qwen,多人使用,如何分配比较合理,大家帮我看看
卡 能力 實際協商 R9700 03:00.0Gen5 x16 Gen5 x16 R9700 07:00.0Gen5 x16 Gen5 x16 7900 XTX 0c:00.0Gen4 x16 Gen4 x16 三張全部滿速滿寬,沒有任何降速或降寬度。
用的主板是B850-creator wifi neo -
RDNA3 ComfyUI OOM 血泪排障:VAE 显存 17GB → 1.7GB 的修复之旅这个值得借鉴,学习了
-
AMD Radeon AI PRO R9700 H3 1080P -
AMD Radeon AI PRO R9700 H3 1080P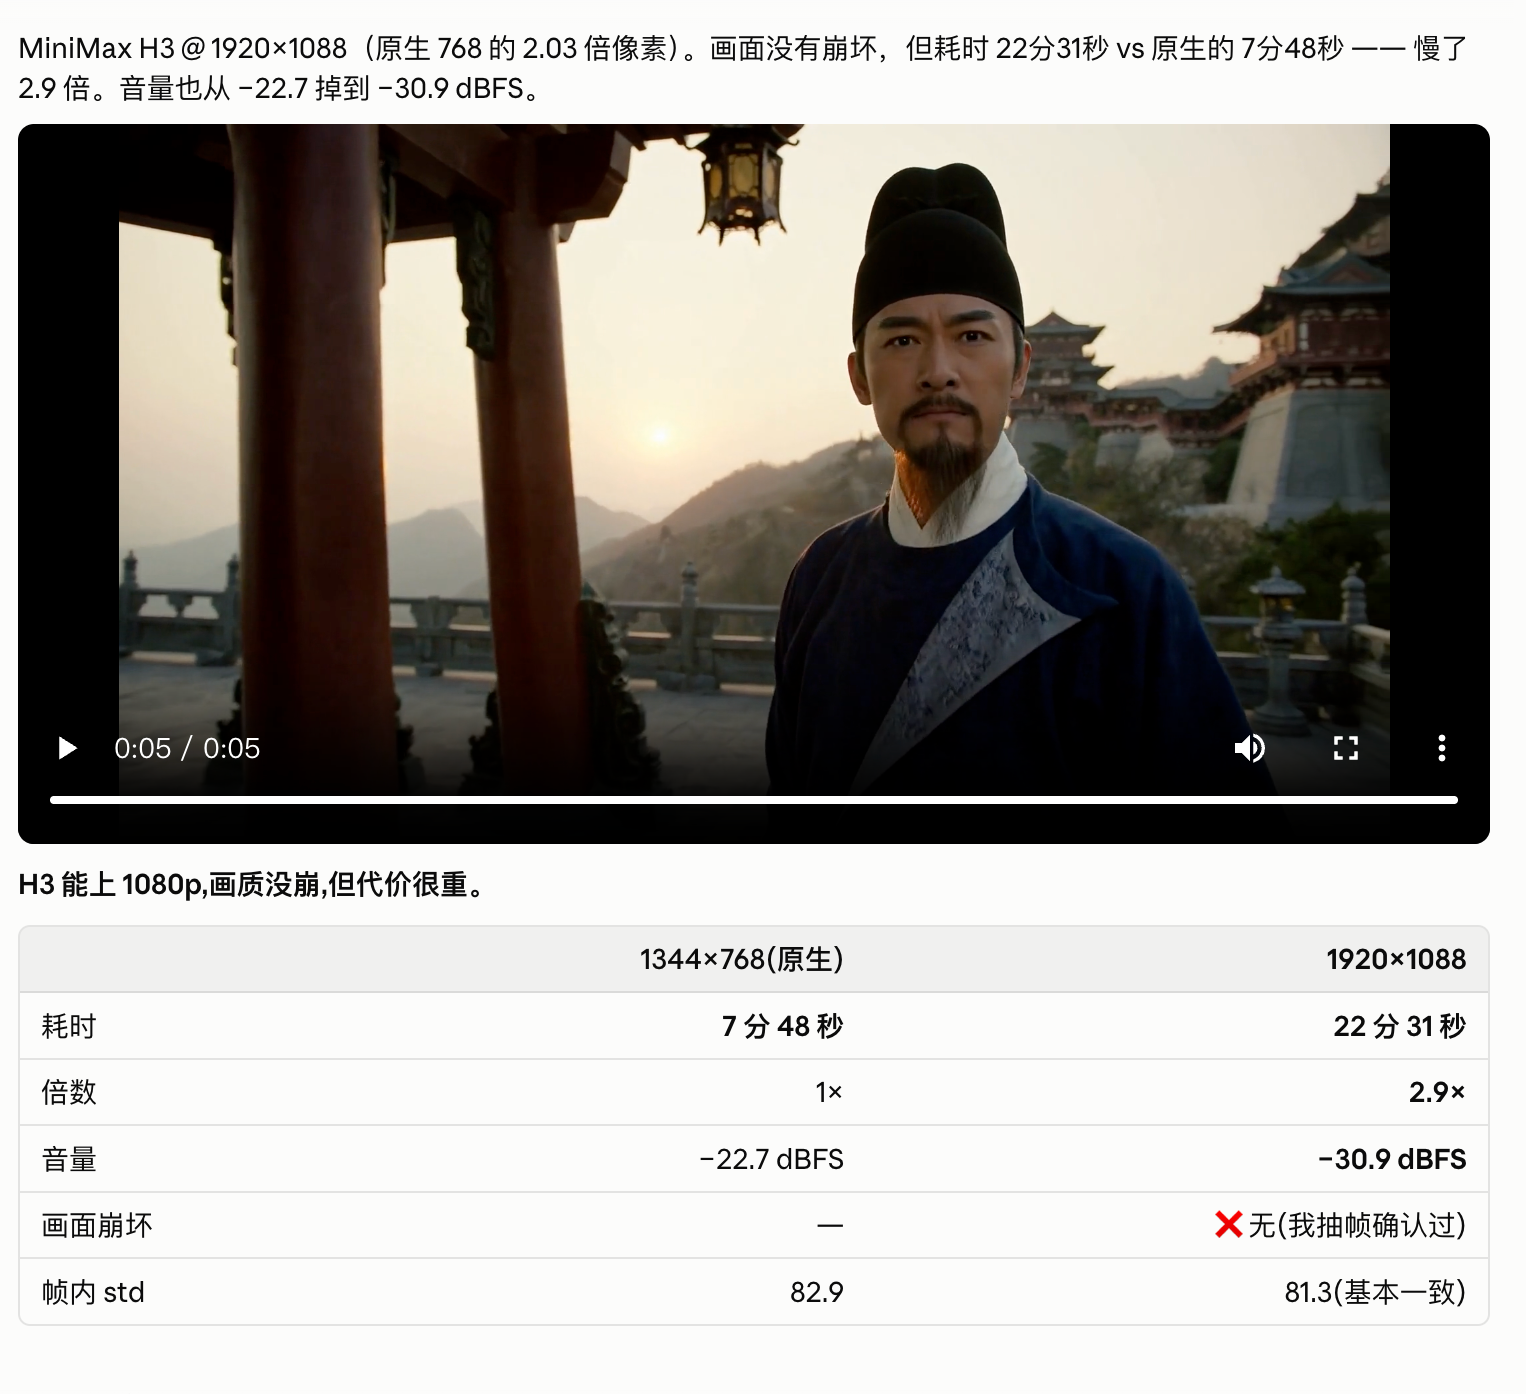
本来想发视频,发不来,先来个截图