
做了中医某体系的rag系统,资料切片,1400+文件耗时8小时+。还要+rerank。多维度交叉。结果:不同模型辅助诊断出来的方子不一样。重新诊断也不一定一样。现在开始新的概念:rag+agent,但是无论怎么折腾。还是不如人脑。但是如果用来总结概述。对比。这些意义还是有的。原因很简单,喂的料做出了的rag系统和使用者的语言语义不一致。还有大模型要出唯一答案,最好机械一点。temp=0, Prompt 里强制约束。现在来说,rag系统只能用来学习。不能结合llm用来搞生产。 最起码严谨的工作领域还不能作为生产力。
-
RAG LoRA和大模型的关系以及应用场景 -
升级后单卡7900xtx,strata 可以跑 100token/s 了!!我是让Hermes抄作业。调优出答案是tier自适应后提速了。但我的是pcie3,达不到楼主的100t/s。
改完并验证,保留这个配置(效果明显,不改回去)。 改动:--adapt-every 0 → --adapt-every 2,加 --adapt-async 1(原配置备份在 strata-orca-iq3_xxs.json.bak-pre-adapt) 指标 改前 改后 解码显存命中率 35.8% 93.6-94.3% 2K/1024 解码 41.0 tok/s 66.5-67.7 tok/s (+63%) 9.3K 提示词解码 42.2 58.0 冷 / 78.4 热 端到端(含预填充) 37.0 66-67 预填充 15K 1476.5 1632.9 (没受损,略快) 常驻/显存余量 30.18 GiB / 902 MiB 不变 引擎自己确认自适应已生效: adaptive swaps exchange them with the GPU cache (no file reads) adaptive tier asynchronous (--adapt-async 1): up to 96 swaps per round, a round every 2 windows asynchronous adaptive tier: 430 rounds, 17745 experts swapped in, ~101 ms per round 每轮 ~100ms 跑在解码窗口之间,所以预填充没被拖累。热得很快 —— 重启后第一个请求就 90.6%,不需要预热跑一堆。 还差的一段 他要 100+,我们在 67。剩下的差距不在 ROCm、也不在这个开关了,主要是:他的 pack 量化档(专家更小 → 24G 装得下更多,我们只有 8780/24576 = 35.7% 能进显存)、以及 host 内存带宽/CPU。我们的 24G 卡在这套 IQ3_S 上,67 tok/s 已经接近这套配置的天花板。 一个可选小改进 加 --expert-profile-save,把学到的路由频次存下来,以后重启直接从你的真实流量热启动(现在重启 后会退回仓库自带那个不匹配的 profile,第一请求 60.6 而不是 67)。要的话我加上,需要再重启一次。 顺带:这个坑和官方文档推荐的 7900 XTX 配置(写的是 --adapt-every 0)是冲突的 —— 已写进 strata skill,附带诊断方法(看 decode expert cache hit rate 是否≈显存槽位占比)。 -
# Fable 5.1 27万字提示词(侧面部分验证老特说Claude“走邪路”) -
升级后单卡7900xtx,strata 可以跑 100token/s 了!!@farmer-node对,停了27B,切换到IQ3_S了。暂时够用了。
-
交作业:X99 CD3+E5 2666 +128G DDR3 + AMD AI Pro 9700,成功安装ubuntu,等不及跟大家分享。后续再更新下手了x99 tf版+e5 2696 v4+ddr4 64G+7900xtx,这两天有时间就要装机和安装系统了。和楼主的显卡不一样。不知道安装时是否要开启Re-Size BAR Support 。其他使用7900xtx装机的彦祖能不能说说情况。因为没有备亮机卡。怕踩坑。谢谢啦:)
-
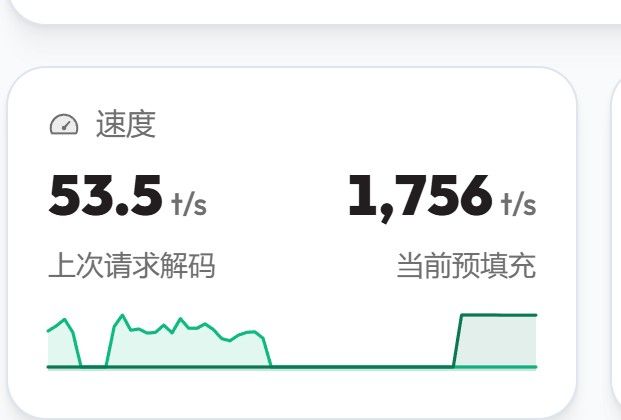
X99(BD3) DDR3 四通道 + 7900 XTX 24G:Strata 跑 Qwen3.8-Flash-Next 無審查版 IQ3_XXS 實測(131K 上下文 / int8 KV / MTP / 解碼 65–75 tok/s)看了大佬们说 IQ3_XXS是聊天玩具后,换成了 IQ3_S,设备:E52696V4,X99 TF,64G DDR4,7900xtx,decode:40+到70+,40+为主。目测最高pp 1700+。
-
cpu买多了有留的必要吗?我的E5 2696 v4,ddr4 64g,7900xtx,跑comfyui加载时间长的离谱。cpu单核性能太差是问题。跑ComfyUI与Hermes双E5没意义。
-
2026.10.01 記憶體(內存)市場持續發瘋? 過去兩個月漲了70%, 大家覺得記憶體價格何時泡沫化?有需要的垃圾佬们不会因为一根涨价几百块而不买。但会因为翻几倍而不爽。库存还是很充足。供过于求。超过心理价价。就抑制消费冲动。直接当观众。没有买家,何来卖家。我不是酸哦。这一波ai高空飞行。民生低空经济。
