跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Kk HhK

Kk Hh

@Kk Hh
取消关注 关注
关于
帖子
41
主题
3
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 那位大神给解释一下MIMIMAXH3 的 SOL Engine
    Kk HhK Kk Hh
    AI音视频画图 minimax dgxspark comfyui

    我现在这个DGX SPARK 上装的 ComfyUI,然后第三方的 DGX SPARK MIMIMAXH3 ,AI说这个使用 了SOL Engine 技术,但是不是官方 SOL Engine 引擎,这是意思?


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @soop-ladios 我就统计我实际使用的多个小时的平均速度,这样真实点,反正不到20tok/s。 我觉得这个版本挺好的一台DGX SPARK 能跑 质量不错,TOKEN 够长,这个速度我能忍了,基本上可用。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    图片.jpeg
    图片.jpeg
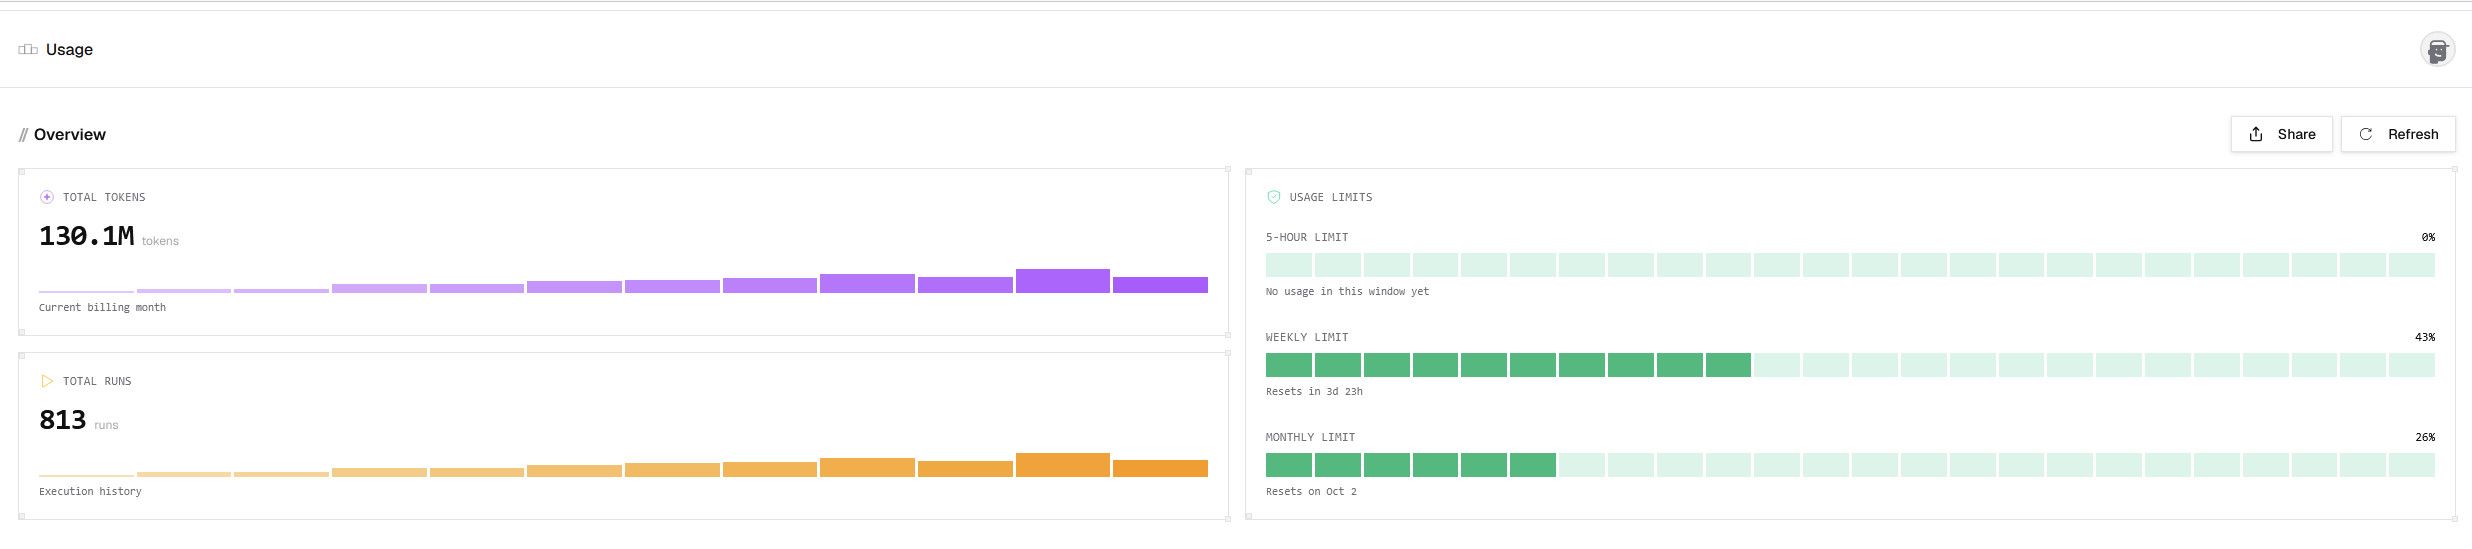
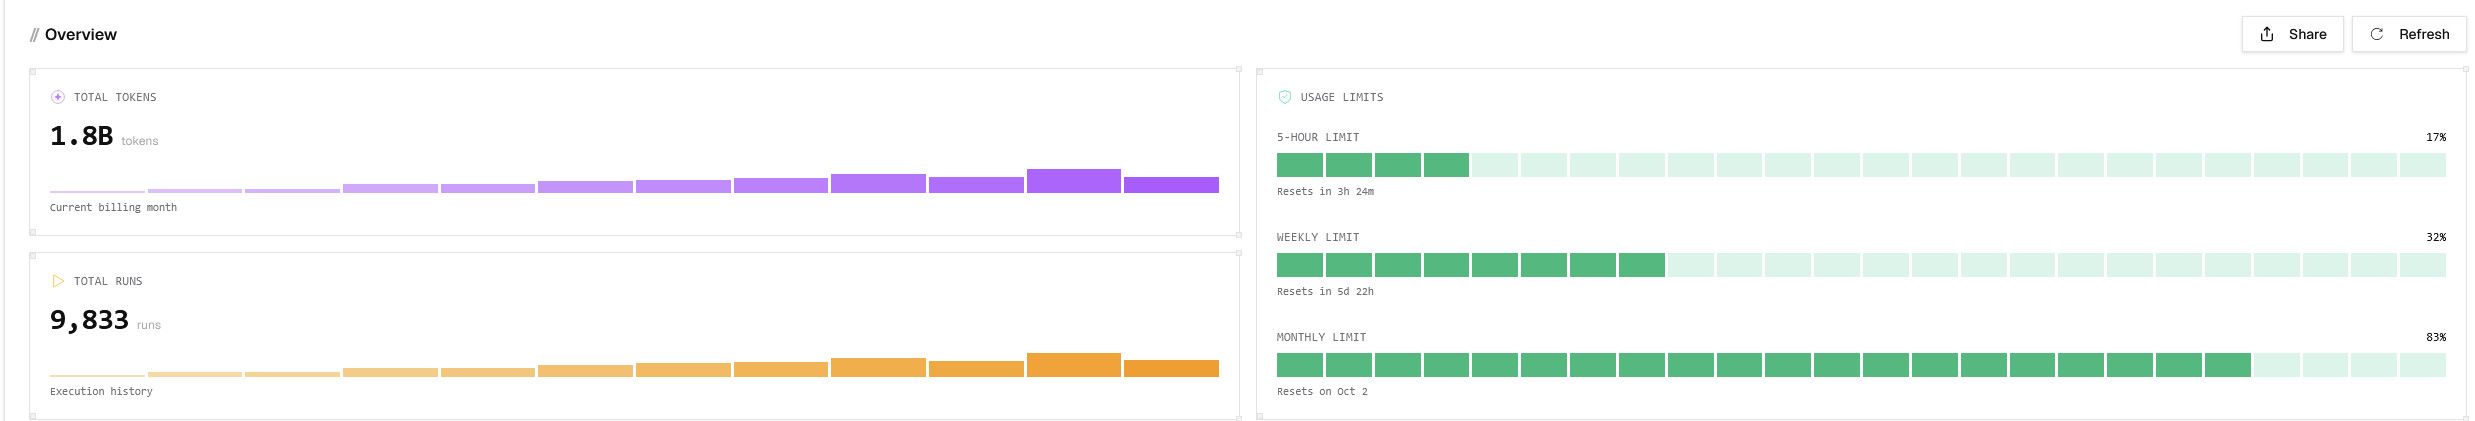
    我是到了周五就开始TOKEN焦虑了


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @johnnybegood 大家的需求不一样,快对于我来说没有大TOKEN的准更重要。有些问题我必须要在本地模型处理,其他的都是走云。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @Xiaote 最近 8 小时(9/8 00:39 → 08:39 UTC):

    生成速度:19.02 tok/s(活跃期)
    指标 数值
    活跃期真实速度 19.02 tok/s(中位 18.4,区间 0~36)
    墙钟均速(占空比 87%) 16.53 tok/s
    8 小时产出 476,178 tokens(59.5k/h)
    活跃时长 7.0 / 8.0 小时(87%)
    接受率 66.7%
    k=4 净收益 +17.1%
    逐位接受率 0.84 → 0.71 → 0.62 → 0.54
    观察
    任务这 8 小时几乎没停(87% 占空比,之前 24 小时才 34%),模型基本满负荷在跑
    19.0 tok/s 是 k=4 上线以来最长时段的最佳均值,k=4 收益也稳定爬到 +17.1%
    对照之前 24 小时的 18.93——近期速度略有提升,说明内容长期处于“顺”状态,MTP 增益持续兑现
    当前状态就是这套配置的稳态最佳:约 19 tok/s、每小时 6 万 token 产能。 基本上就是速度咱们也AI对一下AI 把。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    我顶一下我自己的帖子吧,这个架构在单台DGX SPARK 上很好用,速度现在又升级了一些,还能换模型镜像


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @terry 就是思考内容太多了,但是做各种任务的检查和审计是比较核实的,他检查过一般没有什么遗漏。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @johnnybegood 说:

    @Kk-Hh 单台多少钱买的?

    31000 人民币 JD买的,我是买的技嘉1T的版本,就以现在实际使用的情况来看,这机器也跑不了什么特别大的模型,买个1T版本就够了。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    说实话一个小机能跑成这样,你还要什么自行车啊。再买一台DGX SPARK 做双TP的QWEN 3.8 FLASH NEXT 或者 DPV4 FLASH 我觉得有点不太值,或者再买三台DGX SPARK 做4TP的 GLM 5.3 FLASH 更不值,我宁可多买点云端服务的额度。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @MSHAVL 说:

    @kk-hh 目前掛在我ai max395上切VRAM/RAM 64/64gb下用IQ4xs搭配dsh也非常舒服,@41k上下文深度下pp200多/tg 20-30token/s開192k上下文,目前已經利用goal然後入睡前讓它大型專案開發,隔天早上起來收割。是確定可以做出前沿模型那種質量。但速度響應上就不苛求了。目前pp可能還有提升的空間應該會更好。

    替代文字

    我这个这个其实在300K TOKEN长度的时候 开MTP-3 其实生成速度也是 20-30token/s,TOKEN 最大长度在单台DGX SPARK可以设置成 1M 但是基于对这些FLASH 模型在云端使用的经验他们前500K还行,后500K 质量太差,所以我在本机就只开了500K的TOKEN长度。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    @terry 说:

    重要的不是别人说如何,是你自己感觉如何,你觉得好就行。

    在我的工作环境下,实测这个版本的qwen 3.8 next flash 要好于我的qwen3.8 27b q8,就是速度对于dgx spark来说还是提不上来。所以呢着急我就用线上的glm 5.3 flash 和qwen 3.8 flash ,不着急的晚上挂机的,就让这个本地跑。https://commandcode.ai 这个站有个好处中外的模型都有了,特别复杂的就花钱用贵的模型。我这个本地机器就是平时做挂机基础执行环节的。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

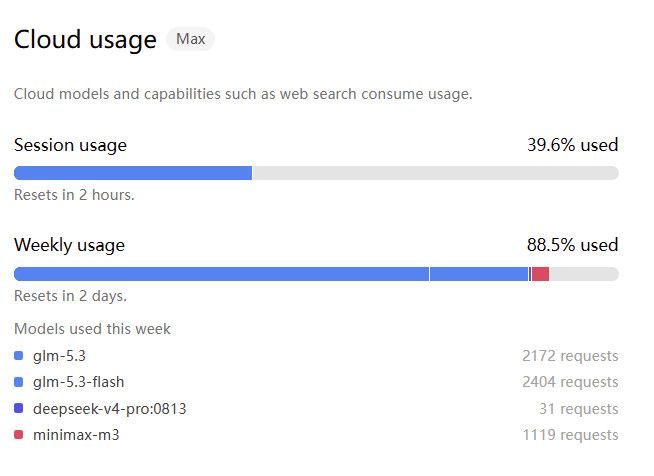
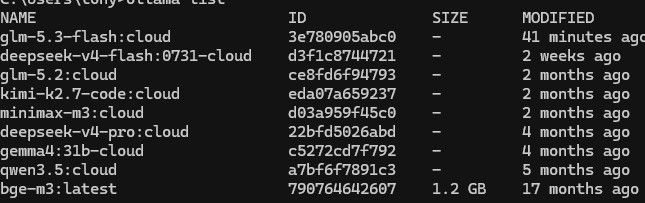
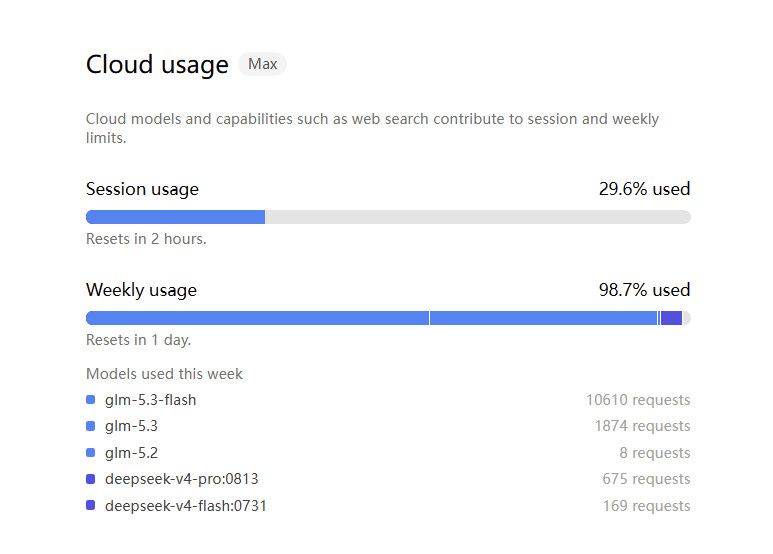
    再啰嗦一句云端服务ollama cloud 的MAX现在好像不让新用户买了,原则还是ollama cloud 最便宜,其次https://commandcode.ai 也能用就是贵点
    7ba35d4d-0c60-4e1e-8f38-af0824beaef0-image.jpeg
    8420bb50-061d-4505-954e-97e8d495eb86-image.jpeg


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    82b93ccd-07d8-44f3-b285-459fecc82adf-image.jpeg
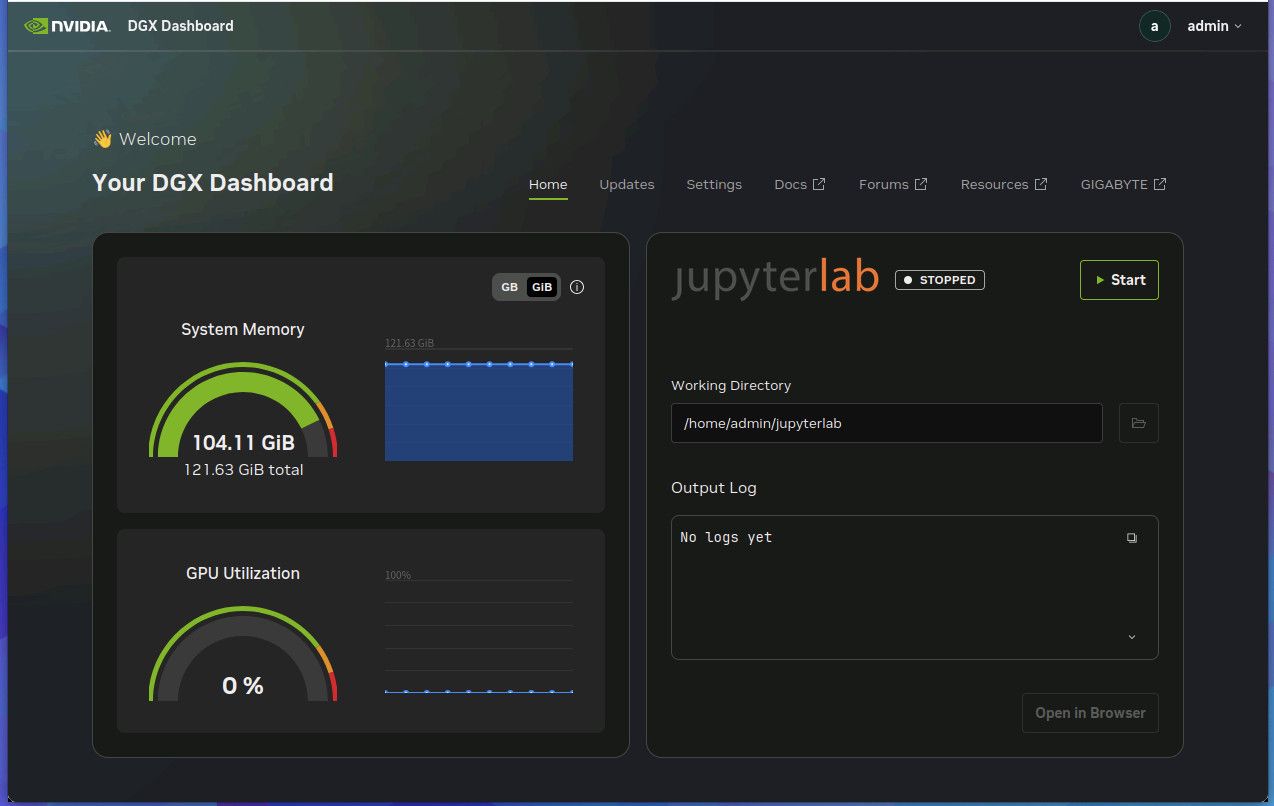
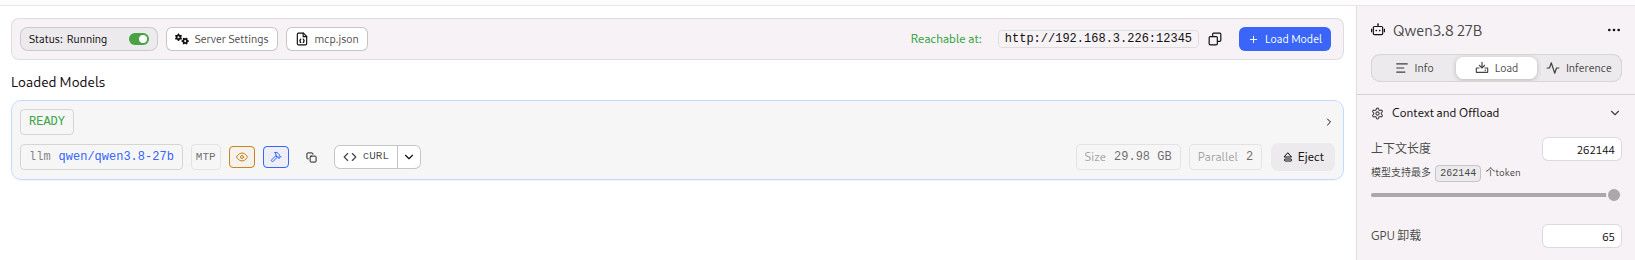
    在我的配置下实际显存占用情况


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

    a2a9d319-e106-4a48-8add-6b35ae0db2f3-image.jpeg
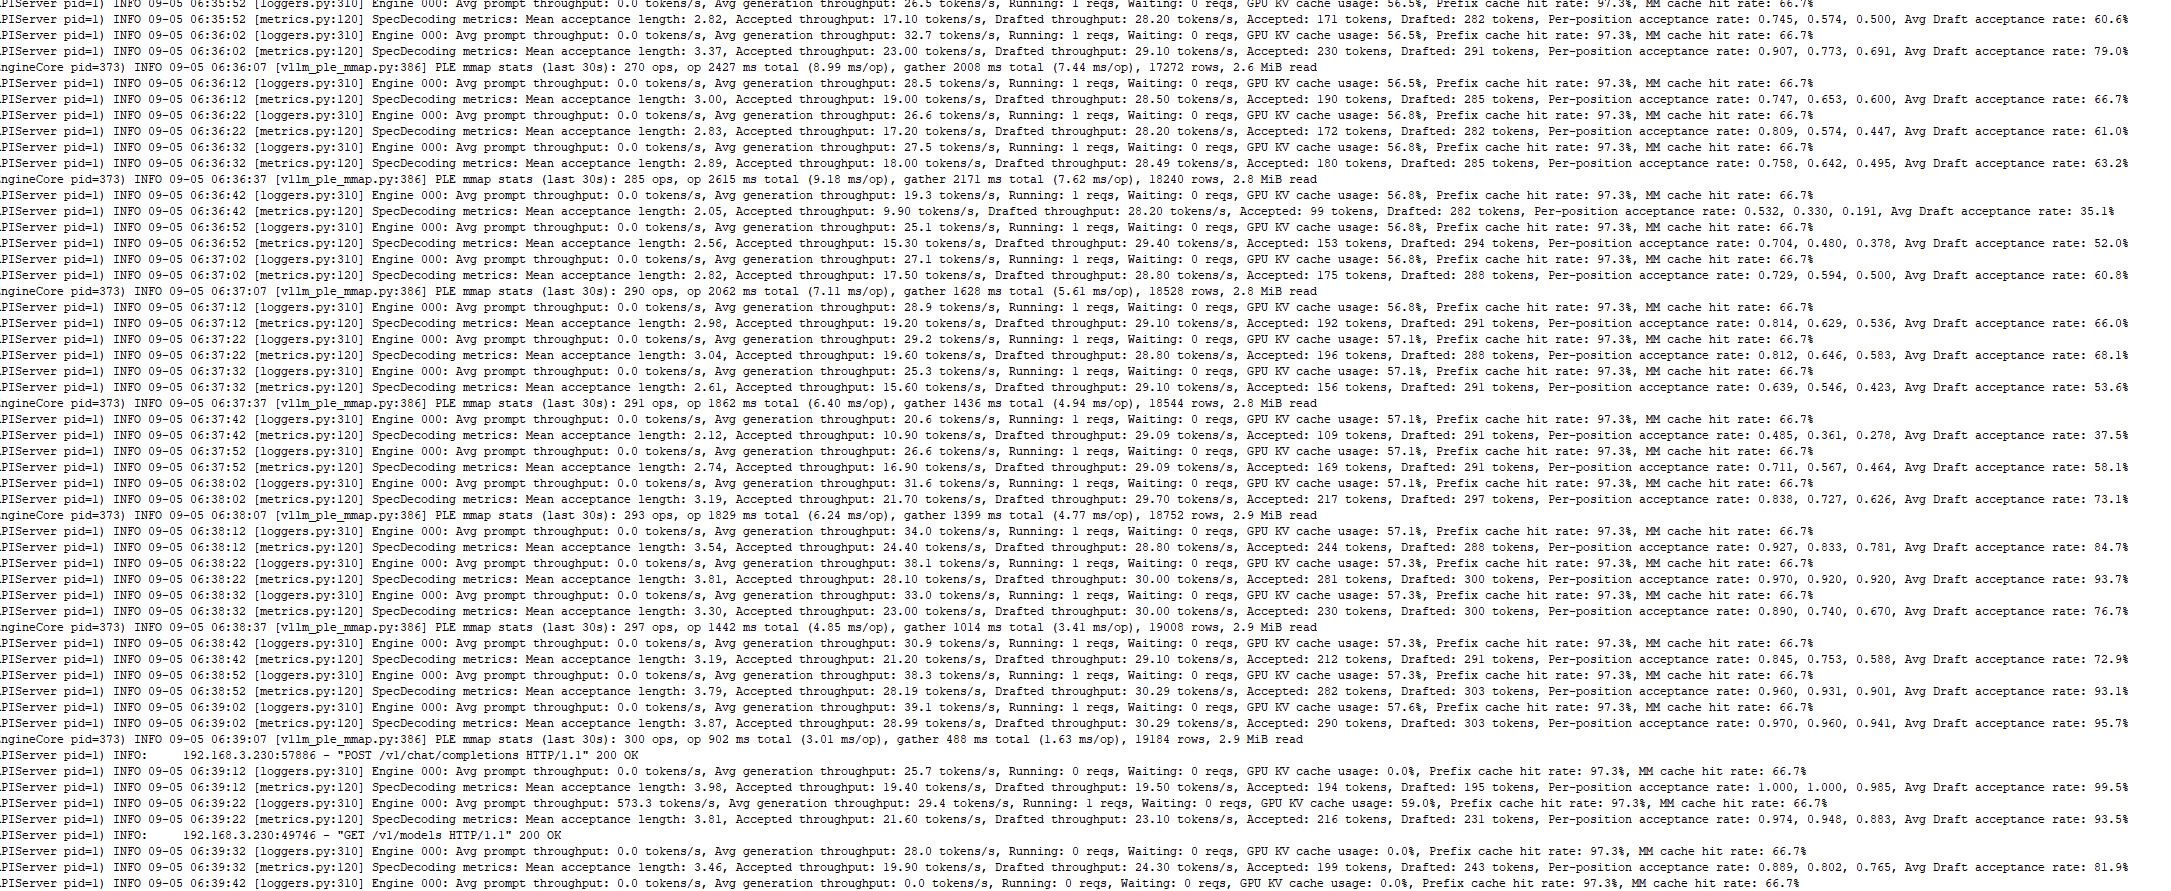
    我补一张图这个是300-400K 的时候TOKEN生成速度。


  • 单台DGX 装qwen 3.8 next flash 500K token 长度,能用
    Kk HhK Kk Hh
    LLM讨论区 dgxspark qwen-flash

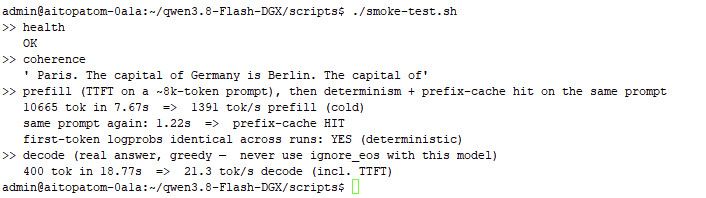
    https://github.com/blazux/qwen3.8-Flash-DGX

    就这个质量还行把,接近Q8,一部分放显存里 一部分放硬盘上.token 长度500K。
    我修正了一些参数 YARN=1 CTX=500000 GPU_MEM=0.80 MTP=3 SEQS=2
    速度见下图,
    356943c0-92c1-46ae-ab48-d833c0364231-image.jpeg


  • 27B 本地模型能做严肃逆向吗?Qwen3.8 硬刚最近很火的 Ox Alpha(牛来)匿名模型实测
    Kk HhK Kk Hh
    LLM讨论区 qwen-27b 本地模型

    27ad914a-794e-48ba-9caf-2c329fc2fce9-image.jpeg
    32a2208c-e0e3-45f1-b7eb-eb82dd3792f0-image.jpeg 如果人不参与的话只能做静态逆向,动态逆向这两个也都是傻子,如果一个问题每次只可能有30%的可能性复现,那么你就烧TOKEN 把,最后的结论AI 给的就是不可行。


  • 有大神在本地部署 GLM 5.2 吗?
    Kk HhK Kk Hh
    LLM讨论区 本地模型 glm

    我觉得还是用云端的挺好 ,GLM5.2的确很强 安全阈值又低 我最近用的也比较疯,OLLAMA CLOUD 应该基本上是最便宜的了。


  • 有大神在本地部署 GLM 5.2 吗?
    Kk HhK Kk Hh
    LLM讨论区 本地模型 glm

    5× DGX Spark+NVFP4+MTP 1M TOEKN ,我猜可能能跑,20W人民币。2x DGX STATION Q8 1M TOKEN 我猜也能跑 20W 美金。 其他服务器版本估计都是天价了。


  • 有大神在本地部署 GLM 5.2 吗?
    Kk HhK Kk Hh
    LLM讨论区 本地模型 glm

    GLM 5.2 是很强,想本地部署,但是成本太高了


  • 我最近对AI有点顿悟了,发现架构能力和判断能力是最重要的!
    Kk HhK Kk Hh
    Mark专区 编程 rag 微调

    嘿嘿,我也是科班出身的,我是计科的 ,20年+的工作经历。很早我们就自己干了,我一直是叛军架构师,现在AI的发展,我只能说大公司要难受了。架构能力和判断能力自己自定义吧,适合你的就是最好的,包括模型选型,这个没法交流。根据我的了解,很多事情从公司层面根本没法想到现在的发展是相当的迅速,从展示层一直穿到汇编层,慢慢看后面更精彩。我们还是有底线的,至少守法,但是没底线的也有很多大神,肯定会越来越热闹了。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组