跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Leon YL

Leon Y

@Leon Y
体面乡绅
取消关注 关注
关于
帖子
49
主题
3
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 【成果分享】52万级古泉图像分类:基于度量学习与 Hermes Agent 自愈机制的训练实践
    Leon YL Leon Y
    LLM讨论区 hermes

    注意:此文由AI辅助生成,不喜勿喷

    各位同好大家好,今天在这里和大家分享一个我最近利用Hermes Agent构建、自建算力训练的计算机视觉多级分类项目。

    古泉(目前主要是明清钱币)的图像识别在实际应用中一直是一个强类间干扰、细粒度的分类难点。目前,项目已跑通 52 万张有效图像 的全流程训练,整体架构设计、特征对齐与 Hermes Agent 托管的自动化闭环已平稳落地。

    一、 训练管线设计:多阶段递进式微调

    为了最大化特征提取效率,整个微调管线分为三个递进的阶段:

    1. Phase 1: 朝代分类(热身阶段)
    2. Phase 2: 钱局分类(高维空间度量学习)
    3. Phase 3: 细粒度版别判别

    二、 无监督自训练闭环

    面对 50 万级别的数据量,人肉标注成本极其高昂。我设计了一套无监督自迭代标注流程,让图片数据集在无人工介入的状态下实现“滚雪球”式增长:
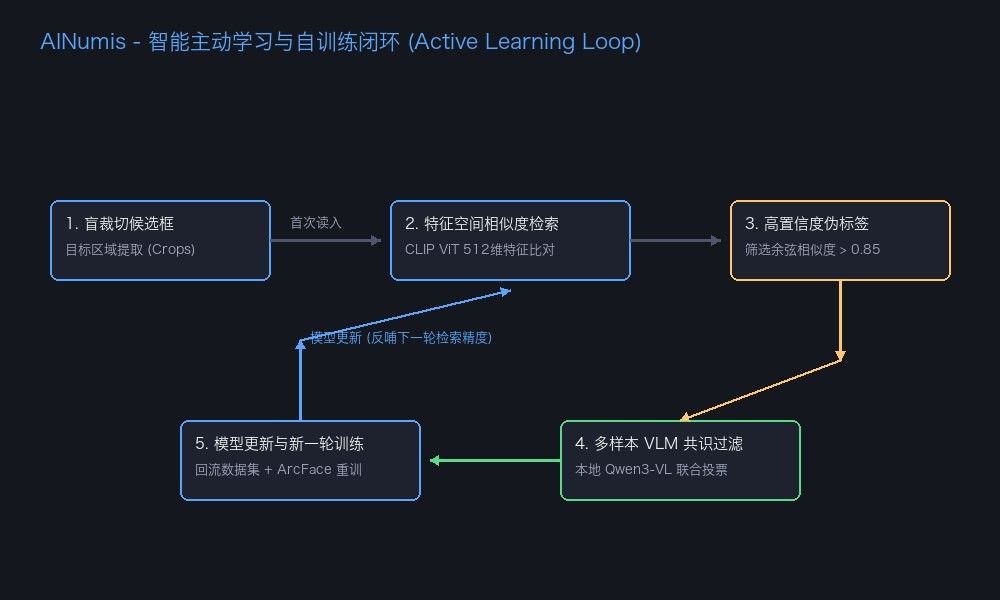
    ea3ee56a-4423-4862-bebc-c50eecad8639-image.jpeg
    该闭环利用阶段性产出的特征向量在海量无标记数据中进行高置信度判定。对于处于决策边界的模糊样本,则由后台调用本地大语言模型服务进行多维度的共识投票清洗,洗净标签噪声后自动并入数据集进行重训,实现模型精度的自我进化。


    三、 基于 Hermes Agent 的自愈式自动化运维

    在大规模模型微调中,工程中断与硬件异常是最耗费精力的部分。为此,引入了 Hermes Agent 作为整个训练管线的托管核心,实现了完全自愈的运行模式:

    • 异常秒级诊断与热修补:
      在训练初期,由于处理多达 41 万张图的 DataLoader 占用了极高的子进程状态,导致系统物理内存剧烈抖动并触发 Exit Code 137(SIGKILL)内存溢出崩溃。
      Hermes Agent 监测到异常后,自动通过 SSH 登录服务器,秒级诊断了主机的内存水位线与 Docker 共享内存上限,不仅直接远程热修补了训练代码,将读取方式降噪重构,更通过重构 Docker 参数将 --shm-size 动态扩容。
    • 双 GPU 负载与温度实时调控:
      在 Phase 2 多卡并行启动后,Hermes Agent 会通过定时任务自动收集两张 RTX 3090 的温度、显存占用以及并行负载。
    • 完全自主的故障自愈机制:
      Hermes Agent 具备高度的自主调试与运行主导权。一旦watch dog在日志中嗅探到任何 DDP(分布式并行)死锁、显卡掉线或 PyTorch 运行时错误,Hermes Agent 的推理大脑会瞬间激活,自主进行日志追溯、修改远程代码并重启 Docker 容器,并在恢复健康后向我们的终端推送完整的排查与修复报告。

    Hermes Agent 作为基础架构中的“AI 运维与算法助理”,彻底将我从冗长、繁琐的“盯日志改 Bug”中解放出来,让研究精力可以 100% 聚焦在算法架构本身。

    欢迎对图像检索、细粒度度量学习以及 AI Agent 托管训练方向感兴趣的同行多提宝贵意见,共同探讨!

    硬件信息可以参考我之前的帖子 https://lcz.me/topic/466/双3090-ollama-加载-q8-视觉模型瞬间断电重启-求老哥们把脉


  • 🎬 34GB 满血 MiniMax H3 双 3090 跑通(DisTorch2 显存拆分)
    Leon YL Leon Y
    AI音视频画图 minimax 视频生成 rtx3090 多卡部署

    之前 2×RTX 3090(24GB×2)只能跑 21GB pruned unet,34GB 满血 int8_convrot 一直放不下。这次用 ComfyUI-MultiGPU(pollockjj)的 UNETLoaderDisTorch2MultiGPU 把 34GB 模型拆到双卡,跑通了 15s 624×1104 视频+音频(362 帧@24fps,ref2va + lipfix 管线)。

    🟢 方案

    • 计算卡 GPU0 + 权重仓库 GPU1(DisTorch2 VRAM split,不是 compute split)
    • 分配:cuda:0 10GB / cuda:1 19GB / CPU 2.7GB 兜底
    • GPU1 只存权重不计算,层经 NVLink 流式传到 GPU0,GPU0 满载

    🔧 踩过的坑

    1. ComfyUI 0.30 默认 DynamicVRAM(aimdo)模式会让 DisTorch2 补丁失效 → 必须加 --disable-dynamic-vram 启动
    2. 0.30 核心删了 Triple/QuadrupleCLIPLoader → 节点报 KeyError,要给 init.py 打 guard 补丁
    3. GPU1 不能塞满 24GB(加载时 36MB 都挤不下,直接 OOM)→ 留 4-5GB 余量
    4. virtual_vram_gb 路径按展开尺寸算会误判(61.7GB vs 实际 31.7GB int8)→ 改用 expert_mode_allocations 字节分配才准

    ⚠️ 注意:这是能力提升(跑得动 34GB 满血),不是速度提升——计算全在 GPU0。长上下文段 ~190s/步,全程约 20 分钟(含机械盘加载)。

  • 【成果分享】52万级古泉图像分类:基于度量学习与 Hermes Agent 自愈机制的训练实践
    Leon YL Leon Y
    LLM讨论区 hermes

    一开始冷启动是用数据库的人工标注的拓片图和照片,然后用海量的盲切图片计算相似度,相似度极高的话,就完成标签传播。高置信的图片会作为下一轮的golden samples。


  • 假如我自己组建Qwen3.8 27b 服务器, 160 tps
    Leon YL Leon Y
    LLM讨论区 qwen-27b 服务器

    我们南洋。。。也没那么落后吧


  • 二张3090通过nvlink跑大模型,有人尝试过吗?
    Leon YL Leon Y
    AI硬件 rtx3090 多卡部署

    我正好也是双 3090 NVLink,看我的帖子:https://lcz.me/topic/466/双3090-ollama-加载-q8-视觉模型瞬间断电重启-求老哥们把脉

    说下真实体验,我这边双 3090+NVLink,功率墙锁定260W,跑qwen3.8-27b-fp8模型

    • llama.cpp:27 tok/s
    • SGLang:~39 tok/s
    • vLLM:~10 tok/s

  • 7900XTX + llama.cpp Qwen3.6 27B TurboQuant + MTP 测试结果分享
    Leon YL Leon Y
    LLM讨论区 7900xtx mtp llama.cpp

    @David-Zhang 说:

    @Leon-Y ollama是个玩具不是工具,换llama.cpp或者 vllm

    果然上了llama.cpp,速度起飞,显卡风扇狂吼。


  • 双3090 + Ollama 加载 Q8 视觉模型瞬间断电重启,求老哥们把脉
    Leon YL Leon Y
    AI硬件 rtx3090

    asked hermes to learn https://github.com/noonghunna/club-3090 and changed PSU to Corsair RM1000X
    it works now!!!


  • 🎬 34GB 满血 MiniMax H3 双 3090 跑通(DisTorch2 显存拆分)
    Leon YL Leon Y
    AI音视频画图 minimax 视频生成 rtx3090 多卡部署

    @terry 说:

    这也非常牛逼了,你的意思是都能加载到显存中?

    是拆到两张 3090 的显存里(24GB×2 = 48GB 总量),还有一小部分放 CPU 内存兜底:

    GPU0(计算卡): 10GB 权重 + 激活,峰值 ~22.7GB,满载计算
    GPU1(仓库卡): 19GB 权重,只存不计算,峰值 ~19.8GB
    CPU 兜底: ~2.7GB

    关键点:

    • 34GB 模型实际权重 31.7GB(int8 压缩),显存装得下 29GB,剩下的 2.7GB 放内存
    • GPU1 不参与计算,只当"权重仓库",层通过 NVLink 流式传到 GPU0 算
    • 所以本质是"显存拆分 + NVLink 搬运",不是"单卡全装"也不是"双卡并行计算"
    • GPU0 util 100% 满载,GPU1 util 0% 纯存储

  • 【成果分享】52万级古泉图像分类:基于度量学习与 Hermes Agent 自愈机制的训练实践
    Leon YL Leon Y
    LLM讨论区 hermes

    目前只关心钱币年号,铸钱局和版别
    品相, 锈迹, 戳记, 磨损, 包浆, 边齿这些都是噪音,用算法suppress掉


  • 10-12 提示词挑战 巴黎铁塔
    Leon YL Leon Y
    随便聊聊 rtx3090 strata 编程

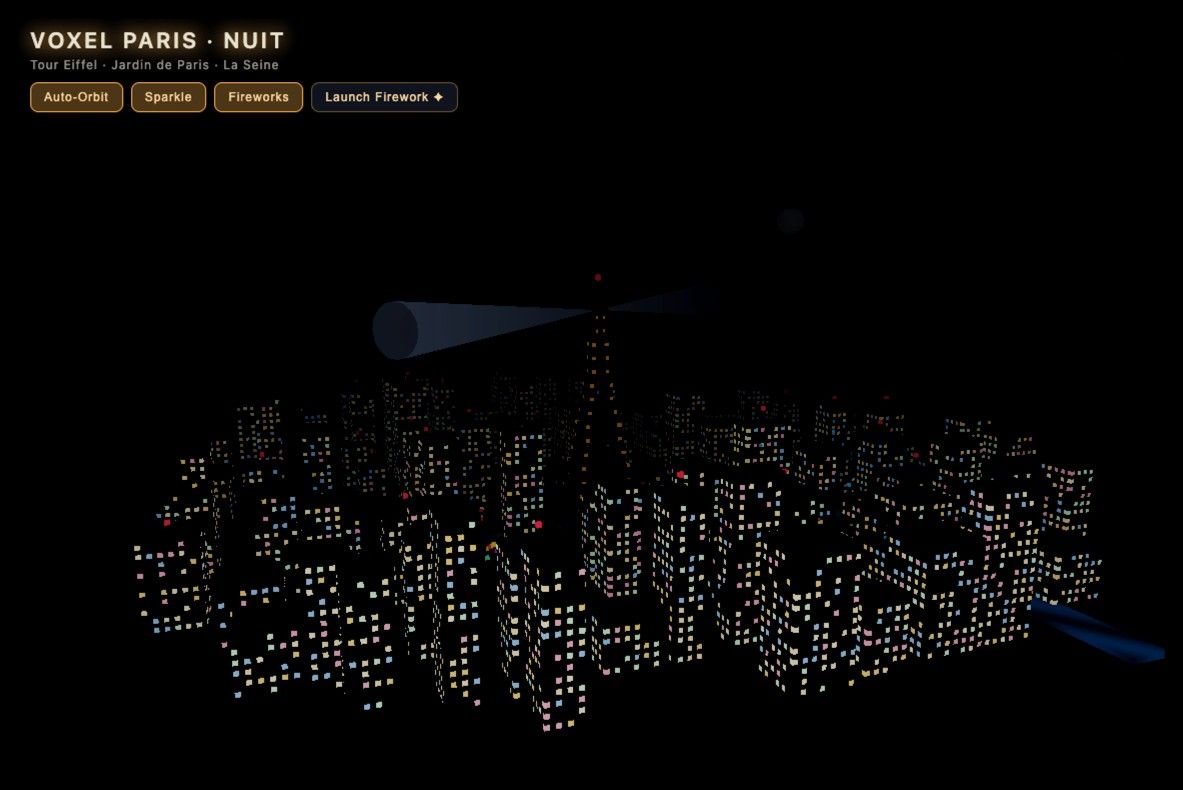
    DSH+qwen3.8-flash-next-iq3_s(Strata v0.1.42)
    image.jpeg

    voxel-paris-night.html


  • 大热的3090风冷改造方案 大幅降温稳定AI大脑
    Leon YL Leon Y
    AI硬件 rtx3090

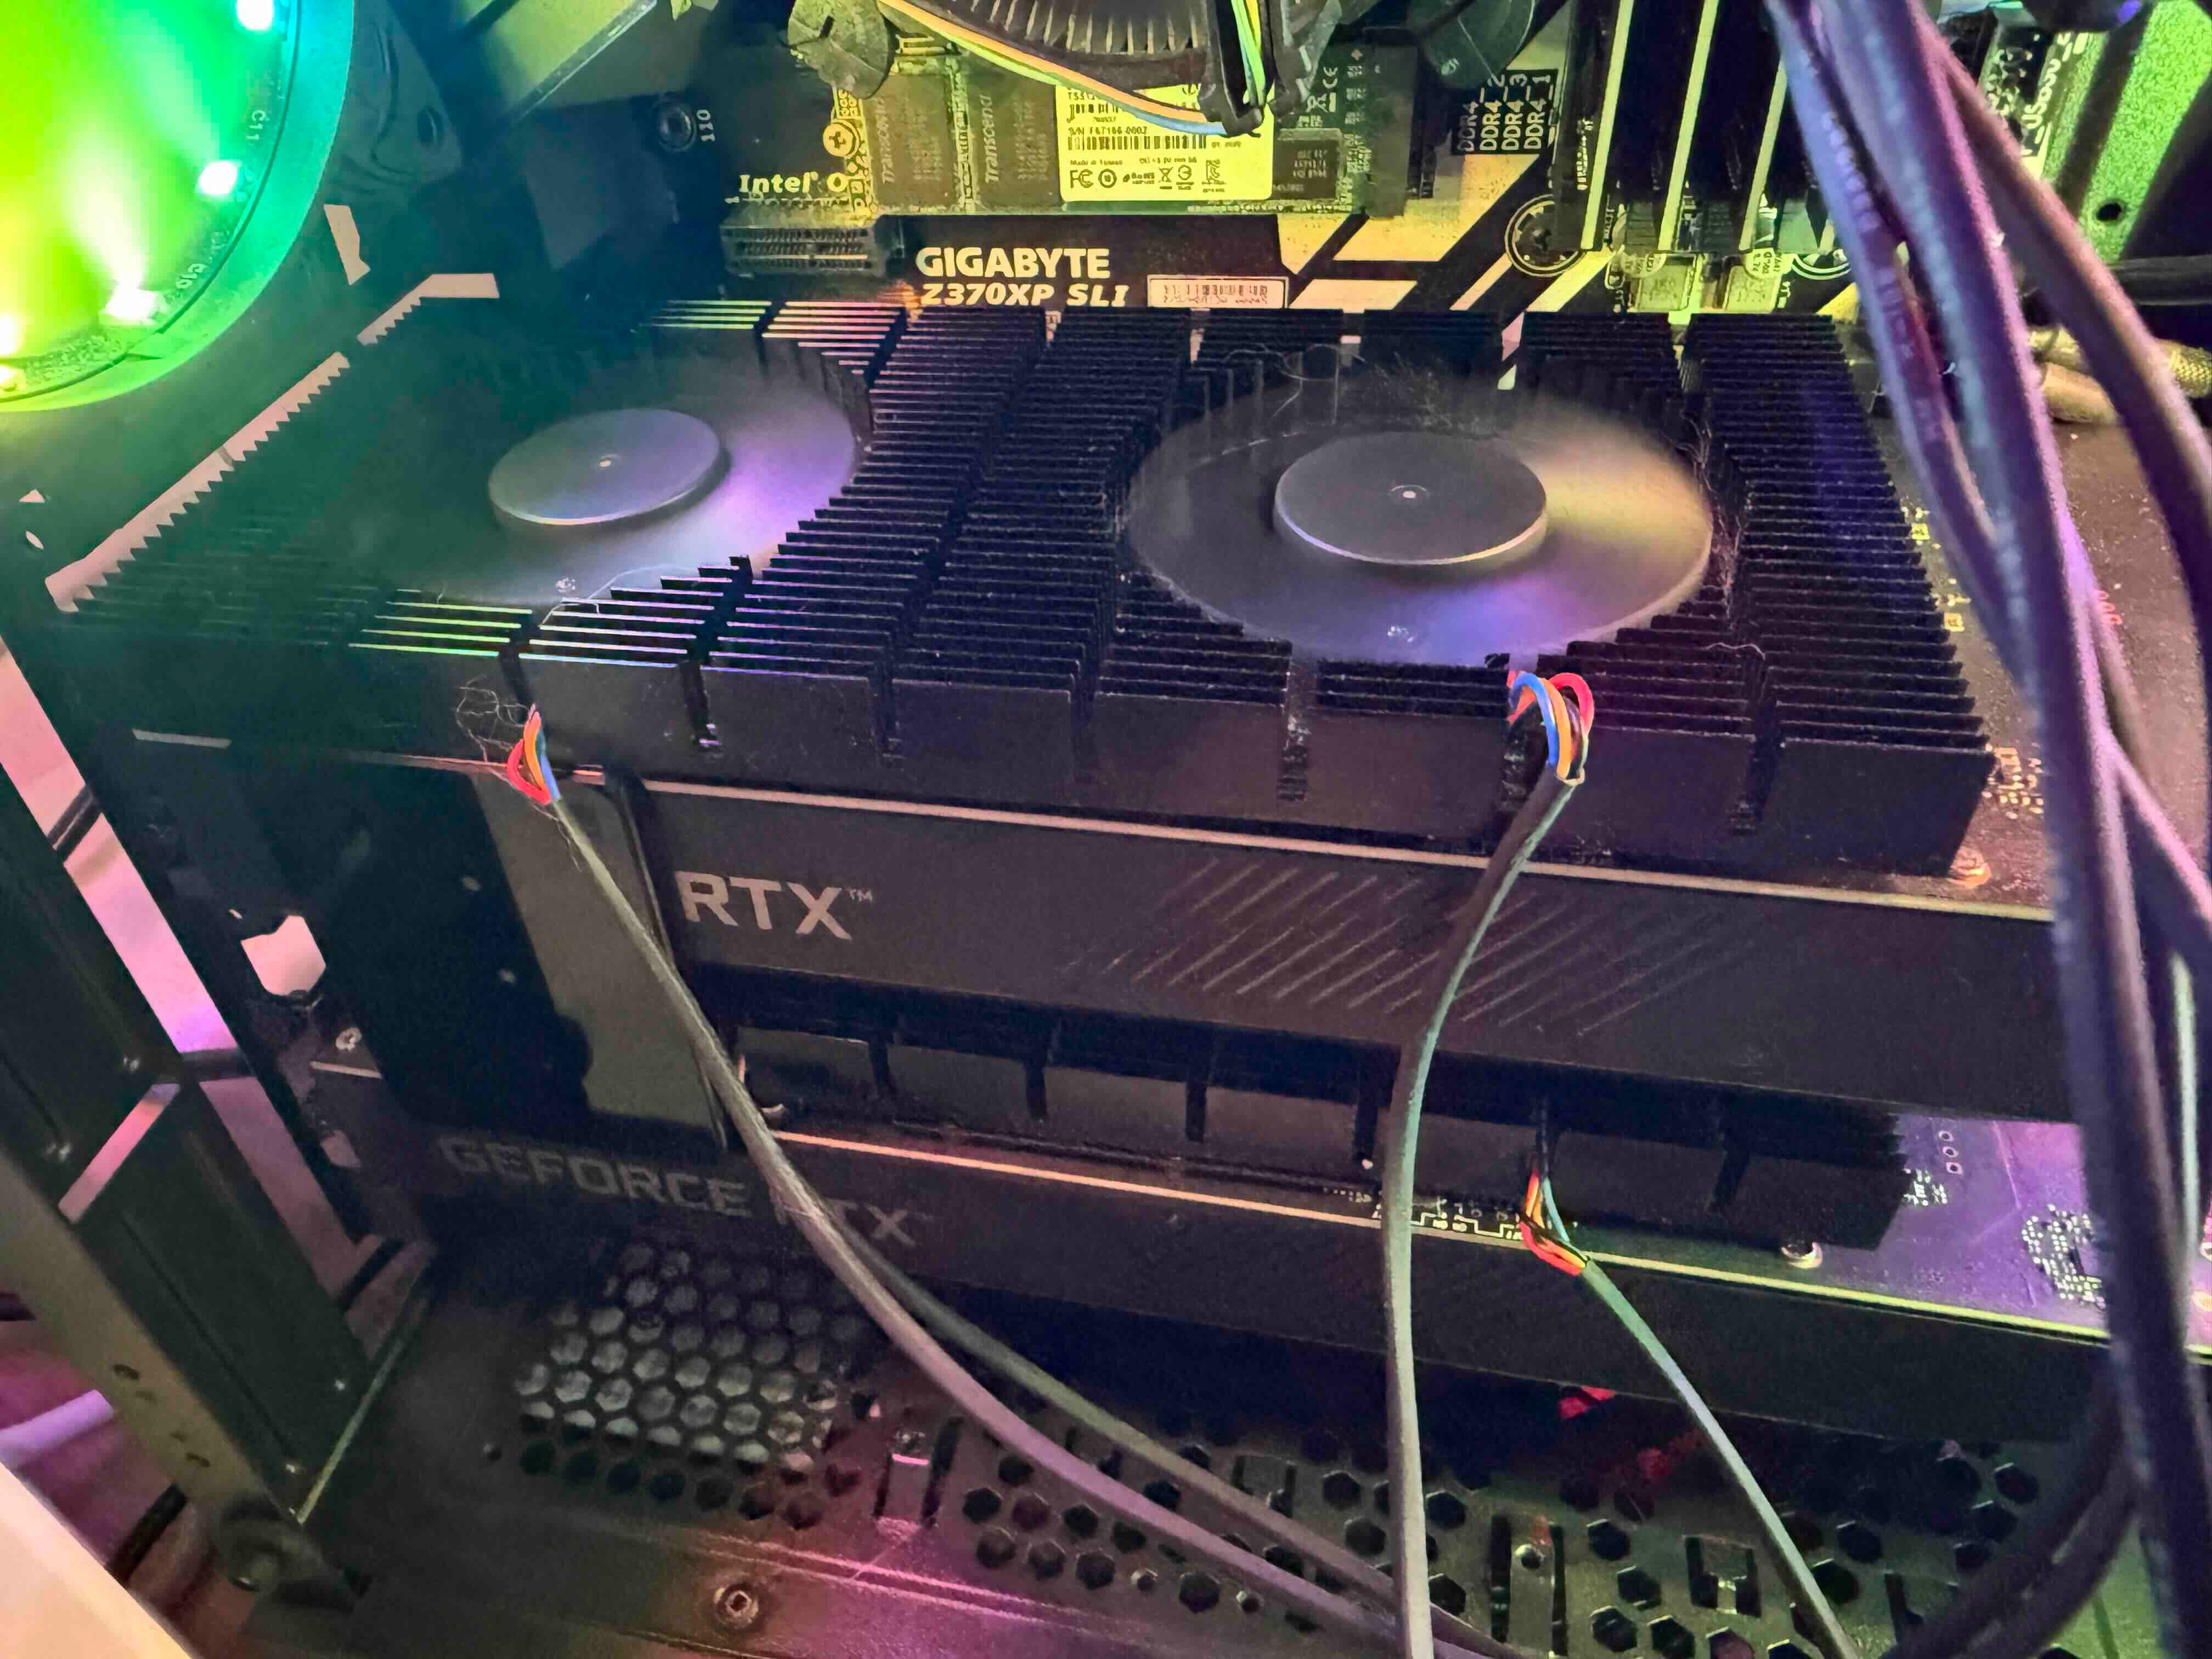
    我的风冷方案
    IMG_7432.jpeg


  • 大热的3090风冷改造方案 大幅降温稳定AI大脑
    Leon YL Leon Y
    AI硬件 rtx3090

    @applejuice 说:

    3 slot

    对,3 slot

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组