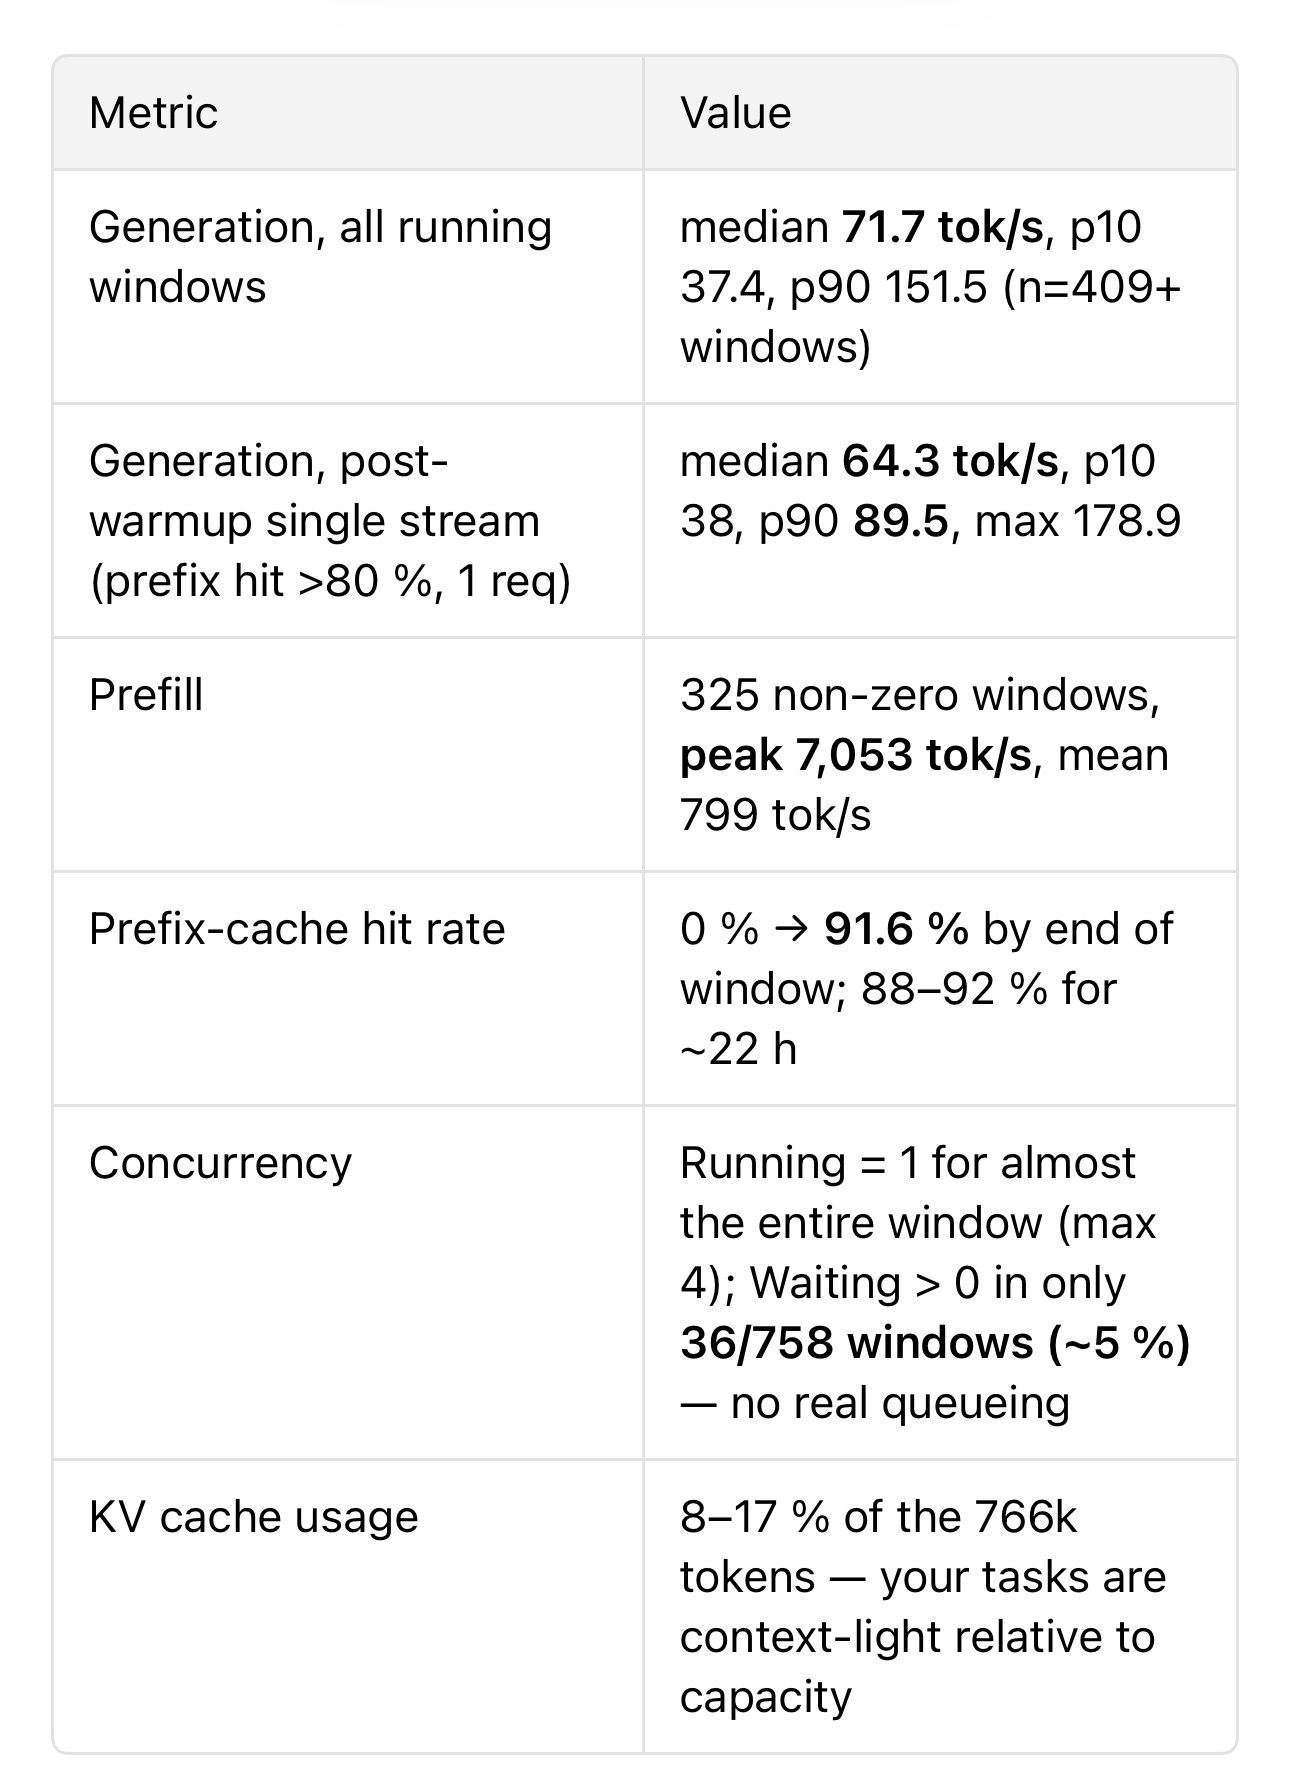
@he-wanga 我72g ram 四流256k毫无问题 应该还可以增加
 L
Luke Mao
@Luke Mao
-
X99, 雙R9700, Radiance + Qwen3.8 Flash-Next IQ4_R 速度測試報告 -
【双 R9700 折腾记】从 Strata 到 Radiance根据报告里的实测数据,给你拟了一条回帖(数字都出自 t5820 那次测量,双 R9700 32G TP2):
pp 和 tg 都是实测的(3.3 小时生产流量 + 一组冷启动 micro-probe,机器是 5820 塔式,双 R9700 32G ×2,TP2):
pp: 冷 prefill 拟合出来 3,191 tok/s(外加 0.51s 固定开销,R²=1.0;121k token 的 prompt 实测 38.7s)。热流量约 3,555 tok/s——因为生产请求多是会话尾部续跑,专家平面已经预热过。
不过我这个是被平台卡住的数:PCIe 只训练在 8 GT/s ×16(Gen5 卡跑 Gen3 速度),ReBAR 还没开(每张卡 31.86G 只映射出 256MiB,内核参数每次 dispatch 都要跨链路读)。冷 prefill 时这条残血链路已经被吃到 75% 占用(~10.4 GB/s/卡,其中 93% 是 expert staging)。模型是 512 专家的 MoE(65.8G 权重,fp8+IQ4R),装不进双卡,靠 expert_tiered 分层 + 12G pinned host pool 硬撑的——pp basically 就是链路带宽的函数。固件开了 ReBAR + Above 4G、链路重训上去之后这块应该还有很大空间,我还没测。
tg: 单请求中位 143 tok/s,p95 193,峰值 211;引擎整体 198 tok/s(MTP 投机解码 3 drafts,接受率 62.8%,3.91 tok/step)。>60k 上下文掉到 ~134,>1.5k token 的长输出再掉 25%。
框架是的,就是楼主这套(radiance 1.10.0,HIP 后端)。待机费电这点感同身受——我统计下来占空比只有 21%,八成时间卡闲着,但显存被吃了 99.7%,prefix cache 命中率 95.7%,全靠缓存撑住 TTFT。
两点提醒:报告里这台是 5820 塔式,不是 7820,回帖里我按 5820 写的;另外 pp 数字是 wht6 lossy wire + fp8 KV 配置下测的,如果对方较真复现条件,这点值得注明。AI给得答复 我这两卡放在t5820我还有一台t7820
-
【双 R9700 折腾记】从 Strata 到 Radiance -
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4 -
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4 -
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4@nami-ryuu 我是双卡sglang fp8 模型 3并发 速度很慢, 一共九40-45左右。现在想拿单卡抄个作业。
-
AMD AI Pro R9700 LLM调教 -
R9700 Proxmox VE 懶人部署兩週運行心得