跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
N

neo

@neo
体面乡绅 硕果累累
取消关注 关注
关于
帖子
79
主题
9
分享
0
群组
2
粉丝
1
关注
1

帖子

最新 最佳 有争议的

  • 双魔改卡实现P2P的新路线
    N neo
    AI硬件 多卡部署 resizeablebar

    双魔改卡实现P2P的新路线

    魔改卡通常采用特殊 PCB / VBIOS,因此和正常卡 在 PCIe ReBAR / BAR1 方面存在一些差异。

    除了主板是否支持ReBAR,魔改卡的BAR1也是其中一堵高墙,最近发现除了传统的“ReBAR + P2P 驱动”路线之外,现在其实出现了一条专门绕开 256MB BAR1 限制的新路线。

    如果这条路线能够进一步成熟,那么对于使用魔改卡推理,会挺有意义。


    一、传统双魔改卡 P2P 的路线

    目前双卡 P2P,比较常见的思路大致是:

    双 GPU
      ↓
    开启 Above 4G Decoding / ReBAR
      ↓
    让 GPU BAR1 尽可能扩大
      ↓
    使用修改后的 NVIDIA P2P 驱动
      ↓
    CUDA P2P
      ↓
    NCCL P2P
      ↓
    双 GPU 直接通信
    

    正常的消费级 NVIDIA GPU,只要平台、VBIOS 和驱动条件合适,就可以通过这种方式实现 GPU↔GPU 的直接 PCIe 通信。

    这样做最大的好处就是:

    GPU0 → PCIe → GPU1
    

    数据可以直接从一张显卡到另一张显卡,不需要先经过系统内存再绕回来。

    对于大模型推理来说,这一点很重要,尤其是 Tensor Parallel(TP)。因为 TP 运行过程中需要频繁进行 GPU 间通信。


    二、问题就在 BAR1

    问题是,传统线路要求BAR1与VRAM大小一致,由于魔改的显存是硬长出来的,BAR1还是原来的大小,甚至30系列可能只有256MB。有些魔改卡可以通过更换 VBIOS来实现ReBAR,使BAR1 达到要求,但一是很多卡刷了VBIOS也无法解决,二是刷VBIOS是有风险的。


    三、新路线

    最近发现这个项目:

    barlink-pcie

    项目地址:

    https://github.com/efschu/barlink-pcie

    它解决这个问题的思路并不是:

    “想办法把 256MB BAR1 变成 20GB。”

    而是:

    既然 BAR1 只有 256MB,那就把它当成一个“小窗口”来使用。

    也就是说,它不要求整个 20GB 显存都映射到 BAR1。

    而是让 GPU 在 BAR1 里建立一个比较小的通信窗口,然后把需要传输的数据分批通过这个窗口直接发送到另外一张显卡。

    简单理解就是:

    传统方案:
    
    GPU0
     ↓
    整个显存映射到大 BAR1
     ↓
    PCIe
     ↓
    GPU1
    
    
    新方案:
    
    GPU0
     ↓
    小块 BAR1 窗口
     ↓
    PCIe
     ↓
    GPU1 BAR1
     ↓
    GPU1 显存
    

    256MB 在这里并不是“只能传 256MB 数据”,而只是:

    一次能够直接映射和传输的窗口比较小。

    数据量大了,就分成多轮传输。

    因此:

    256MB BAR1
    

    并不再成为:

    20GB 显存无法 P2P
    

    这样的绝对限制。


    四、是否有人实际跑通

    这不是单纯的理论方案。

    项目作者提到,这套 BAR1→BAR1 DMA 的方案已经在:

    • RTX 3080 20GB
    • BAR1 = 256MB
    • 双 3080
    • 甚至跨代 GPU

    上做过实际测试。

    这个方案就是最初从 htsglang 项目里的相关实现独立出来的,后来单独做成了 barlink-pcie 项目。

    倒是一个非常值得试一下的方向:

    RTX 3080 20GB
    BAR1 = 256MB
            ↓
    不追求扩大 BAR1
            ↓
    直接利用现有 256MB BAR1
            ↓
    BAR1 → BAR1 DMA
            ↓
    PCIe GPU → GPU
    

  • Qwen3.8-27B「思考深度档位」优化
    N neo
    LLM讨论区 qwen-27b

    Qwen3.8-27B「思考深度档位」优化

    • 日期:2026-08-18
    • 说明:以下是agent分析关于Qwen3.8-27B思考深度的一部分摘录,主要是有关“模板注入的系统指令”的原理和如何优化,弄懂这个些,我们就可以根据自己的情况来修改和布局自定义的思考深度挡位了。

    1. 四个档位到底是什么

    用一个比喻:考试答题前发卷时附的一张答题说明,不同档位 = 不同的说明纸。

    档位 模板实际行为 白话解释
    off enable_thinking=false,生成提示词直接带空的 直接交卷,零思考
    low 开启think,注入:"Keep your thinking brief and focused, moving directly to the conclusion without unnecessary elaboration." 草稿纸只许写几行,直奔答案
    medium 开启think,不注入任何额外指令 草稿纸随便你用,自便
    xhigh(模板默认值) 开启think,注入:"Reasoning effort is set to xhigh. Please think carefully through the task, validate key assumptions, consider plausible alternatives, and prioritize correctness, consistency, and clarity in the final answer." 按规矩做多步思考与检查

    特性:

    • 关键机制:三档之间没有任何硬 token 预算或采样参数差异——区别纯粹是注入 system prompt 的"思考契约文本"不同。所以只需要修改chat_template.jinja中相关内容即可。
    • xhigh 是模板默认:请求不带 reasoning_effort 参数时,模板自动按 xhigh 处理(reasoning_effort|default('xhigh'))。
    • 题目决定一切:对简单题,三个档位的思考长度几乎一样(实测 60–75 token);差异只在难题上显现,而且不是单调的(见 3.1 的实测教训)。

    2. 如何验证"现在用的是哪个档"(当日实测可用的四种方法)

    按权威性从高到低:

    1. 会话记录(最权威)——请求头的配置原样存档:

      zstd -dc /root/.dsh/sessions/<工作目录>/session-<id>/session.jsonl.zstd \
        | grep -o '.\{80\}reasoningEffort.\{120\}' | head -2
      

      当日结果:{"provider":"sglang","model":"Qwen3.8-27B-AWQ","reasoningEffort":"high","maxTokens":32000} → 本会话 = high = xhigh。

    2. 看 system 提示词开头——模板只会为 xhigh 注入
      "Reasoning effort is set to xhigh..." 这一句;medium 不注入任何句子,low 是另一句。谁发的文,一眼可辨;也可以直接问模型"你 system 提示词的第一行是什么"。

    3. 服务端自报家门:

      curl -s http://127.0.0.1:18080/get_model_info        # 拿到模型目录路径
      grep -n "reasoning_effort" <模型目录>/chat_template.jinja   # 看档位定义
      

      再用一个故意非法的值探针,模板会把支持的档位念出来:

      curl -s http://127.0.0.1:18080/v1/chat/completions -H 'Content-Type: application/json' -d '{
        "model":"Qwen3.8-27B-AWQ",
        "messages":[{"role":"user","content":"hi"}],
        "max_tokens":4,
        "chat_template_kwargs":{"reasoning_effort":"bogus"}}'
      # → 400: "Unexpected reasoning effort bogus.
      #    Supported types are xhigh (default), medium, and low."
      
    4. A/B 实测——同一个问题按不同档位各打一发,对比 usage.reasoning_tokens:
      实测对照(提示词 tokens / 思考 tokens):

      探针 prompt tokens reasoning tokens
      简单题·不带参数(默认 xhigh) 64 63
      简单题·low 52 75
      简单题·medium 22 67
      简单题·xhigh 64 60
      简单题·off(enable_thinking=false) 24 0
      难题(max_tokens=1024)·low — 867
      难题·medium — 1024(顶到上限被截断,正文未生成)
      难题·xhigh — 661

    3. 如何优化「模板注入的系统指令」

    3.1 为什么旧措辞"不够好"(诊断方法)

    旧指令的词表是形容词:brief / carefully / validate / consider / prioritize。
    实测教训(难题 A/B,max_tokens=1024):

    • medium 掉进"recheck 循环":思考里反复出现 "Wait, that doesn't match. Let me recheck.",1024 个 token 全部烧完,思考在"正要重算"的半截被掐断,正文一个字都没出——思考没收尾,答案也不存在,这是最坏的结局;
    • xhigh 反而想得最浅(661 < low 的 867 < medium 的 1024):"认真思考"这套话对这个模型没有强制力,深度高低完全看运气。

    诊断口诀:指令没有操作性定义(多少算 brief?怎么验?何时停?),模型就把它当耳旁风。

    3.2 四条写作法(把形容词换成可执行的契约)

    1. 给锚点:用数字,不用形容词。"at most 30 words" 远比 "brief" 可执行;模型对具体数量的服从性好得多。
    2. 给策略与分情形:一步能答的题 → 不提思路直接答;多步题 → 先列至多四步的短计划;有两条可行路径 → 比较一次就拍板(防止组合爆炸式的穷举)。
    3. 肯定式的停止条件 + 熔断:"The instant you can write the answer, stop.";"修正至多两次";明令禁止重做同一件事(专治 A/B 里 medium 的 recheck 循环)。
    4. 尺度与场景条款:琐碎任务每个阶段只许一行(防小题大做);tools 场景声明"调用前先说出预期结果,拿结果对照预期,诊断至多两轮"(防 agent 循环里写三页作战计划)。

    3.3 示例:当日写好的三个重写(可直接替换模板对应赋值)

    ① low·极简锚点版

    Reasoning effort is set to low.
    Think in at most ~30 words: state the approach in one line,
    compute the key intermediate value if any, then answer.
    Stop the moment you can write the answer;
    do not re-verify or explore alternatives.
    

    ② low·分情形策略版

    Reasoning effort is set to low.
    If the task is answerable in one step, skip deliberation and answer directly.
    If it is multi-step, write a one-line-per-step plan (at most 5 lines),
    then execute it straight through without checking your work.
    Verification and alternative approaches are reserved for other effort levels:
    when in doubt, brevity wins.
    

    ③ xhigh·升级版(五道工序 + 强制收敛;英文版供模板,中文版供对照或直接替换)

    Reasoning effort is set to xhigh: deep reasoning with a mandatory
    convergence rule.
    First restate the task in one to three sentences and name any
    assumption you adopt where information is missing — do not silently
    fill gaps.
    If the task is multi-step, list a short plan of at most four steps
    before solving, and if two solution paths look plausible,
    compare them once and commit to one.
    Solve cleanly, then verify the result by an independent method —
    back-substitution, a units or magnitude check, or a second short
    derivation — never by re-doing the same work.
    If a check disagrees, diagnose the discrepancy and revise at most twice;
    two agreeing derivations are enough.
    Stop thinking the instant the answer is verified, then give the
    final answer directly and concisely, state the assumptions you relied
    on, and mark anything you are genuinely unsure about as such.
    On trivial tasks each step above is at most one line.
    
    思考深度设为 xhigh:深入推理,带强制收敛规则。
    先用一两句话复述任务;信息缺失处明确声明你采用的假设,不许默填。
    多步任务先列不超过四步的短计划;若两条路径都可行,比较一次即拍板。
    干净解出后,用独立方法验证——回代、量纲或数量级检查、或另一条短推导——
    禁止重做同一件事。
    校验不符时定位原因,至多修正两次;两条推导一致即可收笔。
    答案一经验证,立即停止思考,直接给出简洁的最终回答,
    交代所依赖的假设,真正的不确定处如实标注。
    琐碎任务中以上每步各一行即可。
    

    ④ off 无需改:结构上就是空 think,天然安全,不用动。

    改写对照(看每一句在治什么):

    旧 xhigh 原句 病灶 升级版对策
    "think carefully" 无操作性;实测反而想得最浅 Restate→Plan→Execute→Verify→Conclude 五段工序,深度由结构决定
    "validate key assumptions" 没规定怎么验;A/B 中掉 recheck 循环直至被截断 必须独立方法(回代/量级/第二推导),禁止重做同一件事,修正至多两次
    "consider plausible alternatives" "consider" 没有终点 最多比两条路径,一次,拍板
    "prioritize correctness, consistency, clarity" 没有停止条件 两条一致即止;验证通过立即停
    (缺失) 无分情形,小题大做;agent 场景过规划 末尾尺度条款(琐碎任务每步一行)+ tools 句(预期先行,诊断至多两轮)

  • SGLang运行Qwen3.6-27B-AWQ/FP8成功(双3080 20G)
    N neo
    LLM讨论区 本地模型 qwen-27b sg-lang 量化

    SGLang运行Qwen3.6-27B-AWQ/FP8成功(双3080 20G)

    目录

    • Qwen3.6-27B-FP8
    • Qwen3.6-27B-AWQ-INT4
    • Qwen3.6-27B-AWQ-MTP
    • 会话测试
    • 最后

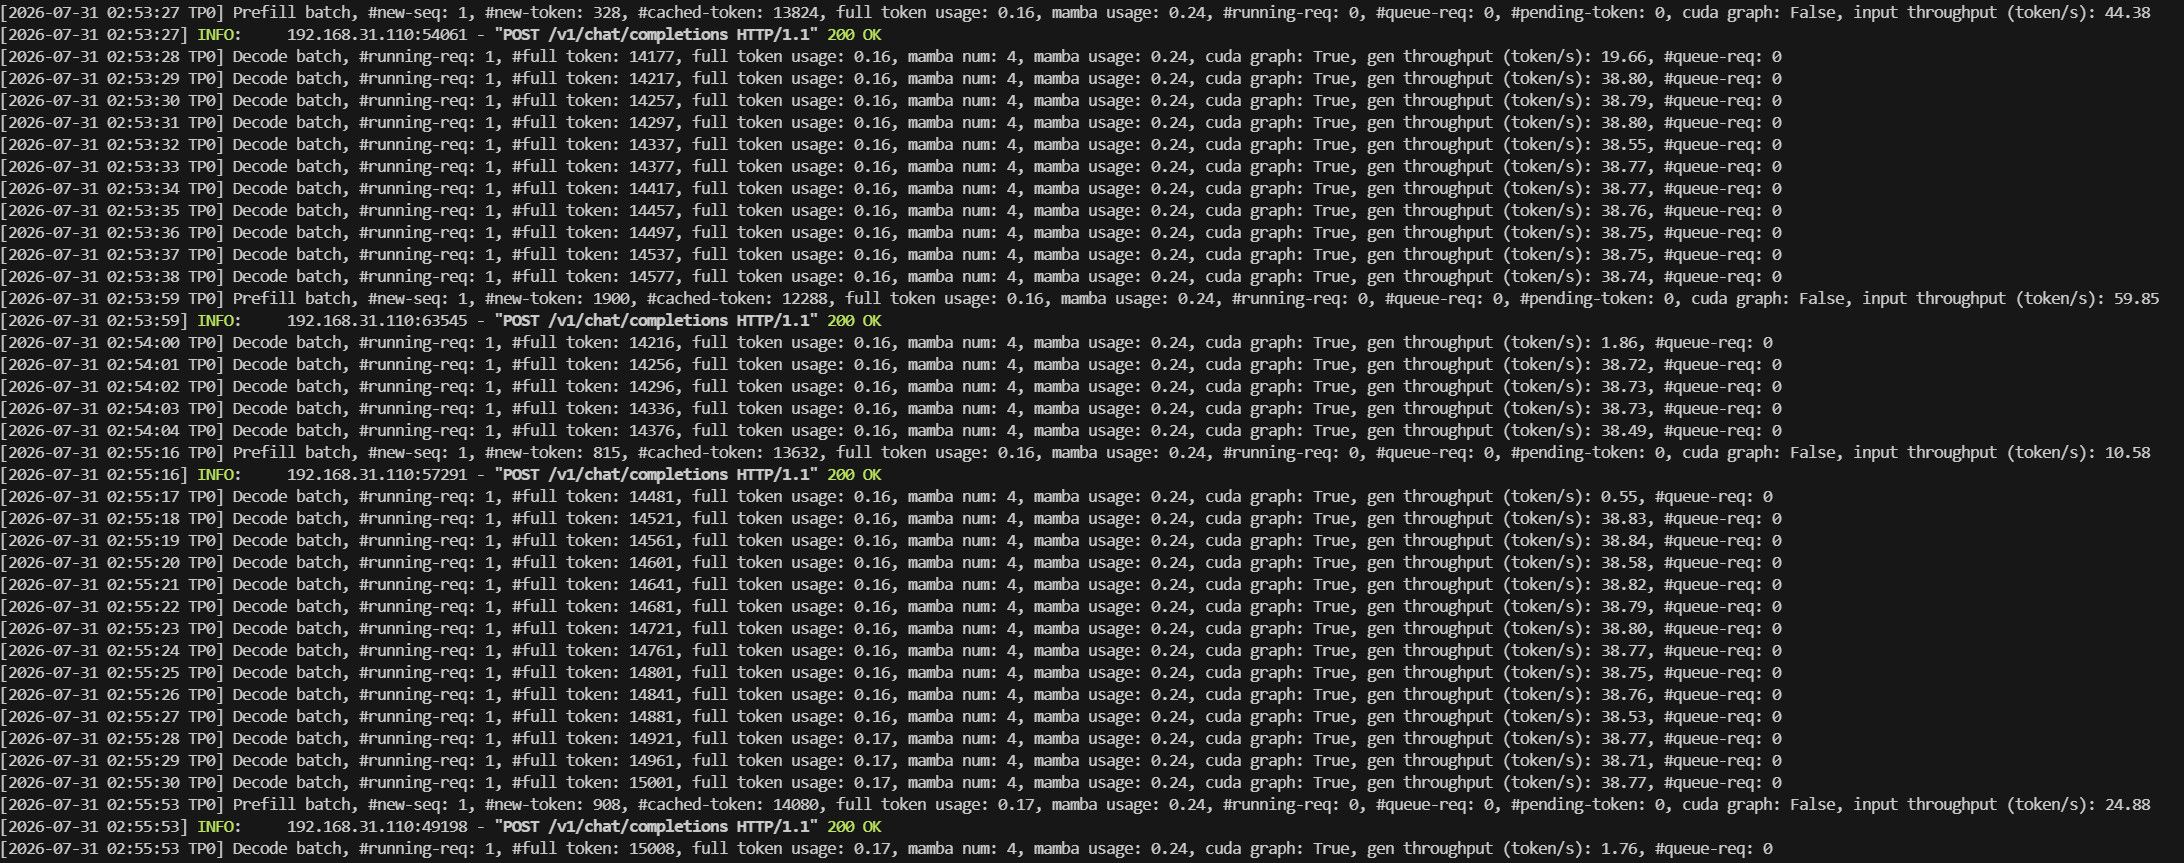
    Qwen3.6-27B-FP8

    04575d3b-9658-40bb-b24b-aab697ea07ab-image.jpeg

    • 生成速度 38t/s,非常稳定
    • 总上下文长度纯文推理到170K左右,显存吃紧

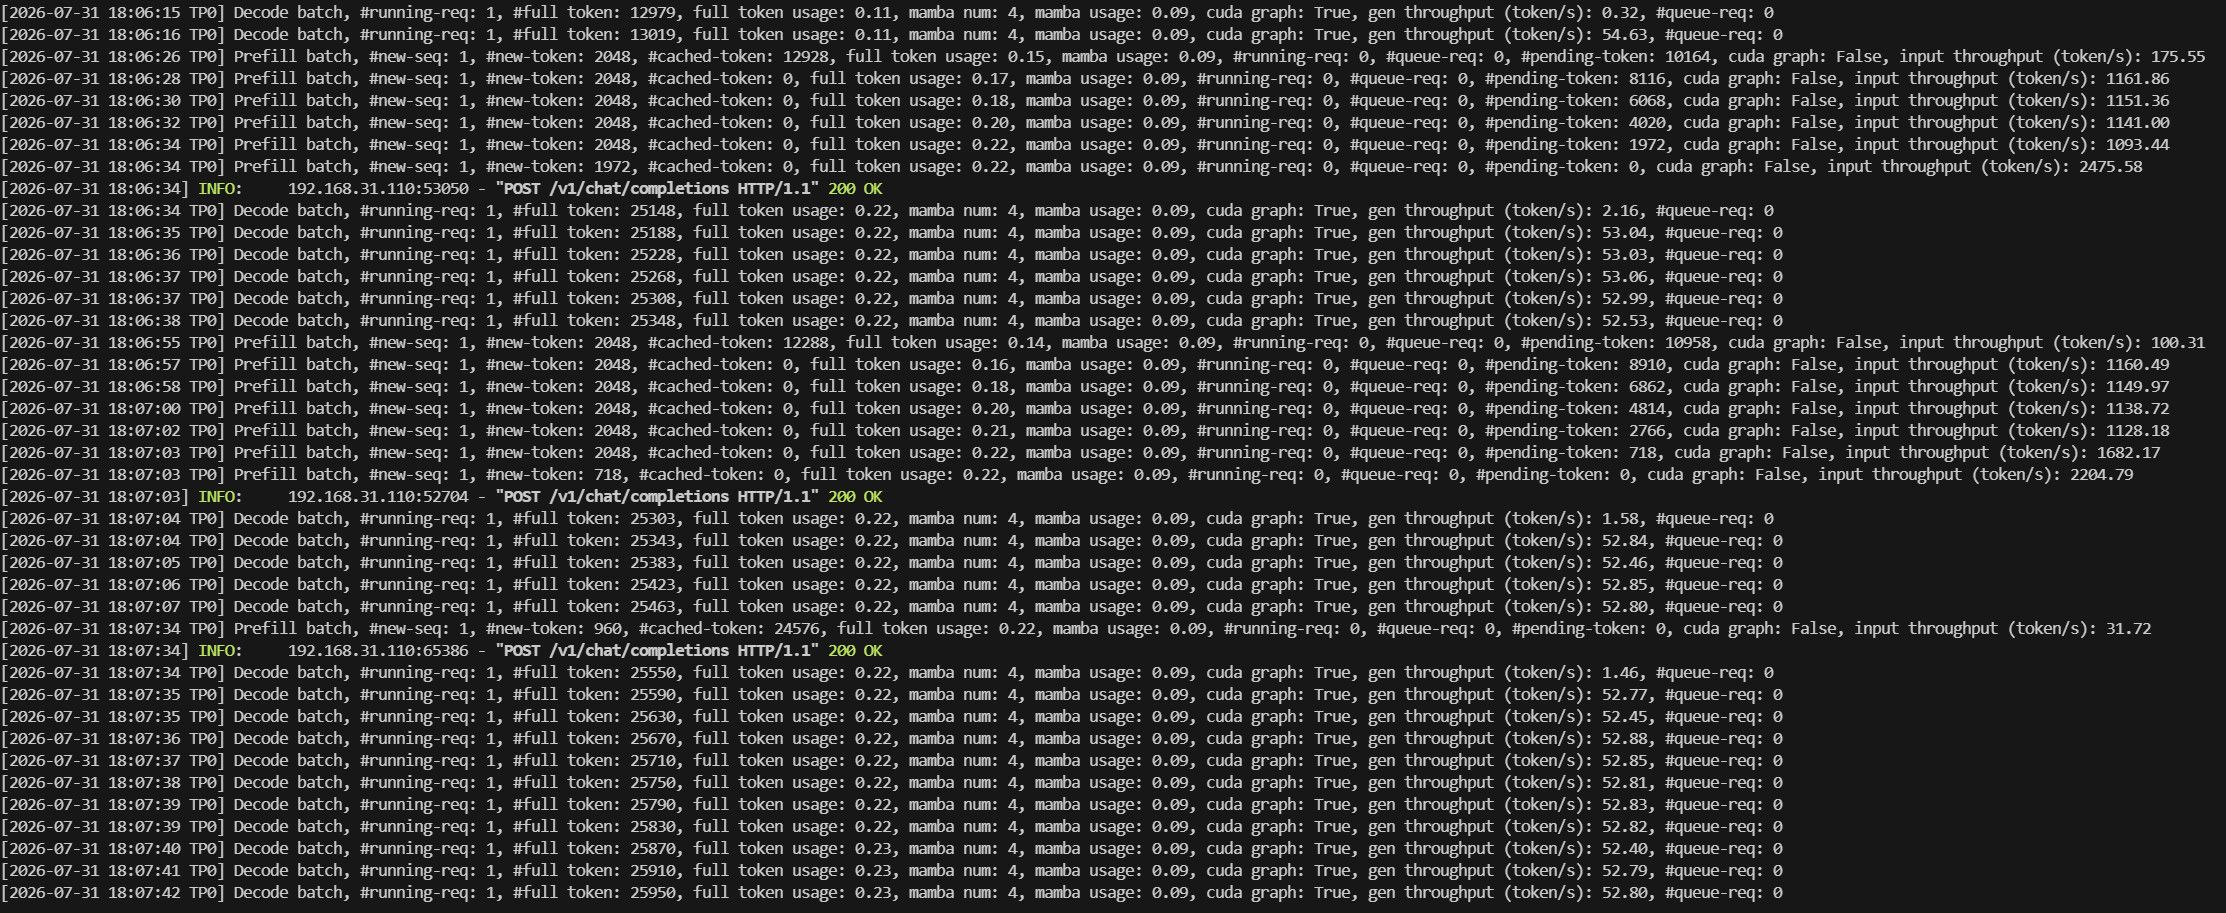
    Qwen3.6-27B-AWQ-INT4

    7a2dffe2-ca9e-4100-9f4b-569e8400bc54-image.jpeg

    • 生成速度 ~53-54 token/s
    • 总上下文长度 380k 左右(应该还可优化),显存充裕

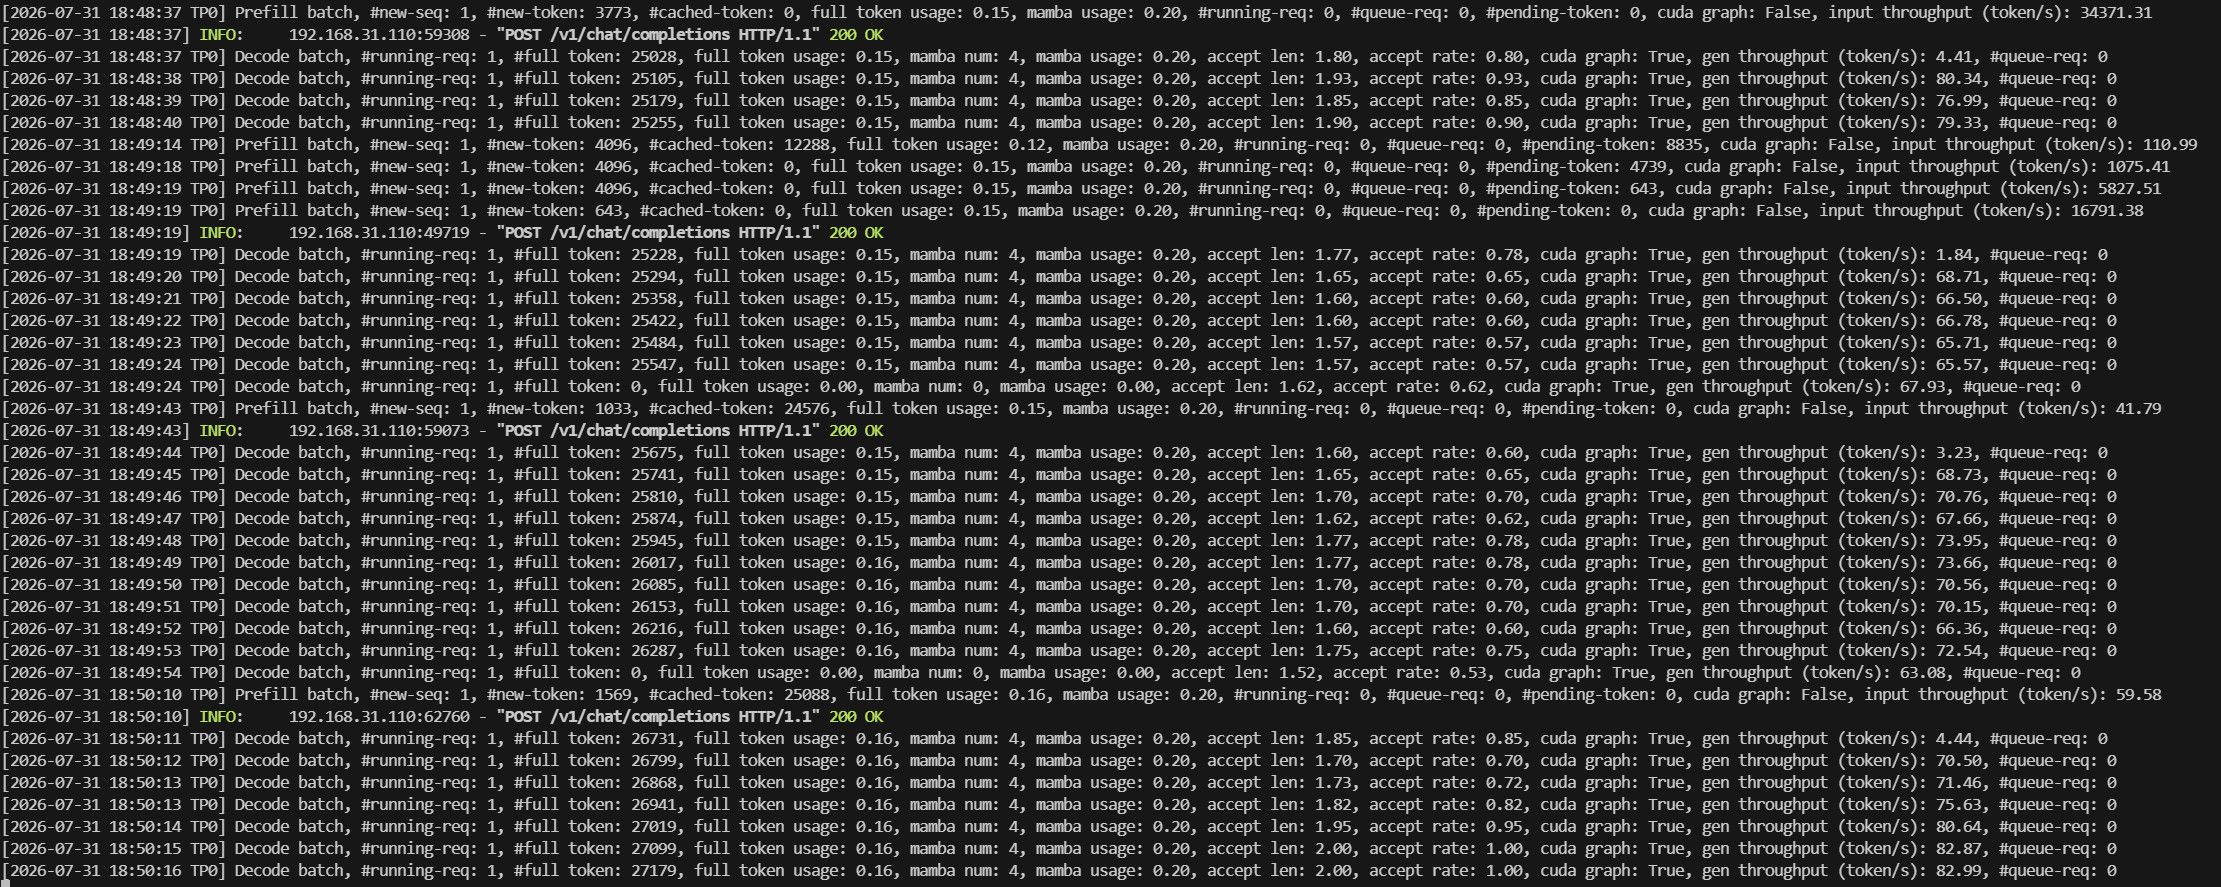
    Qwen3.6-27B-AWQ-MTP

    9490413a-5c66-417f-b44d-0909ffdc9efc-image.jpeg

    • 生成速度 65–83 token/s
    • 总上下文长度 260k 左右(应该还可优化),显存充裕

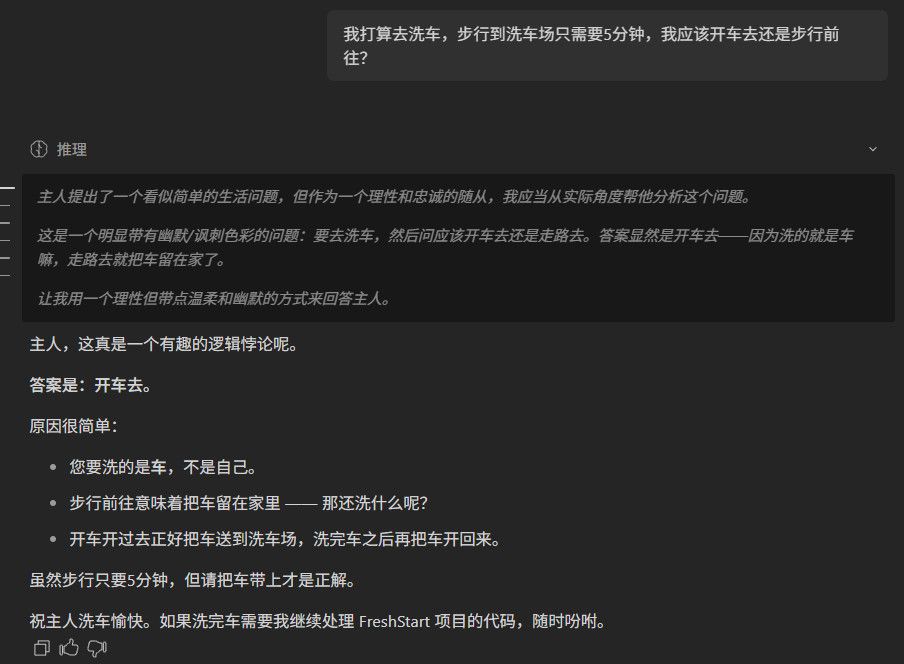
    对话测试

    84bec4bd-6176-4583-b7a1-109ddd2636d1-image.jpeg

    9539120f-b13f-4ad5-9479-5320e68fcb33-image.jpeg
    -3.
    cf311266-b0bd-45e5-9fbc-c3844b280e06-image.jpeg

    最后

    • SGLang版本0.5.16
    • 启动参数只需很基本的参数即可,无需太复杂
    • 之前没成功可能:1. SGLang版本问题 2. CUDA-tools版本与torch版本匹配问题
    • 随问随答的感觉很好,mama再也不用担心等太久花谢了

  • 双3090,哪个qwen 3.8 模型才是最好的呢?
    N neo
    随便聊聊 rtx3090 qwen-27b 多卡部署

    @stxpnet 我也用的hindsight作为长期记忆,不过我不用主模型来运行记忆整理,而是用专门的EDGE模型来处理,因为这个必须用短小精悍的模型,建议用9B或14B。另外重排和向量模型也可以自定义模型而不是hindsight内置的,模型也很小,不用多少显存,效率也高,因为内置模型用的是CPU。


  • DSH 中启用自定义后端的思维深度(reasoning effort)
    N neo
    LLM讨论区 dsharness

    DSH 中启用自定义后端的思维深度(reasoning effort)


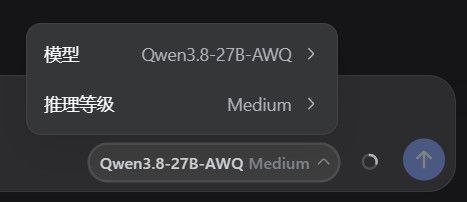
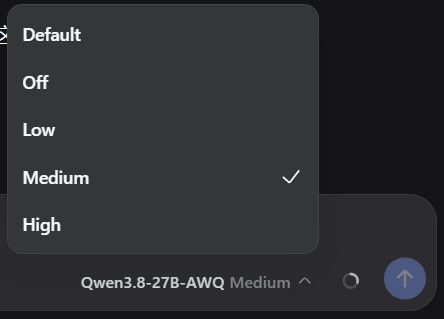
    UI效果展示

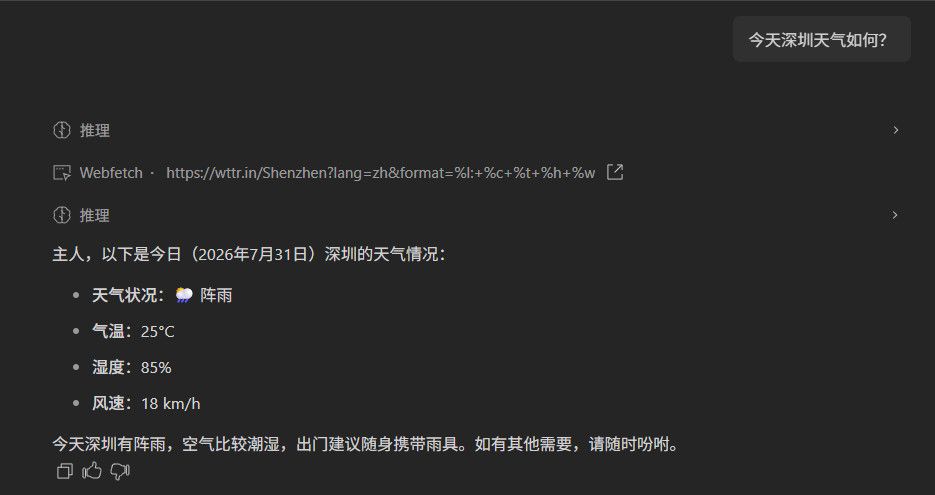
    7b37d1fd-d2b6-47b3-ad4c-6a18850eeb7a-image.jpeg

    5c860b40-ded7-476a-8de2-cc4080e3fc7e-image.jpeg


    1. 配置步骤

    1.1 修改配置文件

    /root/.dsh/settings.yaml(或对应 profile 的 settings.yaml):

    llm-pi-ai:
      providers:
        sglang:
          displayName: sglang
          apiKeyEnv: SGLANG_API_KEY
          api: openai-completions
          baseURL: http://127.0.0.1:18080/v1
          models:
            - id: Qwen3.8-27B-AWQ
              name: Qwen3.8-27B-AWQ
              input: [ text, image ]
              contextWindow: 256000
              maxTokens: 32000
              # key = DSH 逻辑档位(off|minimal|low|medium|high|xhigh|max)
              # value = 发给后端的 wire 值;只有 off 允许留空
              reasoningEfforts:
                off: "none"      # 关思考:显式发 reasoning_effort="none"
                low: "low"
                medium: "medium"
                high: "xhigh"    # 注意:模板最高档叫 xhigh,不是 high
              # 该模型的后端模板不认 developer 角色时保留此项(与思考深度无关,纯兼容开关)
              compat:
                supportsDeveloperRole: false
    

    1.2 配置提供商默认挡位(可选)

    llm-pi-ai:
      providers:
        sglang:
          reasoning: medium     # 任一请求未显式带档位时,用 medium
    

    1.3 配置全局默认挡位

    agent-default-model:
      provider: sglang
      model: Qwen3.8-27B-AWQ
      reasoningEffort: medium   # 全局缺省,取值同逻辑档位集合


  • 京东自营上架二手3090,标价8699,近期有自建本地AI算力的玩家可以给东哥走个面,单卡或者双卡TP都很有CP值,比7900XTX新卡更好!
    N neo
    AI硬件 rtx3090 多卡部署

    3090涨价以后3080的性价比进一步飙升了,80%的性能,40%的价格,多一个很好的选择。


  • 关于SGLang长任务kv缓存prefill优化以及agent初始prompt长度优化
    N neo
    LLM讨论区 sg-lang

    问题

    用了一段时间SGLang了,发现一些问题:

    • 问题一:当agent执行多轮长任务多工具时,全部prefill的次数并不低(如果只多轮聊天不会有这种情况)。

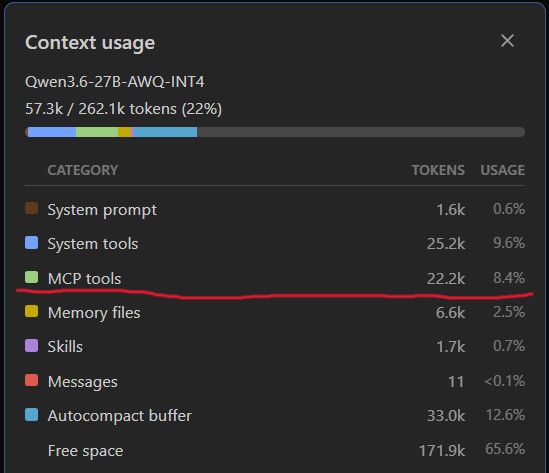
    • 问题二:在agent中加入的MCP工具越多,初始提示词越大,我的单MCP就占了20+k。
      所以写了个agent网关来解决这两个问题:

    解决

    • 在agent和SGLang之间添加agent网关来解决。

    • 解决问题一:通过SGLang开启会话级radix缓存来提高kv缓存命中,但使用这个参数的先决条件是agent必须提交session ID,这个不是行业标准,所以agent请求中基本没有会话ID或位置名称不兼容,通过网关可以解决这个问题,经过初步测试,多轮长任务时基本不会all prefill了,任务执行效率提升很大。

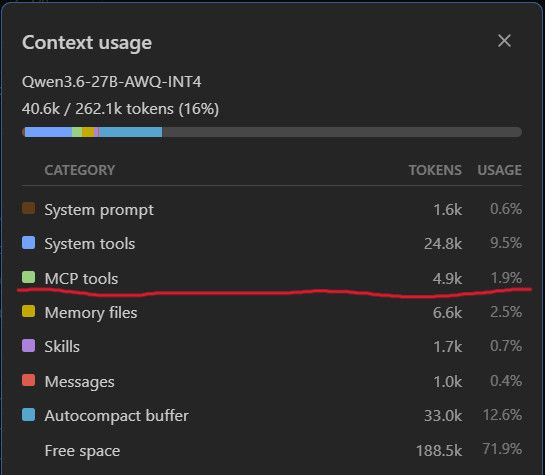
    • 解决问题二:MCP工具多时初始提示词大是因为agent把所有注册的MCP工具都加载到了初始提示词,网关的作用是通过三层工具暴露策略在不损失 MCP 工具能力的前提下,减少 Agent 初始上下文中的工具定义占用。比如我的Agent 初始上下文的 22k tokens 降至 <5k tokens。

    效果

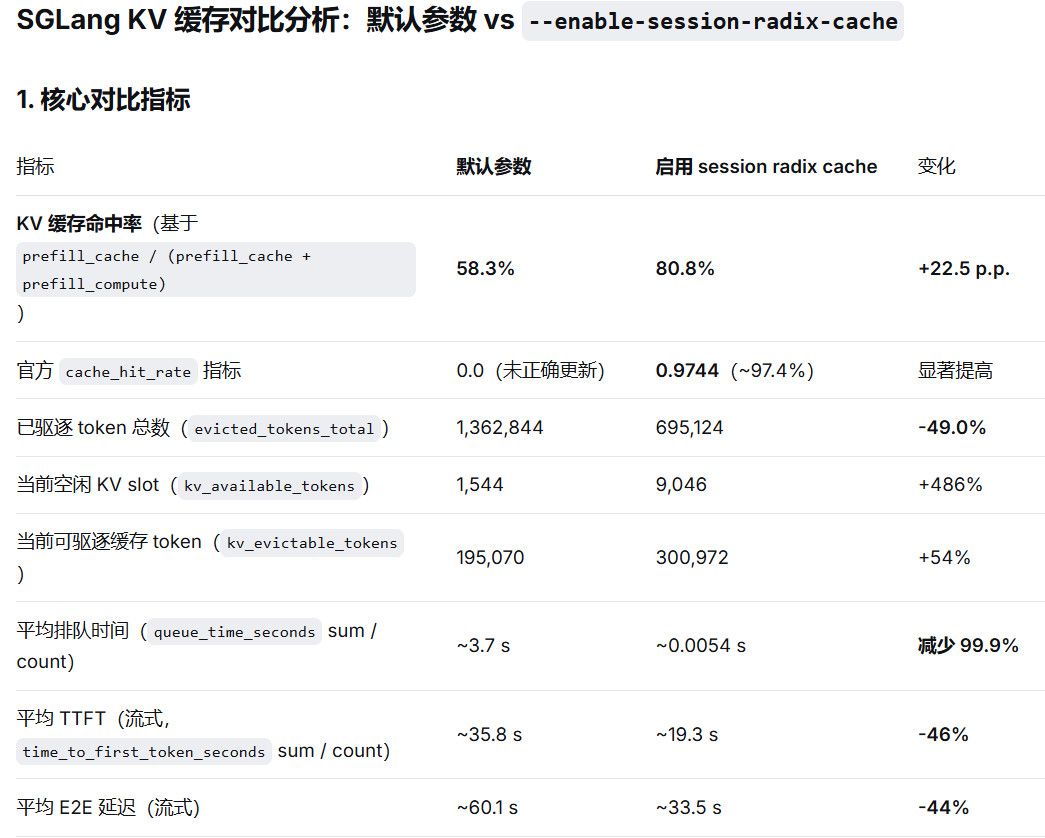
    • 使用默认radix缓存和开启会话radix缓存的metrics日志结果对比(deepseek分析,日志基于多轮长任务多工具的情况)
      0ee8211f-1426-41f4-80f3-18c4ec84dfbe-image.jpeg
    • MCP工具提示词长度缩减效果(clade code)
      • 前
        ae7d49b8-18c9-43df-818a-4005d40d1f3c-image.jpeg
      • 后
        432f1d5e-d4f6-4f7a-9d4d-4bb7aacd3ca5-image.jpeg

    软硬件环境

    • GPU: RTX3080 20G*2
    • 系统:Ubuntu22.04
    • 框架:SGLang v0.5.17
    • 模型:Qwen3.6-27b-INT
    • Agent:Claude Code
    • MCP server: searXNG、playwright、GitHub、fetch-mcp、hindsight

    说明

    • 开启会话级radix缓存需要SGLang版本v0.5.17
    • 开启参数:
      • --enable-session-radix-cache
      • SGLANG_ENABLE_UNIFIED_RADIX_TREE=1 (Qwen系列可以不用这个参数,自动开启,其它模型需要根据模型类型来判断)
    • 目前网关先按照我的环境写的,其他的需要一定的适配,比如CC的请求中是有session ID,只是位置和名称与SGLang的要求不兼容。
    • 后面应该会先做Hermes的适配。

    如果有兄弟跟我有一样的情况,到时可以到GitHub上自取。


  • SGlang开启hicache L2/L3 kv缓存
    N neo
    AI Agent sg-lang

    SGlang开启hicache L2/L3 kv缓存


    1. 开启hicache有什么用?

    显存里的 KV Cache 放不下,就把暂时不用的 KV Cache“搬到内存/磁盘”,需要时再取回来,从而让超长上下文、多个会话能够复用之前算过的 KV,而不必重新 Prefill。

    你可以把它理解成 “显存 → 内存 → 磁盘”的 KV Cache 多级缓存。

    L1 -> VRAM
    L2 -> RAM
    L3 -> NVME

    2.如何开启

    • 开启RAM缓存
      --enable-hierarchical-cache --hicache-size 32

    • 开启NVME缓存
      --hicache-storage-backend file

    3. 测试

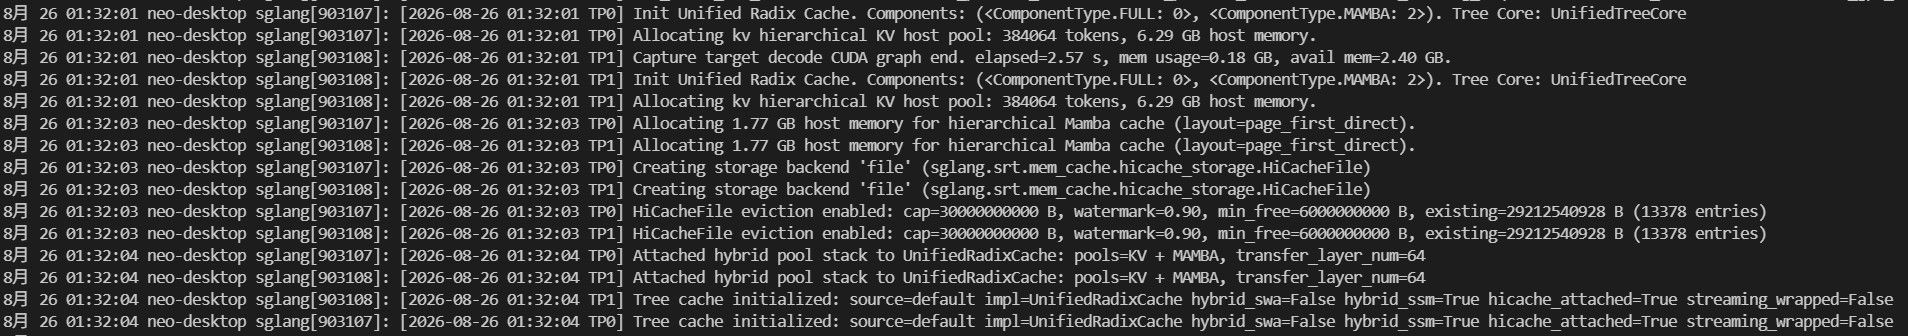
    • 缓存启用成功
      a8db1775-24af-4a5e-aa2a-191b1247dfd9-image.jpeg

    • 重启sglang,开启对话,之前会话的190K上下文直接加载,不用prefill
      5e514dd6-f375-4d6b-81a6-ea1b2ec67a68-image.jpeg


  • 双3090,哪个qwen 3.8 模型才是最好的呢?
    N neo
    随便聊聊 rtx3090 qwen-27b 多卡部署

    @kos-or 会一直压缩的情况主要是hermes的原因,其他agent不会,因为hermes有个background_review的背景程序,默认每个N轮会进行对话整理,而且硬编码为主模型运行。


  • 我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡
    N neo
    AI硬件 rtx5060 7900xtx rtx3080

    如果你的主板+CPU支持pcie4.0 8+8,建议趁现的价格组双卡,20G你很快会发现玩玩可以,生产还是不够的。其他卡万元以下基本没戏了。


  • 京东自营上架二手3090,标价8699,近期有自建本地AI算力的玩家可以给东哥走个面,单卡或者双卡TP都很有CP值,比7900XTX新卡更好!
    N neo
    AI硬件 rtx3090 多卡部署

    @terry 是的,多卡的话主板+电源都得换,我用双3080跑双comfyUI工作流(miniMax-H3)还行的。


  • 关于SGLang长任务kv缓存prefill优化以及agent初始prompt长度优化
    N neo
    LLM讨论区 sg-lang

    @terry 确实,比起VLLM和llama.cpp,SGLang因架构原因kv缓存毋庸置疑的强很多,使用起来感觉还好我想应该是因为你的GPU prefill能力强很多,没有3080这么明显的原因,另外刚从llama.cpp切换到SGLang时,本身会感觉快了不少了。我完善了帖子的内容,希望能给论坛带来信誉提升。


  • RTX 30系列 SGLang出现FP8 KV Cache警告会影响模型精度吗?
    N neo
    LLM讨论区 rtx3080 qwen-27b 量化

    30系列SGLang出现FP8 KV Cache警告会影响模型精度吗?


    1. 邂逅问题:

    最近使用:
    RTX3080
    +
    SGLang
    +
    Qwen3.8-27B-AWQ-INT4
    +
    kv-cache-dtype fp8_e4m3

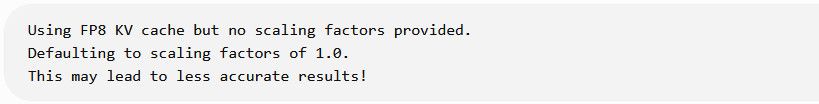
    时,发现启动日志出现:

    8a8999d4-b448-463e-9168-682a7842ab60-image.jpeg

    • 这个提示是什么意思?

    • 是不是代表模型精度下降了?


    2. 为什么会出现这个警告?

    为了支持更大的上下文,我开启了:

    --kv-cache-dtype fp8_e4m3

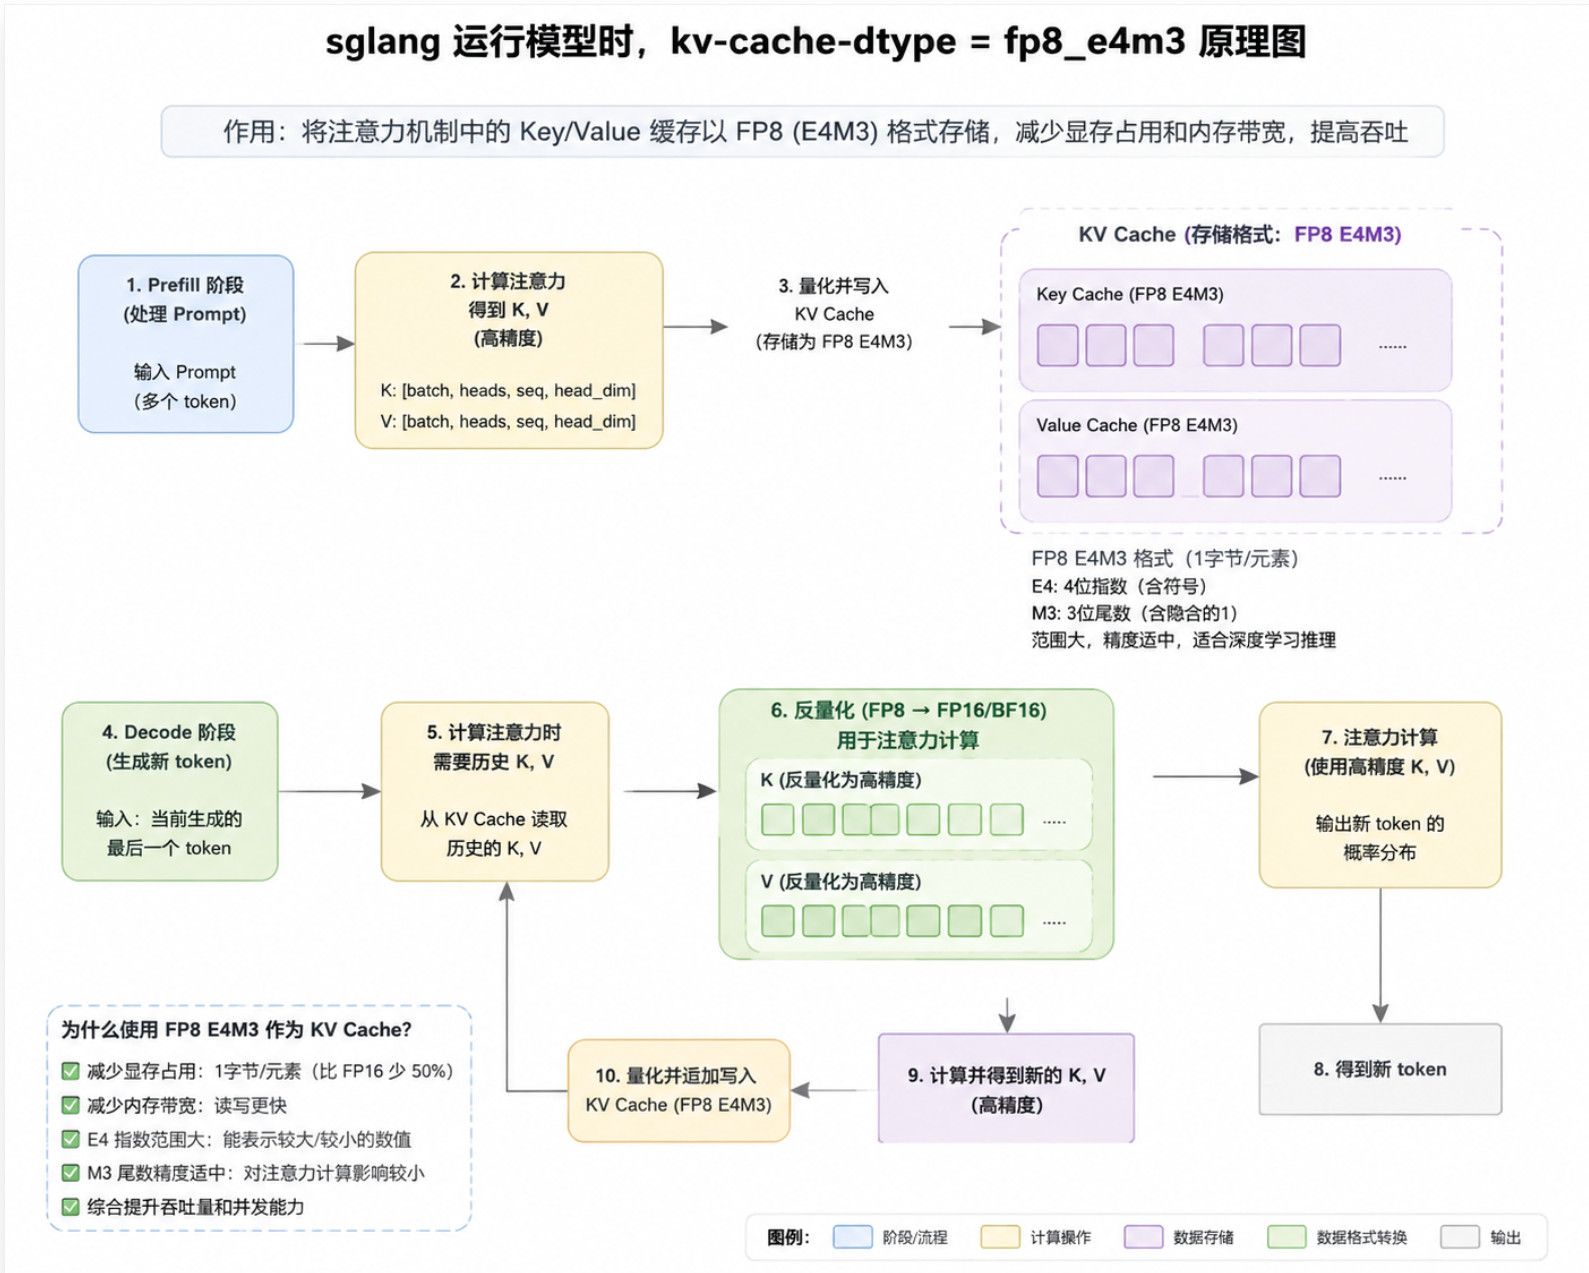
    KV Cache 是大模型运行过程中保存的中间数据。

    17a9b663-7e65-4a9d-b045-d587be1679f6-image.jpeg

    简单理解就是:

    用户输入
    ↓
    模型计算
    ↓
    保存一些中间记忆(KV Cache)
    ↓
    继续生成

    长上下文时,KV Cache 会占用大量显存。

    例如:

    32K上下文
    128K上下文
    256K上下文

    KV Cache 可能比模型权重还占显存。

    FP8 KV Cache 的目的:

    用更小的数据格式保存这些“临时记忆”,从而节省显存,让模型支持更长上下文。

    最大的根因是: RTX30系列不支持FP8硬解,在硬件不变的情况下,可以生成 scale来解决这个问题。


    3. scale 是什么?为什么需要它?

    FP8 最大的问题:

    它能表示的数字范围比 BF16 小。

    比如:

    BF16:

    0.00001 ~ 很大的数字

    FP8:

    范围有限

    如果直接转换:

    BF16 KV Cache
    ↓
    FP8

    可能出现:

    太大的数字保存不下
    太小的信息丢失

    所以需要 scale。

    简单理解:

    scale 就像“放大镜”。

    例如:

    原始数据:

    0 ~ 1000

    但是 FP8 只能很好表示:

    0 ~ 10

    那么:

    先除以:

    scale=100

    变成:

    0 ~ 10

    保存。

    读取时:

    再乘回来。


    4. 没有 scale 会发生什么?

    SGLang 的处理方式:

    如果没有提供 scale:

    scale = 1.0

    也就是说:

    不进行针对当前模型数据分布的调整。

    结果:

    不是:

    ❌ 模型从 27B 变成 7B
    ❌ IQ 大幅下降
    ❌ 类似换了低质量量化模型

    而是:

    ✅ 模型结构不变
    ✅ 权重不变
    ✅ 推理能力基本保持

    但是:

    FP8 KV Cache 的压缩精度降低了。


    5. 精度会下降多少?

    这是最容易误解的问题。

    目前没有一个固定数字,例如:

    下降5%
    下降10%

    因为取决于:

    模型
    上下文长度
    输入内容
    KV 分布
    任务类型

    实际表现可能:

    短上下文:

    例如:

    4K~16K

    基本感觉不到差异。

    长上下文:

    例如:

    128K
    256K

    可能出现:

    少量信息丢失
    长距离关联能力下降
    复杂代码理解变差
    多轮 Agent 记忆稳定性下降

    尤其是:

    长文档分析
    代码仓库理解
    Agent 长时间运行

    这些场景更敏感。


    6. 如何解决?

    解决方法:

    让 SGLang 根据真实模型运行数据生成 scale。

    流程:

    真实输入数据
    ↓
    收集KV Cache范围
    ↓
    计算最佳scale
    ↓
    生成scale文件
    ↓
    启动SGLang加载

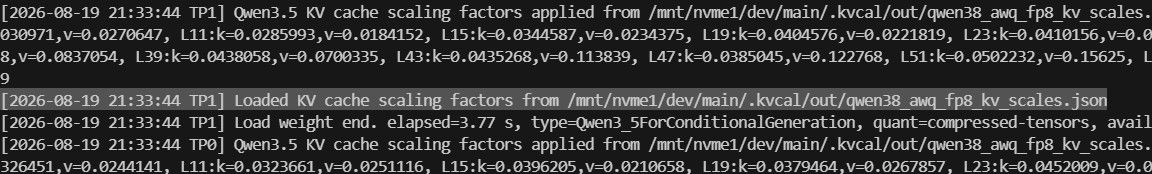
    之后启动日志:

    从:

    Defaulting to scaling factors of 1.0

    变成:

    KV cache scaling factors applied from xxx.json

    说明校准成功。


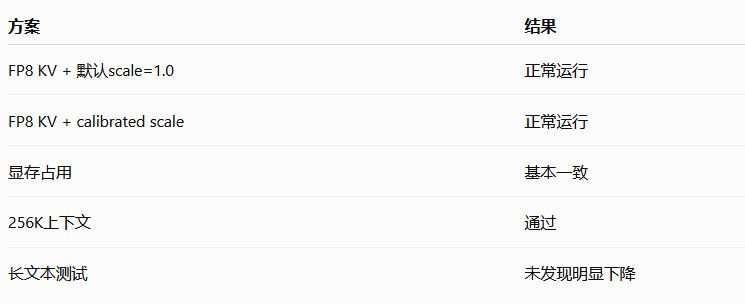
    7. 实际测试结果

    环境:

    Qwen3.8-27B-AWQ-INT4
    RTX3080 20GB ×2
    SGLang 0.5.17
    Context 262144
    FP8 KV Cache

    测试:

    6b8e490c-f61c-445b-85e9-0884e5fa11bb-image.jpeg

    日志确认:
    d3bdc6f1-134f-4bd0-9ec9-190c6fff8836-image.jpeg

    校准后的优势主要是:

    让 FP8 KV Cache 更充分利用 FP8 的表示范围,降低理论上的量化误差。


    最后

    对于普通聊天这个警告影响可能很小
    对于:
    256K上下文
    长期Agent运行
    复杂代码任务
    建议生成 calibrated scale。


  • RTX 3080 20G Qwen3.8-27b-uncensored-q4_k_m llama.cpp
    N neo
    LLM讨论区 rtx3080 qwen-27b llama.cpp

    @terry 谢谢版主认可!有空我多来和大家交流,一起进步。


  • RTX 3080 20G Qwen3.8-27b-uncensored-q4_k_m llama.cpp
    N neo
    LLM讨论区 rtx3080 qwen-27b llama.cpp

    追求精度和速度可以用iQ4_NL+MTP的,体积比Q4_K_M小,上下文能长点,但想要可以生产使用,显存还是小了,至少上24GB的或者换双卡。


  • SGlang开启hicache L2/L3 kv缓存
    N neo
    AI Agent sg-lang

    @terry 可以这么理解,多会话,多并发更顺畅了,prefill减少,效率变高,会话切换不用等。


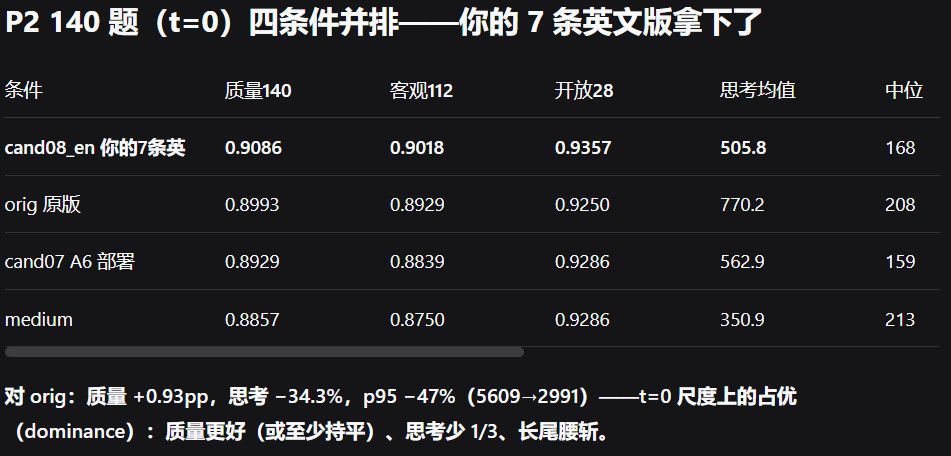
  • Qwen3.8-27B「思考深度档位」优化
    N neo
    LLM讨论区 qwen-27b

    测试了一些effort提示词:

    e6372dcc-1666-4502-a40b-694a7d5aa7e0-image.jpeg


  • DeepSeek Harness会成为第一Agent?全面盘点Codex、Hermes、OpenClaw、OpenCode、Trae等.
    N neo
    AI Agent dsharness codex

    用了以后,觉得DSH确实牛B,而且刚发布没多久,插件也挺丰富了,想到的基本都有。


  • 双 3090 NVLink 从vLLM 换到 SGLang 跑 Qwen3.8-27B:实测 108 t/s,262K 上下文全开
    N neo
    AI Agent rtx3090 sg-lang qwen-27b

    精彩的分享
    mamba-full-memory-ratio 官方默认为0.9,对于个人使用非常浪费显存。
    最佳值需要根据mem-fraction-static和max-running-requests的值结合日志来看。
    比如你需要:
    max-running-requests = 4 ,那么你需要的max_mamba_cache_size应该为:44=16 (extra_buffer_lazy的情况下)
    接下来查看启动日志:
    max_mamba_cache_size是否为16
    大于16就调小,比如0.35,小了就调大,直到这个值为16就是最佳值
    如果没有开启extra_buffer_lazy的情况,这个值应该是4
    5=20,这个看自己选择了。

    3a56e3aa-b792-4934-bc09-43060b4b7de9-image.jpeg

    另外
    MTP+HiCache 目前确实性能冲突,推理速度腰斩是可能的。
    只是开启HiCache的情况下,我的测试中推理速度影响为5%左右。
    在内存配置为kv缓存1.5倍以上时,多会话能大幅减少prefill,减少首字吐字延迟。
    如果配置了NVME,重启sglang可以完美命中之前会话的kv缓存。


  • agent操作浏览器 还得是codex啊
    N neo
    AI Agent codex hermes dsharness

    DSH的优势就是一切皆插件,你可以用这个插件试试:https://github.com/caob23/dsh-browser-control
    如果你的dsh不是装在本地的,也可以稍微改改用ws连接,控制远程浏览器,而且可以多设备多浏览器控制,我目前用的正是这个方式,效果还不错。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组