
感谢分享,你的机箱跟我的很像啊
-
【硬核实测】双 4080S 跑 125B Flash-Next 吊打 27B:单路 153 tok/s,是 27B 的 2.2 倍,Strata 三套量化 vs SGLang 全对比 -
deep seek 重度用户进去领取补偿了吗?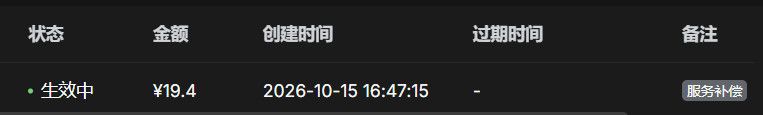
没有过期时间,不错哟 -
如何远程使用DSH?——推荐dsh-im插件国内钉钉和飞书都不错,有官方插件,功能也全,推荐用钉钉,它不是用传统的工具集,对上下文影响很小。
-
秀一下我的装备,某保密机关ai本地主机如果想提高并发数,可以把:
1、mamba-ssm-dtype改为bfloat16,
2、speculative-draft-kv-cache-dtype改为fp8_e4m3,
这应该是最直接和收益最大的方式了 -
【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!附议你的想法,拿整机的能力去跑更大的模型,而不是只用GPU+VRAM,肯定是好事。qwen3.8-flash-next说到底是技术预览版,未来flash是否开源现在还难讲,strata未来是否支持deepseek这样的模型也是未知。如果到时qwen4-27B开源了,而falsh不开源,那又得回到原来27B的老路上了。所以只是升级下内存之类测试尝鲜flash-next还行,现在整机升级朝着这个方向走,感觉为时过早啊。
-
双卡RTX3090 + 256G内存 用Strata 跑orcarouter的QFN IQ4_XS 100t/s 256k 10月8日 冲150T/S继续等了,要想拿来生产,4bit只是最低门槛。
-
[实测] 双 RTX 3080 20G + Strata + Qwen3.8 Flash Next IQ3_S:128K 上下文,Pi Agent 持续任务与多会话实测正好想试试flash-next,很有帮助,感谢分享。
-
不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!精度质量如何呀,有兄弟测试了吗
-
京東4090 48gb一個月準時壞掉了建议魔改卡一定要买一年或者半年包换的哪种,而且在JD要看什么店,有些店可能保证金还没一张卡多,就得小心了。
另外话说4080魔改故障率这么高,价格怎么还在涨,因为筐里挑瓜? -
双魔改卡实现P2P的新路线双魔改卡实现P2P的新路线
魔改卡通常采用特殊 PCB / VBIOS,因此和正常卡 在 PCIe ReBAR / BAR1 方面存在一些差异。
除了主板是否支持ReBAR,魔改卡的BAR1也是其中一堵高墙,最近发现除了传统的“ReBAR + P2P 驱动”路线之外,现在其实出现了一条专门绕开 256MB BAR1 限制的新路线。
如果这条路线能够进一步成熟,那么对于使用魔改卡推理,会挺有意义。
一、传统双魔改卡 P2P 的路线
目前双卡 P2P,比较常见的思路大致是:
双 GPU
  ↓
开启 Above 4G Decoding / ReBAR
  ↓
让 GPU BAR1 尽可能扩大
  ↓
使用修改后的 NVIDIA P2P 驱动
  ↓
CUDA P2P
  ↓
NCCL P2P
  ↓
双 GPU 直接通信
正常的消费级 NVIDIA GPU,只要平台、VBIOS 和驱动条件合适,就可以通过这种方式实现 GPU
 GPU 的直接 PCIe 通信。
这样做最大的好处就是:
GPU0 → PCIe → GPU1数据可以直接从一张显卡到另一张显卡,不需要先经过系统内存再绕回来。
对于大模型推理来说,这一点很重要,尤其是 Tensor Parallel(TP)。因为 TP 运行过程中需要频繁进行 GPU 间通信。
二、问题就在 BAR1
问题是,传统线路要求BAR1与VRAM大小一致,由于魔改的显存是硬长出来的,BAR1还是原来的大小,甚至30系列可能只有256MB。有些魔改卡可以通过更换 VBIOS来实现ReBAR,使BAR1 达到要求,但一是很多卡刷了VBIOS也无法解决,二是刷VBIOS是有风险的。
三、新路线
最近发现这个项目:
barlink-pcie
项目地址:
https://github.com/efschu/barlink-pcie
它解决这个问题的思路并不是:
“想办法把 256MB BAR1 变成 20GB。”
而是:
既然 BAR1 只有 256MB,那就把它当成一个“小窗口”来使用。
也就是说,它不要求整个 20GB 显存都映射到 BAR1。
而是让 GPU 在 BAR1 里建立一个比较小的通信窗口,然后把需要传输的数据分批通过这个窗口直接发送到另外一张显卡。
简单理解就是:
传统方案:

GPU0
 ↓
整个显存映射到大 BAR1
 ↓
PCIe
 ↓
GPU1


新方案:

GPU0
 ↓
小块 BAR1 窗口
 ↓
PCIe
 ↓
GPU1 BAR1
 ↓
GPU1 显存
256MB 在这里并不是“只能传 256MB 数据”,而只是:
一次能够直接映射和传输的窗口比较小。
数据量大了,就分成多轮传输。
因此:
256MB BAR1并不再成为:
20GB 显存无法 P2P这样的绝对限制。
四、是否有人实际跑通
这不是单纯的理论方案。
项目作者提到,这套 BAR1→BAR1 DMA 的方案已经在:
- RTX 3080 20GB
- BAR1 = 256MB
- 双 3080
- 甚至跨代 GPU
上做过实际测试。
这个方案就是最初从 htsglang 项目里的相关实现独立出来的,后来单独做成了
barlink-pcie项目。倒是一个非常值得试一下的方向:
RTX 3080 20GB BAR1 = 256MB ↓ 不追求扩大 BAR1 ↓ 直接利用现有 256MB BAR1 ↓ BAR1 → BAR1 DMA ↓ PCIe GPU → GPU -
agent操作浏览器 还得是codex啊DSH的优势就是一切皆插件,你可以用这个插件试试:https://github.com/caob23/dsh-browser-control
如果你的dsh不是装在本地的,也可以稍微改改用ws连接,控制远程浏览器,而且可以多设备多浏览器控制,我目前用的正是这个方式,效果还不错。 -
我卖掉了RTX5060Ti16G换了RX7900XTX最终还是又换了RTX3080 20G魔改卡如果你的主板+CPU支持pcie4.0 8+8,建议趁现的价格组双卡,20G你很快会发现玩玩可以,生产还是不够的。其他卡万元以下基本没戏了。
-
Qwen3.8-27b 跑了几个小时做的游戏 不忍直视 -
DSH 做了一个系统监控小插件@heheimback 这个插件主要用在远程使用dsh时,可以随时看到主机状态的,如果本地用dsh确实可以不用。
-
DSH 做了一个系统监控小插件 -
今天服务器很不稳定,要么挂死,要么重启。用墨水屏写了一个看板真不错,再用3D打印个壳子就可以摆起来用了,家里有两个闲置的kindle不知道能不能拿来用?
-
DSH 做了一个系统监控小插件DSH 系统监控悬浮卡
先上效果图
-
默认
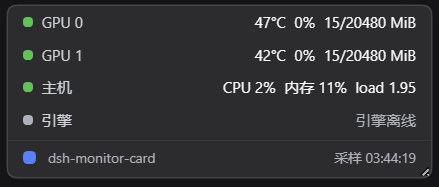
-
负载
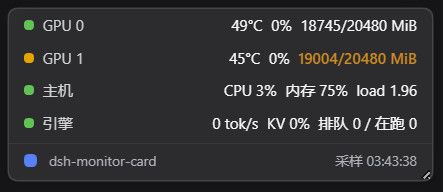
-
随意拖拽、改变尺寸
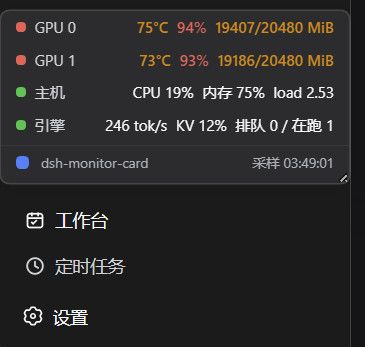
-
隐藏
说明
1、参考了zhubaohi/dsh-gpu-pulse等插件的效果
2、各项显示数值的时效与nvitop大体一致或更快
3、引擎项需SGLang(开启--enable-metrics)
4、监控卡可在DSH中随意拖拽位置,悬浮于页面不被遮挡
5、鼠标在监控卡的右下角可以调整卡尺寸
6、点击左下蓝点可隐藏或恢复监控卡
Github地址
-
-
雙 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next 調校成果感谢分享,prefill速度不错,内存是DDR几的呀?
-
2x3090 NVLink 王者配置再度进化——SGLang dev507 + DFLASH2 全面复测,并发 249 t/s 新高峰感谢分享,有可能的话可以测测长会话生成精度、质量如何,这个也很重要
-
京东自营上架二手3090,标价8699,近期有自建本地AI算力的玩家可以给东哥走个面,单卡或者双卡TP都很有CP值,比7900XTX新卡更好!