

@Terry 没问题。Linux 7.4预计正式发布可能得12月或1月了。要是正式被合并到主干了,我就发一帖,这也是第一次为开源社区贡献代码。
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战 -
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战更新一下进展:
已经把 X99 / Broadwell-EP(8086:6f00)的 P2PDMA 白名单补丁提交给 Linux PCI 维护者,目前被正式接收,已进入 pci/p2pdma 和 pci/next 分支,目标合并至 Linux v7.4。官方更新后未来不需要再编译内核了。
目前还未确认进入 Linus 主线,后续有进展再更新。
-
R9700 + Strata 实测:双卡 128K Prefill 3708 tok/s,兼测 IQ3_XXS / IQ3_S最近在 X99 平台上集中测试了 Strata,主要看两个问题:
- 单张和双张 Radeon AI PRO R9700 跑 Qwen3.8-Flash-Next GSQ-RCO GGUF,性能能到什么水平;
- 在我的平台上,IQ3_XXS 和 IQ3_S 的性能差异有多大。
先说结论
- 单卡 R9700 + IQ3_XXS:128K Prefill 约 2168 tok/s,Decode 约 62 tok/s。
- 双 R9700 + Layer Split + IQ3_XXS:128K Prefill 约 3708 tok/s,双卡扩展比约 1.71×;TTFT 从约 59.6 秒降到 35.1 秒。
- 双卡后 24,576 个 experts 可以全部驻留 GPU,Host Resident Expert 从 18.63 GiB 降到 0。
- 在我的 X99 平台上,Layer Split 明显优于 Peer Device。
- IQ3_S 即使双卡实现 100% expert 显存驻留,128K Prefill 仍比 IQ3_XXS 慢约 15.9%。
- 性能方面目前明显更适合 IQ3_XXS;质量方面,IQ3_S 和 IQ3_XXS 还没有做足够完善的高难度 Agent/Coding 对比,因此暂不下结论。
一、IQ3_XXS:单 R9700 与双 R9700
测试平台与关键参数
项目 配置 主板 / CPU X99-TF / Xeon E5-2697A v4 内存 128GB DDR4 GPU 2 × AMD Radeon AI PRO R9700 32GB PCIe X99 / PCIe 3.0,P2P、HIP IPC 已验证 OS Ubuntu 24.04 Server Strata v0.1.38, 99f3dbd0b21d1401b3769e0c0d963913607f380bROCm 10.2.0a20260914 模型 Qwen3.8-Flash-Next-GSQ-RCO-GGUF 主要量化 IQ3_XXS 关键设置 STRATA_RESIDENT_PIN=1、STRATA_HIP_WMMA=1、STRATA_SELECT_WMMA=1、pcie-frac=0、hipBLASLt tuning OFF前期探索里影响最大的是 Resident Expert Pinning:pageable resident memory 改为 pinned 后,128K Prefill 从约 1506 tok/s 提升到约 2177 tok/s。后续单、双卡测试都以这条内存路径作为基线。
单卡 vs 双卡结果

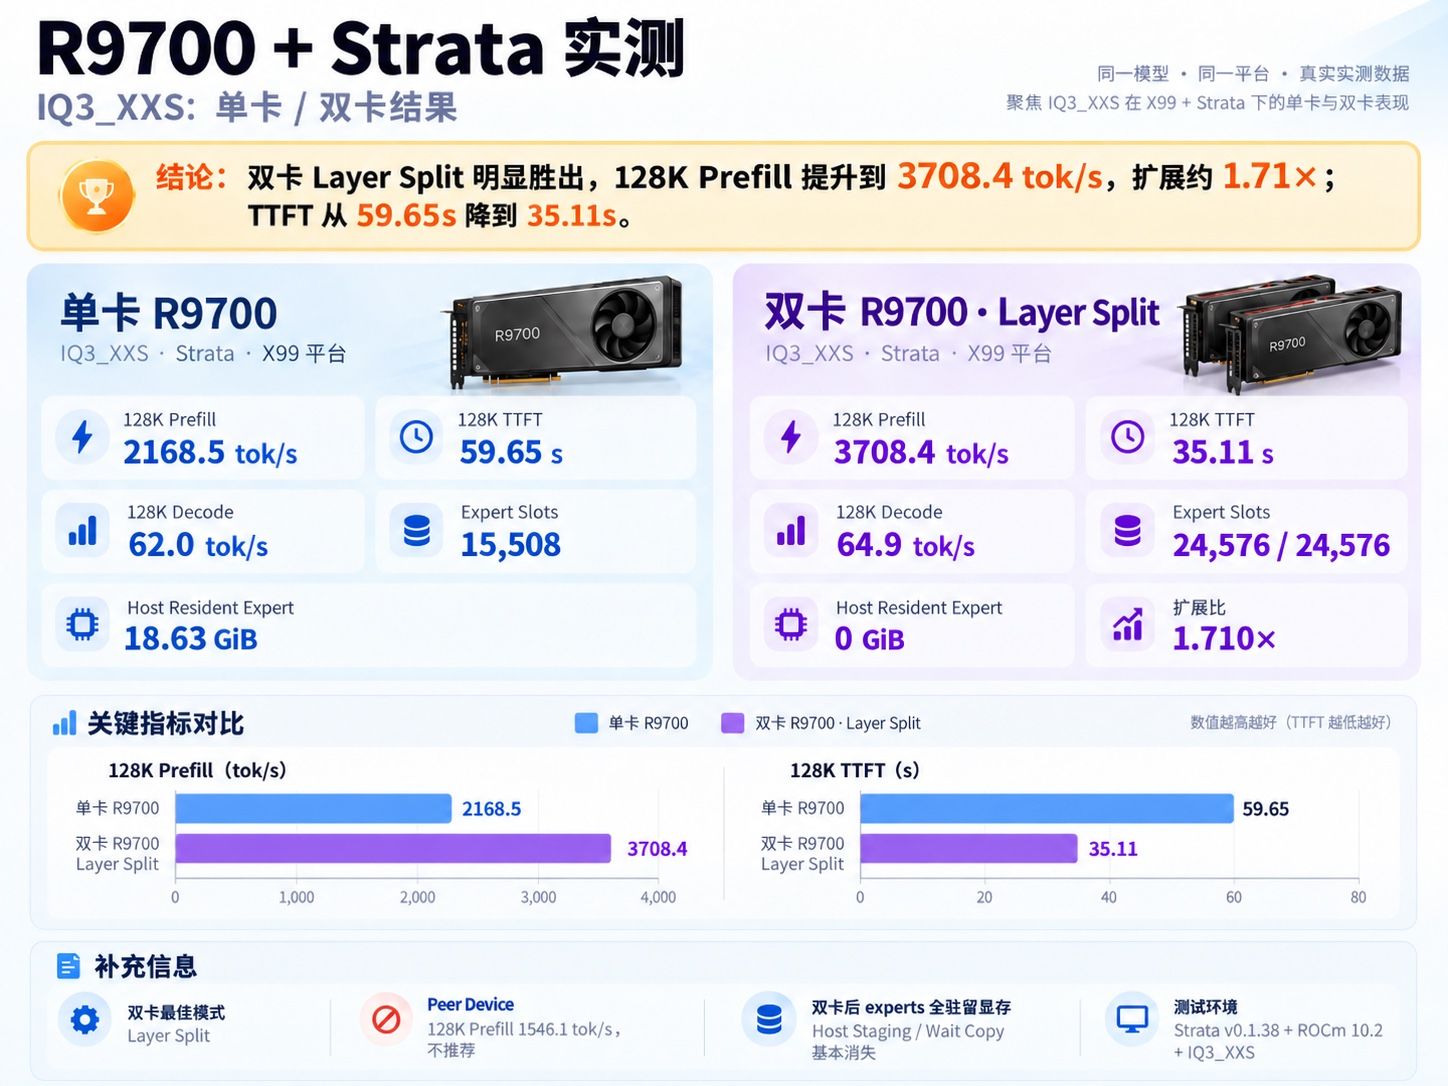
最直观的结果: 15K 下双卡提升约 20%,到了 128K,Prefill 从 2168.5 tok/s 提升到 3708.4 tok/s,扩展约 1.71×。
128K 下 TTFT 从 59.65 秒降到 35.11 秒,少了约 24.5 秒。对于需要不断追加上下文、反复 Tool Calling 的 Agent 工作流,这个变化比单纯 Decode 快几 tok/s 更有意义。
指标 单 R9700 双 R9700 / Layer Split 变化 15K Prefill ≈2140 tok/s 2586 tok/s ≈+20% 128K Prefill 2168.5 tok/s 3708.4 tok/s 1.710× 128K TTFT 59.65 s 35.11 s -24.54 s 128K Decode 62.0 tok/s 64.9 tok/s 基本无损 Expert Slots 15,508 24,576 / 24,576 100% 驻留 GPU Expert ≈25.15 GiB 39.96 GiB ↑ Host Resident Expert 18.63 GiB 0 GiB 完全消除 Host Staging ≈1.5 s 0 消失 Wait Copy ≈1.8 s 0 消失 128K Multi-Needle 5/5 PASS 5/5 PASS 一致 C1 / C2 / C3 PASS PASS 一致 当前 Layer Split 为 0–20 层 / 21–47 层。
这个 1.71× 不能简单理解成传统 TP2 的扩展效率。更准确地说,收益来自三部分叠加:更多 experts 驻留 GPU、Host 搬运基本消失、Layer Split 带来的跨卡流水执行。
Layer Split 与 Peer Device
两种双卡模式都做了实际测试:
模式 128K Prefill 相对单卡 Single 2170.3 tok/s 1.000× Layer Split 3699.3 tok/s 1.704× Peer Device 1546.1 tok/s 0.712× Peer Device 在我的平台上反而比单卡慢,因此后续双卡路线直接选择 Layer Split。
二、IQ3_XXS 与 IQ3_S 对比
这里主要想验证一个问题:IQ3_S 单卡更慢,是因为它占用更大、更多 experts 落到 Host,还是当前 Strata / ROCm / gfx1201 路径下本身就有更高的执行成本?
单卡与双卡的 128K 性能

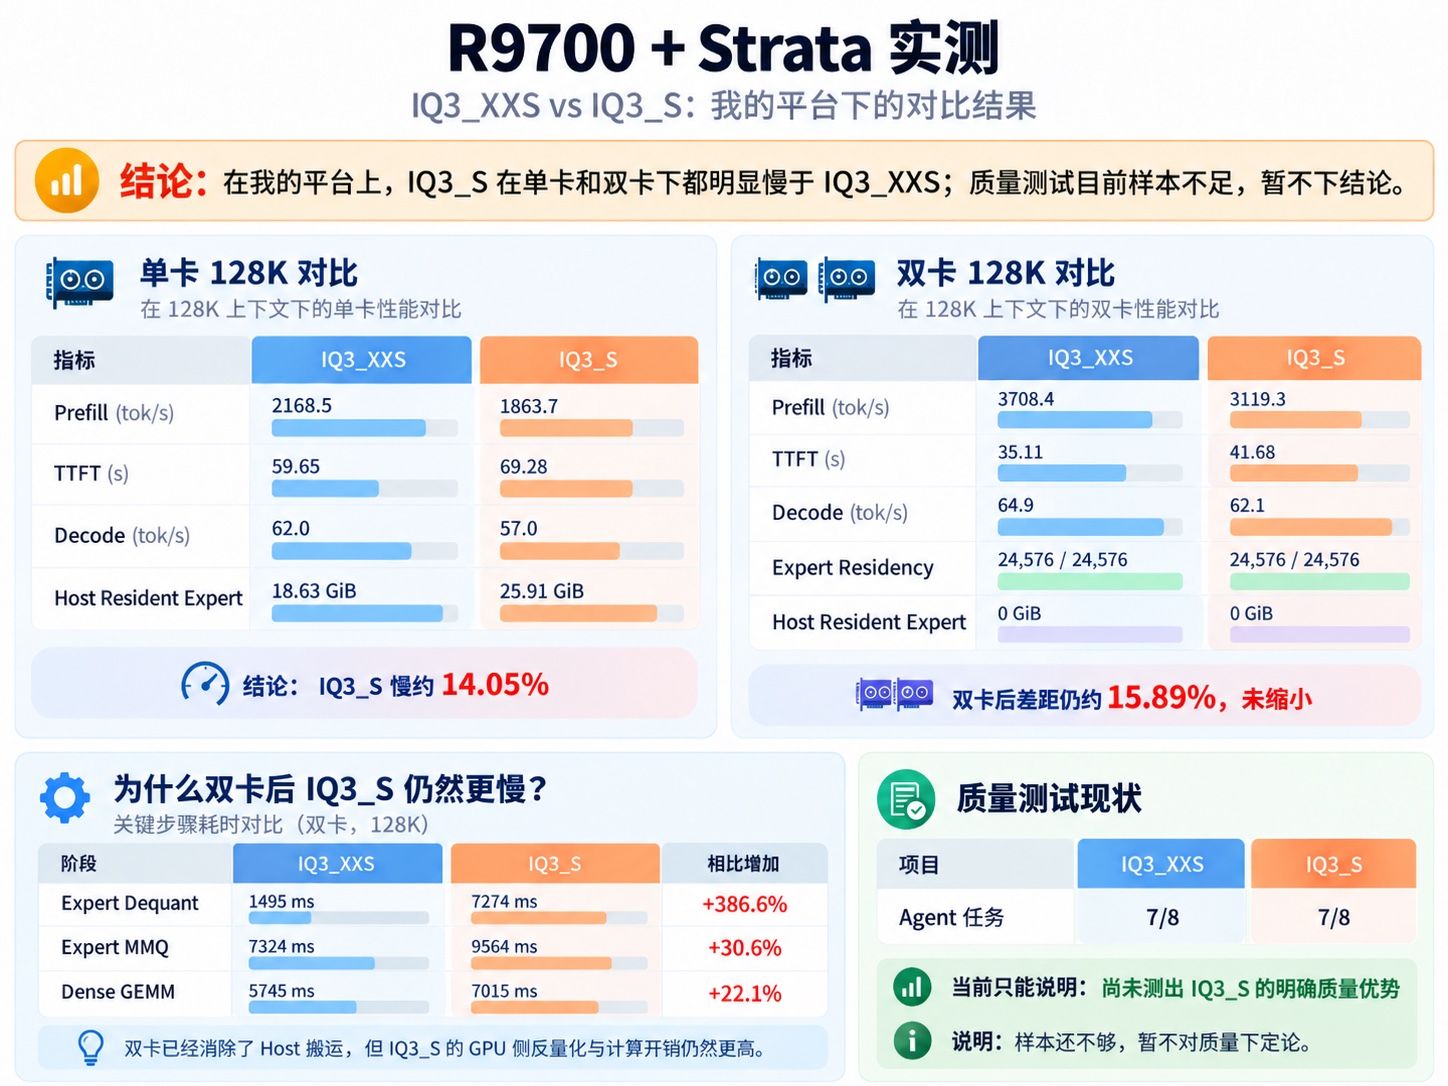
单卡时:
指标 IQ3_XXS IQ3_S IQ3_S 相对变化 15K Prefill 2140.2 tok/s 1833.9 tok/s -14.31% 128K Prefill 2168.5 tok/s 1863.7 tok/s -14.05% 128K TTFT 59.65 s 69.28 s +16.14% 128K Decode 62.0 tok/s 57.0 tok/s -8.06% Host Resident Expert 18.63 GiB 25.91 GiB IQ3_S 更高 单卡时 IQ3_S 的 Host Resident 更大,因此一开始的假设是:双卡如果把 IQ3_S 的 experts 全部放进显存,性能差距也许会明显缩小。
但双卡结果没有支持这个假设:
指标 Dual IQ3_XXS Dual IQ3_S IQ3_S 相对变化 15K Prefill 2586.1 tok/s 2182.0 tok/s -15.63% 128K Prefill 3708.4 tok/s 3119.3 tok/s -15.89% 128K TTFT 35.11 s 41.68 s +18.71% 128K Decode 64.9 tok/s 62.1 tok/s -4.39% Dual Scaling 1.710× 1.674× IQ3_S 略低 Expert Slots 24,576 / 24,576 24,576 / 24,576 均 100% GPU Expert 39.96 GiB 46.83 GiB +6.87 GiB Host Resident 0 GiB 0 GiB 一致 128K 最小可用显存 1.6 / 9.2 GiB 3.2 / 3.2 GiB 均安全 双卡已经把两种量化的 experts 都全部放进 GPU,IQ3_S 仍然慢约 15.9%。
Timing:差距主要出现在哪里
128K Timing IQ3_XXS IQ3_S 变化 Expert Dequant 1495 ms 7274 ms +386.6% Expert MMQ 7324 ms 9564 ms +30.6% Dense GEMM 5745 ms 7015 ms +22.1% Wait Copy 0 ms 100 ms 基本可忽略 因此目前可以确认的是:在 Strata v0.1.38 + ROCm 10.2 + gfx1201 这套实现下,IQ3_S 的 GPU-side execution path 存在明显更高的执行成本。
至于更底层究竟主要来自 quant format、packing、dequant、MMQ kernel、memory traffic 还是其他因素,目前没有继续做 kernel profiling,所以这里不做过度归因。
关于 IQ3_XXS 和 IQ3_S 的质量
这一部分目前测试还不够完善,我不打算下确定结论。
项目 IQ3_XXS IQ3_S Agent 任务 7/8 7/8 C1 Strict JSON PASS PASS C2 Tool Calling PASS PASS C3 Python Coding PASS PASS 128K Multi-Needle 5/5 5/5 这些结果只能说明:目前没有测出 IQ3_S 明显的质量优势。
但 8 个 Agent 任务样本太少,也不足以证明两者质量相同。真正可能拉开差距的,应该是复杂代码修复、多文件依赖、长链路推理、失败后的自我修正、复杂 Tool Calling、长上下文约束保持等更困难任务。
所以目前我的结论只限定在:
性能:IQ3_XXS 明显更好。
质量:证据不足,暂不判断 IQ3_S 是否更好。以后如果继续比较质量,会单独设计更大的高难度 Agent / Coding 测试集。
最终结果
项目 当前结果 单卡性能量化 IQ3_XXS 双卡性能量化 IQ3_XXS 双卡模式 Layer Split 单卡 128K Prefill ≈2168.5 tok/s 双卡 128K Prefill ≈3708.4 tok/s 双卡 128K TTFT ≈35.11 s 双卡 128K Decode ≈64.9 tok/s 双卡扩展比 ≈1.71× 双卡 Expert Residency 24,576 / 24,576 Host Resident 0 GiB Peer Device 当前平台不推荐 IQ3_S 性能 明显慢于 IQ3_XXS IQ3_S vs IQ3_XXS 质量 目前证据不足,暂不下结论 从这次测试来看,X99 虽然只有 PCIe 3.0,但在双 R9700、P2P / HIP IPC 正常、使用 Strata Layer Split 的情况下,128K Prefill 仍然从约 2168 tok/s 提升到 3708 tok/s。
对 Flash-Next 这种 expert residency 很重要的模型来说,第二张卡的价值并不只是增加算力,更重要的是把单卡放不下的 experts 从 Host 搬进 GPU。
以上数据仅代表我的 X99 + 双 R9700 + Strata v0.1.38 + ROCm 10.2 环境。不同 PCIe 拓扑、驱动、Strata 版本、ROCm 版本以及量化文件,结果都可能不同。
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战关于SGLang TP2 + DFlash2 的测试情况,麻烦老特 @Terry 帮忙添加的主帖上。后续关于x99 双卡的测试情况都索引到这个帖子。方便大家查看。
X99 打通双 R9700 P2P 后:SGLang TP2 + DFlash2 实测
https://lcz.me/topic/2036 -
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战尋求大老給問,我目前有2台洋垃圾,就差在顯卡與電源供應器。
也可以建置嗎?處理器 雙路 Intel Xeon E5-2696 v4
主機板 HUANANZHI X99 F8D
記憶體 海力士DDR4-2133 128GB
顯示卡 2080ti / 3060
電源 750w /850w双路 E5-2696 v4 + X99 F8D + 128GB 内存本身没有明显问题,不过如果想跑双卡,关键不在 CPU 和内存,而是在 主板 PCIe 拓扑。
不同 X99 双路板的 PCIe 插槽可能分别挂在不同 CPU / Root Port 下,所以目前还不能只看型号就确定 P2P 一定能打通。
你可以先在这台 F8D 上执行:
lspci -tv
让AI来评估是否可以打通P2P
另外,电源建议多打出一些余量,双卡至少1000w以上。我的双r9700,用振华1300w电源,几乎满功率300w运行5.5小时,非常稳定。
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@Terry 这几天在调试单卡和双卡跑strata,跑完发给帖子
-
R9700单卡 Strata Qwen3.8-Flash-Next 125B 部署与Qwen3.8-27b-MXFP4对比感谢这么详细地整理,信息很有帮助。我这边先把目前能确认的说一下:
decode expert cache hit rate:我这边近期稳定在 98%~99% 左右,最新 ROCm 10.2 测试大约 99.0%~99.1%。
expert arena / hugetlb:我之前主要走的是 resident-cpu-experts 路径,和你这套完整 pinned expert arena 不完全一样。我需要回头核一下启动日志里有没有 MAP_HUGETLB / 4 KB pages 的明确记录。
prompt path borrow slots:这个我也准备从原始日志里把准确数字找出来再对比。
另外提供的这几组 fresh prefill 日志,大多在 650–900 tok/s 左右,和我之前测试 IQ3_S 的结果其实已经比较接近了。
方便的话,再请教一下原帖里大约 15K = 1191 tok/s 那次对应的原始日志,主要想确认是不是也是同一套启动参数和运行状态。
-
R9700单卡 Strata Qwen3.8-Flash-Next 125B 部署与Qwen3.8-27b-MXFP4对比感谢分享,这个测试对我很有参考价值。我这边也是 R9700 + Strata v0.1.34 + TheRock 7.10,最近在复现你的 Prefill 数据。
方便的话想请教几个细节:
你的 Strata 是官方 v0.1.34 原版吗?能否提供一下 commit SHA / 是否有本地 patch?
Prefill 时有设置 STRATA_PREFILL_ISSUER、STRATA_HIP_WMMA、STRATA_RESIDENT_PIN 或其他 STRATA_* 环境变量吗?
expert 是 --mmap-experts --resident-cpu-experts 这一路径吗?
测 PP 时能否确认 reused_tokens=0,也就是每次都是完整 fresh prefill?
我这边同机对比后,IQ3_S 反而比 IQ3_XXS 慢一些,主要差在 expert copy wait,所以比较想确认是不是运行参数或 expert 搬运路径还有差异。
再次感谢分享,如果方便贴一下实际启动参数就更好了。
-
X99 打通双 R9700 P2P 后:SGLang TP2 + DFlash2 实测先说结论
这次测试的前提是:
X99 平台上的两张 Radeon AI PRO R9700 已经先打通 P2P,再进行 SGLang TP2 测试。
基于目前已经完成的测试,可以确认:
- X99 + 双 R9700 在 P2P 打通后可以实际运行 SGLang TP2。
- 在后续正式的对比中,Plain / MTP / DFlash2 使用的是同一个
Qwen/Qwen3.8-27B-FP8target,因此这组 8K / 32K / 64K 数据可以用于比较三种 decode 路径。 - DFlash2 相比普通 MTP:
- 8K:
42.29 → 51.44 tok/s,约 1.22× - 32K:
45.32 → 55.39 tok/s,约 1.22× - 64K:
28.60 → 59.81 tok/s,约 2.09×
- 8K:
- 后续单独对 FP8 + DFlash2 做完整长上下文 characterization 时,192K decode 中位数为 33.75 tok/s。
- 当前已经完成 224,000 input tokens 的单次容量验证,HTTP 200、输出正确,两张 GPU 都有持续计算活动。
- 当前这套 DFlash2 TP2 runtime 中,
/v1/models可报告max_model_len=262144,但 R8N 日志中实际 request admission ceiling 为 227701 tokens。因此本文只声称 224K 已验证,不声称 256K 已验证。 - 同样的
Qwen/Qwen3.8-27B-FP8 + DFlash2在单张 R9700 32GB 上无法完成初始化,OOM 发生在 DFlash draft worker 权重构造阶段,因此目前没有严格 apples-to-apples 的 TP1 / TP2 吞吐 scaling 数据。
另外需要说明:
我此前也测试过
shawnw3i/Qwen3.8-27B-AWQ-MTP路线,并尝试过在 AWQ target 上挂 DFlash2。那属于更早阶段的探索,不是本文 P5B-R 里 51.44 / 55.39 / 59.81 这组 DFlash2 数据。本文会把两条路线分开写,避免混淆。
一、测试平台与 P2P 前提
硬件环境
CPU:
Intel Xeon E5-2697A v4

RAM:
128GB DDR4

主板:
华南金牌X99-TF GAMING V6.0

GPU:
2 × AMD Radeon AI PRO R9700 32GB

本文后续所有双卡 TP2 数据,均是在:

X99
+
双 R9700
+
P2P 已打通
+
SGLang TP2
这一前提下取得。
此前已经单独完成过双卡 P2P / HIP IPC 验证,参加帖子 https://lcz.me/topic/1925/52 X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战
本文不重复讨论 P2P 打通方法,只讨论打通之后的 SGLang TP2 与 DFlash2 表现。
需要区分:
- P2P 是否打通:属于双卡通信前置条件;
- 两张卡是否真的参与同一次 TP2 推理:后续通过运行时状态及 AMD-SMI 按 PCI BDF 的活动采样进行确认。
二、权重口径:AWQ 早期路线与后续 FP8 路线要分开
这一点是整篇帖子最需要避免混淆的地方。
1. 早期 AWQ-MTP 路线
上一个帖子曾经使用:
shawnw3i/Qwen3.8-27B-AWQ-MTP进行 MTP / speculative 相关探索。
也尝试过:
shawnw3i/Qwen3.8-27B-AWQ-MTP
+
DFlash2 draft
但这一阶段属于更早的 AWQ 路线测试。
本文后面引用的 51.44 / 55.39 / 59.81 tok/s,不是这条 AWQ + DFlash2 路线的数据。
因此:
shawnw3i/Qwen3.8-27B-AWQ-MTP只作为早期历史路线说明,不和后面的FP8 数据混在一起。
2. MTP / DFlash2 正式对比
后续 DFlash2 测试正式对比统一使用:
Target:
Qwen/Qwen3.8-27B-FP8
三种运行方式分别是:
Plain
Qwen/Qwen3.8-27B-FP8
无 speculative decoding
MTP
Qwen/Qwen3.8-27B-FP8
+
MTP
DFlash2
Target:
Qwen/Qwen3.8-27B-FP8

Draft:
z-lab/Qwen3.8-27B-DFlash2
因此本次测试的:
Plain vs MTP vs DFlash2是在同一个 FP8 target 下完成的对比。
这组数据才是本文用于判断 DFlash2 相对普通 MTP 效果的主要依据。
3. 后续 DFlash2 characterization
后续 8K / 32K / 64K / 128K / 192K 的完整 characterization,以及 224K capacity probe,继续统一使用:
Target:
Qwen/Qwen3.8-27B-FP8

Draft:
z-lab/Qwen3.8-27B-DFlash2
因此后半部分的 DFlash2 数据也是同一条 FP8 + DFlash2 路线。
三、后续 FP8 + DFlash2 测试的启动条件
后续独立 DFlash2 characterization 使用的核心运行条件如下。
SGLang:
0.5.18 + RDNA4 patch

Image:
sglang-rdna4-production:v0.5.18-r1

Image ID:
sha256:bea0f21f6e2ebcac99274b3f14f271281bf1249111840d9798542f3383191b49

Patch SHA256:
2f78d14d12787d029453671979229a4a26a6c2b3ccd732b422754a2c82f99cce

Frozen launch SHA256:
15f266c4934d89cf6463422b768446341edf3292ed6bbec0b36575e691223a47

Target:
Qwen/Qwen3.8-27B-FP8

Draft:
z-lab/Qwen3.8-27B-DFlash2

Tensor Parallel:
2

GPU count:
2

GPU BDF:
0000:05:00.0
0000:08:00.0

KV cache dtype:
FP8 e4m3

DFlash2:
ON

BN:
32

SSM precision:
FP32

ReplaySSM:
OFF

Default thinking:
enable_thinking=false
Context 配置
完整 8K–192K characterization 阶段使用的是当时冻结的常规测试配置。
后续为了验证 200K 以上容量,只对测试用 TP2 runtime 的 context cap 做了临时调整,其它核心模型和 DFlash2 条件保持不变。
/v1/models max_model_len:
262144
但 229000-token 请求被 SGLang 拒绝,日志给出的实际 request admission ceiling 为:
227701 tokens随后使用:
input tokens:
224000

max output tokens:
128
完成单次成功验证。
测试结束后,临时 context 调整已撤销,launcher 已恢复原状态。
四、Plain / MTP / DFlash2 同一 FP8 Target 对比
这一组是本文最重要的性能对比。
三种模式的 target 都是:
Qwen/Qwen3.8-27B-FP8同时:
TP:
2

KV:
FP8 e4m3
DFlash2 模式额外挂载:
z-lab/Qwen3.8-27B-DFlash2实测 decode:
Context Plain MTP DFlash2 DFlash2 / MTP 8K 21.48 tok/s 42.29 tok/s 51.44 tok/s 1.22× 32K 19.21 tok/s 45.32 tok/s 55.39 tok/s 1.22× 64K 16.82 tok/s 28.60 tok/s 59.81 tok/s 2.09× Plain → MTP
MTP 本身已经带来明显提升。
例如 32K:
Plain:
19.21 tok/s

MTP:
45.32 tok/s
MTP → DFlash2
DFlash2 在同一个 FP8 target 下继续提高 decode。
8K:
42.29 → 51.44 tok/s
≈ 1.22×
32K:
45.32 → 55.39 tok/s
≈ 1.22×
64K:
28.60 → 59.81 tok/s
≈ 2.09×
因此在这组同 target 测试里,可以直接说:
DFlash2 相比普通 MTP 有明确提升。
但也需要注意:
这三个倍数是对应这组具体 workload 的实测结果,不应直接外推为所有 prompt、所有输出类型下都固定存在相同倍数。
Speculative decoding 的实际速度仍然会受到:
accept rate
accept length
verify latency
等因素影响。
五、FP8 + DFlash2 完整长上下文 characterization
后续重新固定了一套 benchmark workload,对 FP8 + DFlash2 单独进行完整长上下文测试。
当前结果:
Context Decode Prefill TTFT E2E 8K 40.78 tok/s 1747.70 tok/s 4.69s 4.96s 32K 40.00 tok/s 1499.38 tok/s 21.85s 23.28s 64K 35.48 tok/s 1248.14 tok/s 52.51s 52.82s 128K 34.38 tok/s 929.67 tok/s 140.99s 142.64s 192K 33.75 tok/s 739.79 tok/s 265.76s 267.33s 从这组数据本身看:
8K      40.78 tok/s
32K     40.00 tok/s
64K     35.48 tok/s
128K    34.38 tok/s
192K    33.75 tok/s
8K 到 192K 的 decode 下降约 17%。
Prefill:
8K      1747.70 tok/s
32K     1499.38 tok/s
64K     1248.14 tok/s
128K     929.67 tok/s
192K     739.79 tok/s
需要特别注意:
这组 40.78 / 40.00 / 35.48 / 34.38 / 33.75 不能直接和之前的 51.44 / 55.39 / 59.81 做“版本性能回归”判断。
因为两轮:
- prompt 不同;
- output workload 不同;
- cache 状态不同;
- benchmark harness 不同;
- streaming / timing 方法不同。
所以两组数据用途不同:
- 前面一组:Plain / MTP / DFlash2 同 target 对比;
- 后续 characterization:观察 FP8 + DFlash2 自己的长上下文性能曲线。
六、224K 单次容量验证
在完成 192K benchmark 后,又继续验证更长输入。
R8N-1 最终只发送一次长请求:
Actual input tokens:
224000

Max output tokens:
128
服务器报告:
prompt tokens:
224000

HTTP:
200

output:
READY

TTFT:
330.757s

E2E:
330.872s
GPU 采样:
GPU 05:
319 samples
GFX average = 100%
GFX peak = 100%

GPU 08:
319 samples
GFX average = 100%
GFX peak = 100%
峰值显存:
GPU 05:
30132 MB

GPU 08:
29849 MB
请求期间未发现:
OOM
GPU reset
GPU hang
HIP fatal
page fault
因此可以直接确认:
X99 双 R9700 P2P + SGLang TP2 + Qwen/Qwen3.8-27B-FP8 + DFlash2 已经实际完成 224,000-token 输入。
这里的 224K 是 server-reported prompt tokens,不是文本长度估算值。
七、为什么本文不写“256K 已验证”
R8N 中:
/v1/models:
max_model_len = 262144
但:
229000-token input被 SGLang request layer 拒绝。
日志给出的实际 request ceiling:
227701 tokens所以目前有三个不同数字:
模型报告 max_model_len:
262144

当前 DFlash2 TP2 runtime 已知 request ceiling:
227701

最高实际成功验证 input:
224000
它们不能混为一谈。
本轮测试只证明:
当前 runtime 能接收并完成 224K;229K 超过了当时 runtime 给出的 admission limit。
至于:
262144 → 227701中间的差额究竟有多少来自:
DFlash2 draft
draft KV
target KV
token pool
其它 runtime reservation
本文并没有逐项隔离,所以不把它写成已证明的单一因果关系。
因此本文不会声称:
双 R9700 硬件最多只能 227.7K也不会声称:
DFlash2 固定只能到 227.7K准确结论只有:
当前这套冻结 DFlash2 TP2 runtime 实测成功到 224K,R8N 日志给出的 admission ceiling 为 227701 tokens。
八、为什么没有 TP1 性能对比
原计划还想做:
TP1 DFlash2
vs
TP2 DFlash2
计算第二张 R9700 带来的纯 throughput scaling。
但是严格相同的 FP8 + DFlash2 stack 在单卡上无法完成启动。
TP1 使用:
GPU:
1 × R9700 32GB

TP:
1

Target:
Qwen/Qwen3.8-27B-FP8

DFlash2:
ON
分别尝试:
32K
64K
128K
三档都在启动阶段 OOM。
32K 的典型状态:
GPU total:
31.86 GiB

allocated:
31.41 GiB

free:
112 MiB

next allocation:
170 MiB

result:
OOM
64K、128K 的失败点和显存状态基本一致。
后续初始化顺序审计确认:
OOM 发生在 DFlash draft worker 权重构造阶段。
此时:
KV pool
attention backend
CUDA/HIP graph
都还没有初始化。
因此可以确认:
32K / 64K / 128K 全部失败并不是上下文长度本身导致的,而是当前 FP8 target + DFlash2 stack 在单张 32GB R9700 上无法完成初始化。
所以目前没有合法的:
TP2 / TP1 decode speedup可以计算。
如果为了获得 TP1 数字而改:
模型精度
权重量化
offload
CPU spill
那就已经不是同一个测试对象。
九、这组测试实际说明了什么
1. X99 打通 P2P 后,双 R9700 TP2 可以实际工作
本文不是只验证:
系统识别两张 GPU而是在真实长上下文请求期间观察两张卡的运行活动。
224K 请求:
05:00.0:
319 个 1 秒样本
GFX 平均 100%

08:00.0:
319 个 1 秒样本
GFX 平均 100%
因此至少对于这套机器,可以确认:
X99 老平台在 P2P 打通以后,可以承载实际双 R9700 TP2 推理。
2. DFlash2 对同一个 FP8 target 的提升明确存在
P5B-R:
Target:
Qwen/Qwen3.8-27B-FP8
实测:
8K:
MTP 42.29
DFlash2 51.44
≈1.22×

32K:
MTP 45.32
DFlash2 55.39
≈1.22×

64K:
MTP 28.60
DFlash2 59.81
≈2.09×
这一组可以用于直接比较:
同一个 FP8 target 下,普通 MTP 与 DFlash2 的实际表现。
3. FP8 + DFlash2 的长上下文能力已经实际验证到 224K
正式 characterization:
192K decode:
33.75 tok/s
单次 capacity probe:
224000 input tokens:
PASS
因此这里不只是模型配置上“允许长上下文”,而是真实请求已经跑过。
4. 双卡首先解决的是容量问题
单卡:
Qwen/Qwen3.8-27B-FP8 + DFlash2
→ draft worker 初始化 OOM
双卡:
X99 + P2P + TP2
→ 正常启动
→ 192K benchmark 完成
→ 224K request 完成
因此这套 stack 上第二张 R9700 的第一层价值是:
让完整 FP8 + DFlash2 从单卡无法初始化,变成双卡可以正常运行长上下文。
至于纯粹 TP1 → TP2 的 throughput scaling,因为 TP1 同配置没有可运行基线,目前不能给出严谨数字。
-
AMD AI Pro R9700 + 洋垃圾CPU + DDR3内存 VS RTX Pro 4000 + 9800 X3D + DDR内存, 学习AI大模型 生成视频选择谁?如果是华南金牌送的6铜管风扇,不会挡内存
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@Terry 已加到签名栏。
正在测试dflash2,目前看比mtp的decode要更快,还在调试参数
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@PhoenixRise2026 可以继续优化,或许可以出个github项目,这玩意还挺重要的。
谢谢老特提醒,创建了个项目,需要的兄弟们可以参考,也是第一次为社区做点贡献。
https://github.com/PhoenixRise2026/x99-amd-gpu-p2p -
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战@PhoenixRise2026
又看了一遍这个帖子,老哥牛逼了。看来RDNA4的驱动你在sglang里面搞定了,就像版主说的,由于SGlang优秀的缓存机制,其实pp这一块重要性没有那么高,那你可以考虑把dflash2给加进去吗?这样的话,这个蛋疼的tg速度就可以解决了。SGlang本身是支持的。
你要是把这个也搞定的话,那你基本上功德无量了

这两天懈怠了,十一前把dflash2测了
-
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
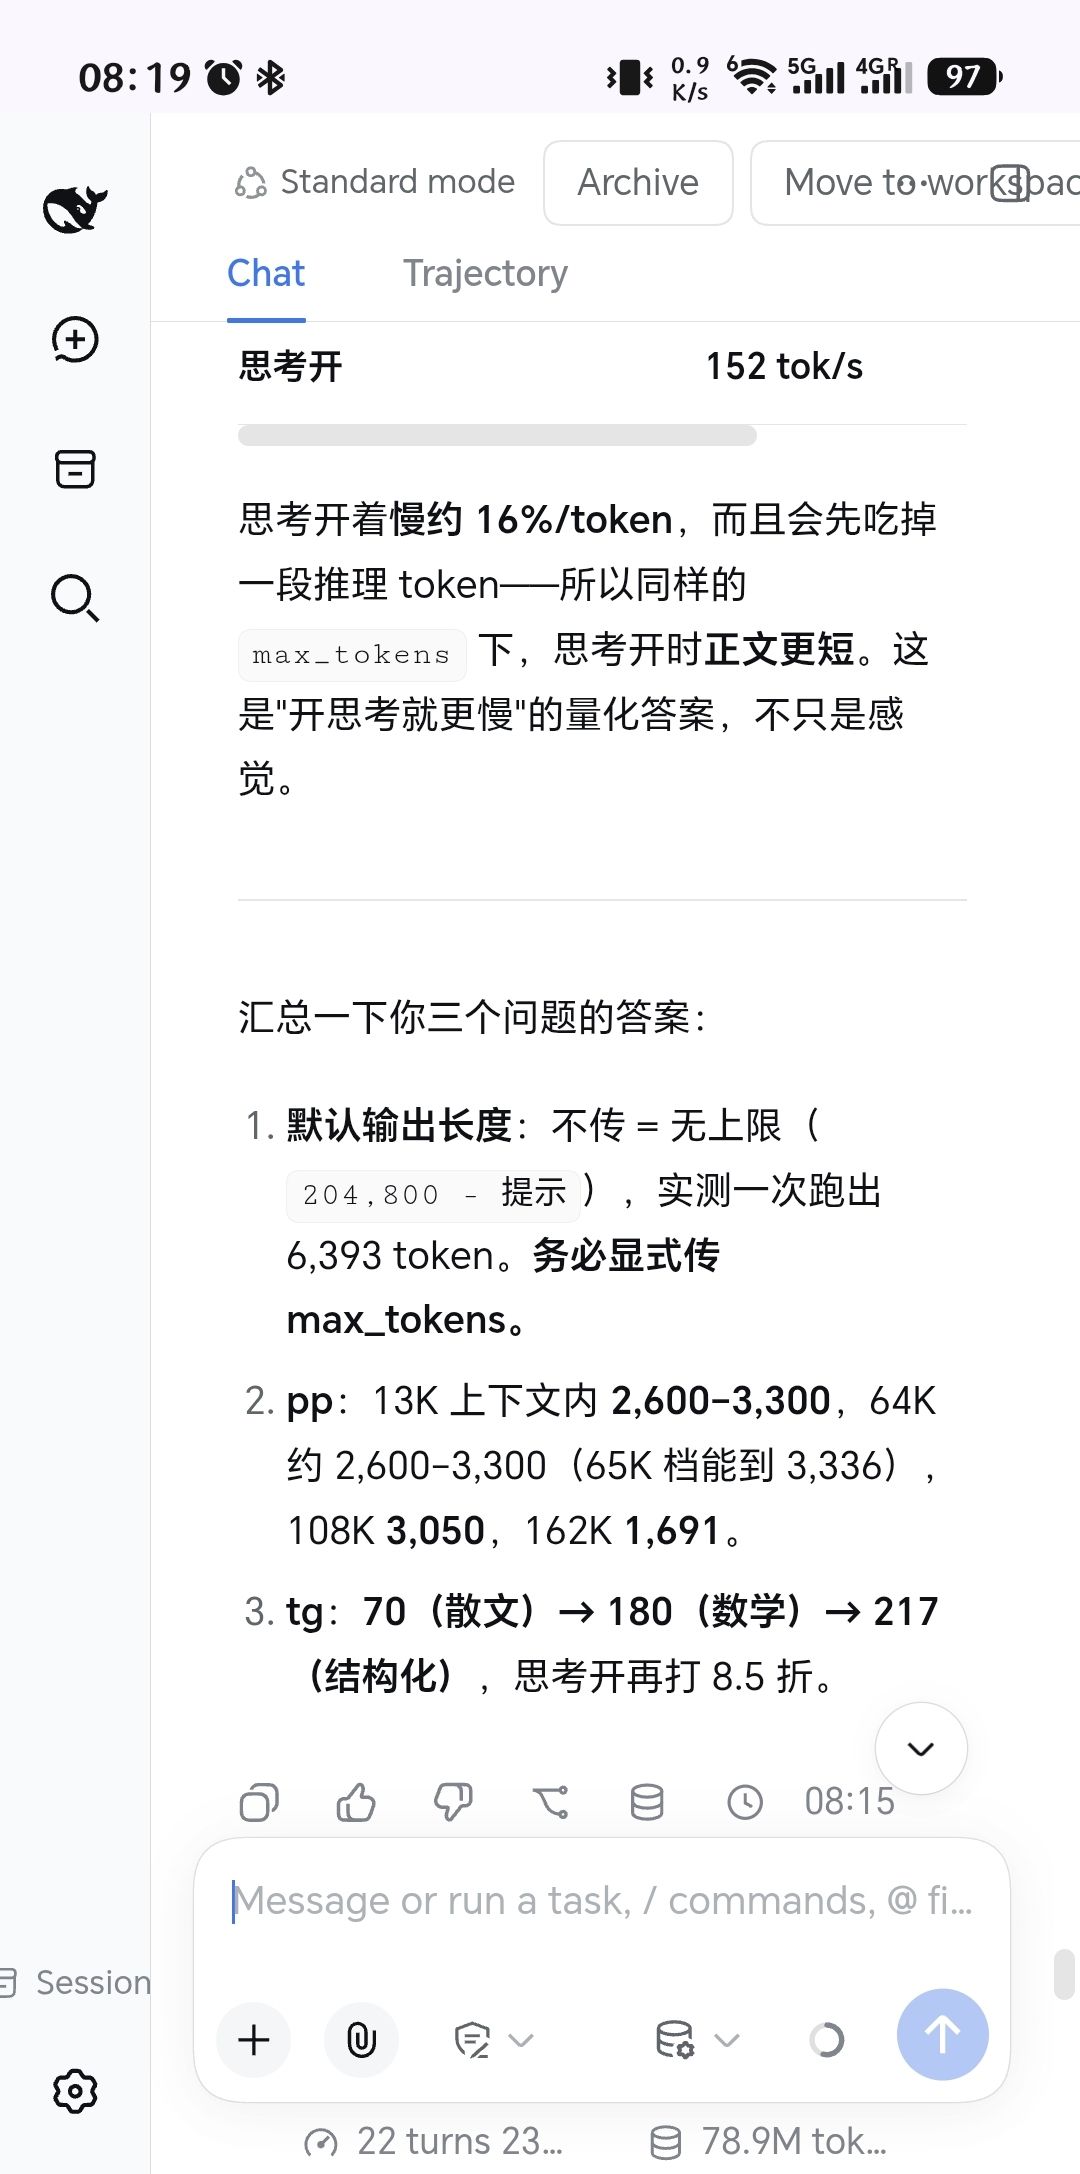
Paiton 单卡确实很强,这个后面有时间我也会测。
我这篇主要验证的是 X99 双 R9700 的 P2P 可行性和双卡 scaling,SGLang 只是目前先跑通的 serving stack。现在这些 PP/TG 数据主要看单卡→双卡提升,不是在做 SGLang vs vLLM 横评。
后续会补 vLLM/Paiton,同模型同参数下再比较。 -
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战谢谢老特肯定。打通P2P和调试SGLang的过程都是Agent来操作的,包括内核编译、遇到问题寻找解决方法。5.5小时双卡几乎满功率推理测试,没有出现问题。
-
我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。没关系,只是讨论而已,但是我看见你开启P2P 性能并没有释放很高。
不知道是模型的问题,还是调优的问题。这些你都试过吗?tcclaviger/Qwen3.8-27B-DFlash2-FP8
https://github.com/magiccodingman/vllm-radiance
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
按双卡 R9700的算力 80token/s 才算比较正常。而且低于80 token/s ,基本没法干活。
目前只是证明了在X99上把双 R9700 Direct P2P 真正跑通,后面有时间会测一下DFlash2、vllm-radiance。
-
我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。 -
X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战更正一下原帖里的一个表述:
我之前写“不同 CPU Root Port”不够准确。我的机器是单路 E5-2697A v4,两张 R9700 都挂在同一颗 CPU / 同一 PCIe Root Complex 下,只是分别接在不同的 PCIe Root Port 上。
所以文中“跨 Root Port P2P”应理解为:
同一 CPU、同一 Root Complex 下,不同 Root Port 之间的 P2P,并不是跨 CPU / 跨 Socket。
原帖已不能编辑,这里补充更正,避免误导。 -
我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。我没看懂你的帖子,如果是单路 CPU E5 系列,两个GPU 应该是挂在一个root complex 下啊?怎么还会跨 Root Port P2P?
这颗CPU :Intel Xeon E5-2697A v4 支持P2P. 一颗CPU 怎么会挂在不同的 Broadwell Root Port ?
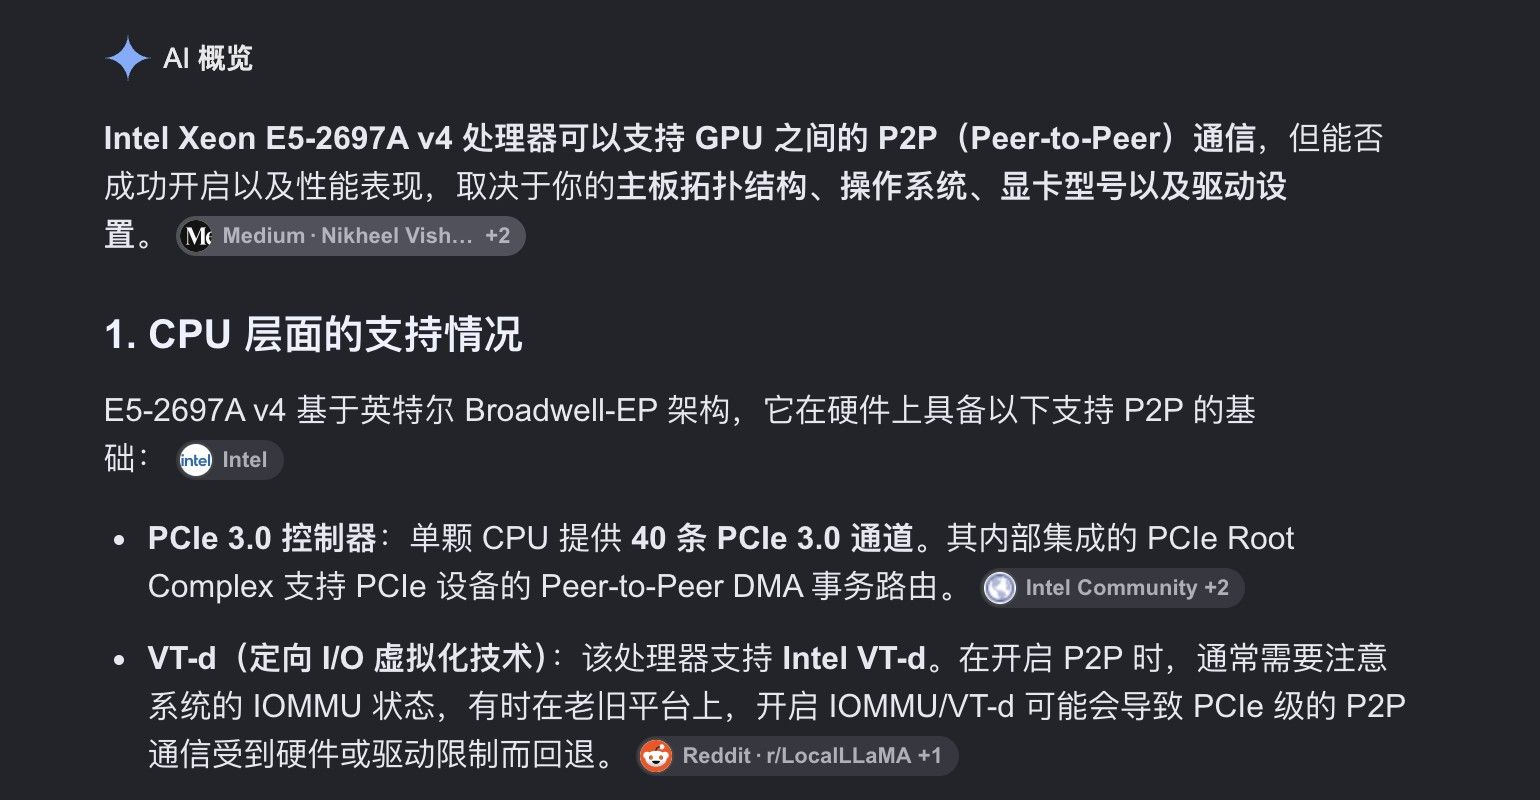
谢谢指出问题。是我帖子里“不同 CPU Root Port”这个说法不严谨。
我的机器是单路 E5-2697A v4,两张 GPU 都挂在同一颗 CPU 下,只是分别接在这颗 CPU 的不同 PCIe Root Port 上。
所以这里说的“跨 Root Port P2P”是同一 CPU、不同 Root Port 之间的 P2P,不是跨 CPU。 -
我之前也以为 X99 基本没法搞 P2P,不过最近在 E5-2697A v4 + X99 + 双 R9700 上实际折腾下来,已经把跨 Root Port 的 Direct P2P 跑通了。