跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Ray WangR

Ray Wang

@Ray Wang
体面乡绅
取消关注 关注
关于
帖子
40
主题
6
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 洋垃圾的回乡路 —— 2x3090 + X99 + 2x2680v4
    Ray WangR Ray Wang
    装备秀 x99 rtx3090

    以下大部分是比较罗嗦的流水账,技术内容在分割线后。

    前阵子入坑了本地AI。手上有两张3090,但是自己用的机器机箱、电源只够跑一张。而且平时要打打游戏,用Adobe系列软件,需要占用显卡,来回释放显存也很麻烦。想着再配一台电脑吧,但是看了看现在内存、SSD的价钱,还是算了吧。
    77d10cff-dfa1-4e4f-8123-4a340e91a469-99ab7faab906937db2d43e200019ccbc.jpg

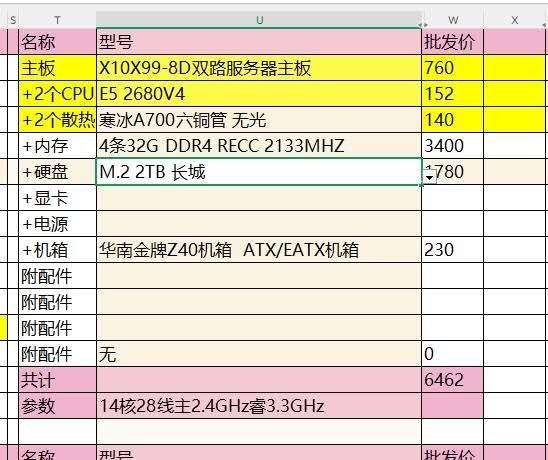
    后来看了牢特视频,了解到了洋垃圾的世界。果断某东搜索华南金牌,到官方店下单了一整套X10X99套餐,带两个U,4x32G ECC拆机条,一个2TB长城NVME,总共6000(机箱散热器这些重的大的东西就没买了)。说实话玩洋垃圾似乎有点小贵,但是比起在美国装新机器还是便宜太多了,而且将来淘汰下来还可以跑我那一堆乱七八糟的docker服务。虽然美国Aliexpress也有X99套装,但是买着感觉就是不如京东旗舰店放心。又花了700元子运到了美国,大概一个星期就到了。
    e4d5a08f-cafd-4db5-a017-7b15a298d241-eda36dbeb1f234fb7695b3f90b3eb730.jpg

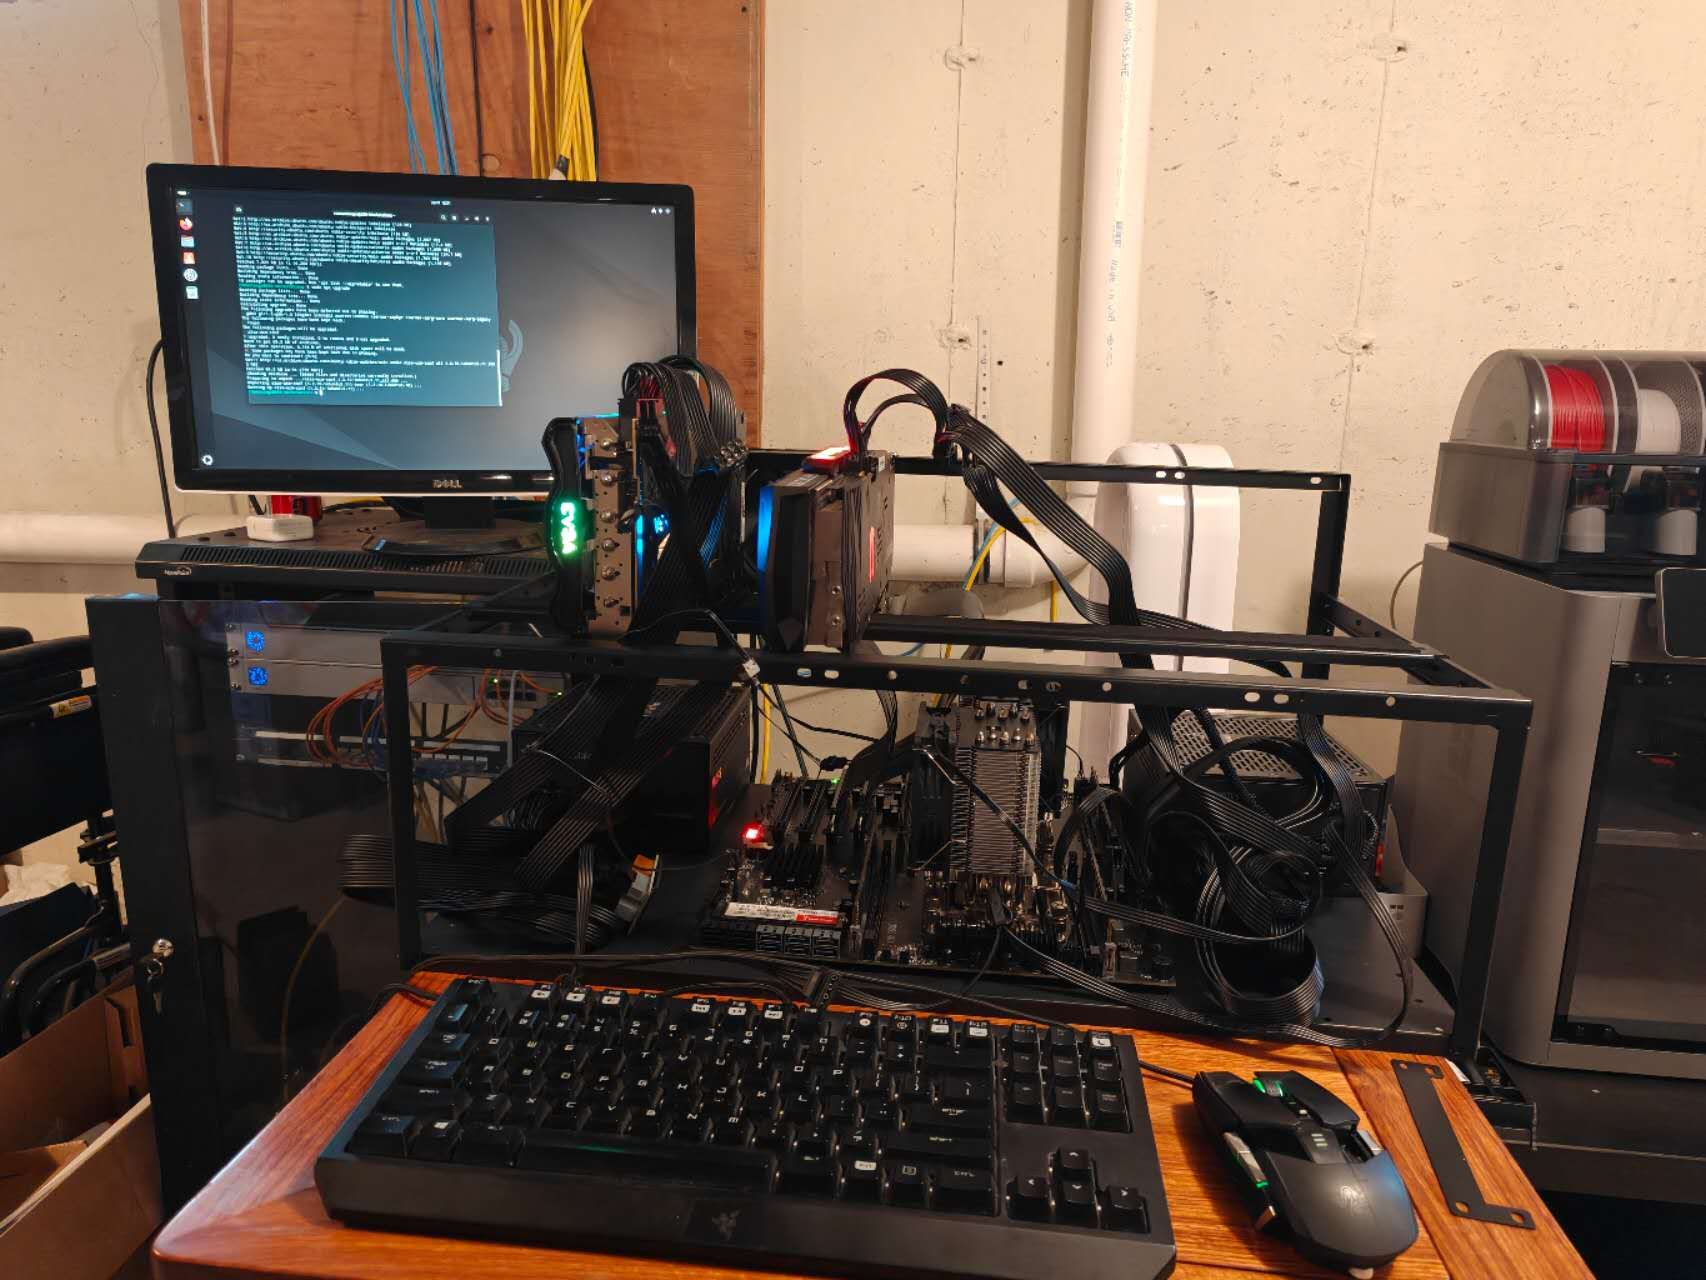
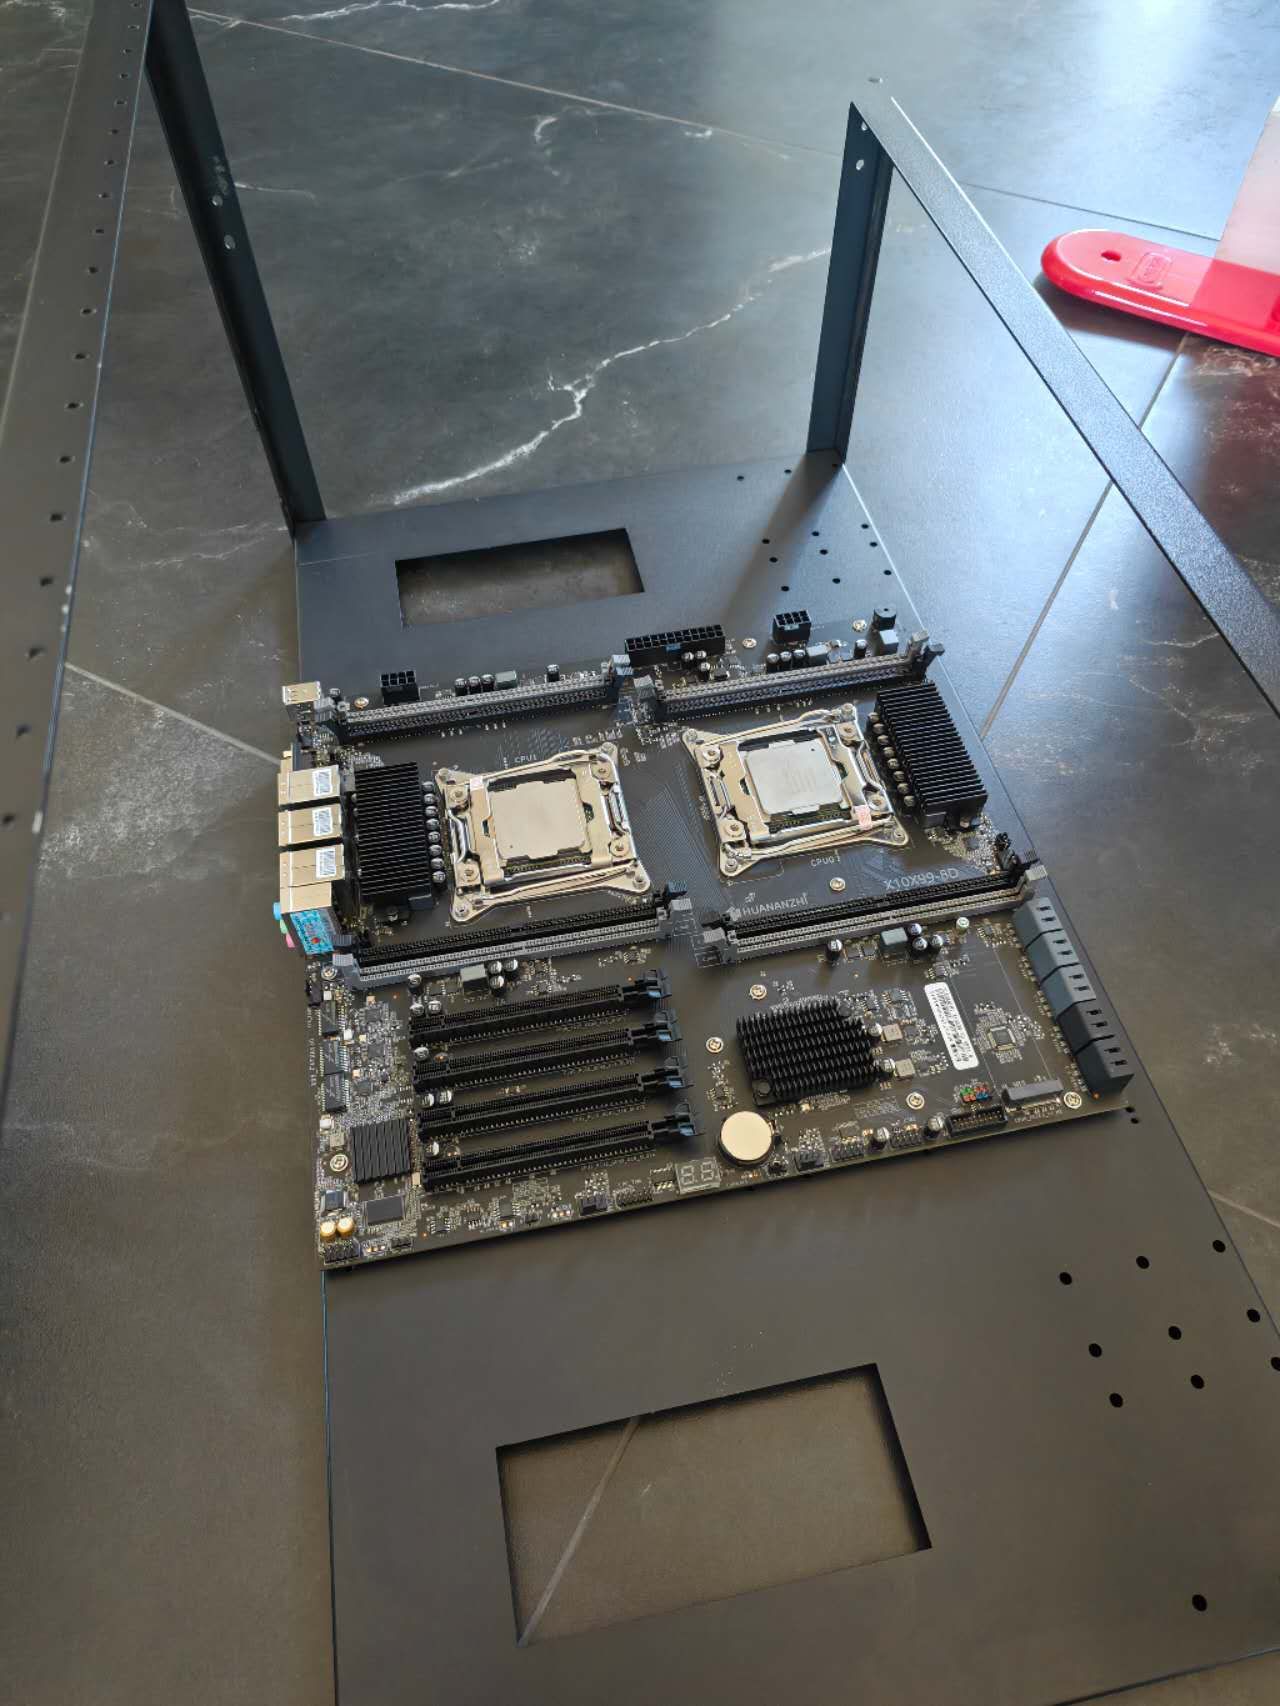
    两个洋垃圾当年不远万里离开了北美机房温柔乡,被送到了深圳冰冷的仓库里,现在终于回到了家乡的温暖怀抱。我把几年前挖矿用的开放式机架和两个电源废物利用,给他搭了个窝...
    3e086e4c-6619-4f03-b2e1-850bed6ed23b-17ef967d0a90eb439414c6534c580730.jpg

    77d10cff-dfa1-4e4f-8123-4a340e91a469-99ab7faab906937db2d43e200019ccbc.jpg

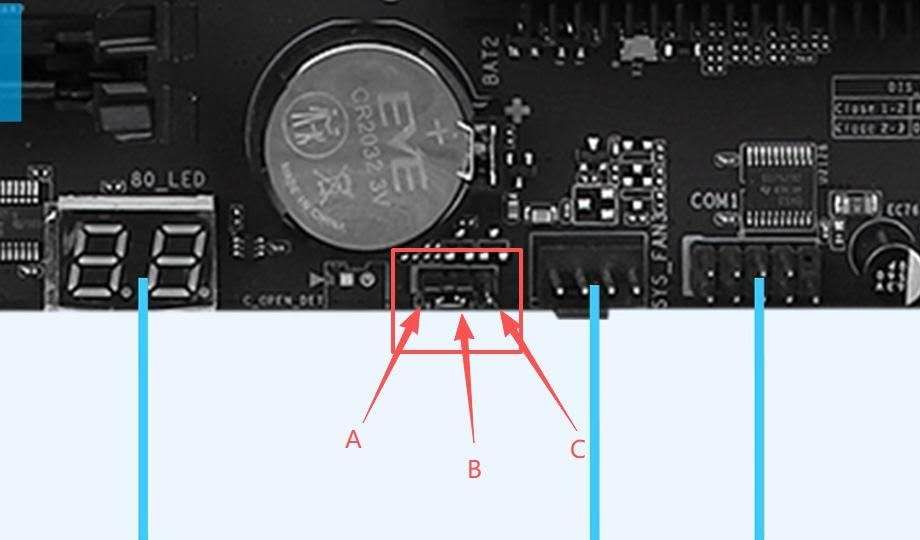
    装机一切都算顺利,只是到最后就是不POST,主板报"Ad"码。售后小哥跟我一起排查了一遍,4条内存8个插槽排列组合搞了一遍也没点亮屏幕。最后发现是因为显示器接的是HDMI,主板上有个3针跳帽负责切换显示模式。插在AB上面是VGA,把它给换到BC上面屏幕就成功亮了... 华南金牌东西是挺好的,就是说明书完全没用,不知道将来会不会对其他人有所帮助。
    d59dea89-6e5a-4186-b2f8-8a038942e430-1cbbc8acfc06938991fd0805583723f6.jpg

    接下来就是装Ubuntu,装各种必要的软件,然后就是跑分了。

    ================================分割线================================

    直接跑Github上 club-3090 的懒人包,以前我都是跑单卡的,现在终于能跑双卡了。用的是vllm,AutoRound INT4 量化,FP8 KV,MTP n=3,262K上下文。

    两张卡我都按推荐的限制到了290W。用的是最新的595驱动,13.2 CUDA。

    ========== NARRATIVE (prompt=65 chars, max_tokens=1000) ==========
    === warmups (3) ===
      warm-1     wall= 19.64s  ttft=   184ms  toks=1000  wall_TPS= 50.91  decode_TPS= 51.40
      warm-2     wall= 19.46s  ttft=   188ms  toks=1000  wall_TPS= 51.39  decode_TPS= 51.89
      warm-3     wall= 19.02s  ttft=   188ms  toks=1000  wall_TPS= 52.58  decode_TPS= 53.10
    
    === measured (5) ===
      run-1      wall= 19.03s  ttft=   146ms  toks=1000  wall_TPS= 52.56  decode_TPS= 52.97
      run-2      wall= 19.25s  ttft=   187ms  toks=1000  wall_TPS= 51.94  decode_TPS= 52.45
      run-3      wall= 20.46s  ttft=   145ms  toks=1000  wall_TPS= 48.88  decode_TPS= 49.23
      run-4      wall= 19.59s  ttft=   193ms  toks=1000  wall_TPS= 51.06  decode_TPS= 51.57
      run-5      wall= 18.44s  ttft=   143ms  toks= 972  wall_TPS= 52.70  decode_TPS= 53.11
    
    === summary [narrative] (n=5) ===
      wall_TPS       mean=  51.43   std=  1.57   CV= 3.0%   min=48.88   max=52.70
      decode_TPS     mean=  51.86   std=  1.59   CV= 3.1%   min=49.23   max=53.11
      TTFT          mean=   163ms  std=   25ms  min=143ms  max=193ms
      PP tok/s       mean=   1.00   std=  1.37   CV=136.9%   min=0.00   max=2.50
    
    ========== CODE (prompt=78 chars, max_tokens=800) ==========
    === warmups (3) ===
      warm-1     wall= 10.25s  ttft=   152ms  toks= 691  wall_TPS= 67.39  decode_TPS= 68.41
      warm-2     wall=  7.23s  ttft=   183ms  toks= 478  wall_TPS= 66.11  decode_TPS= 67.82
      warm-3     wall=  8.92s  ttft=   183ms  toks= 556  wall_TPS= 62.36  decode_TPS= 63.67
    
    === measured (5) ===
      run-1      wall=  7.08s  ttft=   186ms  toks= 466  wall_TPS= 65.81  decode_TPS= 67.58
      run-2      wall= 11.91s  ttft=   185ms  toks= 784  wall_TPS= 65.85  decode_TPS= 66.89
      run-3      wall= 11.79s  ttft=   184ms  toks= 771  wall_TPS= 65.41  decode_TPS= 66.45
      run-4      wall= 11.58s  ttft=   188ms  toks= 746  wall_TPS= 64.43  decode_TPS= 65.49
      run-5      wall= 12.38s  ttft=   185ms  toks= 800  wall_TPS= 64.61  decode_TPS= 65.59
    
    === summary [code] (n=5) ===
      wall_TPS       mean=  65.22   std=  0.67   CV= 1.0%   min=64.43   max=65.85
      decode_TPS     mean=  66.40   std=  0.88   CV= 1.3%   min=65.49   max=67.58
      TTFT          mean=   186ms  std=    2ms  min=184ms  max=188ms
      PP tok/s       mean=   2.50   std=  1.77   CV=70.7%   min=0.00   max=5.00
    

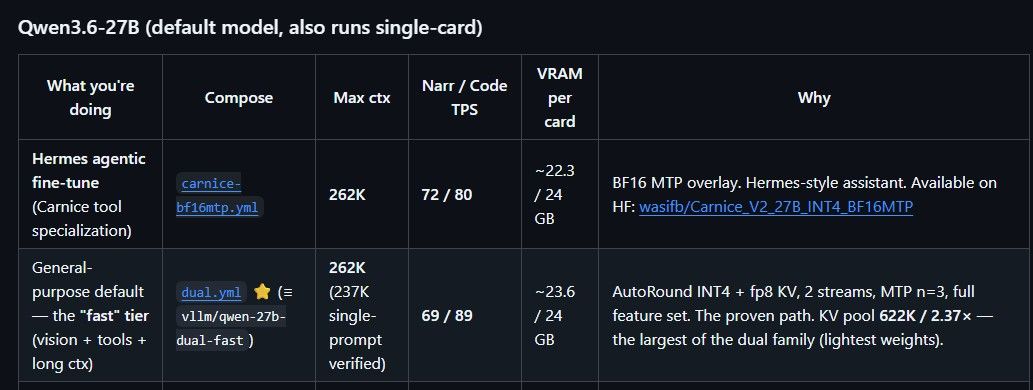
    综合的看就是写作文能跑到50多T/s,写码大概65+T/s。虽然感觉已经很够用了,但是离项目上描述的69/89还有一定的距离,具体还要再多跑一下多调试一下。
    ae32a004-3647-432e-b429-419a2fa9dd9e-image.jpeg


  • 洋垃圾的回乡路 —— 2x3090 + X99 + 2x2680v4
    Ray WangR Ray Wang
    装备秀 x99 rtx3090

    @applejuice 地下室,随便它怎么叫唤我也听不到,延迟的事情我得研究一下。


  • 洋垃圾的回乡路 —— 2x3090 + X99 + 2x2680v4
    Ray WangR Ray Wang
    装备秀 x99 rtx3090

    @kos-or 我之前看到过有个CAD harness,可以让ai做cad,但是具体还没研究过。我搞CAD不专业,打印机买来给儿子打印玩具的...


  • 10-12 提示词挑战 巴黎铁塔
    Ray WangR Ray Wang
    随便聊聊 rtx3090 strata 编程

    voxel-eiffel-night.html

    我也抽一张,QFN Uncensored IQ4_XS 跑了13分钟。我自己电脑上这个老1080Ti看楼主的烟花是一坨黑色,我这个也有黑影,不知道是什么。


  • 微软的137B模型
    Ray WangR Ray Wang
    随便聊聊

    这公司真的是,早就该狗带了,因为传统政企关系,硬是搞了个Azure出来又续了好多年,到了这会儿又是干啥啥不行。


  • 10-15 提示词挑战, 旧金山港口
    Ray WangR Ray Wang
    随便聊聊 本地模型 编程

    哈哈哈,给大家看看Argon在Gemini网站上搓的

    gemini-code-1792039686231.html


  • 洋垃圾X99 + 2x3090跑Strata,非常爽
    Ray WangR Ray Wang
    AI硬件 x99 rtx3090 strata

    =========================编辑1:===========================

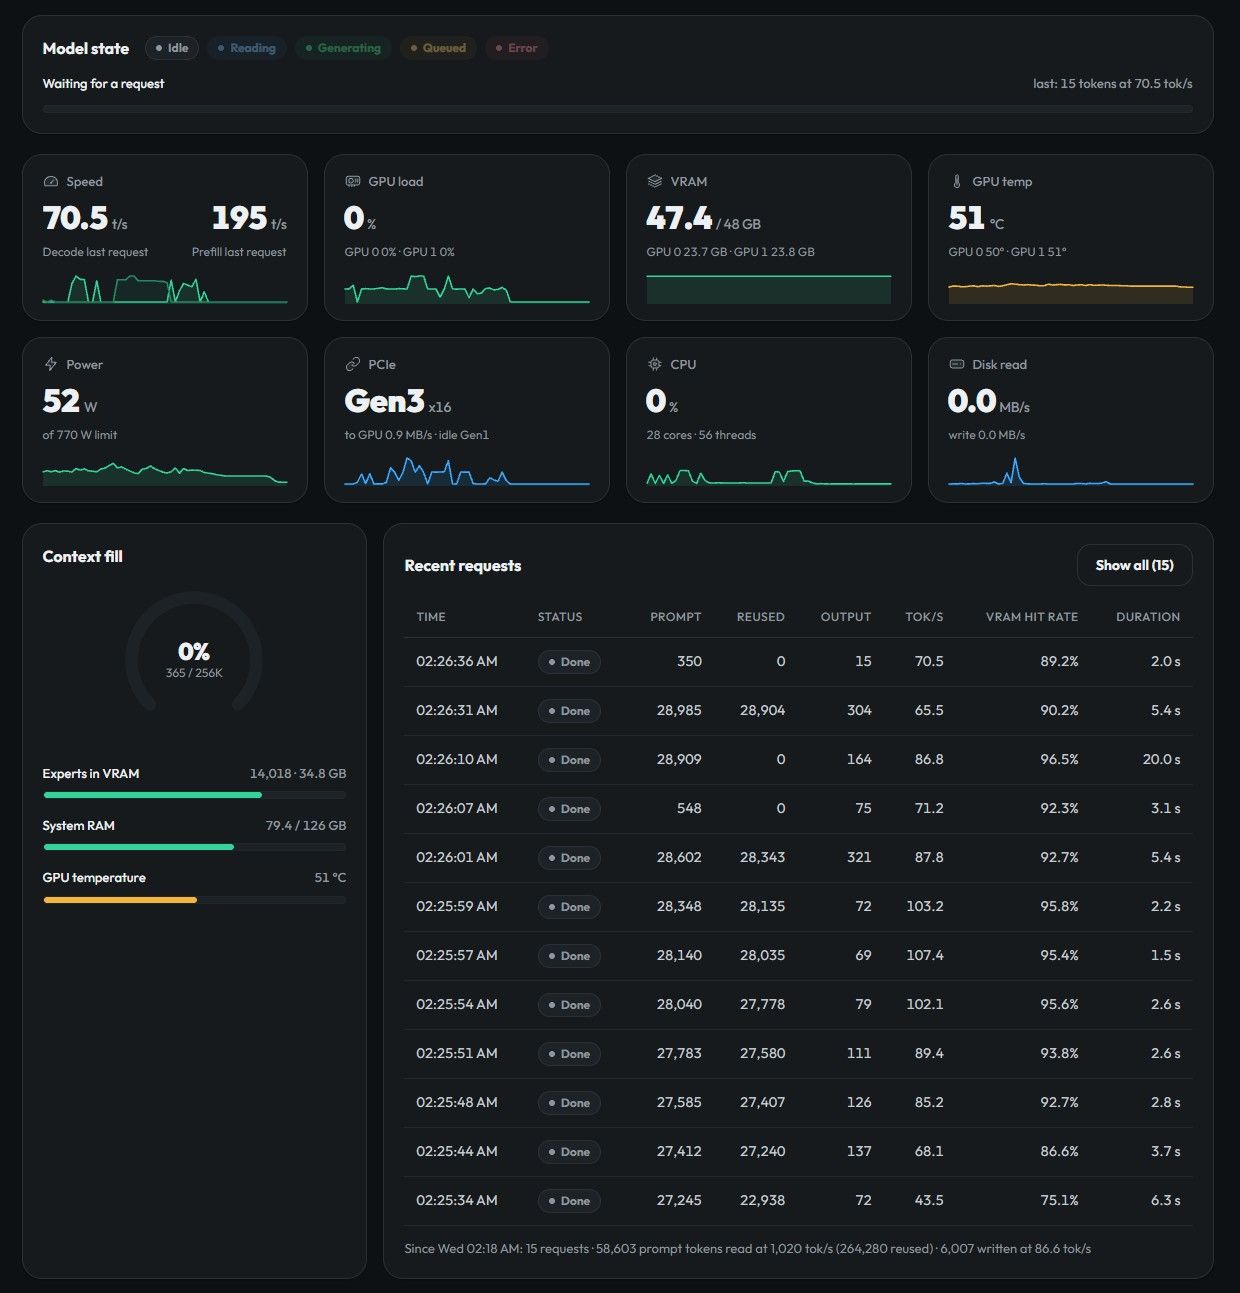
    折腾了一下,装好了IQ4_XS。先看结果。

    image.jpeg

    平均能维持在 80t/s 左右,但是浮动比较大,峰值继续保持在120,低谷却能掉到60多。很明显模型大了以后,能放进显存里面的热门专家数量变少了,导致大量token需要调用内存的专家,使得速度变慢。但是考虑到这套配置之前跑27B也大概就是这个速度,也不错了。

    感谢 @stxpnet 的启发,不过大佬的帖子主要还是技术解析,现成饭基本不给吃 😂没办法,只好自己摸索,最后成功了。不太一样的是,大神说的 --ple-io ram 这个 flag,我一旦开了就直接oom,不加反而可以正常启动。考虑到大神256G的内存,可能还是不太一样的。

    咱是饿惯了,现在终于吃上好的了,不能再看着其他兄弟饿着了,嚼碎了喂给兄弟们吃。不过是linux版本的,Windows我就不知道了。

    第一步,按照库里原有的./setup.sh跑过一遍,装了cuda 13并编译好了,然后退掉。这样比较干净。

    第二步,下载去审查版gguf,按照Strata的既定格式,放到了 ~/Strata-data 目录,注意保存位置

    hf download orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF \
      --include "*IQ4_XS*" \
      --local-dir ~/Strata-data/models/IQ4_XS-Uncensored
    

    第三步,用库里面的iq_pack.py生成pack,注意保存位置

    .venv/bin/python tools/iq_pack.py \
      --gguf ~/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf \
      --out ~/Strata-data/packs/orca-iq4_xs --compat-bf16
    

    第四步,生成MTP runtime,四个命令依次进行

    .venv/bin/python tools/mtp_fetch.py fetch --out mtp
    .venv/bin/python tools/mtp_pack.py --src mtp --experts q2_0 --out mtp/mtp-q2_0.gguf
    .venv/bin/python tools/mtp_rt.py --gguf mtp/mtp-q2_0.gguf --out mtp/rt
    cp data/draft_vocab.bin mtp/rt/draft_vocab.bin
    

    第五步,拿出之前用官方setup.sh生成的.json配置文件,抄一份新的出来,参数改成新模型,存到 ~/Strata/strata-orca-iq4_xs.json。我标注了一些要注意的,其他的按照需求自行更改。

    // strata-orca-iq4_xs.json
    
    {
     "exe": "/home/romeotango/Strata/engine/strata",
     "args": [
      "--pack",
      "/home/romeotango/Strata-data/packs/orca-iq4_xs", // 对应上面pack的位置
      "--native",
      "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置
      "--ple-gguf",
      "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置
      "--expert-profile",
      "/home/romeotango/Strata/data/expert-profile.bin",
      "--expert-cache",
      "auto",
      "--prefill",
      "auto",
      "--spec",
      "4",
      "--mtp",
      "/home/romeotango/Strata-data/mtp/rt",
      "--max-context",
      "262144",
      "--kv",
      "int8",
      "--kv-resident",
      "32768",
      "--vision",
      "--vram-reserve-mib",
      "700",
      "--remote-expert-opt",
      "--pcie-frac",
      "0.00",
      "--spec-min-p",
      "0.70",
      "--layer-split",
      "auto"
     ],
     "cwd": "/home/romeotango/Strata",
     "tokenizer": "/home/romeotango/Strata-data/packs/orca-iq4_xs/tokenizer", // 对应pack里面tokenizer位置
     "model_name": "qwen3.8-flash-next-iq4_xs-uncensored", // 模型名字
     "log": "/home/romeotango/Strata/strata-orca-iq4_xs.log", // 日志位置
     "lib_dirs": [
      "/usr/local/cuda-13.0/bin",
      "/usr/local/cuda-13.0/lib64"
     ],
     "port": 8080,
     "gpu": [
      0,
      1
     ], // 双gpu
     "gpus_asked": true,
     "layer_split": "auto",
     "vision": {
      "exe": "/home/romeotango/Strata/engine/strata-vision",
      "mmproj": "/home/romeotango/Strata-data/models/mmproj-Qwen3.8-Flash-Next-BF16.gguf", // 如果前面setup了视觉,照抄原来的就可以
      "model": "/home/romeotango/Strata-data/models/IQ4_XS-Uncensored/Qwen3.8-Flash-Next-Uncensored-IQ4_XS-00001-of-00003.gguf", // 对应模型gguf位置
      "gpu": true,
      "max_tokens": 1024
     },
     "host": "0.0.0.0" // 我是内网其他机器也要用,如果只有本地用就127.0.0.1就好
    }
    

    第六步,启动,对应上步保存的配置文件

    .venv/bin/python -m serve.server --engine strata --config strata-orca-iq4_xs.json --port 8080
    

    原则上来说,这套流程可以适配任何Qwen3.8-Flash-Next版本。

    =========================原文===========================

    因为跑的太爽了,特意上来灌灌水,技术向的内容这边已经很多了,就不重复了。之前在这边晒出过我的洋垃圾套装跑Qwen3.6-27B的帖子,链接。

    配置表

    当时跑了一阵子还觉得有点过了,因为2个cpu,2个gpu,还有128GB的内存,我同时开了2-3个编程工程,跑了二十几个各类docker,都吃不满。

    后来Qwen3.8-27B出来了,我也第一时间装好了,可是它似乎不像3.6那样可以两个进程跑满了,只能把上下文降下来才能稳定跑并行。而且推理我也一直没有调试好,经常感觉它推理了半天才能做一点工作出来,还时不时做错,体感有时还不如3.6。

    再后来,Strata跑Qwen3.8-Flash-Next火了,我观望了几天以后,前天装上了。两天使用下来不得不说,体验真的飞起。

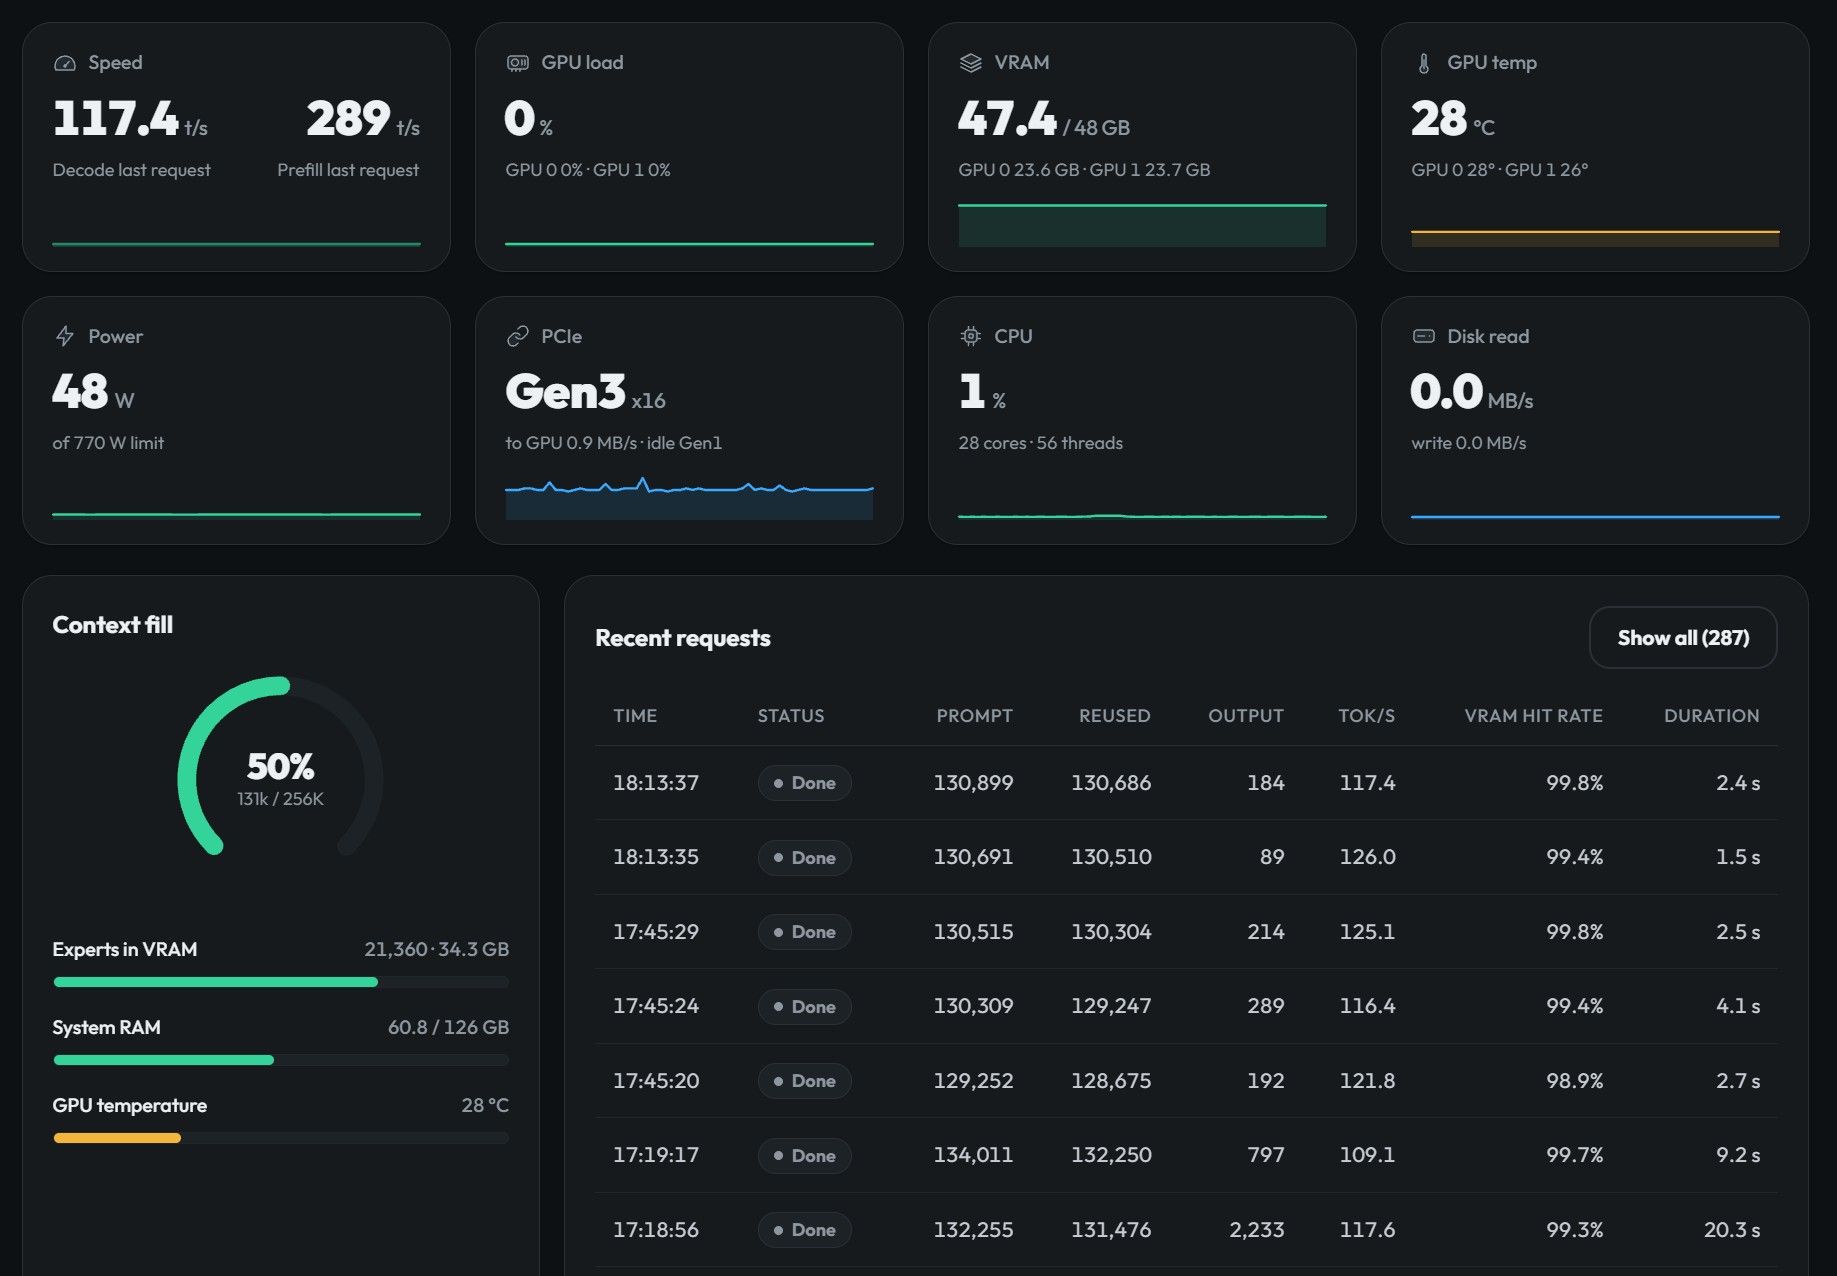
    Strata Dashboard

    Strata对于以前完全不能玩的12GB / 16GB卡是从无到有的质的飞跃,对于广大双持3090这种配置也是非常不错的提升。IQ3_XXS模型,256k上下文,Prefill能干到3000t/s,Decode稳定110+ t/s,很多情况下超过120。

    最爽的是知识面明显拓宽了。我最近在写一些比较偏门的稿子,之前27B写出来很多瞎编的,后来让Hermes自己去fact check最后改正回来了。装上Strata以后让3.8-Flash-Next重新写了一遍,质量非常好。

    编程方面我没有深入试过。写新代码我都是用Claude,然后让Hermes本地模型去审查代码。目前感觉虽然量化了,但是审代码能力没问题,没给我已有工作流产生任何影响。让它改bug也都一次过,没掉链子。下一步可以考虑给它一些小的模块去做做试试。

    安装方面,我个人依旧不爱折腾,https://github.com/Niko1221/Strata 官方repo clone下来,直接 ./setup.sh,根据提示自己选就可以了,没手调任何设置,只是跟着大家选了IQ3_XXS,体感非常舒适。

    下一步有两个想法,要么换IQ4试试,看了别的帖子也能跑到不错的速度。要么就跑单卡玩,另一个卡可以解放出来做图。

    最后再感谢一下老特,让我知道了洋垃圾这种东西,妈的我拉满了才6000块钱,算上两张3090的二手价加起来也顶多2w,还要什么自行车。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组