
我的现在好了。新加坡playstore
 S
seabass
@seabass
-
【公告】抡锤者安卓 APP 开启测试,欢迎参与体验与反馈,参与Google Play测试并完成的,奖励50分! -
Tesla V100 32GB Pcie 单卡 跑 Qwen3.8-Flash-Next IQ2_XS 256K上下文 实测速度 80-90tok/s ,最高100token/s以上我的 Tesla V100 32GB PCIe 跑 Qwen3.8-Flash-Next IQ3_S
Strata | 200K 上下文 | 视觉 开 | speculative decoding 开 | 1 slot模拟真实多轮对话测试:每轮新增约 10K tokens + 提问,AI 回复保留在历史里,前缀缓存全程命中,一直聊到 183K。
| 已用上下文 | 解码 | 首字延迟(新增10K) | 预填充 |
| 10–40K | 70–89 t/s | 8.5–9.2 秒 | 1100–1180 t/s |
| 50K | 74.5 t/s | 9.4 秒 | 1081 t/s |
| 60–100K | 49–57 t/s | 10.5–13.7 秒 | 780–975 t/s |
| 110–150K | 49–60 t/s | 14–15.6 秒 | 695–765 t/s |
| 160–183K | 48–61 t/s | 16.5–17.2 秒 | 634–662 t/s |结论:
- 50K 以内 70–89 t/s,跟 IQ2_XS 差不多快
- 60K 以后降到约 50–60 t/s,然后一直稳定到 183K,没有继续明显掉速
- 有前缀缓存的话,即使 180K 上下文,每轮新增 10K 也只要约 17 秒首字
-
水一贴: Strata v0.1.43 又又又提速了 -
安装运行strata 遇到问题,请教一下大家我用 Claude 做翻译和核对。
我的配置和你很接近,可以做个对照:双 2080 Ti 22G,E5-2666 v3(和你的 2678 v3 同代,AVX2,没有 AVX-512),252G 内存,Ubuntu。
模型是 Qwen3.8-Flash-Next IQ3_S,262K 上下文,解码 55–77 tok/s,29K 长 prompt 预填充约 1050 tok/s。所以 2080 Ti 和这代 CPU 本身没问题,7 tok/s 肯定不正常。我的参数(基本全 auto):
--expert-cache auto --prefill auto --spec 4 --spec-min-p 0.5 --mtp ... --max-context 262144 --kv int8 --kv-resident 32768 --vram-reserve-mib 700 --vision
日志里:层自动切分 0–19 在卡0、20–47 在卡1;pcie_frac 自动探测为 0.23(PCIe 10.8 GB/s);专家缓存每张卡约 15GB,加载完显存只剩约 470MB;专家缓存命中率加权平均约 97%。我觉得问题主要在内存和硬盘:
- 启动时约 47GB 专家载入锁页内存,我这边运行时系统内存占用约 60GB。你 64G 内存还要跑 Windows,非常紧。如果专家放不下,解码时就要去读盘,速度会掉得很厉害。
- 盘速对比(直接读,绕过缓存):我的 SATA SSD 546 MB/s,冷启动加载 47GB 约 90 秒;挪到 NVMe(1.5 GB/s)后加载速度从 0.52 提到 1.45 GiB/s,约 66
秒就绪。解码速度两者一样,因为专家全在内存/显存里时根本不读盘。 - 你说 SSD 只有 300 多 MB/s,这正好是 SATA II(3Gb/s)的上限,老 X79/X99 板很常见。用 CrystalDiskInfo 看传输模式是 SATA/300 还是 SATA/600,能换就插到 SATA3 口。机械硬盘就更不行了。
建议自查:
- 看日志里的 expert cache hit rate,正常应该在 90% 以上;KV streaming ... hit VRAM 也应该接近 100%。
- 生成时打开任务管理器,看磁盘占用是不是一直很高。如果是,就说明在从盘读专家。
- 上下文降到 8K 对显存帮助不大:KV 只有 --kv-resident 那部分(32K)常驻显存,其余在内存里。
-
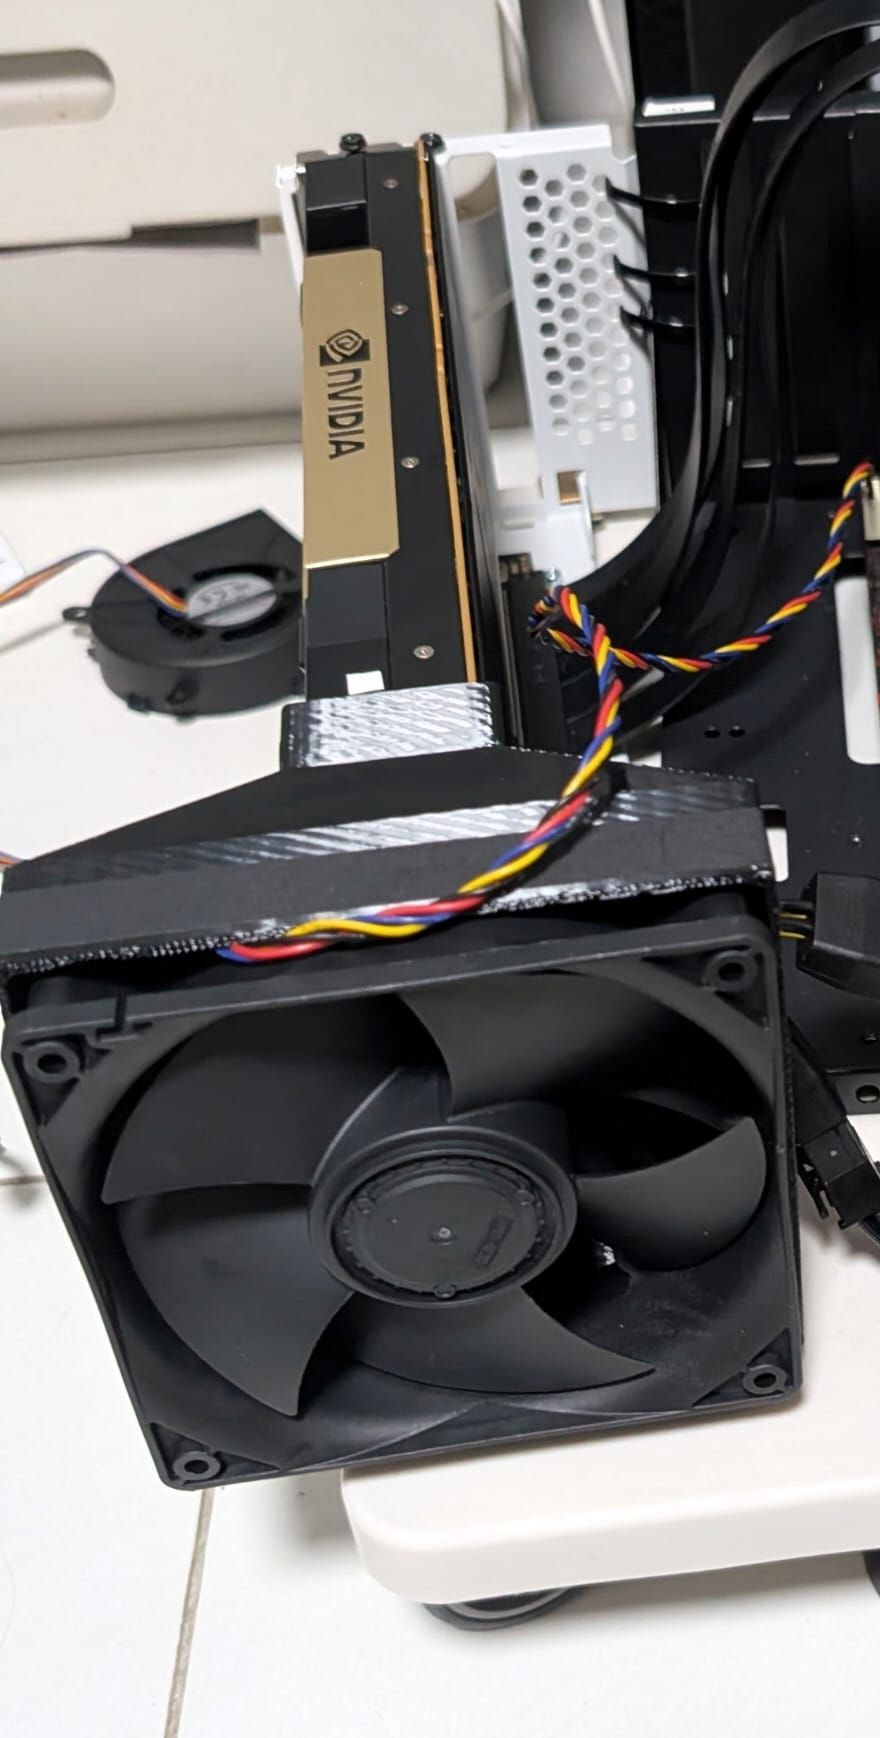
廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型@soop-ladios 哎呀,我才发现你的风扇跟我的不一样,你的不是外接式的。应该接风扇,不是接显卡。
-
廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型@soop-ladios
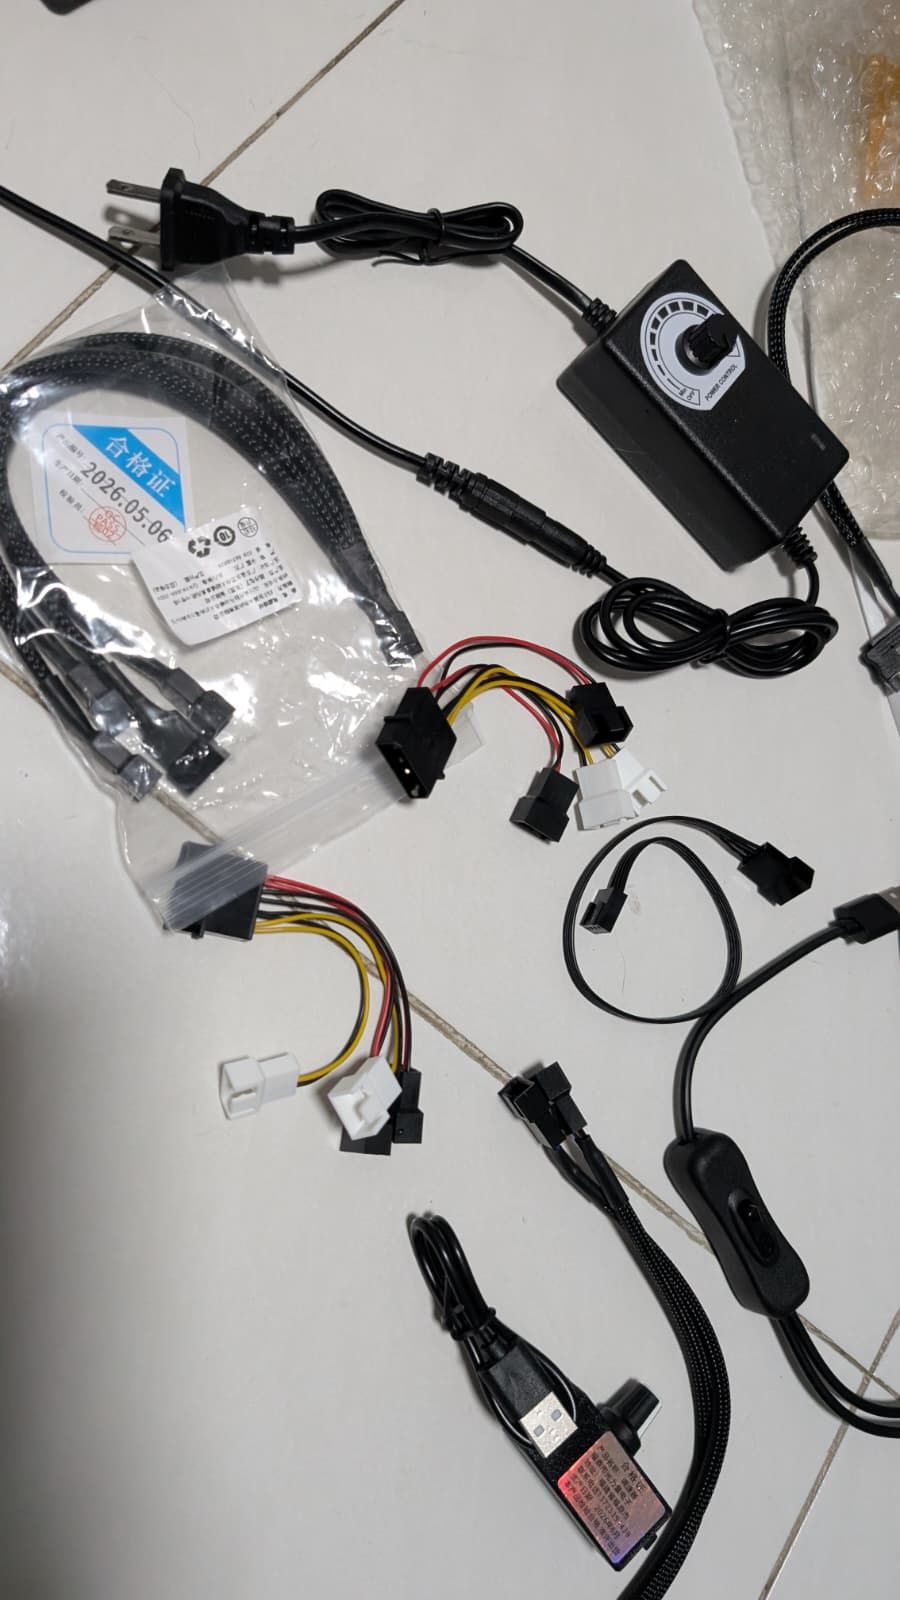
那时候我的 V100 PCIe 还没到,我买了一堆电源相关的东西来试, 我也不知道自己这样弄对不对,不过目前为止,我的 V100 还没有过热。 -
廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型@soop-ladios
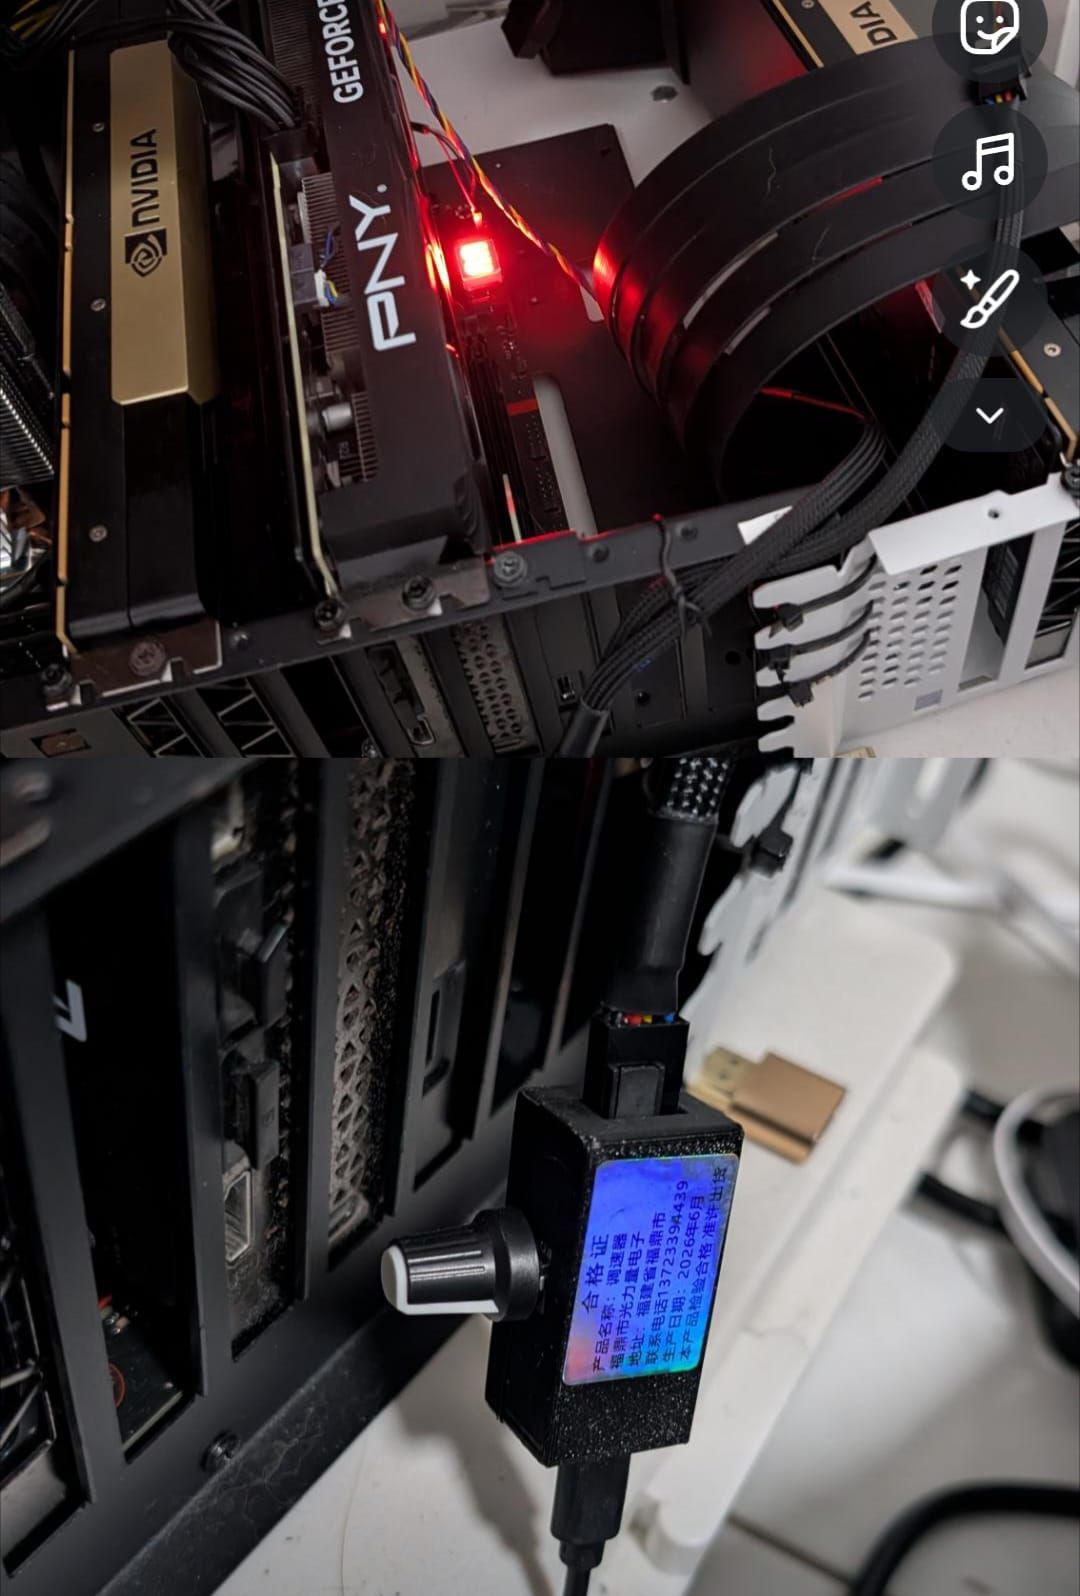
自己加了个风扇调速电阻/旋钮,实现手动调速。风扇转速可以自己控制,低速静音,高速加强散热。
我也有同样的问题,目前先把风扇调到可以接受的噪音水平。 -
Tesla V100 32GB Pcie 单卡 跑 Qwen3.8-Flash-Next IQ2_XS 256K上下文 实测速度 80-90tok/s ,最高100token/s以上 -
双显卡叠加 VRAM 玩本地模型的迷思,两年过来人血泪谈,最终直上32gb 单卡 -
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接 -
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接 -
最低成本使用deepseek-v4-flash API的方式:OpenCode Go订阅 -
你们的Hermes都是怎么网上冲浪的? -
交作业:X99 CD3+E5 2666 +128G DDR3 + AMD AI Pro 9700,成功安装ubuntu,等不及跟大家分享。后续再更新Advanced -> Intel RC Setup -> IIO Configuration -> Intel NIC Frequency / PCIe Speed
谢谢分享。我找了一下 Advanced -> Intel RC Setup -> IIO Configuration -> Intel NIC Frequency / PCIe Speed
-
【求助】铭凡HX99G 打算 eGPU上7900XTX 24G,是否可行 -
📡 AI日报 5/28 | Google Gemini Omni发布、NVIDIA削减显卡产能30-40%、Hike GPU价格、开源Alpamayo/Ising模型