跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
stxpnetS

stxpnet

@stxpnet
王侯将相
取消关注 关注
关于
帖子
597
主题
81
分享
0
群组
1
粉丝
3
关注
3

帖子

最新 最佳 有争议的

  • 3090坛友进来,过年了【解锁F16算力 加快TTFT】(10-26更新WIN系统)
    stxpnetS stxpnet
    AI硬件 rtx3090 nvidia

    @magician6677 https://github.com/impacifist/Windows-GPU-UNLOCK WINDOWS更新了


  • 3090坛友进来,过年了【解锁F16算力 加快TTFT】(10-26更新WIN系统)
    stxpnetS stxpnet
    AI硬件 rtx3090 nvidia

    所以去AUTODL租一台3090 48G的物理机,能不能在LINUX下面提取出它的BIOS,然后找 张哥扩48G显存?


  • 4090 (4070TI) 解锁F16(FP32)算力 加快PREFILL
    stxpnetS stxpnet
    AI硬件 rtx4090 cuda

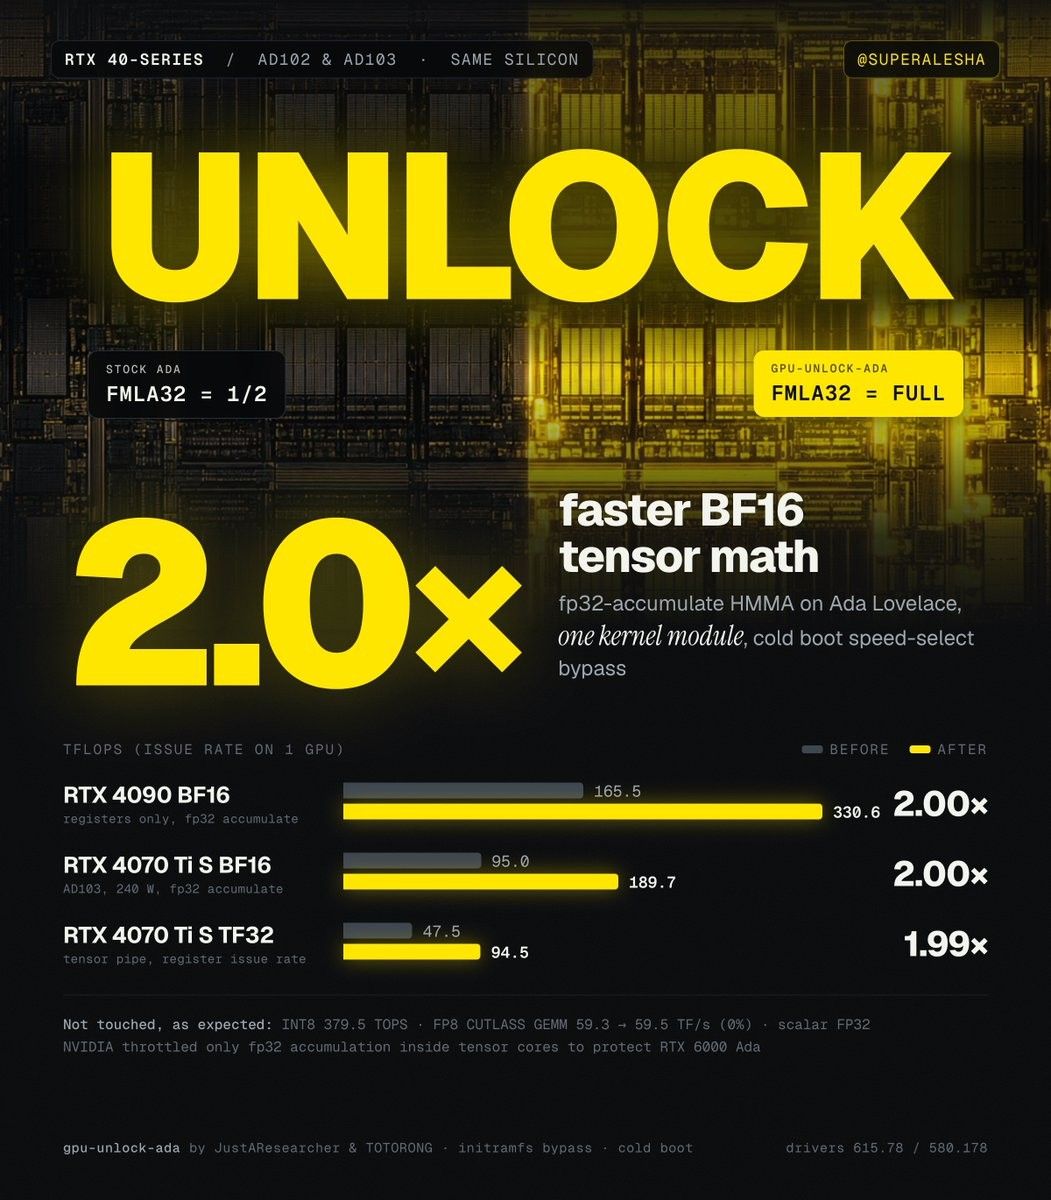
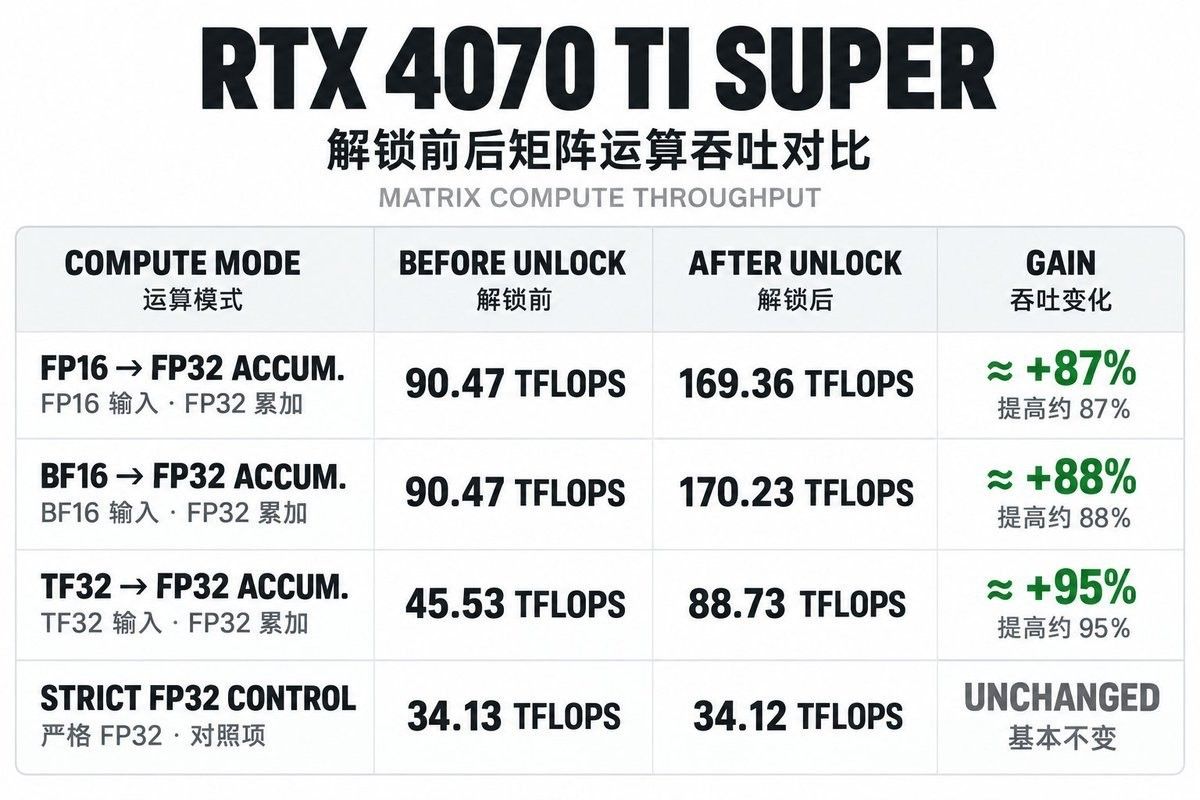
    这次轮到40系的兄弟们了。。。

    https://github.com/JustAResearcher/gpu-unlock-ada
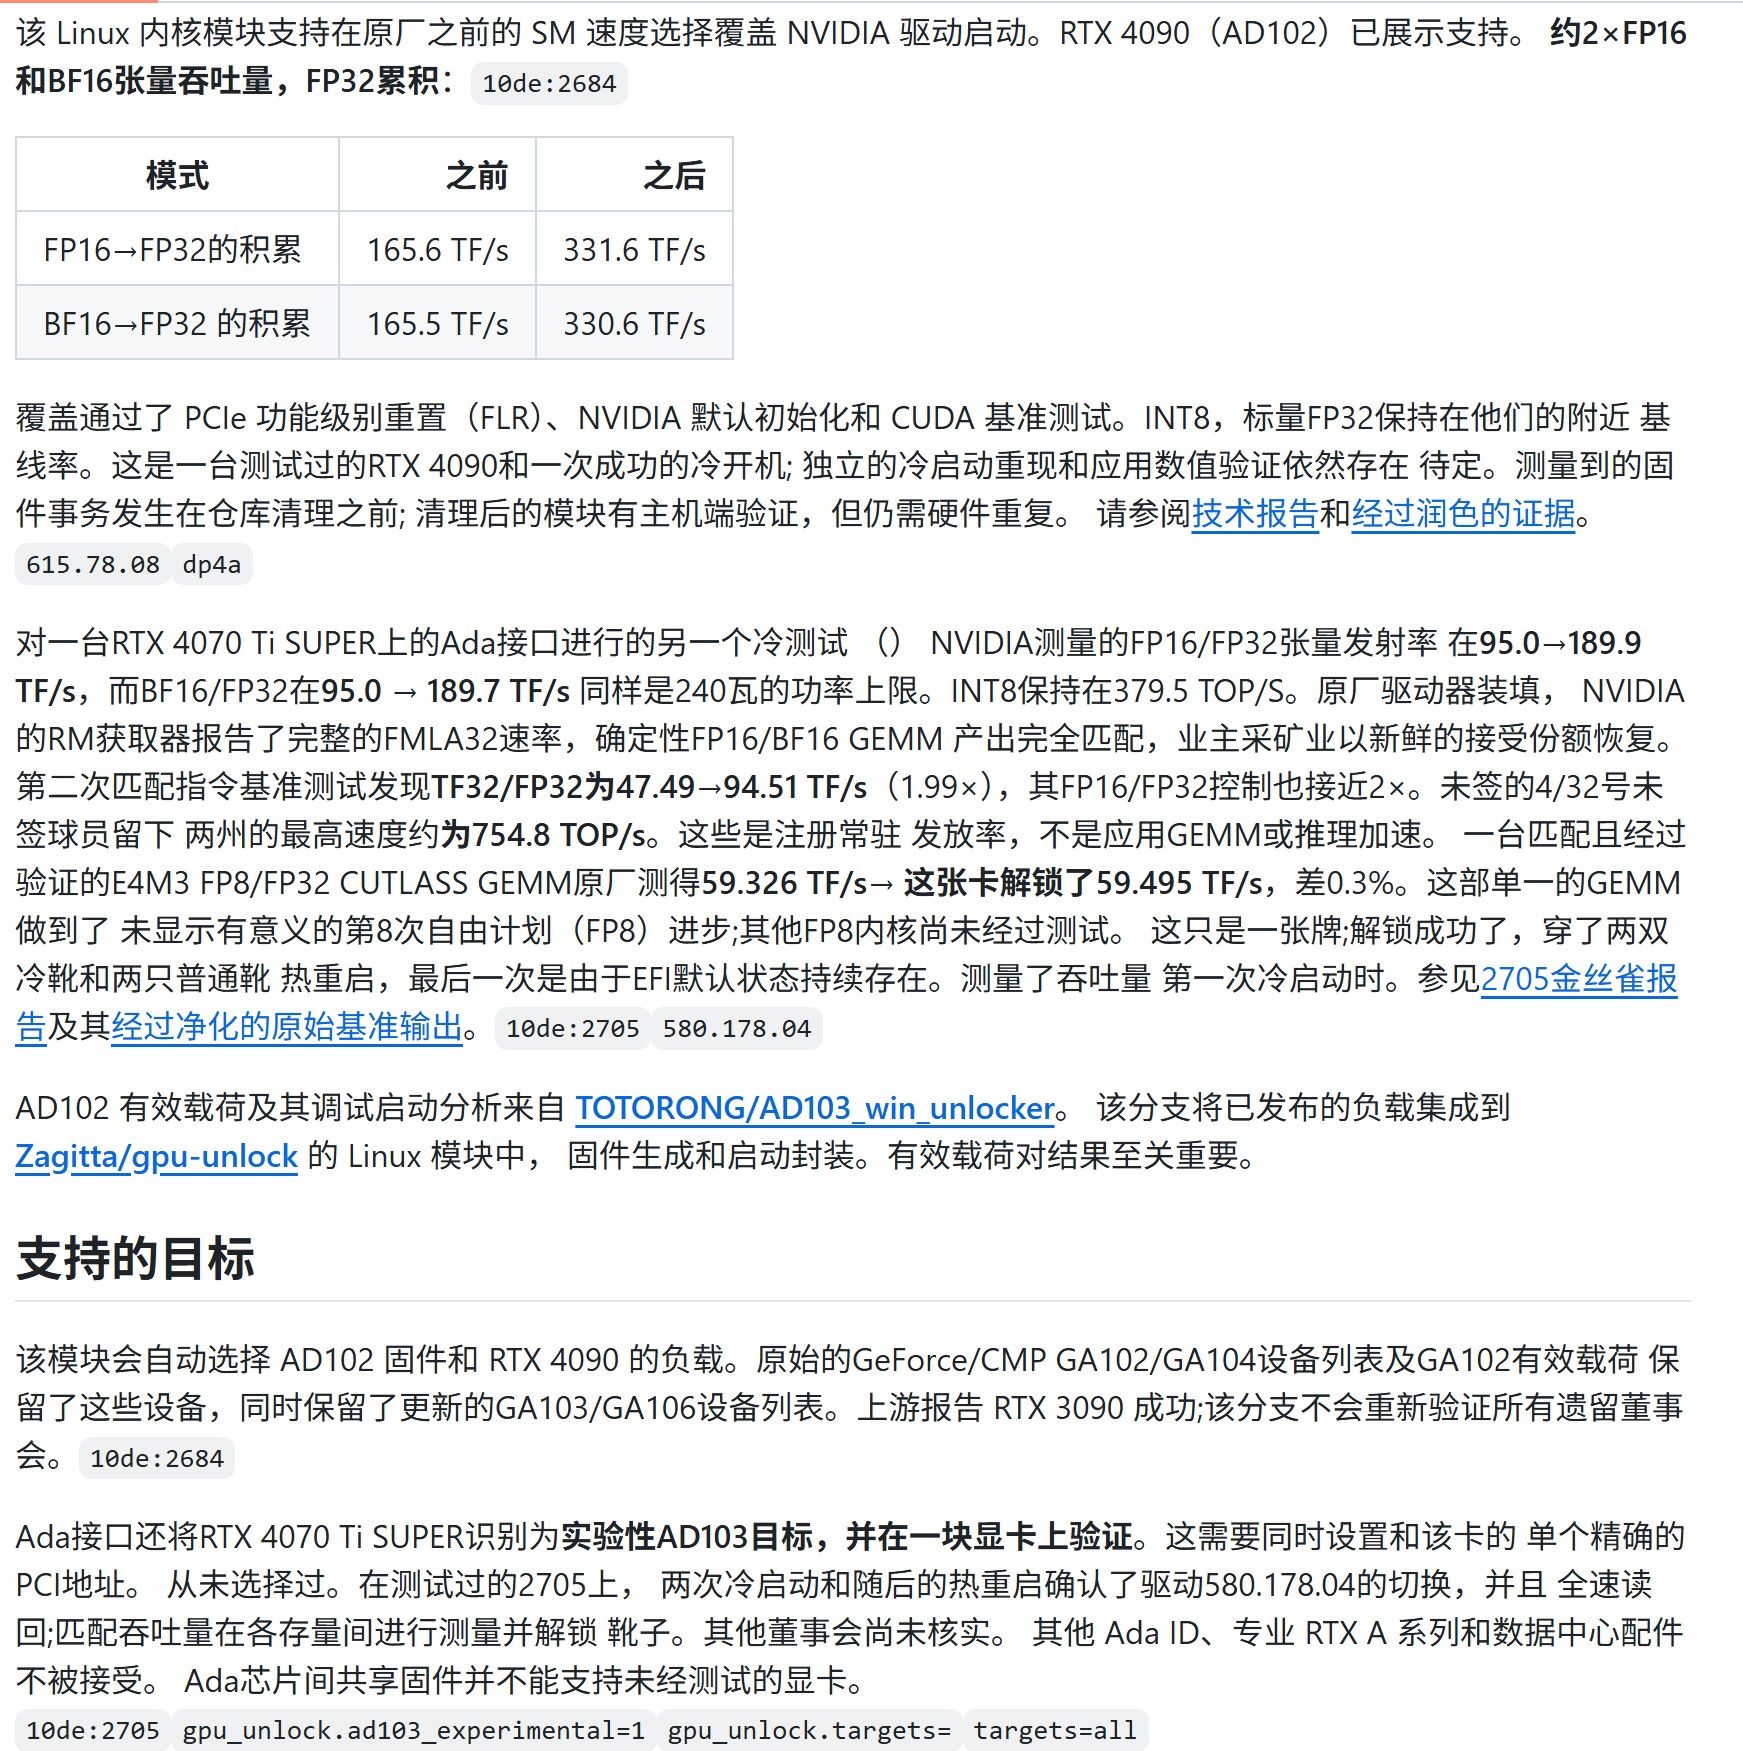
    {ACFF0C17-BC9A-45D2-B880-8BBB382D2F85}.jpeg

    12小时前发布的

    image.jpeg

    借用一下 这个大神的图。

    image.jpeg

    另外友情提示一下,解锁后PREFILL固然有一定的提升,但也要小心这是英伟达的阴谋(让普通玩家手里的老卡 快速走完生命周期,然后去购买他们的新款显卡) 。


  • 有没有一个管理本地AGENT的AGENT?
    stxpnetS stxpnet
    AI Agent hermes dsharness

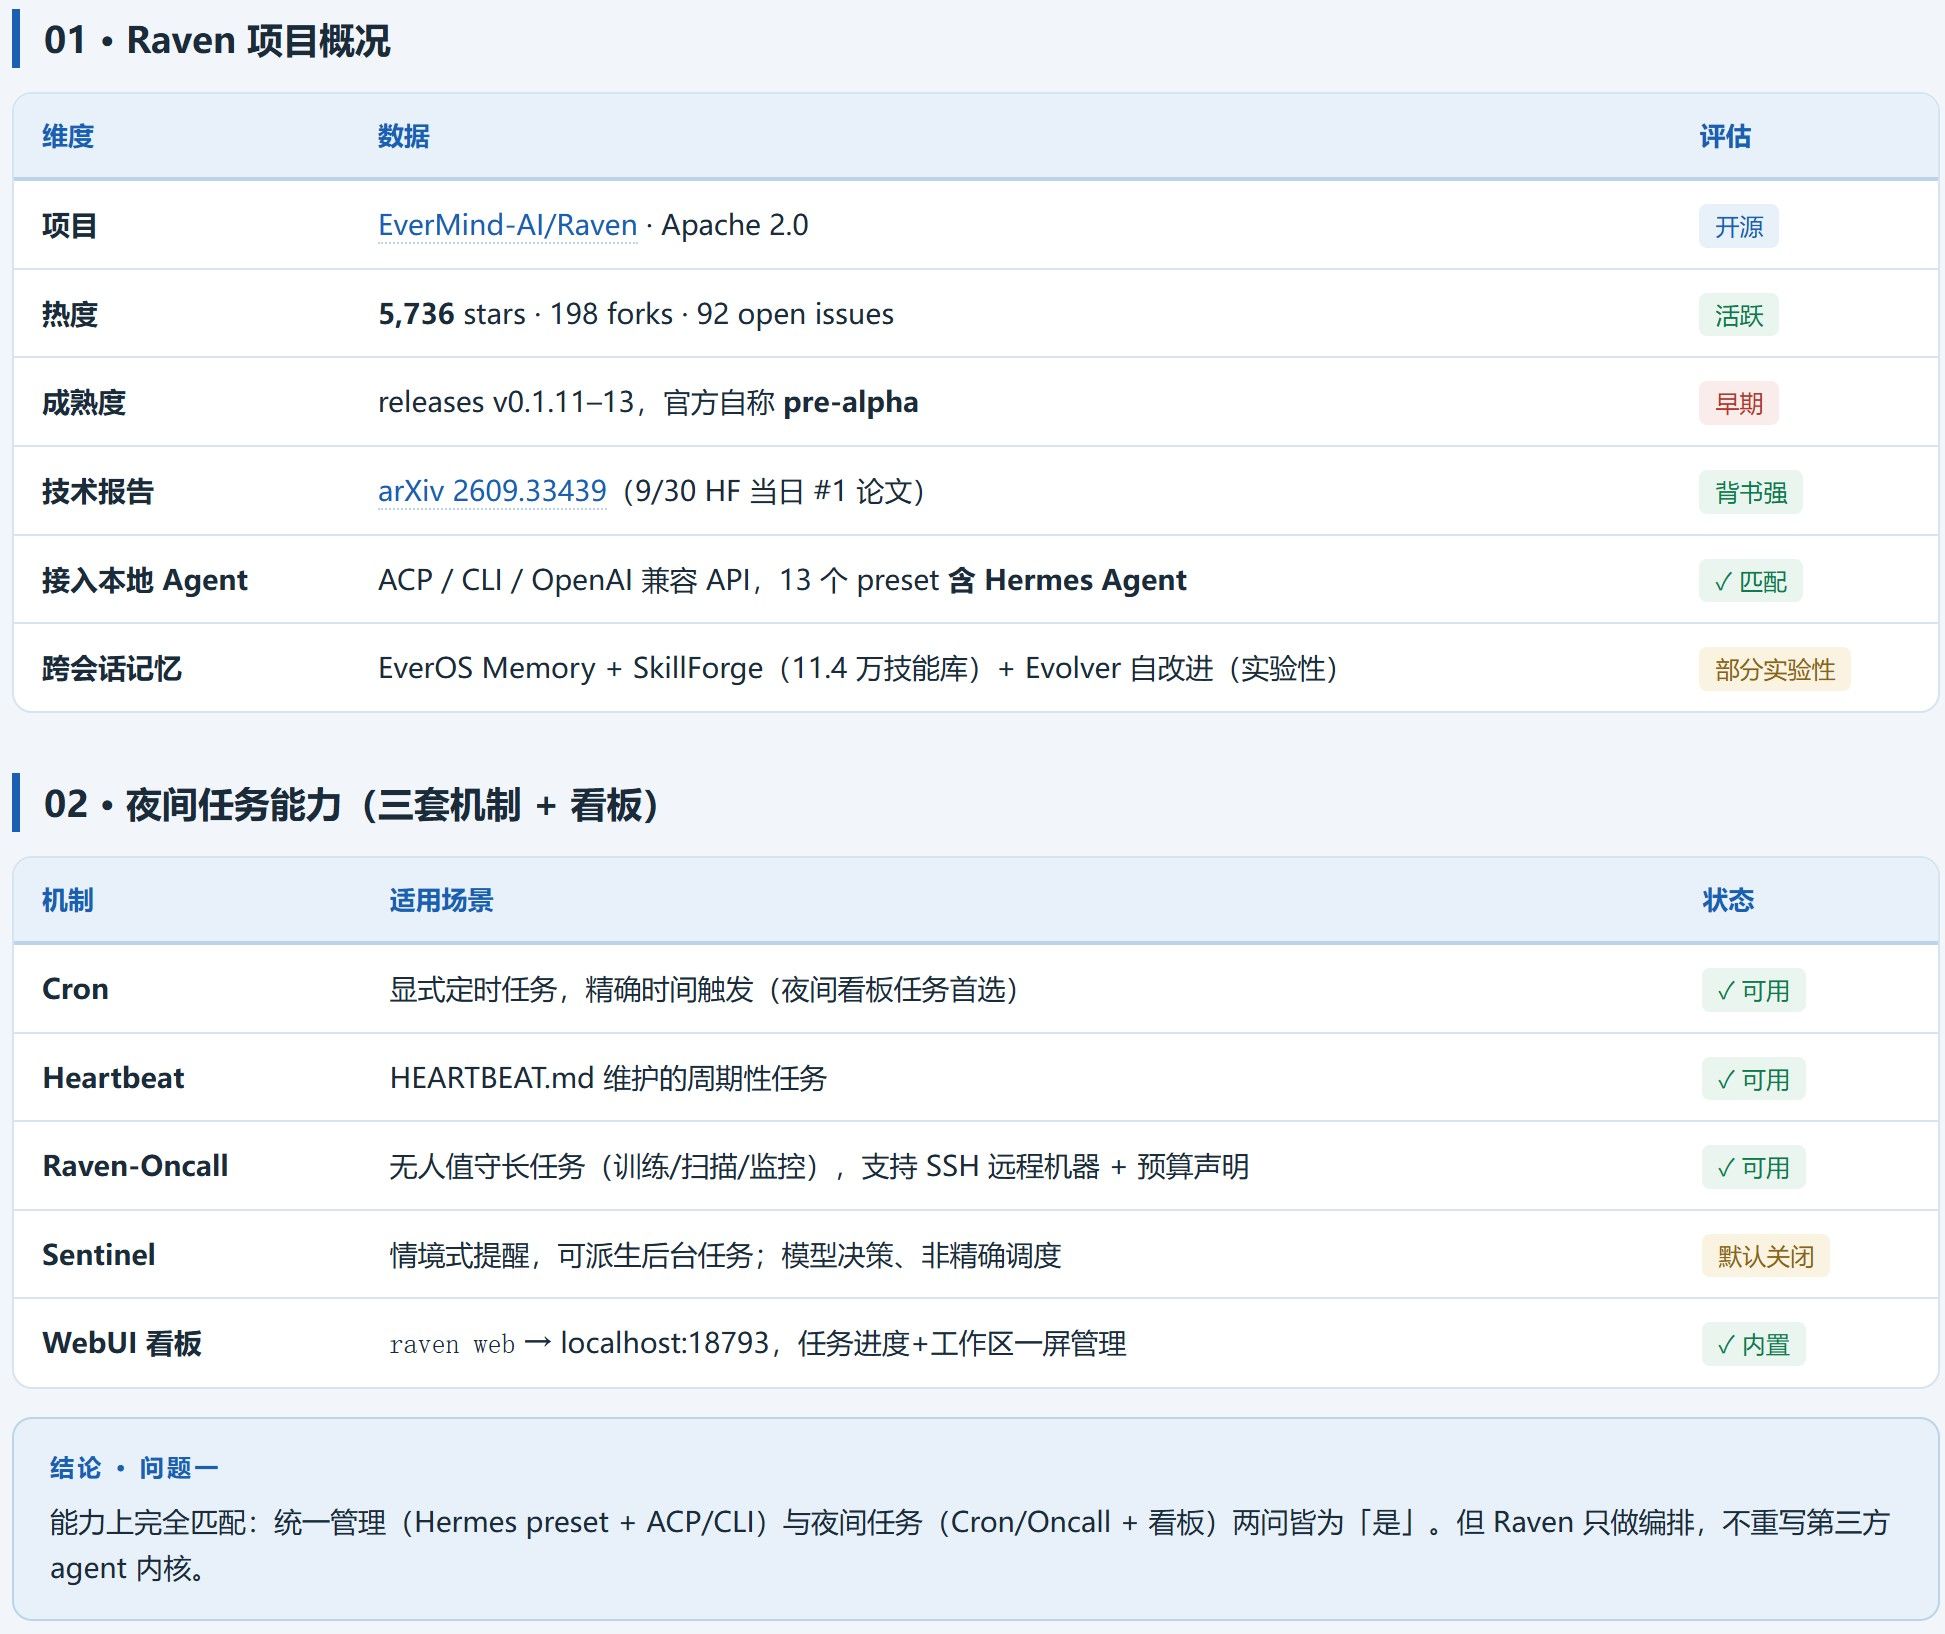
    偶然看到这个RAVEN的项目,目前还在pre-alpha,比较贴合我的实际需要。
    我想要的就是让它来管理HERMES和OMP,在夜间 空闲的时候完成一些任务。
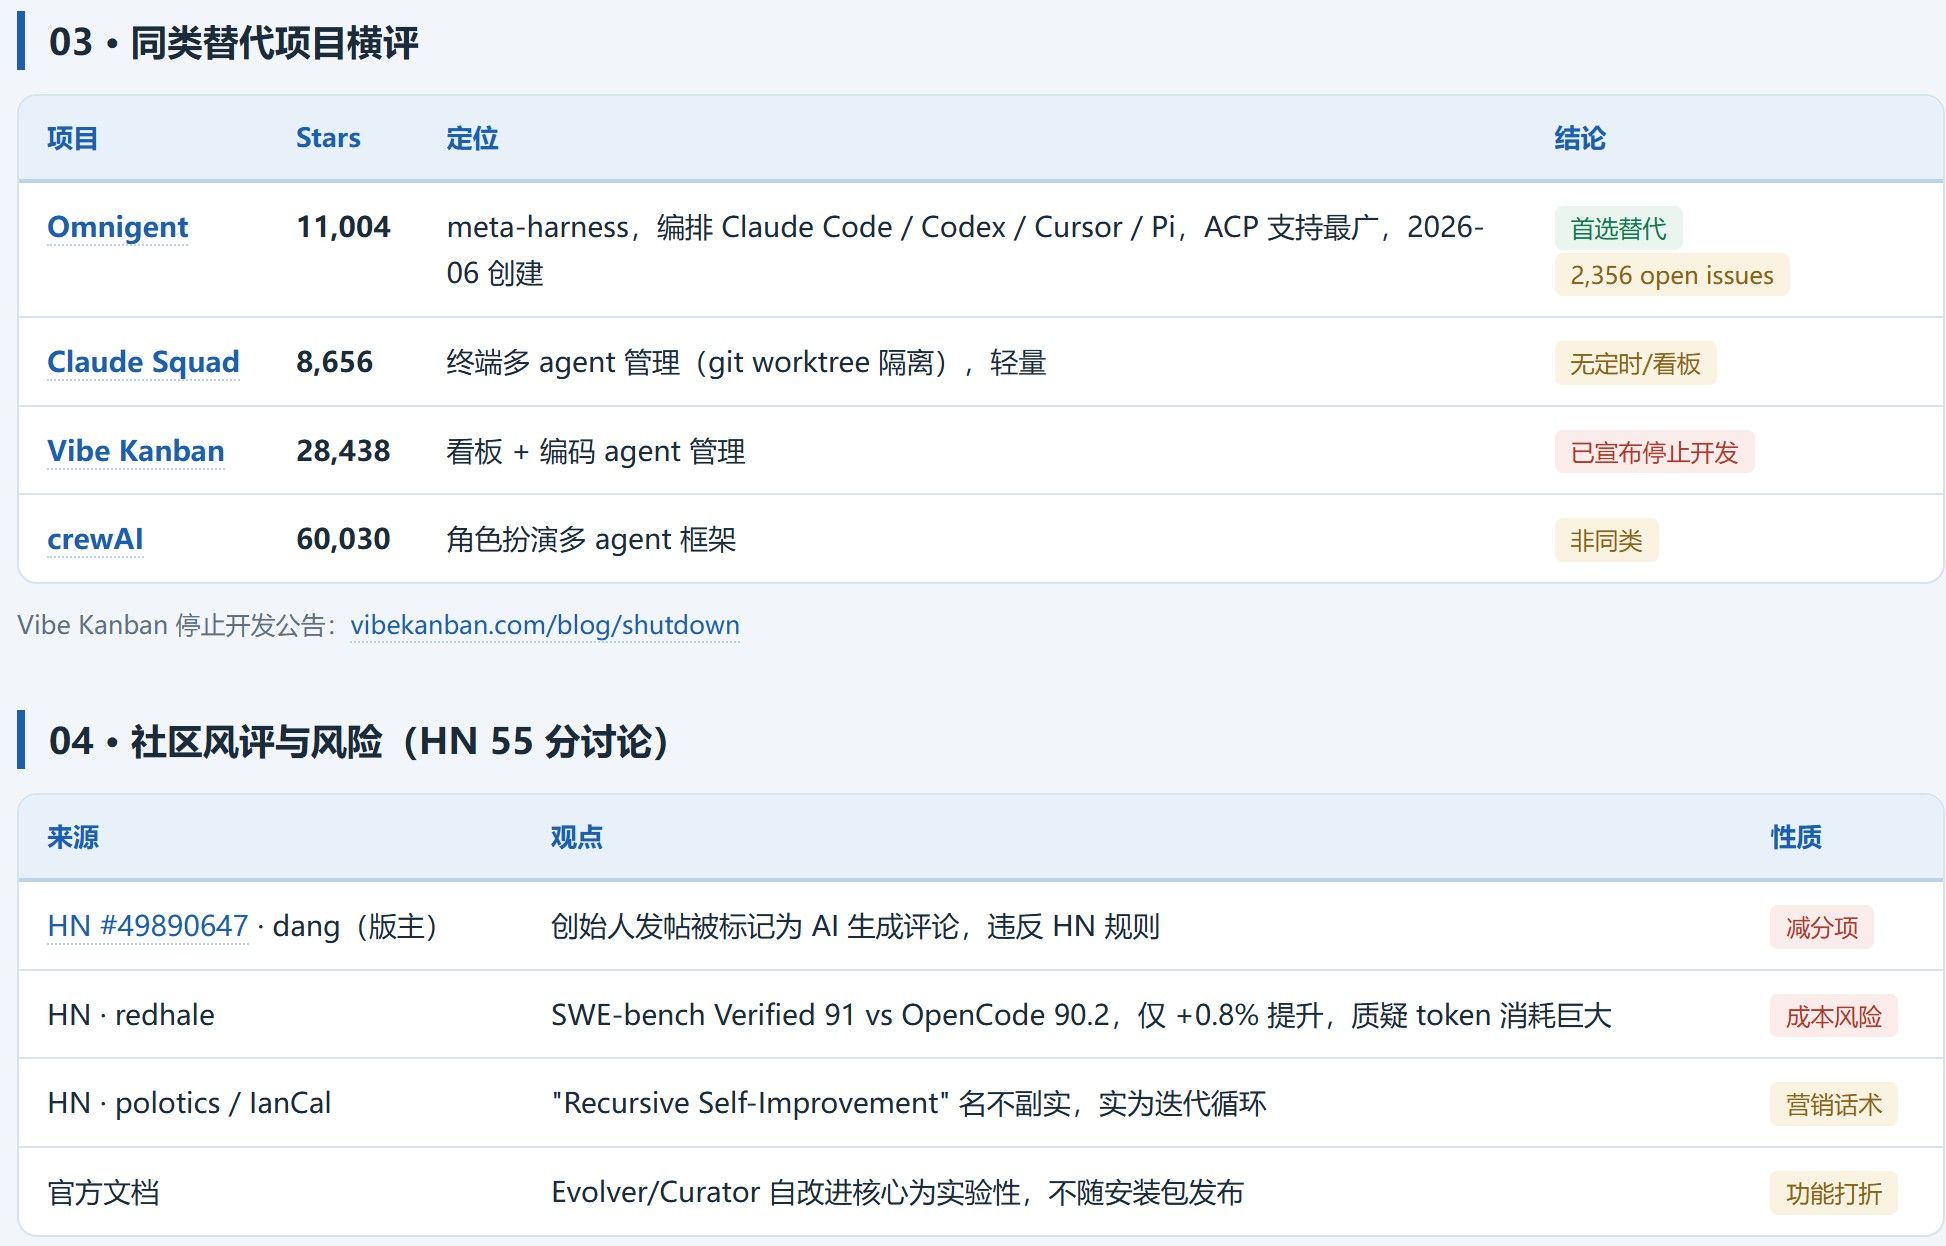
    它的官方视频宣传的就是 harness of harness,这比dsh 还强? 以下是hermes调研的结果
    {BB92AB87-BEC1-41A3-93AA-C754CDC897EE}.jpeg

    同类首选替代,星数也没有它高。
    {C5CA8A74-2A3E-4573-81E8-41218986EDDA}.jpeg

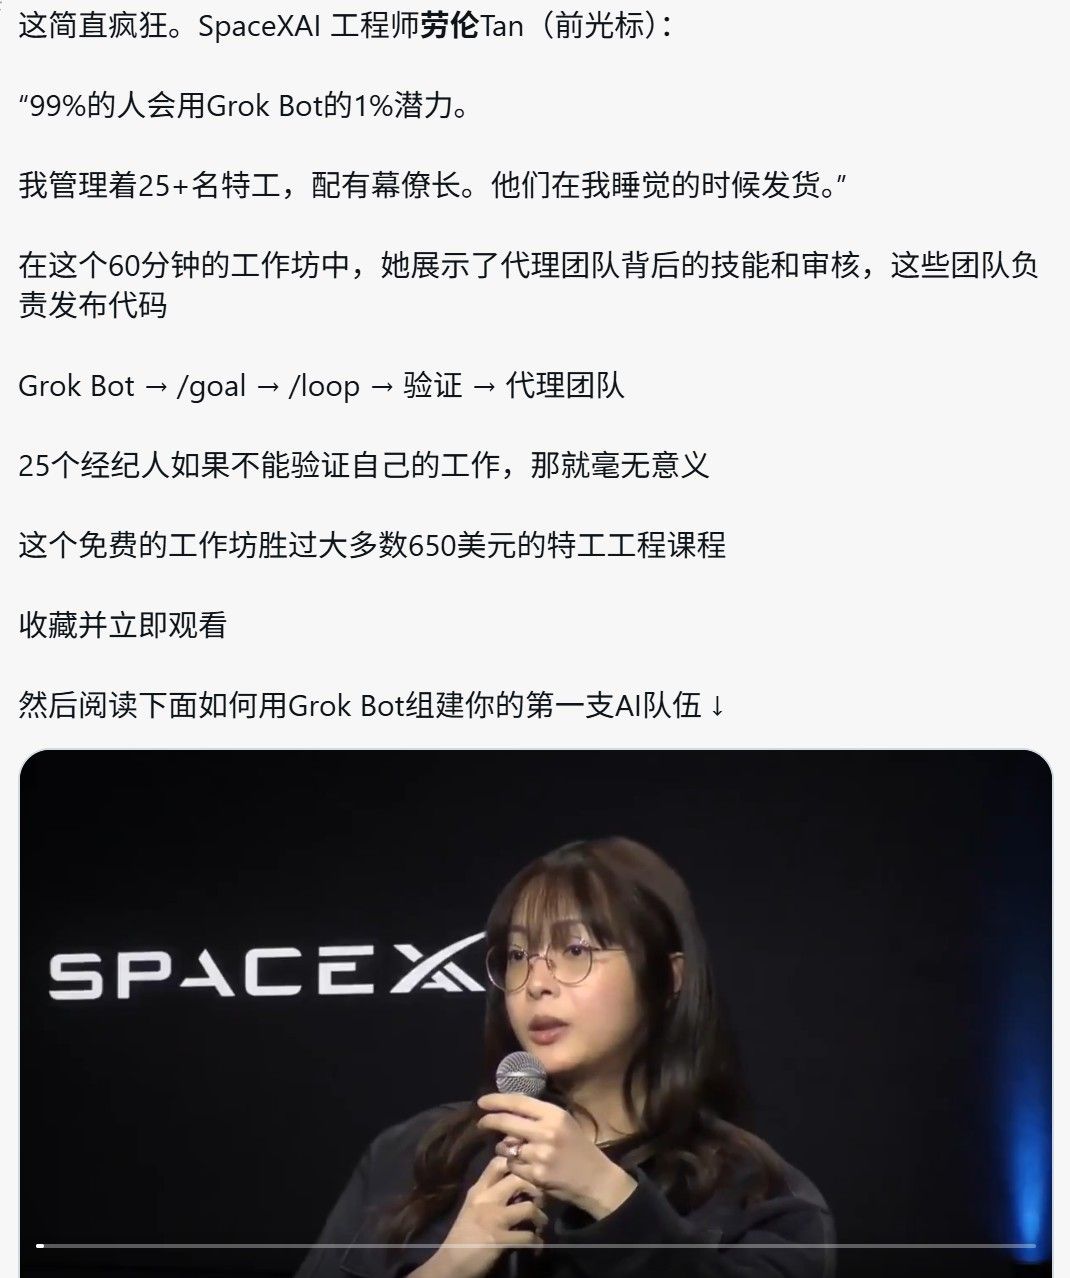
    目前我使用AGENT的主要痛点就是,我自己实际上已经没有时间来精力,认知也难跟上AGENT了。所以需要一个类似 Lauren Tan提到的AGENT 幕僚长那样的角色来管理它们:
    {CD531D74-D963-44B4-84A3-7DA1D3043760}.jpeg

    大家有没有好的经验呢?请分享。


  • Grok Bot & Muse AI,在线AI助手还能火多久?不妨回顾下Open JEV和Open Claw,功能单一且可替代,或者缺陷严重,依靠炒作都火不下去!
    stxpnetS stxpnet
    AI Agent muse openclaw

    这类感觉还是富 人的玩具,看它们的宣传,感觉就是鼓励用户多花TOKEN,感觉有点像自来水和空调不要钱,那你们这些用户最好24小时开着,不然资本家机房里面的算力设备没法创造利润,不好向股东和股市交待啊。


  • 真的很难想象workbuddy 居然那么火爆
    stxpnetS stxpnet
    AI Agent 本地模型

    @aaronku 说:

    就算易用容易上手,大家真的对隐私没有任何担心么?还有如果有的企业里不允许使用第三方 这该如何是好?
    还有就是模型不是还是用的云端的么?烧token?
    我更倾向使用本地部署,不知道大家有没有本地搞过的

    有个破甲版的WORKBUDDY,但是我不敢用。不知道有没有大神用REA把CLAUD CODE或者WORK BUDDY 逆向出来,弄个开源的WORKBUDDY,那么对我们这群本地党来说,至少可以爽 玩3个月。


  • 電腦的HERMES讀取GB10的模型
    stxpnetS stxpnet
    随便聊聊 gb10 hermes dgxspark

    楼主似乎在台湾,上X去找就行了。
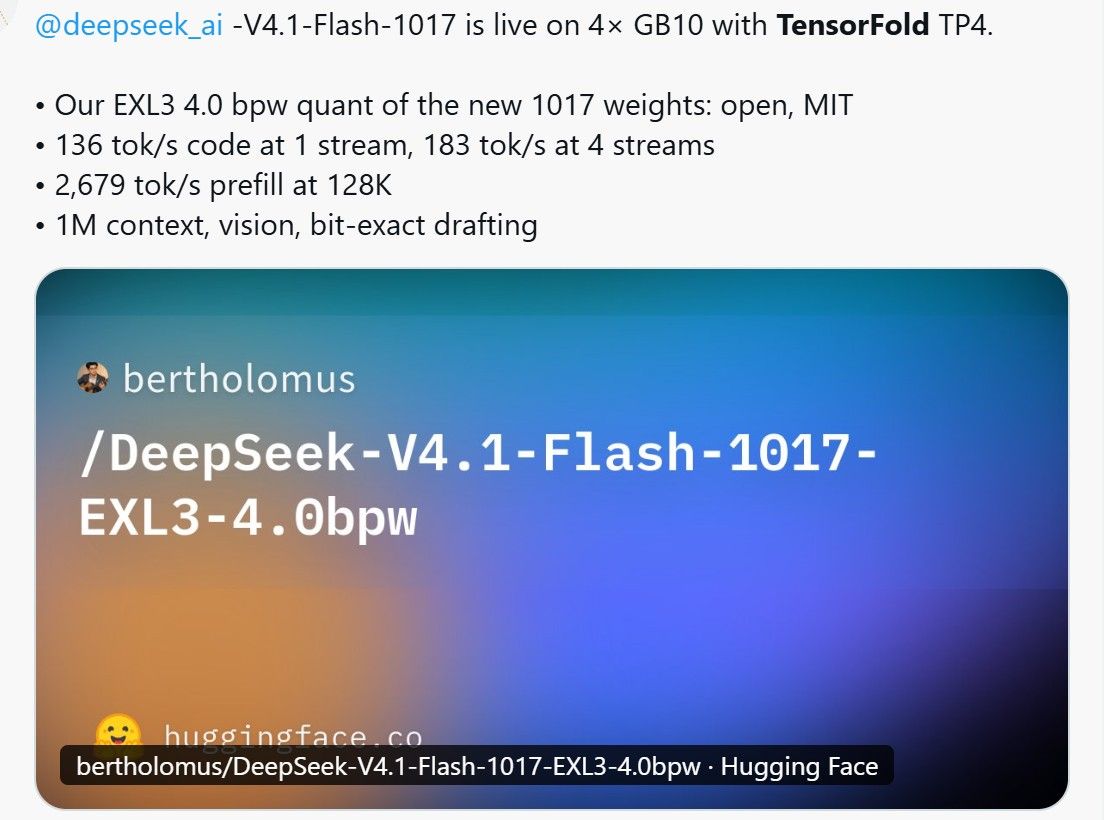
    我目测,最好的应该是tensor fold了,基本是dgx spark的专属框架+模型:

    {671C9AB6-18FB-4909-8BD7-49145562A319}.jpeg
    这速度基本上有一台24小时自动印TOKEN机了。


  • 3090春天来啦!最新推理引擎比Strata 快1.63倍!!!
    stxpnetS stxpnet
    LLM讨论区 rtx3090 strata

    这个turbo tan不一定有strata厉害 ,目前Strata我都不追新了,等他出更大的版本一起更新。


  • 造孽啊!————大家看看我的硬件配置,至于如此token水平吗?
    stxpnetS stxpnet
    AI硬件 x99 intel qwen-27b

    这人的号估计是保不住了——开口就骂老特,全程没有一句正常讨论,上来就是粗口。

    没有人有义务帮他,就这态度,恐怕连 SYCL 是什么都不知道。

    幸好没让他去折腾 AMD 的框架和模型,不然回帖的人怕是要被他挨个骂一遍。

    个人补充一点:日本人开发的 XESTARTA(专门针对 Intel 显卡),应该也能让他这套硬件比较舒服地跑起 Qwen 3.6-35B-A3B,是更合适的框架+模型组合。


  • 造孽啊!————大家看看我的硬件配置,至于如此token水平吗?
    stxpnetS stxpnet
    AI硬件 x99 intel qwen-27b

    就一张图,也不知道说啥好。 系统,框架,模型,一个字都不清楚。
    我用有限的信息,让GLM 5.3 FLASH调研出来的结果:

    # 华南X99 T8 + E5-2676 v3 + 32G + A770 16G 本地LLM选型调研报告
    
    > 调研日期:2026-10-23 | 方法:CBS 多查询调研(Google 4 组 + Reddit/DDG 2 组 + 深挖 3 页)
    > 参数:标准版(每主题 3-4 查询 × 15-20 条,80% 相关阈值)
    
    ## 一、硬件现状判定
    
    | 部件 | 型号 | 对 LLM 的实际意义 |
    |---|---|---|
    | GPU | Intel Arc A770 16GB (Xe-HPG/DG2, XMX) | 16GB 显存=最大资产;实测有效读带宽 ~374 GB/s(理论 560);llama.cpp SYCL 官方认证卡 |
    | CPU | E5-2676 v3 (12C/24T Haswell-EP) | AVX2 有、AVX-512 有但慢;给 MoE 专家 offload 和 draft 模型打下手 |
    | 内存 | 4×8G DDR4 | 四通道 ~68 GB/s 理论 / ~44 GB/s 实际;32G 装 27B 的 CPU 侧很紧,MoE 大模型装不下 |
    | 主板 | 华南 X99 T8 | 无 REBAR 支持,Arc 在无 REBAR 平台有 5-15% 额外损失(缓解补丁存在);Gen3 x16 |
    
    **关键事实:这套平台的价值 90% 在那张 A770 上,CPU 和主板只配当配角。**
    一切"上大模型"的方案(30B+ 稠密、百亿级 MoE 全量)都会被内存带宽和显存双重卡死,电力->智力转换率极差。
    
    ## 二、三个推荐方案对比
    
    | 维度 | 方案 A(首推)⚡ | 方案 B(求稳) | 方案 C(求大)⚠️ |
    |---|---|---|---|
    | **框架** | llama.cpp SYCL + **MTP 推测解码**(ef777/a770-qwen-xe1 调优分支) | llama.cpp SYCL 原版或 Ollama(Vulkan) | llama.cpp SYCL `--n-cpu-moe` 专家分层 + GPU 草稿 |
    | **模型** | **Qwen3.8-27B Q3_K_S**(~11.7GB)或 UD-Q3_K_XL | **Qwen3.6-14B / Qwen3-8B Q4_K_M** | **Qwen3.6-35B-A3B (MoE) Q4**,专家放内存 |
    | **实测速度** | 41-50 t/s decode @16-24K ctx(A770 同卡实测),prefill 600+ t/s | 14B Q4 约 25-30 t/s(带宽上限 39 t/s) | 15-25 t/s(GPU 侧快、CPU 侧专家 ~20-30 t/s 混合后取低值) |
    | **显存占用** | 12GB 权重 + 3GB KV(q8_0) ≈ 15GB,贴满 | ~11GB / 16GB,留足余量 | 专家 ~20GB 在内存,GPU 只放共享权重+KV |
    | **上下文** | 16-24K(q8_0 KV);32G 内存是硬上限 | 8-16K 从容 | 长上下文会挤压内存,26K 以内 |
    | **整机功耗** | ~270W | ~255W | ~340W(CPU 常驻高载) |
    | **电力->智力** | **0.16 t/s/W(冠军)**,1M token ≈ 1.7 kWh ≈ 0.95元 | 0.12 t/s/W,1M token ≈ 2.4 kWh | 0.05 t/s/W,1M token ≈ 5.2 kWh(垫底) |
    | **部署难度** | 中:需 oneAPI 2026.1 自编译 + 打补丁 | 低:官方 SYCL 预编译包即用 | 中高:offload 参数需反复调 |
    | **理由** | 智力上限和能效双冠军。MTP 推测解码让 27B 智力模型的 decode 提速 2.5 倍,是这张卡社区公认的"最优解",且你正好有 32G 内存喂 draft | 生态最省心,质量稳定,留升级余量;但 14B 智力天花板明显低于 27B | 看着"35B 最大",实际被 DDR4-2133 带宽锁死,每瓦产出只有方案 A 的 1/3——**这是电力->智力视角下的反面教材** |
    
    ## 三、为什么这么排(证据链)
    
    1. **A770 的 decode 是纯带宽游戏**:ef777 实测 374 GB/s 有效读带宽,27B Q3(11.7GB)不投机时 ~20 t/s 是物理天花板;开 MTP 3-draft 后 verify 步 4 token 近似 1 token 成本 → 40-50 t/s。这不是玄学,是拿内核级 SYCL/ESIMD 补丁换来的(IQ4/IQ3 K-quant matvec + FA decode 内核,perplexity 不变)。
    2. **框架排序(A770 上)**:llama.cpp SYCL ≫ Ollama(Vulkan) ≈ 裸 Vulkan > IPEX-LLM(PyTorch)。vLLM XPU 只对 Arc Pro B 系列(Xe2)成熟,A770 不建议。AWQ/GPTQ/EXL2 全部排除(CUDA-only 或不成熟)。
    3. **MoE 全放 GPU 不行**:A770 上 MoE 模型因 ~2500 次/token 内核发射反而只有 14 t/s(llama.cpp SYCL 调度瓶颈),27B 稠密+MTP 反而更快——这正是方案 A 压倒"MoE 大杯"的实测依据。
    4. **CPU 只配干两件事**:给 MTP 当 draft 宿主、给 A3B 级 MoE 当专家仓库。DDR4-2133 四通道 44 GB/s 实际带宽决定了 CPU 侧任何角色都在拖后腿,所以方案 C 只能是"能跑"而不是"推荐"。
    5. **X99 T8 平台适配注意**:
       - 无 REBAR:装 Intel 最新版驱动(26.x),并留意社区 no-rebar 缓解补丁,损失可压到 ~5%;
       - Linux 建议 `xe` 内核驱动(`xe.force_probe=56a0`)+ level-zero 26.35+,比 i915 明显快(Reddit/博客共识);
       - 主板 PCIex16 是 Gen3:双 A770 tensor split 实测损失可控(zhaoyshine 双 A770 平台 PCIe 3.0 x8 下 tensor split 19.3 vs layer 15.7 t/s),但单卡方案不受影响;
       - 32G 内存上限意味着 Q3 27B + draft + 系统占用后所剩无几,**别再上 30B 以上量化模型**。
    
    ## 四、落地命令锚点(方案 A)
    
    ```bash
    # 编译(oneAPI 2026.1)
    source /opt/intel/oneapi/setvars.sh
    cmake -B build -DGGML_SYCL=ON -DCMAKE_C_COMPILER=icx -DCMAKE_CXX_COMPILER=icpx -DGGML_SYCL_F16=ON
    
    # 服务(q8_0 KV + FA + MTP)
    ONEAPI_DEVICE_SELECTOR="level_zero:0" ./llama-server \
      -m Qwen3.8-27B-Q3_K_S.gguf -ngl 999 -fa on \
      -ctk q8_0 -ctv q8_0 -c 16384 -b 2048 -ub 768 \
      --model-draft mtp-Qwen3.8-27B-Q4_0.gguf --spec-draft-n-max 3
    

    进一步提速可套 ef777 的 Xe-HPG 专用内核补丁(GitHub: ef777/a770-qwen-xe1,2026-10-11 更新)。

    五、信源

    • ef777/a770-qwen-xe1 — A770 16G + Qwen3.8-27B Q3_K_S/UD-Q3_K_XL + MTP 全套实测(本次核心依据,同卡同模型)
    • zhaoyshine/dual-intel-arc-a770-llm-bench — 双 A770 SYCL/Vulkan/MTP 基准(2026-10-22 更新)
    • quantized.uk Intel Arc cookbook — 框架路线对比与兼容性矩阵
    • r/LocalLLaMA A770 MoE 内核发射瓶颈帖 + PSA 推测解码提速帖
    • Reddit "Xeon DDR4 CPU inference" — DDR4 带宽→t/s 换算与 65% 效率经验值

    结论一句话

    这张 A770 的"电力->智力"最优解只有一个:别贪大,用 llama.cpp SYCL + MTP 把 Qwen3.8-27B Q3_K_S 压到 16GB 里跑出 40+ t/s。 35B MoE 大杯方案能跑但每瓦智力产出只有它的 1/3,纯属电力浪费;14B 稳方案留给不想折腾的时候。


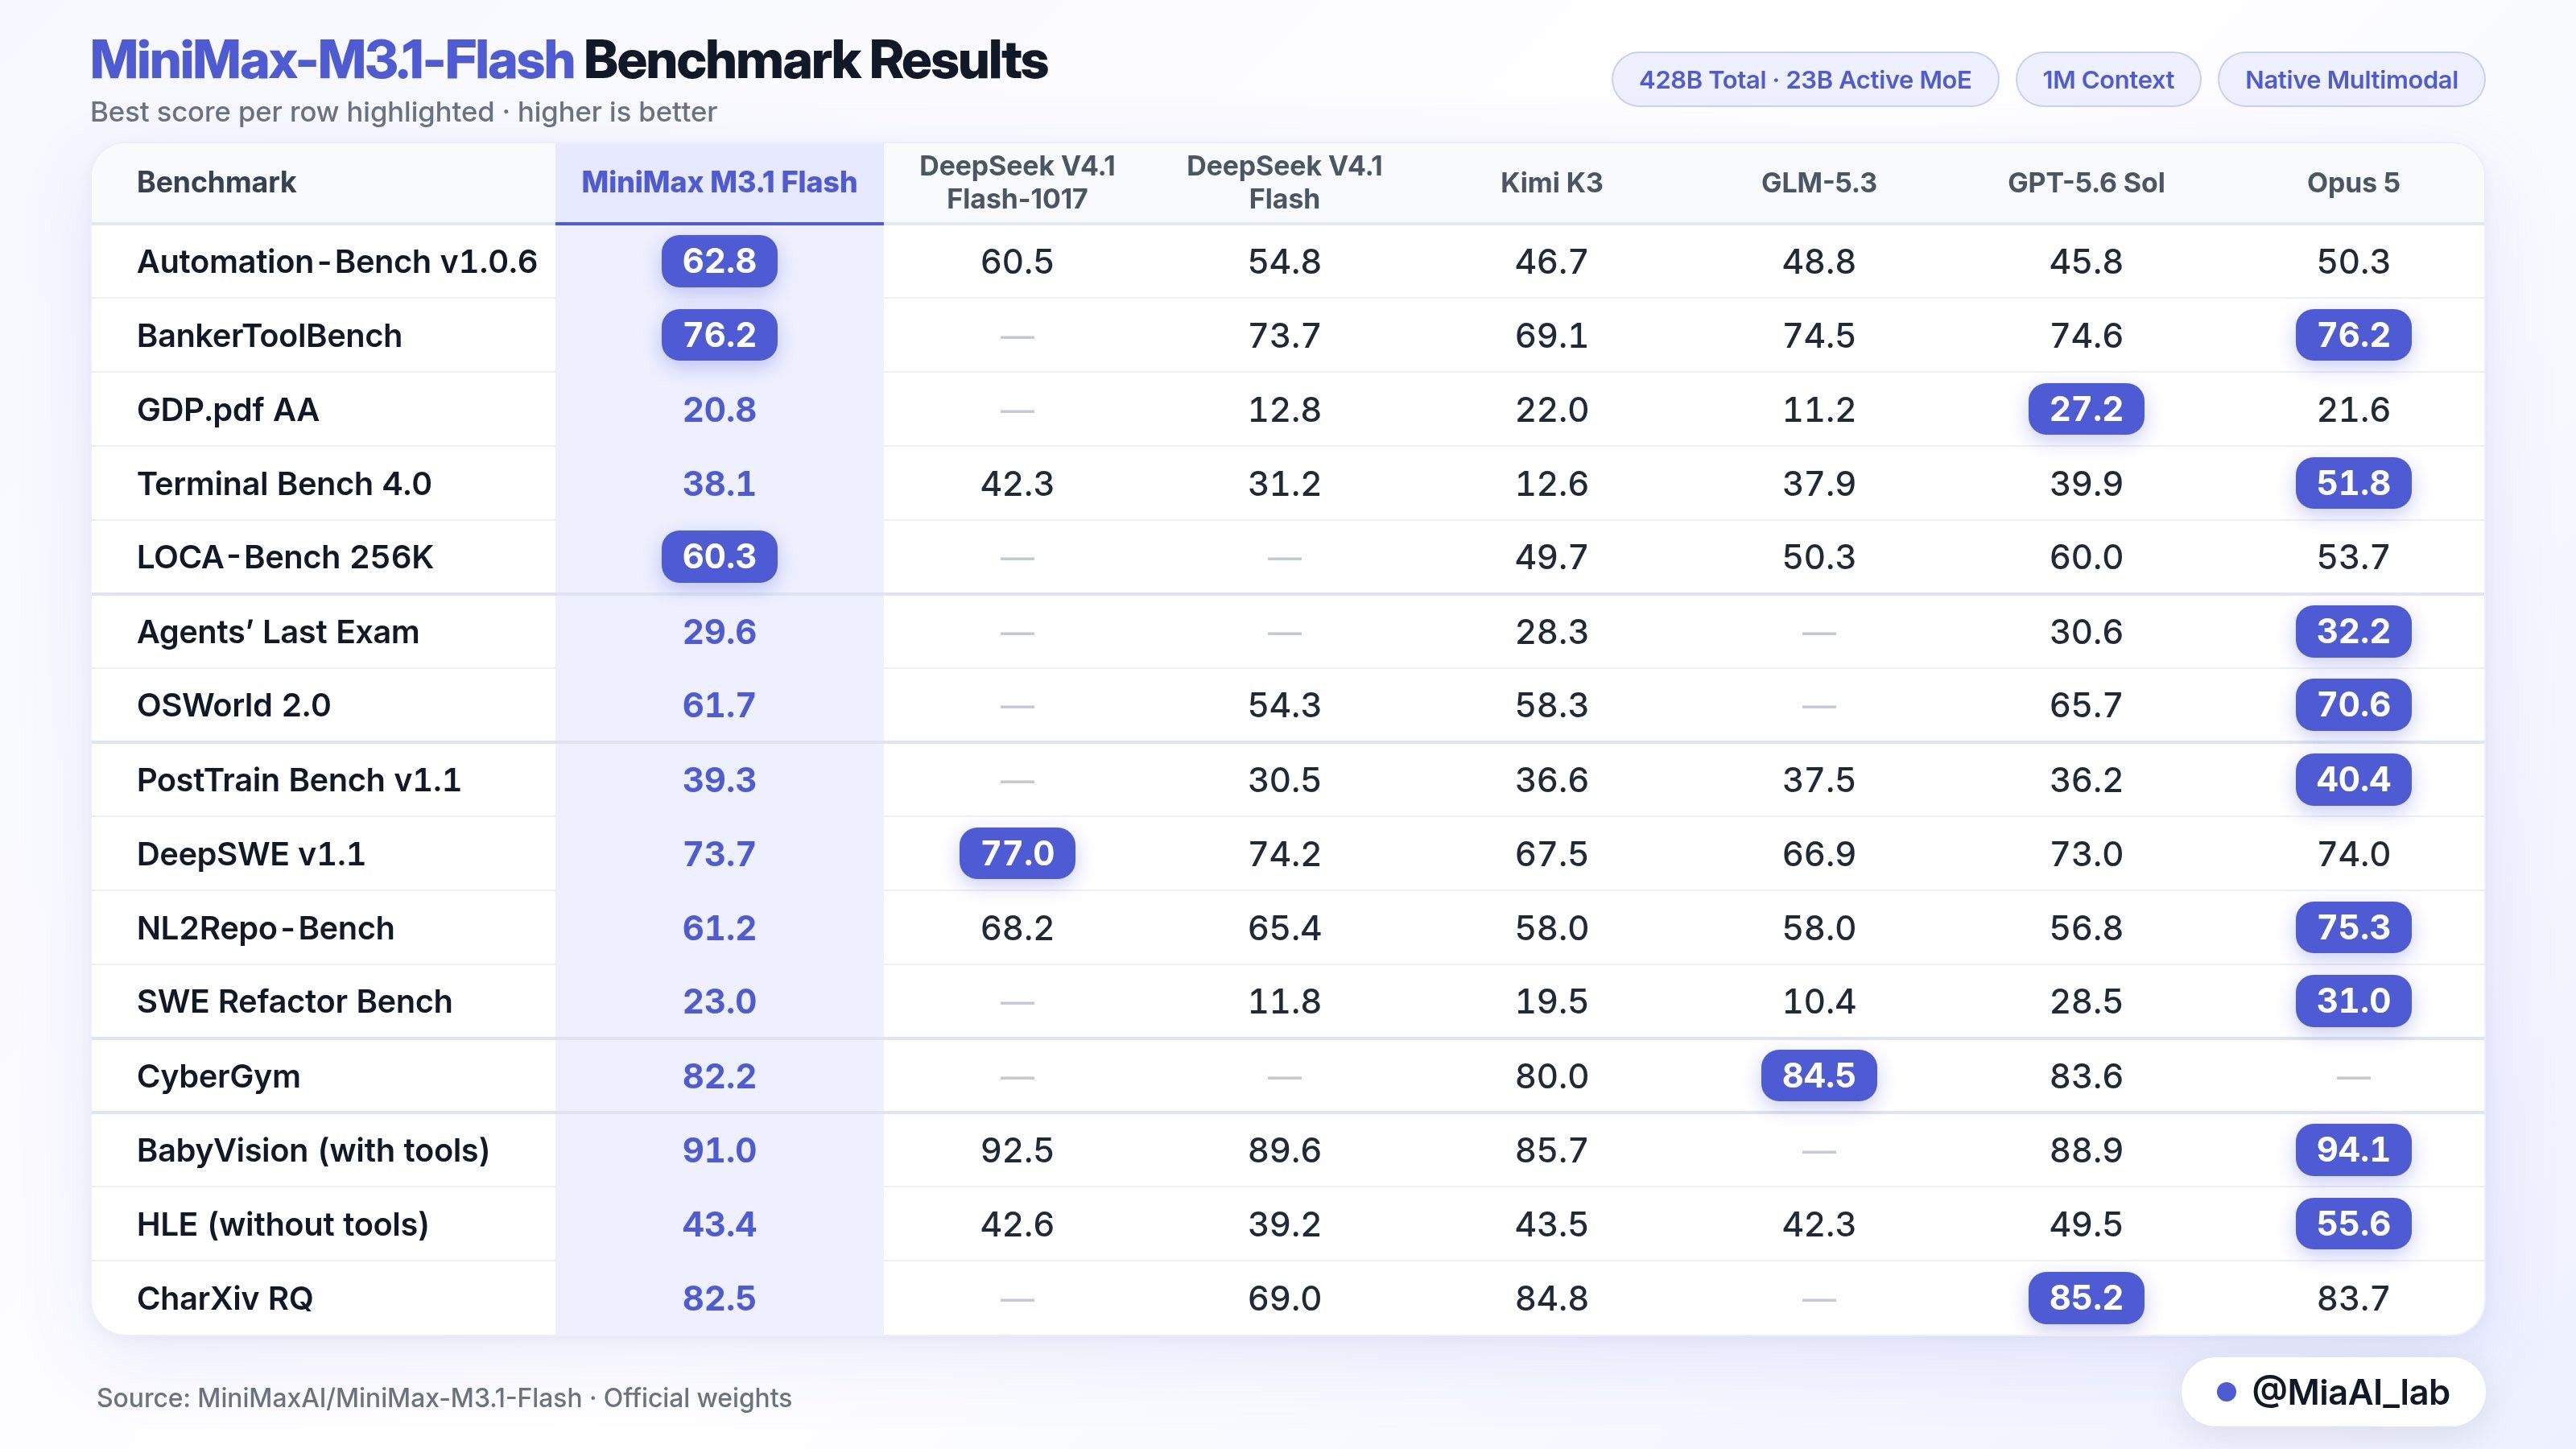
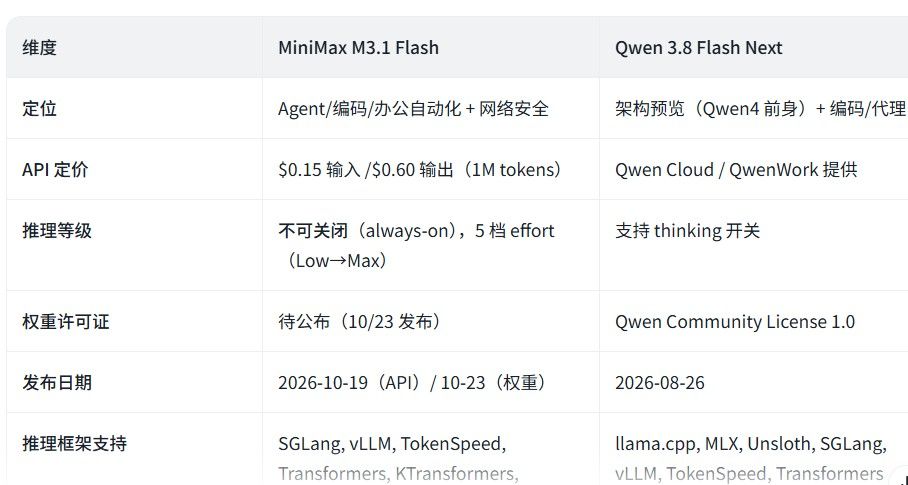
  • 【讨论】 Minimax M3.1 Flash开源了 (26-10-23)
    stxpnetS stxpnet
    随便聊聊 minimax strata 本地模型

    利用本地的话,主要是做子AGENT降低TOKEN消耗,以及白天对抗国内API高峰时的降速,我只想到一种玩法,白天用QFN 3.8快速协助工作。 晚上再换上大参数的在线API,带着本地DEEPSEEK或者MINIMAX 继续打磨,复核。


  • 本地AI硬件焦虑个锤子!看看好消息吧
    stxpnetS stxpnet
    LLM讨论区 本地模型

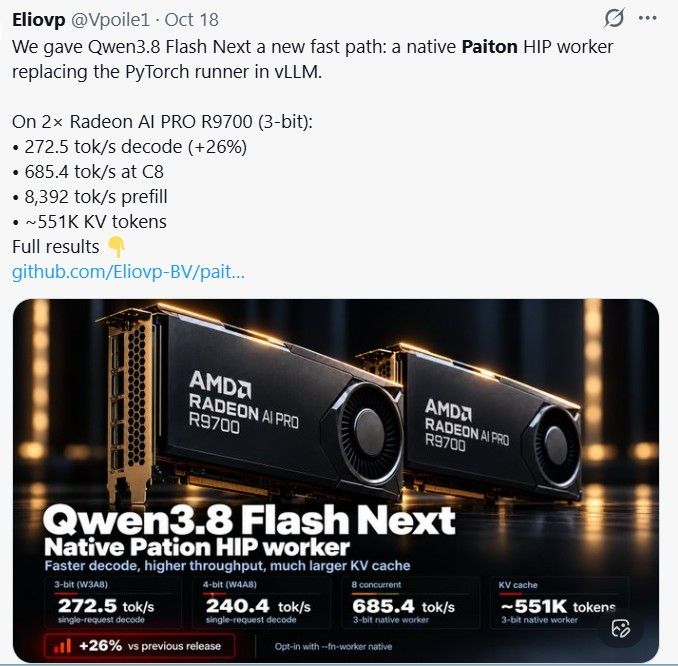
    {A4A8DCF1-A929-42B8-B493-35C14F1C9A3C}.jpeg

    刚搜了一下paiton. 你们这R9700 也吃得太好了吧。。。。 羡慕嫉妒+后悔。


  • 【讨论】 Minimax M3.1 Flash开源了 (26-10-23)
    stxpnetS stxpnet
    随便聊聊 minimax strata 本地模型

    image.jpeg

    {54AEE6D5-9CDA-4F6A-88D1-1D2DFD2CF75E}.jpeg

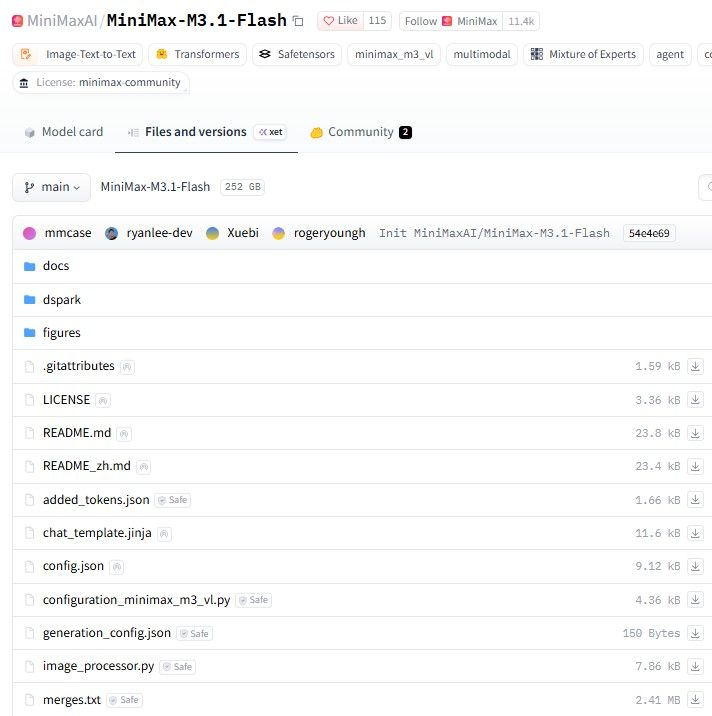
    本贴主角,甘愿当各个在线AGENT 小弟的minimax M3.1 FLASH
    F16权重 252G

    {91D17964-9B90-454B-9CEB-A8526569804F}.jpeg

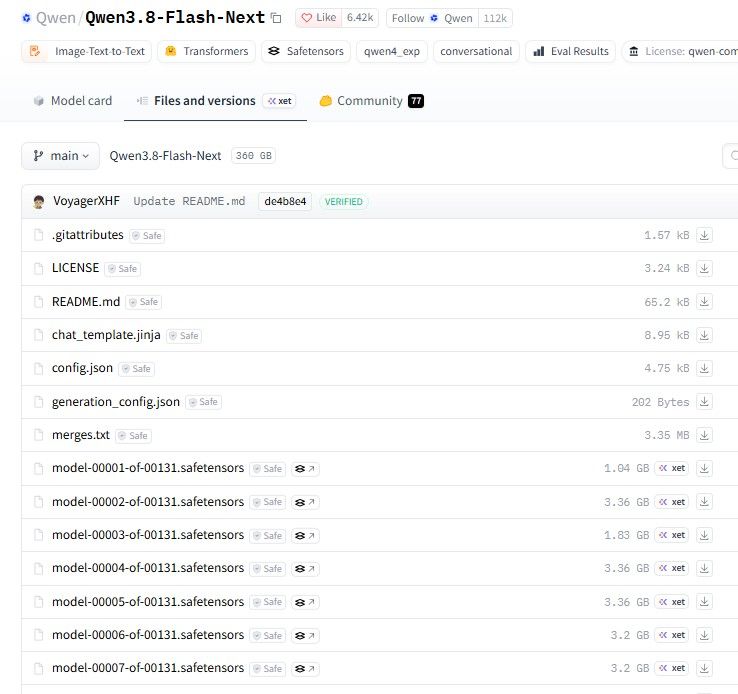
    被Strata捧红的当红炸子鸡
    F16权重 360G

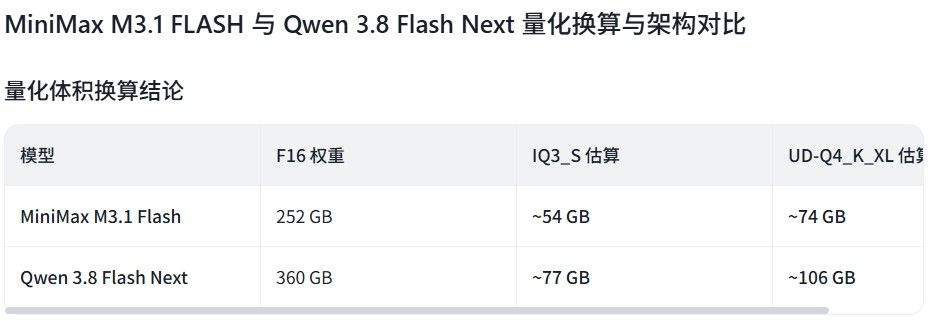
    如果按QFN3.8的IQ3_S 体积来换算:
    {967FF798-4019-42CC-B21E-7B0F31E7E508}.jpeg

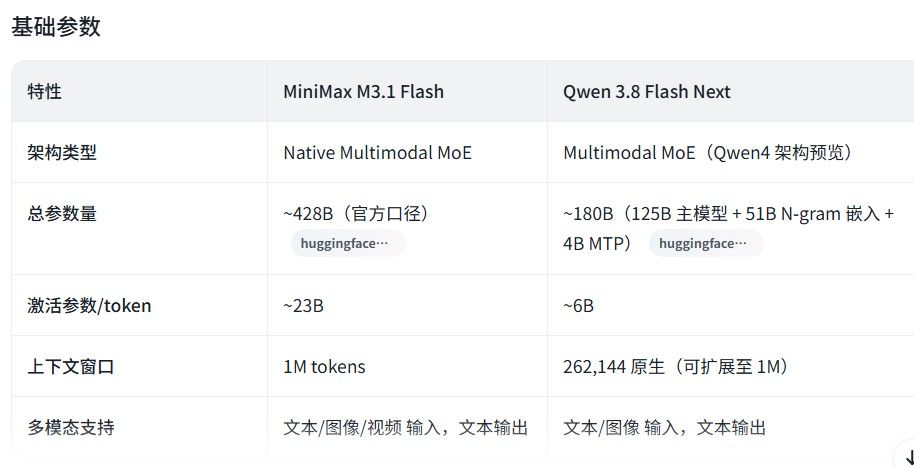
    总体积小了,但是激活参数较高,现在流畅跑QFN3.8的硬件不一定能带得动。
    {2AE8951B-969C-4995-88FE-0C6491083F72}.jpeg

    {DDC3686B-C52C-4F89-8D21-E051A426234F}.jpeg

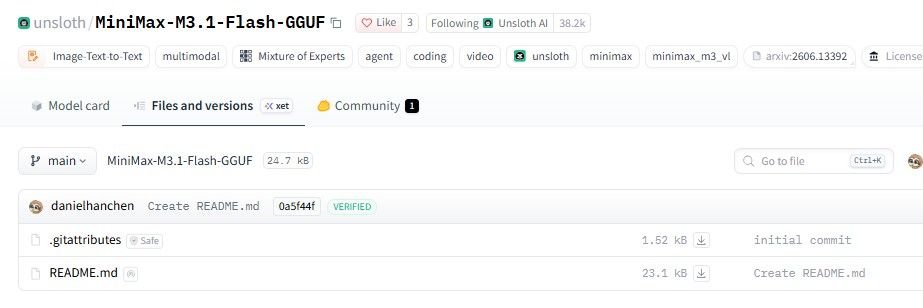
    unsloth已经在制作中
    {8B4825D7-932F-40B7-A7F3-26E33B9BBE47}.jpeg


  • 加拿大垃圾佬淘机记:为了跑本地 AI,从 X299 折腾到 X570,顺便交了点学费
    stxpnetS stxpnet
    AI硬件 rtx5060 多卡部署

    X570 三条X16就直接PK掉了牙膏厂那种残疾不高于20条PCIE的 阉割主板. 多出的PCIE会让STRATA跑得更舒服.


  • Qwen 3.8 思考真的要至少設low
    stxpnetS stxpnet
    随便聊聊 qwen

    有没有好的AUTO插件,自动根据输入字数做路由到不同的思考等级,我觉得那样是相对合理的.


  • 10-22 提示词挑战: 魔方演示网页
    stxpnetS stxpnet
    随便聊聊 编程

    哈哈,应该让他的AGENT写一个JS脚本来自动玩.


  • 10-22 提示词挑战: 魔方演示网页
    stxpnetS stxpnet
    随便聊聊 编程

    是的,旧的那个很难一次性做好,我发现那些简单的提示词想一次做好可能必须要opus 5.5那样的前沿模型才可以。

    你这个效果很好啊,交互不行是因为提示词没有明确给需求。


  • 10-22 提示词挑战: 魔方演示网页
    stxpnetS stxpnet
    随便聊聊 编程

    {1B336A7B-8502-43A6-A538-8A4A2910EF44}.jpeg
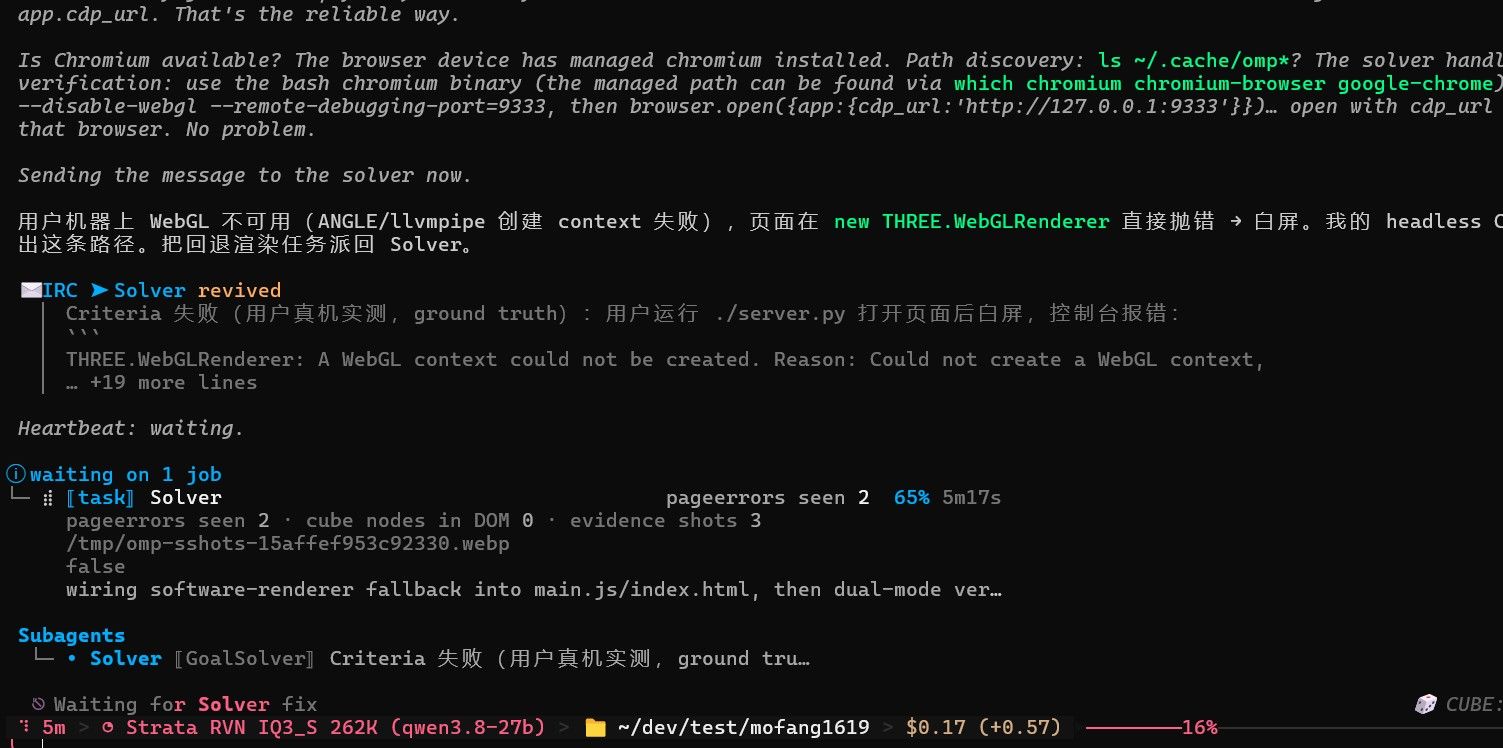
    在我的环境实测,OMP + goal driven插件,10分钟就写好了(主编排花费40Ktoken),但是第一次运行失败。第二次让它修复 花了非常久也写不好。

    同时我用GLM5.3 FLASH在另一台电脑上,使用goal interview的方式,模型问了我一些问题。 15分钟就写好并交付了。 不过 在拖曳 魔方的某一面时,用户体验还是差强人意。


  • 10-22 提示词挑战: 魔方演示网页
    stxpnetS stxpnet
    随便聊聊 编程
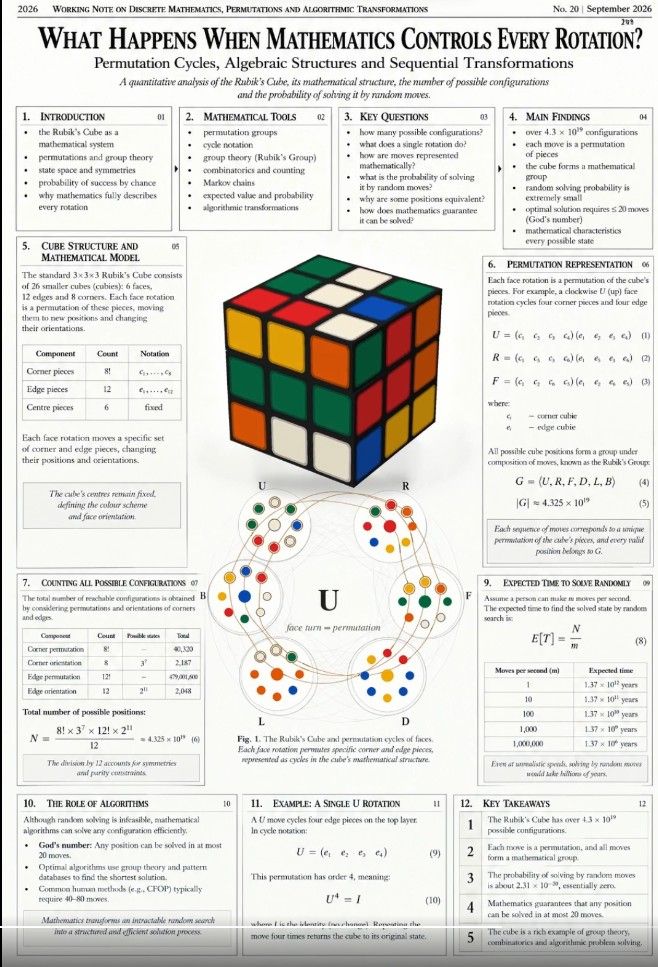
    目标:用HTML及three.js 写一个经典魔方的3D展开图,要求:魔方的每一面一种颜色:红,黄,绿,蓝,白,橙。
       上方的魔方是3D可动组件,用户可随意用鼠标拖动让它的一面旋转。
       下方为魔方六面展开图,每一面一个圆,圆心中间大圆点是该面的中间方块颜色,周边8个点则对应魔方上周边8个点的颜色。
       如果可以再增加拖动时的音效。
    验收标准:人类可以通过该网页了解魔方的玩法。能通过多个步骤将魔方还原为初始状态。
    

    {9398607F-06A6-4186-92F1-42EE9B7D2923}.jpeg

    图片是这个提示词的灵感来源, 各位 可以测试一下这个提示词,看看多久可以完成,成品效果如何。它应该可以综合考验本地LLM的 空间感知,网页设计,编程等实力。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组